

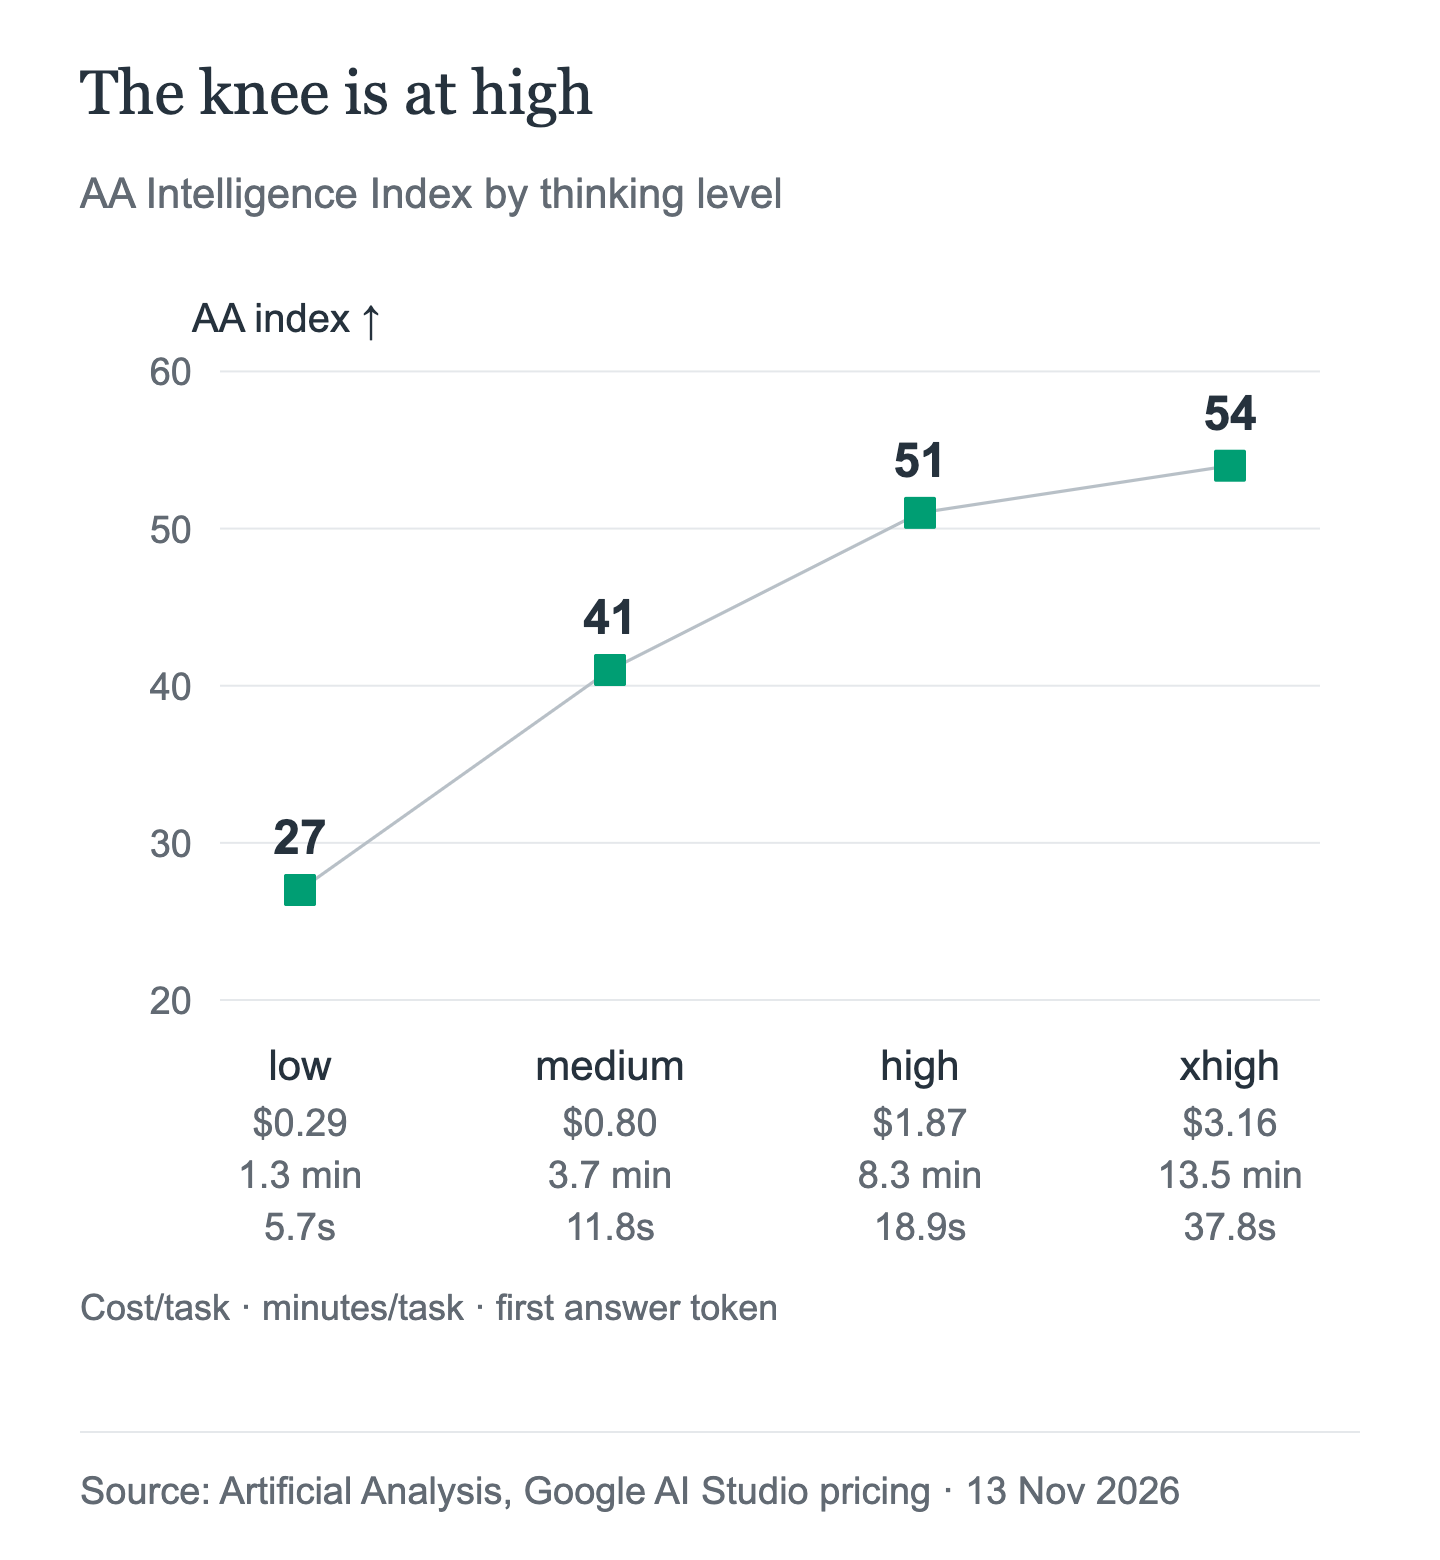
У Gemini 4 Hydrogen четыре уровня thinking mode, и ведут они себя почти как четыре разные модели. По актуальным измерениям Artificial Analysis одна и та же модель набирает 27 на low, 41 на medium, 51 на high и 54 на xhigh. По умолчанию установлен high, а xhigh — новинка семейства Gemini 4: Carbon и Argon ограничиваются уровнем high.
Разброс велик: одна и та же модель охватывает 27 пунктов индекса от low до xhigh. Переход с medium на high даёт 10 пунктов индекса примерно за $1.07 на задачу. Переход с high на xhigh добавляет 3 пункта за $1.29, а ожидание первого токена ответа почти удваивается. Практический вывод: начинайте с high, оставьте xhigh для сложных многошаговых задач, а low и medium рассматривайте как режимы с меньшей задержкой, качество которых нужно проверять отдельно.
Ниже разберём, для чего подходит каждый уровень, сколько он стоит, что меняется в API и какие сведения AIHubMix приводит — и не приводит.
Четыре уровня и изменения
Gemini 4 Hydrogen поддерживает уровни low, medium, high и xhigh. В примечаниях к выпуску Google сказано прямо: «По умолчанию используется high, также добавлен xhigh». Это два отличия от Gemini 3.8 Flash, у которой по умолчанию установлен medium, а максимальный уровень — high.
Остальные модели семейства не изменились. Carbon и Argon поддерживают уровни low, medium и high, по умолчанию установлен medium. Hydrogen — единственная модель Gemini 4 с уровнем выше high.
| Модель | Уровни | По умолчанию |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL в этот набор не входит. В документации Gemini 4 по thinking mode сказано, что MINIMAL «не поддерживается моделями Gemini 4», а в примечаниях к выпуску Hydrogen указано, что модель «отклоняет minimal с ошибкой». Документированного способа отключить thinking mode у этой модели нет.
Рекомендации Google
Рекомендации Google — разумная отправная точка, но они составлены до приведённых ниже измерений. В частности, рекомендация использовать medium для интерактивного программирования предполагает такой уровень качества, которого Artificial Analysis не наблюдает на medium.
| Уровень | Описание Google и рекомендуемые сценарии |
|---|---|
| low | «Меньше всего токенов, минимальная задержка» — быстрые чаты, высокая нагрузка |
| medium | «Меньше токенов, быстрее ответы» — интерактивное программирование, прототипы интерфейсов |
| high | «Баланс интеллекта и скорости» — уровень по умолчанию для большинства задач |
| xhigh | «Максимум токенов, наиболее глубокие рассуждения» — сложные многошаговые задачи программирования |
К таблице прилагаются два предупреждения. «Использование xhigh увеличивает задержку и расход токенов и может приводить к избыточным рассуждениям при простых промптах», — отмечает Google. Рекомендация по оценке также однозначна: «Проводите оценивание на всех четырёх уровнях, задав высокое значение max_output_tokens».
Измерения по уровням
Artificial Analysis измерила все четыре уровня. Использовался Intelligence Index v5.0.1; в рейтинге 78 моделей. Данные проверены 2026-11-13T02:40Z; цены — стандартные, из прайс-листа. Это стоимость задач по оценке AA, а не счета AIHubMix.
| Уровень | Место в рейтинге AA | Индекс AA | $/задачу | Мин./задачу | До первого токена ответа |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Важнее всего величина прироста при переходе между уровнями:
low→medium: +14 пунктов индекса, +$0.51 на задачу, +2.4 минуты и +6.1 секунды до первого токена.medium→high: +10 пунктов индекса, +$1.07 на задачу, +4.6 минуты и +7.1 секунды до первого токена.high→xhigh: +3 пункта индекса, +$1.29 на задачу, +5.2 минуты и +18.9 секунды до первого токена.
high — переломная точка. Это последний переход, на котором прирост качества велик относительно дополнительных затрат; на xhigh ожидание первого токена почти удваивается ради небольшого прироста индекса. Это не значит, что xhigh — плохой уровень. Он подходит для задач, с которыми не справляется high, — именно так его и описывает Google.
Для сравнения: в том же срезе Carbon high набирает 60 при $5.48 за задачу и 28.1 минуты; Carbon medium — 58 при $4.68; Carbon low — 54 при $5.22; Argon high — 50 при $4.97 и 30.6 минуты. Hydrogen на уровне xhigh набирает столько же, сколько Carbon low, — 54, но стоимость задачи на 39.5% ниже ($3.16 против $5.22), хотя первый токен появляется через 37.77 секунды против 13.61. Hydrogen на уровне high превосходит Argon high на один пункт индекса при стоимости задачи на 62.4% ниже.
Где уровни дают сбой
low — это не просто небольшое снижение качества. С результатом 27 он уступает high 24 пункта индекса. Если перевести нагрузку с high на low, чтобы сэкономить $1.58 на задачу, вы не получите тот же продукт с меньшим объёмом рассуждений — вы получите гораздо более слабую модель. Для классификации, маршрутизации или краткого извлечения данных это может подойти. Для программирования и агентных задач — нет, если только вы не провели оценку на конкретных задачах.
medium — это уровень для снижения задержки, а не для повышения качества. Он набирает 41 пункт — на 10 меньше, чем high, — и стоит $0.80 против $1.87. Экономия существенная — 57% на задачу, — но разрыв в качестве больше, чем можно предположить по разнице в цене. Google рекомендует medium для интерактивного программирования; прежде чем следовать этому совету, проверьте его на собственных задачах — так подсказывают результаты AA.
xhigh может чрезмерно углубляться в рассуждения. Google прямо предупреждает об этом. Цифры AA по стоимости и времени показывают эффект: $3.16 за задачу, 13.5 минуты и 37.77 секунды до первого токена. Для простого промпта это слишком большая задержка ради небольшого прироста. Для сложной многошаговой задачи программирования, с которой не справляется high, это единственный уровень, позволяющий пойти дальше.
Многословность тоже увеличивает счёт. Artificial Analysis называет Hydrogen «очень многословной»: запуск на xhigh сгенерировал 304 миллиона выходных токенов при расчёте индекса — это 76-е место из 77, тогда как медианное значение составляет 72.8 миллиона. К выходным токенам относятся и токены рассуждений, а каждый миллион выходных токенов стоит $7.50. На более высоком уровне модель не просто дольше рассуждает — она генерирует больше токенов, за которые взимается плата.
Стоимость: как thinking mode превращается в токены
Тарифы просты. Hydrogen стоит $1.50 за миллион входных токенов, $7.50 за миллион выходных токенов и $0.075 за миллион входных токенов из кэша. В выходные токены входят токены рассуждений. Поэтому уровень влияет на стоимость сильнее, чем его название: оплата взимается за сгенерированные моделью рассуждения, а не за выбранный уровень.
Вот три правила тарификации, которые легко упустить.
Уровень по умолчанию изменился. В Gemini 3.8 Flash по умолчанию использовался medium, а в Hydrogen — high. После миграции нагрузка, для которой уровень не задавался явно, будет расходовать больше выходных токенов за ход при той же цене за токен. Изменение бюджета, замаскированное под замену модели.
Кэширование доступно только в неявном режиме. Hydrogen поддерживает неявное кэширование с минимальным порогом 4,096 токенов и скидкой 95% при попадании в кэш; явное кэширование не поддерживается. На странице Google для корпоративных клиентов также сказано: «По умолчанию запись в кэш тарифицируется по цене стандартного входного токена, умноженной на 1.25». Это формулировка Google о тарификации; правила тарификации кэша AIHubMix для этой модели не задокументированы.
У длинного вывода есть ограничение на один этап генерации. Синхронный запрос генерирует до 65,536 токенов за один этап — как с потоковой передачей, так и без неё. Для более длинного вывода нужны фоновое выполнение или токены продолжения, а max_output_tokens ограничивает совокупное число токенов рассуждений и выходных токенов. Если задать background=true, не указав max_output_tokens, сервер остановится после 65,536 токенов. Для длинной генерации Google рекомендует задавать лимиты 131,072 или 262,144 — максимум 1,048,576 минус число входных токенов.
Что поддерживает API и какие запросы отклоняет
Параметр называется thinking_level (snake_case). В примере для Python от Google он задаётся внутри thinking_config; в примере для Node — внутри thinkingConfig (camelCase). На странице модели перечислены значения LOW, MEDIUM, HIGH и XHIGH, а в примечаниях к выпуску они записаны строчными буквами. Используйте enum своего SDK или документированное строковое значение, а не вводите вариант регистра вручную.
Вот три варианта запроса, которые завершатся ошибкой:
thinking_budgetдля любой модели Gemini 4 приводит к ошибке400: INVALID_ARGUMENT. Если задать одновременноthinking_levelиthinking_budget, запрос также завершится ошибкой.thinking_level="MINIMAL"не поддерживается; Hydrogen отклоняет такое значение.- Пользовательские значения
temperature,top_pиtop_kигнорируются. Фиксированные значения по умолчанию: temperature 1.0, topP 0.95 и topK 64.
На платформе Google Hydrogen также поддерживает вызов функций, выполнение кода, контекст URL и управление компьютером. В Interactions API используйте previous_interaction_id для многошаговых диалогов и сеансов с вызовами инструментов.
Что документирует AIHubMix, а что нет
В документации AIHubMix для Hydrogen указан маршрут POST https://aihubmix.com/v1/chat/completions с параметром model="gemini-4-hydrogen". На странице модели перечислен ввод текста, изображений, аудио, видео и PDF, а также текстовый вывод; в llms.txt всё ещё указана более старая версия — только текст, поэтому ориентируйтесь на страницу как на более актуальный источник. Возможности использования инструментов, структурированного вывода и рассуждений помечены как «не опубликованы». Модель отсутствует в индексе моделей, сформированном 2026-11-11, схема протокола также не опубликована.
Это важно для данной статьи, поскольку AIHubMix не описывает, как задавать уровень thinking mode ни для одной модели Gemini 4. В руководстве AIHubMix по Gemini рассматривается reasoning_effort для моделей поколения Gemini 2.5, но не thinking_level и не xhigh для Gemini 4. Не стоит предполагать, что шлюз передаёт любой из этих параметров, и считать, что на AIHubMix по умолчанию установлен тот же уровень, что и в API Google.
Безопаснее всего использовать формат запроса, описанный в документации AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Если возможность задавать уровень обязательна, обращайтесь напрямую к API Google или проверьте работу шлюза с помощью небольшого запроса, прежде чем направлять через него рабочий трафик. Пока принимаете решение, полезно свериться со страницей сравнения AIHubMix для оценки стоимости. Для этой статьи живые тесты не проводились.
С чего начать в зависимости от задачи
| Задача | С какого уровня начать и почему |
|---|---|
| Быстрый чат, маршрутизация, классификация | medium; протестируйте low: его оценка — 27 |
| Интерактивное программирование, прототипирование интерфейсов | high: у AA для medium оценка — 41 |
| Выполнение агентами, циклы вызовов инструментов | high; используйте xhigh, только если задача застопорилась |
| Сложная отладка, архитектура, планирование | xhigh или Carbon: на 3 пункта выше за 69% дополнительной стоимости |
| Массовая пакетная обработка после оценки | low или medium: самые дешёвые, но индексы — 27 и 41 |
| Строгое ограничение задержки: менее 15 секунд | medium или low: high ждёт 18.89 с |
Это отправные точки, а не правила маршрутизации. Подходящий уровень — самый низкий из тех, что проходит вашу собственную оценку; Google рекомендует проводить эту оценку на всех четырёх уровнях.
Часто задаваемые вопросы
Какие уровни thinking есть у Gemini 4 Hydrogen?
Четыре: low, medium, high и xhigh. По умолчанию используется high.
Что изменилось по сравнению с Gemini 3.8 Flash?
Уровень по умолчанию изменился с medium на high, а выше high добавили xhigh. Для Carbon и Argon по умолчанию по-прежнему установлен medium, а максимальный уровень — high.
Стоит ли использовать xhigh?
Для сложных многоэтапных задач, с которыми не справляется high, — да: он добавляет 3 пункта к индексу. Но каждая задача обходится на 69% дороже, чем с high, а ожидание первого токена почти удваивается. Поэтому для простых промптов этот уровень не подходит в качестве настройки по умолчанию.
Почему low настолько отстаёт?
По оценке Artificial Analysis, его индекс равен 27 — на 24 пункта ниже, чем у high. Задача стоит $0.29 против $1.87, но разрыв в качестве гораздо больше, чем разница в цене. Используйте этот уровень, только если оценка конкретной задачи показывает, что его достаточно.
Поддерживает ли AIHubMix thinking_level или xhigh?
В документации подтверждений нет. AIHubMix не публикует сведения о поддержке reasoning для Hydrogen и не предоставляет руководства по уровням thinking в Gemini 4. Прежде чем полагаться на эти возможности, проверьте их поддержку.
Что произойдёт, если отправить thinking_budget?
Gemini 4 вернёт 400: INVALID_ARGUMENT. Если одновременно задать thinking_budget и thinking_level, система также вернёт ошибку.
Можно ли отключить thinking?
Задокументированного способа отключить его нет. Gemini 4 не поддерживает MINIMAL, и Hydrogen выдаёт ошибку при его использовании.
Читайте дальше: серия статей о Gemini 4 Hydrogen
- Если вы ещё решаете, стоит ли переходить на Hydrogen с Gemini 3.8 Flash, в первой статье рассматриваются запуск, изменение цены и компромиссы при выборе бенчмарков: Gemini 4 Hydrogen и Gemini 3.8 Flash: стоит ли переходить?.
- Если вас интересует, как Hydrogen сравнивается с Carbon и Argon при выполнении одной и той же задачи, в третьей статье все три модели сопоставляются по ценам и задержке, а также приводится таблица задач: Gemini 4 Carbon, Hydrogen и Argon: какую модель выбрать для каждой задачи?.
Источники
- Google AI Studio, Gemini 4 Hydrogen: что нового
- Google, Gemini 4 thinking
- Google, страница модели Gemini 4 Hydrogen
- Google AI Studio, цены Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — актуальный снимок на 2026-11-13T02:40Z, Intelligence Index v5.0.1


