Gemini 4 Carbon можно напрямую подставить вместо Gemini 4 Argon на уровне схемы запросов. Подойдёт то же тело запроса для Chat Completions: нужно изменить ID модели, а некоторые значения параметров не сохраняются. Важные сбои происходят уровнем ниже — ошибки параметров с ответом 400, незаметное усечение вывода и настройки тайм-аутов и оплаты, рассчитанные на длительный thinking mode.
В первую неделю всё решают четыре настройки по умолчанию:
- Не задавайте
max_tokensвыше 65,536 на AIHubMix: шлюз документирует только Chat Completions и не указывает более высокий предел вывода. - Для фоновых запусков через Google Interactions задайте
store=trueи явныйmax_output_tokens; для Carbon на AIHubMix эти поля не задокументированы. - При использовании нативного для провайдера пути длительной генерации увеличьте тайм-аут чтения HTTP до 15–20 минут для каждого потока.
- Удалите
temperature,top_pиtop_k— они игнорируются, — а также штрафы и значенияcandidate_countвыше 1: согласно руководству Google по Carbon, они приводят к ответу 400.
Основы, которые не изменились, — доступ, отказы по соображениям безопасности и стоимость задачи — описаны в публикации о миграции с Argon. Здесь речь пойдёт о поведении Carbon.
Какие сбои явные, а какие — незаметные
Сбои чётко делятся на два типа: ошибка 400 сразу сообщает о проблеме, а о незаметном ограничении вы узнаете из счёта.
| Что наблюдается | Тип | Что сделать в первую очередь |
|---|---|---|
| HTTP 400 для параметра | Явный | Удалить неподдерживаемое поле |
| 400 для фонового запроса | Явный | Добавить store=true |
| Ответ обрывается на 65,536 токенах | Незаметный | Увеличить max_tokens, но не выше 65,536 |
| Пустой текст, статус incomplete | Незаметный | Увеличить лимит и повторить запрос |
| Фоновый запуск заканчивается примерно на 64K | Незаметный | Задать max_output_tokens |
| Ответ выглядит поверхностнее | Незаметный | Явно задать уровень thinking mode |
| Счёт выше расчётного | Незаметный | Учитывать thinking mode и этапы генерации |
На AIHubMix для gemini-4-carbon указаны цены $2 за входные токены, $10 за выходные и $0.10 за кэшированные токены на миллион токенов — начальные тарифы Google — для Chat Completions. Они временные; подробности — в разделе об оплате.
Явные сбои: задокументированные ошибки 400
Многие задокументированные ошибки 400 связаны с проверкой параметров; ошибки состояния запроса возникают, когда история заканчивается ходом модели или содержит заранее заполненные ходы модели. Правила ниже взяты из нативного руководства Google по Carbon, если не указано иное; для Carbon на AIHubMix сейчас задокументирован только Chat Completions. В описании Carbon на AIHubMix этот класс ошибок характеризуется одной строкой: «400 — ошибка параметра; большинство таких ошибок передаётся от вышестоящего провайдера». Это описание работы шлюза, а не результат тестирования. Подробности приведены в руководстве Google по Carbon и на странице нововведений.
| Причина | Что наблюдается | Исправление |
|---|---|---|
| max_output_tokens > 1M* | 400; превышен лимит | Нативный путь ≤1M; шлюз ≤65K* |
| frequency/presence penalty | 400; не поддерживается | Удалить поля |
| candidate_count > 1 | 400; несколько вариантов ответа | Не указывать или задать 1 |
| background без store* | 400; требуется store* | Добавить store=true |
| История заканчивается ходом модели | Отклонено; не поддерживается | Закончить ходом пользователя |
| Оба параметра управления | 400; нельзя использовать вместе | Передать один из них |
| thinking_budget или MINIMAL | 400; руководство по Carbon | Использовать low/medium/high |
Google приводит сообщение без изменений: «store=true is required for background interactions.» * Только для нативного Google: max_output_tokens ограничен 1M, а для фоновых запусков требуется store=true; на AIHubMix этот путь не задокументирован. В Chat Completions на AIHubMix используйте ≤65K.
У minimal два значения. В нативных полях Google Carbon использование thinking_budget и thinking_level=MINIMAL приводит к HTTP 400; используйте low, medium или high. В слое совместимости Google с OpenAI значение reasoning_effort=minimal преобразуется в low; AIHubMix не сообщал, применяется ли это преобразование к Carbon.
Обработка инструментов — связанная с этим ловушка. В руководстве Google по Carbon рекомендуется отдавать предпочтение последовательным ходам выполнения инструментов, а в руководстве AIHubMix по Gemini задокументировано tool_choice="auto"; поддержка инструментов Carbon на шлюзе пока не подтверждена.
Минимальный безопасный запрос к /v1/chat/completions не содержит параметров, которые Carbon игнорирует:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Если запрос возвращает 200, с транспортным уровнем всё в порядке. Остальное касается ответов, которые не вызывают ошибок.
Незаметные сбои: нет ошибки, но неверный вывод и счёт
Стандартный лимит вывода — 65,536; нативный режим длительной генерации — отдельный путь
Стандартный предел вывода Carbon — 65,536 токенов. Для Chat Completions поле ограничения — max_tokens; в нативных руководствах Google используется max_output_tokens. Нативный путь Google для длительной генерации позволяет получить до 1,048,576 токенов за вычетом входных; 131,072 и 262,144 — примеры таких значений. На странице нововведений Google сформулировано правило: «Если задать background: true, не указав max_output_tokens, сервер остановится после 64K токенов». Для Carbon на AIHubMix фоновые запуски и продолжение генерации не задокументированы.
В нативном для провайдера режиме длительная генерация выполняется сегментами: по 64K на этап при фоновой генерации или потоковой передаче и по 32K на этап без потоковой передачи; один REST-запрос без потоковой передачи останавливается после 32,768 токенов. В руководстве Google отмечено: «Более ранние версии SDK и слой совместимости с OpenAI не могут получать длинные завершения генерации с помощью токенов продолжения». Для AIHubMix в качестве консервативного, не проверенного на практике ограничения шлюза задавайте max_tokens не выше 65,536; не рассчитывайте объединять более длинные ответы, пока это не будет указано на странице модели.
Низкий лимит обрывает thinking mode, а пустой вывод всё равно оплачивается
Лимит распространяется не только на текст, но и на thinking mode. В руководстве Google по длительной генерации сказано: «Низкое значение, например 8,192, останавливает модель до того, как она закончит thinking mode». Статус становится incomplete, а «текст может быть пустым, если модель всё ещё находилась в режиме thinking». В любом случае запрос оплачивается. Закладывайте бюджет и на thinking mode, и на ответ; пустой ответ со статусом incomplete считайте проблемой лимита: увеличьте его, повторите запрос и учтите, что первая попытка тоже попадёт в счёт.
По умолчанию уровень thinking mode — medium
В Carbon по умолчанию используется medium, как и в Argon. Команды, перешедшие с Gemini 3.1 Pro Preview, где по умолчанию задано high, без изменения кода теряют один уровень и могут принять более поверхностный ответ за регрессию. Google рекомендует medium для большинства задач программирования и работы с агентами. Явно задайте уровень в тестовой среде и передавайте только один управляющий параметр: reasoning_effort и thinking_level нельзя использовать вместе.
Параметры семплирования игнорируются
temperature, top_p и top_k игнорируются: ошибки нет, результаты семплирования не меняются. Удалите эти параметры. Штрафы и значения candidate_count выше 1 приводят к ответу 400.
Явное кэширование больше не поддерживается
cachedContents и caches.create не поддерживаются. Неявное кэширование применяется начиная с 4,096 токенов и даёт скидку 95%. Удалите код для явного кэширования, разместите стабильный префикс промпта в начале и перед расчётом скидки проверьте использование кэшированных токенов.
У состояния диалога есть ограничение
Google рекомендует использовать previous_interaction_id для продолжения. В Chat Completions такого поля нет, поэтому сохраняйте историю, но завершайте её ходом пользователя: завершение ходом модели или заранее заполненный ход модели не поддерживаются.
Тайм-ауты: 15–20 минут, а не 60 секунд
В руководстве Google по длительной генерации рекомендуется устанавливать тайм-аут чтения HTTP в 15–20 минут для каждого потока; в контрольном списке миграции повторяется требование о минимуме в 15 минут. Эта рекомендация относится к запросам длительной генерации. Отдельное измерение AA показывает время ожидания первого токена ответа: для Carbon High оно составило 67.1 секунды, Medium — 23.2, Low — 12.9, а для Argon High — 40.1. Успеет ли вообще прийти первый токен при ограничении в 60 секунд?
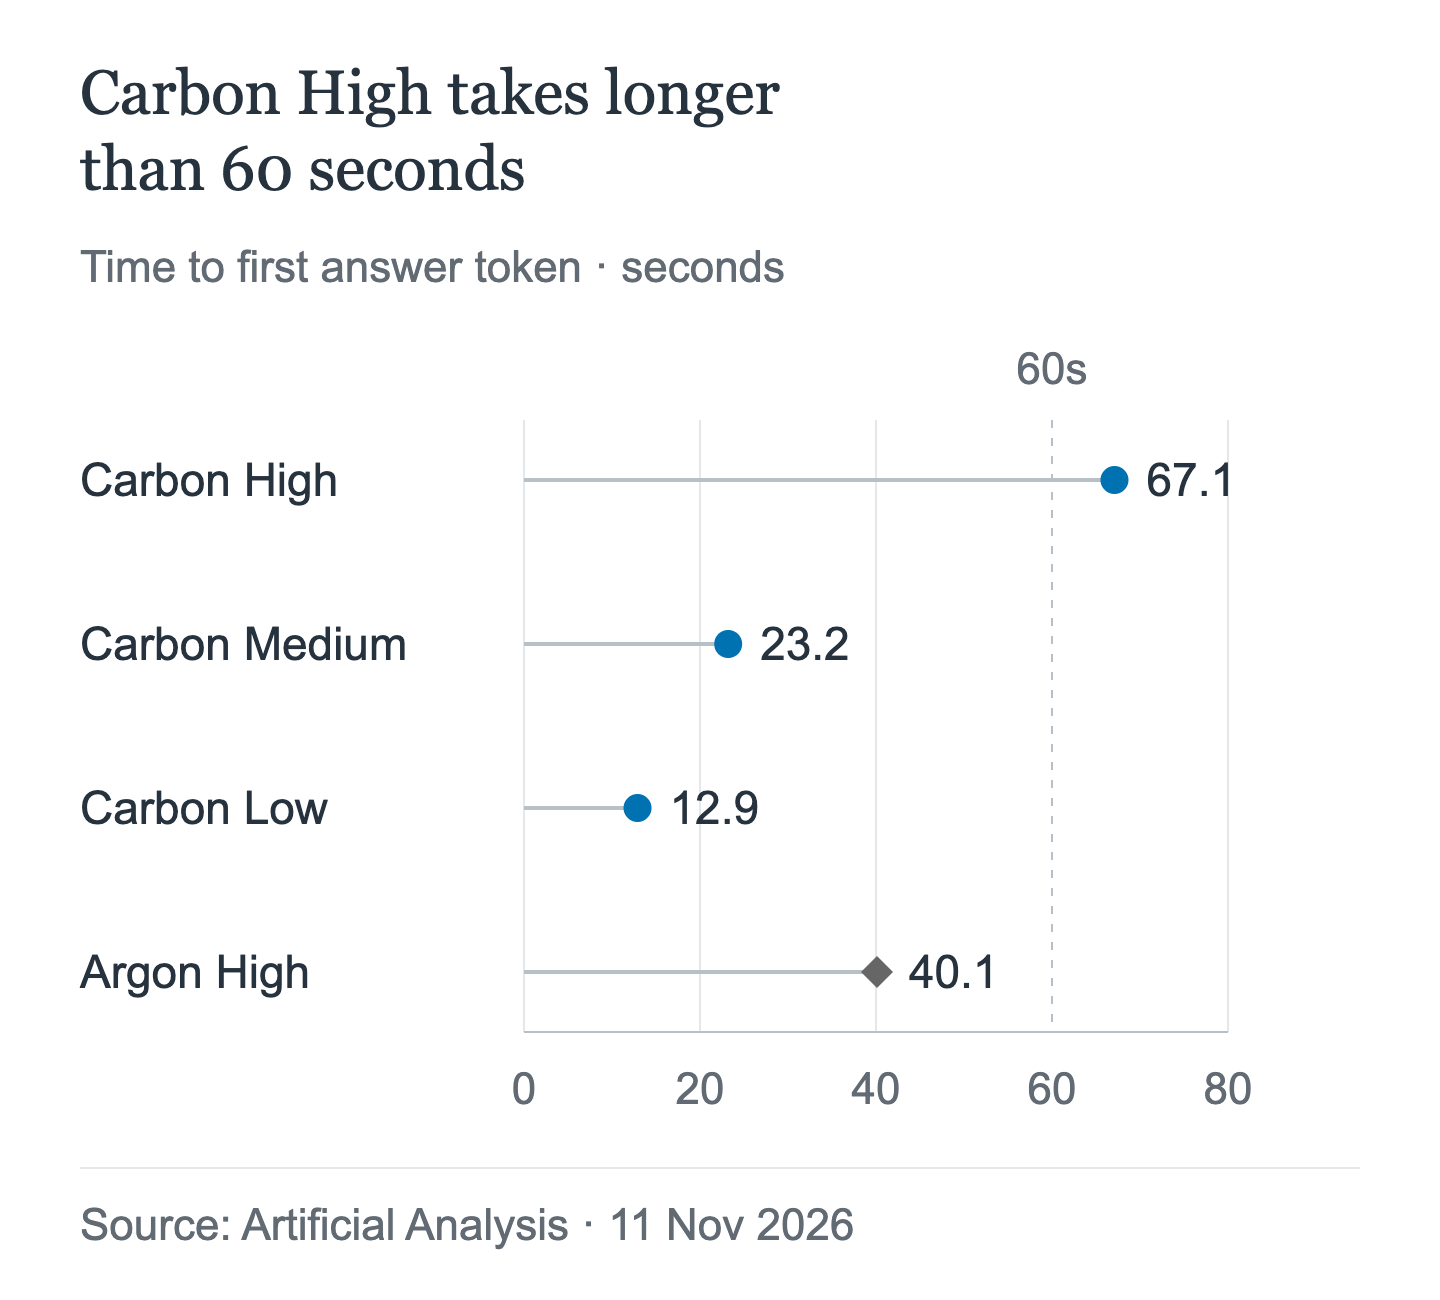
В этом измерении Carbon High превысил ориентир в 60 секунд. Время до первого токена не позволяет определить безопасный тайм-аут для всего запроса: рекомендация выше — 15–20 минут — взята из руководства Google по длительной генерации. Это результаты одного замера, а не гарантия задержки и не тест AIHubMix.
Для отдельных вызовов нативного клиента Google установлены более жёсткие ограничения, чем для фоновых запусков: 20 минут для потока, 10 минут для вызова без потоковой передачи и 24 часа для фонового запуска. AIHubMix не документирует эти ограничения для фоновых запусков.
Минимальные версии нативных SDK для длительной генерации: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. В Claude Code параметр API_TIMEOUT_MS по умолчанию равен 10 минутам; если позднее подтвердится возможность использовать Carbon через Claude Code, увеличьте это значение до первого запуска.
Ловушки при оплате
Цена Carbon за токен проста, а счёт — нет. Несколько механизмов увеличивают сумму, и одно запланированное изменение удваивает все тарифы.
Thinking mode оплачивается как вывод
Токены thinking mode оплачиваются по тарифу на вывод. Сейчас цена вывода Carbon — $10 за миллион токенов, а с 1 декабря она составит $20.
Оплачивается каждый этап длительной генерации
Пример из Google: для промпта из 1,000 токенов, генерирующего 200,000 выходных токенов, показатель total_input_tokens равен 397,216 с учётом этапов по 1,000, 66,536, 132,072 и 197,608 токенов. «Оплачивается каждый токен на каждом этапе, в том числе на этапах, которые содержат только thinking mode». Неявное кэширование даёт скидку 95% на большую часть входных токенов, но этапы всё равно учитываются в статистике использования. Оплачивается и уже выполненная работа, даже если запуск завершился ошибкой или был отменён: «Завершённые сегменты тарифицируются в конце каждого сегмента, даже если более поздний сегмент завершается ошибкой или отменяется», а также «Вы оплачиваете всю работу, выполненную до завершения взаимодействия».
Для заземления предусмотрен отдельный счётчик
В нативном сервисе Google заземление с помощью Google Search включает 5,000 бесплатных запросов в месяц, общих для Gemini 3 и новее; далее взимается $14 за 1,000 запросов, не более 1,500 в день. На AIHubMix заземление для Carbon не задокументировано.
Примечание о Vertex касается только провайдера
На странице цен Google Vertex приведено дополнительное правило: запросы с генерацией свыше 32K токенов оплачиваются по использованию токенов, доступных для получения, даже если запрос завершается из-за тайм-аута на стороне клиента или сервера; правило действует с 13 ноября 2026 года. Это правило провайдера; информация о том, применяется ли оно к провайдеру VertexAI на AIHubMix, не опубликована. Уточните это заранее.
С 1 декабря все тарифы удваиваются
| Тариф | До 30 ноября | С 1 декабря |
|---|---|---|
| Входные токены | $2 за 1M | $4 за 1M |
| Выходные токены | $10 за 1M | $20 за 1M |
| Чтение из кэша | $0.10 за 1M | $0.20 за 1M |
Для Carbon и Argon действуют одинаковые начальные тарифы; 1 декабря все они удваиваются. Сейчас на AIHubMix указаны начальные тарифы, а цены после декабря не опубликованы. Считайте удвоение гарантированным, а будущие цены шлюза — неизвестными; прежде чем утверждать бюджет, проверьте и то и другое.
Агенты с реальными разрешениями
Для вызовов через нативный API Google в руководстве Carbon рекомендуется выполнять вызовы инструментов последовательно. При использовании этого способа отправляйте по одному вызову за раз. В руководстве AIHubMix по Gemini описан параметр tool_choice="auto", но поддержка инструментов и принудительный выбор инструмента для Carbon через шлюз не подтверждены.
История не должна заканчиваться ходом модели; также не поддерживаются предварительно заполненные ходы модели. Если результата инструмента нет, отправьте ход пользователя с запросом о следующем шаге.
В карточке модели указаны периодические замедления или тайм-ауты, а также повышенный расход токенов на высоких уровнях; дата отсечения знаний — March 2026. При наличии доступа на запись тайм-аут представляет реальный риск: если выполнение превысит лимит клиента, после него могут остаться частично выполненные изменения, а завершённые сегменты всё равно будут тарифицироваться.
Инструменты для программирования: прежде чем что-либо настраивать, проверьте страницу модели
В листинге Carbon на AIHubMix документирован только Chat Completions, а Carbon пока отсутствует в публичном индексе моделей. Для Claude Code нужен Anthropic Messages, для Codex — Responses. Поддержка ни одного из этих протоколов для Carbon на AIHubMix не подтверждена. Не рассчитывайте, что они будут работать: откройте страницу модели Carbon по ссылке выше и проверьте список протоколов. Если там указан только Chat Completions, используйте совместимый с OpenAI клиент или подождите.
Формат запроса такой же, как у Argon, но доступность протоколов различается: сейчас для Carbon на AIHubMix документирован только Chat Completions. В публикации о Claude Code описаны ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN и API_TIMEOUT_MS; в публикации о Codex — блок провайдера, wire_api и model_reasoning_effort. Разница в том, доступен ли соответствующий протокол.
| Клиент | Требуемый протокол | Carbon на AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Не документирован |
| Codex | Responses API | Не документирован |
| OpenAI SDK | Chat Completions | Документирован |
Настройки:
- ID модели:
gemini-4-carbon. - Thinking: low, medium, high; по умолчанию — medium.
- Сопоставление уровней: нативное поле
thinking_level, поле совместимостиreasoning_effort; Google сопоставляет значения effort, но AIHubMix не опубликовал правила сопоставления для Carbon. Передайте одно из них. - Контекст: 1,048,576 у Google; AIHubMix не публиковал лимит для Carbon, поэтому не ориентируйтесь на показатель провайдера.
- Известные проблемы: медленное получение первого токена при высоком уровне, рекомендация провайдера выполнять вызовы инструментов последовательно, консервативный неподтверждённый лимит AIHubMix в 65,536 выходных токенов и дата отсечения — March 2026.
Быстрый тест, 10–15 минут:
- Выберите небольшой репозиторий с одним неудачным модульным тестом и командой запуска тестов, которая выполняется менее чем за минуту.
- Установите модель
gemini-4-carbon, задайте дляmax_tokensзначение 65,536 или меньше, а для HTTP-тайм-аута — не менее 15 минут. - Попросите инструмент внести минимальное изменение, необходимое для успешного прохождения теста, затем запустите команду тестирования и проверьте diff.
- Успех: изменение минимально, тест проходит за 10–15 минут. Неудача: зафиксируйте, что именно произошло — ошибка 400, неполный ответ, тайм-аут или некорректное изменение; для каждого случая выше указан свой способ исправления.
- Если инструмент позволяет задавать уровень, проверьте medium и high и оставьте тот, при котором выполнение укладывается в отведённое время.
Проверьте перед первым запросом в production
- Указан ID модели
gemini-4-carbon. - Нет параметров
temperature,top_pилиtop_k. - Нет параметров
frequency_penaltyилиpresence_penalty; оставьтеcandidate_countравным 1 или не указывайте его. max_tokensзадано как 65,536 или меньше.- Для фоновых запросов через нативный API Google задайте
store=trueи явно укажитеmax_output_tokens; AIHubMix не документировал этот режим. - HTTP-тайм-аут — не менее 15 минут; предпочтительна потоковая передача.
- Используется только один из параметров:
reasoning_effortилиthinking_level. - При работе через нативный API Google предпочтительны последовательные ходы с вызовами инструментов; AIHubMix документирует
tool_choice="auto", но поддержка Carbon не подтверждена. - Не вызывайте кэш явно; сначала передавайте стабильный префикс промпта.
- В бюджет заложены токены thinking и каждый этап длительной генерации.
- Тарифы на December 1 проверены с ответственным за бюджет.
- Перед настройкой совместимость инструмента для программирования проверена на странице модели.
Часто задаваемые вопросы
Нужно ли менять тело запроса при переходе с Argon на Carbon?
Нет. Схема не изменилась. Поменяйте ID модели, проверьте значения и удалите поля, которые теперь вызывают ошибку 400.
Почему max_output_tokens вызывает ошибку 400?
Нативный API Google для Carbon отклоняет значения выше 1,048,576. Для пути Chat Completions на AIHubMix есть отдельная консервативная рекомендация: пока не документирован путь с большим лимитом, задавайте max_tokens не выше 65,536. Низкое значение вместо этого обрезает thinking, что хуже: ответ может оказаться неполным, но его всё равно тарифицируют.
Почему ответ пустой?
Если статус указывает на незавершённый ответ, текст может быть пустым, потому что модель всё ещё обрабатывала запрос. Работа тарифицируется. Увеличьте лимит и повторите запрос.
Почему фоновый запрос останавливается на 64K?
В нативном фоновом режиме Google сервер останавливается на 64K, если не указать max_output_tokens. Задайте лимит явно: нативная длительная генерация может достигать 1,048,576 за вычетом входных данных. AIHubMix не документировал фоновый режим.
Учитывается ли temperature?
Нет. Параметры temperature, top_p и top_k игнорируются. Параметры штрафов и значения candidate_count выше 1 вместо этого вызывают ошибку 400.
Удвоится ли стоимость Carbon на December 1?
Тарифы Google удваиваются: входные токены — с $2 до $4, выходные — с $10 до $20, чтение из кэша — с $0.10 до $0.20. AIHubMix не публиковал цены после December, поэтому уточните стоимость, прежде чем утверждать бюджет.
Можно ли использовать Claude Code или Codex с Carbon?
Это не подтверждено. Для Carbon на AIHubMix документирован Chat Completions; Claude Code требует Anthropic Messages, а Codex — Responses. Сначала проверьте страницу модели.
Читайте дальше: серия Gemini 4 Carbon
- Если миграция уже идёт и остаётся понять, оправдывает ли Carbon свою цену, в сравнении рядом указаны одинаковые вступительные тарифы.
Gemini 4 Carbon против Argon: одинаковая цена — когда Carbon того стоит? - Если вы выбираете агента для программирования, а не переносите эндпоинт, в сравнении рассматриваются использование инструментов и стоимость одной задачи.
Gemini 4 Carbon против Fable 5.2: что выбрать для агентного программирования?