

3–4 ноября 2026 года набор APB Full проверял DeepSeek V4.1 Flash 1017 через AIHubMix у пяти провайдеров. Для каждого провайдера использовались одни и те же вопросы, параметры и скрипты запросов; пять записей о провайдерах опубликованы на странице моделей. Этот профиль APB охватывает только официальный канал DeepSeek. Запросы направлялись через маршрут официального поставщика DeepSeek в AIHubMix, а не напрямую к API DeepSeek.
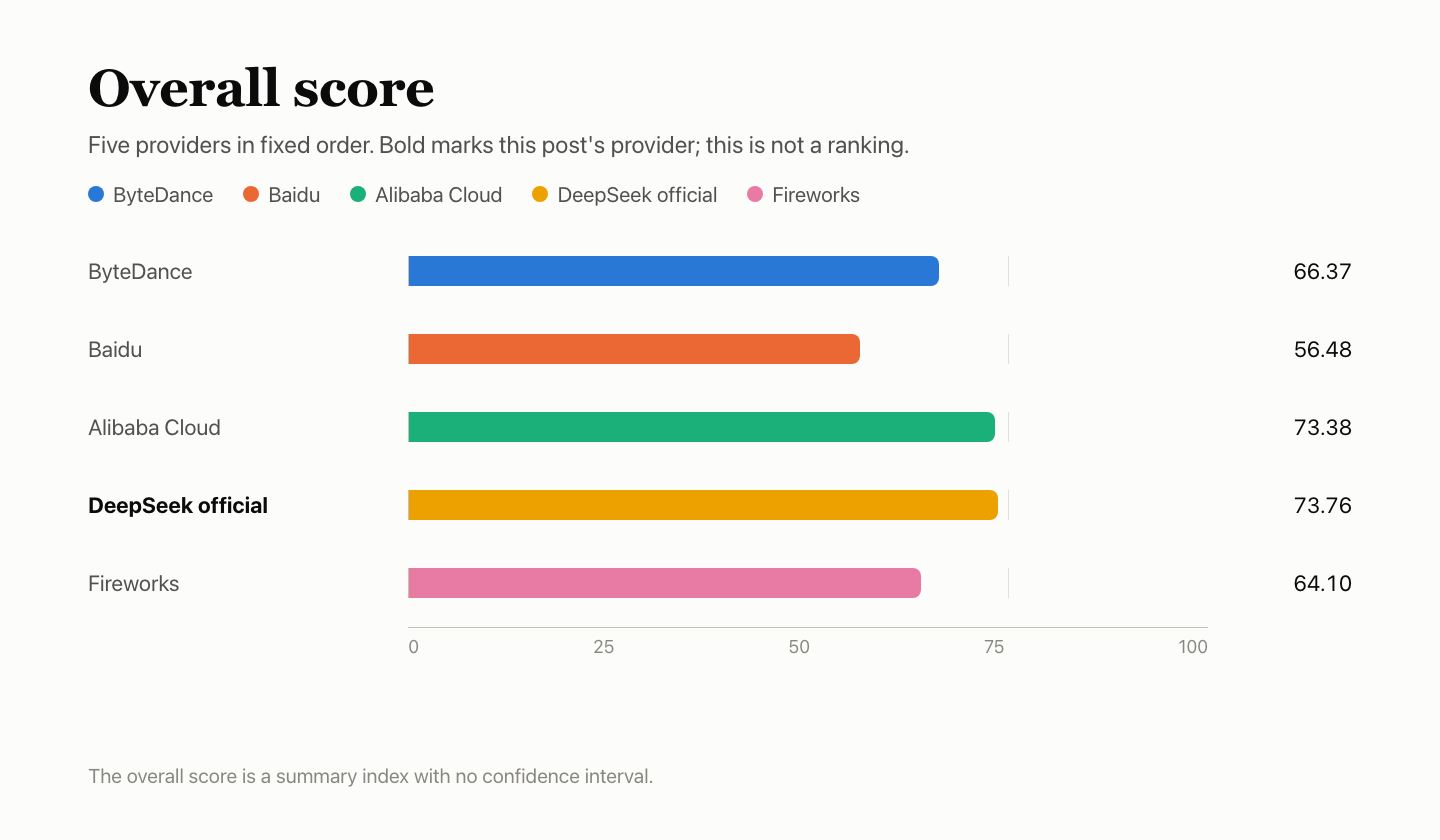
В этой публикации приводятся только оценки; провайдеры не ранжируются и ни один из них не рекомендуется: Q 42.45, F 94.00, P 86.14, K 98.38 и R 100. Q, F, P и R — оценки четырёх разделов; K — подоценка P. Общая оценка 73.76 — сводный индекс, а не сертификация; для неё не указан доверительный интервал. Стандарт оценки — AIHubMix Provider Benchmark Standard v2.0.
Оценки пяти провайдеров
Жирным выделен провайдер, которому посвящена эта публикация. Провайдеры перечислены в фиксированном порядке, не по рейтингу. K — подоценка P с весом 20%; она приведена отдельно для справки. Общая оценка — сводный индекс без доверительного интервала. Официальный канал DeepSeek и Alibaba Cloud различаются по общей оценке на 0.37, и это различие не позволяет их разделить.
Краткий обзор
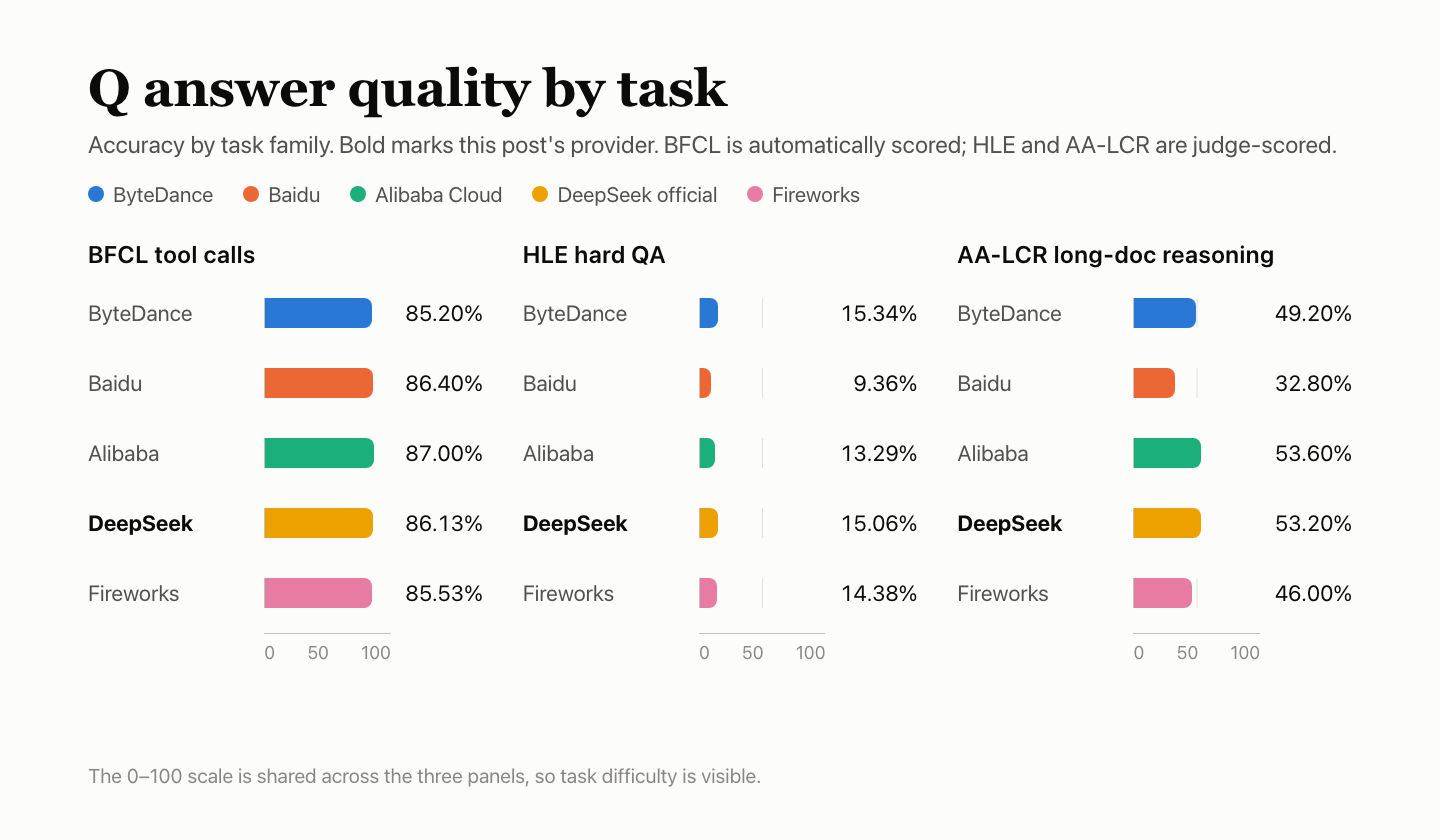
- Качество ответов: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Семь ответов HLE были усечены по лимиту max_tokens и засчитаны как неправильные. Этот канал служит базовым уровнем Q для сравнения с остальными четырьмя.
- Поддержка функций: F 94.00. Пройдено 137 из 147 учитываемых проверок. Ещё 27 проверок, зависящих от точного количества токенов, признаны недействительными и исключены из знаменателя.
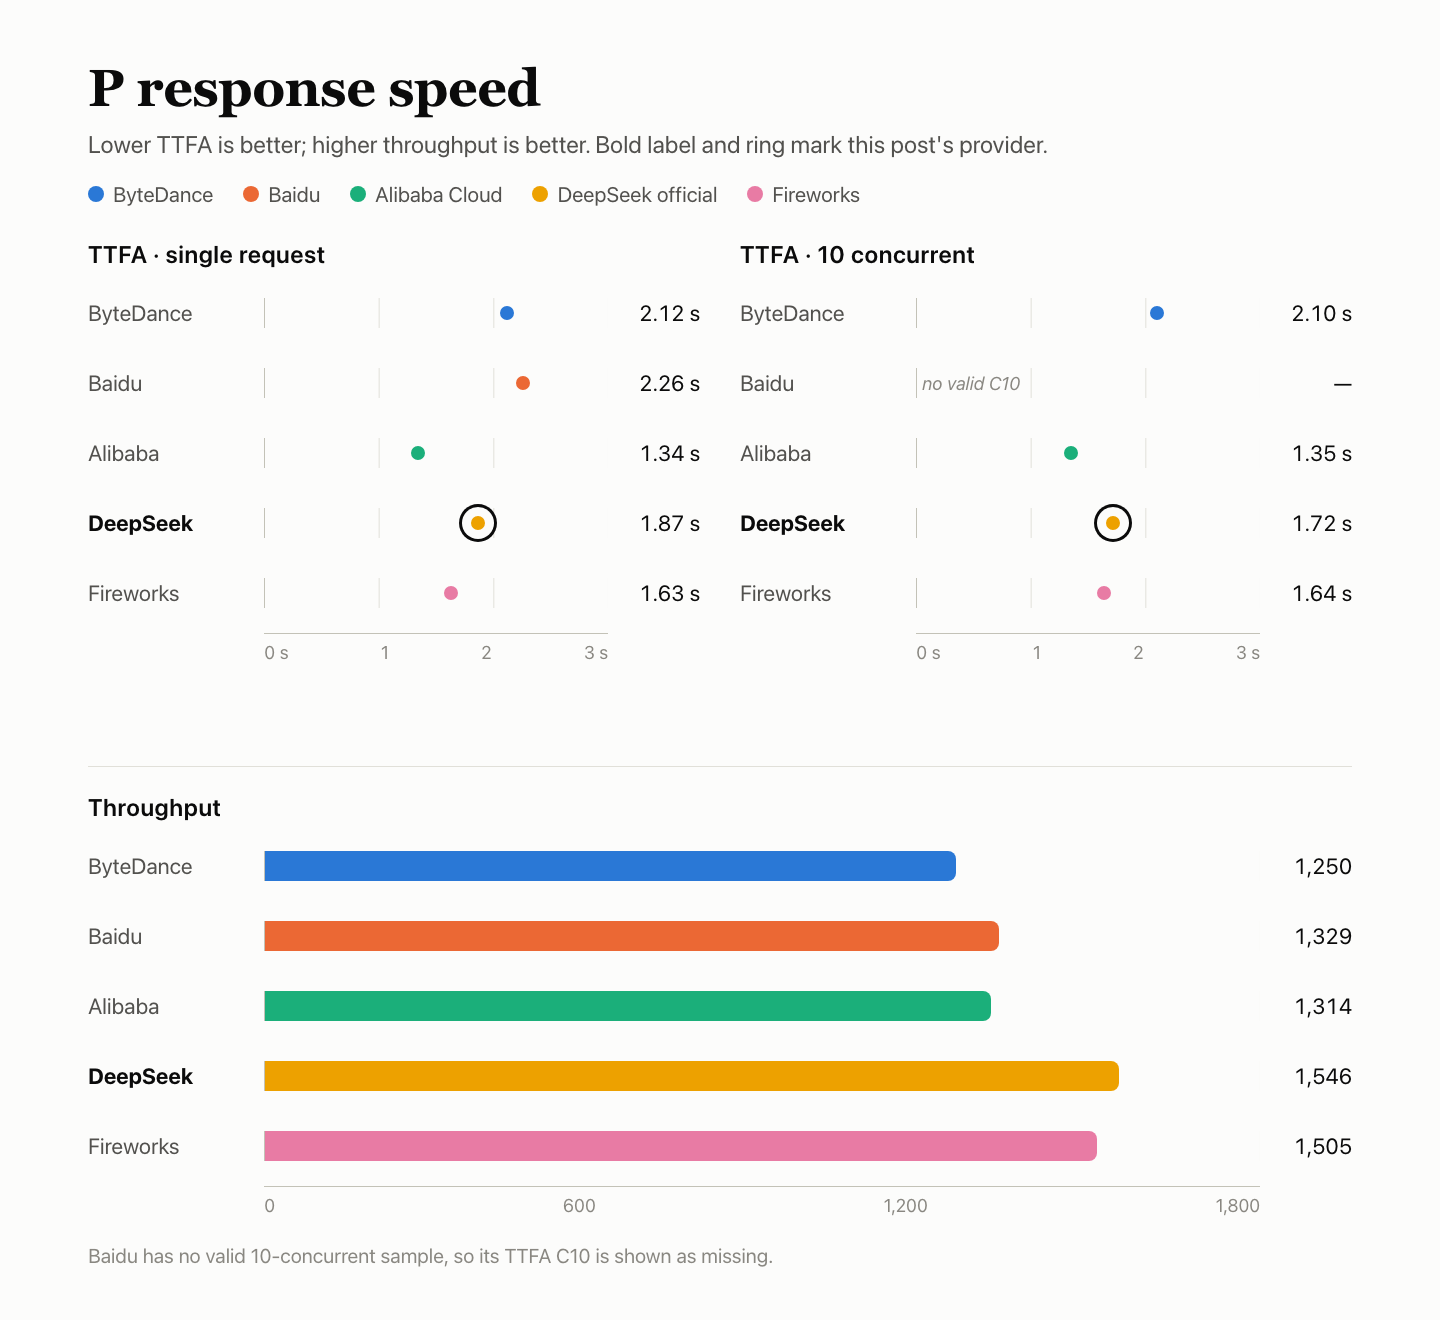
- Скорость ответа: P 86.14. В первом окне с одним параллельным запросом 15 из 30 запросов оказались недействительными (12 × 503, 2 × deadline, 1 × read timeout) и учитывались как бесконечное время; медиана времени до первого токена — 1.87 s (1.72 s только для действительных запросов); при параллелизме 10 — 1.72 s; TPOT — 2.84 ms.
- Кэш: K 98.38. Все 18 запросов с попаданием в кэш на префиксах 8k и 32k дали попадание; контрольные запросы без прогрева кэша его не использовали.
- Стабильность сервиса: R 100. Все 300 выделенных запросов успешно завершились с первой попытки.
Настройки тестирования
Запросы проходили через AIHubMix с выбором маршрута официального поставщика DeepSeek; в кратком руководстве описана настройка доступа.
| Параметр | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | deepseek-flash |
| Возвращённое имя модели | deepseek-flash |
| Маршрут доступа | Маршрут официального поставщика DeepSeek в AIHubMix; не прямое подключение к API DeepSeek |
| Параметры | Режим без thinking, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, автоматические повторы отключены |
| Thinking выключен | Во всех запросах использовался reasoning_effort=none |
| Время | 2026-11-03 18:07 – 11-04 16:33 UTC+8; пять провайдеров использовали один Mac mini, сеть и аккаунт |
| Выборки | Качество ответов: 4,250 попыток (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); проверки функций: 60 × 3 окна; скорость: 90 при одном параллельном запросе и 90 при параллелизме 10; стабильность: 300; кэш: 30 (по три группы для префиксов 8k и 32k) |
Q — качество ответов: 42.45
Набор включает 500 вопросов BFCL × 3 запуска, 250 вопросов HLE × 10 и 25 вопросов AA-LCR × 10. Оценка BFCL выполняется автоматически по правилам; для HLE и AA-LCR используется модель-судья deepseek-flash. Все пять провайдеров отвечали на одни и те же вопросы. Десять ответов не удалось оценить, поэтому их исключили; осталось 4,240 оценённых попыток.
| Бенчмарк | Вопросы | Правильные ответы | Точность | Ошибки |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| Сложные вопросы HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Итого · 95% ДИ 40.08%–44.73% | 4,240 оценённых | 1,800/4,240 | 42.45% | 7 |
Сбои сервиса — неудачный запрос или усечённый вывод — остаются в знаменателе и засчитываются как неправильные ответы. В данном случае это семь ответов HLE, достигших лимита max_tokens. Оценка BFCL выполняется автоматически, а HLE и AA-LCR оценивает модель-судья.
Знаменатели BFCL — это суммарные значения для трёх запусков.
| Категория BFCL | Пройдено | Доля прохождения |
|---|---|---|
| simple_python — одна функция, правильный вызов и аргументы | 334/360 | 92.78% |
| multiple — выбрать нужную функцию из нескольких | 268/300 | 89.33% |
| parallel — несколько раз параллельно вызвать одну и ту же функцию | 271/300 | 90.33% |
| parallel_multiple — параллельно вызвать несколько разных функций | 207/240 | 86.25% |
| irrelevance — ни одна функция не подходит, вызывать ничего не нужно | 113/150 | 75.33% |
| ahm_multi_turn — цепочка вызовов инструментов из трёх этапов | 99/150 | 66.00% |
Сравнение с остальными четырьмя
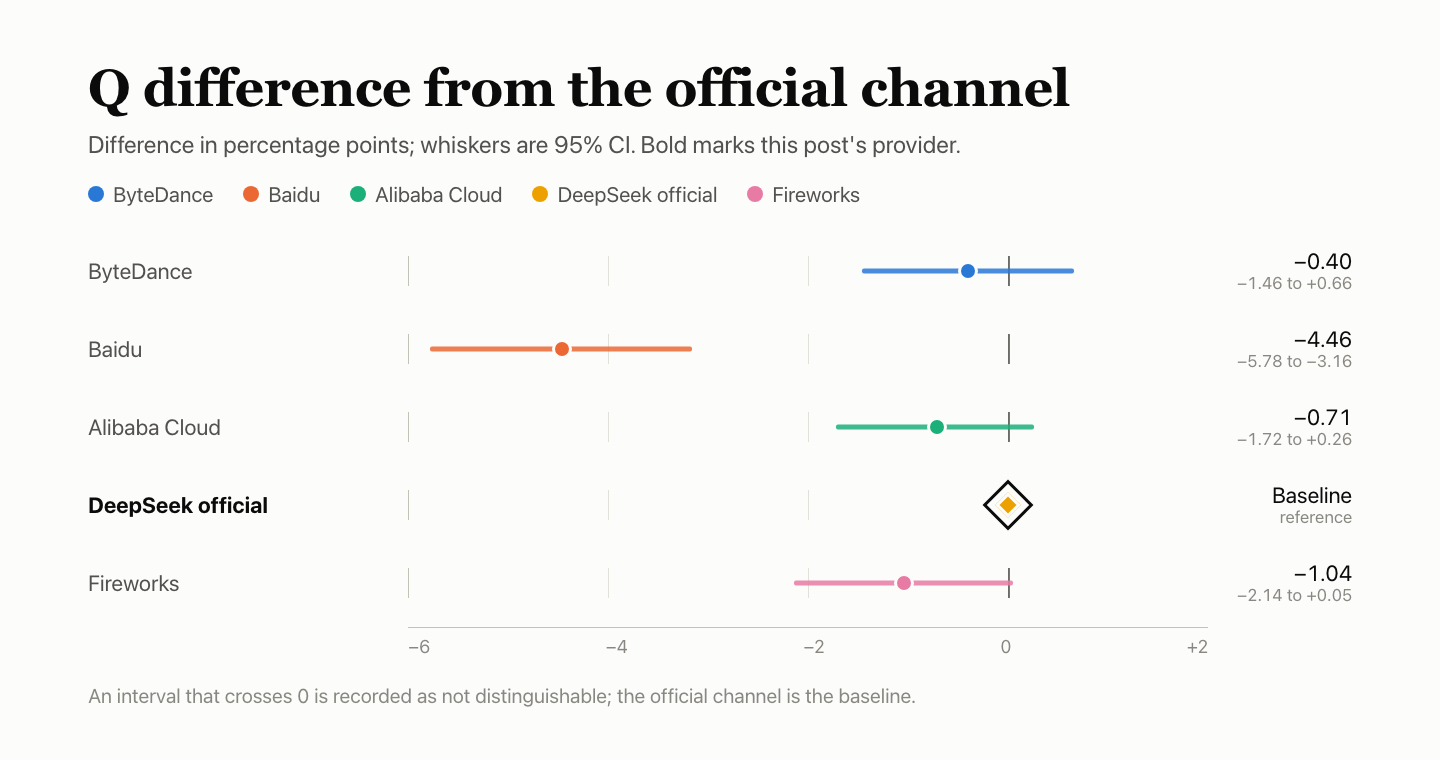
Каждое различие указано в процентных пунктах относительно этого базового уровня; интервалы 95% показаны усами. Если интервал пересекает 0, различие не позволяет разделить результаты. Модель-судья относится к тому же семейству DeepSeek, что и тестируемая модель, и не калибровалась, поэтому оценки HLE и AA-LCR могут быть мягкими.
F — поддержка функций: 94.00
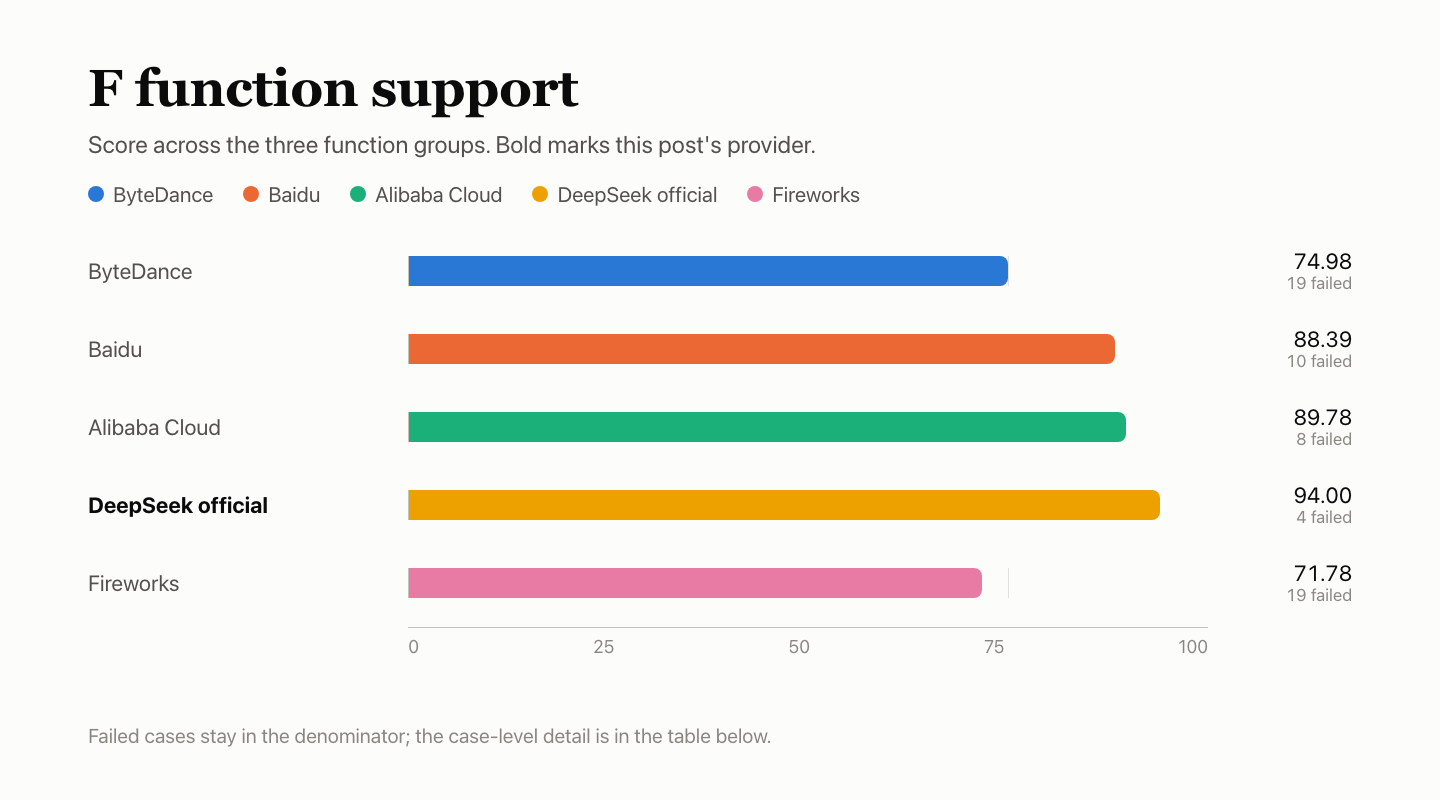
Проверки функций оценивают поведение протокола, а не качество ответов. В каждом из трёх окон запускалось по 60 случаев из шести групп — всего 180 проверок, оцениваемых по формату, указанному в документации каждого провайдера. Неприменимые, недействительные и ненаблюдавшиеся проверки исключаются из знаменателя. Этот канал прошёл 137 из 147 учитываемых проверок и получил взвешенную оценку 94.00; это не простое отношение 137/147.
| Группа | Вес | Пройдено | Исключено | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и протокол сообщений | 20% | 27/27 | 3 | 100.00 |
| Интерфейс инструментов | 20% | 30/30 | — | 100.00 |
| Ограничения вывода и параметры | 20% | 30/30 | — | 100.00 |
| Контекст и состояние | 15% | 14/15 | 15 | 93.33 |
| Ошибки и восстановление | 15% | 24/30 | — | 80.00 |
| Учёт использования и протокол кэширования | 10% | 12/15 | 15 | 80.00 |
| Итого · взвешенная оценка | — | 137/147 | 33 | 94.00 |
Взвешенная оценка учитывает веса групп; это не отношение числа пройденных проверок к 147.
| Не пройденный случай | Окна с ошибкой | Причина |
|---|---|---|
| Некорректные сообщения (Ошибки и восстановление) | 3/3 | Возвращён код 400, но тело ответа пустое, без структурированного описания ошибки |
| Некорректный stream_options (Ошибки и восстановление) | 3/3 | Возвращён код 400, но тело ответа пустое, без структурированного описания ошибки |
| Учёт токенов thinking mode (Учёт использования и протокол кэширования) | 3/3 | Количество токенов thinking mode не возвращено |
| Изоляция запросов (Контекст и состояние) | 1/3 | На первом шаге в ответе не было только STORED, как требовалось, поэтому проверку изоляции продолжить не удалось |
Исключённые проверки не засчитываются ни как пройденные, ни как проваленные.
| Статус | Случай | Количество | Причина |
|---|---|---|---|
| Не наблюдался | Последовательность остановки потоковой передачи | 3 | Запрос для этого шага не был отправлен после предыдущего шага, поэтому оценить его не удалось |
| Недействительно | Длинный ввод 10k; в пределах лимита контекста; длинный ввод 32k; длинный ввод 100k; превышение контекста; подсчёт токенов нативного формата; инструменты учитываются во входных данных; согласованность подсчёта входных данных до и после кэширования; согласованность входных данных в потоковом и непотоковом режимах | 27 | Шаблон подсчёта токенов нативного формата, зафиксированный на стороне теста, не соответствовал данным об использовании, возвращённым этим каналом, поэтому проверки, зависящие от точных подсчётов, признали недействительными и исключили из знаменателя |
| Неприменимо | Явный cache_control | 3 | Заранее отмечено как неподдерживаемое этим интерфейсом |
27 недействительных проверок — это случаи с длинным вводом, лимитом контекста, подсчётом токенов нативного формата и согласованностью кэша из списка. Поскольку зафиксированный шаблон не соответствовал данным об использовании, возвращённым этим каналом, все проверки, зависевшие от точного подсчёта, исключили, а не оценивали.
Два случая завершились ошибкой у всех пяти провайдеров: некорректные messages и некорректный stream_options. В обоих случаях вернулся код 400 с пустым телом, поэтому клиент не получил структурированного описания ошибки. Общая закономерность указывает скорее на уровень шлюза AIHubMix, который требует отдельного расследования. Учёт токенов thinking mode также дал сбой у всех пяти провайдеров, но по другим причинам: ByteDance и Fireworks продолжали сообщать о токенах thinking mode после его отключения, тогда как остальные три не возвращали их количество.
Сравнение с остальными четырьмя
P — скорость ответа: 86.14
Каждый запрос содержал около 10,000 входных токенов и запрашивал около 1,100 выходных токенов. В каждом из трёх окон отправляли 30 запросов с одним параллельным запросом и 30 при параллелизме 10 — всего 180.
| Метрика | Значение |
|---|---|
| TTFA до первого токена | Один параллельный запрос: медиана 1.87 s (1.72 s для действительных запросов). Параллелизм 10: медиана 1.72 s |
| TPOT | Один параллельный запрос: 2.84 ms/токен. Параллелизм 10: 2.67 ms/токен |
| Пропускная способность успешных запросов (goodput) | Параллелизм 10: 1,546.0 token/s |
| Действительные запросы | Один параллельный запрос: 75/90 (окно 1: 15/30); параллелизм 10: 90/90. Недействительные: 12 × 503 service_unavailable_error, 2 × deadline reached, 1 × read timeout |
| Оценки компонентов | TTFA 51.65, TPOT 100.00, пропускная способность 100.00; для TTFA и TPOT берётся меньшее значение из двух уровней, веса — 35% / 35% / 30%; оценка скорости ответа — 83.08 |
| Состав P | Оценка скорости ответа 83.08 с весом 80%, кэш K 98.38 с весом 20%; P 86.14 |
Все 15 недействительных запросов пришлись на первое окно с одним параллельным запросом: 12 вернули код 503, 2 превысили дедлайн, а 1 завершился тайм-аутом чтения. Недействительные запросы учитываются как бесконечное время, поэтому заявленная медиана составляет 1.87 s. Только для действительных запросов медиана — 1.72 s. При параллелизме 10 медиана также составляет 1.72 s. TPOT равен 2.84 ms/токен при одном параллельном запросе и 2.67 ms/токен при параллелизме 10.
Сравнение с остальными четырьмя
Пять провайдеров использовали один Mac mini, сеть и аккаунт. Три окна проводились последовательно для каждого провайдера, поэтому периоды сбора данных совпадают не полностью; небольшие расхождения не следует переоценивать.
K — кэш: 98.38
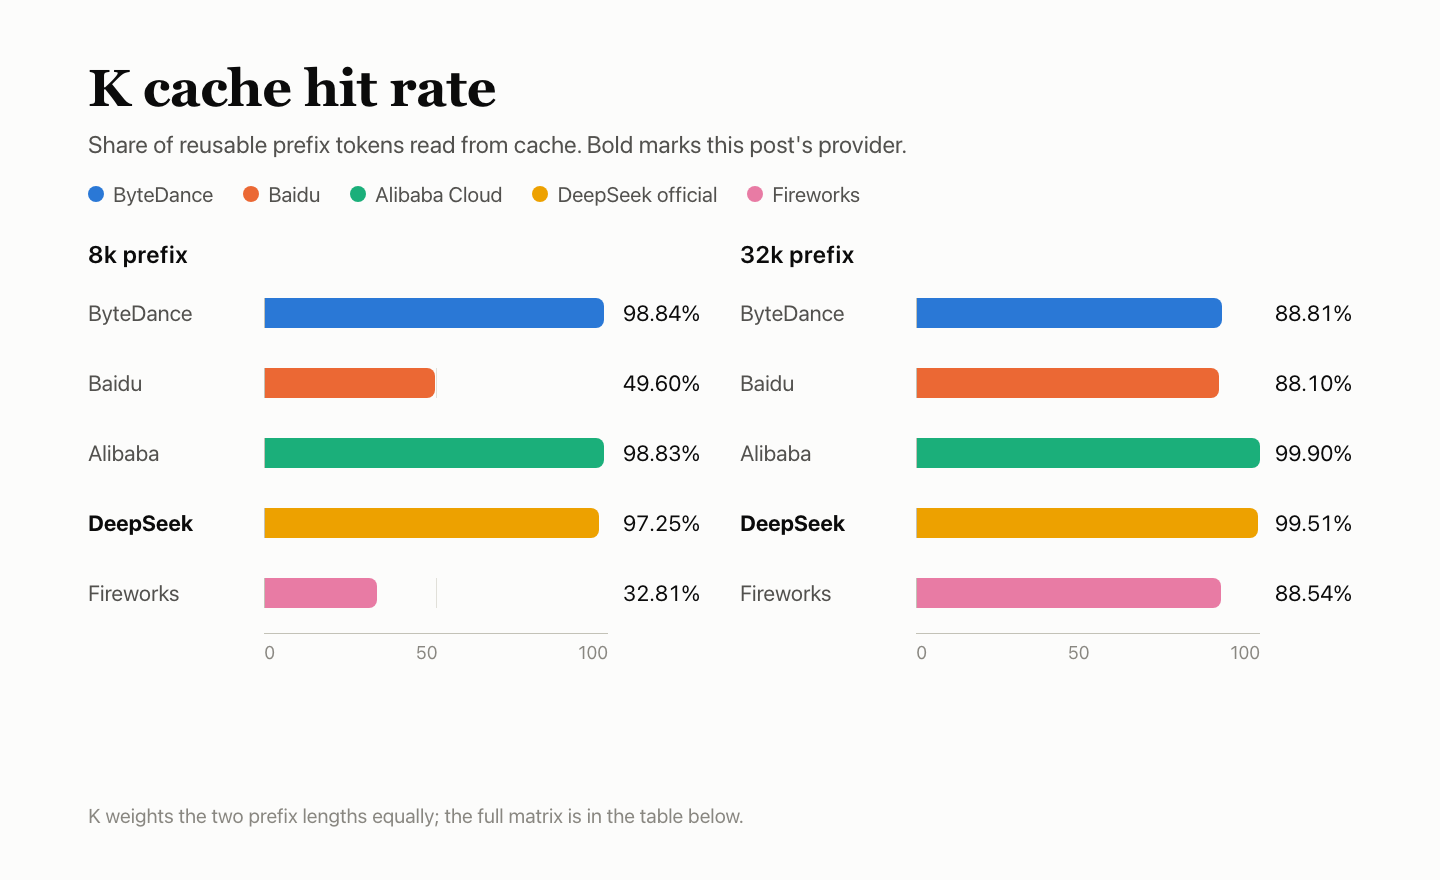
В каждой группе отправляется пять запросов. Первый задаёт фиксированный префикс 8k или 32k. В запросах со второго по четвёртый префикс сохраняется, а меняется только заключительный вопрос; их отправляют через 5, 30 и 120 секунд. В пятом запросе используется новый префикс в качестве контрольного без прогрева кэша. Три окна × два размера дают 30 запросов. K — отношение количества токенов кэша, считанных в запросах с попаданием, к количеству токенов, которые должны повторно использоваться; на каждый размер приходится половина веса. K составляет 20% от P. Кэширование контекста описано в документации API DeepSeek.
| Префикс | Окно | Начальный запрос | +5 s | +30 s | +120 s | Контрольный запрос без прогрева кэша |
|---|---|---|---|---|---|---|
| 8k | Окно 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Окно 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Окно 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Окно 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Окно 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Окно 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Для запросов с попаданием в кэш на префиксе 8k засчитано 9 попаданий из 9; каждый запрос считал 7,808 токенов: всего считано 70,272 при 72,261 токене, доступном для повторного использования, — 97.25. Для префикса 32k засчитано 9 попаданий из 9; каждый запрос считал 31,872 токена: всего 286,848 при 288,270 доступных для повторного использования — 99.51. Контрольные запросы не считывали кэш. K для обоих размеров составляет 98.38.
Сравнение с остальными четырьмя
R — стабильность сервиса: 100
300 запросов охватывают короткий текст, длинный ввод 10k, вызовы инструментов и историю диалога из нескольких ходов; запросы отправляются с одним параллельным запросом в каждом из трёх окон. Проверяется только успешность и полнота с первой попытки, а не правильность ответа; повторов нет. Сбои, уже учтённые при оценке качества ответов и скорости, в R повторно не засчитываются.
| Тип запроса | Успешно с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод 10k | 90/90 |
| Вызовы инструментов | 60/60 |
| История диалога из нескольких ходов | 30/30 |
| Итого · 95% ДИ 98.78%–100% | 300/300 |
Все 300 запросов с первой попытки получили корректный и полный ответ. Показатель R 100 охватывает только эти 300 специальных запросов; это не означает, что на всём маршруте не было сбоев. При 300 успешных запросах нижняя граница 95%-го доверительного интервала составляет 98.78%, то есть данные позволяют предположить, что доля сбоев ниже 1.22%.
Сравнение с остальными четырьмя
Показатель R охватывает только 300 специальных запросов; сбои в качестве ответов и скорости фиксируются в Q и P, а не учитываются повторно в R.
| Провайдер | Успешное выполнение с первой попытки | 95%-й ДИ |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Официальный канал DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часто задаваемые вопросы
Это прямое подключение к API DeepSeek?
Нет. Запросы проходят через маршрут официального поставщика DeepSeek на AIHubMix; напрямую в API DeepSeek они не отправляются.
Почему официальный канал DeepSeek используется как базовый уровень Q?
Это официальный канал DeepSeek для той же модели, поэтому результаты качества ответов остальных четырёх провайдеров выражаются как отличия от него. Роль базового уровня не подразумевает ранжирования по качеству ответов.
Что произошло в первом окне измерения скорости при одном параллельном запросе?
Пятнадцать из 30 запросов оказались некорректными: 12 вернули 503, для 2 истёк срок ожидания, а 1 завершился тайм-аутом чтения. Они учитываются как бесконечное время, поэтому медиана составляет 1.87 с; только для корректных запросов она равна 1.72 с.
Что это за 27 некорректных проверок функций?
Они зависят от точного количества токенов: длинные входные данные, ограничения контекстного окна, нативный подсчёт входных данных и согласованность входных данных для кэширования. Закреплённый шаблон нативного подсчёта на стороне теста не соответствовал учёту использования, указанному этим каналом, поэтому проверки исключили из знаменателя, а не засчитали как сбои.
Почему R 100 не гарантирует, что на маршруте не бывает сбоев?
R охватывает только 300 специальных запросов для проверки стабильности. Сбои во время тестов качества ответов и скорости фиксируются в Q и P. При 300 успешных запросах из 300 нижняя граница 95%-го доверительного интервала составляет 98.78%, поэтому доля сбоев, вероятно, ниже 1.22%, но её нулевое значение не доказано.
Как тест кэширования отличает повторные чтения от чтений без попадания в кэш?
В каждой группе сначала создаётся префикс размером 8k или 32k, затем через 5, 30 и 120 секунд он отправляется повторно с новым заключительным вопросом, после чего для контрольного чтения без попадания в кэш отправляется новый префикс. Для обоих размеров в кэш попали 9 из 9 повторных запросов, а в каждом контрольном чтении без попадания в кэш было обнаружено 0 токенов из кэша.
Читайте дальше: серия DeepSeek V4.1 Flash
- Показатель Q у ByteDance отличается от этого базового уровня менее чем на 0.40 балла, тогда как результаты поддержки функций и кэширования иные: DeepSeek V4.1 Flash на ByteDance: вызовы инструментов совпадают, учёт — нет.
- У Baidu часть запросов завершилась ошибкой
no_available_channel, что отразилось и на Q, и на P: DeepSeek V4.1 Flash на Baidu: отсутствие доступного канала влияет на Q и P. - Общий результат Alibaba Cloud отличается на 0.37, и это различие статистически неразличимо: DeepSeek V4.1 Flash на Alibaba Cloud: первый токен за 1.34s, кэш — 99.37.
- На Fireworks попадание в кэш зафиксировано в 3 из 9 горячих запросов размером 8k, тогда как здесь — в 9 из 9: DeepSeek V4.1 Flash на Fireworks: пустые ответы со stop, попаданий в кэш — 3/9.


