

03–04.11.2026 DeepSeek V4.1 Flash 1017 протестировали на наборе APB Full через пять провайдеров, используя одни и те же вопросы, параметры и скрипты запросов. Этот профиль APB охватывает только Fireworks. Модель указана как DeepSeek V4.1 Flash 1017.
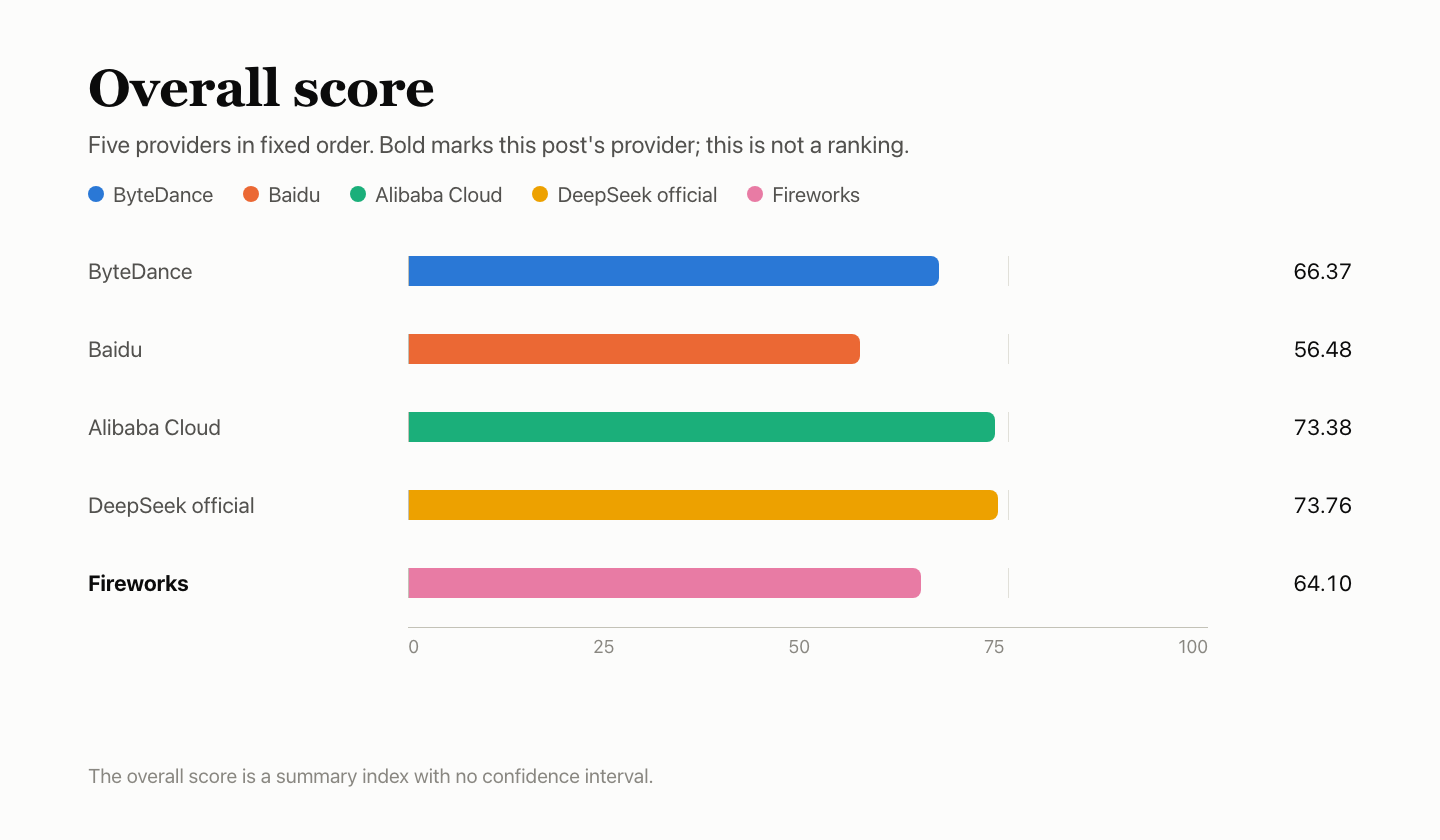
Оценки: Q — 41.42, F — 71.78, P — 79.51, K — 60.68 и R — 100; общий индекс — 64.10. В этой публикации приведены только оценки, без рейтинга и рекомендаций по выбору провайдера. Сначала идут Q, F, P, K и R; общий индекс — сводное число без доверительного интервала. Стандарт — AIHubMix Provider Benchmark Standard v2.0.
Оценки пяти провайдеров
Полужирным выделен провайдер, которому посвящена эта публикация. Фиксированный порядок провайдеров, не рейтинг. K — субоценка P с весом 20%. Общий индекс — сводное число без доверительного интервала. DeepSeek official channel и Alibaba Cloud отличаются на 0.37, и различие между ними неразличимо.
Кратко
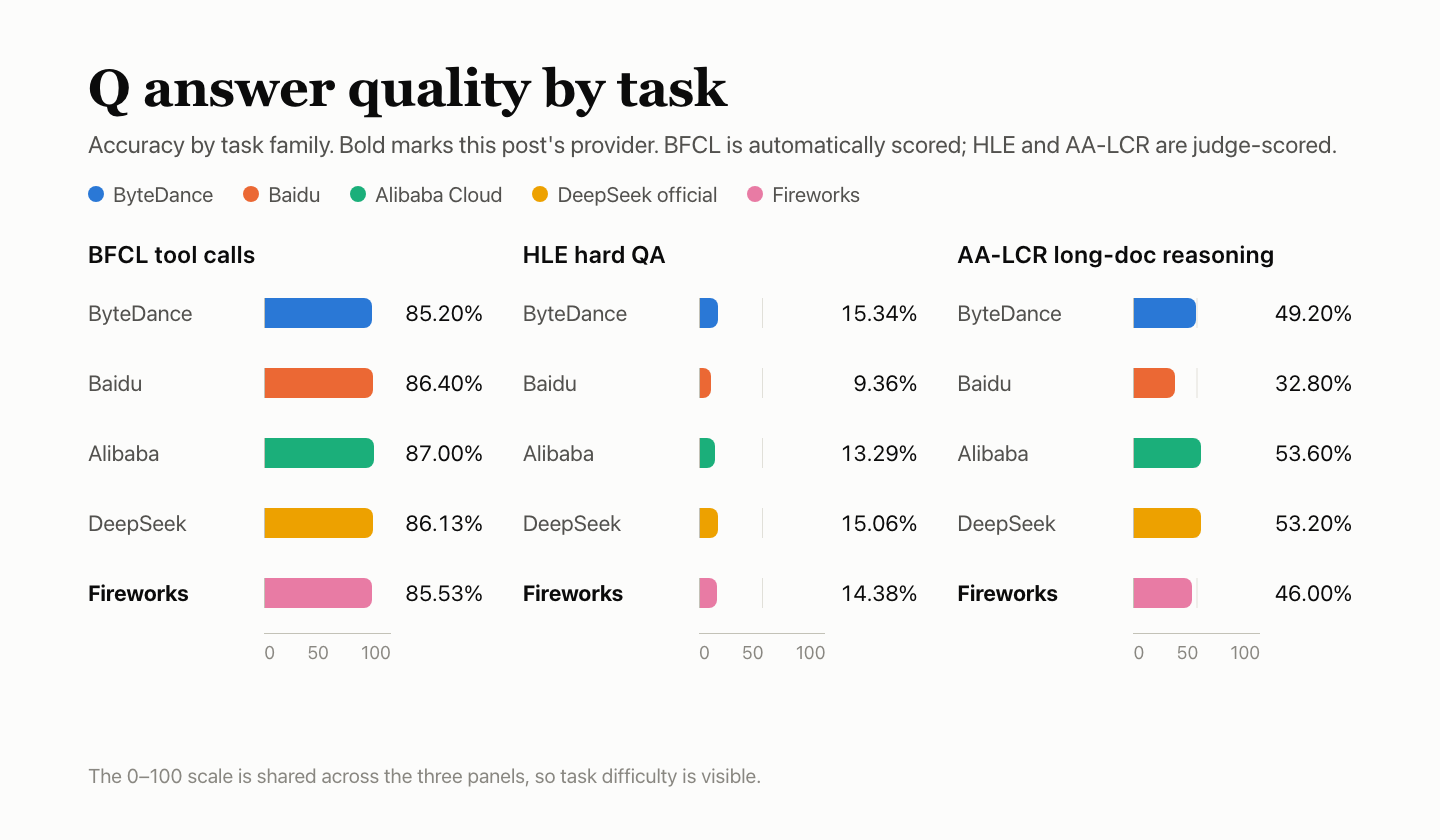
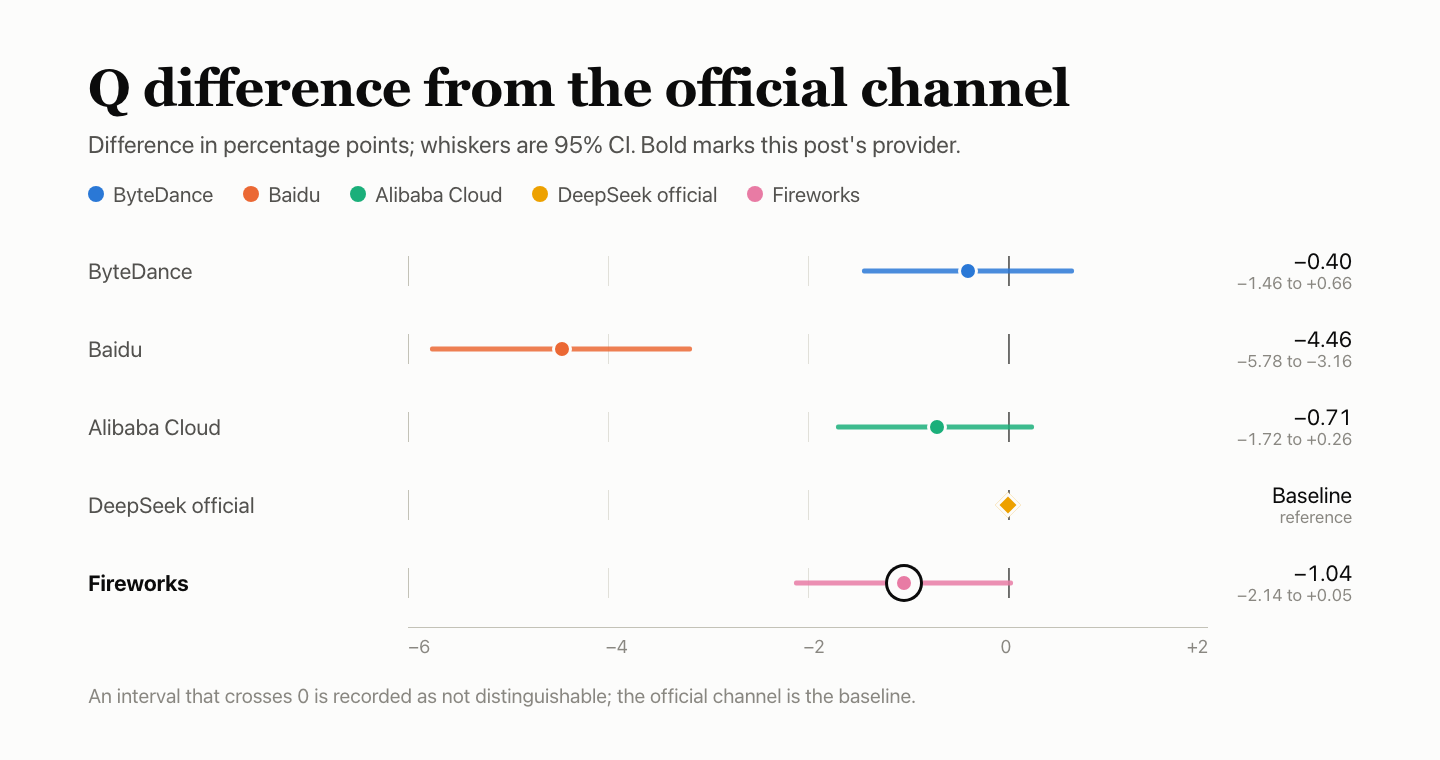
- Q — качество ответов: 41.42. BFCL — 85.53%, HLE — 14.38%, AA-LCR — 46.00%. Разница с официальным каналом: −1.04 процентного пункта, 95% ДИ от −2.14 до +0.05; различие неразличимо. Все 34 ошибки AA-LCR пришлись на окно 2 и засчитаны как неправильные ответы.
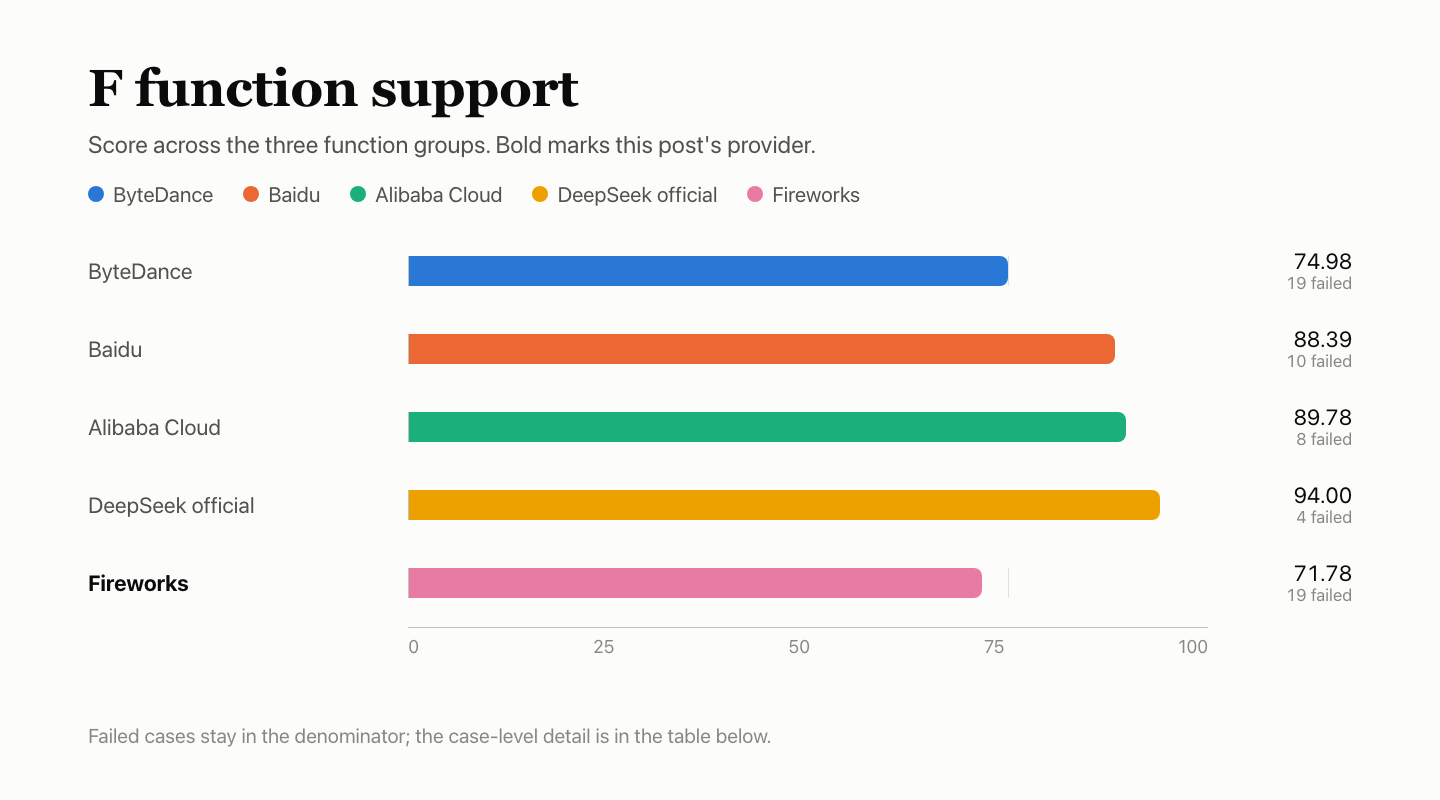
- F — поддержка функций: 71.78. Пройдены 122 из 177 учитываемых проверок. В обоих случаях с stop возвращалось пустое тело;
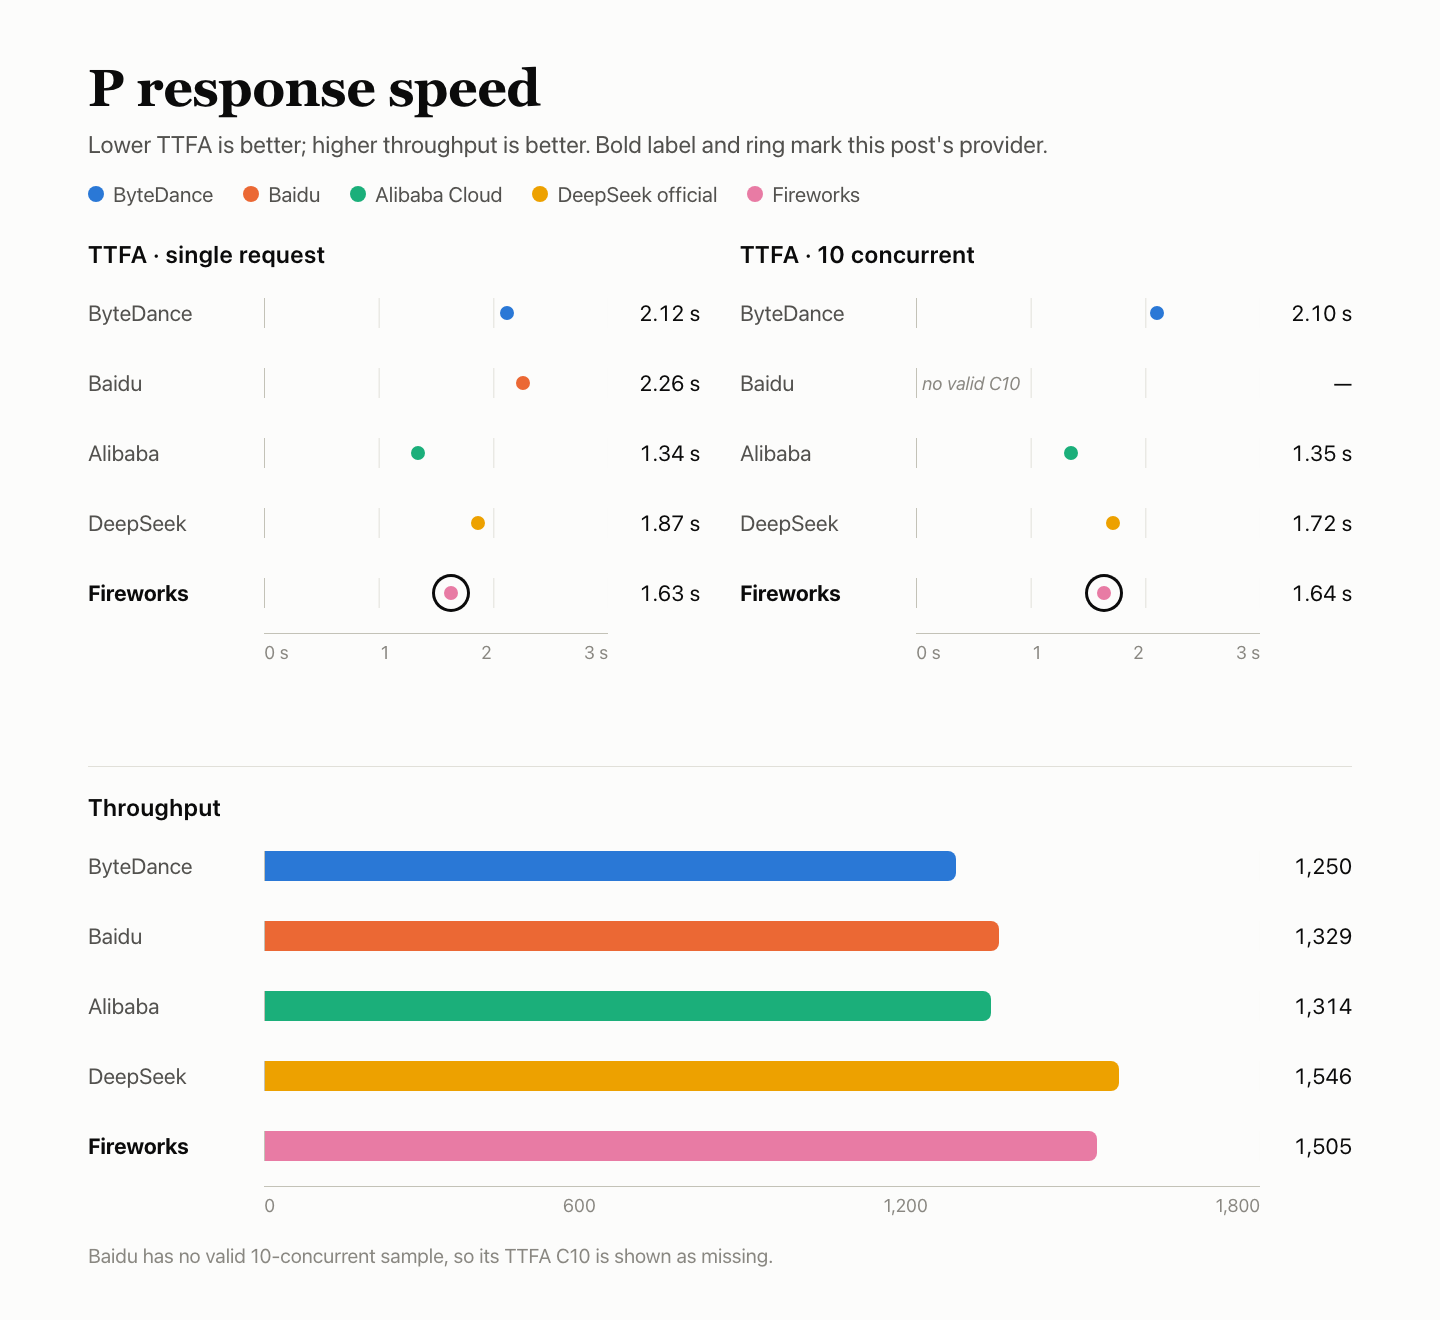
reasoning_effort=noneне отключал thinking; для входа в 10k сообщалось о 10,026 токенах при нативном подсчёте 10,000. - P — скорость ответа: 79.51. Оценка скорости ответа — 84.22, показатель попадания в кэш K учитывается с весом 20%. Медиана TTFA — 1.63 с при одном параллельном запросе и 1.64 с при 10; TPOT — 3.29 мс. 1 из 180 ответов состоял из одного токена и был помечен как недействительный.
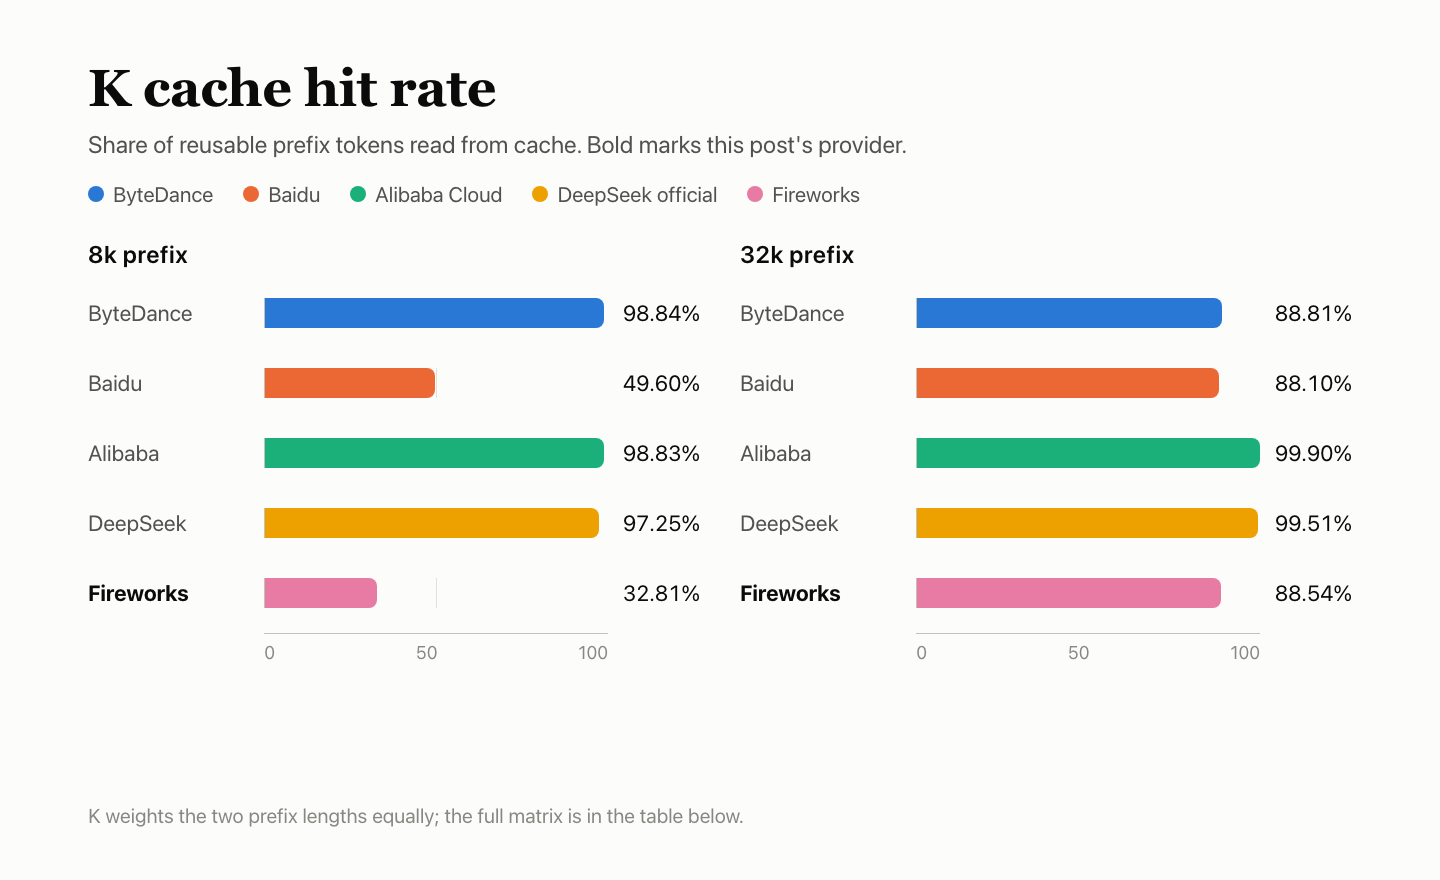
- K — кэш: 60.68. Для проверок K использовалась документированная привязка сессии. Попадания в горячий кэш: 8/9 для 32k; 3/9 для 8k.
- R — стабильность сервиса: 100. Все 300 из 300 выделенных запросов прошли с первой попытки.
Настройки теста
| Параметр | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | fireworks-deepseek-v4.1-flash-1017 |
| Возвращённое имя модели | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Маршрут доступа | ID модели провайдера AIHubMix, а не аккаунт самого провайдера |
| Параметры | Без thinking, temperature 1.0, max_tokens 16,384, тайм-аут 300 с, без повторных попыток |
| Отключение thinking | Нативный параметр thinking.type=disabled; reasoning_effort=none не отключает thinking. В функциональных проверках оставляли reasoning_effort=none. |
| Время | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Один Mac mini, сеть и аккаунт для всех пяти. |
| Выборки | Q — 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F — 60×3; P — 90+90; R — 300; K — 30 |
| Дополнительные настройки | В проверках K передавались документированное поле user и заголовок x-session-affinity для привязки к реплике. |
Запросы отправлялись по краткому руководству AIHubMix; ID моделей приведены на странице моделей. Thinking отключали с помощью нативного параметра thinking.type=disabled из документации API модели.
Q — качество ответов: 41.42
Набор включал 500 вопросов BFCL × 3 раунда, 250 вопросов HLE × 10 и 25 вопросов AA-LCR × 10. BFCL оценивался автоматически; ответы HLE и AA-LCR оценивала модель deepseek-flash. Все пять провайдеров получили одинаковые вопросы. Десять ответов, которые нельзя было оценить, исключили; осталось 4,240 оцениваемых результатов.
| Задача | Вопросы | Верные ответы | Точность | Ошибки |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Сложные вопросы и ответы HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Итого · 95% ДИ 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Ошибки остаются в знаменателе и засчитываются как неправильные ответы: 2 в BFCL (окна 2 и 3), 5 в HLE — обрезаны на max_tokens, 34 в AA-LCR — все в окне 2.
| Категория BFCL | Пройдено | Доля пройденных |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
В категории simple_python пройдены 333/360 проверок (92.50%), в parallel — 270/300 (90.00%), в ahm_multi_turn — 95/150 (63.33%), а в irrelevance — 111/150 (74.00%).
Сравнение с остальными четырьмя
Разница в процентных пунктах относительно официального канала; 95% интервал показан усами. Пересечение с 0 означает, что различие неразличимо. Оценщик deepseek-flash принадлежит к тому же семейству и не калиброван, поэтому может быть склонен ставить высокие оценки.
F — поддержка функций: 71.78
60 случаев образуют шесть групп, каждую проверяли в трёх окнах: всего 180 проверок по формату, задокументированному провайдером. Неприменимые, недействительные и ненаблюдавшиеся проверки не включаются в знаменатель. Пройдены 122 из 177 учитываемых проверок; оценка с весами групп — 71.78.
| Группа случаев | Вес | Пройдено | Исключено | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и обмен сообщениями | 20% | 24/30 | — | 80.00 |
| Интерфейс инструментов | 20% | 29/30 | — | 96.67 |
| Ограничения вывода | 20% | 21/30 | — | 70.00 |
| Контекст и состояние | 15% | 15/30 | — | 50.00 |
| Ошибки и восстановление | 15% | 21/30 | — | 70.00 |
| Подсчёт и кэш | 10% | 12/27 | 3 | 44.44 |
| Итого · с учётом весов | — | 122/177 | 3 | 71.78 |
«Окна с ошибкой» — число окон, в которых случай не был пройден.
| Случай с ошибкой | Окна с ошибкой | Причина |
|---|---|---|
| Остановка потоковой передачи | 3/3 | При stop тело пустое; без stop работает. |
| Рассуждения в теле ответа | 3/3 | При reasoning_effort=none всё равно возвращались рассуждения. |
| Последовательность остановки | 3/3 | При stop тело пустое; без stop работает. |
| Настройка thinking | 3/3 | При reasoning_effort=none всё равно возвращались рассуждения. |
| Разнообразие сэмплирования | 3/3 | Результаты при Temp 0/1 слишком похожи |
| Длинный вход 10k | 3/3 | Сообщалось о 10,026; нативный подсчёт — 10,000. |
| В пределах контекстного окна | 3/3 | Сообщалось о 10,026; нативный подсчёт — 10,000. |
| Длинный вход 32k | 3/3 | Сообщалось о 10,026; нативный подсчёт — 10,000. |
| Длинный вход 100k | 3/3 | Сообщалось о 10,026; нативный подсчёт — 10,000. |
| За пределами контекстного окна | 3/3 | Должна быть ошибка параметра; возвращён статус 200. |
| Некорректные сообщения | 3/3 | 400, пустое тело |
| Результат инструмента без вызова | 3/3 | Должна быть ошибка параметра; возвращён статус 200. |
| Некорректный stream_options | 3/3 | 400, пустое тело |
| Подсчёт токенов thinking | 3/3 | Токены thinking учитывались и после отключения. |
| Нативный подсчёт входа | 3/3 | Сообщалось о 34; нативный подсчёт — 8. |
| Определения инструментов во входе | 3/3 | Несоответствие уже было в контрольном запросе без инструментов. |
| Подсчёт входа при использовании кэша | 3/3 | Подсчёт повторяющегося префикса не совпал с нативным. |
| Согласованность подсчёта входа при потоковой передаче | 3/3 | Сообщалось о 34; нативный подсчёт — 8 |
| Только один инструмент за раз | 1/3 | Ошибка 500 от вышестоящего сервиса. |
В обоих случаях с stop во всех трёх окнах возвращалось пустое тело, тогда как с тем же входом, но без stop, всё работало. В обоих случаях с thinking при reasoning_effort=none всё равно возвращались рассуждения.
Исключённые проверки не засчитываются ни как пройденные, ни как ошибочные.
| Статус | Случай | Количество | Причина |
|---|---|---|---|
| Не применимо | Явный cache_control | 3 | Заранее определено как неподдерживаемое этим интерфейсом |
Некорректные messages и stream_options приводили к ошибке у всех пяти провайдеров: 400 с пустым телом и без структурированной ошибки. Вероятнее всего, общий результат обусловлен уровнем шлюза AIHubMix; это требует отдельного расследования. Подсчёт токенов thinking также не прошёл у всех пяти, но ByteDance и Fireworks сообщали о токенах thinking после отключения, тогда как остальные три не возвращали их количество.
Сравнение с остальными четырьмя
P — скорость ответа: 79.51
Каждый запрос содержал около 10,000 входных токенов и запрашивал около 1,100 выходных токенов. В каждом из трёх окон отправляли по 30 запросов с одним параллельным запросом и по 30 — с 10 параллельными запросами, всего 180.
| Метрика | Результат |
|---|---|
| TTFA | 1.63 с при одном параллельном запросе; 1.64 с при 10 |
| TPOT | 3.24 мс при одном параллельном запросе; 3.29 мс при 10 |
| Goodput | 1,504.5 токенов/с при 10 |
| Действительные | 90/90 при одном параллельном запросе; 89/90 при 10 (29/30 в окне 3), один ответ состоял из одного токена |
| Компоненты | TTFA — 54.91, TPOT — 100.00, goodput — 100.00; веса — 35/35/30 |
| Состав P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 из 180 запросов были действительными; недействительный запрос вернул один токен и учитывается как бесконечность при расчёте медиан, поэтому медианы могут быть выше, чем только для действительных запросов. TPOT рассчитывается по фрагментам потока; goodput — это число действительных выходных токенов при 10 параллельных запросах, делённое на время выполнения пакета.
Одна машина, сеть и аккаунт; расписание окон зависело от провайдера.
K — кэш: 60.68
Каждая группа состоит из пяти запросов: сначала создаётся префикс длиной 8k или 32k, затем тот же префикс отправляется с новым финальным вопросом через 5 с, 30 с и 120 с, после чего для контрольной проверки без попадания в кэш используется новый префикс. Три окна × две длины = 30. K — доля токенов чтения из горячего кэша от числа повторно используемых токенов; длины имеют одинаковый вес. K составляет 20% от P.
| Префикс | Окно | Начальный запрос | +5 s | +30 s | +120 s | Контроль без кэша |
|---|---|---|---|---|---|---|
| 8k | Окно 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Окно 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Окно 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Окно 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Окно 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Окно 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Префикс 8k попал в кэш в 3 из 9 горячих запросов: было прочитано 23,706 из 72,252 повторно используемых токенов — 32.81. Префикс 32k попал в кэш в 8 из 9 запросов: было прочитано 255,212 из 288,261 — 88.54. K составляет 60.68 при равном весе двух длин. В контрольных запросах без кэша было прочитано 0 токенов. Таким образом, при одинаковом устройстве теста два префикса разной длины показали разные результаты. В пробах K использовались документированное поле user и заголовок x-session-affinity.
R — стабильность сервиса: 100
В трёх окнах было выполнено 300 запросов с коротким текстом, длинным вводом, вызовом инструмента и историей диалога из нескольких ходов при параллельности 1. Проверялись только корректность и полнота первого ответа; ответы не оценивались, повторных попыток не было. Сбои Q и P здесь не учитываются повторно.
| Тип запроса | Успех с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод, 10k | 90/90 |
| Вызов инструмента | 60/60 |
| История диалога из нескольких ходов | 30/30 |
| Итого · 95% ДИ: 98.78%–100% | 300/300 |
Все 300 запросов с первой попытки вернули корректный и полный ответ. При 300 успешных запросах нижняя граница 95% доверительного интервала составляет 98.78%, поэтому данные позволяют утверждать лишь, что доля сбоев ниже 1.22%. Оценка R 100 относится к этим 300 запросам, а не ко всему пути.
| Провайдер | Успех с первой попытки | 95% доверительный интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Официальный канал DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часто задаваемые вопросы
Что учитывает Q 41.42?
BFCL, HLE и AA-LCR на 4,240 оцениваемых примерах: 1,756 верных ответов, 41.42%, 95% ДИ: 39.13%–43.59%; отличие от официального канала статистически неразличимо.
Почему оба запроса с stop завершились сбоем?
Запрос с параметром stop вернул пустое тело во всех трёх окнах, тогда как тот же ввод без stop сработал. Это наблюдалось и в потоковом, и в непотоковом режимах.
Отключает ли reasoning_effort=none мышление?
Нет. Во всех трёх окнах модель по-прежнему возвращала содержимое рассуждений; в остальных запросах использовался нативный параметр thinking.type=disabled.
Почему для ввода 10k указано 10,026 токенов?
В случае 10k было указано 10,026 токенов вместо нативного значения 10,000. В случаях 32k и 100k также указывалось 10,026, а расхождение присутствовало и в контрольном запросе без инструментов.
Почему для 8k было 3 попадания в кэш из 9, а для 32k — 8 из 9?
В обоих случаях использовались одинаковое устройство теста и документированные настройки привязки к сессии. Разница — в данных о чтении, сообщённых сервером: для 8k попадания в кэш были в окнах 1 и 2, для 32k — во всех трёх.
Что учитывает R 100?
300 отдельных запросов — все корректны с первой попытки; нижняя граница 95% доверительного интервала составляет 98.78%. Сбои Q и P в оценке R не учитываются.
Читайте дальше: серия DeepSeek V4.1 Flash
- ByteDance, как и Fireworks, сообщал о токенах мышления после его отключения: DeepSeek V4.1 Flash на ByteDance: вызовы инструментов совпадают, данные учёта — нет
- Для Baidu зафиксированы Q 38.00 и P 37.77: DeepSeek V4.1 Flash на Baidu: ни один доступный канал не достигает Q и P
- Для Alibaba Cloud зафиксированы задержка первого токена 1.34 s и кэш 99.37: DeepSeek V4.1 Flash на Alibaba Cloud: первый токен за 1.34s, кэш 99.37
- Официальный канал — это базовый уровень Q; показатель F составляет 94.00: DeepSeek V4.1 Flash на официальном канале: F 94.00, 15 некорректных проб


