

3–4 ноября 2026 года на DeepSeek V4.1 Flash 1017 провели полный тестовый набор APB через AIHubMix у пяти провайдеров. Для каждого провайдера использовались одна и та же модель, вопросы, параметры и скрипты запросов; модель указана на странице модели AIHubMix, а все пять вариантов провайдеров — на странице моделей. Этот профиль APB охватывает только Alibaba Cloud: что измерялось в каждом разделе и какие результаты были получены.
В этой статье приводятся оценки без ранжирования провайдеров и рекомендаций. Сначала идут Q, F, P, K и R; K — подоценка P. Общая оценка — сводный индекс, а не сертификация; доверительный интервал для неё не рассчитывался. Правила подсчёта определены в стандарте AIHubMix Provider Benchmark Standard v2.0.
Оценки пяти провайдеров
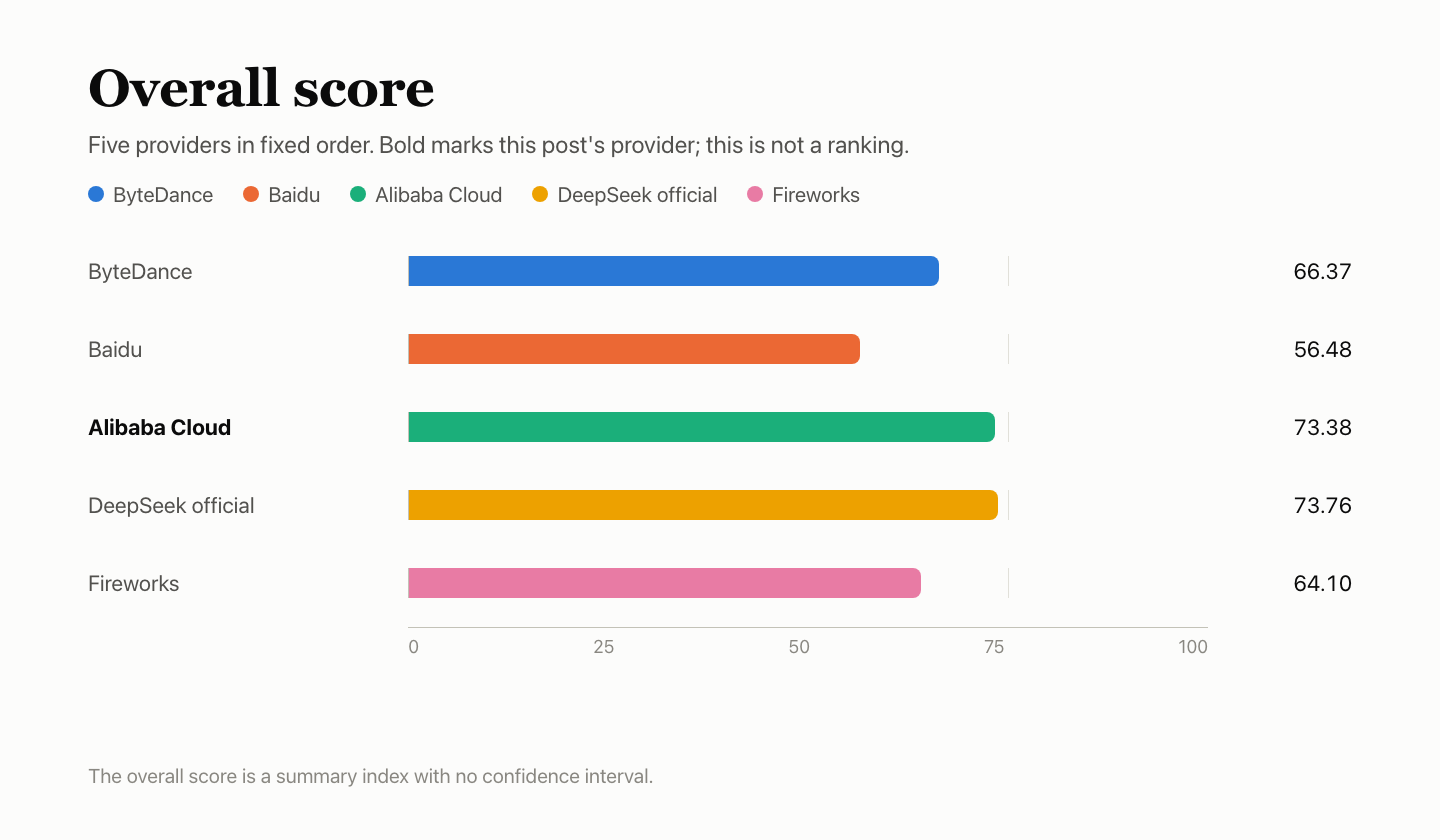
Полужирным выделен провайдер, рассматриваемый в этой статье. Провайдеры перечислены в фиксированном порядке, а не по рейтингу. K — подоценка P с весом 20%, приведённая отдельно для справки. Общая оценка — сводный индекс без доверительного интервала. Разница в 0.37 между официальным каналом DeepSeek и Alibaba Cloud не является статистически различимой.
Кратко
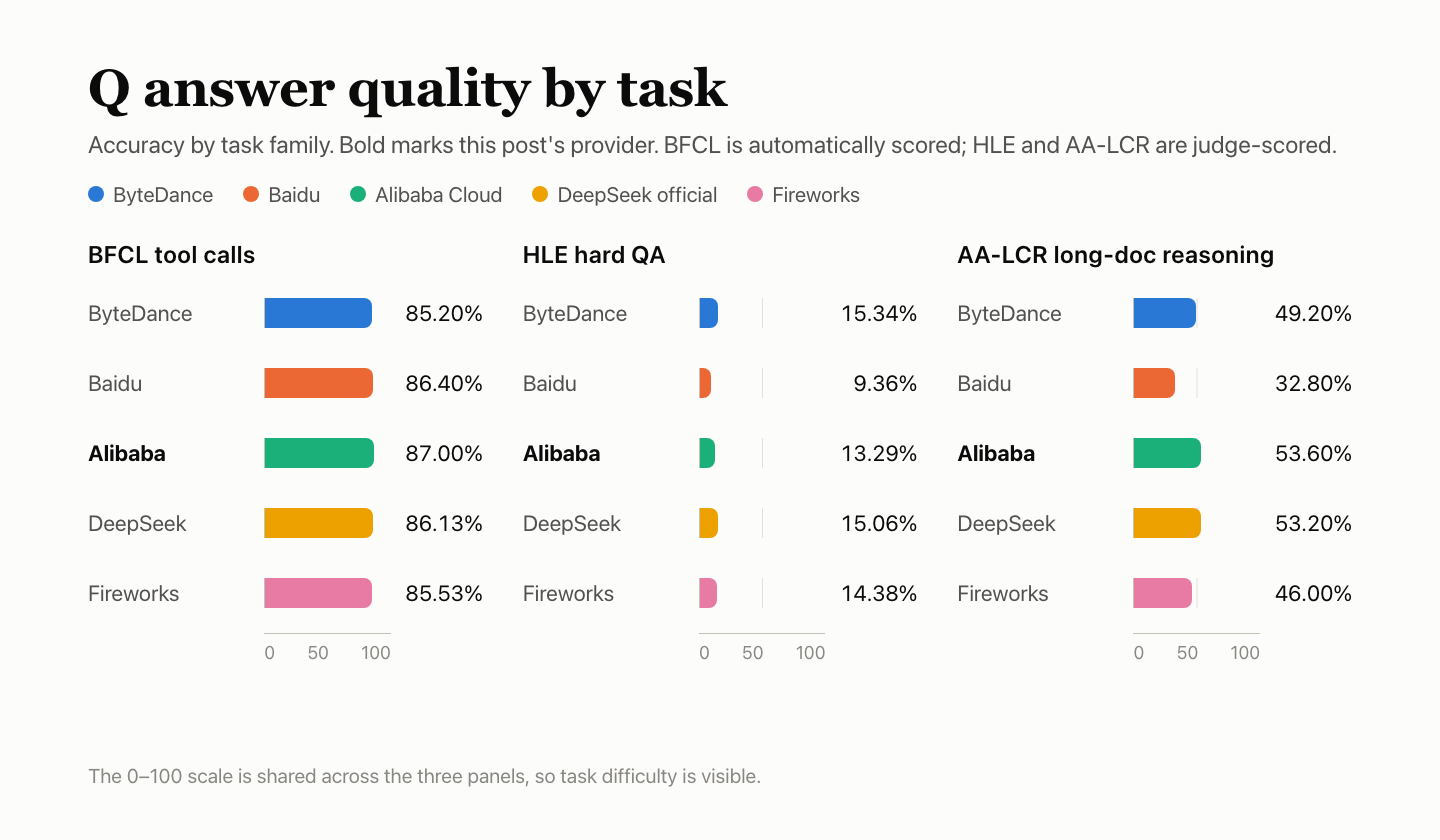
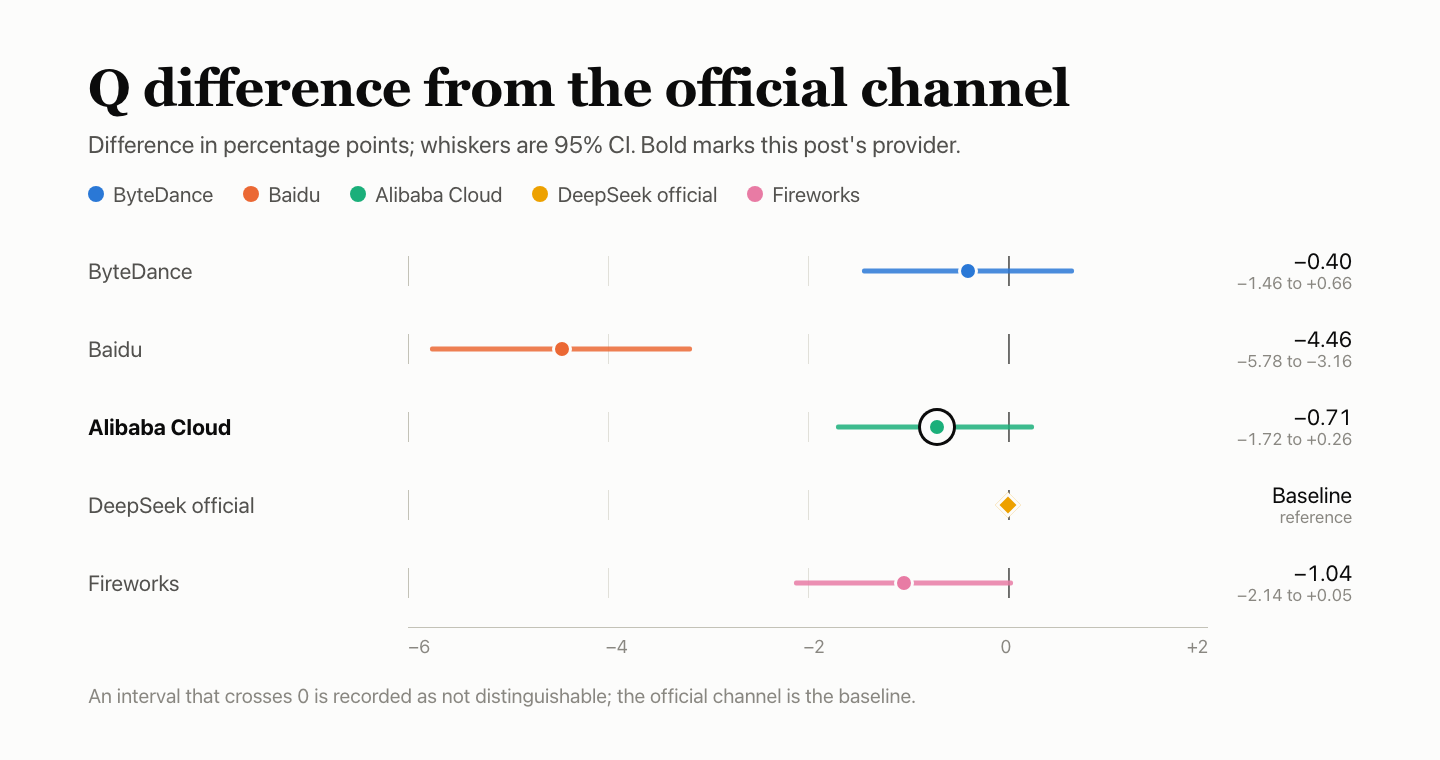
- Качество ответов: Q 41.75. BFCL — 87.00%, HLE — 13.29%, AA-LCR — 53.60%. Разница с официальным каналом составляет −0.71 процентного пункта, 95%-й интервал — от −1.72 до +0.26, поэтому результаты двух каналов статистически неразличимы.
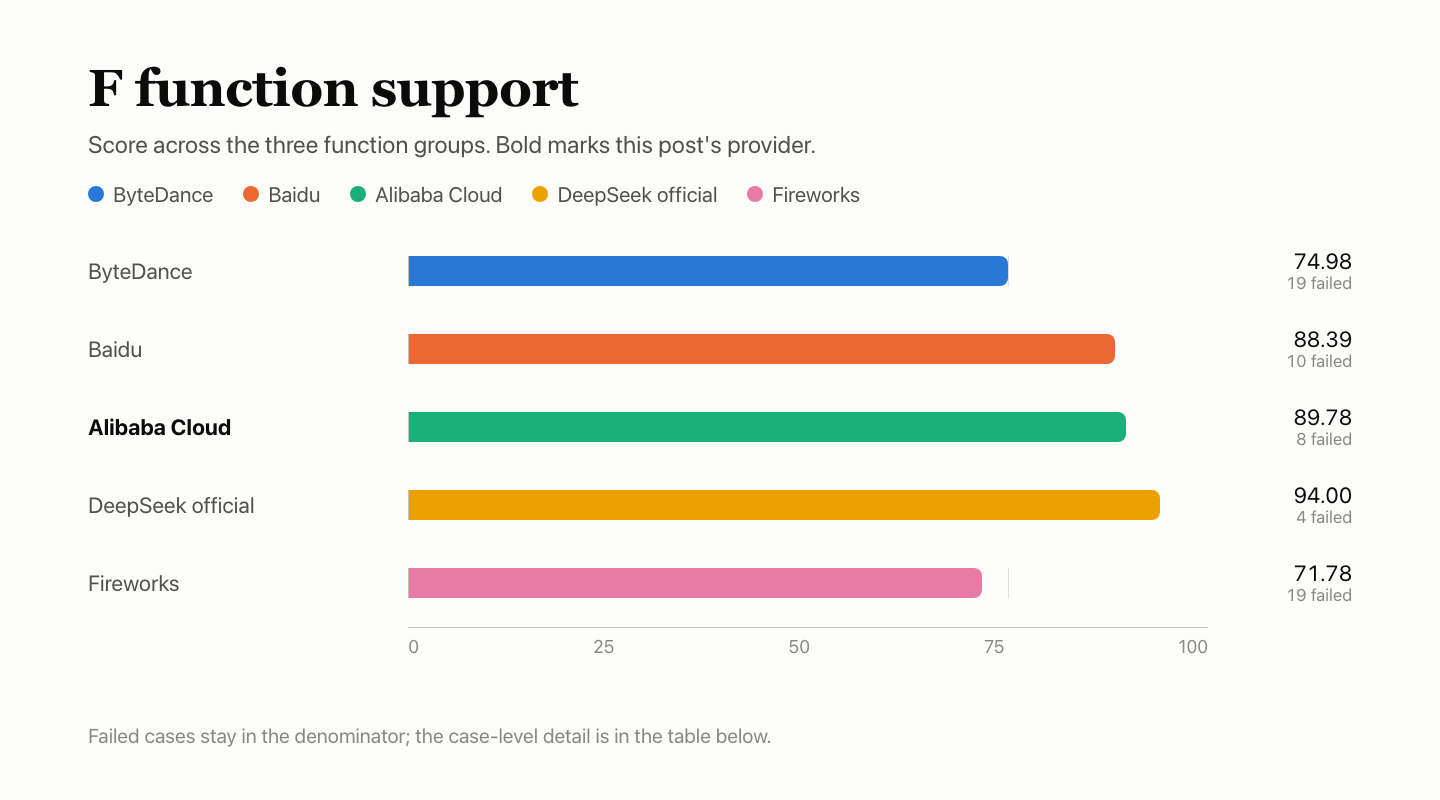
- Поддержка функций: F 89.78. Пройдены 155 из 177 проверок, вошедших в знаменатель. На недопустимую схему инструмента вернулась ошибка 503 вместо ошибки параметров; переполнение контекстного окна не вернуло документированный тип ошибки; изолированный результат инструмента вернул 200.
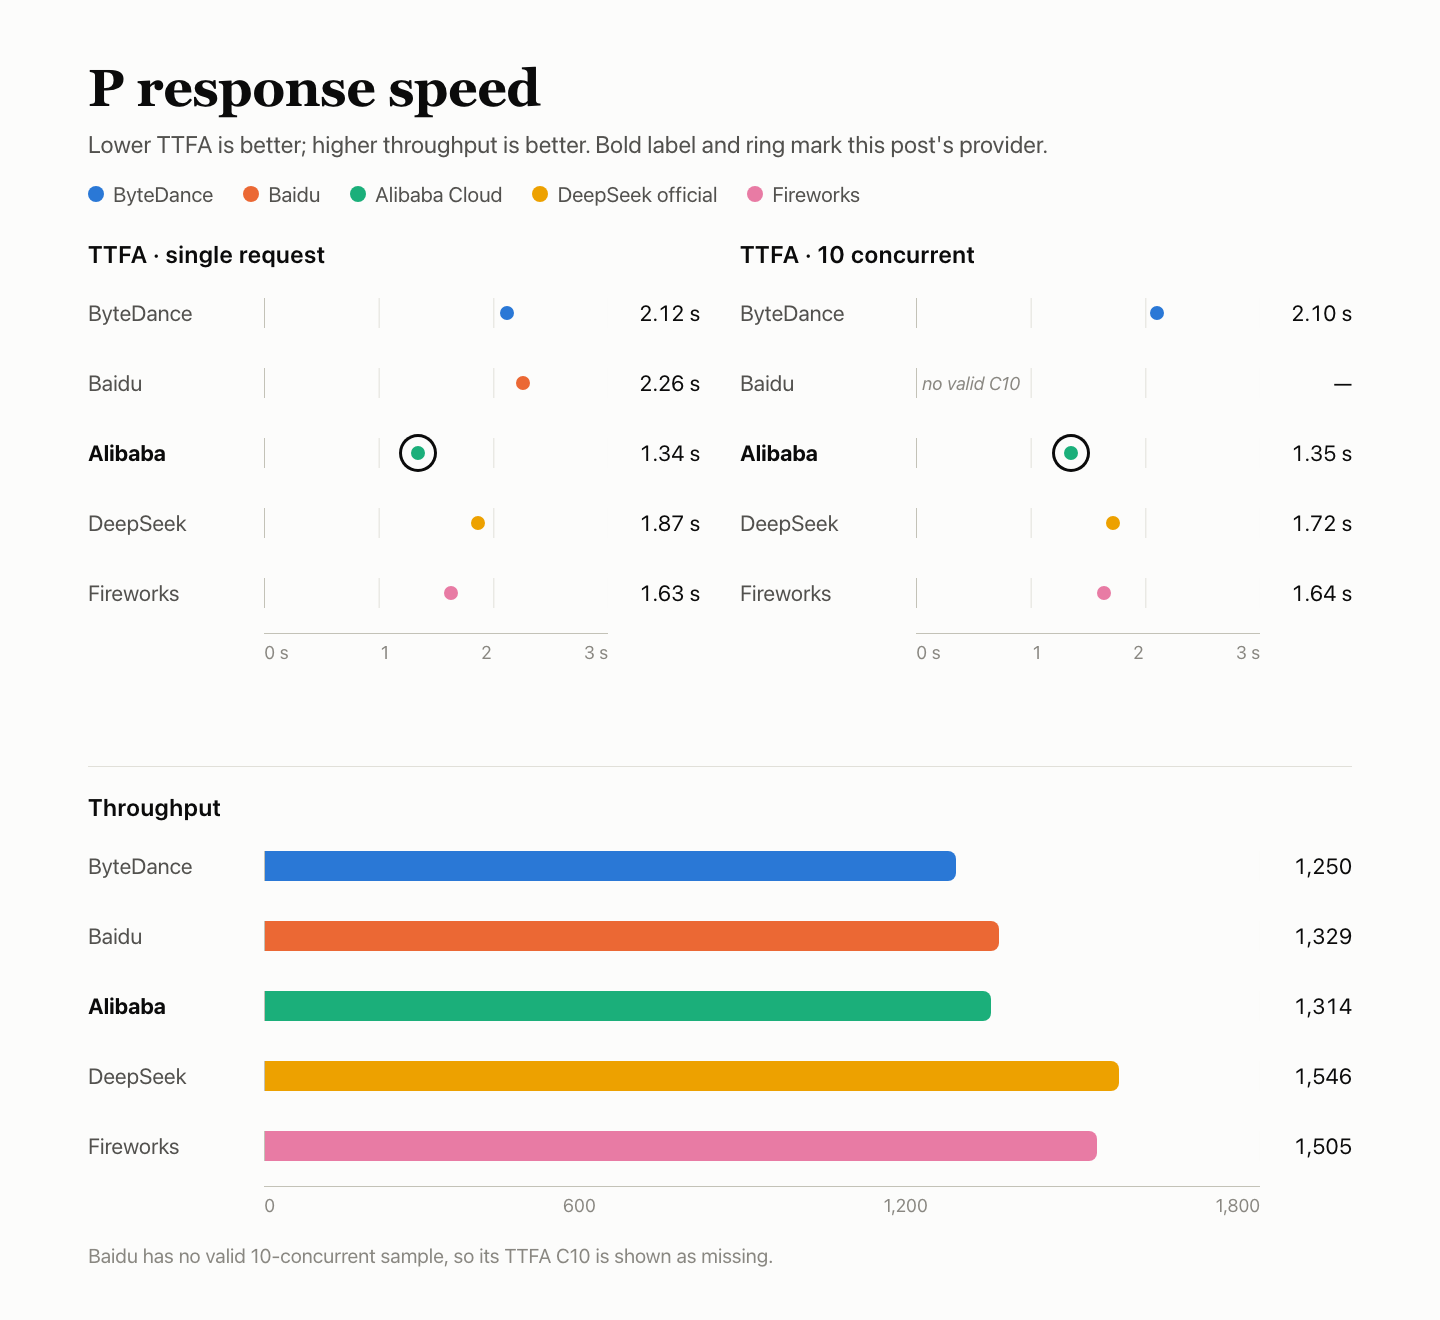
- Скорость ответа: P 88.58. Медианное время до первого токена с содержимым составило 1.34 s при одновременности 1 и 1.35 s при одновременности 10, TPOT — 4.69 ms; все 180 запросов на измерение скорости были корректными.
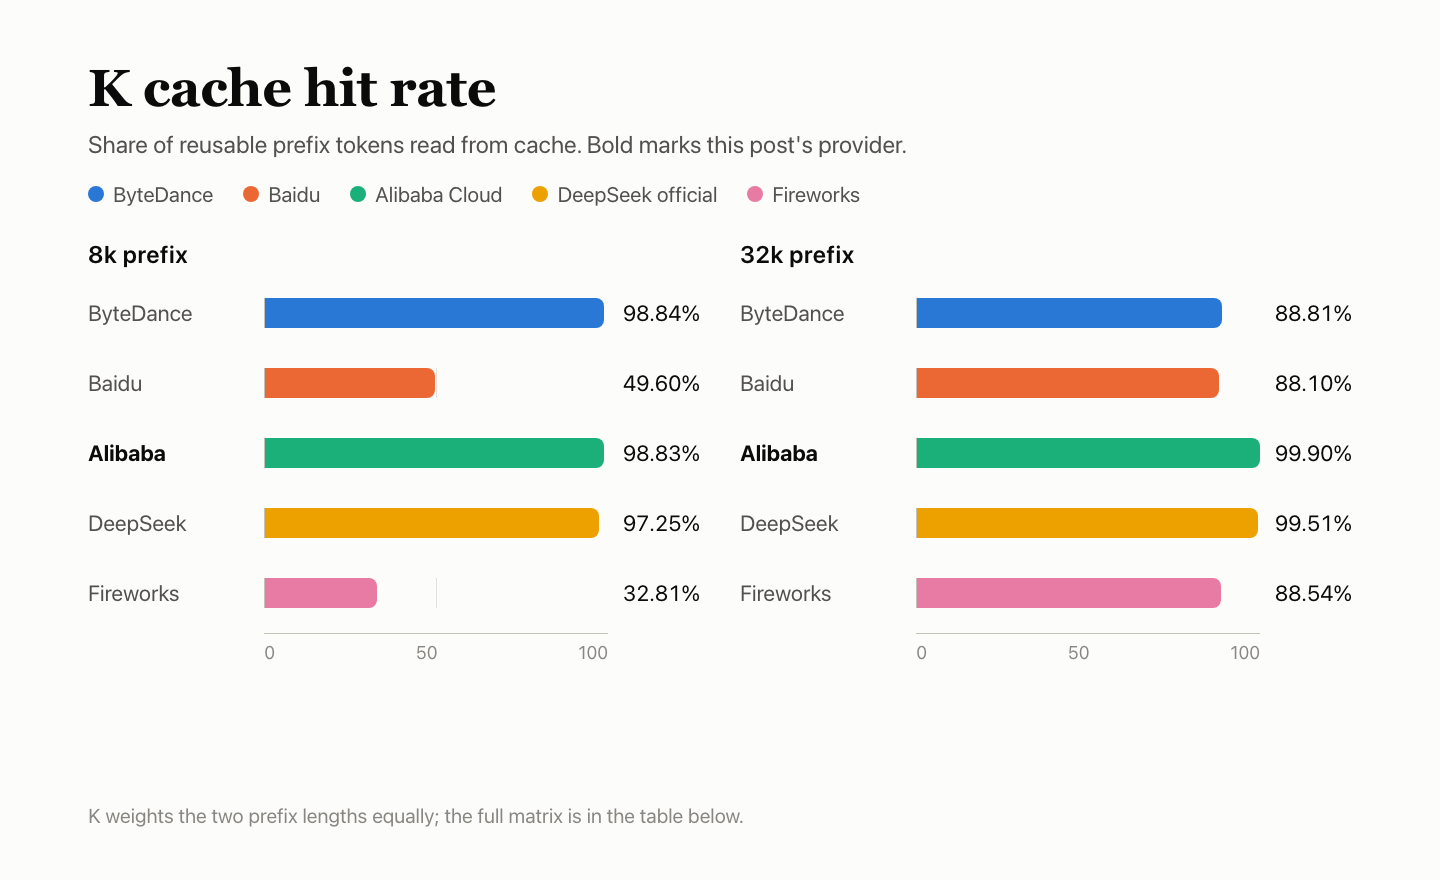
- Кэш: K 99.37. Все 18 горячих запросов с префиксами 8k и 32k попали в кэш, а контрольные запросы без кэша его не читали.
- Стабильность сервиса: R 100. Все 300 выделенных для этого запросов прошли с первой попытки.
Настройки тестирования
Запросы проходили через AIHubMix; для этого выбирался ID модели провайдера. Маршрут описан в разделе быстрого старта. Опубликованные тарифы модели указаны на странице цен DeepSeek.
| Параметр | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | alicloud-deepseek-v4.1-flash-1017 |
| Возвращённое название модели | deepseek-v4.1-flash-1017 |
| Маршрут доступа | Через AIHubMix с выбором ID модели провайдера, а не через подключение к собственной учётной записи провайдера |
| Параметры | Режим без thinking, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, автоматические повторы отключены |
| Thinking выключен | Во всех запросах использовался reasoning_effort=none |
| Время | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Пять провайдеров использовали один Mac mini, сеть и учётную запись. |
| Выборка | Качество ответов: 4,250 запусков на вопрос (BFCL 500 × 3 раунда, HLE 250 × 10, AA-LCR 25 × 10); функциональные проверки: 60 × 3 окна; скорость: 90 запросов при одновременности 1 и 90 при одновременности 10; стабильность: 300; кэш: 30 (префиксы 8k и 32k, по 3 группы каждого размера) |
Q — качество ответов: 41.75
Для оценки качества ответов использовались три набора вопросов: 500 вопросов BFCL с 3 раундами на каждый, 250 вопросов HLE с 10 раундами на каждый и 25 вопросов AA-LCR с 10 раундами на каждый. BFCL оценивался автоматически по правилам; HLE и AA-LCR проверяла модель-судья deepseek-flash. Все пять провайдеров отвечали на одни и те же вопросы, а результаты трёх наборов объединялись в одну оценку точности. Десять ответов исключили, поскольку вопросы нельзя было оценить; в итоге осталось 4,240 оценённых запусков.
| Задание | Вопросы | Верно | Точность | Сбои |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Сложные вопросы и ответы HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Итого · 95%-й интервал 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Сбои сервиса (неудачные запросы или усечённый вывод) остаются в знаменателе и засчитываются как неправильные ответы; их не исключают. В Alibaba Cloud вывод HLE 8 раз достигал ограничения max_tokens и обрезался.
На каждый вопрос BFCL даётся 3 раунда; в таблице объединены результаты всех 3 раундов.
| Категория BFCL | Пройдены | Доля пройденных |
|---|---|---|
| simple_python: одна функция, корректный вызов и аргументы | 332/360 | 92.22% |
| multiple: выбор нужной функции из нескольких | 270/300 | 90.00% |
| parallel: параллельный вызов одной функции несколько раз | 273/300 | 91.00% |
| parallel_multiple: параллельный вызов нескольких разных функций | 212/240 | 88.33% |
| irrelevance: ни одна функция не подходит, вызывать ничего не нужно | 113/150 | 75.33% |
| ahm_multi_turn: цепочка инструментов из трёх этапов | 105/150 | 70.00% |
Сравнение с остальными четырьмя
Разница в точности с официальным каналом в процентных пунктах; 95%-й интервал показан усами. Если интервал пересекает 0, различий нет. Для оценки HLE и AA-LCR использовалась модель-судья deepseek-flash из того же семейства DeepSeek, что и тестируемая модель; её калибровка не проводилась, поэтому оценка может быть завышенной.
F — поддержка функций: 89.78
Функциональные проверки оценивают соответствие поведения интерфейса протоколу, а не качество ответов модели. 60 случаев относятся к шести группам; каждая группа проверялась в трёх окнах, всего получилось 180 проверок. Результаты сверялись с форматом, задокументированным каждым провайдером. Неприменимые, недопустимые или ненаблюдавшиеся проверки исключаются из знаменателя. Alibaba Cloud прошла 155 из 177 проверок, вошедших в знаменатель; с учётом весов групп оценка составляет 89.78.
Взвешенная оценка рассчитывается с учётом весов групп, а не простым подсчётом пройденных проверок из 177.
| Группа | Вес | Пройдены | Исключены | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и протокол сообщений | 20% | 30/30 | — | 100.00 |
| Интерфейс инструментов | 20% | 30/30 | — | 100.00 |
| Ограничения вывода и параметры | 20% | 30/30 | — | 100.00 |
| Контекст и состояние | 15% | 26/30 | — | 86.67 |
| Ошибки и восстановление | 15% | 18/30 | — | 60.00 |
| Учёт токенов и протокол кэширования | 10% | 21/27 | 3 | 77.78 |
| Итого · взвешенная оценка | — | 155/177 | 3 | 89.78 |
Значение 3/3 в столбце с количеством окон означает, что проверка не пройдена во всех трёх окнах.
| Не пройденная проверка | Окна, в которых проверка не пройдена | Причина |
|---|---|---|
| Переполнение контекстного окна (контекст и состояние) | 3/3 | Вернулась ошибка, но не документированная ошибка длины контекстного окна |
| Ошибка формата messages (ошибки и восстановление) | 3/3 | Вернулась ошибка 400 с пустым телом ответа, без структурированного описания ошибки |
| Недопустимая схема инструмента (ошибки и восстановление) | 3/3 | Должна была вернуться ошибка параметров; вернулась ошибка 503 |
| Изолированный результат инструмента (ошибки и восстановление) | 3/3 | Должна была вернуться ошибка параметров; вернулся код 200 |
| Ошибка формата stream_options (ошибки и восстановление) | 3/3 | Вернулась ошибка 400 с пустым телом ответа, без структурированного описания ошибки |
| Учёт токенов рассуждений (учёт токенов и протокол кэширования) | 3/3 | Количество токенов рассуждений не возвращено |
| Определения инструментов учитываются как входные данные (учёт токенов и протокол кэширования) | 3/3 | При наличии определений инструментов указанное количество входных токенов не превышало количество без них |
| Изоляция запросов (контекст и состояние) | 1/3 | На первом шаге в ответе не было только STORED, как требовалось, поэтому проверку изоляции продолжить не удалось |
Эти проверки исключаются из знаменателя и не засчитываются ни как пройденные, ни как проваленные.
| Статус | Проверка | Количество | Причина |
|---|---|---|---|
| Неприменимо | Явный cache_control | 3 | Заранее указано, что этот интерфейс не поддерживает эту функцию |
Ошибки формата messages и stream_options возникли у всех пяти провайдеров: каждый вернул 400 с пустым телом, поэтому клиент не получил структурированного описания ошибки. Поскольку все пять демонстрируют одинаковое поведение, вероятнее всего, проблема находится на уровне шлюза AIHubMix и требует отдельного расследования. Проверка учёта токенов рассуждений также не пройдена у всех пяти, но по разным причинам: ByteDance и Fireworks указывали токены рассуждений даже при выключенном thinking mode, а остальные три не возвращали их количество.
Сравнение с остальными четырьмя
P — скорость ответа: 88.58
Каждый запрос содержал около 10,000 входных токенов и запрашивал около 1,100 выходных. В трёх окнах отправляли по 30 запросов при одновременности 1 и 30 при одновременности 10, всего 180 запросов. Время ожидания первого токена с содержимым (TTFA) измеряется для каждого корректного запроса, а в таблице указаны медианы. TPOT оценивается по времени между фрагментами потоковой передачи, а не по времени обработки каждого токена на оборудовании; пропускная способность — это количество корректных выходных токенов при одновременности 10, делённое на общее время выполнения пакета запросов.
| Метрика | Результат |
|---|---|
| Время до первого токена с содержимым TTFA | Медиана при одновременности 1 — 1.34 s, медиана при одновременности 10 — 1.35 s |
| Скорость генерации TPOT | При одновременности 1 — 4.63 ms/токен, при одновременности 10 — 4.69 ms/токен |
| Эффективная пропускная способность (goodput) | При одновременности 10 — 1,313.6 токенов/с |
| Корректные запросы | При одновременности 1 — 90/90, при одновременности 10 — 90/90 |
| Оценки компонентов | TTFA — 59.65, TPOT — 100.00, пропускная способность — 100.00; для TTFA и TPOT берётся меньшее значение из двух уровней, веса составляют 35% / 35% / 30%, оценка скорости ответа — 85.88 |
| Оценка P | Оценка скорости ответа 85.88 с весом 80%, кэш K 99.37 с весом 20%, итог — 88.58 |
Сравнение с остальными четырьмя
Все пять провайдеров использовали одну и ту же машину, сеть и учётную запись. Три окна планировались отдельно для каждого провайдера, поэтому периоды сбора данных совпадают не полностью; не следует придавать слишком большое значение небольшим расхождениям.
K — кэш: 99.37
Каждая группа состоит из пяти запросов: первый содержит фиксированный префикс примерно на 8k или 32k токенов и заполняет кэш; в запросах 2–4 префикс сохраняется, а в конце меняется только вопрос — через 5, 30 и 120 секунд; в пятом запросе используется новый префикс для контрольной проверки без кэша. Три окна × два размера дают 30 запросов. K — отношение количества токенов, прочитанных из кэша в горячих запросах, к количеству токенов, которые согласно правилу должны быть доступны для повторного использования; для каждого размера задан вес 50%. K составляет 20% оценки P. В матрице показано сообщённое сервером количество токенов, прочитанных из кэша.
| Префикс | Окно | Начальный запрос (запрос 1) | Горячий через 5 s | Горячий через 30 s | Горячий через 120 s | Контрольный без кэша (запрос 5) |
|---|---|---|---|---|---|---|
| 8k | Окно 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Окно 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Окно 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Окно 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Окно 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Окно 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Префикс | Попадания в кэш | Прочитано токенов | Должно быть доступно для повторного использования | Оценка |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k и 32k, по половине веса каждому) | 99.37 |
Все 9 горячих запросов с префиксом 8k попали в кэш и прочитали по 7,936 токенов; все 9 горячих запросов с префиксом 32k попали в кэш и прочитали по 32,000 токенов. Начальные запросы и контрольные запросы без кэша не читали его, поэтому горячие запросы чётко отделяются от контрольных.
Сравнение с остальными четырьмя
R — стабильность сервиса: 100
В 300 запросах использовались четыре типа: короткий текст, длинный ввод на 10k, вызовы инструментов и история диалога из нескольких ходов. Запросы отправлялись при одновременности 1 в трёх окнах. Проверялись только первые ответы — на корректность и полноту; правильность ответов не оценивалась, повторы не выполнялись. Сбои в разделах качества ответов и скорости учитываются соответственно в Q и P, а не повторно в R.
| Тип запроса | Успех с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод на 10k | 90/90 |
| Вызовы инструментов | 60/60 |
| История диалога из нескольких ходов | 30/30 |
| Итого · 95%-й интервал 98.78%–100% | 300/300 |
Все 300 запросов вернули корректный полный ответ с первой попытки. R 100 учитывает только эти 300 специальных запросов и не означает, что во всей цепочке не было сбоев. Нижняя граница 95% интервала составляет 98.78%: даже при результате 300/300 вероятность того, что доля сбоев превышает 1.22%, невелика.
В сравнении с четырьмя другими
R учитывает только эти 300 специальных запросов; сбои в качестве ответов и скорости фиксируются в Q и P и повторно в R не учитываются.
| Провайдер | Успех с первой попытки | 95% интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часто задаваемые вопросы
Значима ли общая разница в 0.37 между Alibaba Cloud и официальным каналом?
Нет. По результатам этого теста их нельзя различить: разница Q составляет −0.71 процентного пункта, а 95% интервал — от −1.72 до +0.26, то есть включает 0. Общая оценка — сводный индекс без доверительного интервала.
Что учитывает оценка Q?
Три набора: 500 вопросов BFCL × 3 раунда с автоматической оценкой; HLE — 250 × 10 и AA-LCR — 25 × 10 с оценкой моделью-судьёй deepseek-flash. Совокупная точность составляет 41.75% по 4,240 оценённым запускам вопросов.
Почему F равен 89.78, если пройдены 155 из 177 проверок?
Оценка взвешивается по группам, а не рассчитывается как простое соотношение пройденных проверок. Ошибки и восстановление получили 60.00, а тарификация и протокол кэширования — 77.78; три группы протокольных проверок получили 100.00.
Почему R равен 100, если в других разделах были неудачные запросы?
R учитывает только 300 специальных запросов для проверки стабильности. Сбои в качестве ответов и скорости фиксируются в Q и P и повторно в R не учитываются.
Является ли K 99.37 показателем попаданий в кэш?
Это отношение числа токенов, прочитанных из кэша в запросах с прогретым кэшем, к числу токенов, которые должны переиспользоваться; префиксы 8k и 32k имеют равный вес. Оценка префикса 8k составила 98.83, а префикса 32k — 99.90.
Означает ли время до первого токена 1.34 s, что полный ответ приходит за 1.34 s?
Нет. Это время ожидания первого токена содержимого. В каждом запросе запрашивалось около 1,100 выходных токенов, а TPOT при параллелизме 10 составлял 4.69 ms на токен.
Читайте дальше: серия DeepSeek V4.1 Flash
- Совокупная оценка Q Alibaba Cloud отличается от официального базового показателя на 0.71 процентного пункта, и интервал включает 0; в профиле ByteDance такое же сравнение продолжается на тарификацию вызовов инструментов: DeepSeek V4.1 Flash на ByteDance: вызовы инструментов совпадают, тарификация — нет.
- Alibaba Cloud вернул корректные ответы на все 180 запросов для проверки скорости; профиль Baidu рассматривает тот же тестовый стенд, где ни один доступный канал не повлиял на Q и P: DeepSeek V4.1 Flash на Baidu: отсутствие доступного канала влияет на Q и P.
- В этой статье официальный канал служит базовым показателем для сравнения качества ответов; его собственный профиль охватывает F 94.00 и 15 некорректных проб при параллелизме 1: DeepSeek V4.1 Flash на официальном канале: F 94.00, 15 некорректных проб.
- Alibaba Cloud обеспечил попадание в кэш для 9/9 запросов с прогретым кэшем при обоих размерах префикса; профиль Fireworks описывает пустые ответы при остановке и 3/9 попаданий в кэш при 8k: DeepSeek V4.1 Flash на Fireworks: пустые ответы при остановке, 3/9 попаданий в кэш.


