

3–4 ноября 2026 года DeepSeek V4.1 Flash 1017 тестировали у пяти провайдеров через AIHubMix с полным набором APB: каждый раз использовались одни и те же вопросы, параметры и скрипты запросов. Этот профиль APB посвящён только запуску через Baidu и рассматривает результаты по разделам.
Приведённые ниже числа — только оценки, а не рейтинг и не рекомендация провайдера. Сначала идут Q 38.00, F 88.39, P 37.77, K 68.85 и R 100; общий показатель 56.48 — сводный индекс без доверительного интервала. Правила оценки соответствуют AIHubMix Provider Benchmark Standard v2.0.
Оценки пяти провайдеров
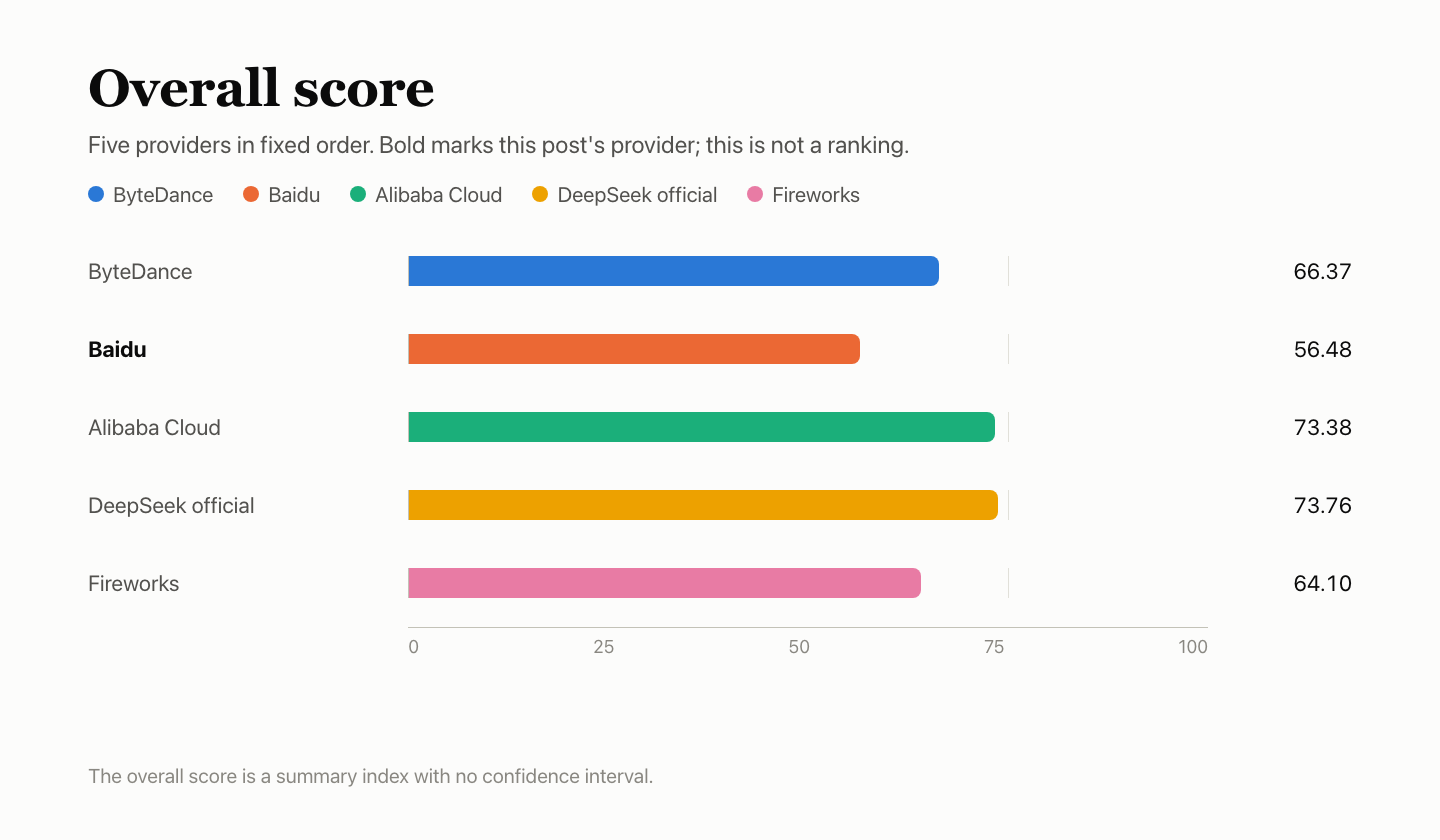
Полужирным выделен провайдер, которому посвящена эта публикация. Провайдеры перечислены в фиксированном порядке, а не по рейтингу. K — субоценка P с весом 20%. Общий показатель — сводный индекс без доверительного интервала. Разница между официальным каналом и Alibaba Cloud составляет 0.37 и статистически неразличима.
Краткий обзор
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. Сводный результат на 4.46 пункта ниже, чем у официального канала; 95%-й интервал от −5.78 до −3.16 не включает 0. Для HLE зарегистрировано 864 сбоя запросов, а для AA-LCR — 100; почти все они пришлись на первое окно и учитывались как неправильные ответы.
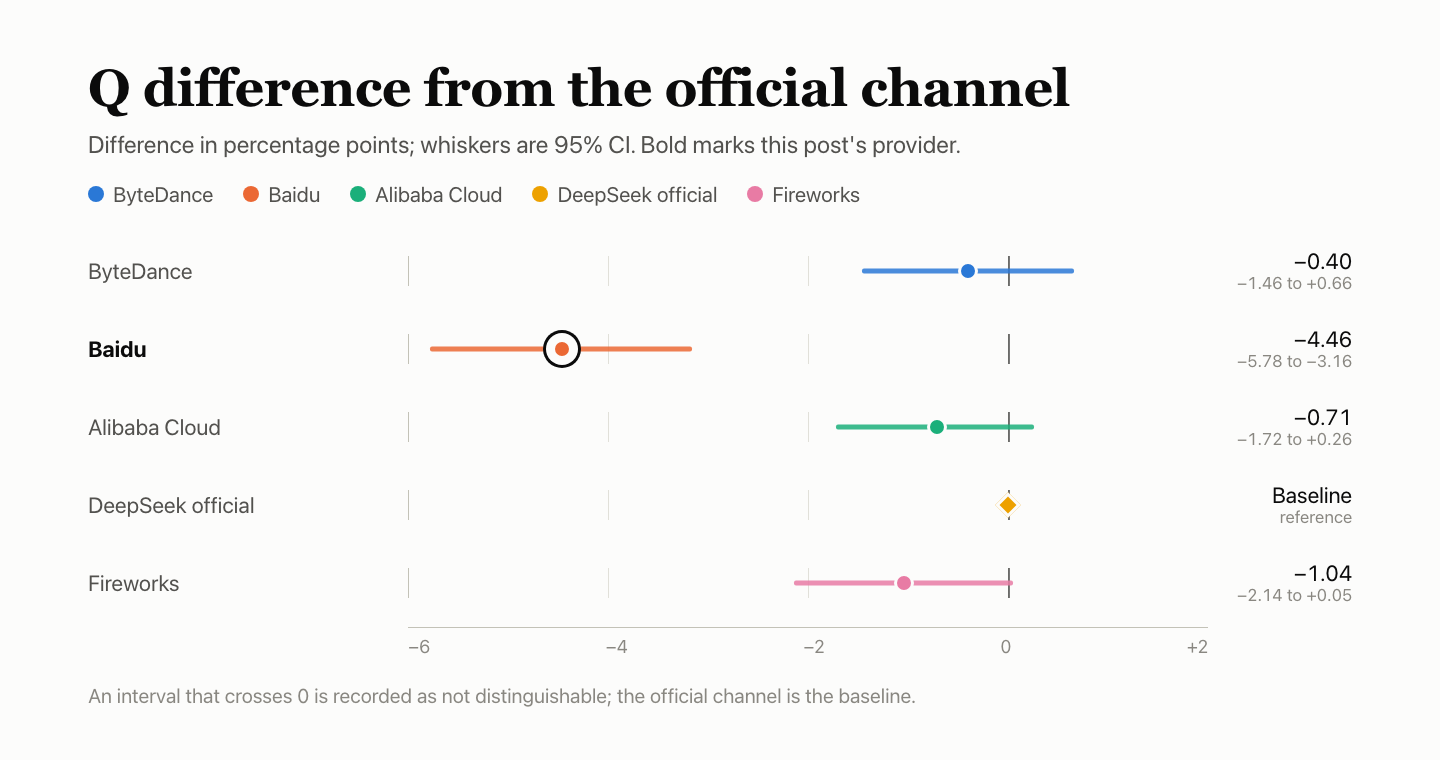
- F: 88.39. Пройдено 148 из 174 учитываемых проверок. Поле чтения кэша и число токенов thinking не были возвращены; на запросы с превышением контекстного окна и осиротевшим результатом вызова инструмента пришёл ответ 200.
- P: 37.77. 50 из 90 проб с десятью параллельными запросами вернули
no_available_channel, поэтому более половины оказались недействительными, а TTFA и TPOT получили штрафные значения. При одном параллельном запросе действительными были 78 из 90 проб. - K: 68.85. Для горячих запросов с префиксом 8k попадание в кэш произошло 5 раз из 9; 3 запроса завершились сбоем. Для префикса 32k попадание было 8 раз из 9. Попадания указываются блоками по 1,024 токена: 7,168 токенов для 8k и 31,744 для 32k.
- R: 100. Все 300 специальных запросов завершились успешно с первой попытки. Сбои каналов при ответах и проверках скорости учитываются в Q и P.
Настройка тестирования
Для запросов использовался маршрут AIHubMix быстрый старт с ID модели, специфичным для провайдера; параметры соответствуют документации API DeepSeek. ID моделей других провайдеров перечислены на странице моделей. Это не прямое подключение через собственную учётную запись Baidu.
| Поле | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | baidu-deepseek-v4.1-flash-1017 |
| Возвращённое имя модели | deepseek-v4.1-flash-1017 |
| Маршрут доступа | Через AIHubMix с ID модели, специфичным для провайдера; не прямое подключение через собственную учётную запись провайдера |
| Параметры | Режим без thinking, temperature 1.0, max_tokens 16,384, timeout 300 s, автоматические повторы отключены |
| Thinking отключён | Для каждого запроса использовался параметр reasoning_effort=none |
| Время | 2026-11-03 18:07 – 11-04 16:33 UTC+8; все пять провайдеров использовали один Mac mini, сеть и учётную запись |
| Выборка | 4,250 попыток ответа (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 случаев работы с функциями × 3 окна; 90 проб с одним параллельным запросом и 90 проб с десятью параллельными запросами для проверки скорости; 300 запросов для проверки стабильности; 30 проб кэша (по три группы для префиксов 8k и 32k) |
Q — качество ответов: 38.00
Качество ответов проверяется на трёх типах задач: 500 задач BFCL, на каждую из которых дано по три ответа; 250 задач HLE, на каждую — по десять ответов; и 25 задач AA-LCR, на каждую — по десять ответов. Оценка BFCL выполняется по автоматическим правилам; ответы на HLE и AA-LCR судейская модель deepseek-flash оценивает как правильные или неправильные. Все пять провайдеров получили один и тот же набор задач, а результаты по трём типам объединяются в общий показатель точности. Десять ответов исключили, поскольку их нельзя было оценить; в итоге было учтено 4,240 попыток.
| Задача | Элементы | Правильные | Точность | Сбои |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Сложные вопросы HLE, оценка судьёй | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Общий результат · 95%-й интервал 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Сбои сервиса, будь то неудачный запрос или усечённый вывод, остаются в знаменателе и считаются неправильными ответами. Для HLE произошло 864 сбоя запросов (863 в первом окне, 1 во втором), а 11 выводов были усечены из-за ограничения max_tokens. Для AA-LCR произошло 100 сбоев запросов — все в первом окне.
На каждую задачу BFCL даётся три ответа; в таблице объединены результаты всех трёх раундов.
| Категория BFCL | Пройдено | Доля успешных |
|---|---|---|
| simple_python: одна функция, правильный вызов и аргументы | 336/360 | 93.33% |
| multiple: выбрать нужную функцию из нескольких | 269/300 | 89.67% |
| parallel: несколько параллельных вызовов одной функции | 268/300 | 89.33% |
| parallel_multiple: параллельные вызовы нескольких разных функций | 206/240 | 85.83% |
| irrelevance: не вызывать функцию, если ни одна не подходит | 113/150 | 75.33% |
| ahm_multi_turn: цепочка инструментов из трёх этапов | 104/150 | 69.33% |
Сравнение с остальными четырьмя
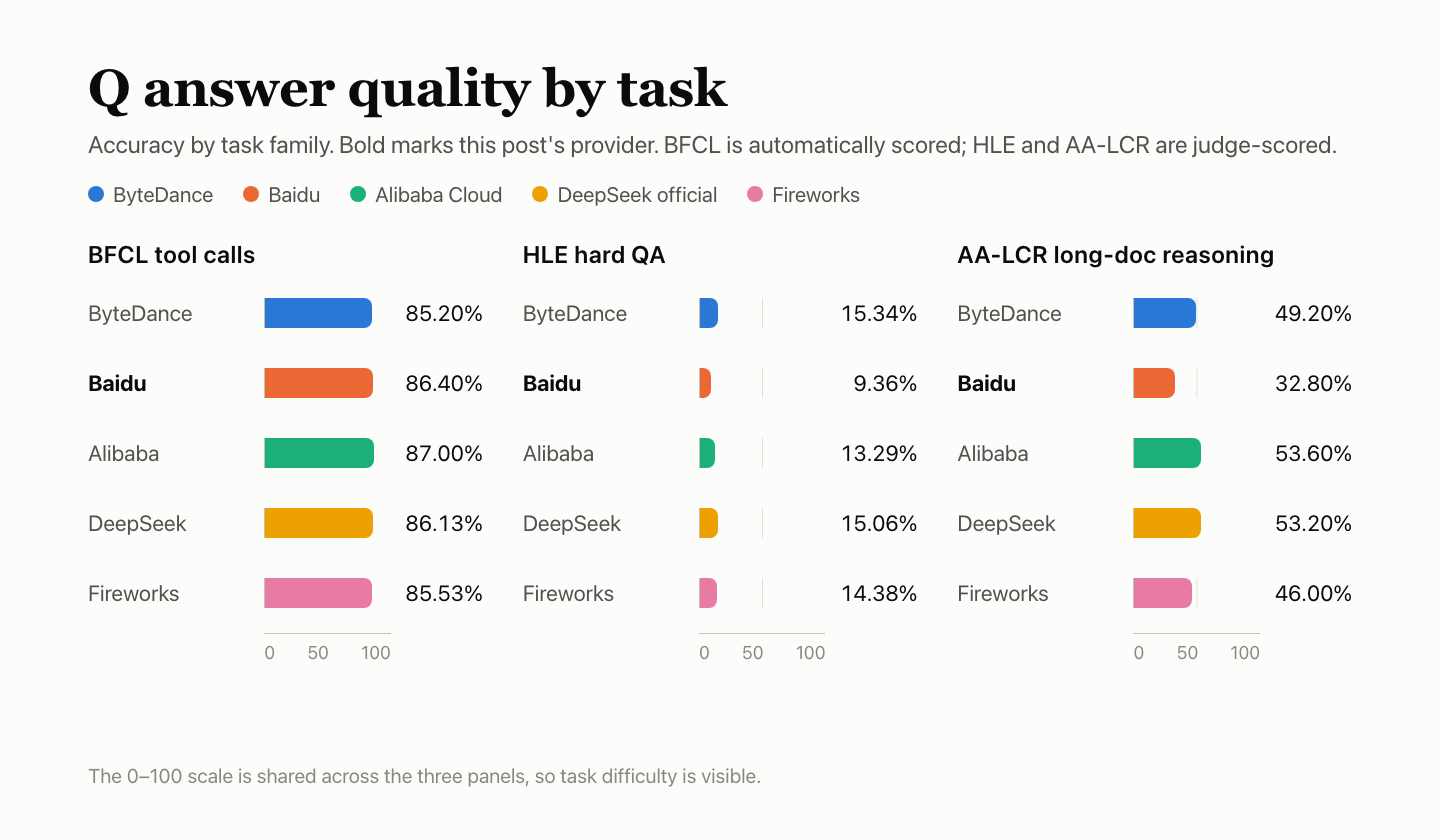
Разница указана в процентных пунктах относительно официального канала; 95%-й интервал показан усами. Если интервал включает 0, разница считается неразличимой. Модель-судья для HLE и AA-LCR, deepseek-flash, принадлежит к тому же семейству DeepSeek, что и тестируемая модель, и не проходила калибровку, поэтому её оценки могут быть снисходительными.
F — поддержка функций: 88.39
Проверки работы с функциями оценивают соответствие интерфейса протоколу, а не качество ответов модели. В каждом из трёх окон однократно запускали по 60 случаев из шести групп — всего 180 проверок; результаты сверяли с форматом, указанным в документации провайдера. Неприменимые, недействительные или ненаблюдаемые проверки исключаются из знаменателя. Для Baidu учитывались 174 проверки, из которых пройдены 148; взвешенная оценка составила 88.39.
Оценка группы взвешивается по её доле, а не рассчитывается простым делением 148/174.
| Группа случаев | Вес | Пройдено | Исключено | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и протокол сообщений | 20% | 27/27 | 3 | 100.00 |
| Интерфейс инструментов | 20% | 30/30 | — | 100.00 |
| Ограничения вывода и параметры | 20% | 29/30 | — | 96.67 |
| Контекст и состояние | 15% | 26/30 | — | 86.67 |
| Ошибки и восстановление | 15% | 21/30 | — | 70.00 |
| Учёт использования и протокол кэша | 10% | 15/27 | 3 | 55.56 |
| Итого, взвешенная оценка | 100% | 148/174 | 6 | 88.39 |
| Не пройденный случай | Окна с ошибкой | Причина |
|---|---|---|
| Превышение контекста (контекст и состояние) | 3/3 | Должна возвращаться ошибка параметра; возвращён код 200 |
| Некорректные сообщения (ошибки и восстановление) | 3/3 | Возвращён код 400 с пустым телом, структурированной ошибки нет |
| Осиротевший результат вызова инструмента (ошибки и восстановление) | 3/3 | Должна возвращаться ошибка параметра; возвращён код 200 |
| Некорректный stream_options (ошибки и восстановление) | 3/3 | Возвращён код 400 с пустым телом, структурированной ошибки нет |
| Поле чтения кэша (учёт использования и протокол кэша) | 3/3 | Поле чтения кэша не возвращено; подтвердить показание нельзя |
| Учёт токенов thinking (учёт использования и протокол кэша) | 3/3 | Количество токенов thinking не возвращено |
| Определения инструментов учитываются во входных данных (учёт использования и протокол кэша) | 3/3 | При наличии определений инструментов указанное число входных токенов не превышало значение без них |
| Согласованность числа входных токенов до и после кэширования (учёт использования и протокол кэша) | 3/3 | Поле чтения кэша не возвращено; подтвердить показание нельзя |
| Разнообразие при семплировании (ограничения вывода и параметры) | 1/3 | Повторяющиеся выводы при temperature 0 и 1 различались недостаточно и не достигли заранее установленного порога |
| Изоляция между запросами (контекст и состояние) | 1/3 | На первом шаге не был получен требуемый ответ только STORED, поэтому проверку изоляции продолжить не удалось |
Эти проверки исключаются из знаменателя: они не считаются ни пройденными, ни проваленными.
| Статус | Случай | Количество | Причина |
|---|---|---|---|
| Не наблюдалось | Последовательность остановки потоковой передачи | 3 | Запрос для этого шага не был отправлен после предыдущего, поэтому оценить результат невозможно |
| Неприменимо | Явный cache_control | 3 | Заранее отмечено как неподдерживаемое этим интерфейсом |
Некорректные messages и некорректный stream_options не сработали у всех пяти провайдеров: оба случая вернули код 400 с пустым телом, не предоставив клиенту структурированную ошибку. Сбой, общий для всех пяти, вероятнее всего, возникает на уровне шлюза AIHubMix и требует отдельного расследования. Учёт токенов thinking также не сработал у всех пяти, но по разным причинам: ByteDance и Fireworks указывали токены thinking даже при отключённом thinking, тогда как остальные три не возвращали их количество.
Сравнение с остальными четырьмя
P — скорость ответа: 37.77
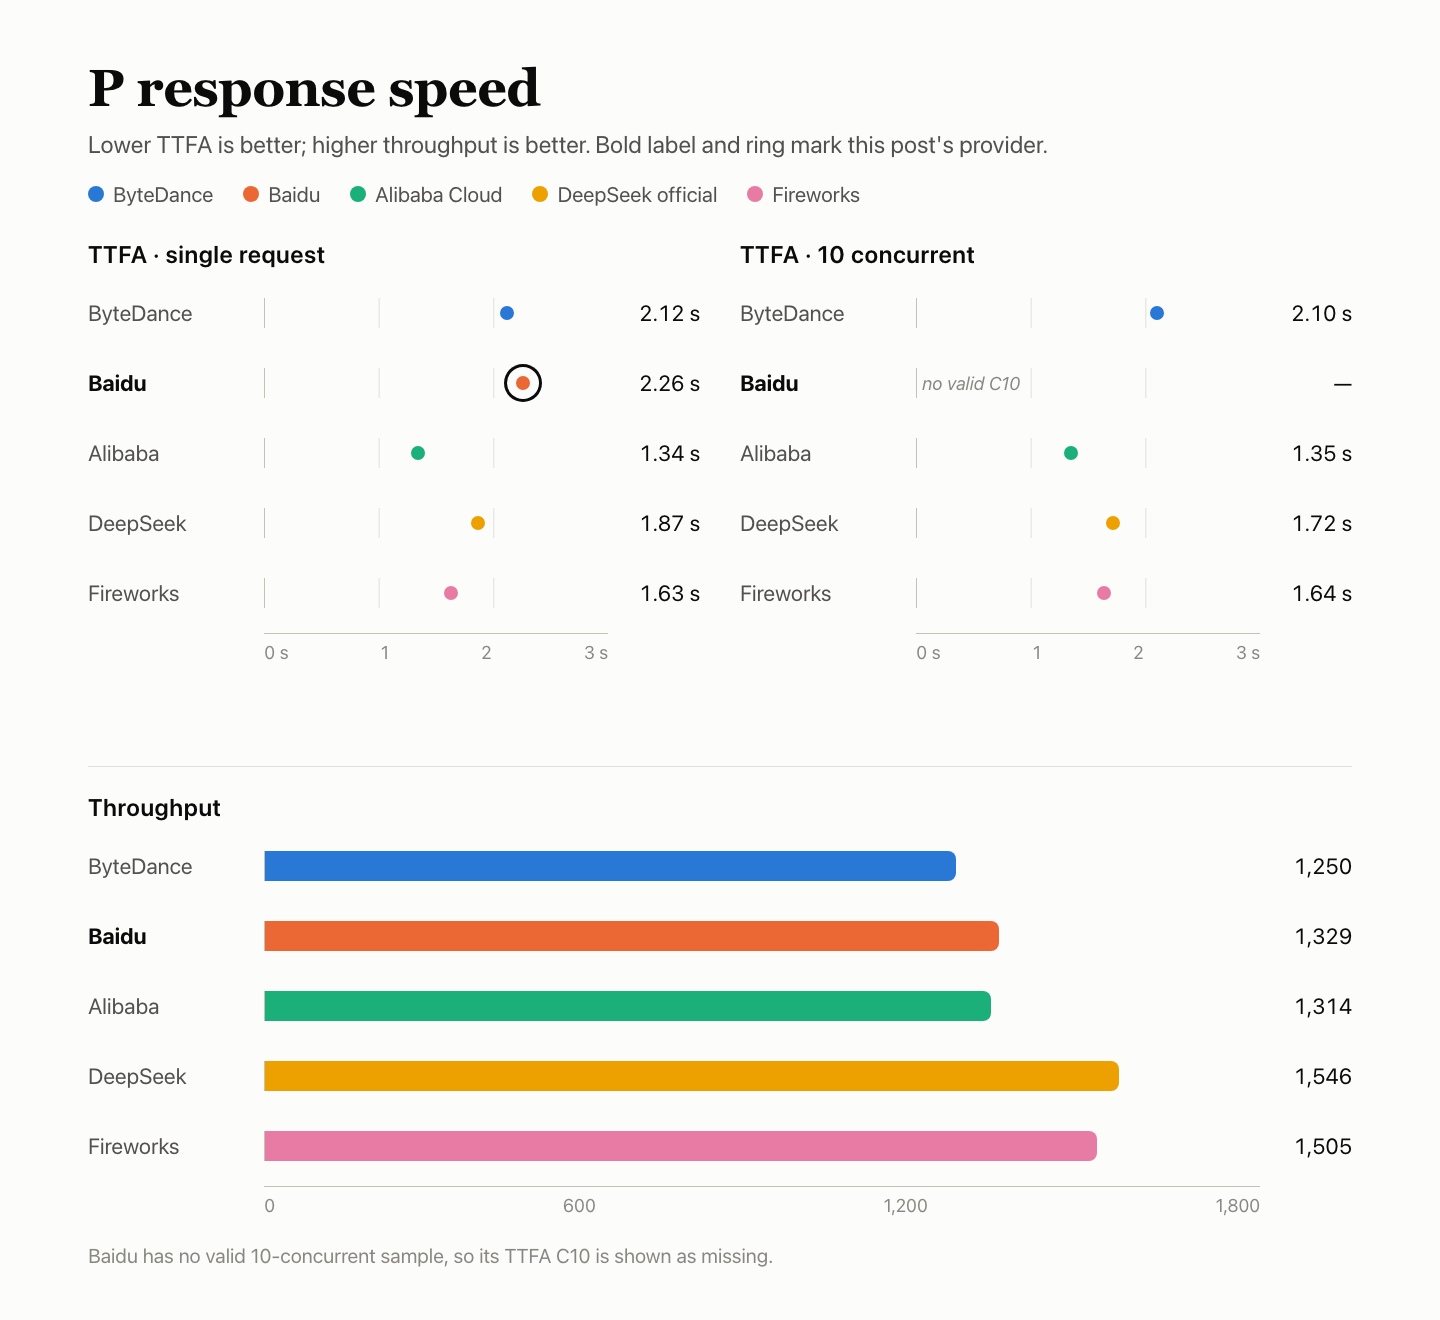
Каждый запрос содержал около 10,000 входных токенов и запрашивал ответ объёмом около 1,100 выходных токенов. В каждом из трёх окон отправляли по 30 проб с одним параллельным запросом и по 30 проб с десятью параллельными запросами — всего 180 запросов.
| Метрика | Результат |
|---|---|
| TTFA до первого токена | Один параллельный запрос: медиана 2.26 s (медиана действительных запросов — 2.05 s); десять параллельных запросов: более половины недействительны, медиана с учётом всех запросов считается равной бесконечности (медиана действительных запросов — 1.86 s) |
| Скорость генерации TPOT | Один параллельный запрос: 3.48 ms/токен; десять параллельных запросов: 50.00 ms/токен (более половины недействительны, применено штрафное значение) |
| Goodput (действительная пропускная способность) | Десять параллельных запросов: 1,329.2 токен/с |
| Действительные запросы | Один параллельный запрос: 78/90 (в первом окне 18/30); десять параллельных запросов: 40/90 (в первом окне 0/30, в третьем — 10/30) |
| Причина недействительности | 62 пробы вернули 400 no_available_channel |
| Оценка компонентов | TTFA 0.00, TPOT 0.00, пропускная способность 100.00; оценка ответа 30.00 |
| Структура P | Оценка ответа 30.00 с весом 80%, кэш K 68.85 с весом 20%, итог 37.77 |
TPOT оценивается по фрагментам потоковой передачи, а не измеряется для каждого токена на аппаратном уровне. Goodput — это количество действительных выходных токенов при десяти параллельных запросах, делённое на длительность пакета по часам.
В категории с десятью параллельными запросами 50 из 90 проб вернули no_available_channel. Поскольку недействительными оказались более половины проб, медианное время до первого токена считается равным бесконечности, а TTFA и TPOT получают штрафные значения. В категории с одним параллельным запросом действительными были 78 из 90 проб.
Все пять провайдеров использовали одну машину, сеть и учётную запись. Три окна планировались отдельно для каждого провайдера, поэтому периоды сбора данных совпадали не полностью; небольшие разрывы не следует переоценивать.
K — кэш: 68.85
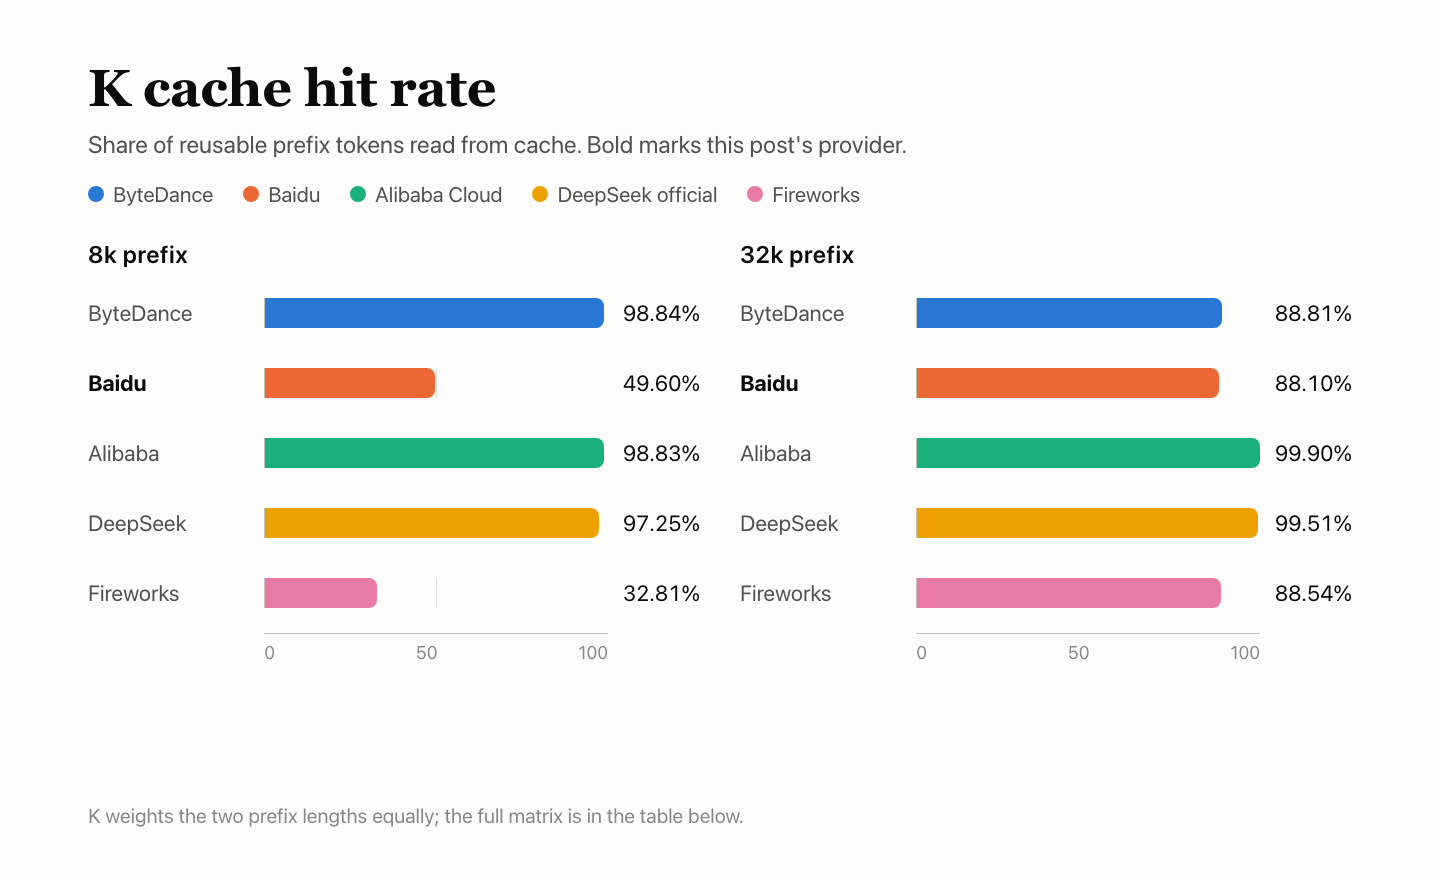
В каждой группе отправляется пять запросов. В первом используется фиксированный префикс примерно на 8k или 32k токенов, который заполняет кэш. В запросах 2–4 префикс сохраняется, меняется только вопрос в конце; интервалы между запросами составляют 5 s, 30 s и 120 s. В пятом запросе используется новый префикс для контрольной проверки без попадания в кэш. Три окна × две длины дают 30 запросов. K — это количество токенов, прочитанных из кэша горячими запросами, делённое на число токенов, которые согласно правилам должны повторно использоваться; обе длины имеют одинаковый вес. K составляет 20% от P.
В таблице указано количество токенов, прочитанных из кэша согласно данным сервера; «не возвращено» означает, что поле отсутствовало в ответе.
| Префикс | Окно | Заполнение кэша | +5 s | +30 s | +120 s | Контрольный запрос без попадания в кэш |
|---|---|---|---|---|---|---|
| 8k | 1 | Сбой | Сбой | Сбой | Не возвращено | Не возвращено |
| 8k | 2 | Не возвращено | 7,168 | 7,168 | Сбой | Сбой |
| 8k | 3 | Не возвращено | 7,168 | 7,168 | 7,168 | Не возвращено |
| 32k | 1 | Не возвращено | Не возвращено | 31,744 | 31,744 | Не возвращено |
| 32k | 2 | Не возвращено | 31,744 | 31,744 | 31,744 | Не возвращено |
| 32k | 3 | Не возвращено | 31,744 | 31,744 | 31,744 | Не возвращено |
Попадание в кэш для префикса 8k пришлось на 5 из 9 горячих запросов: из 72,252 токенов, которые можно было повторно использовать, было прочитано 35,840, что соответствует 49.60. Для префикса 32k попадание было в 8 из 9 запросов: прочитано 253,952 из 288,261, что соответствует 88.10. При равном весе двух длин K составляет 68.85. Всего не прошли пять запросов с префиксом 8k: начальный запрос, запросы через 5 с и 30 с в окне 1, а также запросы через 120 с и контрольный запрос без кэша в окне 2; для всех получена ошибка no_available_channel. Таким образом, в тарифе 8k не прошли три горячих запроса.
При попадании в кэш учитываемое значение округляется до блоков по 1,024 токена: 7,168 токенов для префикса 8k и 31,744 для префикса 32k. При отсутствии попадания блок usage не содержит prompt_tokens_details; в таблице указано «не возвращено», а значение считается равным 0.
В сравнении с остальными четырьмя
R — стабильность сервиса: 100
300 запросов относятся к четырём типам: короткий текст, длинный ввод, вызов инструмента и история диалога из нескольких ходов. Их отправляли с конкурентностью 1 в трёх временных окнах. Проверяется только то, был ли первый ответ корректным и полным; ответы не оцениваются, повторные попытки не выполняются. Ошибки во время проверки ответов и скорости учитываются в Q и P, а не в R.
| Тип запроса | Успех с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод 10k | 90/90 |
| Вызов инструмента | 60/60 |
| История диалога из нескольких ходов | 30/30 |
| Всего | 300/300, 95% ДИ 98.78%–100% |
Все 300 запросов с первой попытки вернули корректный и полный ответ. R 100 относится только к этим 300 специальным запросам; это не означает, что на всём пути не было ошибок. При 300 успешных запросах из 300 нижняя граница 95% интервала составляет 98.78%, поэтому доля ошибок, вероятно, ниже 1.22%.
В сравнении с остальными четырьмя
R относится только к этим 300 специальным запросам; ошибки во время проверки ответов и скорости учитываются в Q и P, а не в R.
| Провайдер | Успех с первой попытки | 95% интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Официальный канал DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часто задаваемые вопросы
Что означает общий балл?
Это сводный индекс без доверительного интервала, а не сертификация. В этой статье приведены показатели Q, F, P, K и R; рекомендаций по провайдерам она не содержит.
Почему половина проверок при конкурентности 10 завершилась ошибкой?
Для 50 из 90 запросов вернулась ошибка no_available_channel. Поскольку более половины результатов оказались недействительными, медианное время до первого токена считается бесконечным, а TTFA и TPOT получают штрафные значения.
Означает ли R 100, что ошибок канала не было?
Нет. R охватывает 300 специальных запросов, каждый из которых завершился успехом с первой попытки. 62 ответа no_available_channel во время проверки скорости и ошибки во время проверки ответов учитываются в P и Q.
Почему K равен 68.85, хотя попадание в кэш для префикса 32k было в 8 из 9 случаев?
Обе длины имеют одинаковый вес. Для префикса 8k попадание в кэш было в 5 из 9 горячих запросов, а оценка составила 49.60; для префикса 32k — в 8 из 9, оценка 88.10. Среднее значение — 68.85.
Можно ли отличить качество ответов Baidu от официального канала?
Да. Разница по совокупному показателю Q составляет −4.46 процентного пункта, а 95% интервал от −5.78 до −3.16 не включает 0. Это единственный результат провайдера ниже официального канала, для которого интервал не включает 0.
Какие проверки не вошли в F?
Шесть: три проверки стоп-последовательности в потоковой передаче, которые не удалось провести, поскольку запрос на предыдущем шаге не был отправлен, и три явные проверки cache_control, заранее отмеченные как неподдерживаемые этим интерфейсом.
Читайте дальше: серия статей о DeepSeek V4.1 Flash
- Точность BFCL у Baidu была близка к показателю официального канала; в статье о ByteDance та же серия тестов охватывает вызовы инструментов и учёт токенов: DeepSeek V4.1 Flash на ByteDance: вызовы инструментов совпадают, учёт — нет
- TTFA Baidu при конкурентности 1 — 2.26 с; для сравнения, в другом запуске показатель достиг 1.34 с: DeepSeek V4.1 Flash на Alibaba Cloud: первый токен за 1.34s, попадание в кэш 99.37
- Показатель F Baidu — 88.39; для сравнения, в эталонном запуске он составил 94.00 при 15 недействительных проверках: DeepSeek V4.1 Flash на официальном канале: 94.00 F, 15 недействительных проверок
- Для кэша 8k у Baidu попаданий было 5/9; для сравнения, в другом запуске — 3/9 и пустые ответы при остановке: DeepSeek V4.1 Flash на Fireworks: пустые ответы при остановке, 3/9 попаданий в кэш


