
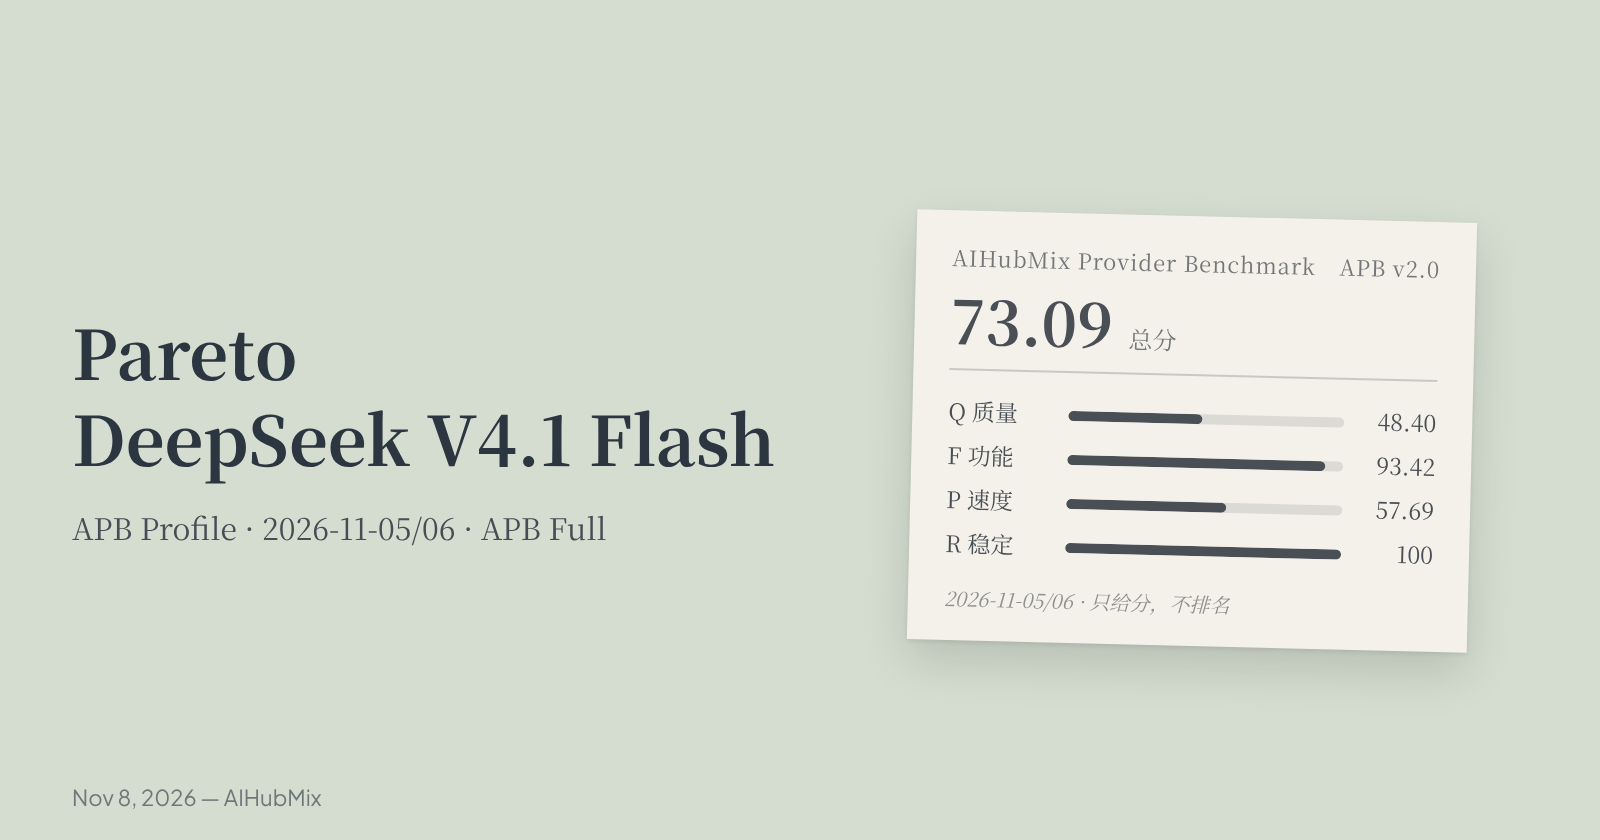
05–06.11.2026 DeepSeek V4.1 Flash 1017 прошла полный набор AIHubMix Provider Benchmark (APB) на Pareto. Результаты: Q 48.40, F 93.42, P 57.69, K 27.58 и R 100; общий индекс — 73.09. Этот профиль APB охватывает только Pareto. Модель указана как DeepSeek V4.1 Flash 1017.
В этой статье приводятся только результаты, без рейтинга и рекомендаций по провайдерам. Сначала идут Q, F, P, K и R; общий индекс — сводное число без доверительного интервала. Стандарт: AIHubMix Provider Benchmark Standard v2.0.
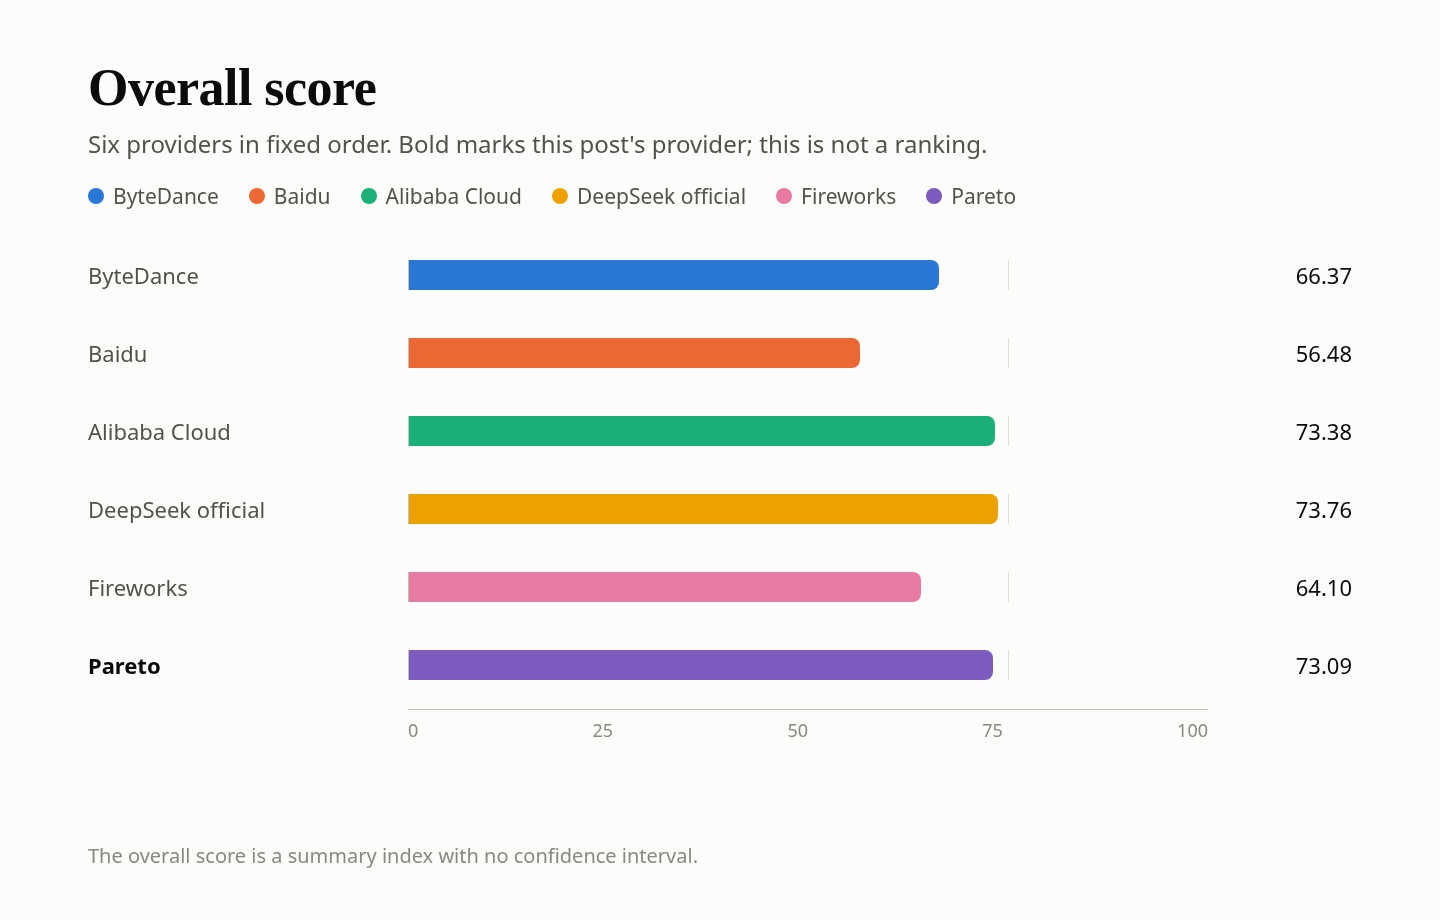
Результаты у шести провайдеров
Полужирным выделен провайдер, которому посвящена эта статья. Фиксированный порядок провайдеров, не рейтинг. K — подоценка P с весом 20%. Общий индекс — сводное число без доверительного интервала. Разница между официальным каналом DeepSeek и Alibaba Cloud составляет 0.37, статистически различить их нельзя.
Краткий обзор
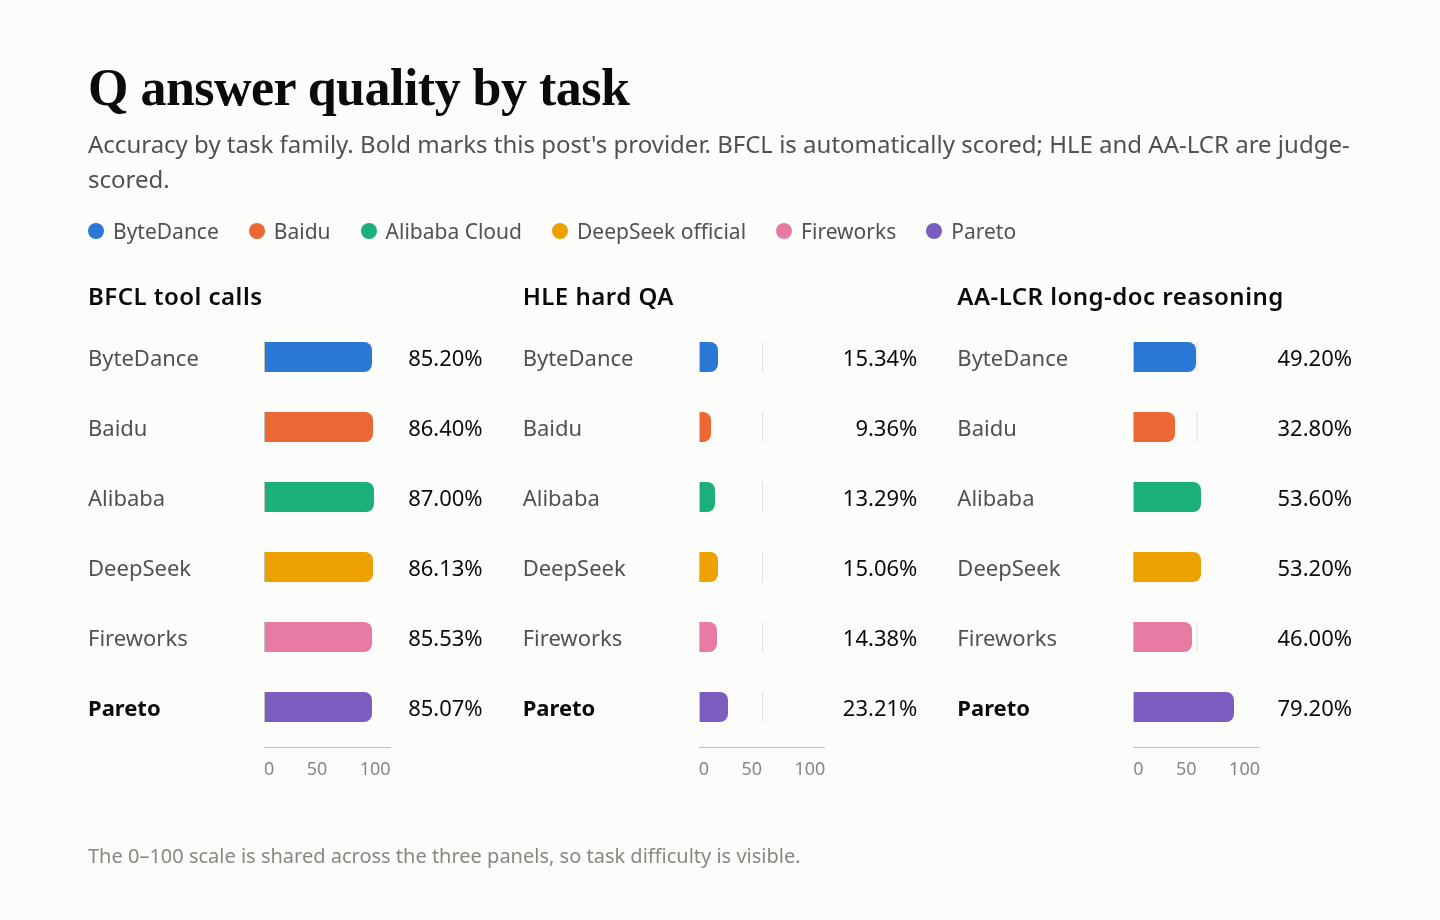
- Q — качество ответов: 48.40. BFCL — 85.07%, HLE — 23.21%, AA-LCR — 79.20%. По сравнению с официальным каналом: +5.94 процентного пункта, 95% ДИ от +3.54 до +8.36. В HLE произошло 996 сбоев сервиса; большинство ответов были усечены, поскольку thinking израсходовал лимит длины вывода. Они засчитываются как неправильные.
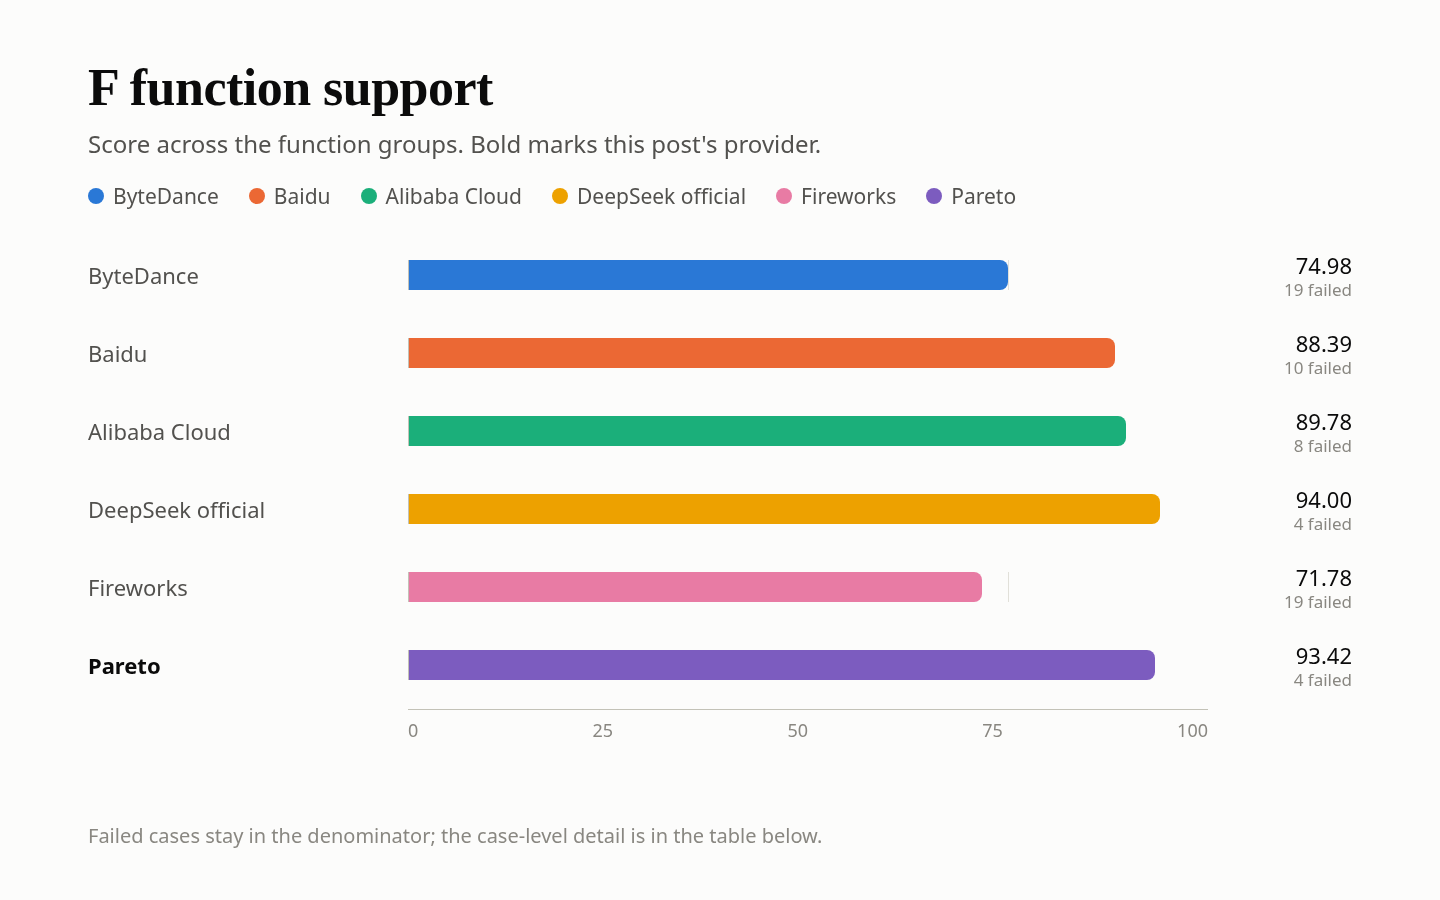
- F — поддержка функций: 93.42. Пройдены 29 из 33 учитываемых проверок (потоковая передача — 23/27, ошибки — 3/3, учёт использования — 3/3). 147 проверок не вошли в знаменатель. Из 4 неудачных проверок в 3 запросах с последовательностью stop возвращались пустые тела, а в 1 случае текстовый образец для потоковой передачи не совпал точно.
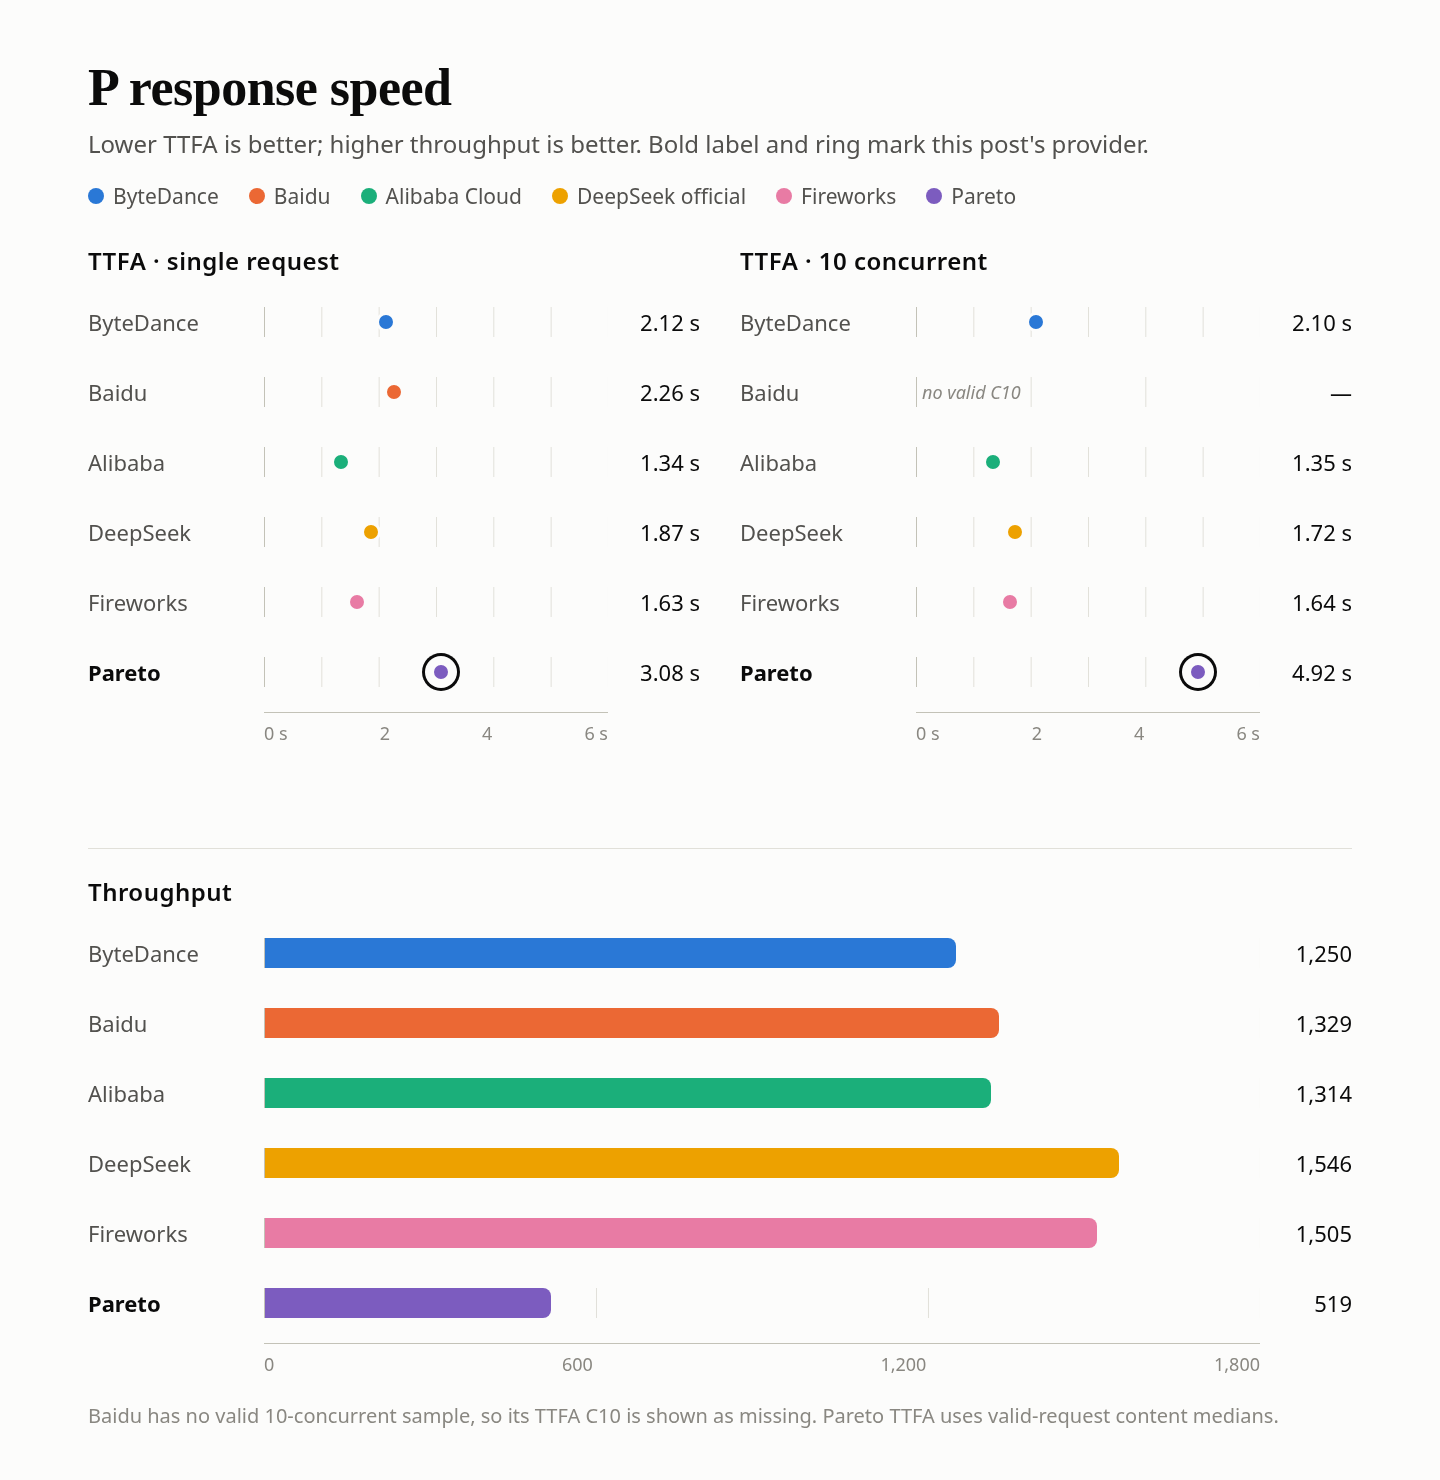
- P — скорость ответа: 57.69. Оценка скорости ответа — 65.22, кэш K учитывается с весом 20%. Медианы TTFA для корректных запросов: 3.08 с при одиночном запросе и 4.92 с при 10 параллельных запросах; медианы для оценки, включая некорректные запросы, — 5.85 с и 6.13 с. Корректными были 110 из 180 проверочных запросов; 70 оказались некорректными, поскольку thinking израсходовал лимит вывода для теста скорости.
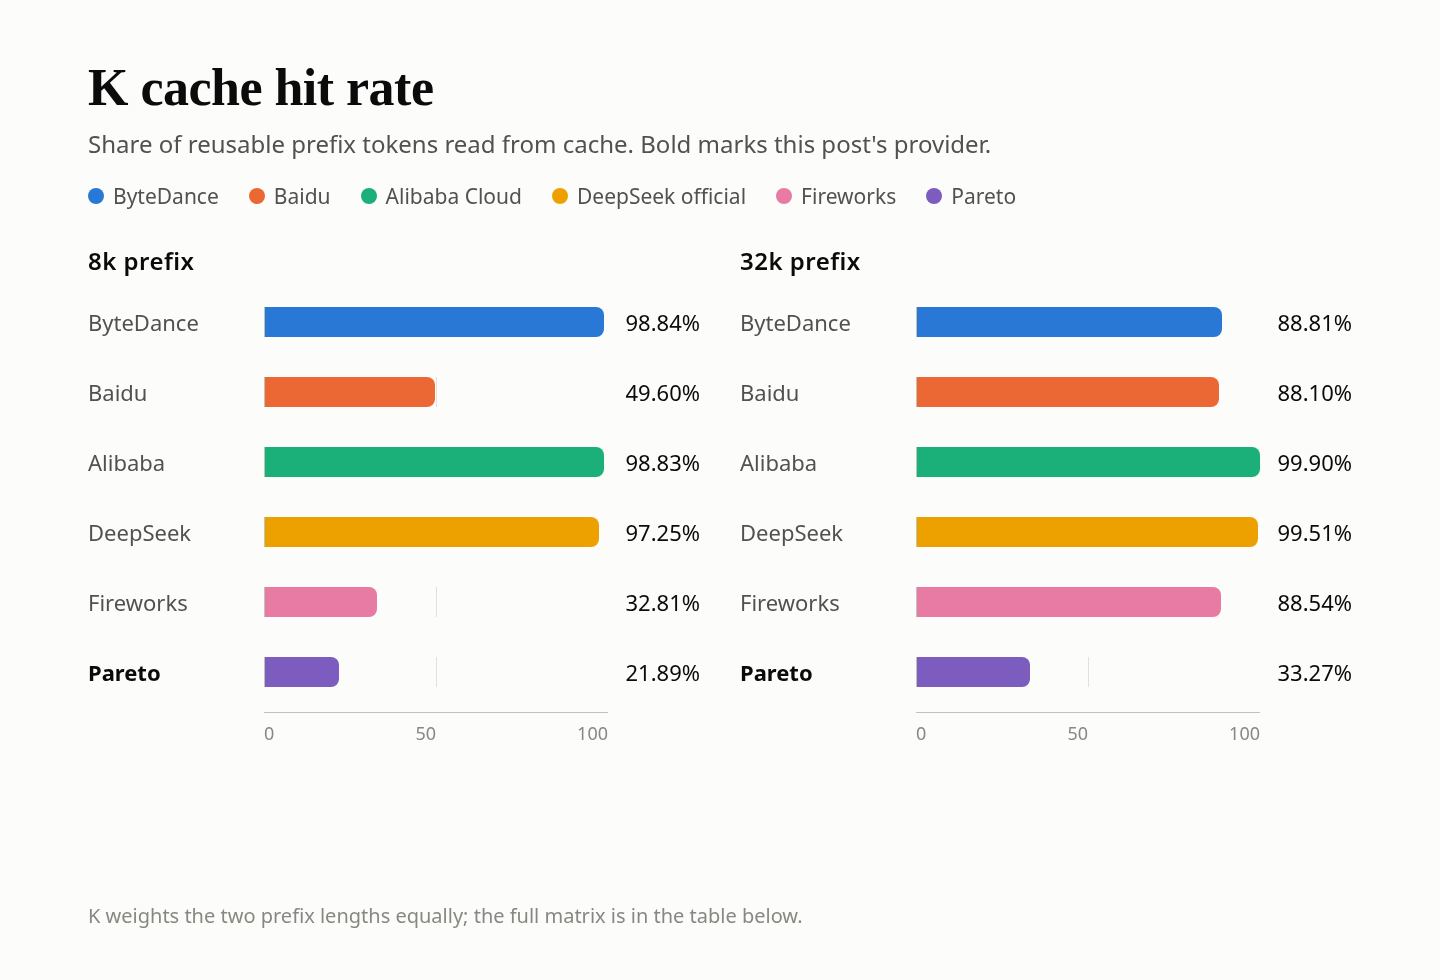
- K — кэш: 27.58. 8k: 2/9 попаданий в горячий кэш (прочитано 15,872 / можно повторно использовать 72,504); 32k: 3/9 (прочитано 96,000 / можно повторно использовать 288,513). Оценка рассчитана для конфигурации по умолчанию.
- R — стабильность сервиса: 100. Все 300/300 выделенных запросов успешно выполнены с первой попытки.
Настройки тестирования
| Параметр | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | deepseek/deepseek-v4.1-flash |
| Маршрут доступа | Pareto, с указанным выше ID модели |
| Параметры | temperature 1.0, max_tokens 16,384, timeout 300 s; только запросы с потоковой передачей |
| Thinking | Включён режим thinking с высокой интенсивностью |
| Время | 05–06.11.2026 UTC+8; кэш повторно протестирован 06.11.2026 с конфигурацией по умолчанию |
| Выборка | Q — 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F — 60×3; P — 90+90; R — 300; K — 30 |
| Примечания | В этом запуске использовался thinking с высокой интенсивностью; остальные пять провайдеров серии работали без него. Поддержка функций оценивается по подмножеству, доступному при потоковой передаче; для кэша используется конфигурация по умолчанию. |
Запросы отправлялись с помощью AIHubMix краткого руководства; ID моделей доступны на странице моделей.
Q — качество ответов: 48.40
В набор вошли 500 вопросов BFCL × 3 раунда, 250 вопросов HLE × 10 и 25 вопросов AA-LCR × 10. BFCL оценивался автоматически; HLE и AA-LCR проверялись с помощью deepseek-flash. Во всех трёх категориях использовались те же задания, что и для остальных провайдеров. Десять ответов, которые невозможно было оценить, исключили; осталось 4,240 оцениваемых случаев.
| Задание | Вопросы | Правильные ответы | Точность | Сбои |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Сложные вопросы и ответы HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Итого · 95% ДИ 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Сбои остаются в знаменателе и засчитываются как неправильные ответы: 996 ответов HLE были усечены, поскольку thinking израсходовал лимит длины вывода. Из 1,494 попыток HLE, в которых был получен полный ответ, правильными оказались 578 (около 38.7%).
| Категория BFCL | Пройдено | Доля пройденных |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
В simple_python пройдены 333/360 проверок (92.50%), в multiple — 269/300 (89.67%), в ahm_multi_turn — 102/150 (68.00%), а в irrelevance — 104/150 (69.33%).
В сравнении с остальными пятью
Разница в процентных пунктах относительно официального канала; 95% интервал показан усами. Если интервал пересекает 0, результаты статистически неразличимы. Оценка deepseek-flash проводится моделью того же семейства и не откалибрована, поэтому она может быть снисходительной.
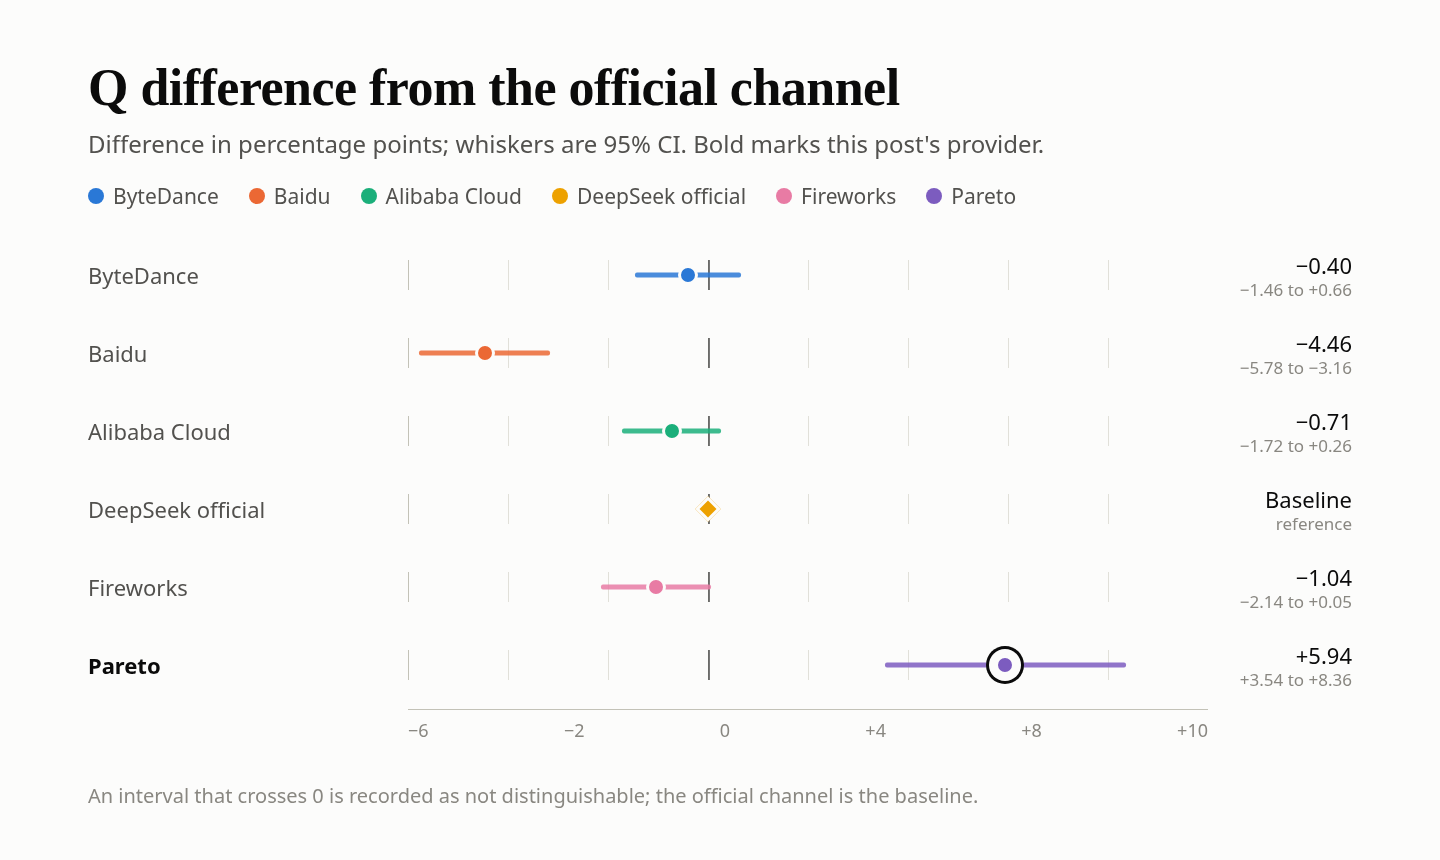
Численная разница с официальным каналом составляет +5.94 (+3.54–+8.36).
F — поддержка функций: 93.42
Из 33 учитываемых проверок пройдены 29; 147 не учитывались. Значение 93.42 получено путём перенормировки исходных весов групп по наблюдавшимся группам (потоковая передача — 20%, ошибки — 15%, учёт использования — 10%; всего 45%). Простая доля пройденных проверок 29/33 составляет 87.88%. Инструменты, ограничения и контекст вообще не учитывались.
| Группа проверок | Вес | Пройдено | Исключено | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и обмен сообщениями | 20% | 23/27 | 3 | 85.19 |
| Интерфейс инструментов | 20% | — | 30 | — |
| Ограничения на вывод | 20% | — | 30 | — |
| Контекст и состояние | 15% | — | 30 | — |
| Ошибки и восстановление | 15% | 3/3 | 27 | 100.00 |
| Учёт использования и кэш | 10% | 3/3 | 27 | 100.00 |
| Учтено / взвешенная оценка | — | 29/33 | 147 | 93.42 |
«Окна с ошибками» — число окон, в которых проверка не была пройдена.
| Неудачная проверка | Окон с ошибками | Причина |
|---|---|---|
| Остановка потоковой передачи | 3/3 | Пустое тело при stop |
| Текст при потоковой передаче | 1/3 | В конце тела добавлена лишняя точка по сравнению с образцом |
В сравнении с остальными пятью
P — скорость ответа: 57.69
Для оценки используется время до первого токена содержимого, а не время до первого токена любого типа. При включённом thinking модель выдаёт содержимое thinking до видимого текста ответа, поэтому ожидание содержимого дольше ожидания первого пакета. В каждом из трёх окон отправляли 30 запросов при параллельности 1 и 30 при параллельности 10, всего 180 запросов.
| Метрика | Результат |
|---|---|
| TTFA до содержимого | Медианы для оценки: 5.85 с (c=1) и 6.13 с (c=10); медианы для корректных запросов: 3.08 с и 4.92 с |
| До первого токена любого типа | Медианы для корректных запросов: 1.46 с и 1.76 с |
| TPOT | Более медленный диапазон для оценки: 4.87 мс/токен |
| Goodput | 519 токенов/с при параллельности 10 |
| Корректные | 53/90 при c=1 и 57/90 при c=10, всего 110/180; 70 запросов некорректны, поскольку thinking израсходовал лимит вывода для теста скорости (~2,048 токенов) |
| Компоненты | TTFA 24.59, TPOT 100.00, goodput 72.05; оценка скорости ответа — 65.22 |
| Структура оценки P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Токены thinking не учитываются в числителе goodput.
K — кэш: 27.58
Суммарные данные о чтении получены при повторном тестировании 06.11.2026 с конфигурацией по умолчанию. Матрицы кэша для отдельных запросов не включены (исходные трассировки не переносились). Вес двух длин префикса в K одинаковый; K составляет 20% от P.
| Префикс | Попадания в горячий кэш | Прочитано / можно повторно использовать | Сегмент |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (равные веса) | 27.58 |
Холодные контрольные проверки пройдены: 6/6 для каждой длины.
R — стабильность сервиса: 100
300 запросов охватывали короткий текст, длинный ввод, вызовы инструментов и многошаговую историю при параллельности 1. Проверялись только корректность и полнота первого ответа; ответы не оценивались, повторных попыток не было. Сбои Q и P здесь повторно не учитываются.
| Тип запроса | Успешно с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод 10k | 90/90 |
| Вызов инструментов | 60/60 |
| Многошаговая история | 30/30 |
| Итого · 95% ДИ 98.78%–100% | 300/300 |
Часто задаваемые вопросы
Что учитывает Q 48.40?
BFCL, HLE и AA-LCR по 4,240 оцениваемым случаям: 2,052 правильных ответа, 48.40%, 95% ДИ 45.39%–51.26%. Численная разница с официальным каналом составляет +5.94 (+3.54–+8.36).
Почему произошло 996 сбоев сервиса в HLE?
Большинство ответов были усечены, поскольку thinking израсходовал лимит длины вывода; они остаются в знаменателе и засчитываются как неправильные.
Почему оценка F равна 93.42, если 147 проверок исключены?
Учитывается только подмножество проверок, доступное при потоковой передаче. Веса групп перенормируются по наблюдавшимся группам; инструменты, ограничения и контекст вообще не учитываются.
Почему проверки с stop не были пройдены?
Во всех трёх окнах запросы с последовательностью stop возвращали пустое тело.
Почему 70 из 180 проверочных запросов скорости оказались некорректными?
Thinking израсходовал лимит вывода для теста скорости (около 2,048 токенов).
Что учитывает R 100?
300 выделенных запросов; все корректны с первой попытки. Нижняя граница 95% ДИ — 98.78%. Сбои Q и P не учитываются в R.
Читайте дальше: серия тестов DeepSeek V4.1 Flash
- ByteDance зафиксировал токены thinking после его отключения: DeepSeek V4.1 Flash на ByteDance: вызовы инструментов совпадают, учёт использования — нет
- Baidu показал Q 38.00 и P 37.77: DeepSeek V4.1 Flash на Baidu: ни один доступный канал не достигает целевых Q и P
- В Alibaba Cloud зафиксированы 1.34 с до первого токена и кэш 99.37: DeepSeek V4.1 Flash на Alibaba Cloud: 1.34 с до первого токена, кэш 99.37
- Официальный канал служит базовым для Q, его оценка F — 94.00: DeepSeek V4.1 Flash в официальном канале: F 94.00, 15 некорректных проверочных запросов
- Fireworks возвращал пустые ответы при stop и показал 3/9 попаданий в кэш при 8k: DeepSeek V4.1 Flash на Fireworks: пустые ответы при stop, 3/9 попаданий в кэш


