A Anthropic lançou Claude Fable 5.2 em 9 de novembro de 2026. Um dia depois, o Google disponibilizou Gemini 4 Carbon em geral. A própria tabela de benchmarks de lançamento da Anthropic inclui uma coluna para Carbon, o que torna esta uma comparação útil para a mesma carga de trabalho de programação de longa duração.
Os dois modelos são vendidos para a mesma tarefa: programação agêntica de longa duração. O agente lê um repositório, edita vários arquivos, executa comandos, examina a saída dos testes e continua trabalhando por 15 a 45 minutos sem intervenção humana. Essa é a tarefa avaliada aqui. Chat, preenchimento automático e scripts curtos são testes diferentes.
A resposta curta
Fable lidera os benchmarks de programação difíceis apresentados e é mais rápido com o mesmo nível de esforço, ocupando as três primeiras posições AA à frente de Carbon High, em #4. Carbon tem pontuações mais altas nas linhas de Terminal-Bench 4.0 e AutomationBench-AA apresentadas e custa menos por tarefa com esforço High até o fim do preço promocional do Google, em 30 de novembro. No nível Medium, Fable custa menos e é muito mais rápido, enquanto Carbon tem uma pontuação mais alta no índice AA.
Escolha Fable para raciocínio avançado sobre código e Carbon para execução no terminal e automação; verifique os limites de entrada, retenção e saída antes de usar qualquer um dos dois.
O que mostra um único harness
Artificial Analysis testa todos os modelos no mesmo harness e nas mesmas tarefas; as páginas de Carbon e Fable apresentam os resultados de cada avaliação. Os números são do snapshot de 11 de novembro de 2026; a AA usa os preços de tabela padrão, não o desconto promocional do Google.
| Modelo | Índice AA | $/tarefa | Min/tarefa | Primeiro token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Observação: índice de inteligência da AA e custo por tarefa com preços padrão, snapshot 2026-11-11T05:23Z. Fable Max, Xhigh e High ocupam as posições #1 a #3; Carbon High está em #4; Opus 5.5 Max, em #5; Carbon Medium, em #6. Primeiro token é o tempo até o primeiro token da resposta.
Com esforço High, Fable está 1.79 pontos à frente, custa 17.0% a mais por tarefa ($9.08 contra $7.76), termina em 17.3 minutos em vez de 25.6 e retorna o primeiro token em 30.4 segundos em vez de 67.1. Max custa $26.54 por tarefa, 3.4 vezes mais que Carbon High, e leva 233.9 segundos para responder.
No nível Medium, a ordem muda: Fable pontua 56.41, contra 58.26 de Carbon, ficando 1.85 pontos abaixo, mas custa $3.80, contra $6.59, e leva 7.8 minutos, contra 23.3. O preço mais baixo por token de Carbon não o torna mais barato por tarefa neste caso: ele usa mais tokens.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| % sem alucinações | 88.58 | 42.02 | 40.73 | 49.66 |
| Precisão % | 58.27 | 77.23 | 79.13 | 65.5 |
| Elo do Briefcase | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Observação: Artificial Analysis, mesmo harness e snapshot. Ausência de alucinações é a proporção de respostas de Omniscience sem afirmações inventadas; precisão é uma pontuação separada. Quanto maior, melhor em todas as linhas. Fable Xhigh foi omitido para facilitar a leitura da tabela; sua pontuação no FrontierCode 2.0 é 47.58.
Qual modelo lidera em cada teste com esforço High? A diferença com sinal abaixo subtrai Fable de Carbon; assim, fica clara a direção, enquanto a tabela acima mostra as pontuações absolutas.
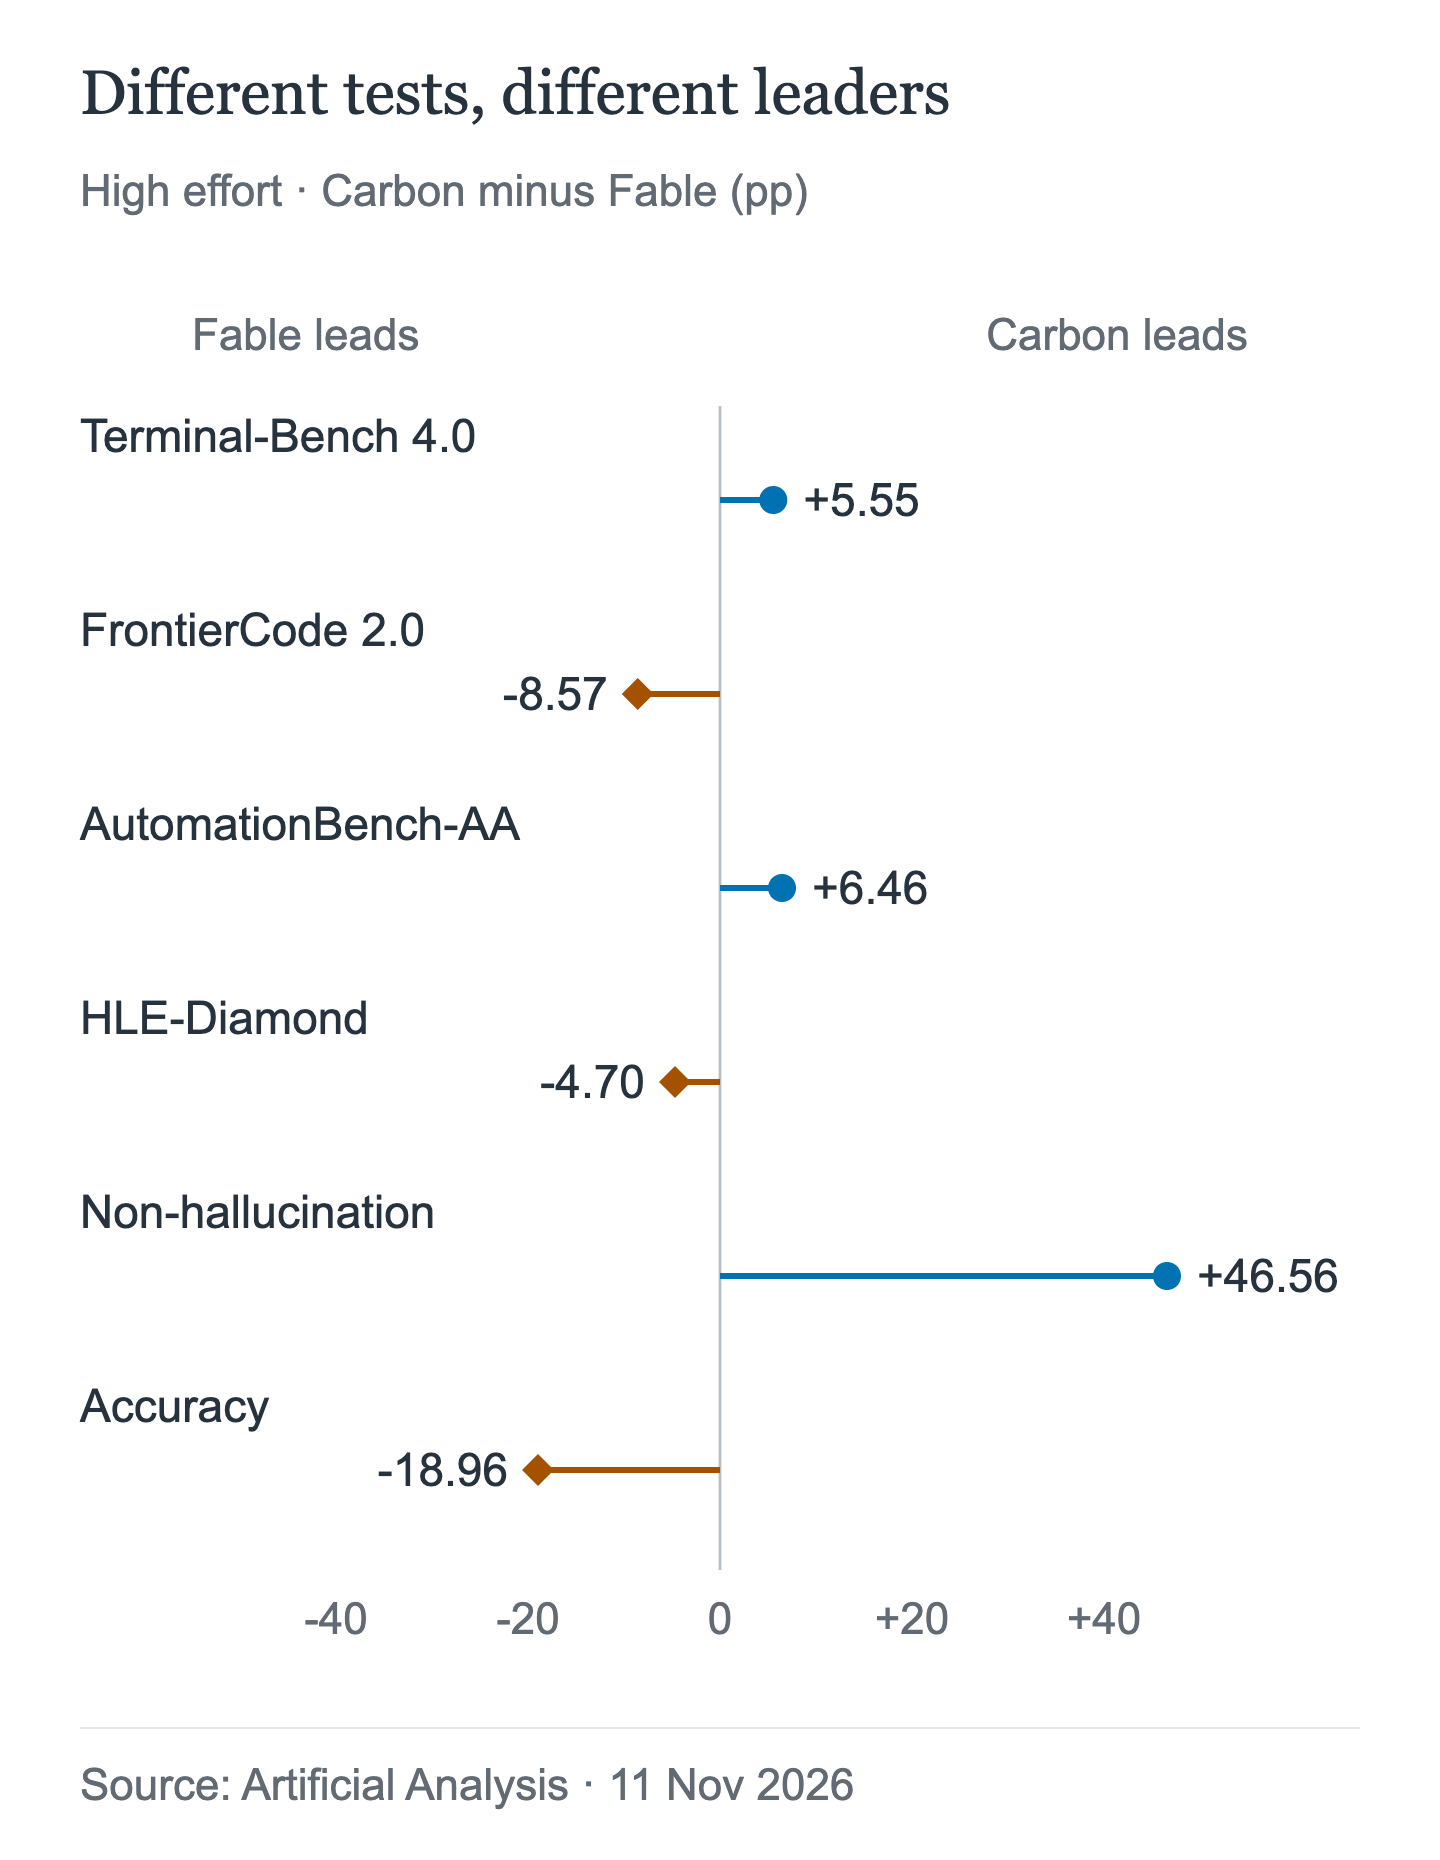
Essas são diferenças em pontos percentuais entre testes independentes, não uma pontuação de qualidade combinada. Uma diferença maior em um benchmark não significa uma melhora geral maior. Em particular, ausência de alucinações e precisão medem resultados diferentes.
Fable supera Carbon no FrontierCode 2.0 por 8.57 pontos com esforço High e no HLE-Diamond por 4.7; o Elo do Briefcase é 1677.4 contra 1610.6. FrontierCode é o benchmark mais próximo de mudanças difíceis em vários arquivos de código. Carbon vence no Terminal-Bench 4.0 por 5.55 e no AutomationBench por 6.46, benchmarks que avaliam execução na linha de comando, recuperação de erros e automação.
A diferença na ausência de alucinações é a maior da tabela: 88.58% para Carbon contra 42.02% para Fable com esforço High. A precisão aponta na direção oposta: 58.27% contra 77.23%. Carbon tem menos chances de inventar informações, mas também menos chances de responder corretamente. Para um agente que não pode inventar uma API, isso pode valer a pena; para um agente que precisa responder, a precisão de Fable é o indicador mais favorável.
Mais esforço não significa sempre resultados melhores: a pontuação de Fable Max no FrontierCode, 48.76, fica ligeiramente abaixo dos 49.13 de High, e no Terminal-Bench continua em 59.6.
A própria tabela da Anthropic
A página de lançamento da Anthropic publica uma tabela de comparação entre fornecedores que inclui Carbon. As configurações diferem das da AA: Fable é executado com Xhigh, o nível de esforço mais alto apresentado, e Carbon com Medium. Compare os resultados apenas dentro desta tabela.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Elo do Briefcase | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Observação: dados informados pela própria Anthropic. Fable com Xhigh, seu nível de esforço mais alto disponível; Carbon com Medium. A escala de AutomationBench da Anthropic difere da da AA (51.4/53.9 contra 71.36/77.82), então compare os resultados dentro desta tabela. Os 41.1 de Carbon no FrontierCode correspondem a uma execução com Medium; os 40.56 da AA são com High, em outro harness.
A tendência coincide com a da AA: Fable lidera no FrontierCode, FrontierSWE, OSWorld e TB-Science; Carbon lidera no AutomationBench por 2.5 pontos, uma diferença menor que os 6.5 da AA, mas na mesma direção. A tabela sustenta a afirmação de que “Carbon é competitivo em automação”, não a de que “Carbon é o melhor modelo para programação avançada”.
A própria recomendação da Anthropic complica a ideia de que “Fable é a atualização”: “Para a maioria das tarefas de programação e conhecimento, recomendamos que os usuários comecem com Claude Opus 5.5.” A empresa afirma que, com esforço High, Fable pontua aproximadamente o mesmo que o melhor resultado do Opus 5.5 (45.3% contra 45.5%) por cerca de metade do custo por tarefa.
Quanto custam os tokens
| Modelo | Entrada | Saída | Leitura do cache |
|---|---|---|---|
| Carbon, até 30 de nov. | $2 | $10 | $0.10 |
| Carbon, a partir de 1º de dez. | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Observação: USD por 1M de tokens, preços oficiais. Gravações no cache de Fable: $10 (5 min) ou $16 (1 hora); 50% de desconto no Batch. O valor de Carbon com cache é o preço de leitura; o preço oficial de leitura do cache de Opus 5.5 é $0.20.
O preço por token de Fable é o dobro da tarifa padrão de Carbon e quatro vezes maior que a tarifa promocional. A proporção é simples; a conta por tarefa, não. A AA mediu $7.76 por tarefa para Carbon High a $4/$20, contra $9.08 para Fable High, uma diferença de 17.0%. Com a tarifa de $2/$10 do Google, o mesmo uso custa cerca de $3.88, uma estimativa calculada. Até 30 de novembro, Fable High custa cerca de 2.3 vezes mais por tarefa; a partir de 1º de dezembro, a diferença volta a 17.0%.
Com os preços padrão, Fable Medium custa $3.80, contra $6.59 de Carbon, ou seja, 42% menos, apesar de o preço por token ser duas vezes maior. Carbon leva 23.3 minutos e usa mais tokens; Fable leva 7.8. Com a tarifa promocional, Carbon Medium custa cerca de $3.30, calculado da mesma forma, próximo do preço de Fable; essa vantagem desaparece em 1º de dezembro.
Por tarefa, Max custa 3.4 vezes mais que Carbon High ($26.54) e leva 45.2 minutos. Gastar mais não garante um agente de programação uniformemente melhor: a pontuação de Max no FrontierCode é ligeiramente inferior à de High.
A AIHubMix lista Carbon pelo preço promocional do Google. Os valores de Fable apresentados aqui são as tarifas oficiais da Anthropic.
Diferenças de comportamento que determinam a implantação
| Dimensão | Carbon | Fable 5.2 |
|---|---|---|
| Saída máxima | 65,536; nativo ≤1,048,576−entrada* | 128,000 |
| Contexto | 1,048,576 (nativo do Google) | 1M |
| Pensamento | low / medium / high; padrão medium | adaptativo; padrão high |
| Ferramentas forçadas | auto documentado* | qualquer uma / ferramenta retorna 400 |
| Amostragem | ignorada; remover | alguns valores retornam 400 |
| Retenção | limite não informado | 30 dias; sem ZDR |
| Entrada | texto na AIHubMix | texto, imagem, PDF† |
| Data de corte | março de 2026 | junho de 2026 |
Observação: *Os limites mais altos de Carbon correspondem aos recursos nativos do Google para decodificação longa; no momento, a AIHubMix documenta apenas entrada de texto e Chat Completions, então o suporte do gateway não está confirmado. †As modalidades de entrada de Fable vêm do índice de modelos da AIHubMix. *A AIHubMix documenta tool_choice="auto", mas o suporte específico para Carbon não está confirmado. O limite de saída documentado para o modelo Fable é 128,000. ZDR significa retenção zero de dados.
O uso forçado de ferramentas é um impedimento decisivo para Fable: “O uso forçado de ferramentas (tipos any e tool de tool_choice) retorna um erro 400.” Um agente que precisa chamar uma ferramenta específica a cada turno não pode usar Fable sem alterações. O guia de Carbon do Google recomenda turnos sequenciais de execução de ferramentas; a AIHubMix documenta tool_choice="auto" no guia do Gemini, mas o suporte específico para ferramentas de Carbon no gateway ainda não está confirmado.
A retenção é um impedimento de política para Fable, cuja visão geral diz que “exige retenção de dados por 30 dias e não está disponível sob retenção zero de dados, a menos que expressamente autorizado pela Anthropic”. A documentação de Carbon, conforme consultada aqui, não menciona essa restrição; isso não é uma garantia. Equipes sujeitas a regulamentações devem confirmar as políticas de ambos antes da implantação.
O limite padrão de 65,536 tokens de Carbon cobre a maioria das edições; a geração de arquivos inteiros pode atingir esse limite. O modo nativo de segundo plano do Google pode chegar a 1,048,576 menos a entrada, cobra pelas etapas de segmentação e pode retornar incomplete com o texto vazio, mesmo assim cobrando pelo uso. A AIHubMix não documentou esse fluxo. Os 128,000 tokens de Fable chegam em uma única resposta.
Nenhum dos modelos permite desativar o modo de pensamento. Carbon oferece low, medium e high, usa medium por padrão e ignora os parâmetros de amostragem. O “pensamento adaptativo está sempre ativado e não pode ser desativado” em Fable, cujo padrão é high e que retorna 400 para alguns valores de amostragem.
O Google disponibilizou Carbon para defensores por meio de seu programa Fairwind antes do lançamento geral. Os classificadores de Fable bloqueiam solicitações de testes de penetração e exploração de vulnerabilidades e recorrem a outros modelos para tarefas de cibersegurança e biologia. Em testes de segurança, o comportamento diante de recusas importa mais do que uma linha de benchmark.
Opus 5.5 como referência
Opus 5.5 não é o concorrente, mas é a referência escolhida pela própria Anthropic. A $4/$20, pontua 59.11 na AA, custa $10.04 por tarefa, leva 25.0 minutos e demora 356.4 segundos para retornar o primeiro token, o tempo mais longo da tabela (a linha da AA é com esforço Max; o padrão é Medium). Lidera no Elo do Briefcase, com 1800.6, mas fica atrás de Fable High no FrontierCode e de Carbon High no Terminal-Bench. Ainda assim, a Anthropic recomenda Opus 5.5 como ponto de partida para a maioria das tarefas de programação.
Quem deve escolher cada modelo
Escolha Fable 5.2 quando mudanças complexas no código forem a prioridade e você quiser os melhores resultados medidos no FrontierCode e no HLE. No nível Medium, é mais barato e mais rápido — $3.80 e 7.8 minutos, contra $6.59 e 23.3 de Carbon —, enquanto Carbon pontua mais alto no índice AA. Escolha Fable se precisar de entrada de imagem, de uma data de corte de junho de 2026 ou se a retenção de 30 dias e a impossibilidade de forçar chamadas de ferramentas forem aceitáveis.
Escolha Carbon quando o trabalho no terminal for predominante: ciclos de teste e correção, automação de shell e operações em várias etapas. Ele tem pontuações mais altas nas linhas indicadas do Terminal-Bench 4.0 e do AutomationBench-AA e custa menos no nível High effort até 30 de novembro. O contexto nativo do Google e os limites de saída longa não estão confirmados no AIHubMix; implante-o apenas com texto e tool_choice="auto" somente após confirmar o suporte a ferramentas do Carbon. Sua pontuação de não alucinação é maior, enquanto sua precisão é menor.
Escolha Opus 5.5 como ponto de partida recomendado pela Anthropic e por seu perfil equilibrado; aceite o primeiro token lento no nível Max effort.
Não escolha nenhum dos dois para latência interativa: os primeiros tokens no nível High effort levam 30.4 segundos com Fable e 67.1 com Carbon, e os 23.2 segundos do Carbon Medium ainda estão longe da velocidade de um chat.
Execute ambos pelo AIHubMix
O AIHubMix disponibiliza os dois modelos com uma única chave e um endpoint compartilhado de chat completions. O ID do Carbon é gemini-4-carbon; a página do modelo documenta chat completions, entrada de texto e o preço introdutório do Google. O ID do Fable 5.2 é claude-fable-5-2; o AIHubMix lista Chat Completions, Responses e Anthropic Messages, com contexto de 1M e saída máxima de 128K. A interface documentada do Carbon é mais restrita: chat completions, não a API nativa do Gemini. O gateway também tenta o próximo melhor provedor, então o comportamento pode diferir de uma implantação com um único provedor.
O guia de início rápido aborda a autenticação e a URL base. Um teste de fumaça pode verificar se os dois IDs são reconhecidos usando a mesma chave; não foi realizado nenhum teste ao vivo para este rascunho:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Isso verifica o roteamento, não os recursos: sem ferramentas e sem saída longa. Para uma comparação real, execute o mesmo rastreamento do agente com os dois IDs e registre o tempo da tarefa, o uso de tokens e as falhas. A página de comparação coloca contexto, protocolos e preços lado a lado.
Perguntas frequentes
Gemini 4 Carbon é melhor que Fable 5.2 para programação agêntica?
Nenhum vence em todos os aspectos do trabalho. Fable 5.2 lidera no FrontierCode 2.0 e no índice geral no nível High effort; Carbon lidera no Terminal-Bench 4.0 e no AutomationBench. Escolha com base na carga de trabalho que o agente realmente executa.
Por que Fable 5.2 custa quatro vezes mais que Carbon?
Nas tarifas oficiais, Fable custa $8/$40 por milhão de tokens, contra o preço introdutório de $2/$10 do Carbon — quatro vezes mais tanto na entrada quanto na saída. Comparado à tarifa padrão do Carbon, de $4/$20 a partir de 1º de dezembro, custa o dobro.
Fable 5.2 realmente custa menos por tarefa no nível Medium?
Nos preços padrão, sim: $3.80 contra $6.59 do Carbon Medium, e 7.8 minutos contra 23.3. O preço introdutório por token do Carbon reduz a diferença; a comparação com os preços padrão é a mais duradoura.
Fable 5.2 pode forçar uma chamada de ferramenta?
Não. A Anthropic documenta que os valores any e tool de tool_choice retornam um erro 400. Agentes que exigem uma chamada forçada precisam de um fluxo diferente ou de outro modelo.
Carbon tem menos probabilidade de alucinar do que Fable 5.2?
Na medida de não alucinação Omniscience da AA, sim: 88.58% contra 42.02% no nível High. Sua precisão é menor, 58.27% contra 77.23%, então também tem menos probabilidade de fornecer a resposta correta.
É possível executar os dois modelos pelo AIHubMix com uma única chave?
Sim. Use gemini-4-carbon e claude-fable-5-2 com a mesma chave e URL base. O AIHubMix documenta chat completions para Carbon e chat completions, Responses e Messages para Fable.
Continue lendo: a série Gemini 4 Carbon
- Antes de escolher um concorrente, esclareça a questão entre os modelos da mesma família: Gemini 4 Carbon vs Argon: Mesmo preço, quando vale a pena escolher Carbon?
- Depois que Carbon entrar no fluxo, os primeiros erros 400 e timeouts geralmente são de configuração, não do modelo: Migração da API Gemini 4 Carbon: erros 400, timeouts e limites de saída
Fontes
- Gemini 4 Carbon já disponível — Google, 10 de novembro de 2026.
- Claude Fable 5.2 — Anthropic, 9 de novembro de 2026.
- Visão geral do Claude Fable 5.2 — documentação da Anthropic.
- Gemini 4 Carbon e Claude Fable 5.2 — Artificial Analysis, dados de 11 de novembro de 2026.
- Gemini 4 Carbon no AIHubMix — página do modelo e preços.