

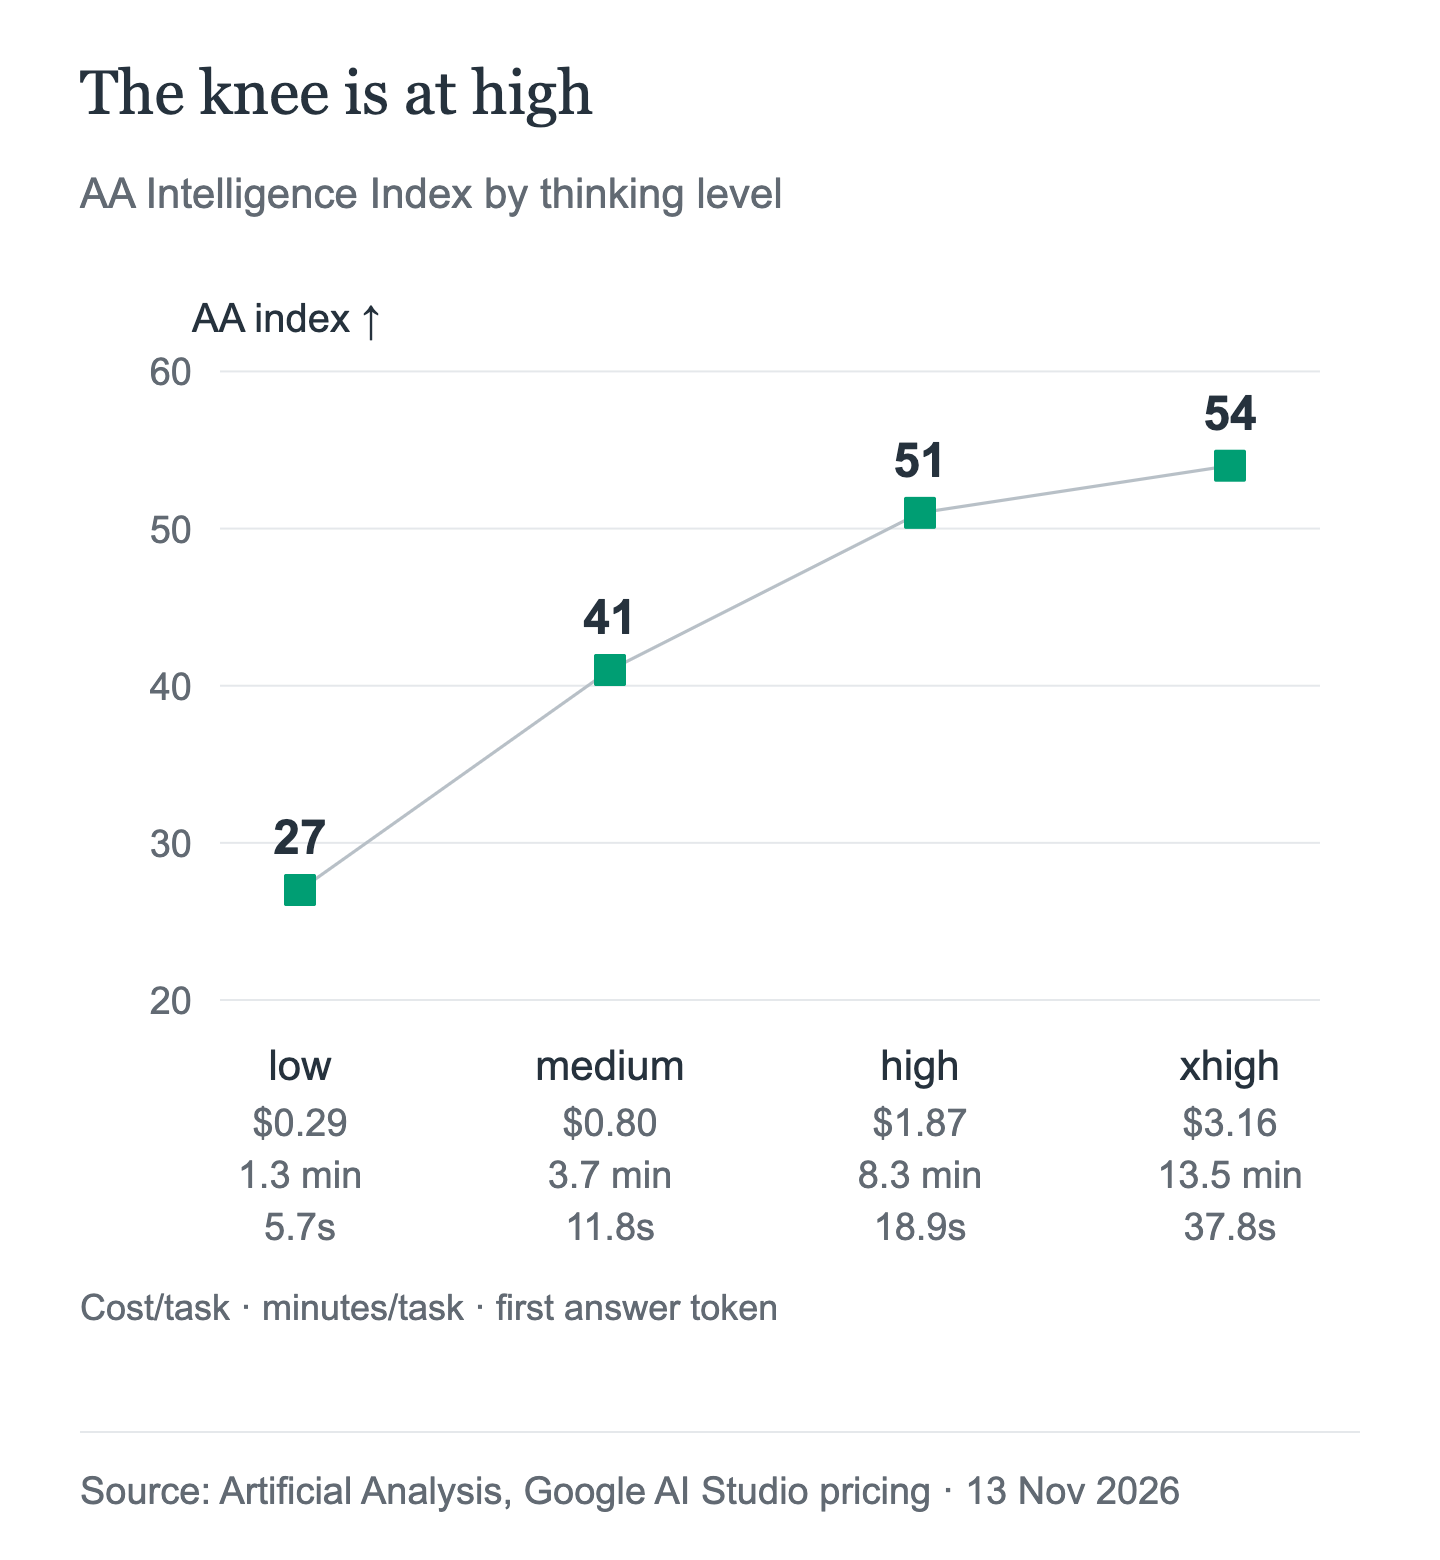
Gemini 4 Hydrogen ma cztery poziomy rozumowania, które zachowują się jak cztery różne modele. W bieżących pomiarach Artificial Analysis ten sam model uzyskuje 27 przy low, 41 przy medium, 51 przy high i 54 przy xhigh. Domyślnie ustawiony jest poziom high, a xhigh to nowość w rodzinie Gemini 4: Carbon i Argon kończą na poziomie high.
Rozpiętość jest duża: ten sam model obejmuje 27 punktów indeksu, od low do xhigh. Przejście z medium na high daje 10 punktów indeksu za około 1,07 USD więcej za zadanie. Przejście z high na xhigh daje 3 punkty za 1,29 USD, a czas oczekiwania na pierwszy token odpowiedzi niemal się podwaja. W praktyce najlepiej zacząć od high, zarezerwować xhigh do trudnych, wieloetapowych zadań, a low i medium traktować jako ustawienia opóźnienia, których jakość trzeba sprawdzić osobno.
Poniżej: do czego służy każdy poziom, ile kosztuje, co zmienia się w API oraz co AIHubMix dokumentuje, a czego nie.
Cztery poziomy i wprowadzone zmiany
Gemini 4 Hydrogen obsługuje poziomy low, medium, high i xhigh. W informacjach o wydaniu Google pisze wprost: „Domyślnym poziomem modelu jest high; wprowadzono też poziom xhigh”. To dwie zmiany w porównaniu z Gemini 3.8 Flash, którego domyślnym poziomem jest medium, a najwyższym — high.
Pozostałe modele z rodziny się nie zmieniły. Carbon i Argon obsługują poziomy low, medium i high, przy czym domyślnie ustawiony jest medium. Hydrogen to jedyny model Gemini 4 z ustawieniem powyżej high.
| Model | Poziomy | Domyślnie |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL nie należy do tego zestawu. Dokumentacja trybu rozumowania Gemini 4 informuje, że MINIMAL „nie jest obsługiwany w modelach Gemini 4”, a w informacjach o wydaniu Hydrogen Google podaje, że model „odrzuca minimal, zwracając błąd”. Nie udokumentowano możliwości wyłączenia rozumowania w tym modelu.
Co zaleca Google
Wskazówki Google to rozsądny punkt wyjścia, ale powstały przed pomiarami przedstawionymi poniżej. Szczególnie zalecenie poziomu medium do interaktywnego programowania zakłada jakość, której Artificial Analysis nie stwierdza przy medium.
| Poziom | Opis Google i zalecane zastosowanie |
|---|---|
| low | „Najmniej tokenów, najniższe opóźnienie” — szybki czat, duże obciążenie |
| medium | „Mniejsze zużycie tokenów, szybsze odpowiedzi” — interaktywne programowanie, prototypy interfejsów |
| high | „Równowaga między inteligencją a szybkością” — ustawienie domyślne dla większości zadań |
| xhigh | „Najwięcej tokenów, najgłębsze rozumowanie” — trudne, wieloetapowe zadania programistyczne |
Do tabeli dołączono dwa zastrzeżenia. „Użycie xhigh zwiększa opóźnienie i zużycie tokenów, a przy prostszych promptach może prowadzić do nadmiernego rozumowania” — ostrzega Google. Zalecenie dotyczące ewaluacji jest równie konkretne: „Przeprowadź ewaluacje na wszystkich czterech poziomach, ustawiając wysoką wartość max_output_tokens”.
Poziomy w pomiarach
Artificial Analysis zmierzyło wszystkie cztery poziomy. Pomiar obejmuje Intelligence Index v5.0.1, 78 modeli w rankingu, dane pobrane 2026-11-13T02:40Z i standardowe ceny katalogowe. Są to koszty zadań AA, a nie rachunki AIHubMix.
| Poziom | Pozycja w rankingu AA | Indeks AA | USD/zadanie | Min/zadanie | Pierwszy token odpowiedzi |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Najważniejsze są różnice między kolejnymi poziomami:
low→medium: +14 punktów indeksu, +0,51 USD za zadanie, +2,4 minuty, +6,1 sekundy do pierwszego tokenu.medium→high: +10 punktów indeksu, +1,07 USD za zadanie, +4,6 minuty, +7,1 sekundy do pierwszego tokenu.high→xhigh: +3 punkty indeksu, +1,29 USD za zadanie, +5,2 minuty, +18,9 sekundy do pierwszego tokenu.
high to punkt załamania krzywej. To ostatni krok, w którym przyrost jakości jest duży w stosunku do dodatkowego kosztu; przy xhigh czas oczekiwania na pierwszy token niemal się podwaja przy niewielkim wzroście indeksu. Nie oznacza to, że xhigh jest złym ustawieniem. Oznacza, że warto używać go do zadań, z którymi nie radzi sobie high — dokładnie tak opisuje ten poziom Google.
Dla porównania: w tej samej migawce Carbon high uzyskuje wynik 60 przy koszcie 5,48 USD za zadanie i czasie 28,1 minuty, Carbon medium — 58 przy 4,68 USD, Carbon low — 54 przy 5,22 USD, a Argon high — 50 przy 4,97 USD i czasie 30,6 minuty. Hydrogen xhigh uzyskuje taki sam wynik jak Carbon low — 54 — przy koszcie za zadanie niższym o 39,5% (3,16 USD wobec 5,22 USD), choć na pierwszy token trzeba czekać 37,77 sekundy zamiast 13,61. Hydrogen high przewyższa Argon high o jeden punkt indeksu przy koszcie za zadanie niższym o 62,4%.
Gdzie ten zestaw poziomów się załamuje
low to nieznacznie słabszy wariant. Wynik 27 oznacza, że model znajduje się o 24 punkty indeksu poniżej high. Przejście z high na low po to, by zaoszczędzić 1,58 USD na zadaniu, nie oznacza korzystania z tego samego produktu z mniejszą ilością rozumowania — to wybór znacznie słabszego modelu. Może się sprawdzić przy klasyfikacji, kierowaniu zadań lub krótkim wyodrębnianiu informacji. Bez ewaluacji dostosowanej do konkretnego zadania nie sprawdzi się przy programowaniu ani zadaniach agentowych.
medium to ustawienie opóźnienia, nie jakości. Uzyskuje wynik 41, o 10 punktów niższy niż high, a kosztuje 0,80 USD wobec 1,87 USD. Oszczędność jest realna — 57% na zadaniu — ale różnica jakości jest większa, niż sugeruje różnica w cenie. Google zaleca medium do interaktywnego programowania; wynik AA wskazuje, że przed zastosowaniem tego zalecenia warto sprawdzić je na własnych zadaniach.
xhigh może prowadzić do nadmiernego rozumowania. Google ostrzega przed tym wprost. Pokazują to dane AA dotyczące kosztu i czasu: 3,16 USD za zadanie, 13,5 minuty i 37,77 sekundy oczekiwania na pierwszy token. Przy prostym prompcie to dużo opóźnienia za niewielki przyrost jakości. Przy trudnym, wieloetapowym zadaniu programistycznym, z którym nie radzi sobie high, to jedyny poziom idący dalej.
Rozwlekłość ma wpływ na rachunek. Artificial Analysis opisuje Hydrogen jako model „bardzo rozwlekły”: przebieg xhigh wygenerował 304 miliony tokenów wyjściowych na potrzeby obliczenia indeksu, co dało mu 76. miejsce na 77 modeli, przy medianie wynoszącej 72,8 miliona. Tokeny wyjściowe obejmują tokeny rozumowania, a ich cena wynosi 7,50 USD za milion. Wyższy poziom nie tylko oznacza dłuższe rozumowanie — generuje też więcej płatnych tokenów.
Koszty: jak rozumowanie zamienia się w tokeny
Cennik jest prosty. Hydrogen kosztuje 1,50 USD za milion tokenów wejściowych, 7,50 USD za milion tokenów wyjściowych i 0,075 USD za milion tokenów wejściowych w pamięci podręcznej. Tokeny wyjściowe obejmują tokeny rozumowania. Dlatego poziom ma większe znaczenie niż stawka: opłata naliczana jest za tokeny wygenerowane w toku rozumowania, a nie za nazwę poziomu.
Łatwo przeoczyć trzy zasady naliczania opłat.
Ustawienie domyślne się zmieniło. Gemini 3.8 Flash domyślnie używał poziomu medium, a Hydrogen — high. Po migracji zadanie, które nigdy nie miało jawnie ustawionego poziomu, zużyje więcej tokenów wyjściowych w każdej turze, nawet jeśli cena za token pozostanie taka sama. To zmiana budżetu ukryta pod pozorem zmiany modelu.
Buforowanie działa wyłącznie niejawnie. Hydrogen obsługuje niejawne buforowanie z minimalnym progiem 4,096 tokenów i 95% rabatem przy trafieniu w pamięć podręczną; jawne buforowanie nie jest obsługiwane. Na stronie dla klientów korporacyjnych Google podaje też: „Zapis do pamięci podręcznej jest domyślnie rozliczany według stawki 1.25x standardowej ceny tokenów wejściowych”. To sformułowanie Google dotyczące rozliczeń; zasady rozliczania pamięci podręcznej przez AIHubMix nie są udokumentowane dla tego modelu.
Długie wyjście ma limit na każde wywołanie. Żądanie synchroniczne generuje maksymalnie 65,536 tokenów na jedno wywołanie — niezależnie od tego, czy używa strumieniowania. Dłuższe wyjście wymaga wykonania w tle lub tokenów kontynuacji, a max_output_tokens ogranicza łączną liczbę tokenów rozumowania i wyjściowych. Jeśli ustawisz background=true bez max_output_tokens, serwer zatrzyma generowanie po 65,536 tokenach. Zalecane przez Google limity dla długiego dekodowania to 131,072 lub 262,144, maksymalnie 1,048,576 minus długość wejścia.
Co obsługuje API, a co odrzuca
Parametr nazywa się thinking_level (snake_case). W przykładzie dla Pythona Google umieszcza go w thinking_config; w przykładzie dla Node — wewnątrz thinkingConfig (camelCase). Na stronie modelu wymieniono wartości LOW, MEDIUM, HIGH i XHIGH; w informacjach o wydaniu zapisano je małymi literami. Zamiast ręcznie wpisywać wariant o określonej wielkości liter, użyj wartości wyliczeniowej z SDK lub udokumentowanego ciągu znaków.
Trzy typy żądań zakończą się błędem:
thinking_budgetw dowolnym modelu Gemini 4 zwraca400: INVALID_ARGUMENT. Ustawienie jednocześniethinking_levelithinking_budgetrównież zwraca błąd.thinking_level="MINIMAL"nie jest obsługiwany; Hydrogen go odrzuca.- Niestandardowe wartości
temperature,top_pitop_ksą ignorowane. Stałe wartości domyślne to temperature 1.0, topP 0.95 i topK 64.
Na platformie Google Hydrogen obsługuje również wywoływanie funkcji, wykonywanie kodu, kontekst URL i obsługę komputera. W API Interactions do sesji wieloturowych i wywoływania narzędzi użyj previous_interaction_id.
Co dokumentuje AIHubMix, a czego nie
Udokumentowana trasa AIHubMix dla Hydrogen to POST https://aihubmix.com/v1/chat/completions z parametrem model="gemini-4-hydrogen". Na stronie modelu wymieniono tekst, obraz, dźwięk, wideo i PDF jako obsługiwane formaty wejściowe oraz tekst jako format wyjściowy; w llms.txt nadal znajduje się starszy wpis o obsłudze wyłącznie tekstu, dlatego za nowsze źródło należy uznać stronę modelu. Obsługa użycia narzędzi, ustrukturyzowanego wyjścia i rozumowania jest „nieopublikowana”. Modelu nie ma w indeksie modeli wygenerowanym 2026-11-11, a schemat protokołu nie został opublikowany.
Ma to znaczenie w kontekście tego artykułu, ponieważ AIHubMix nie dokumentuje sposobu ustawiania poziomu rozumowania dla żadnego modelu Gemini 4. Przewodnik AIHubMix dotyczący Gemini opisuje parametr reasoning_effort dla modeli z ery Gemini 2.5, a nie thinking_level ani xhigh w Gemini 4. Nie zakładaj, że którakolwiek z tych wartości przejdzie przez bramę API, ani że ustawieniem domyślnym w AIHubMix będzie to samo ustawienie, które obserwujesz w API Google.
Bezpieczny format żądania to ten udokumentowany przez AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Jeśli możliwość wyboru poziomu jest niezbędna, wywołuj bezpośrednio API Google albo najpierw sprawdź działanie bramy API za pomocą małego żądania, zanim przekierujesz przez nią ruch produkcyjny. Strona porównawcza AIHubMix może pomóc ocenić koszty podczas podejmowania decyzji. Na potrzeby tego artykułu nie przeprowadzono testu na żywo.
Od czego zacząć w zależności od obciążenia
| Obciążenie | Od jakiego poziomu zacząć i dlaczego |
|---|---|
| Szybki czat, routing, klasyfikacja | medium, przetestuj low; low uzyskuje 27 pkt |
| Interaktywne kodowanie, prototypowanie interfejsów | high; medium w AA uzyskuje 41 pkt |
| Wykonywanie zadań przez agenta, pętle wywołań narzędzi | high; użyj xhigh tylko w przypadku problemów |
| Trudne debugowanie, architektura, planowanie | xhigh lub Carbon; 3 punkty za 69% więcej |
| Przetwarzanie wsadowe na dużą skalę po ewaluacji | low lub medium; najtańsze, ale indeks wynosi 27/41 |
| Ścisły limit opóźnienia poniżej 15 sekund | medium lub low; high czeka 18.89 s |
To punkty wyjścia, a nie reguły routingu. Właściwy poziom to najniższy, który przechodzi Twoją własną ewaluację. Google zaleca przeprowadzenie jej na wszystkich czterech poziomach.
FAQ
Jakie poziomy rozumowania ma Gemini 4 Hydrogen?
Są cztery: low, medium, high i xhigh. Domyślny poziom to high.
Co się zmieniło w porównaniu z Gemini 3.8 Flash?
Domyślny poziom zmienił się z medium na high, a powyżej high dodano xhigh. Domyślnymi poziomami Carbon i Argon nadal są medium, a ich maksymalny poziom to high.
Czy xhigh jest wart swojej ceny?
Tak, w przypadku trudnych zadań wieloetapowych, z którymi high sobie nie radzi: zyskujesz 3 punkty indeksu. Kosztuje jednak 69% więcej na zadanie niż high i niemal dwukrotnie wydłuża oczekiwanie na pierwszy token, więc nie jest dobrym domyślnym wyborem do prostych promptów.
Dlaczego low wypada tak słabo?
Artificial Analysis przyznaje mu 27 punktów indeksu, czyli o 24 punkty mniej niż high. Kosztuje 0.29 USD za zadanie, w porównaniu z 1.87 USD, ale różnica w jakości jest znacznie większa niż różnica w cenie. Używaj go tylko wtedy, gdy ewaluacja konkretnego zadania potwierdzi, że wystarczy.
Czy AIHubMix obsługuje thinking_level lub xhigh?
Nie wynika to z dokumentacji. AIHubMix nie publikuje informacji o obsłudze rozumowania dla Hydrogen ani przewodnika po poziomach rozumowania Gemini 4. Zanim zaczniesz polegać na którymkolwiek z tych rozwiązań, zweryfikuj ich obsługę.
Co się stanie, jeśli wyślę thinking_budget?
Gemini 4 zwróci 400: INVALID_ARGUMENT. Ustawienie zarówno thinking_budget, jak i thinking_level również spowoduje błąd.
Czy mogę wyłączyć rozumowanie?
Nie ma udokumentowanego przełącznika wyłączającego tę funkcję. MINIMAL nie jest obsługiwany w Gemini 4, a Hydrogen odrzuca go z błędem.
Czytaj dalej: seria o Gemini 4 Hydrogen
- Jeśli nadal zastanawiasz się, czy Hydrogen to właściwy upgrade z Gemini 3.8 Flash, pierwszy artykuł omawia premierę, zmianę ceny i kompromisy w wynikach benchmarków: Gemini 4 Hydrogen vs Gemini 3.8 Flash: Czy warto dokonać upgrade’u?.
- Jeśli chcesz wiedzieć, jak Hydrogen wypada w porównaniu z Carbon i Argon przy tym samym zadaniu, trzeci artykuł zestawia wszystkie trzy modele, uwzględniając ceny, opóźnienia i tabelę obciążeń: Gemini 4 Carbon vs Hydrogen vs Argon: który model do jakiego zadania?.
Źródła
- Google AI Studio, Gemini 4 Hydrogen: co nowego
- Google, Gemini 4 i rozumowanie
- Google, strona modelu Gemini 4 Hydrogen
- Google AI Studio, cennik Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — aktualny zrzut danych z 2026-11-13T02:40Z, Intelligence Index v5.0.1


