Gemini 4 Carbon można zastąpić Gemini 4 Argon bez zmian w schemacie żądania. Działa ten sam obiekt treści żądania chat completions: zmienia się identyfikator modelu, a kilka wartości parametrów nie zostaje zachowanych. Istotne błędy pojawiają się poziom niżej — błędy parametrów zwracające 400, limity wyjścia powodujące ciche obcinanie odpowiedzi oraz limity czasu i sposób rozliczania dostosowane do długiego namysłu.
O pierwszym tygodniu decydują cztery ustawienia domyślne:
- W AIHubMix nie ustawiaj
max_tokenspowyżej 65,536; bramka dokumentuje wyłącznie Chat Completions i nie udostępnia ścieżki pozwalającej uzyskać większe wyjście. - W przypadku natywnych interakcji Google i zadań działających w tle ustaw
store=trueoraz jawny parametrmax_output_tokens; te pola nie są udokumentowane dla Carbon w AIHubMix. - W przypadku natywnej ścieżki dostawcy z długim dekodowaniem ustaw limit czasu odczytu HTTP na 15–20 minut dla każdego strumienia.
- Usuń
temperature,top_pitop_k, które są ignorowane, a także kary oraz wartościcandidate_countwiększe niż 1, które według przewodnika Google po Carbon powodują błąd 400.
Niezmienione podstawowe informacje — dostęp, odmowy ze względów bezpieczeństwa, koszt zadania — znajdziesz w wpisie o migracji Argon. Ten wpis opisuje zachowanie specyficzne dla Carbon.
Co zawodzi jawnie, a co po cichu
Błędy łatwo podzielić na dwie kategorie: błąd 400 informuje od razu, a cichy limit daje o sobie znać dopiero na fakturze.
| Co widzisz | Kategoria | Pierwsze działanie |
|---|---|---|
| HTTP 400 dla parametru | Jawny | Usuń nieobsługiwane pole |
| 400 dla żądania działającego w tle | Jawny | Dodaj store=true |
| Odpowiedź zatrzymuje się na 65,536 tokenach | Cichy | Zwiększ max_tokens, maksymalnie do 65,536 |
| Pusty tekst, status incomplete | Cichy | Zwiększ limit i ponów próbę |
| Zadanie działające w tle kończy się w pobliżu 64K | Cichy | Ustaw max_output_tokens |
| Odpowiedź wydaje się płytsza | Cichy | Jawnie ustaw poziom rozumowania |
| Rachunek przekracza szacunki | Cichy | Uwzględnij tokeny rozumowania i kolejne etapy dekodowania |
AIHubMix podaje cenę gemini-4-carbon w Chat Completions: 2 USD za milion tokenów wejściowych, 10 USD za milion wyjściowych i 0,10 USD za milion tokenów z pamięci podręcznej — są to stawki promocyjne Google. Są tymczasowe; zobacz sekcję o rozliczeniach.
Jawne błędy: udokumentowane kody 400
Wiele udokumentowanych błędów 400 wynika z walidacji parametrów; problemy z historią i wstępnie wypełnionymi turami modelu dotyczą stanu żądania. Poniższe zasady pochodzą z natywnego przewodnika Google po Carbon, o ile nie zaznaczono inaczej; AIHubMix dokumentuje obecnie dla Carbon wyłącznie Chat Completions. Opis Carbon w AIHubMix ujmuje tę kategorię w jednym zdaniu: „400 — błąd parametru; większość takich błędów jest przekazywana od dostawcy nadrzędnego”. To opis działania bramki, a nie wynik testu. Szczegóły znajdziesz w przewodniku Google po Carbon i na stronie z nowościami.
| Przyczyna | Co widzisz | Rozwiązanie |
|---|---|---|
| max_output_tokens > 1M* | 400; przekroczony limit | Nattywnie ≤1M; bramka ≤65K* |
| frequency/presence penalty | 400; parametr nieobsługiwany | Usuń pola |
| candidate_count > 1 | 400; wiele kandydatów | Pomiń parametr lub ustaw 1 |
| background bez store* | 400; store jest wymagane* | Dodaj store=true |
| Historia kończy się turą modelu | Odrzucono; nieobsługiwane | Zakończ turą użytkownika |
| oba parametry sterujące | 400; nie można ich łączyć | Wyślij jeden |
| thinking_budget lub MINIMAL | 400; przewodnik po Carbon | Użyj low/medium/high |
Google wyświetla dokładny komunikat: „store=true is required for background interactions”. * Tylko natywna usługa Google: max_output_tokens ma limit 1M, a zadania działające w tle wymagają store=true; AIHubMix nie udokumentował tej ścieżki. W ścieżce Chat Completions AIHubMix używaj wartości ≤65K.
Wiersz minimal ma dwa znaczenia. W natywnych polach Carbon Google parametry thinking_budget i thinking_level=MINIMAL powodują błąd HTTP 400; użyj low, medium lub high. W warstwie zgodności z OpenAI Google wartość reasoning_effort=minimal jest mapowana na low; AIHubMix nie opublikował informacji, czy stosuje to mapowanie do Carbon.
Obsługa narzędzi to powiązana pułapka. Przewodnik Google po Carbon zaleca wykonywanie wywołań narzędzi w sekwencyjnych turach, a przewodnik AIHubMix po Gemini dokumentuje tool_choice="auto"; obsługa narzędzi specyficzna dla Carbon w bramce nie została potwierdzona.
Najprostsze bezpieczne żądanie do /v1/chat/completions pomija to, co Carbon ignoruje:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Jeśli zwróci 200, warstwa transportowa jest już skonfigurowana. Reszta dotyczy odpowiedzi, które nie zgłaszają błędu.
Ciche błędy: brak komunikatu o błędzie, nieprawidłowe wyjście, nieprawidłowy rachunek
Standardowy limit wyjścia to 65,536 tokenów; natywne długie dekodowanie dostawcy to osobna ścieżka
Standardowy limit wyjścia Carbon wynosi 65,536 tokenów. W Chat Completions pole limitu to max_tokens; w natywnych przewodnikach Google nosi nazwę max_output_tokens. Natywna ścieżka Google z długim dekodowaniem może obsłużyć do 1,048,576 tokenów pomniejszonych o tokeny wejściowe; 131,072 i 262,144 to przykładowe wartości. Zasada na stronie Google z nowościami brzmi: „Jeśli ustawisz background: true bez zdefiniowania max_output_tokens, serwer zatrzyma się po 64K tokenów”. AIHubMix nie udokumentował dla Carbon obsługi działania w tle ani kontynuowania.
Natywne długie dekodowanie dostawcy przebiega etapami: 64K na etap w trybie background lub streaming, 32K na etap bez strumieniowania; pojedyncze niestrumieniowane żądanie REST zatrzymuje się po 32,768 tokenach. W przewodniku Google zaznaczono, że „starsze wersje SDK i warstwa zgodności z OpenAI nie potrafią pobierać długich odpowiedzi za pomocą tokenów kontynuacji”. W AIHubMix ustaw max_tokens na 65,536 lub mniej jako ostrożny, niezweryfikowany limit bramki; nie planuj łączenia dłuższych odpowiedzi, dopóki strona modelu tego nie udokumentuje.
Niski limit obcina rozumowanie, a puste wyjście jest płatne
Limit obejmuje tokeny rozumowania, nie tylko tekst. W przewodniku Google po długim dekodowaniu czytamy: „Niska wartość, na przykład 8,192, zatrzymuje model, zanim skończy rozumować”. Status zmienia się na incomplete, a „tekst może być pusty, jeśli model wciąż rozumował”. Opłata i tak zostanie naliczona. Uwzględnij tokeny rozumowania i odpowiedź w budżecie, a pustą odpowiedź ze statusem incomplete potraktuj jako problem z limitem: zwiększ go, ponów próbę i pamiętaj, że pierwsza próba również pojawi się na rachunku.
Domyślny poziom rozumowania to medium
Carbon domyślnie używa poziomu medium, tak samo jak Argon. Zespoły korzystające z Gemini 3.1 Pro Preview, które domyślnie używa poziomu high, tracą jeden poziom bez zmiany kodu i mogą uznać płytszą odpowiedź za regresję. Google zaleca medium do większości zadań programistycznych i zadań agentowych. Jawnie ustaw poziom w środowisku staging i wysyłaj tylko jedno pole sterujące: nie można łączyć reasoning_effort z thinking_level.
Parametry próbkowania są ignorowane
temperature, top_p i top_k są ignorowane — nie pojawia się błąd, a próbka się nie zmienia. Usuń te parametry. Kary i wartości candidate_count większe niż 1 powodują błąd 400.
Jawne buforowanie zniknęło
cachedContents i caches.create nie są obsługiwane. Niejawne buforowanie działa od 4,096 tokenów i zapewnia 95% zniżki. Usuń kod jawnego buforowania, umieść stabilny prefiks promptu na początku i przed uwzględnieniem zniżki sprawdź użycie tokenów z pamięci podręcznej.
Zasady dotyczące stanu konwersacji
Google zaleca używanie previous_interaction_id do kontynuowania konwersacji. Chat Completions nie ma takiego pola, więc zachowaj historię, ale zakończ ją turą użytkownika; zakończenie rolą modelu lub wstępnie wypełniona tura modelu nie są obsługiwane.
Limity czasu: 15–20 minut, nie 60 sekund
Przewodnik Google po długim dekodowaniu zaleca limity czasu odczytu HTTP wynoszące 15–20 minut na strumień; na liście kontrolnej migracji powtórzono minimum 15 minut. Zalecenie dotyczy żądań z długim dekodowaniem. Osobny pomiar AA pokazuje czas oczekiwania na pierwszy token odpowiedzi: Carbon High — 67,1 sekundy, Medium — 23,2, Low — 12,9, a Argon High — 40,1. Czy limit 60 sekund w ogóle pozwala otrzymać pierwszy token?
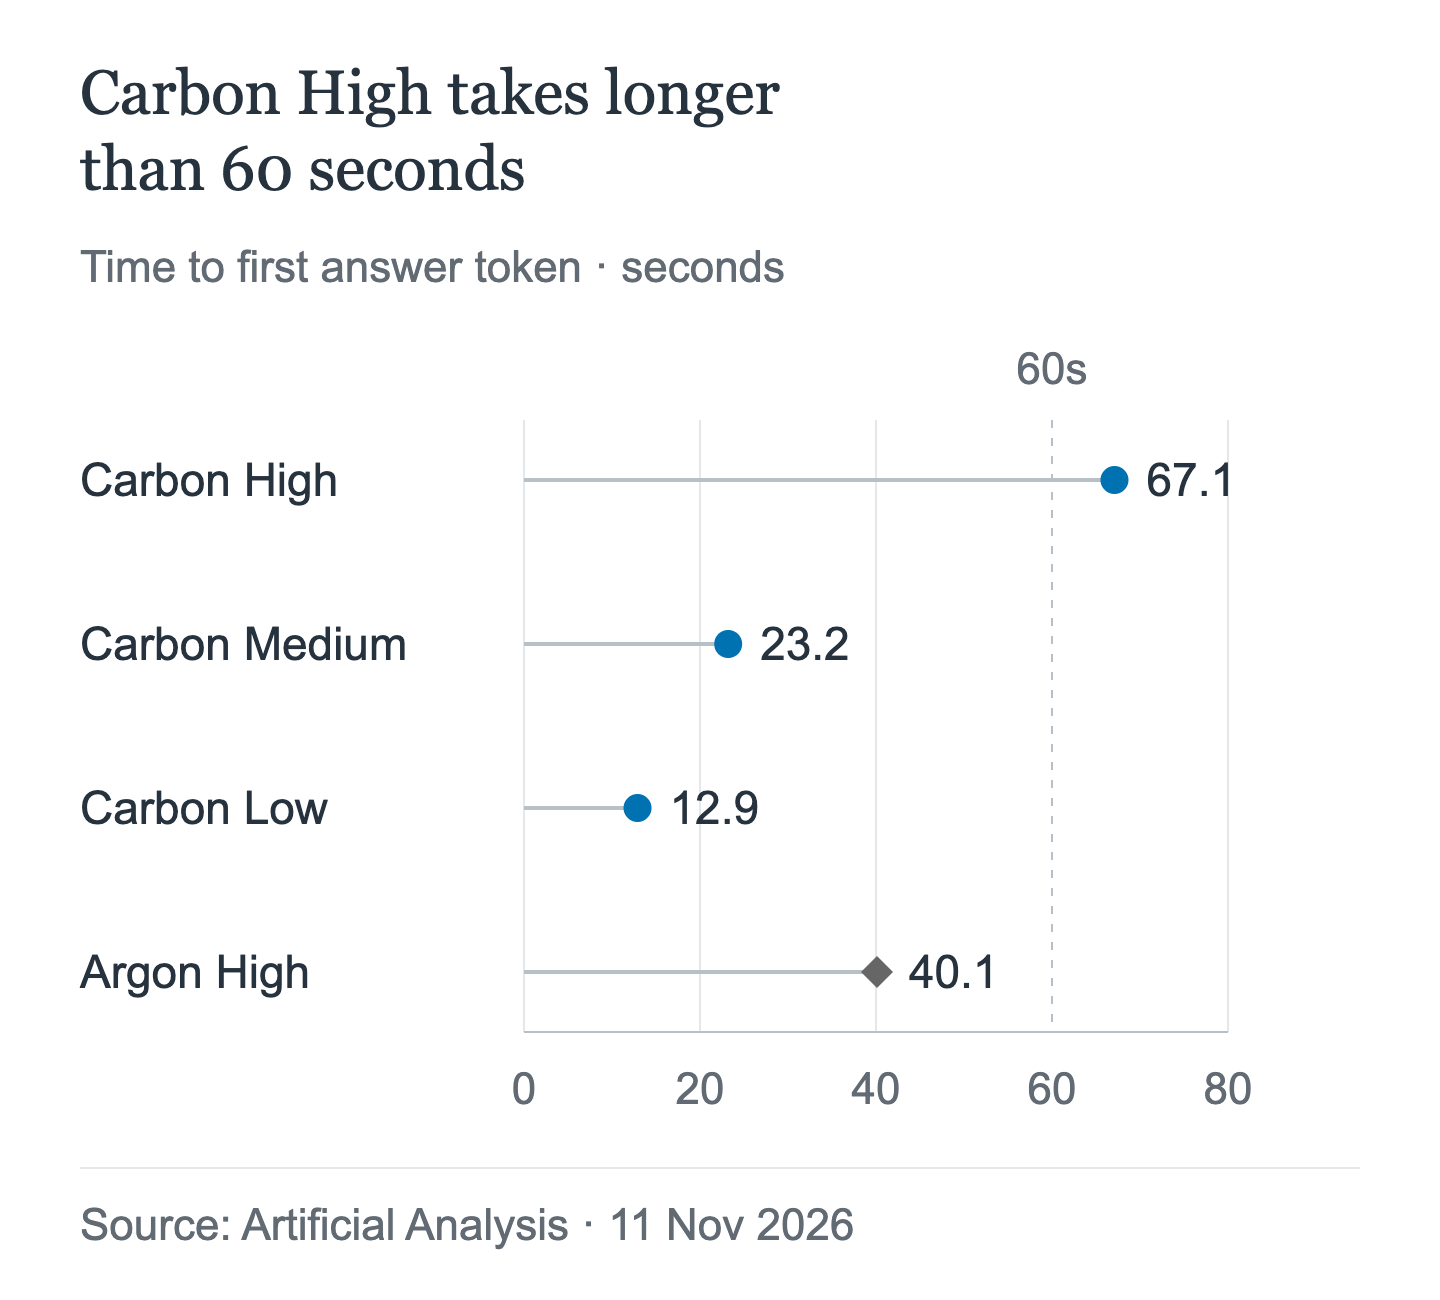
W tym pomiarze Carbon High przekracza wartość odniesienia wynoszącą 60 sekund. Czas do pierwszego tokenu nie pozwala ustalić bezpiecznego limitu dla całego żądania: zalecenie 15–20 minut powyżej pochodzi z przewodnika Google po długim dekodowaniu. To wyniki z jednego pomiaru, a nie gwarancja opóźnień ani test AIHubMix.
Natywne limity czasu po stronie klienta Google są bardziej restrykcyjne niż limit dla zadań działających w tle: 20 minut dla strumienia, 10 dla wywołania bez strumieniowania, w porównaniu z 24 godzinami dla działania w tle. AIHubMix nie dokumentuje tych limitów dla zadań działających w tle.
Minimalne wersje natywnych SDK wymagane do długiego dekodowania: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. Parametr API_TIMEOUT_MS w Claude Code domyślnie wynosi 10 minut; jeśli później zostanie potwierdzona obsługa Carbon w Claude Code, zwiększ tę wartość przed pierwszym uruchomieniem.
Pułapki rozliczeniowe
Cena Carbon za token jest prosta, ale rachunek już nie. Kilka mechanizmów podbija kwotę, a jedna zaplanowana zmiana podwaja wszystkie stawki.
Tokeny rozumowania są rozliczane jak tokeny wyjściowe
Tokeny rozumowania są rozliczane jak tokeny wyjściowe. Obecna stawka za wyjście Carbon wynosi 10 USD za milion tokenów, a od 1 grudnia wzrośnie do 20 USD.
Rozliczany jest każdy etap długiego dekodowania
Przykład z Google: dla promptu liczącego 1 000 tokenów i odpowiedzi zawierającej 200,000 tokenów parametr total_input_tokens wynosi 397,216 przy etapach obejmujących 1,000, 66,536, 132,072 i 197,608 tokenów. „Płacisz za każdy token na każdym etapie, również za etapy zawierające wyłącznie tokeny rozumowania”. Niejawne buforowanie obniża koszt większości tokenów wejściowych o 95%, ale tokeny z kolejnych etapów nadal są uwzględniane w zużyciu. Rozliczana jest też wykonana praca, gdy zadanie zakończy się błędem lub zostanie anulowane: „Ukończone segmenty są rozliczane po zakończeniu każdego segmentu, nawet jeśli późniejszy segment zakończy się błędem lub zostanie anulowany” oraz „Płacisz za całą pracę wykonaną przed zakończeniem interakcji”.
Ugruntowanie odpowiedzi ma osobny licznik
W natywnej usłudze Google ugruntowanie odpowiedzi za pomocą wyszukiwarki Google obejmuje 5 000 bezpłatnych żądań miesięcznie, wspólnych dla Gemini 3 i nowszych modeli. Po przekroczeniu limitu koszt wynosi 14 USD za 1 000 żądań, maksymalnie 1 500 dziennie. AIHubMix nie udokumentował ugruntowania odpowiedzi dla Carbon.
Uwaga dotycząca Vertex dotyczy wyłącznie dostawcy
Strona z cennikiem Google Vertex zawiera dodatkową zasadę: za odpowiedzi dłuższe niż 32K tokenów opłata jest naliczana na podstawie liczby tokenów możliwych do pobrania, nawet jeśli żądanie zakończy się błędem z powodu limitu czasu po stronie klienta lub serwera; zasada obowiązuje od 13 listopada 2026 r. To reguła dostawcy; nie opublikowano informacji, czy dostawca VertexAI w AIHubMix ją stosuje. Zapytaj, zanim przyjmiesz to za pewnik.
1 grudnia wszystkie stawki ulegną podwojeniu
| Stawka | Do 30 listopada | Od 1 grudnia |
|---|---|---|
| Wejście | 2 USD za 1M | 4 USD za 1M |
| Wyjście | 10 USD za 1M | 20 USD za 1M |
| Odczyt z pamięci podręcznej | 0,10 USD za 1M | 0,20 USD za 1M |
Carbon i Argon korzystają z tych samych stawek promocyjnych; 1 grudnia wszystkie stawki wzrosną dwukrotnie. Obecnie AIHubMix podaje stawki promocyjne, ale nie opublikował cen obowiązujących po grudniowej zmianie. Przyjmij podwojenie stawek za pewnik, a cenę bramki po zmianie — jako niewiadomą; przed zatwierdzeniem budżetu sprawdź obie kwestie.
Agenci z rzeczywistymi uprawnieniami
W przypadku wywołań natywnych dla Google przewodnik Carbon zaleca sekwencyjne tury wykonywania narzędzi. Korzystając z tej ścieżki, wykonuj po jednym wywołaniu naraz. Przewodnik AIHubMix dotyczący Gemini opisuje tool_choice="auto", ale obsługa narzędzi specyficzna dla Carbon oraz wymuszanie wywołań narzędzi przez bramę nie zostały potwierdzone.
Historia nie może kończyć się turą modelu, a wstępnie wypełnione tury modelu nie są obsługiwane. Jeśli brakuje wyniku narzędzia, wyślij turę użytkownika z prośbą o wykonanie następnego kroku.
Karta modelu wymienia sporadyczne spowolnienia lub przekroczenia limitu czasu oraz dodatkowe tokeny przy wyższych poziomach; data graniczna wiedzy to marzec 2026 r. Przy dostępie do zapisu rzeczywistym ryzykiem jest przekroczenie limitu czasu: zadanie trwające dłużej niż limit klienta może pozostawić po sobie częściowe zmiany, a za ukończone fragmenty nadal naliczana jest opłata.
Narzędzia do kodowania: przed konfiguracją sprawdź stronę modelu
Oferta Carbon w AIHubMix opisuje wyłącznie Chat Completions, a Carbon nie ma jeszcze w publicznym indeksie modeli. Claude Code wymaga Anthropic Messages, a Codex — Responses. Obsługa żadnego z tych protokołów dla Carbon w AIHubMix nie została potwierdzona. Nie zakładaj, że którykolwiek z nich zadziała: otwórz podlinkowaną wyżej stronę modelu Carbon i sprawdź listę protokołów. Jeśli widnieje na niej tylko Chat Completions, użyj klienta zgodnego z OpenAI albo poczekaj.
Format żądania jest taki sam jak w przypadku Argon, ale dostępność protokołów się różni: obecnie dokumentacja Carbon w AIHubMix obejmuje tylko Chat Completions. Wpis o Claude Code omawia ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN i API_TIMEOUT_MS; wpis o Codex omawia blok dostawcy, wire_api i model_reasoning_effort. Zmienia się to, czy dany protokół jest dostępny.
| Klient | Wymagany protokół | Carbon w AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Brak dokumentacji |
| Codex | Responses API | Brak dokumentacji |
| OpenAI SDK | Chat Completions | Udokumentowany |
Ustawienia:
- ID modelu:
gemini-4-carbon. - Rozumowanie: low, medium, high; domyślnie medium.
- Mapowanie poziomu: natywne pole
thinking_level, pole zgodnościreasoning_effort; Google mapuje wartości poziomu rozumowania, ale AIHubMix nie opublikował mapowania dla Carbon. Wyślij jedno z tych pól. - Kontekst: 1,048,576 według Google; AIHubMix nie opublikował limitu dla Carbon, więc nie opieraj rozwiązania na wartości podanej przez dostawcę.
- Znane problemy: wolne generowanie pierwszego tokena przy poziomie high, zalecenie dostawcy, by preferować sekwencyjne tury wywołań narzędzi, ostrożny, niezweryfikowany limit AIHubMix wynoszący 65,536 tokenów wyjściowych oraz data graniczna wiedzy: marzec 2026 r.
Test dymny, 10–15 minut:
- Wybierz małe repozytorium z jednym niezaliczonym testem jednostkowym i poleceniem testowym, które kończy się w mniej niż minutę.
- Ustaw model na
gemini-4-carbon, wartośćmax_tokensna 65,536 lub mniej, a limit czasu HTTP na co najmniej 15 minut. - Poproś narzędzie o wprowadzenie najmniejszej zmiany, która sprawi, że test przejdzie, a następnie uruchom polecenie testowe i sprawdź różnice.
- Powodzenie: zmiana jest minimalna, a test przechodzi w ciągu 10–15 minut. Niepowodzenie: odnotuj, czy odpowiedź była błędem 400, niekompletną odpowiedzią, przekroczeniem limitu czasu czy nieprawidłową zmianą; każda z tych sytuacji wymaga innego rozwiązania opisanego powyżej.
- Jeśli narzędzie pozwala ustawić poziom, przetestuj medium i high, a następnie wybierz ten, który mieści się w wyznaczonym czasie.
Lista kontrolna przed pierwszym żądaniem produkcyjnym
- ID modelu ustawione na
gemini-4-carbon. - Bez
temperature,top_panitop_k. - Bez
frequency_penaltyanipresence_penalty; ustawcandidate_countna 1 lub pomiń to pole. max_tokensustawione na 65,536 lub mniej.- Natywne dla Google żądania działające w tle wysyłają
store=truei jawnie ustawionemax_output_tokens; AIHubMix nie opisał tej ścieżki. - Limit czasu HTTP wynosi co najmniej 15 minut; zalecane jest strumieniowanie.
- Używaj tylko jednego z pól:
reasoning_effortithinking_level. - W Google Native preferuj sekwencyjne tury wywołań narzędzi; AIHubMix opisuje
tool_choice="auto", ale obsługa Carbon nie została potwierdzona. - Bez jawnych wywołań pamięci podręcznej; najpierw umieść stabilny prefiks promptu.
- Budżet uwzględnia tokeny rozumowania i każde przejście długiego dekodowania.
- Stawki z 1 grudnia sprawdzone z osobą odpowiedzialną za budżet.
- Przed konfiguracją narzędzie do kodowania sprawdzone na stronie modelu.
FAQ
Czy przy przejściu z Argon na Carbon trzeba zmienić treść żądania?
Nie. Schemat się nie zmienia. Zmień ID modelu, sprawdź wartości i usuń pola, które teraz zwracają błąd 400.
Dlaczego max_output_tokens zwraca błąd 400?
Natywne API Carbon od Google odrzuca wartości powyżej 1,048,576. Ścieżka Chat Completions w AIHubMix ma osobne, ostrożne zalecenie: nie przekraczaj 65,536 dla max_tokens, dopóki nie zostanie udokumentowana ścieżka obsługująca większe wartości. Zbyt niska wartość powoduje zamiast tego ucięcie rozumowania, co jest gorsze: odpowiedź może być niekompletna, a opłata i tak zostanie naliczona.
Dlaczego odpowiedź jest pusta?
Jeśli stan wskazuje na niekompletność, treść może być pusta, ponieważ model wciąż rozumował. Płacisz za wykonaną pracę. Zwiększ limit i ponów próbę.
Dlaczego żądanie działające w tle zatrzymuje się na 64K?
W natywnej ścieżce Google dla żądań działających w tle pominięcie max_output_tokens powoduje zatrzymanie serwera na 64K. Ustaw limit jawnie; natywne długie dekodowanie może osiągnąć wartość do 1,048,576 pomniejszoną o dane wejściowe. AIHubMix nie opisał trybu działania w tle.
Czy parametr temperature jest uwzględniany?
Nie. Parametry temperature, top_p i top_k są ignorowane. Użycie kar lub ustawienie candidate_count na wartość większą niż 1 powoduje błąd 400.
Czy 1 grudnia Carbon będzie kosztować dwa razy więcej?
Stawki Google wzrosną dwukrotnie: koszt danych wejściowych z $2 do $4, wyjściowych z $10 do $20, a odczytów z pamięci podręcznej z $0.10 do $0.20. AIHubMix nie opublikował cen obowiązujących po grudniu, więc potwierdź je przed zatwierdzeniem budżetu.
Czy można używać Claude Code lub Codex z Carbon?
Nie zostało to potwierdzone. AIHubMix dokumentuje dla Carbon Chat Completions; Claude Code wymaga Anthropic Messages, a Codex — Responses. Najpierw sprawdź stronę modelu.
Czytaj dalej: seria Gemini 4 Carbon
- Jeśli migracja już trwa, a pozostałe pytanie brzmi, czy Carbon jest wart swojej ceny, w porównaniu zestawiono obok siebie wspólne stawki wprowadzające.
Gemini 4 Carbon kontra Argon: ta sama cena — kiedy Carbon jest wart swojej ceny? - Jeśli wybierasz agenta do kodowania, zamiast migrować punkt końcowy, porównanie bezpośrednie omawia użycie narzędzi i koszt zadania.
Gemini 4 Carbon kontra Fable 5.2: który model wybrać do kodowania agentowego?