

W pełnym teście APB z 2026-11-03/04 cztery wyniki Pareto to Q 44.58, F 93.42, P 57.69 i R 100, a wynik ogólny wynosi 68.72. Gorące zapytania 8k trafiły w 2 przypadkach na 9, a zapytania 32k — w 3 na 9.
W dniach 2026-11-03/04 przetestowano DeepSeek V4.1 Flash 1017 u sześciu dostawców za pośrednictwem AIHubMix, korzystając z pełnego zestawu APB oraz tych samych pytań, parametrów i skryptów zapytań. Ten profil APB dotyczy wyłącznie Pareto: opisuje, co mierzyła każda sekcja i jakie przyniosła wyniki.
Poniższe liczby to wyniki, a nie ranking ani rekomendacja dostawcy. Najpierw podano cztery wyniki: Q, F, P i R; wynik ogólny to indeks podsumowujący, a nie certyfikat, i nie ma przedziału ufności. Zasady punktacji określono w dokumencie AIHubMix Provider Benchmark Standard v2.0.
Wyniki sześciu dostawców
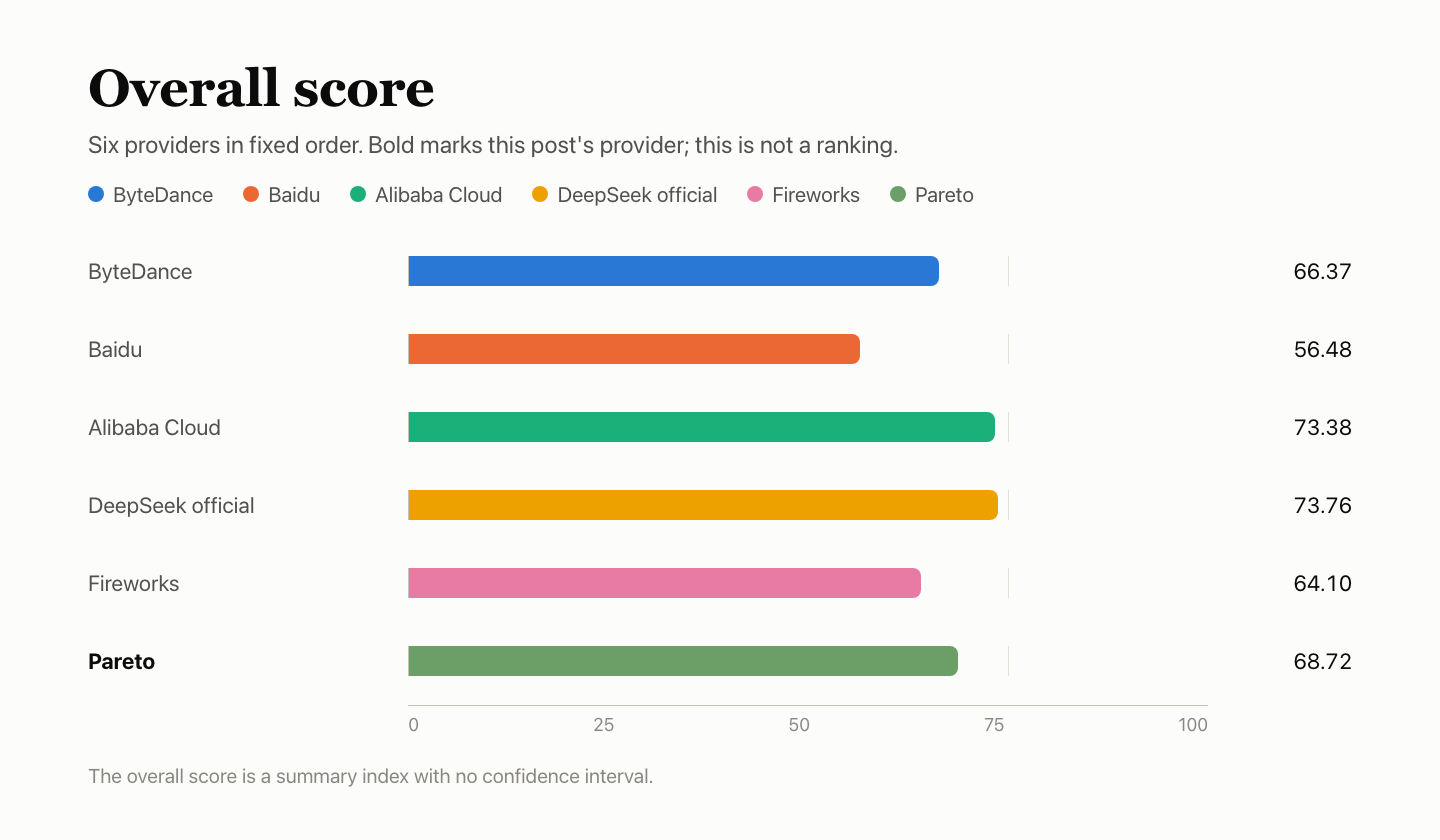
| Dostawca | Jakość Q | Funkcje F | Szybkość P | Pamięć podręczna K | Stabilność R | Wynik ogólny |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Oficjalny kanał DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (ten artykuł) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Dostawcy są wymienieni w ustalonej kolejności, a nie w rankingu. K to wynik cząstkowy P, stanowiący 20% jego wartości; podano go osobno w celach informacyjnych. Wynik ogólny obliczono zgodnie z zasadami agregacji określonymi w AIHubMix Provider Benchmark Standard, które uwzględniają również porównanie z oficjalnym kanałem i kompletność materiału dowodowego; nie jest to bezpośrednia ważona suma czterech wyników z tabeli. To indeks podsumowujący bez przedziału ufności. Wynik ogólny DeepSeek Official Channel i Alibaba Cloud różni się zaledwie o 0.37, co nie stanowi rozróżnialnej różnicy.
W skrócie
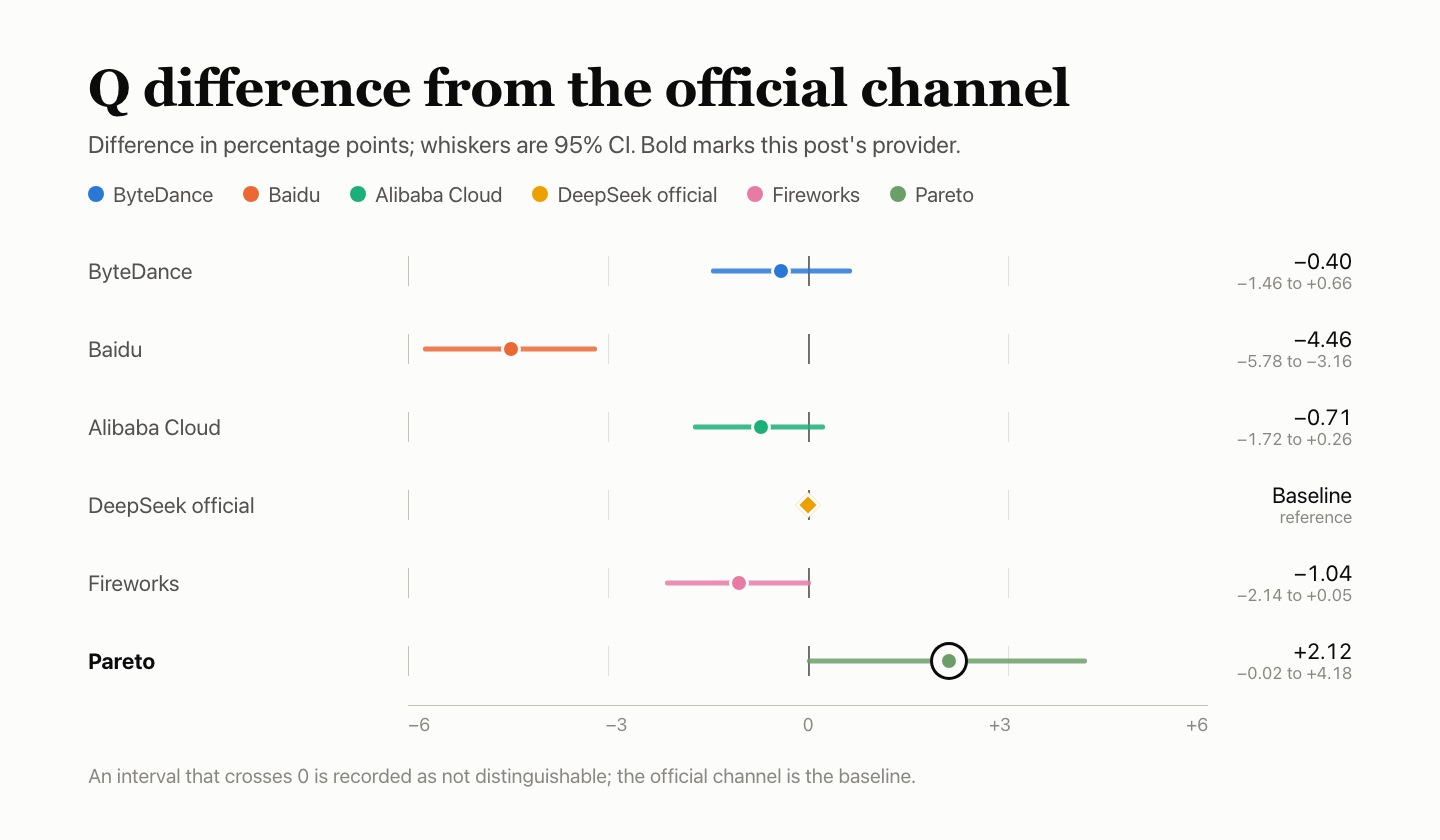
- Jakość odpowiedzi: Q 44.58; BFCL 85.27%, HLE 19.32%, AA-LCR 52.00%. Różnica względem oficjalnego kanału wynosi +2.12 punktu procentowego, a 95% przedział obejmuje wartości od −0.02 do +4.18: różnica nierozróżnialna.
- Obsługa funkcji: F 93.42; zaliczono 29 z 33 pierwotnych punktowanych kontroli. Dodatkowe pomyślne zapisy strumieniowania obejmują wywołania narzędzi i pełny obieg wyników narzędzi, wywołania równoległe i nazwane, tryb JSON oraz historię rozmowy; wyniki zachowują pierwotne wartości.
- Szybkość odpowiedzi: P 57.69. Mediana czasu do pierwszego tokenu treści wyniosła 5.85 s przy równoległości 1 i 6.13 s przy równoległości 10; TPOT to 4.63 ms. Prawidłowych było 110 ze 180 zapytań testujących szybkość.
- Pamięć podręczna: K 27.58. Gorące zapytania 8k trafiły w 2 przypadkach na 9, a gorące zapytania 32k — w 3 na 9; żaden zimny test kontrolny nie odczytał danych z pamięci podręcznej.
- Stabilność usługi: R 100. Wszystkie 300 dedykowanych zapytań powiodły się za pierwszym razem.
Konfiguracja testu
| Pozycja | Szczegóły |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Żądany identyfikator modelu | deepseek/deepseek-v4.1-flash |
| Zwrócona nazwa modelu | deepseek/deepseek-v4.1-flash |
| Ścieżka dostępu | Przez AIHubMix z identyfikatorem modelu właściwym dla dostawcy, a nie bezpośrednio przez konto dostawcy |
| Parametry | Stały profil żądań APB v2, temperature 1.0, max_tokens 16,384, limit czasu 300 s, bez automatycznych ponowień |
| Czas | 2026-11-03 18:07 – 11-04 16:33; zapytania do pamięci podręcznej: 11-05 19:31 – 11-06 10:35; wszystkie godziny w UTC+8. Wspólne dla wszystkich sześciu dostawców były jeden Mac mini, jedna sieć i jedno konto. |
| Próbki | Q: 4,250 instancji pytań; F: 180 kontroli; P: 180 zapytań; R: 300; K: 30 |
Zapytania wysyłano za pośrednictwem ścieżki szybkiego startu AIHubMix, używając identyfikatora modelu właściwego dla dostawcy; identyfikatory pozostałych dostawców wymieniono na stronie modeli. Parametry samego modelu opisano w dokumentacji API DeepSeek.
Q — jakość odpowiedzi: 44.58
Jakość odpowiedzi oceniano w trzech zestawach: 500 pytań BFCL, na które udzielono odpowiedzi po 3 razy, 250 pytań HLE, na które udzielono odpowiedzi po 10 razy, oraz 25 pytań AA-LCR, na które udzielono odpowiedzi po 10 razy. BFCL oceniano automatycznie według reguł; odpowiedzi w HLE i AA-LCR klasyfikował jako poprawne lub błędne model oceniający deepseek-flash. Wszyscy sześciu dostawcy otrzymali te same pytania, a wyniki trzech zestawów połączono w jeden wskaźnik trafności. Usunięto dziesięć odpowiedzi, ponieważ pytania nie dały się ocenić, pozostawiając 4,240 ocenianych instancji pytań.
| Zestaw | Pytania × rundy | Poprawne | Trafność | Błędy usługi |
|---|---|---|---|---|
| Wywołania narzędzi BFCL, oceniane automatycznie | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Trudne pytania i odpowiedzi HLE, oceniane przez model sędziowski | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Rozumowanie na podstawie długich dokumentów AA-LCR, oceniane przez model sędziowski | 25 × 10 | 130/250 | 52.00% | 0 |
| Łącznie · 95% przedział: 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Każda instancja pytania otrzymała pełną odpowiedź; nie wystąpiły błędy usługi.
| Kategoria BFCL | Zaliczone | Odsetek zaliczeń |
|---|---|---|
| simple_python: jedna funkcja, poprawne wywołanie i argumenty | 333/360 | 92.50% |
| multiple: wybór właściwej funkcji spośród kilku | 269/300 | 89.67% |
| parallel: jednoczesne wielokrotne wywołanie jednej funkcji | 265/300 | 88.33% |
| parallel_multiple: jednoczesne wywołanie kilku funkcji | 203/240 | 84.58% |
| irrelevance: brak odpowiedniej funkcji, więc bez wywołania | 109/150 | 72.67% |
| ahm_multi_turn: trzyetapowy łańcuch narzędzi | 100/150 | 66.67% |
Na każde pytanie BFCL udzielono odpowiedzi 3 razy; tabela sumuje wyniki z 3 rund.
Porównanie z pozostałymi pięcioma
| Dostawca | BFCL | HLE | AA-LCR | Łącznie | Względem oficjalnego |
|---|---|---|---|---|---|
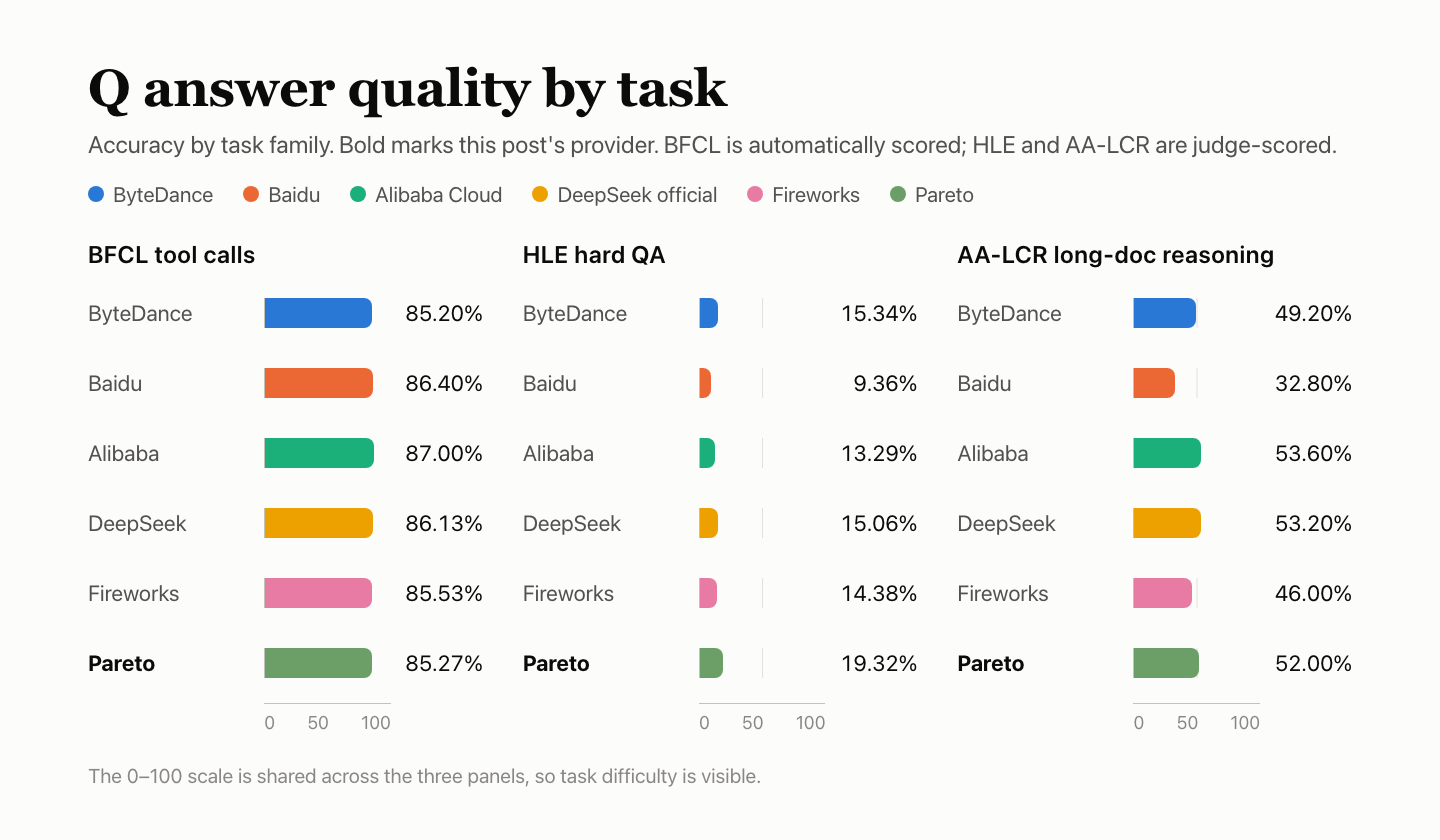
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 do +0.66), różnica nierozróżnialna |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 do −3.16), wynik niższy niż oficjalny |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 do +0.26), różnica nierozróżnialna |
| Oficjalny kanał DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Wartość bazowa |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 do +0.05), różnica nierozróżnialna |
| Pareto (ten artykuł) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 do +4.18), różnica nierozróżnialna |
Względem oficjalnego: różnica trafności w punktach procentowych, z 95% przedziałem w nawiasach; jeśli przedział obejmuje 0, wynik odnotowano jako nierozróżnialny. Model oceniający HLE i AA-LCR, deepseek-flash, należy do tej samej rodziny DeepSeek co testowany model i nie był kalibrowany, więc jego oceny mogą być pobłażliwe.
F — obsługa funkcji: 93.42
Testy funkcji sprawdzają, czy zachowanie interfejsu jest zgodne z protokołem. F 93.42 wynika z 33 zliczanych kontroli (29 zaliczono), po ponownej normalizacji wag zaobserwowanych grup; pozostałe 147 zaplanowanych miejsc na kontrole w pierwotnym zestawie wyłączono z punktacji.
| Grupa przypadków | Waga | Zaliczone / obserwacje strumieniowania | Wyłączone | Wynik grupy |
|---|---|---|---|---|
| Strumieniowanie i protokół wiadomości | 20% | 23/27 | 3 | 85.19 |
| Interfejs narzędzi Wywołania narzędzi, pełny obieg wyników narzędzi, wywołania równoległe i nazwane | 20% | Zaobserwowano zaliczenia w strumieniowaniu* | 30 | — |
| Ograniczenia wyjścia i parametry Tryb JSON i wyłączone rozumowanie | 20% | Zaobserwowano zaliczenia w strumieniowaniu* | 30 | — |
| Kontekst i stan Historia rozmowy i instrukcje systemowe | 15% | Zaobserwowano zaliczenia w strumieniowaniu* | 30 | — |
| Błędy i odzyskiwanie działania | 15% | 3/3 | 27 | 100.00 |
| Rozliczanie użycia i protokół pamięci podręcznej | 10% | 3/3 | 27 | 100.00 |
| Łącznie · wynik ważony | 29/33 | 147 | 93.42 | |
- Wymienione funkcje mają pomyślne zapisy strumieniowania; nie oznacza to maksymalnej oceny dla całej grupy. Nie dodano żadnych kontroli do punktacji. F 93.42 i wynik ogólny 68.72 zachowują pierwotne wartości.
| Niezaliczone przypadki | Okna | Przyczyna |
|---|---|---|
| Sekwencja stop w strumieniowaniu Strumieniowanie i protokół wiadomości | 3/3 | Puste body przy użyciu sekwencji stop; ten sam input bez sekwencji stop działał |
| Dokładny tekst wyjściowy Strumieniowanie i protokół wiadomości | 1/3 | Dodatkowa kropka na końcu spowodowała niezgodność przy dokładnym dopasowaniu tekstu |
„Okna” oznaczają liczbę spośród 3 okien, w których kontrola zakończyła się niepowodzeniem.
Przypadki nieprawidłowych wiadomości i nieprawidłowych opcji strumienia zwracały kod 400 z pustym body odpowiedzi u kilku dostawców. Sposób rozliczania tokenów rozumowania różnił się między dostawcami.
Porównanie z pozostałymi pięcioma
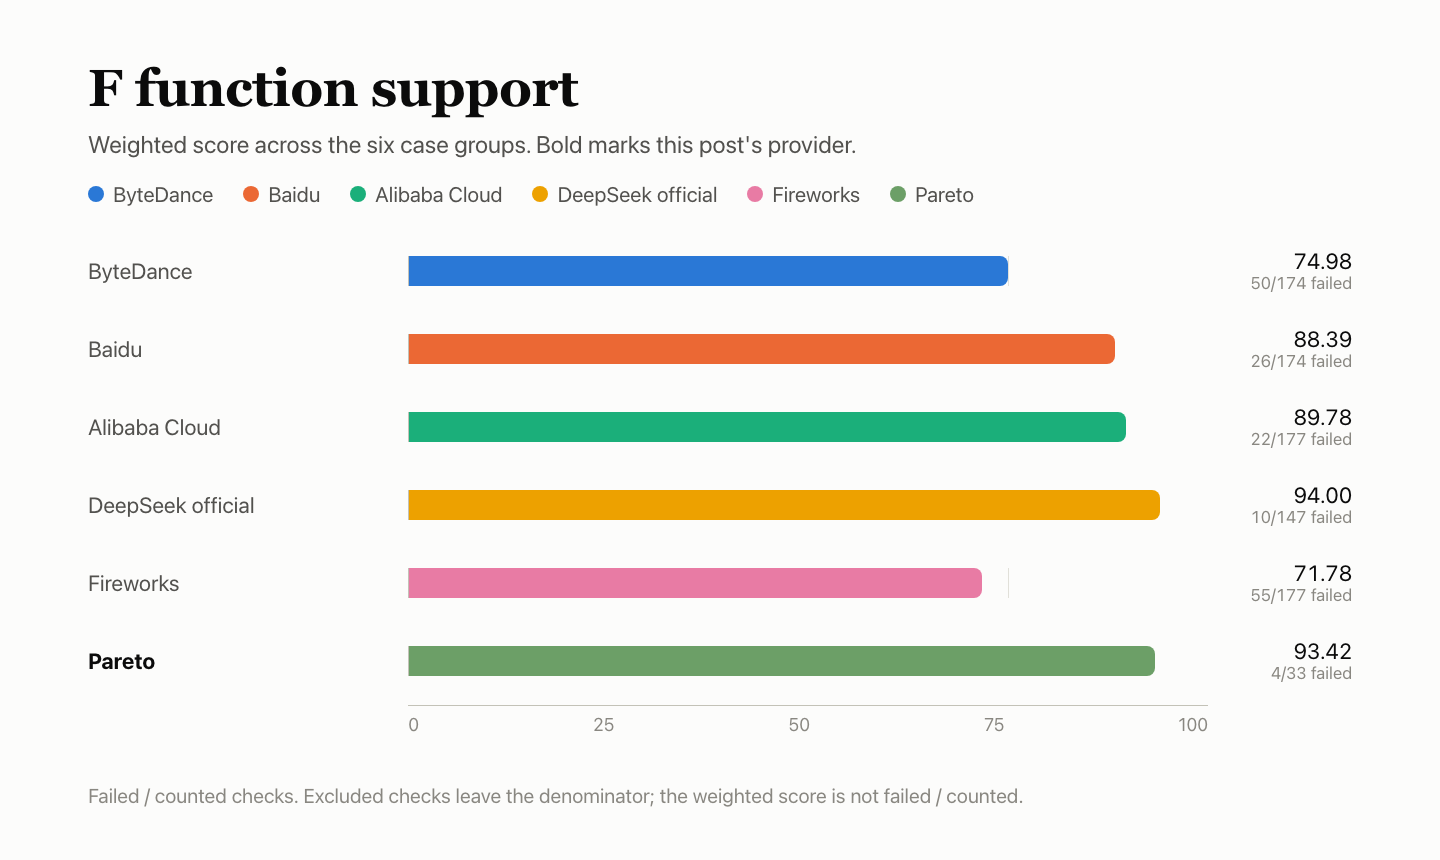
| Dostawca | Zaliczone | Niezaliczone | Wyłączone | Wynik ważony |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Oficjalny kanał DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (ten artykuł) | 29 | 4 | 147 | 93.42 |
P — szybkość odpowiedzi: 57.69
Każde zapytanie zawierało około 10,000 tokenów wejściowych i wymagało około 1,100 tokenów tekstu w body odpowiedzi. W każdym z trzech okien uruchomiono 30 zapytań przy równoległości 1 i 30 przy równoległości 10 — łącznie 180 zapytań.
| Pozycja | Szczegóły |
|---|---|
| Pierwszy token treści (TTFA) | Mediana: 5.85 s przy równoległości 1 (3.08 s tylko dla prawidłowych), 6.13 s przy równoległości 10 (4.92 s tylko dla prawidłowych) |
| Szybkość generowania (TPOT) | 4.42 ms/token przy równoległości 1, 4.63 ms/token przy równoległości 10 |
| Efektywna przepustowość | 519.4 token/s przy równoległości 10 |
| Prawidłowe zapytania | 53/90 przy równoległości 1 (okna 1–3: 15/30, 18/30, 20/30), 57/90 przy równoległości 10 (23/30, 16/30, 18/30); nieprawidłowe: 70 zwróciło kod 200 z wartością None |
| Wyniki cząstkowe | TTFA 24.59, TPOT 100.00, przepustowość 72.05; TTFA i TPOT korzystają z niższego poziomu, z wagami 35% / 35% / 30%: wynik szybkości odpowiedzi 65.22 |
| Wynik P | Wynik szybkości odpowiedzi 65.22 × 80% + pamięć podręczna K 27.58 × 20% = 57.69 |
Nieprawidłowe zapytania są punktowane tak, jakby ich czas był nieskończony, dlatego mediany w tabeli mogą być wyższe niż mediany obliczone tylko dla prawidłowych zapytań. TPOT jest szacowany na podstawie fragmentów strumieniowania, a nie mierzony dla każdego tokenu na sprzęcie. Przepustowość oblicza się jako liczbę prawidłowych tokenów wyjściowych przy równoległości 10 podzieloną przez czas trwania całej partii.
Porównanie z pozostałymi pięcioma
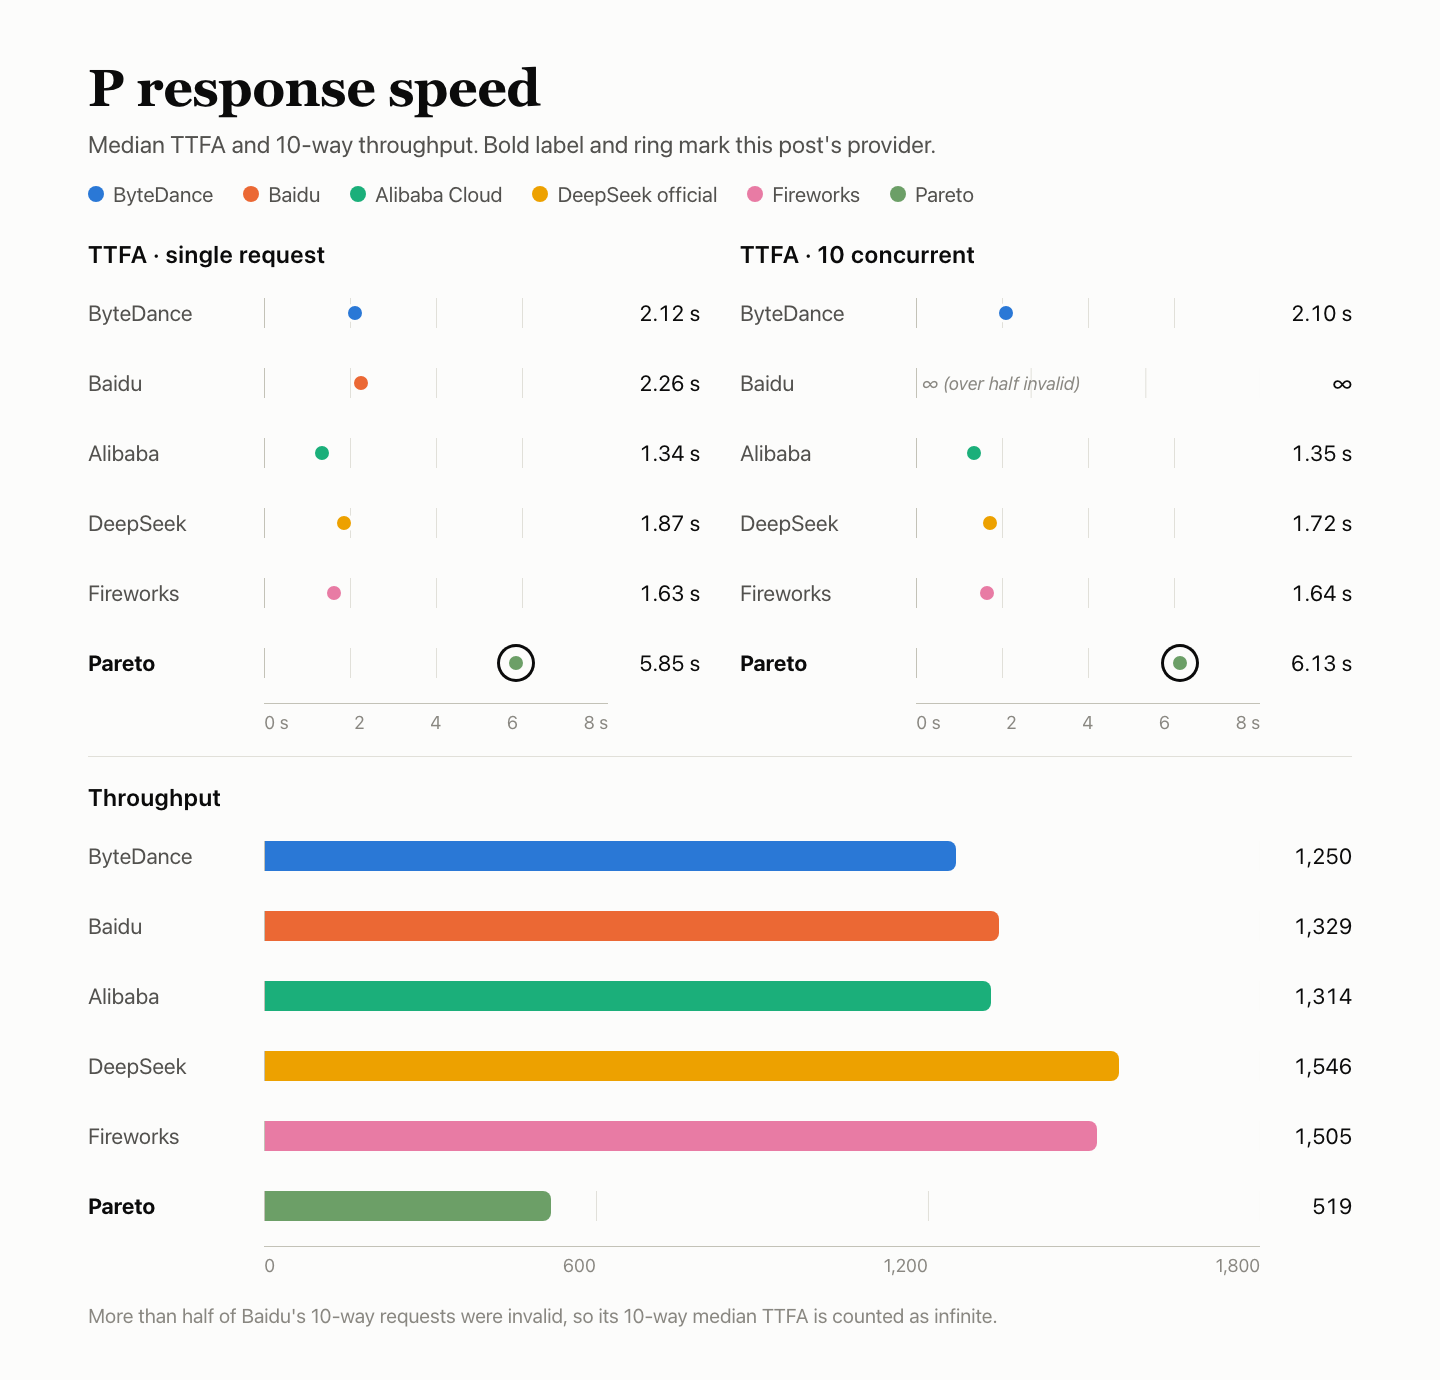
| Dostawca | Prawidłowe zapytania | TTFA, równoległość 1 | TTFA, równoległość 10 | TPOT (wolniej) | Przepustowość, token/s | Wynik szybkości odpowiedzi |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Oficjalny kanał DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (ten artykuł) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Wszystkie sześć modeli działało na tej samej maszynie, w tej samej sieci i na tym samym koncie. Trzy okna pomiarowe zaplanowano osobno dla każdego dostawcy, więc okresy zbierania danych nie pokrywają się w pełni; nie należy wyciągać zbyt daleko idących wniosków z niewielkich różnic. Symbol ∞ oznacza, że ponad połowa zapytań była nieprawidłowa, więc mediana jest traktowana jako nieskończona.
K — pamięć podręczna: 27.58
Każda grupa wysyła pięć zapytań. Pierwsze zawiera stały prefiks o długości około 8k lub 32k tokenów i zapełnia pamięć podręczną. W zapytaniach 2–4 prefiks pozostaje ten sam, zmienia się tylko końcowe pytanie, a odstępy między zapytaniami wynoszą 5 s, 30 s i 120 s. Piąte zapytanie używa nowego prefiksu jako kontroli bez trafienia w pamięć podręczną. Trzy okna × dwie długości dają 30 zapytań. K to liczba tokenów odczytanych z pamięci podręcznej przez gorące zapytania podzielona przez liczbę tokenów, które zgodnie z przyjętymi zasadami powinny nadawać się do ponownego użycia; obie długości mają równą wagę. K stanowi 20% P.
| Okno | 1 · zapełnienie | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · kontrola bez trafienia |
|---|---|---|---|---|---|
| Prefiks 8k · trafienia gorących zapytań 2/9 · odczytano 15,872 z 72,504 tokenów kwalifikujących się do ponownego użycia · 21.89 | — | — | — | — | — |
| Okno 1 | 0 | 0 | 7,936 | 0 | 0 |
| Okno 2 | 0 | 0 | 0 | 0 | 0 |
| Okno 3 | 0 | 0 | 7,936 | 0 | 0 |
| Prefiks 32k · trafienia gorących zapytań 3/9 · odczytano 96,000 z 288,513 tokenów kwalifikujących się do ponownego użycia · 33.27 | — | — | — | — | — |
| Okno 1 | 0 | 0 | 32,000 | 0 | 0 |
| Okno 2 | 0 | 0 | 0 | 0 | 0 |
| Okno 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (równa waga dla 8k i 32k) | — | — | — | — | 27.58 |
Podane wartości oznaczają liczbę tokenów odczytanych z pamięci podręcznej, zgłoszoną przez serwer; „Nie zwrócono” oznacza, że pole nie występowało w odpowiedzi.
Gorące zapytania z prefiksem 8k trafiły w pamięć podręczną w 2 z 9 przypadków, odczytując po 7,936 tokenów przy każdym trafieniu; zapytania z prefiksem 32k trafiły w 3 z 9 przypadków, odczytując po 32,000 tokenów przy każdym trafieniu. Zapytania kontrolne bez trafienia nie odczytały danych z pamięci podręcznej, więc gorące i kontrolne można wyraźnie rozróżnić.
Porównanie z pozostałą piątką
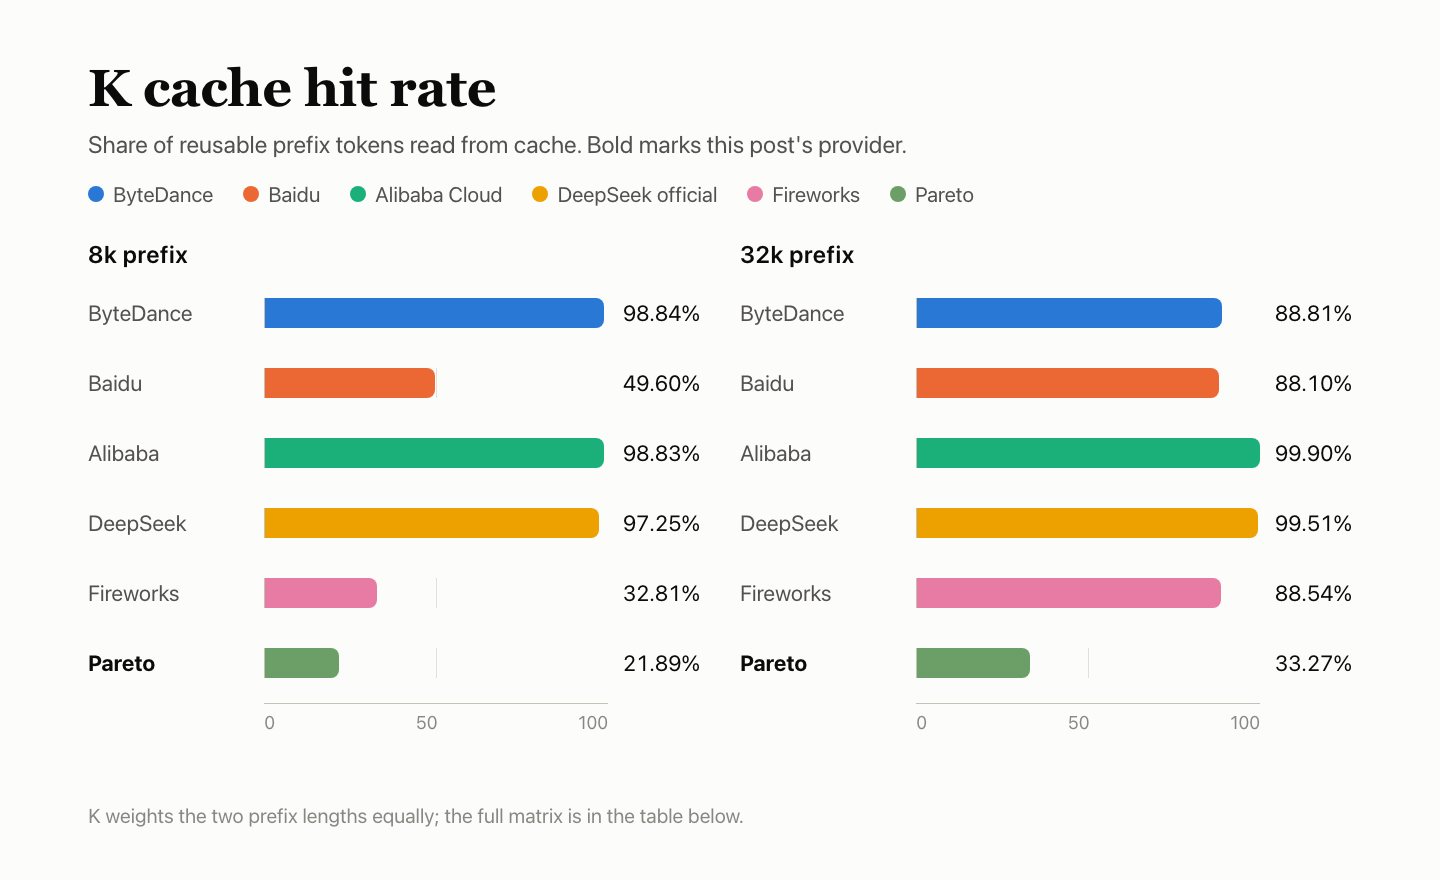
| Dostawca | Trafienia dla 8k | 8k | Trafienia dla 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Oficjalny kanał DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (ten artykuł) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — stabilność usługi: 100
300 zapytań podzielono na cztery typy: krótki tekst, długie wejście, wywołania narzędzi i historię wieloturową. Wysłano je z pojedynczą współbieżnością w trzech oknach pomiarowych. Sprawdzano tylko, czy pierwsza próba zwróciła prawidłową i kompletną odpowiedź; odpowiedzi nie były oceniane i nie ponawiano prób. Błędy w sekcjach dotyczących jakości odpowiedzi i szybkości są uwzględniane w Q i P, a nie ponownie w R.
| Typ zapytania | Powodzenie za pierwszym razem |
|---|---|
| Krótki tekst | 120/120 |
| Długie wejście 10k | 90/90 |
| Wywołania narzędzi | 60/60 |
| Historia wieloturowa | 30/30 |
| Łącznie · przedział 95%: 98.78%–100% | 300/300 |
Wszystkie 300 zapytań zwróciły prawidłową i kompletną odpowiedź za pierwszym razem. R = 100 dotyczy wyłącznie tych 300 dedykowanych zapytań; nie oznacza, że w całym łańcuchu nie wystąpiły błędy. Dolna granica przedziału 95% wynosi 98.78%: 300 sukcesów na 300 oznacza jedynie, że prawdopodobnie odsetek błędów jest niższy niż 1.22%.
Porównanie z pozostałą piątką
| Dostawca | Powodzenie za pierwszym razem | Przedział 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Oficjalny kanał DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (ten artykuł) | 300/300 | 98.78%–100% |
R obejmuje wyłącznie te 300 dedykowanych zapytań; błędy w sekcjach dotyczących jakości odpowiedzi i szybkości są odnotowywane w Q i P i nie są ponownie uwzględniane w R.
FAQ
Dlaczego F wynosi 93.42, skoro uwzględniono tylko 33 testy?
Pierwotnie zliczone testy zaliczyły 29 z 33 prób, co po ponownej normalizacji wag zaobserwowanych grup dało F 93.42; pozostałe 147 zaplanowanych miejsc na testy wyłączono z oceny. Zapis strumieniowania opisuje konkretne działające funkcje i nie dodaje ocenianych testów. Wyświetlany wynik ogólny pozostaje równy 68.72.
Dlaczego P wynosi 57.69, skoro TPOT otrzymało 100.00 punktów?
Tylko 110 z 180 zapytań dotyczących szybkości było prawidłowych; 70 zwróciło 200 z wartością None. Nieprawidłowe zapytania liczą się jako nieskończone, więc mediana czasu do pierwszego tokenu odpowiedzi wynosi 5.85 s przy pojedynczej współbieżności i 6.13 s przy współbieżności 10 (odpowiednio 3.08 s i 4.92 s wyłącznie dla prawidłowych zapytań). TTFA otrzymało 24.59 punktów, a przepustowość 72.05, co dało wynik odpowiedzi 65.22; po uwzględnieniu K = 27.58 dla pamięci podręcznej z wagą 20% P wynosi 57.69.
Dlaczego K wynosi zaledwie 27.58?
Gorące zapytania trafiły w pamięć podręczną w 2 z 9 przypadków dla 8k (21.89) i w 3 z 9 przypadków dla 32k (33.27), a obie długości mają równą wagę. Gdy dochodziło do trafienia, odczytywano 7,936 lub 32,000 tokenów, a żadne zapytanie kontrolne nie odczytało danych z pamięci podręcznej.
Czy jakość odpowiedzi Pareto jest wyższa niż jakość oficjalnego kanału?
Nie w sposób, który można odróżnić statystycznie. Łączna trafność wynosi 44.58% wobec 42.45%, co daje różnicę +2.12 punktu, ale przedział 95% rozciąga się od −0.02 do +4.18 i obejmuje 0. Sędzia dla HLE i AA-LCR, deepseek-flash, nie został skalibrowany i może oceniać zbyt łagodnie.
Które testy F nie przeszły?
Dwa. Sekwencja zatrzymująca strumieniowanie zwróciła pustą treść we wszystkich trzech oknach, podczas gdy to samo wejście bez sekwencji zatrzymującej zadziałało. W jednym z trzech okien dokładne wyjście tekstowe zawierało dodatkową kropkę na końcu.
Czytaj dalej: seria DeepSeek V4.1 Flash
- Różnica Q Pareto wynosząca +2.12 została zmierzona względem oficjalnego kanału; pomiar bazowy tego kanału opisano w artykule Oficjalny kanał DeepSeek — recenzja DeepSeek V4.1 Flash: punkt odniesienia do porównań, 15 nieprawidłowych zapytań przy pojedynczej współbieżności.
- Fireworks również zwracał pustą treść przy zapytaniach z sekwencją zatrzymującą, a dla 8k odnotował 3 trafienia na 9: Recenzja DeepSeek V4.1 Flash w Fireworks: zapytania z sekwencją zatrzymującą zwracają pustą treść, 3 trafienia na 9 gorących zapytań z prefiksem 8k.
- Gorące zapytania w Alibaba Cloud trafiły w pamięć podręczną w 18 z 18 przypadków, wobec 5 z 18 w Pareto: Recenzja DeepSeek V4.1 Flash w Alibaba Cloud: 1.34 s do pierwszego tokenu odpowiedzi, trafienie w pamięć podręczną dla wszystkich 18 gorących zapytań, odpowiedzi nie do odróżnienia od oficjalnych.
- Wszystkie zapytania dotyczące szybkości w ByteDance były prawidłowe, a czas do pierwszego tokenu odpowiedzi wyniósł 2.12 s: Recenzja DeepSeek V4.1 Flash w ByteDance: odpowiedzi nie do odróżnienia od oficjalnych, liczby tokenów wejściowych się nie zgadzają.
- Baidu również utraciło wiele zapytań dotyczących szybkości z powodu no_available_channel: Recenzja DeepSeek V4.1 Flash w Baidu: wywoływanie narzędzi na poziomie oficjalnego kanału, częste błędy no-available-channel obniżają jakość odpowiedzi i szybkość.
Źródła
- Strona modelu DeepSeek V4.1 Flash 1017 (AIHubMix)
- Standard testów porównawczych dostawców AIHubMix v2.0 (dokumentacja AIHubMix)
- Szybki start (dokumentacja AIHubMix)
- Modele (AIHubMix)
- Dokumentacja API DeepSeek (DeepSeek)


