

W dniach 2026-11-03/04 DeepSeek V4.1 Flash 1017 przetestowano w pełnym zestawie APB u pięciu dostawców, korzystając z AIHubMix i tych samych pytań, parametrów oraz skryptów żądań. Ten profil APB obejmuje wyłącznie Fireworks. Model figuruje pod nazwą DeepSeek V4.1 Flash 1017.
Wyniki to Q 41.42, F 71.78, P 79.51, K 60.68 i R 100; indeks ogólny wynosi 64.10. W tym wpisie podajemy wyłącznie wyniki — bez rankingu i rekomendacji dostawcy. Najpierw prezentujemy Q, F, P, K i R; indeks ogólny to liczba podsumowująca, bez przedziału ufności. Zastosowano standard AIHubMix Provider Benchmark Standard v2.0.
Wyniki pięciu dostawców
Pogrubieniem oznaczono dostawcę opisywanego w tym wpisie. Kolejność dostawców jest stała i nie odzwierciedla rankingu. K jest składową wyniku P o wadze 20%. Indeks ogólny to liczba podsumowująca, bez przedziału ufności. Wyniki DeepSeek official channel i Alibaba Cloud różnią się o 0.37 i nie da się ich od siebie odróżnić.
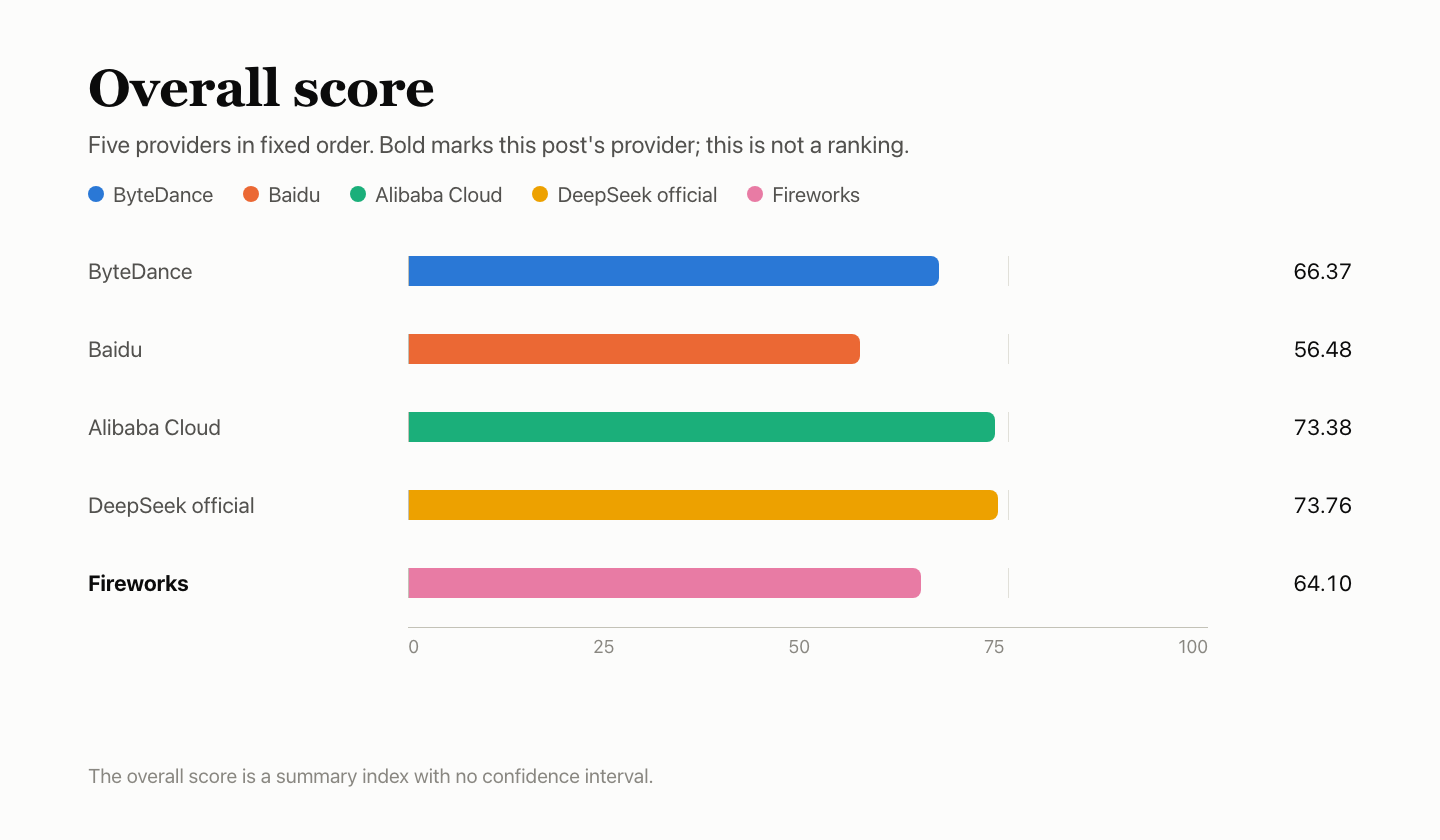
W skrócie
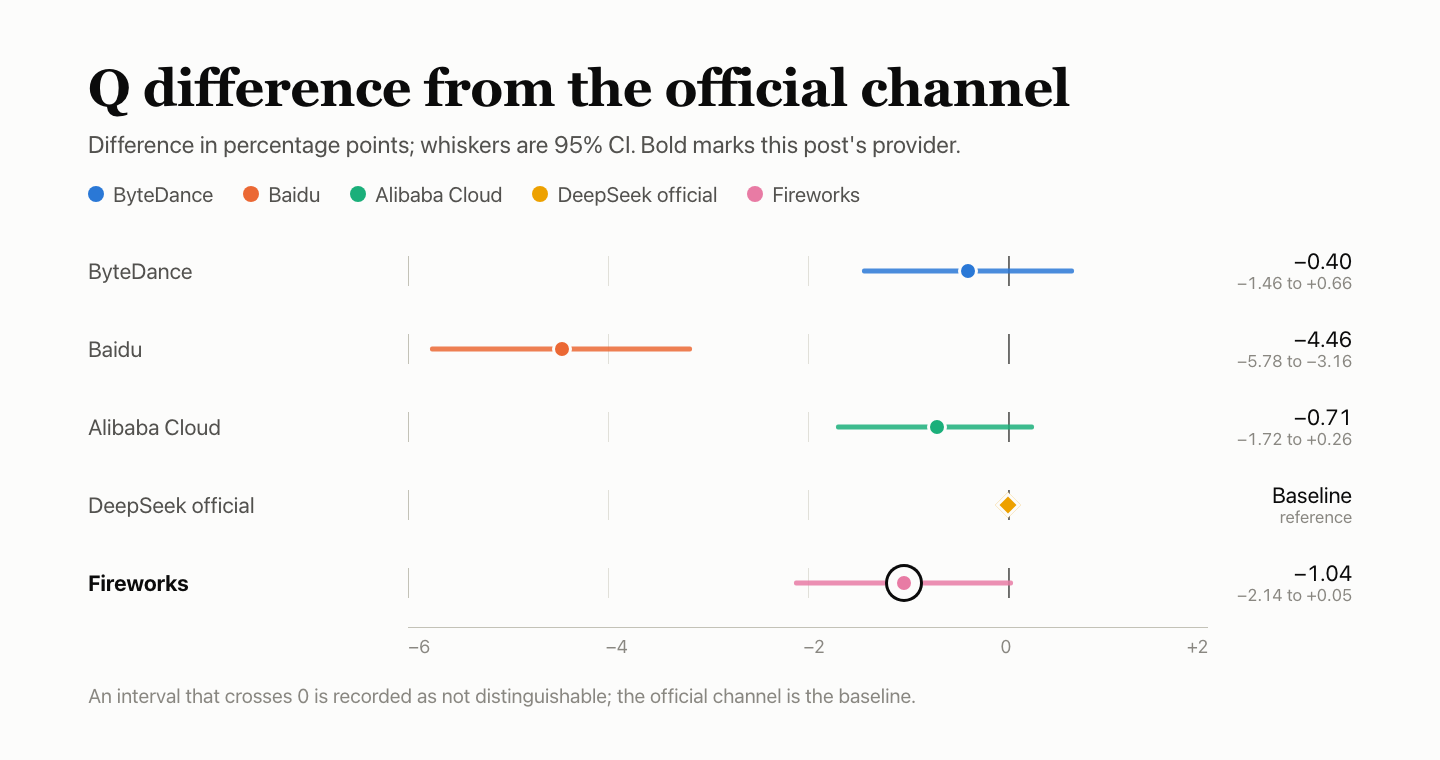
- Q — jakość odpowiedzi: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. W porównaniu z oficjalnym kanałem: −1.04 punktu procentowego, 95% CI od −2.14 do +0.05 — różnica nie jest istotna. Wszystkie 34 błędne odpowiedzi w AA-LCR przypadły na okno 2 i uznano je za niepoprawne.
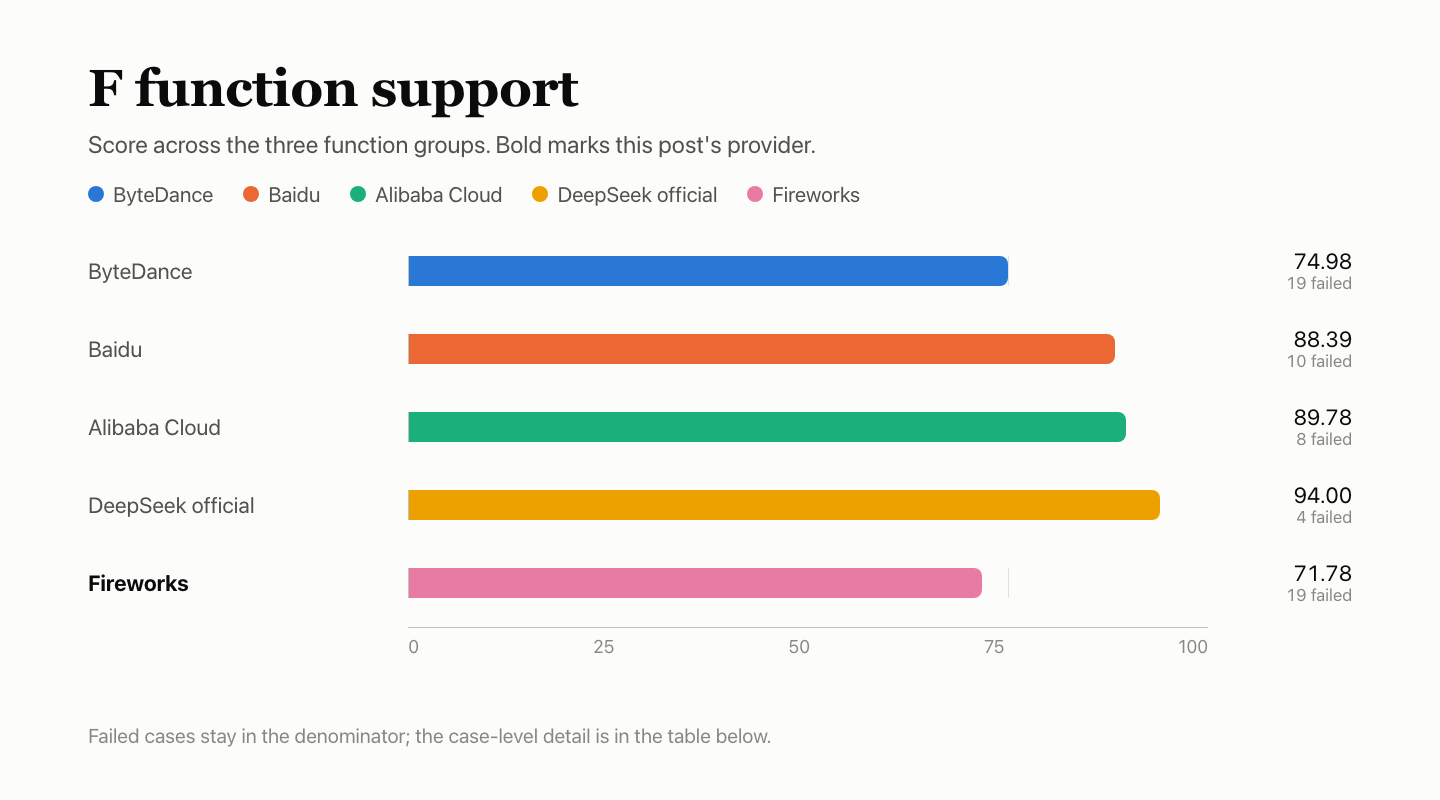
- F — obsługa funkcji: 71.78. Zaliczone 122/177 uwzględnionych kontroli. W obu przypadkach ze stop odpowiedź miała puste body;
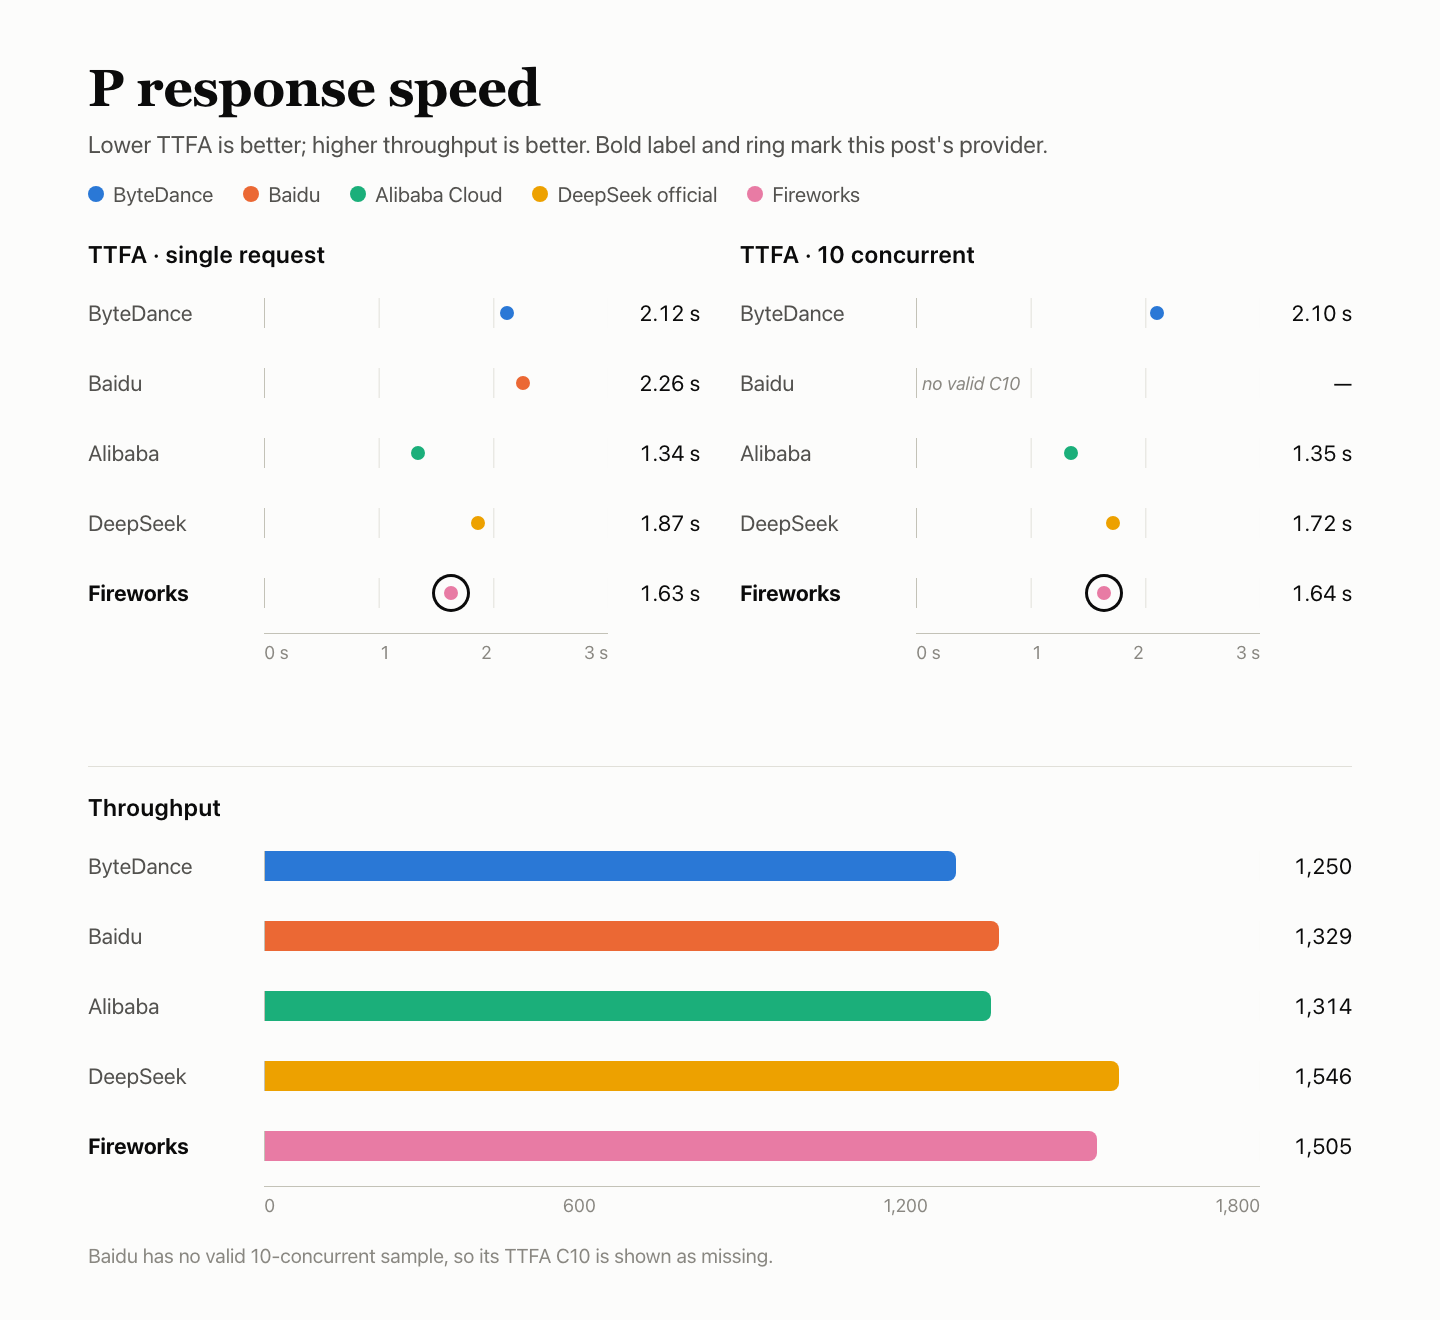
reasoning_effort=nonenie wyłączyło myślenia; dla wejścia 10k zgłoszono 10,026 tokenów, podczas gdy natywna liczba wynosiła 10,000. - P — szybkość odpowiedzi: 79.51. Wynik za odpowiedzi: 84.22, K za pamięć podręczną stanowi 20%. Mediana TTFA: 1.63 s przy jednym równoczesnym żądaniu i 1.64 s przy 10; TPOT: 3.29 ms. 1 ze 180 wyników zawierał tylko jeden token i został oznaczony jako nieprawidłowy.
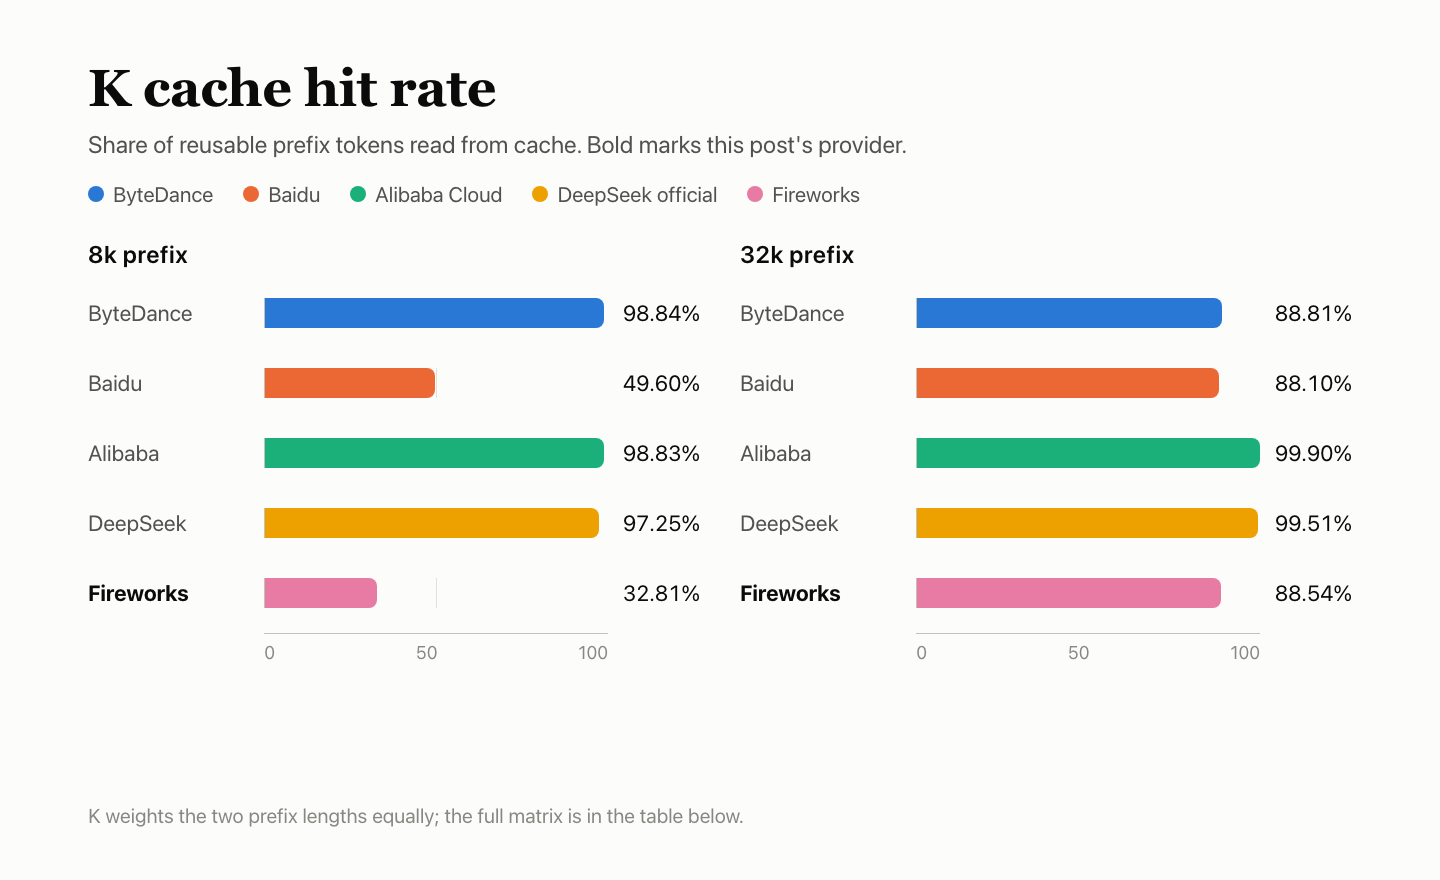
- K — pamięć podręczna: 60.68. W testach K zastosowano udokumentowaną powinowatość sesji. Trafienia w gorący cache dla 32k: 8/9; dla 8k: 3/9.
- R — stabilność usługi: 100. Wszystkie 300/300 dedykowanych żądań powiodły się za pierwszym razem.
Konfiguracja testu
| Element | Ustawienie |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Żądany identyfikator modelu | fireworks-deepseek-v4.1-flash-1017 |
| Zwrócona nazwa modelu | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Ścieżka dostępu | Identyfikator modelu dostawcy w AIHubMix, a nie konto samego dostawcy |
| Parametry | Bez myślenia, temperature 1.0, max_tokens 16,384, limit czasu 300 s, bez ponawiania |
| Wyłączone myślenie | Natywne ustawienie thinking.type=disabled; reasoning_effort=none nie wyłącza myślenia. W przypadkach dotyczących funkcji pozostawiono reasoning_effort=none. |
| Czas | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Jeden Mac mini, ta sama sieć i konto dla wszystkich pięciu. |
| Próbki | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Dodatkowe ustawienia | W testach K użyto udokumentowanego pola user oraz nagłówka x-session-affinity, aby zachować powinowatość do repliki. |
Żądania wysyłano zgodnie z szybkim przewodnikiem AIHubMix; identyfikatory modeli znajdują się na stronie modeli. Aby wyłączyć myślenie, użyto natywnego ustawienia thinking.type=disabled z dokumentacji API modelu.
Q — jakość odpowiedzi: 41.42
Zestaw obejmował 500 pytań BFCL × 3 rundy, 250 HLE × 10 oraz 25 AA-LCR × 10. BFCL oceniano automatycznie; HLE i AA-LCR oceniał deepseek-flash. Wszyscy pięciu otrzymali te same pytania. Usunięto dziesięć odpowiedzi, których nie dało się ocenić; pozostało 4,240 ocenionych przypadków.
| Zadanie | Pytania | Poprawne | Trafność | Błędy |
|---|---|---|---|---|
| Wywołania narzędzi BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Trudne pytania i odpowiedzi HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Rozumowanie na podstawie długich dokumentów AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Łącznie · 95% CI 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Błędy pozostają w mianowniku i liczą się jako odpowiedzi niepoprawne: BFCL 2 (okna 2 i 3), HLE 5 uciętych po osiągnięciu max_tokens, AA-LCR 34 — wszystkie w oknie 2.
| Kategoria BFCL | Zaliczone | Odsetek zaliczeń |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python zaliczyło 333/360 przypadków (92.50%), parallel 270/300 (90.00%), ahm_multi_turn 95/150 (63.33%), a irrelevance 111/150 (74.00%).
Porównanie z pozostałymi czterema
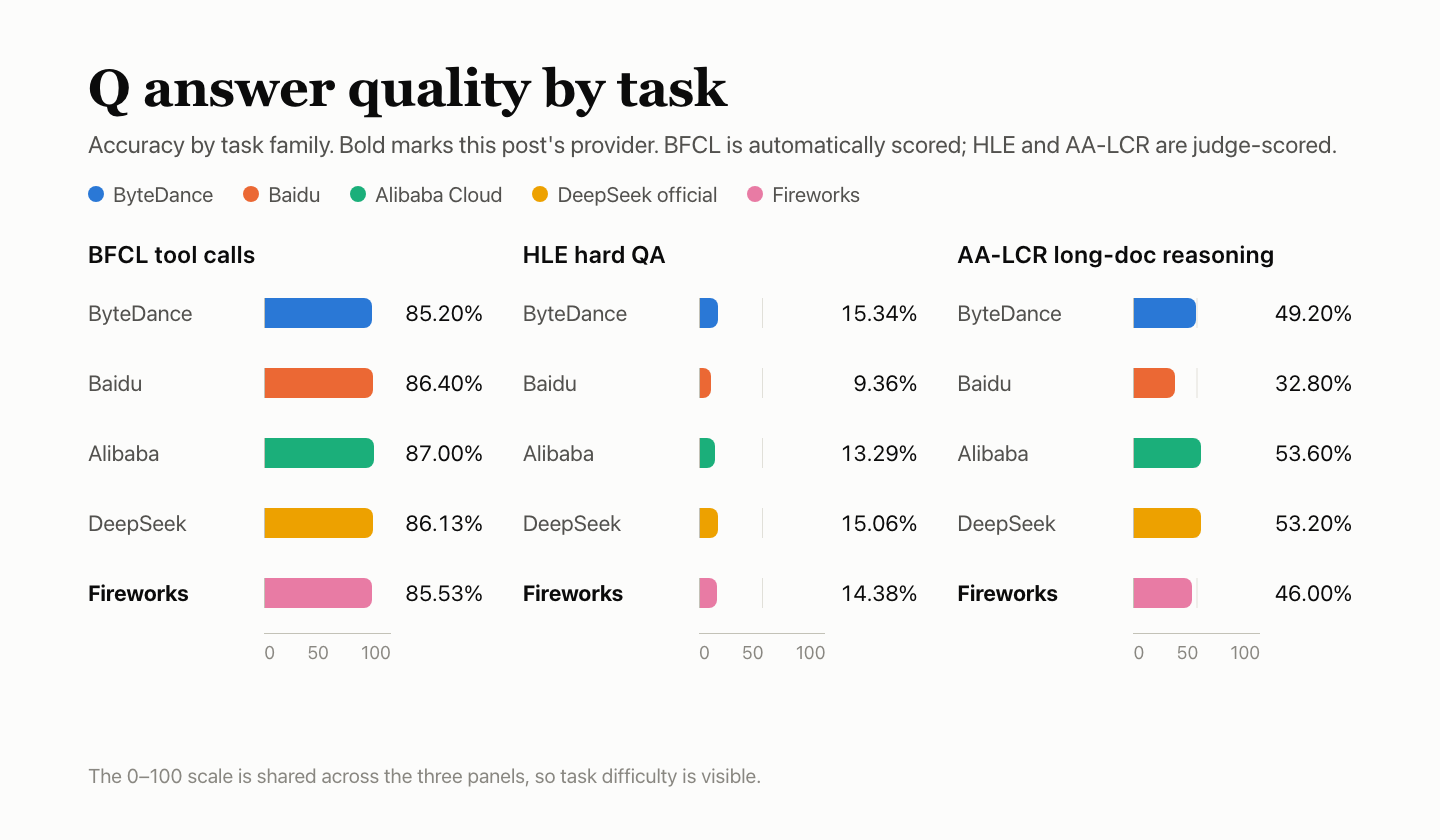
Różnica w punktach procentowych względem oficjalnego kanału; przedział 95% przedstawiono jako wąsy. Przecięcie z 0 oznacza, że wyników nie da się od siebie odróżnić. Sędzia deepseek-flash należy do tej samej rodziny modeli i nie został skalibrowany, więc może oceniać łagodnie.
F — obsługa funkcji: 71.78
Na 60 przypadków składa się sześć grup, z których każdą uruchomiono w trzech oknach: 180 kontroli ocenionych względem formatu udokumentowanego przez dostawcę. Kontrole nieadekwatne, nieprawidłowe i nieobserwowane pominięto w mianowniku. Zaliczone 122 z 177 uwzględnionych kontroli; wynik ważony grupami to 71.78.
| Grupa przypadków | Waga | Zaliczone | Wykluczone | Wynik grupy |
|---|---|---|---|---|
| Strumieniowanie i komunikaty | 20% | 24/30 | — | 80.00 |
| Interfejs narzędzi | 20% | 29/30 | — | 96.67 |
| Ograniczenia wyjścia | 20% | 21/30 | — | 70.00 |
| Kontekst i stan | 15% | 15/30 | — | 50.00 |
| Błędy i odzyskiwanie | 15% | 21/30 | — | 70.00 |
| Rozliczanie i pamięć podręczna | 10% | 12/27 | 3 | 44.44 |
| Łącznie · wynik ważony | — | 122/177 | 3 | 71.78 |
„Nieudane okna” to liczba trzech okien, w których dany przypadek nie został zaliczony.
| Nieudany przypadek | Nieudane okna | Przyczyna |
|---|---|---|
| Stop w strumieniowaniu | 3/3 | Puste body przy stop; bez stop działa. |
| Rozumowanie w body | 3/3 | reasoning_effort=none mimo to zwróciło rozumowanie. |
| Sekwencja stop | 3/3 | Puste body przy stop; bez stop działa. |
| Ustawienie myślenia | 3/3 | reasoning_effort=none mimo to zwróciło rozumowanie. |
| Różnorodność próbkowania | 3/3 | Wyniki dla Temp 0/1 zbyt podobne |
| Długie wejście 10k | 3/3 | Zgłoszono 10,026; natywnie 10,000. |
| W granicach limitu kontekstu | 3/3 | Zgłoszono 10,026; natywnie 10,000. |
| Długie wejście 32k | 3/3 | Zgłoszono 10,026; natywnie 10,000. |
| Długie wejście 100k | 3/3 | Zgłoszono 10,026; natywnie 10,000. |
| Przekroczenie kontekstu | 3/3 | Oczekiwano błędu parametru; zwrócono 200. |
| Nieprawidłowe komunikaty | 3/3 | 400, puste body |
| Osierocony wynik narzędzia | 3/3 | Oczekiwano błędu parametru; zwrócono 200. |
| Nieprawidłowe stream_options | 3/3 | 400, puste body |
| Rozliczanie tokenów myślenia | 3/3 | Zgłoszono tokeny myślenia po wyłączeniu. |
| Natywna liczba tokenów wejściowych | 3/3 | Zgłoszono 34; natywnie 8. |
| Definicje narzędzi w wejściu | 3/3 | Już kontrola bez narzędzi wykazała niezgodność. |
| Liczba tokenów wejściowych przy użyciu pamięci podręcznej | 3/3 | Liczba tokenów powtarzanego prefiksu nie zgadzała się z natywną. |
| Zgodność liczby tokenów wejściowych w strumieniowaniu | 3/3 | Zgłoszono 34; natywnie 8 |
| Jedno narzędzie naraz | 1/3 | Błąd upstream 500. |
W obu przypadkach ze stop odpowiedź miała puste body, a przy tym samym wejściu bez stop działała — we wszystkich trzech oknach. reasoning_effort=none mimo to zwróciło rozumowanie w obu przypadkach dotyczących myślenia.
Wykluczone kontrole nie są zaliczane ani jako sukces, ani jako porażka.
| Status | Przypadek | Liczba | Przyczyna |
|---|---|---|---|
| Nie dotyczy | Jawne cache_control | 3 | Z góry określono, że ten interfejs tego nie obsługuje |
Nieprawidłowe messages i stream_options zakończyły się błędem u wszystkich pięciu: zwrócono 400 z pustym body i bez ustrukturyzowanego błędu. Ponieważ wynik był wspólny, przyczyna najpewniej leży po stronie warstwy bramy AIHubMix; wymaga to osobnego zbadania. Rozliczanie tokenów myślenia również nie powiodło się u wszystkich pięciu, ale ByteDance i Fireworks zgłosiły tokeny myślenia po wyłączeniu, a pozostałe trzy nie zwróciły ich liczby.
Porównanie z pozostałymi czterema
P — szybkość odpowiedzi: 79.51
Każde żądanie zawierało około 10,000 tokenów wejściowych i prosiło o około 1,100 tokenów wyjściowych. W każdym z trzech okien wysłano 30 żądań przy jednym równoczesnym żądaniu i 30 przy 10 równoczesnych żądaniach, łącznie 180.
| Metryka | Wynik |
|---|---|
| TTFA | 1.63 s przy jednym równoczesnym żądaniu; 1.64 s przy 10 |
| TPOT | 3.24 ms przy jednym równoczesnym żądaniu; 3.29 ms przy 10 |
| Przepustowość goodput | 1,504.5 token/s przy 10 |
| Prawidłowe | 90/90 przy jednym równoczesnym żądaniu; 89/90 przy 10 (29/30 w oknie 3), jeden wynik zawierał tylko jeden token |
| Składowe | TTFA 54.91, TPOT 100.00, goodput 100.00; wagi 35/35/30 |
| Składniki wyniku P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 ze 180 wyników było prawidłowych; nieprawidłowe żądanie zwróciło jeden token i w medianach liczy się jako nieskończoność, dlatego mediany mogą być wyższe niż dla samych prawidłowych żądań. TPOT obliczono na podstawie fragmentów strumienia; goodput to liczba prawidłowych tokenów wyjściowych przy 10 równoczesnych żądaniach podzielona przez czas całej partii.
Jedna maszyna, sieć i konto; okna testowe harmonogramował dostawca.
K — pamięć podręczna: 60.68
Każda grupa składa się z pięciu żądań: najpierw utworzenie prefiksu 8k lub 32k, następnie użycie tego samego prefiksu z nowym końcowym pytaniem po 5 s, 30 s i 120 s, a na końcu nowego prefiksu jako kontroli zimnego cache. Trzy okna × dwie długości = 30. K to liczba tokenów odczytanych z gorącego cache podzielona przez liczbę tokenów możliwych do ponownego wykorzystania; obie długości mają równą wagę. K stanowi 20% wyniku P.
| Prefiks | Okno | Wstępne żądanie | +5 s | +30 s | +120 s | Kontrola zimnego cache |
|---|---|---|---|---|---|---|
| 8k | Okno 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Okno 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Okno 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Okno 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Okno 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Okno 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Prefiks 8k trafił w 3 z 9 gorących żądań, odczytując 23,706 z 72,252 tokenów możliwych do ponownego użycia (32.81). Prefiks 32k trafił w 8 z 9, odczytując 255,212 z 288,261 (88.54). K wynosi 60.68 przy równym ważeniu obu długości. Kontrole bez pamięci podręcznej odczytały 0. Prefiksy o obu długościach zachowywały się więc inaczej mimo zastosowania tej samej konfiguracji. W sondach K użyto udokumentowanego pola user i nagłówka x-session-affinity.
R — stabilność usługi: 100
300 żądań obejmowało krótkie teksty, długie dane wejściowe, wywołania narzędzi i historię wielu tur, przy współbieżności równej 1, w trzech oknach. Sprawdzano wyłącznie poprawność i kompletność pierwszej odpowiedzi; odpowiedzi nie były oceniane i nie ponawiano żadnych żądań. Błędy Q i P nie są tu ponownie uwzględniane.
| Typ żądania | Powodzenie przy pierwszej próbie |
|---|---|
| Krótki tekst | 120/120 |
| Długie dane wejściowe 10k | 90/90 |
| Wywołanie narzędzia | 60/60 |
| Historia wielu tur | 30/30 |
| Łącznie · 95% przedział ufności 98.78%–100% | 300/300 |
Wszystkie 300 żądań zakończyły się poprawną i kompletną odpowiedzią za pierwszym razem. Przy 300 sukcesach dolna granica 95% przedziału wynosi 98.78%, więc dane potwierdzają jedynie, że odsetek błędów jest niższy niż 1.22%. R 100 dotyczy tych 300 żądań, a nie całej ścieżki.
| Dostawca | Powodzenie przy pierwszej próbie | 95% przedział |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Co obejmuje Q 41.42?
BFCL, HLE i AA-LCR w 4,240 ocenianych przypadkach: 1,756 poprawnych odpowiedzi, 41.42%, 95% przedział ufności 39.13%–43.59%; różnicy względem oficjalnego kanału nie da się odróżnić od przypadku.
Dlaczego oba przypadki z parametrem stop zakończyły się błędem?
Żądanie z parametrem stop zwracało puste body we wszystkich trzech oknach, podczas gdy to samo wejście bez stop działało. Problem występował zarówno w przypadku strumieniowania, jak i bez niego.
Czy reasoning_effort=none wyłącza myślenie?
Nie. We wszystkich trzech oknach nadal zwracana była treść rozumowania; w pozostałych żądaniach użyto natywnego ustawienia thinking.type=disabled.
Dlaczego wejście 10k jest podawane jako 10,026 tokenów?
Przypadek 10k wykazał 10,026 tokenów zamiast natywnych 10,000. W przypadkach 32k i 100k wykazano tę samą wartość 10,026, a rozbieżność wystąpiła już w kontroli bez narzędzi.
Dlaczego prefiks 8k trafił w 3/9, a 32k w 8/9?
W obu przypadkach zastosowano tę samą konfigurację i udokumentowane ustawienia affinity. Różnica dotyczy odczytów raportowanych przez serwer: 8k trafił w oknach 1 i 2, a 32k we wszystkich trzech.
Co obejmuje R 100?
300 dedykowanych żądań, wszystkie poprawne przy pierwszej próbie; dolna granica 95% przedziału wynosi 98.78%. Błędy Q i P nie są wliczane do R.
Czytaj dalej: seria DeepSeek V4.1 Flash
- ByteDance, podobnie jak Fireworks, raportował tokeny rozumowania po jego wyłączeniu: DeepSeek V4.1 Flash w ByteDance: wywołania narzędzi się zgadzają, rozliczanie nie
- W Baidu odnotowano Q 38.00 i P 37.77: DeepSeek V4.1 Flash w Baidu: żaden dostępny kanał nie osiąga Q i P
- Alibaba Cloud odnotował czas do pierwszego tokenu 1.34 s i trafienia w pamięci podręcznej na poziomie 99.37: DeepSeek V4.1 Flash w Alibaba Cloud: pierwszy token po 1.34s, trafienia w pamięci podręcznej 99.37
- Oficjalny kanał stanowi punkt odniesienia dla Q, a F wynosi 94.00: DeepSeek V4.1 Flash w oficjalnym kanale: F 94.00, 15 nieprawidłowych sond


