

W dniach 2026-11-03/04 przetestowano DeepSeek V4.1 Flash 1017 u pięciu dostawców za pośrednictwem AIHubMix, korzystając z pełnego zestawu APB: za każdym razem tych samych pytań, parametrów i skryptów żądań. Ten profil APB obejmuje wyłącznie test Baidu, sekcja po sekcji.
Poniższe liczby to wyłącznie wyniki, a nie ranking ani rekomendacja dostawcy. Najpierw podano Q 38.00, F 88.39, P 37.77, K 68.85 i R 100; wynik ogólny 56.48 to indeks zbiorczy bez przedziału ufności. Zastosowano zasady punktacji określone w standardzie AIHubMix Provider Benchmark Standard v2.0.
Wyniki pięciu dostawców
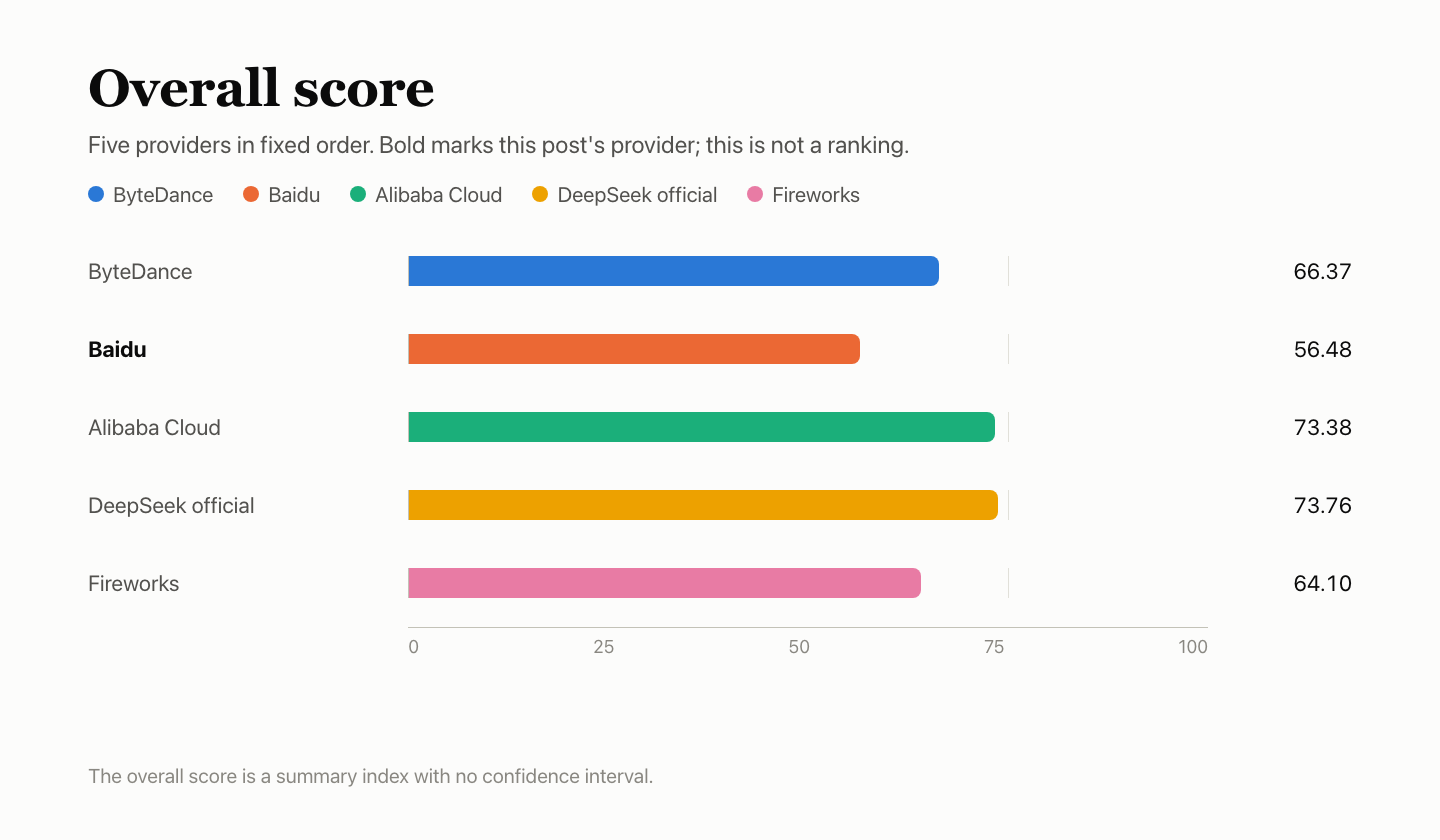
Pogrubieniem oznaczono dostawcę omawianego w tym wpisie. Dostawców wymieniono w stałej kolejności, a nie według rankingu. K to składowa wyniku P o wadze 20%. Wynik ogólny to indeks zbiorczy bez przedziału ufności. Różnica między oficjalnym kanałem a Alibaba Cloud wynosi 0.37 i nie jest statystycznie rozróżnialna.
W skrócie
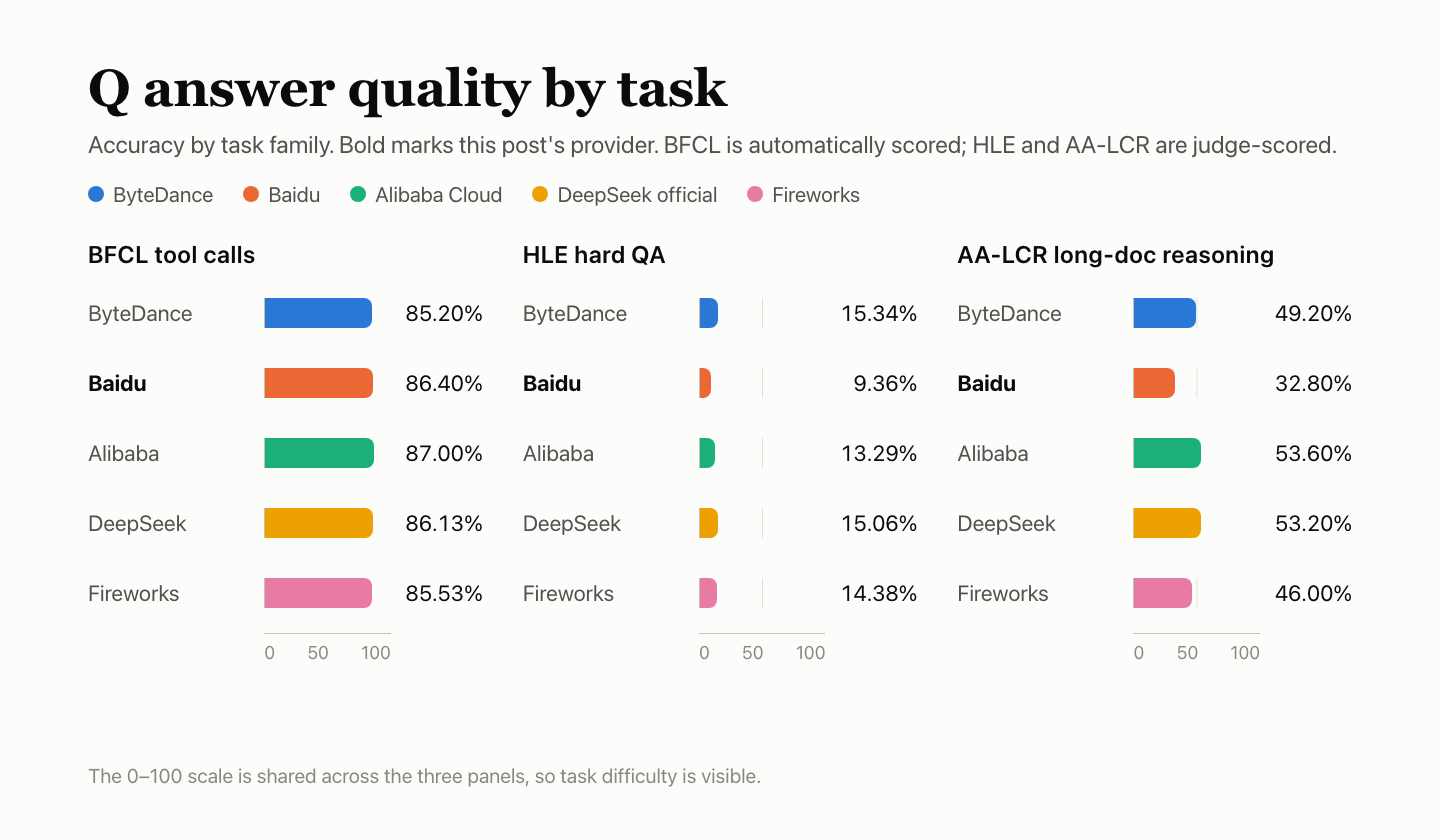
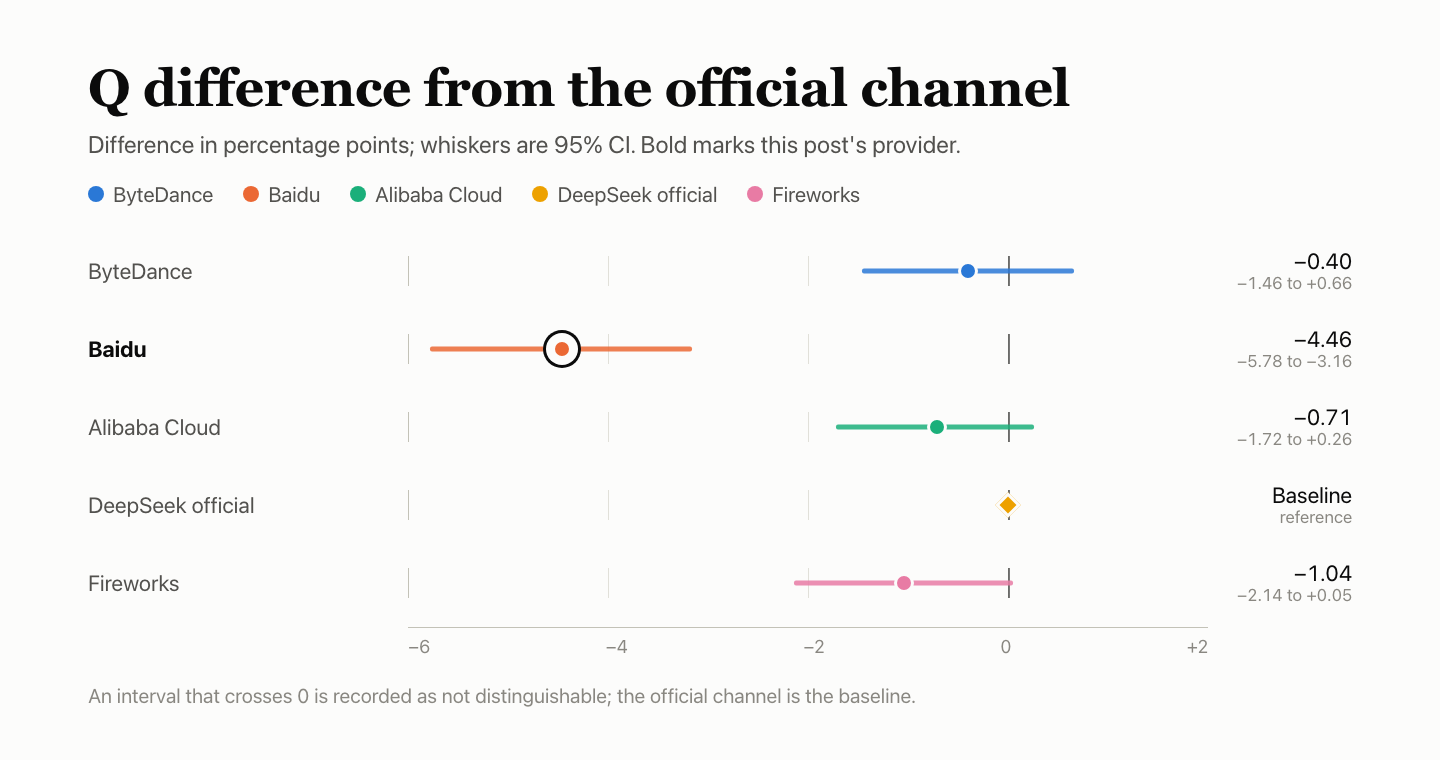
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. Łączny wynik jest o 4.46 punktu niższy niż w oficjalnym kanale, a 95-procentowy przedział wynosi od −5.78 do −3.16 i nie obejmuje 0. W HLE odnotowano 864 nieudane żądania, a w AA-LCR 100; niemal wszystkie wystąpiły w pierwszym oknie i zostały policzone jako błędne odpowiedzi.
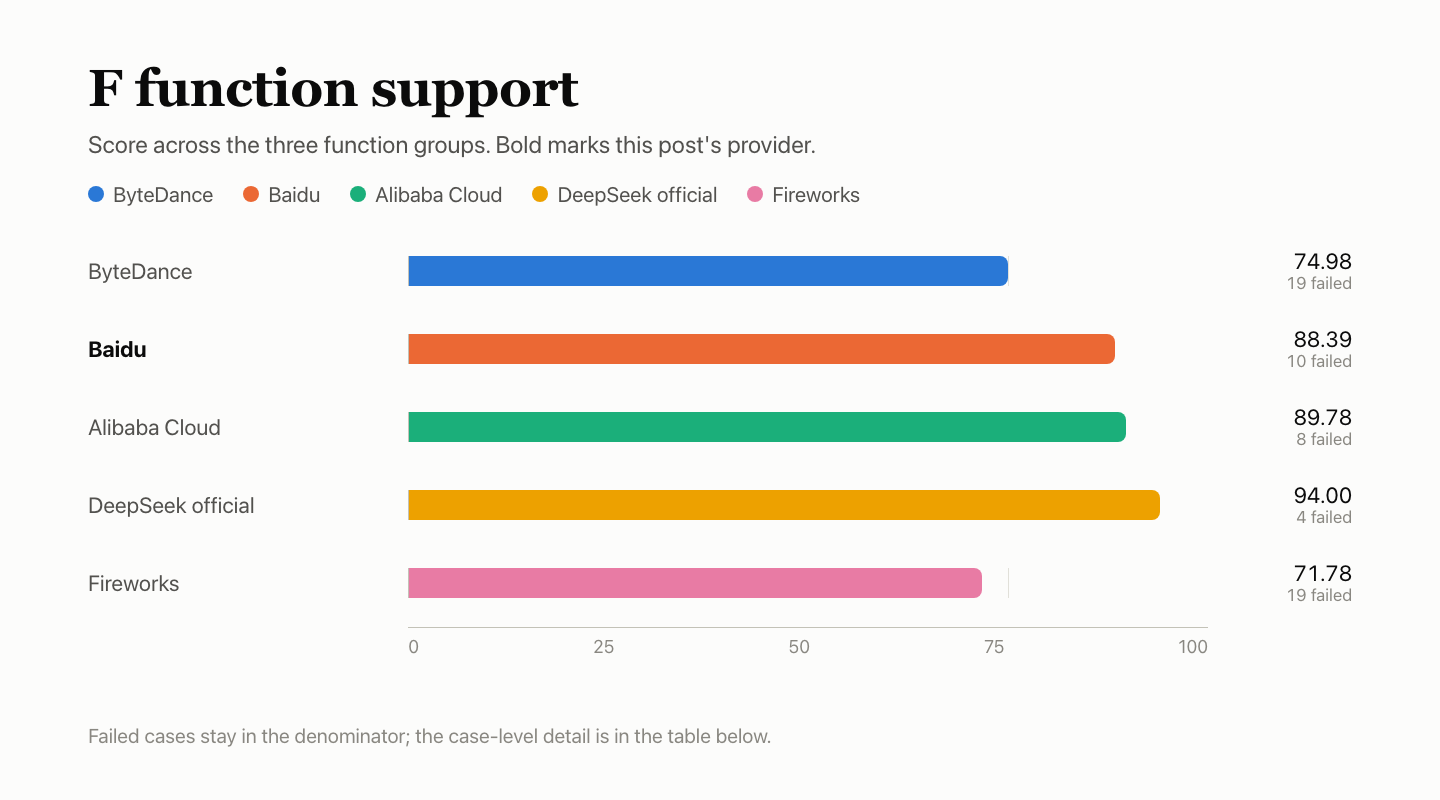
- F: 88.39. Zaliczone zostały 148 ze 174 uwzględnionych kontroli. Nie zwrócono pola odczytu z pamięci podręcznej ani liczby tokenów rozumowania; przypadki przekroczenia kontekstu i osieroconych wyników narzędzi zwróciły 200.
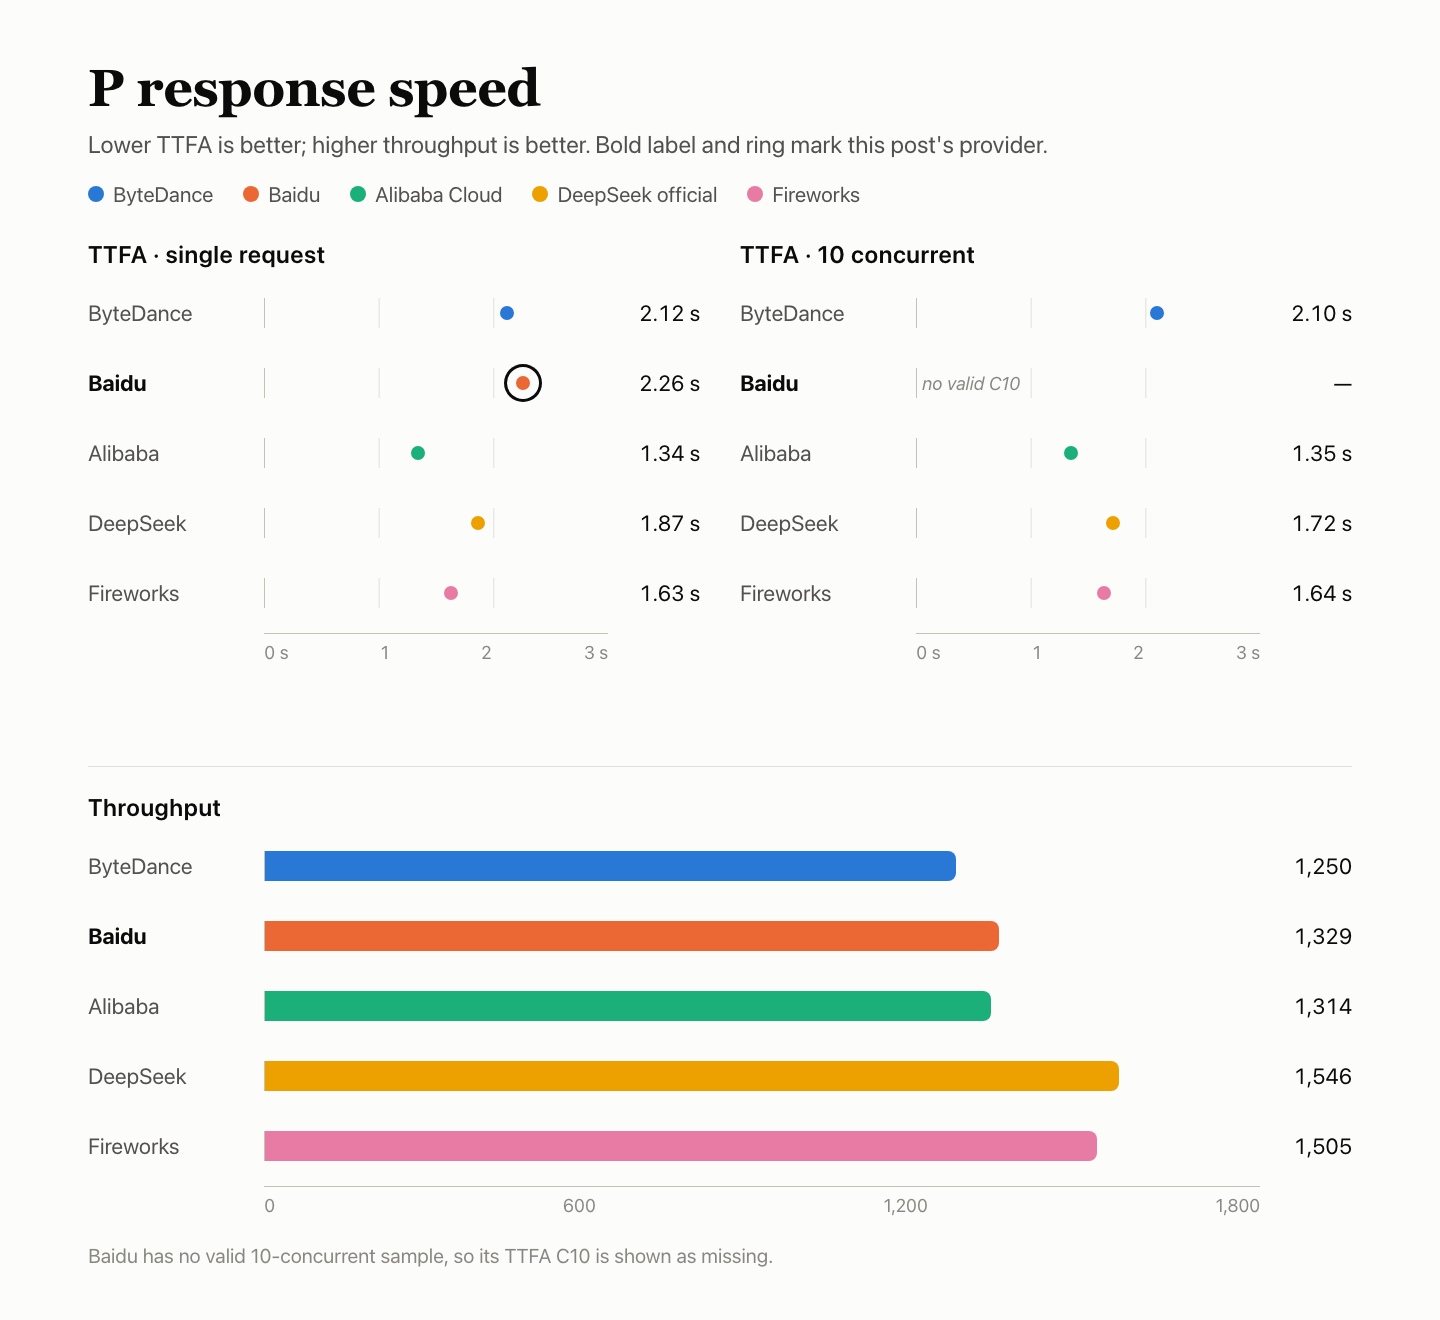
- P: 37.77. 50 z 90 prób przy 10 równoczesnych żądaniach zwróciło
no_available_channel, przez co ponad połowa była nieprawidłowa, a TTFA i TPOT otrzymały wartości karne. Próby przy jednym równoczesnym żądaniu były prawidłowe w 78 z 90 przypadków. - K: 68.85. W przypadku gorących żądań z prefiksem 8k trafienie nastąpiło 5 razy na 9, a 3 żądania zakończyły się niepowodzeniem; dla prefiksu 32k trafienie nastąpiło 8 razy na 9. Trafienia raportowane są w blokach po 1,024 tokeny: 7,168 tokenów dla 8k i 31,744 dla 32k.
- R: 100. Wszystkie 300 dedykowanych żądań powiodły się za pierwszym razem. Błędy kanału podczas generowania odpowiedzi i prób szybkościowych są uwzględniane w Q i P.
Konfiguracja testu
Żądania wysyłano przez trasę AIHubMix szybkiego startu, używając identyfikatora właściwego dla dostawcy; parametry były zgodne z dokumentacją API DeepSeek. Identyfikatory pozostałych dostawców podano na stronie modeli. Nie jest to bezpośrednie połączenie z własnym kontem Baidu.
| Pole | Wartość |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Żądany identyfikator modelu | baidu-deepseek-v4.1-flash-1017 |
| Zwrócona nazwa modelu | deepseek-v4.1-flash-1017 |
| Trasa dostępu | Przez AIHubMix, z użyciem identyfikatora modelu właściwego dla dostawcy; nie jest to bezpośrednie połączenie z własnym kontem dostawcy |
| Parametry | Tryb bez rozumowania, temperature 1.0, max_tokens 16,384, limit czasu 300 s, bez automatycznych ponowień |
| Rozumowanie wyłączone | W każdym żądaniu użyto reasoning_effort=none |
| Czas | 2026-11-03 18:07 – 11-04 16:33 UTC+8; wszyscy pięciu dostawców korzystali z tego samego Mac mini, sieci i konta |
| Próbki | 4,250 prób generowania odpowiedzi (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 przypadków funkcji × 3 okna; 90 prób szybkościowych przy jednym równoczesnym żądaniu i 90 przy dziesięciu równoczesnych żądaniach; 300 żądań stabilności; 30 prób pamięci podręcznej (po trzy grupy dla prefiksów 8k i 32k) |
Q — jakość odpowiedzi: 38.00
Jakość odpowiedzi oceniano na podstawie trzech typów zadań: 500 zadań BFCL, na każde odpowiedziano trzykrotnie; 250 zadań HLE, na każde odpowiedziano dziesięciokrotnie; oraz 25 zadań AA-LCR, na każde odpowiedziano dziesięciokrotnie. Wynik BFCL oblicza się według reguł automatycznych; odpowiedzi w HLE i AA-LCR ocenia model sędziowski deepseek-flash, oznaczając je jako poprawne lub błędne. Wszyscy pięciu dostawcy otrzymali ten sam zestaw zadań, a wyniki wszystkich trzech typów połączono w jeden wskaźnik trafności. Usunięto dziesięć odpowiedzi, których nie dało się ocenić, pozostawiając 4,240 ocenionych prób.
| Zadanie | Liczba pozycji | Poprawne | Trafność | Niepowodzenia |
|---|---|---|---|---|
| Wywołania narzędzi w BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Trudne pytania HLE oceniane przez model sędziowski | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Rozumowanie na podstawie długich dokumentów AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Łącznie · 95-procentowy przedział 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Błędy usługi — zarówno nieudane żądania, jak i ucięte wyniki — pozostają w mianowniku i są liczone jako błędne odpowiedzi. W HLE odnotowano 864 nieudane żądania (863 w pierwszym oknie, 1 w drugim) oraz 11 wyników uciętych z powodu limitu max_tokens. W AA-LCR odnotowano 100 nieudanych żądań, wszystkie w pierwszym oknie.
Na każde zadanie BFCL odpowiadano trzykrotnie; tabela przedstawia wyniki połączone z tych trzech rund.
| Kategoria BFCL | Zaliczone | Odsetek zaliczeń |
|---|---|---|
| simple_python: jedna funkcja, poprawne wywołanie i argumenty | 336/360 | 93.33% |
| multiple: wybór właściwej funkcji spośród kilku | 269/300 | 89.67% |
| parallel: równoległe wywołanie jednej funkcji kilka razy | 268/300 | 89.33% |
| parallel_multiple: równoległe wywołanie kilku różnych funkcji | 206/240 | 85.83% |
| irrelevance: nie wywołuj funkcji, jeśli żadna nie ma zastosowania | 113/150 | 75.33% |
| ahm_multi_turn: trzyetapowy łańcuch narzędzi | 104/150 | 69.33% |
Porównanie z pozostałymi czterema
Różnica jest podana w punktach procentowych względem oficjalnego kanału; 95-procentowy przedział pokazano jako wąsy. Przedział obejmujący 0 oznacza wynik nierozróżnialny. Model sędziowski deepseek-flash używany w HLE i AA-LCR należy do tej samej rodziny DeepSeek co testowany model i nie został skalibrowany, więc jego oceny mogą być pobłażliwe.
F — obsługa funkcji: 88.39
Testy funkcji sprawdzają, czy interfejs działa zgodnie ze specyfikacją protokołu, a nie to, czy model dobrze odpowiada. Wykonano 60 przypadków w sześciu grupach, po jednym razie w każdym z trzech okien, co dało 180 kontroli ocenionych względem formatu opisanego w dokumentacji dostawcy. Kontrole nie mające zastosowania, nieprawidłowe lub nieobserwowane wykluczono z mianownika. W przypadku Baidu uwzględniono 174 kontrole, z których 148 zaliczono; wynik ważony wyniósł 88.39.
Wynik grupy jest ważony udziałem tej grupy, a nie obliczany jako proste 148/174.
| Grupa przypadków | Waga | Zaliczone | Wykluczone | Wynik grupy |
|---|---|---|---|---|
| Strumieniowanie i protokół komunikatów | 20% | 27/27 | 3 | 100.00 |
| Interfejs narzędzi | 20% | 30/30 | — | 100.00 |
| Ograniczenia wyjścia i parametry | 20% | 29/30 | — | 96.67 |
| Kontekst i stan | 15% | 26/30 | — | 86.67 |
| Błędy i odzyskiwanie | 15% | 21/30 | — | 70.00 |
| Rozliczanie i protokół pamięci podręcznej | 10% | 15/27 | 3 | 55.56 |
| Łącznie, wynik ważony | 100% | 148/174 | 6 | 88.39 |
| Nieudany przypadek | Nieudane okna | Przyczyna |
|---|---|---|
| Przekroczenie kontekstu (kontekst i stan) | 3/3 | Powinien zwrócić błąd parametru; zwrócił 200 |
| Nieprawidłowe komunikaty (błędy i odzyskiwanie) | 3/3 | Zwrócił 400 z pustym treścią odpowiedzi, bez ustrukturyzowanego błędu |
| Osierocony wynik narzędzia (błędy i odzyskiwanie) | 3/3 | Powinien zwrócić błąd parametru; zwrócił 200 |
| Nieprawidłowe stream_options (błędy i odzyskiwanie) | 3/3 | Zwrócił 400 z pustym treścią odpowiedzi, bez ustrukturyzowanego błędu |
| Pole odczytu z pamięci podręcznej (rozliczanie i protokół pamięci podręcznej) | 3/3 | Nie zwrócono pola odczytu z pamięci podręcznej; nie można potwierdzić odczytu |
| Rozliczanie tokenów rozumowania (rozliczanie i protokół pamięci podręcznej) | 3/3 | Nie zwrócono liczby tokenów rozumowania |
| Definicje narzędzi wliczane do danych wejściowych (rozliczanie i protokół pamięci podręcznej) | 3/3 | Po dodaniu definicji narzędzi zgłoszona liczba tokenów wejściowych nie wzrosła |
| Zgodność liczby tokenów wejściowych przed użyciem pamięci podręcznej i po nim (rozliczanie i protokół pamięci podręcznej) | 3/3 | Nie zwrócono pola odczytu z pamięci podręcznej; nie można potwierdzić odczytu |
| Różnorodność próbkowania (ograniczenia wyjścia i parametry) | 1/3 | Powtarzane wyniki przy temperaturze 0 i 1 różniły się zbyt mało, poniżej wcześniej zarejestrowanego standardu |
| Izolacja między żądaniami (kontekst i stan) | 1/3 | Pierwszy krok nie zwrócił wyłącznie STORED, jak wymagano, dlatego nie można było przeprowadzić kontroli izolacji |
Te kontrole są wykluczone z mianownika: nie zostały ani zaliczone, ani niezaliczone.
| Status | Przypadek | Liczba | Przyczyna |
|---|---|---|---|
| Nieobserwowane | Sekwencja zatrzymująca strumieniowanie | 3 | Żądanie dla tego kroku nie zostało wysłane po poprzednim kroku, więc nie można go ocenić |
| Nie dotyczy | Jawne cache_control | 3 | Wcześniej zarejestrowano, że ten interfejs go nie obsługuje |
Nieprawidłowe messages i nieprawidłowe stream_options kończyły się niepowodzeniem u wszystkich pięciu dostawców: oba przypadki zwracały 400 z pustym treścią odpowiedzi, nie udostępniając klientowi ustrukturyzowanego błędu. Awaria występująca u wszystkich pięciu dostawców najprawdopodobniej leży po stronie bramy AIHubMix i wymaga osobnego zbadania. Rozliczanie tokenów rozumowania również nie powiodło się u wszystkich pięciu, choć z różnych powodów: ByteDance i Fireworks raportowały tokeny rozumowania nawet przy wyłączonym rozumowaniu, natomiast pozostali trzej nie zwracali ich liczby.
Porównanie z pozostałymi czterema
P — szybkość odpowiedzi: 37.77
Każde żądanie zawierało około 10,000 tokenów wejściowych i wymagało odpowiedzi o długości około 1,100 tokenów. W każdym z trzech okien wysłano po 30 prób przy jednym równoczesnym żądaniu i po 30 przy dziesięciu równoczesnych żądaniach, łącznie 180 żądań.
| Metryka | Wynik |
|---|---|
| TTFA — czas do pierwszego tokenu | Mediana dla jednego żądania: 2.26 s (mediana prawidłowych żądań: 2.05 s); przy dziesięciu równoczesnych żądaniach ponad połowa prób była nieprawidłowa, więc mediana została uznana za nieskończoność (mediana prawidłowych żądań: 1.86 s) |
| Szybkość generowania TPOT | Jedno żądanie: 3.48 ms/token; dziesięć równoczesnych żądań: 50.00 ms/token (ponad połowa prób była nieprawidłowa, zastosowano wartość karną) |
| Goodput (prawidłowa przepustowość) | Dziesięć równoczesnych żądań: 1,329.2 token/s |
| Prawidłowe żądania | Jedno żądanie: 78/90 (pierwsze okno 18/30); dziesięć równoczesnych żądań: 40/90 (pierwsze okno 0/30, trzecie okno 10/30) |
| Przyczyna nieprawidłowości | 62 próby zwróciły 400 no_available_channel |
| Wynik składowej | TTFA 0.00, TPOT 0.00, przepustowość 100.00; wynik szybkości odpowiedzi 30.00 |
| Składowe P | Wynik szybkości odpowiedzi 30.00 z wagą 80%, pamięć podręczna K 68.85 z wagą 20%, wynik łączny 37.77 |
TPOT szacuje się na podstawie fragmentów strumieniowanych danych, a nie mierzy dla każdego tokenu na sprzęcie. Goodput to liczba prawidłowych tokenów wyjściowych przy dziesięciu równoczesnych żądaniach podzielona przez czas zegarowy całej partii.
W przypadku dziesięciu równoczesnych żądań 50 z 90 prób zwróciło no_available_channel. Ponieważ ponad połowa prób była nieprawidłowa, medianę czasu do pierwszego tokenu uznano za nieskończoność, a TTFA i TPOT otrzymały wartości karne. Przy jednym równoczesnym żądaniu 78 z 90 prób pozostało prawidłowych.
Wszyscy pięciu dostawcy korzystali z tego samego komputera, sieci i konta. Trzy okna zaplanowano osobno dla każdego dostawcy, więc okresy zbierania danych nie pokrywają się w pełni; niewielkich różnic czasowych nie należy nadinterpretować.
K — pamięć podręczna: 68.85
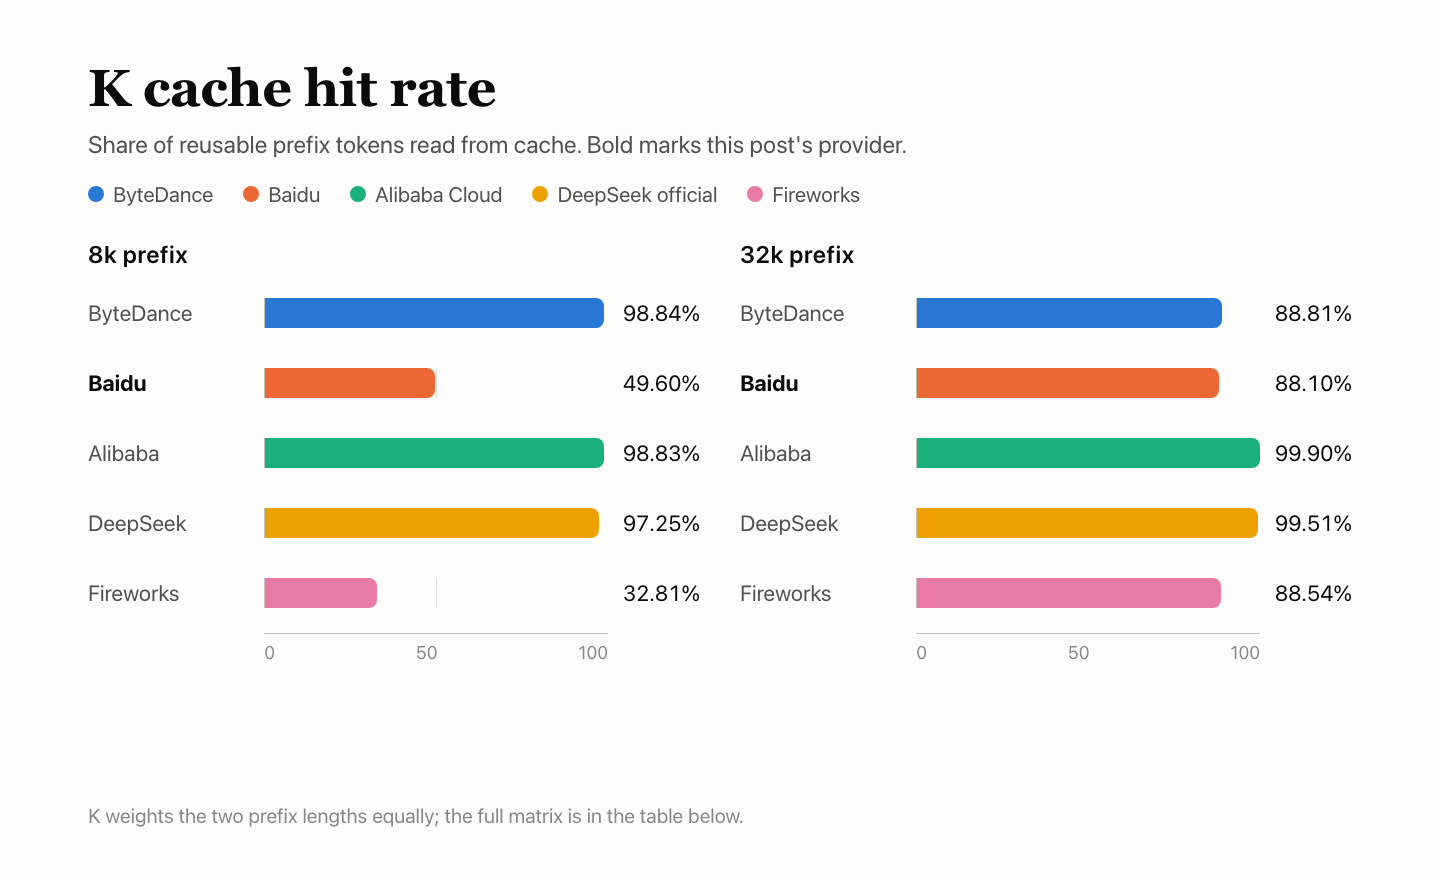
Każda grupa obejmuje pięć żądań. Pierwsze zawiera stały prefiks o długości około 8k lub 32k tokenów i zapełnia pamięć podręczną. Żądania 2–4 zachowują prefiks i zmieniają tylko pytanie na końcu, z przerwami 5 s, 30 s i 120 s. Piąte używa nowego prefiksu jako kontroli bez trafienia w pamięć podręczną. Trzy okna × dwie długości dają 30 żądań. K to liczba tokenów odczytanych z pamięci podręcznej przez gorące żądania, podzielona przez liczbę tokenów, które zgodnie z regułami powinny nadawać się do ponownego użycia; obie długości mają równą wagę. K stanowi 20% wyniku P.
Tabela przedstawia liczbę tokenów odczytanych z pamięci podręcznej, którą zgłosił serwer; „nie zwrócono” oznacza, że w odpowiedzi brakowało tego pola.
| Prefiks | Okno | Zapełnienie | +5 s | +30 s | +120 s | Kontrola bez trafienia |
|---|---|---|---|---|---|---|
| 8k | 1 | Niepowodzenie | Niepowodzenie | Niepowodzenie | Nie zwrócono | Nie zwrócono |
| 8k | 2 | Nie zwrócono | 7,168 | 7,168 | Niepowodzenie | Niepowodzenie |
| 8k | 3 | Nie zwrócono | 7,168 | 7,168 | 7,168 | Nie zwrócono |
| 32k | 1 | Nie zwrócono | Nie zwrócono | 31,744 | 31,744 | Nie zwrócono |
| 32k | 2 | Nie zwrócono | 31,744 | 31,744 | 31,744 | Nie zwrócono |
| 32k | 3 | Nie zwrócono | 31,744 | 31,744 | 31,744 | Nie zwrócono |
Prefiks 8k trafił w 5 z 9 gorących żądań, odczytując 35,840 z 72,252 tokenów, które można było ponownie wykorzystać, co dało 49.60. Prefiks 32k trafił w 8 z 9 żądań, odczytując 253,952 z 288,261 tokenów, co dało 88.10. K wynosi 68.85 przy równym ważeniu obu długości. Pięć żądań 8k nie powiodło się: żądanie inicjujące w oknie 1, żądania po 5 s i 30 s oraz żądania po 120 s i kontrolne bez pamięci podręcznej w oknie 2. Wszystkie zwróciły no_available_channel. To daje łącznie trzy nieudane gorące żądania w kategorii 8k.
W przypadku trafienia odczyt jest raportowany w blokach po 1,024 tokenów: 7,168 tokenów dla prefiksu 8k i 31,744 dla prefiksu 32k. Przy chybieniu blok użycia pomija prompt_tokens_details; tabela podaje „nie zwrócono”, a wartość jest liczona jako 0.
W porównaniu z pozostałymi czterema
R — stabilność usługi: 100
300 żądań podzielono na cztery typy: krótki tekst, długie wejście, wywołanie narzędzia i historię wieloturową. Wysyłano je z pojedynczą współbieżnością w trzech oknach. Sprawdzano wyłącznie, czy pierwsza odpowiedź była prawidłowa i kompletna; odpowiedzi nie były oceniane i nie ponawiano żądań. Błędy podczas udzielania odpowiedzi i testów szybkości są uwzględniane odpowiednio w Q i P, a nie ponownie w R.
| Typ żądania | Powodzenie przy pierwszej próbie |
|---|---|
| Krótki tekst | 120/120 |
| Długie wejście 10k | 90/90 |
| Wywołanie narzędzia | 60/60 |
| Historia wieloturowa | 30/30 |
| Łącznie | 300/300, 95% CI 98.78%–100% |
Wszystkie 300 żądań zwróciło prawidłową i kompletną odpowiedź przy pierwszej próbie. R 100 dotyczy wyłącznie tych 300 dedykowanych żądań; nie oznacza, że na całej ścieżce nie wystąpiły błędy. Przy 300 powodzeniach na 300 prób dolna granica 95% przedziału wynosi 98.78%, więc prawdopodobnie odsetek błędów jest niższy niż 1.22%.
W porównaniu z pozostałymi czterema
R obejmuje wyłącznie te 300 dedykowanych żądań; błędy podczas udzielania odpowiedzi i testów szybkości są uwzględniane w Q i P, a nie ponownie w R.
| Dostawca | Powodzenie przy pierwszej próbie | 95% przedział |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Oficjalny DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Najczęściej zadawane pytania
Co oznacza wynik ogólny?
To zbiorczy indeks bez przedziału ufności, a nie certyfikat. W tym artykule przedstawiono wyniki Q, F, P, K i R i nie rekomenduje się żadnego dostawcy.
Dlaczego połowa testów z dziesięcioma równoległymi żądaniami zakończyła się niepowodzeniem?
50 z 90 odpowiedzi zawierało no_available_channel. Ponieważ ponad połowa odpowiedzi była nieprawidłowa, mediana czasu do pierwszego tokena jest traktowana jako nieskończona, a wyniki TTFA i TPOT otrzymują wartości kary.
Czy R 100 oznacza, że nie wystąpiły błędy kanału?
Nie. R obejmuje 300 dedykowanych żądań, które wszystkie zakończyły się powodzeniem przy pierwszej próbie. 62 odpowiedzi no_available_channel w teście szybkości oraz błędy w teście udzielania odpowiedzi są uwzględniane odpowiednio w P i Q.
Dlaczego K wynosi 68.85, skoro prefiks 32k trafił w 8 z 9 żądań?
Obie długości mają taką samą wagę. Prefiks 8k trafił w 5 z 9 gorących żądań i uzyskał wynik 49.60, a prefiks 32k trafił w 8 z 9 i uzyskał 88.10; średnia wynosi 68.85.
Czy jakość odpowiedzi Baidu różni się od jakości oficjalnego kanału?
Tak. Łączna różnica Q wynosi −4.46 punktu procentowego, a jej 95% przedział od −5.78 do −3.16 nie obejmuje 0. To jedyny wynik dostawcy niższy od wyniku oficjalnego kanału, którego przedział nie obejmuje 0.
Jakie testy pominięto przy obliczaniu F?
Sześć: trzy testy sekwencji stop w strumieniowaniu, których nie udało się zaobserwować, ponieważ żądanie z poprzedniego kroku nie zostało wysłane, oraz trzy jawne testy cache_control, wcześniej zarejestrowane jako nieobsługiwane przez ten interfejs.
Czytaj dalej: seria DeepSeek V4.1 Flash
- Dokładność BFCL w Baidu była zbliżona do wyniku oficjalnego kanału; artykuł o ByteDance przedstawia te same testy, obejmujące wyniki wywołań narzędzi i naliczania opłat: DeepSeek V4.1 Flash w ByteDance: wywołania narzędzi zgodne, naliczanie opłat — nie
- TTFA Baidu przy pojedynczej współbieżności wynosi 2.26 s, w porównaniu z 1.34 s w innym teście: DeepSeek V4.1 Flash w Alibaba Cloud: pierwszy token po 1.34s, cache 99.37
- Wynik F Baidu wynoszący 88.39 można zestawić z wynikiem referencyjnym 94.00 przy 15 nieprawidłowych testach: DeepSeek V4.1 Flash w oficjalnym kanale: F 94.00, 15 nieprawidłowych testów
- Wynik trafień w cache 5/9 dla 8k w Baidu można porównać z wynikiem 3/9 i pustymi odpowiedziami stop w innym teście: DeepSeek V4.1 Flash w Fireworks: puste odpowiedzi stop, 3/9 trafień w cache


