

W dniach 2026-11-03/04 przeprowadzono pełny zestaw APB dla DeepSeek V4.1 Flash 1017 u pięciu dostawców za pośrednictwem AIHubMix. U każdego dostawcy użyto tego samego modelu, pytań, parametrów i skryptów żądań; model znajduje się na stronie modelu AIHubMix, a wpisy pięciu dostawców — na stronie modeli. Ten profil APB dotyczy wyłącznie Alibaba Cloud: opisuje, co mierzyła każda sekcja i jakie były wyniki.
W tym wpisie przedstawiono wyniki bez tworzenia rankingu dostawców i rekomendowania któregokolwiek z nich. Najpierw omówiono Q, F, P, K i R; K jest składową wyniku P. Wynik ogólny to indeks podsumowujący, a nie certyfikacja, i nie ma przedziału ufności. Zasady punktacji określa AIHubMix Provider Benchmark Standard v2.0.
Wyniki pięciu dostawców
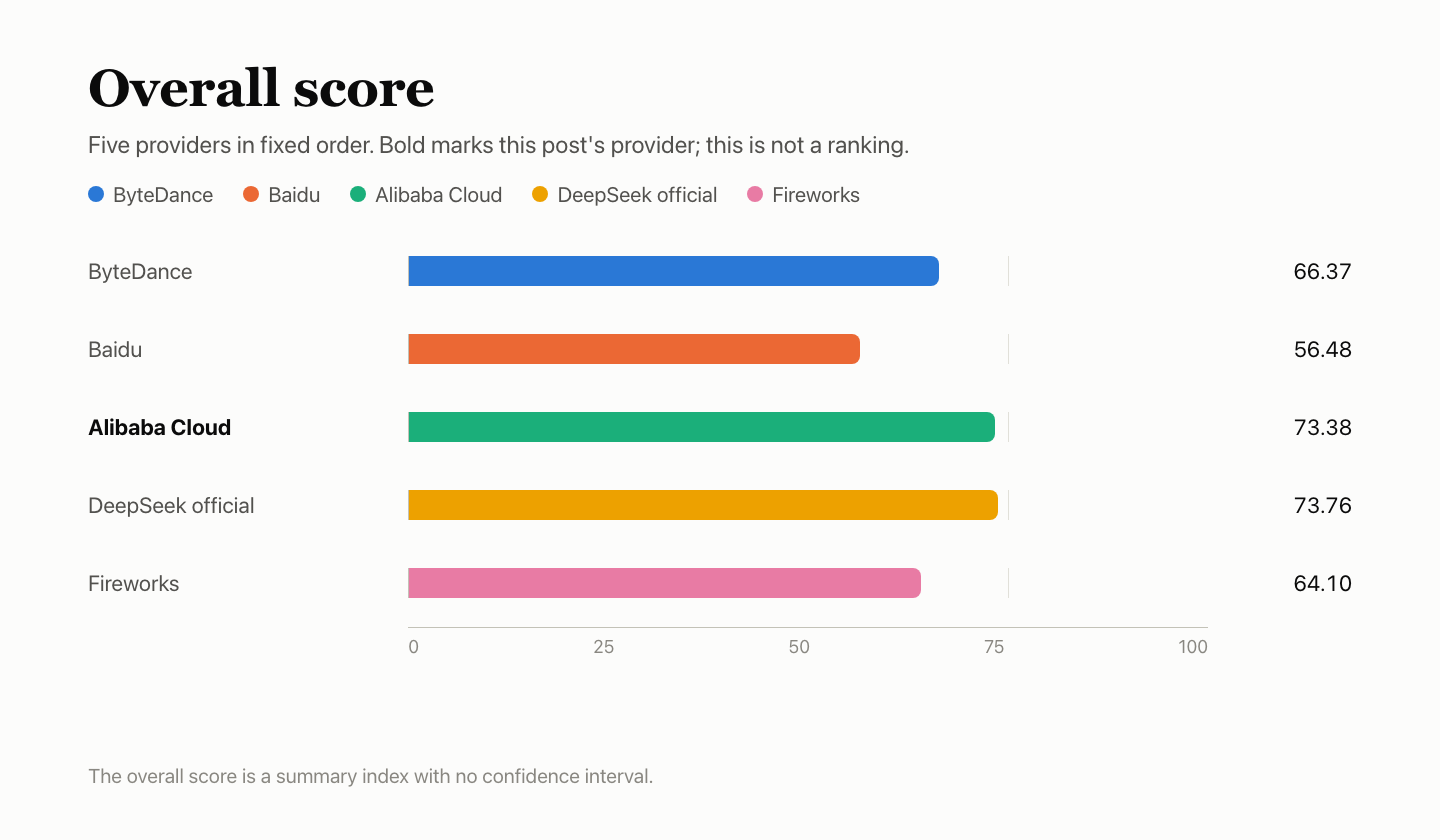
Pogrubieniem wyróżniono dostawcę omawianego w tym wpisie. Dostawcy są przedstawieni w stałej kolejności, a nie w rankingu. K to składowa wyniku P o wadze 20%, pokazana osobno dla odniesienia. Wynik ogólny to indeks podsumowujący bez przedziału ufności. Wyniki DeepSeek official channel i Alibaba Cloud różnią się o 0.37 i nie można ich rozróżnić.
W skrócie
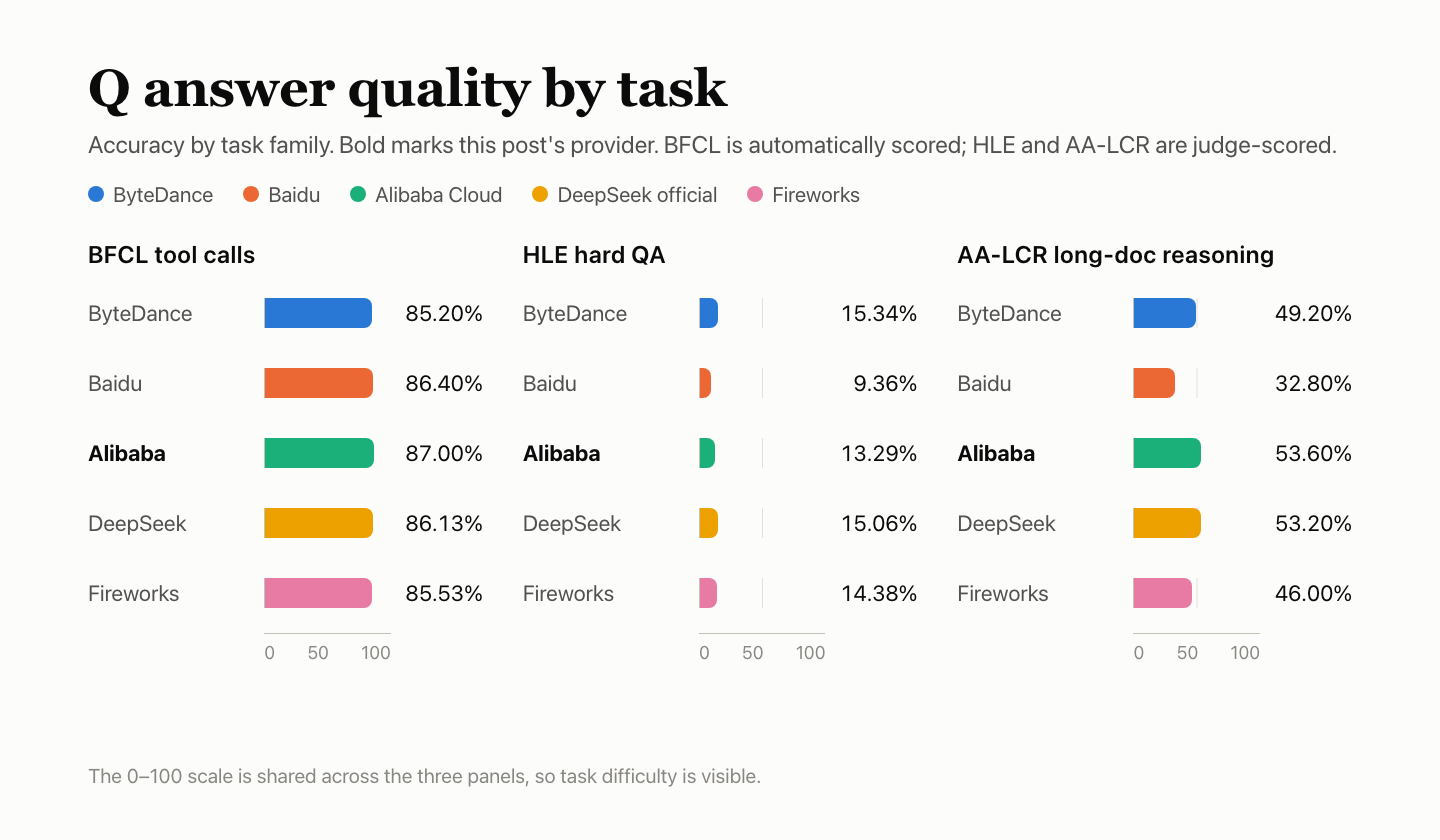
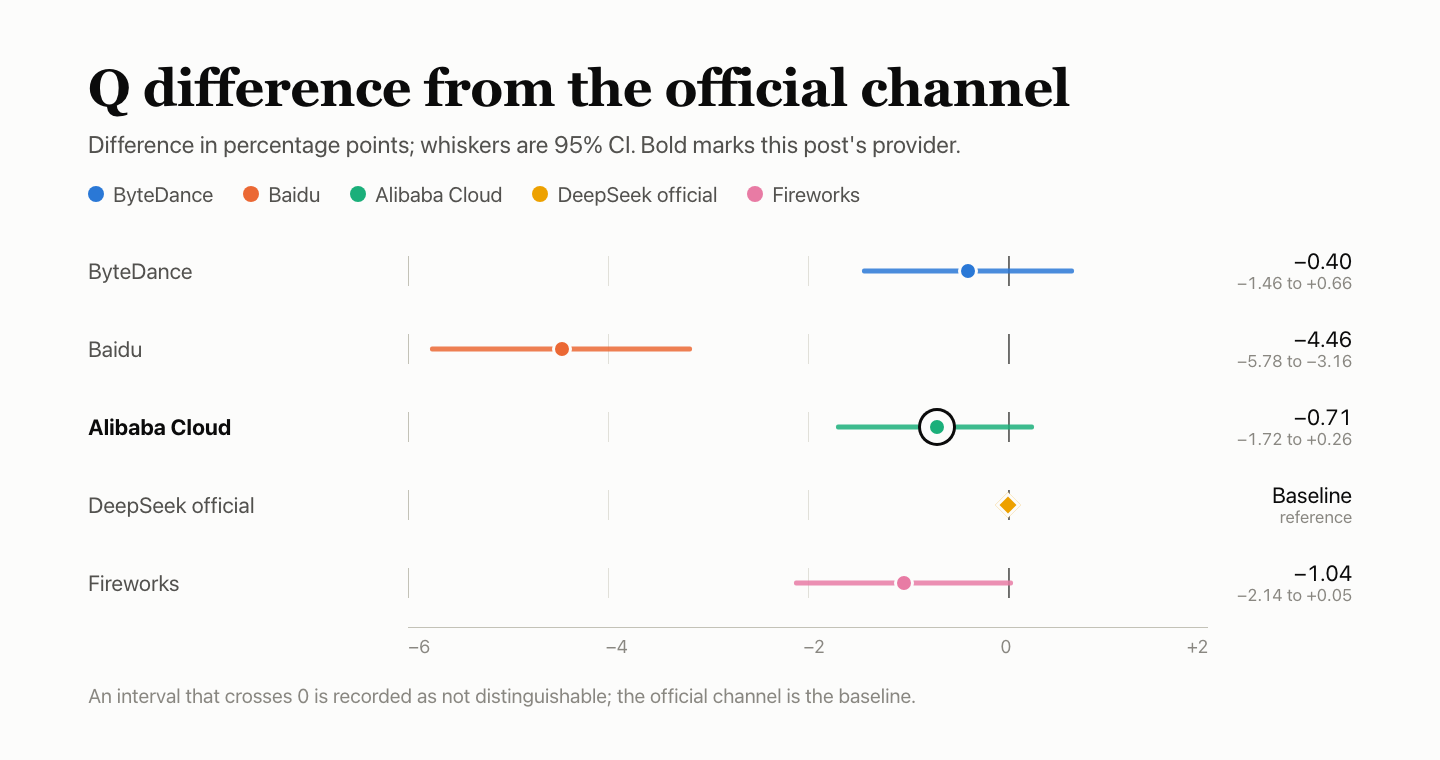
- Jakość odpowiedzi: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Różnica względem oficjalnego kanału wynosi −0.71 punktu procentowego, a 95-procentowy przedział to od −1.72 do +0.26, więc tych dwóch wyników nie można rozróżnić.
- Obsługa funkcji: F 89.78. Zaliczone zostały 155 z 177 kontroli uwzględnionych w mianowniku. Nieprawidłowy schemat narzędzia zwrócił 503 zamiast błędu parametru, przepełnienie kontekstu nie zwróciło udokumentowanego typu błędu, a odizolowany wynik narzędzia zwrócił 200.
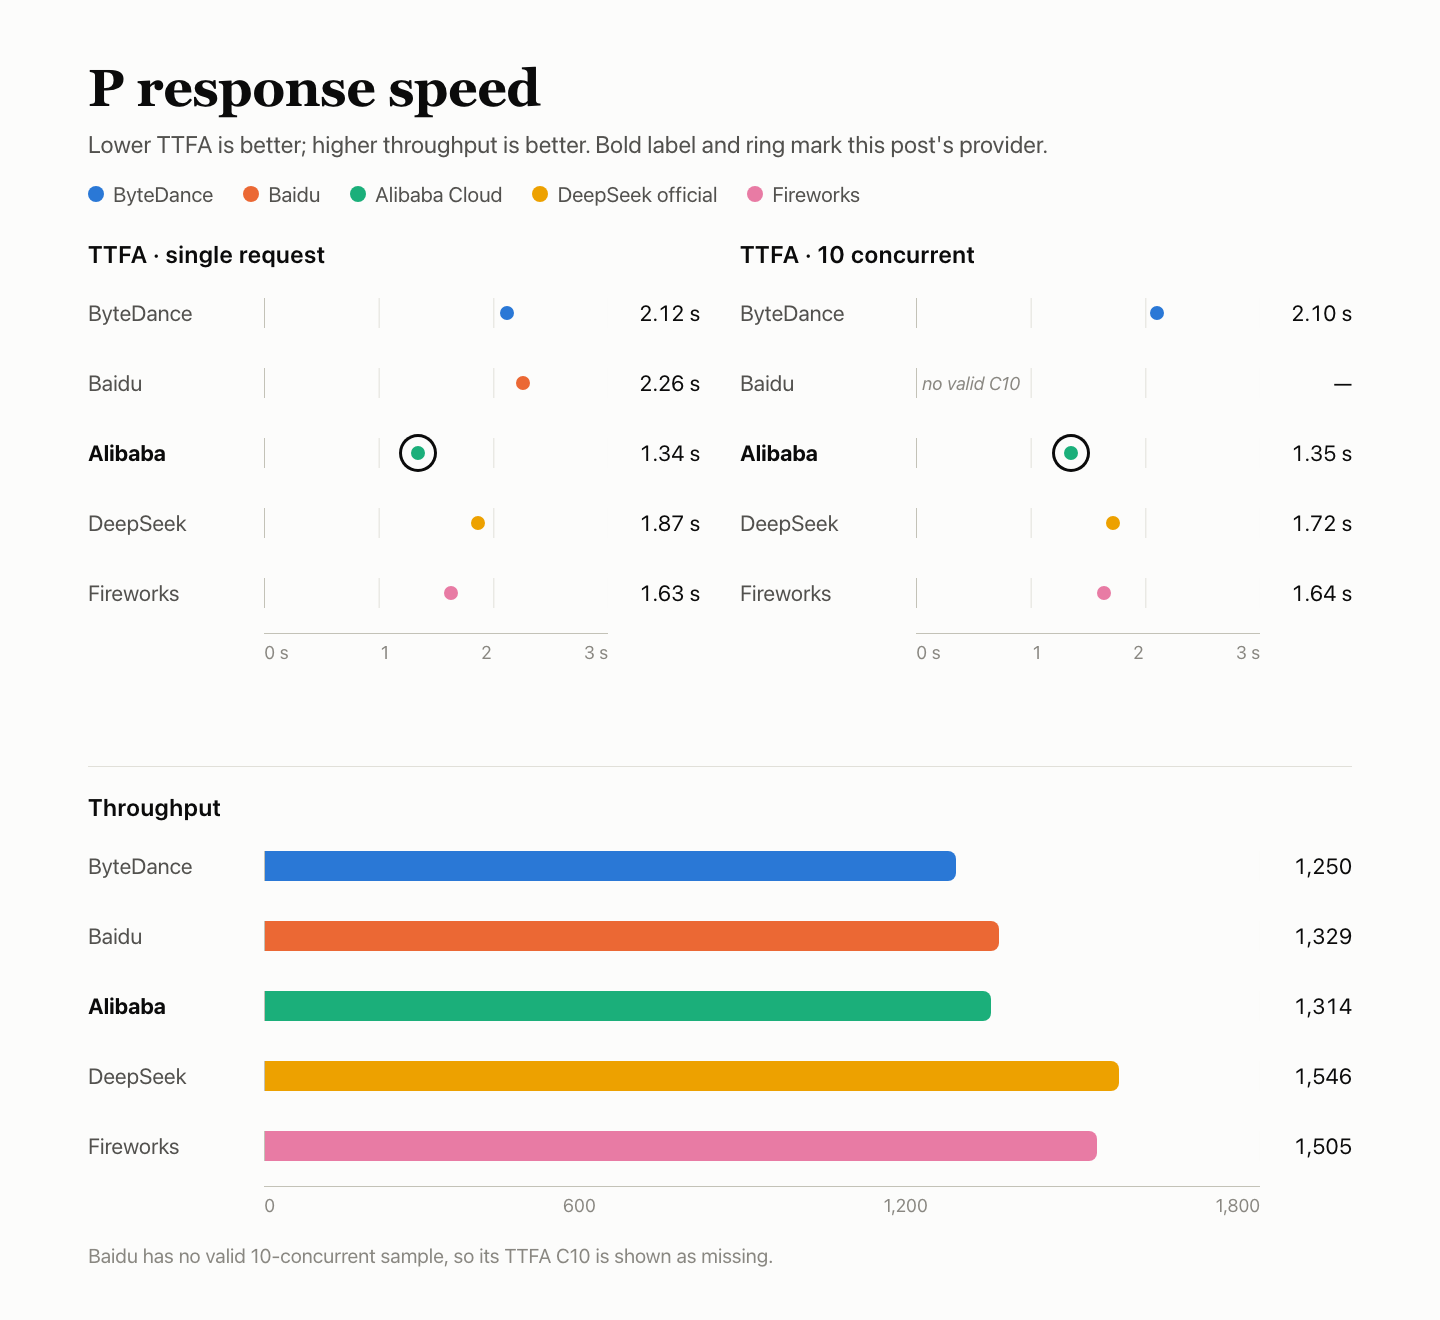
- Szybkość odpowiedzi: P 88.58. Mediana czasu do pierwszego tokenu treści wyniosła 1.34 s przy współbieżności 1 i 1.35 s przy współbieżności 10, TPOT wyniósł 4.69 ms, a wszystkie 180 żądań szybkościowych było prawidłowych.
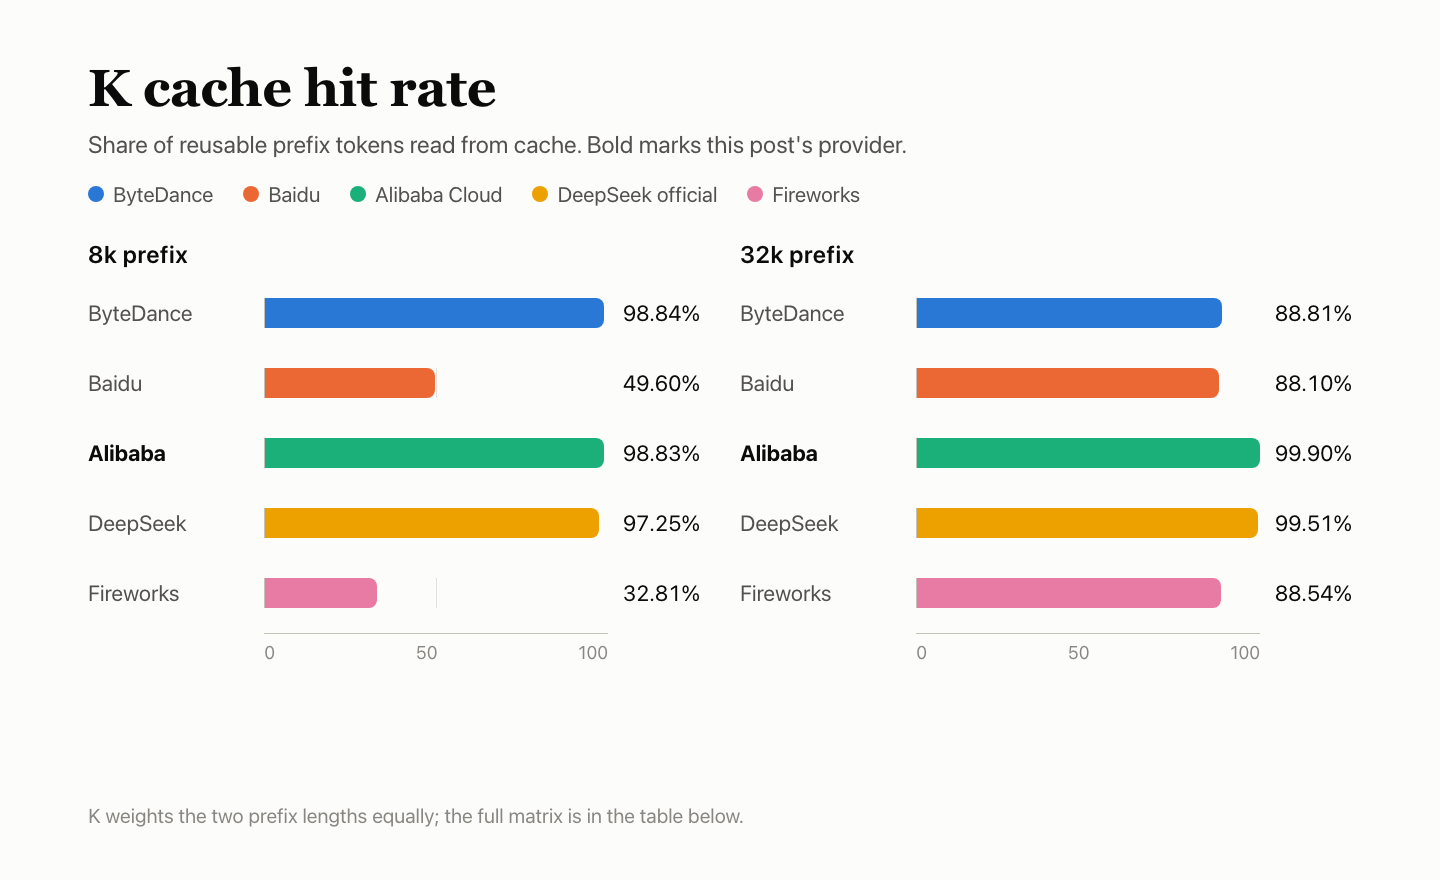
- Cache: K 99.37. Wszystkie 18 gorących żądań dla prefiksów 8k i 32k trafiły w pamięć podręczną, a żadne zimne żądanie kontrolne nie odczytało jej zawartości.
- Stabilność usługi: R 100. Wszystkie 300 dedykowanych żądań powiodły się przy pierwszej próbie.
Konfiguracja testu
Test przeprowadzono przez AIHubMix, wybierając identyfikator modelu dostawcy; sposób kierowania żądań opisano w szybkim wprowadzeniu. Na stronie cennika DeepSeek podano opublikowane stawki modelu.
| Element | Szczegóły |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Żądany identyfikator modelu | alicloud-deepseek-v4.1-flash-1017 |
| Zwrócona nazwa modelu | deepseek-v4.1-flash-1017 |
| Sposób dostępu | Przez AIHubMix, po wybraniu identyfikatora modelu dostawcy, a nie przez połączenie z własnym kontem dostawcy |
| Parametry | Tryb bez rozumowania, temperatura 1.0, max_tokens 16,384, limit czasu 300 s, bez automatycznych ponowień |
| Rozumowanie wyłączone | We wszystkich żądaniach użyto reasoning_effort=none |
| Czas | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Pięciu dostawców korzystało z tego samego Mac mini, sieci i konta. |
| Próbki | Jakość odpowiedzi: 4,250 przebiegów pytań (BFCL 500 × 3 rundy, HLE 250 × 10, AA-LCR 25 × 10); przypadki obsługi funkcji: 60 × 3 okna; szybkość: 90 przy współbieżności 1 i 90 przy współbieżności 10; stabilność: 300; pamięć podręczna: 30 (prefiksy 8k i 32k, po 3 grupy każdy) |
Q — jakość odpowiedzi: 41.75
Jakość odpowiedzi oceniono na podstawie trzech zestawów pytań: 500 pytań BFCL, każde w 3 rundach, 250 pytań HLE, każde w 10 rundach, oraz 25 pytań AA-LCR, każde w 10 rundach. BFCL oceniano automatycznie według reguł, a HLE i AA-LCR — za pomocą modelu oceniającego deepseek-flash. Wszyscy pięciu dostawcy otrzymali te same pytania, a wyniki trzech zestawów połączono w jeden wynik dokładności. Usunięto dziesięć odpowiedzi, ponieważ nie można było ocenić pytań, pozostawiając 4,240 ocenionych przebiegów pytań.
| Zadanie | Pytania | Poprawne | Dokładność | Błędy |
|---|---|---|---|---|
| Wywołania narzędzi BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Trudne pytania i odpowiedzi HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Rozumowanie na podstawie długich dokumentów AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Łącznie · przedział 95%: 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Błędy usługi (nieudane żądania lub ucięte wyjście) pozostają w mianowniku i są liczone jako odpowiedzi niepoprawne; nie są usuwane. W przypadku Alibaba Cloud wyjście HLE osiągnęło limit max_tokens i zostało ucięte 8 razy.
Na każde pytanie BFCL przypadają 3 rundy; tabela przedstawia łączne wyniki z tych 3 rund.
| Kategoria BFCL | Zaliczone | Odsetek zaliczonych |
|---|---|---|
| simple_python: jedna funkcja, prawidłowe wywołanie i argumenty | 332/360 | 92.22% |
| multiple: wybór właściwej funkcji spośród kilku | 270/300 | 90.00% |
| parallel: równoległe wywołanie tej samej funkcji kilka razy | 273/300 | 91.00% |
| parallel_multiple: równoległe wywołanie kilku różnych funkcji | 212/240 | 88.33% |
| irrelevance: żadna funkcja nie jest odpowiednia, nie należy wywoływać żadnej | 113/150 | 75.33% |
| ahm_multi_turn: trzyetapowy łańcuch narzędzi | 105/150 | 70.00% |
Porównanie z pozostałymi czterema
W porównaniu z oficjalnym kanałem: różnica dokładności w punktach procentowych, z 95-procentowym przedziałem oznaczonym wąsami; przedział obejmujący 0 oznacza brak rozróżnienia. Model oceniający deepseek-flash użyty dla HLE i AA-LCR należy do tej samej rodziny DeepSeek co testowany model i nie został skalibrowany, więc jego oceny mogą być łagodne.
F — obsługa funkcji: 89.78
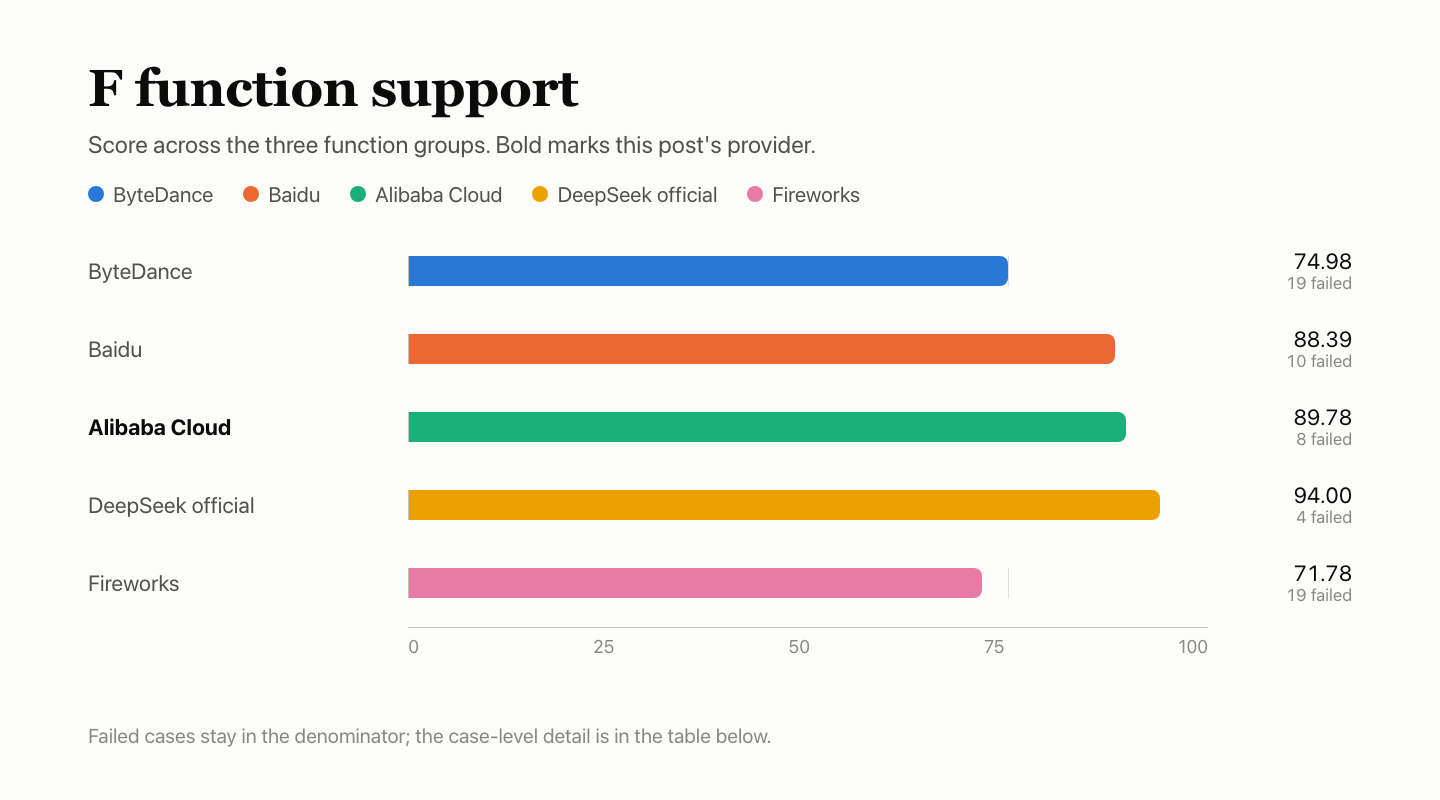
Przypadki obsługi funkcji sprawdzają, czy zachowanie interfejsu jest zgodne z protokołem, a nie to, czy model dobrze odpowiada. 60 przypadków podzielono na sześć grup i uruchomiono w trzech oknach, co dało 180 kontroli ocenianych zgodnie z formatem udokumentowanym przez każdego dostawcę. Kontrole, które nie miały zastosowania, były nieprawidłowe lub których nie zaobserwowano, wykluczono z mianownika. Alibaba Cloud zaliczył 155 z 177 kontroli uwzględnionych w mianowniku; wagi grup dały wynik 89.78.
Wynik ważony oblicza się na podstawie wag grup, a nie jako prostą liczbę zaliczonych kontroli spośród 177.
| Grupa | Waga | Zaliczone | Wykluczone | Wynik grupy |
|---|---|---|---|---|
| Strumieniowanie i protokół wiadomości | 20% | 30/30 | — | 100.00 |
| Interfejs narzędzi | 20% | 30/30 | — | 100.00 |
| Ograniczenia wyjścia i parametry | 20% | 30/30 | — | 100.00 |
| Kontekst i stan | 15% | 26/30 | — | 86.67 |
| Błędy i odzyskiwanie | 15% | 18/30 | — | 60.00 |
| Rozliczanie i protokół pamięci podręcznej | 10% | 21/27 | 3 | 77.78 |
| Łącznie · wynik ważony | — | 155/177 | 3 | 89.78 |
Wartość 3/3 w kolumnie z liczbą okien oznacza, że przypadek nie powiódł się we wszystkich trzech oknach.
| Nieudany przypadek | Nieudane okna | Przyczyna |
|---|---|---|
| Przepełnienie kontekstu (kontekst i stan) | 3/3 | Zwrócono błąd, ale nie udokumentowany błąd długości kontekstu |
| Błąd formatu messages (błędy i odzyskiwanie) | 3/3 | Zwrócono 400 z pustym ciałem odpowiedzi, bez ustrukturyzowanego opisu błędu |
| Nieprawidłowy schemat narzędzia (błędy i odzyskiwanie) | 3/3 | Powinien zostać zwrócony błąd parametru; zwrócono 503 |
| Odizolowany wynik narzędzia (błędy i odzyskiwanie) | 3/3 | Powinien zostać zwrócony błąd parametru; zwrócono 200 |
| Błąd formatu stream_options (błędy i odzyskiwanie) | 3/3 | Zwrócono 400 z pustym ciałem odpowiedzi, bez ustrukturyzowanego opisu błędu |
| Rozliczanie tokenów rozumowania (rozliczanie i protokół pamięci podręcznej) | 3/3 | Nie zwrócono liczby tokenów rozumowania |
| Definicje narzędzi liczone jako dane wejściowe (rozliczanie i protokół pamięci podręcznej) | 3/3 | Przy definicjach narzędzi zgłoszona liczba tokenów wejściowych nie była większa niż bez nich |
| Izolacja żądań (kontekst i stan) | 1/3 | Pierwszy krok nie zwrócił wyłącznie STORED, jak wymagano, więc nie można było przeprowadzić kontroli izolacji |
Te kontrole są wykluczone z mianownika i nie są liczone ani jako zaliczone, ani jako niezaliczone.
| Status | Przypadek | Liczba | Przyczyna |
|---|---|---|---|
| Nie dotyczy | Jawne cache_control | 3 | Z góry oznaczono jako nieobsługiwane przez ten interfejs |
Przypadki błędu formatu messages i błędu formatu stream_options nie powiodły się u wszystkich pięciu dostawców: każdy zwrócił 400 z pustym ciałem, więc klient nie otrzymał ustrukturyzowanego opisu błędu. Ponieważ wszyscy pięciu wykazali to samo zachowanie, najprawdopodobniej jego źródłem jest warstwa bramy AIHubMix i wymaga osobnego zbadania. Rozliczanie tokenów rozumowania również nie powiodło się u wszystkich pięciu, ale z innych przyczyn: ByteDance i Fireworks zgłaszały tokeny rozumowania nawet przy wyłączonym rozumowaniu, a pozostałych trzech dostawców nie zwracało ich liczby.
Porównanie z pozostałymi czterema
P — szybkość odpowiedzi: 88.58
Każde żądanie zawierało około 10,000 tokenów wejściowych i wymagało około 1,100 tokenów wyjściowych. W trzech oknach wysłano 30 żądań przy współbieżności 1 i 30 przy współbieżności 10, łącznie 180. Czas oczekiwania na pierwszy token treści (TTFA) mierzono dla każdego prawidłowego żądania, a tabela przedstawia mediany. TPOT szacuje się na podstawie czasów nadejścia fragmentów strumienia, a nie sprzętowego pomiaru czasu na token; przepustowość to liczba prawidłowych tokenów wyjściowych przy współbieżności 10 podzielona przez łączny czas zegarowy partii.
| Metryka | Wynik |
|---|---|
| Czas do pierwszego tokenu treści TTFA | Mediana przy współbieżności 1: 1.34 s, mediana przy współbieżności 10: 1.35 s |
| Szybkość generowania TPOT | Przy współbieżności 1: 4.63 ms/token, przy współbieżności 10: 4.69 ms/token |
| Efektywna przepustowość (goodput) | Przy współbieżności 10: 1,313.6 tokenów/s |
| Prawidłowe żądania | Przy współbieżności 1: 90/90, przy współbieżności 10: 90/90 |
| Wyniki składowe | TTFA 59.65, TPOT 100.00, przepustowość 100.00; dla TTFA i TPOT przyjmuje się niższy wynik z dwóch poziomów, z wagami 35% / 35% / 30%; wynik szybkości odpowiedzi: 85.88 |
| Wynik P | Wynik szybkości odpowiedzi 85.88 o wadze 80%, cache K 99.37 o wadze 20%, łącznie 88.58 |
Porównanie z pozostałymi czterema
Wszyscy pięciu dostawcy korzystali z tej samej maszyny, sieci i konta. Trzy okna zaplanowano osobno dla każdego dostawcy, więc okresy zbierania danych nie pokrywają się całkowicie i nie należy nadinterpretować niewielkich różnic.
K — pamięć podręczna: 99.37
Każda grupa obejmuje pięć żądań: pierwsze zawiera stały prefiks o długości około 8k lub 32k tokenów i zapełnia pamięć podręczną; w żądaniach 2–4 prefiks pozostaje niezmieniony, a zmienia się tylko końcowe pytanie, wysyłane po 5, 30 i 120 sekundach; piąte żądanie używa nowego prefiksu jako zimnej próby kontrolnej. Trzy okna × dwie długości dają 30 żądań. K to liczba tokenów odczytanych z pamięci podręcznej w gorących żądaniach podzielona przez liczbę tokenów, które zgodnie z regułą powinny być możliwe do ponownego wykorzystania, przy równych wagach obu długości; K stanowi 20% wyniku P. Macierz pokazuje odczyty tokenów z pamięci podręcznej zgłoszone przez serwer.
| Prefiks | Okno | Zapełnienie (żądanie 1) | Gorące po 5 s | Gorące po 30 s | Gorące po 120 s | Zimna próba kontrolna (żądanie 5) |
|---|---|---|---|---|---|---|
| 8k | Okno 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Okno 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Okno 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Okno 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Okno 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Okno 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Prefiks | Trafienia w pamięć podręczną | Odczytane tokeny | Powinny nadawać się do ponownego wykorzystania | Wynik |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k i 32k, po połowie) | 99.37 |
Wszystkie 9 gorących żądań z prefiksem 8k trafiło w pamięć podręczną, odczytując po 7,936 tokenów; wszystkie 9 gorących żądań z prefiksem 32k trafiło w pamięć podręczną, odczytując po 32,000 tokenów. Żądanie zapełniające i zimna próba kontrolna nie odczytały danych z pamięci podręcznej, więc gorące i zimne żądania są wyraźnie rozdzielone.
Porównanie z pozostałymi czterema
R — stabilność usługi: 100
300 żądań obejmowało cztery typy — krótki tekst, długie wejście 10k, wywołania narzędzi i historię wieloturową — i wysłano je przy współbieżności 1 w trzech oknach. Sprawdzano tylko pierwszą odpowiedź pod kątem prawidłowości i kompletności; nie oceniano poprawności odpowiedzi i nie ponawiano żądań. Błędy z sekcji dotyczących jakości odpowiedzi i szybkości są liczone odpowiednio w Q i P, a nie ponownie w R.
| Typ żądania | Powodzenie przy pierwszej próbie |
|---|---|
| Krótki tekst | 120/120 |
| Długie wejście 10k | 90/90 |
| Wywołania narzędzi | 60/60 |
| Historia wieloturowa | 30/30 |
| Łącznie · przedział 95%: 98.78%–100% | 300/300 |
Wszystkie 300 żądań zwróciły prawidłową, kompletną odpowiedź za pierwszym podejściem. R 100 obejmuje tylko te 300 dedykowanych żądań i nie oznacza, że w całym łańcuchu nie wystąpiły błędy. Dolna granica 95-procentowego przedziału wynosi 98.78%: nawet przy wyniku 300/300 prawdopodobieństwo, że odsetek błędów jest niższy niż 1.22%, pozostaje wysokie.
W porównaniu z pozostałymi czterema
R obejmuje tylko te 300 dedykowanych żądań; błędy jakości odpowiedzi i szybkości są odnotowywane w Q i P, a nie liczone ponownie w R.
| Dostawca | Powodzenie za pierwszym podejściem | Przedział 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Czy różnica 0.37 w wyniku ogólnym między Alibaba Cloud a oficjalnym kanałem ma znaczenie?
Nie. W tym teście nie można ich od siebie odróżnić: różnica Q wynosi −0.71 punktu procentowego, a 95-procentowy przedział mieści się w zakresie od −1.72 do +0.26, obejmując 0. Wynik ogólny to indeks podsumowujący, dla którego nie podano przedziału ufności.
Co uwzględnia wynik Q?
Trzy zestawy: 500 pytań BFCL × 3 rundy, ocenianych automatycznie; HLE 250 × 10 oraz AA-LCR 25 × 10, ocenianych przez model-sędziego deepseek-flash. Łączna dokładność wyniosła 41.75% dla 4,240 ocenionych przebiegów pytań.
Dlaczego F wynosi 89.78, skoro 155 z 177 kontroli zakończyło się powodzeniem?
Wynik jest ważony według grup, a nie wyliczany jako prosty odsetek zaliczonych kontroli. Błędy i odzyskiwanie działania uzyskały 60.00, a rozliczanie użycia i protokół pamięci podręcznej — 77.78; trzy grupy protokołów uzyskały 100.00.
Dlaczego R wynosi 100, jeśli w innych sekcjach wystąpiły nieudane żądania?
R obejmuje tylko 300 dedykowanych żądań testujących stabilność. Błędy jakości odpowiedzi i szybkości są odnotowywane w Q i P, a nie liczone ponownie w R.
Czy K 99.37 to współczynnik trafień w pamięci podręcznej?
To stosunek liczby tokenów odczytanych z pamięci podręcznej przy gorących żądaniach do liczby tokenów, które powinny nadawać się do ponownego użycia; prefikty 8k i 32k mają równą wagę. Prefiks 8k uzyskał 98.83, a prefiks 32k — 99.90.
Czy pierwsze tokeny po 1.34 s oznaczają, że cała odpowiedź dociera w 1.34 s?
Nie. To czas oczekiwania na pierwszy token treści. Każde żądanie obejmowało około 1,100 tokenów wyjściowych, a TPOT przy współbieżności 10 wynosił 4.69 ms na token.
Czytaj dalej: seria DeepSeek V4.1 Flash
- Łączny wynik Q Alibaba Cloud różni się od oficjalnego wyniku bazowego o 0.71 punktu procentowego, co mieści się w przedziale obejmującym 0; profil ByteDance rozszerza to porównanie o rozliczanie wywołań narzędzi: DeepSeek V4.1 Flash w ByteDance: wywołania narzędzi się zgadzają, rozliczanie — nie.
- Alibaba Cloud zwrócił prawidłowe wyniki dla wszystkich 180 żądań w teście szybkości; profil Baidu wykorzystuje ten sam zestaw testowy, w którym żaden dostępny kanał nie wpłynął na Q ani P: DeepSeek V4.1 Flash w Baidu: brak dostępnego kanału wpływa na Q i P.
- Oficjalny kanał stanowi punkt odniesienia dla porównania jakości odpowiedzi w tym artykule; jego profil obejmuje F 94.00 oraz 15 nieprawidłowych sond przy pojedynczej współbieżności: DeepSeek V4.1 Flash w oficjalnym kanale: F 94.00, 15 nieprawidłowych sond.
- Alibaba Cloud zaliczył 9/9 gorących żądań dla obu długości prefiksu; profil Fireworks obejmuje puste odpowiedzi po zatrzymaniu oraz 3/9 trafień w pamięci podręcznej dla 8k: DeepSeek V4.1 Flash w Fireworks: puste odpowiedzi po zatrzymaniu, 3/9 trafień w pamięci podręcznej.


