

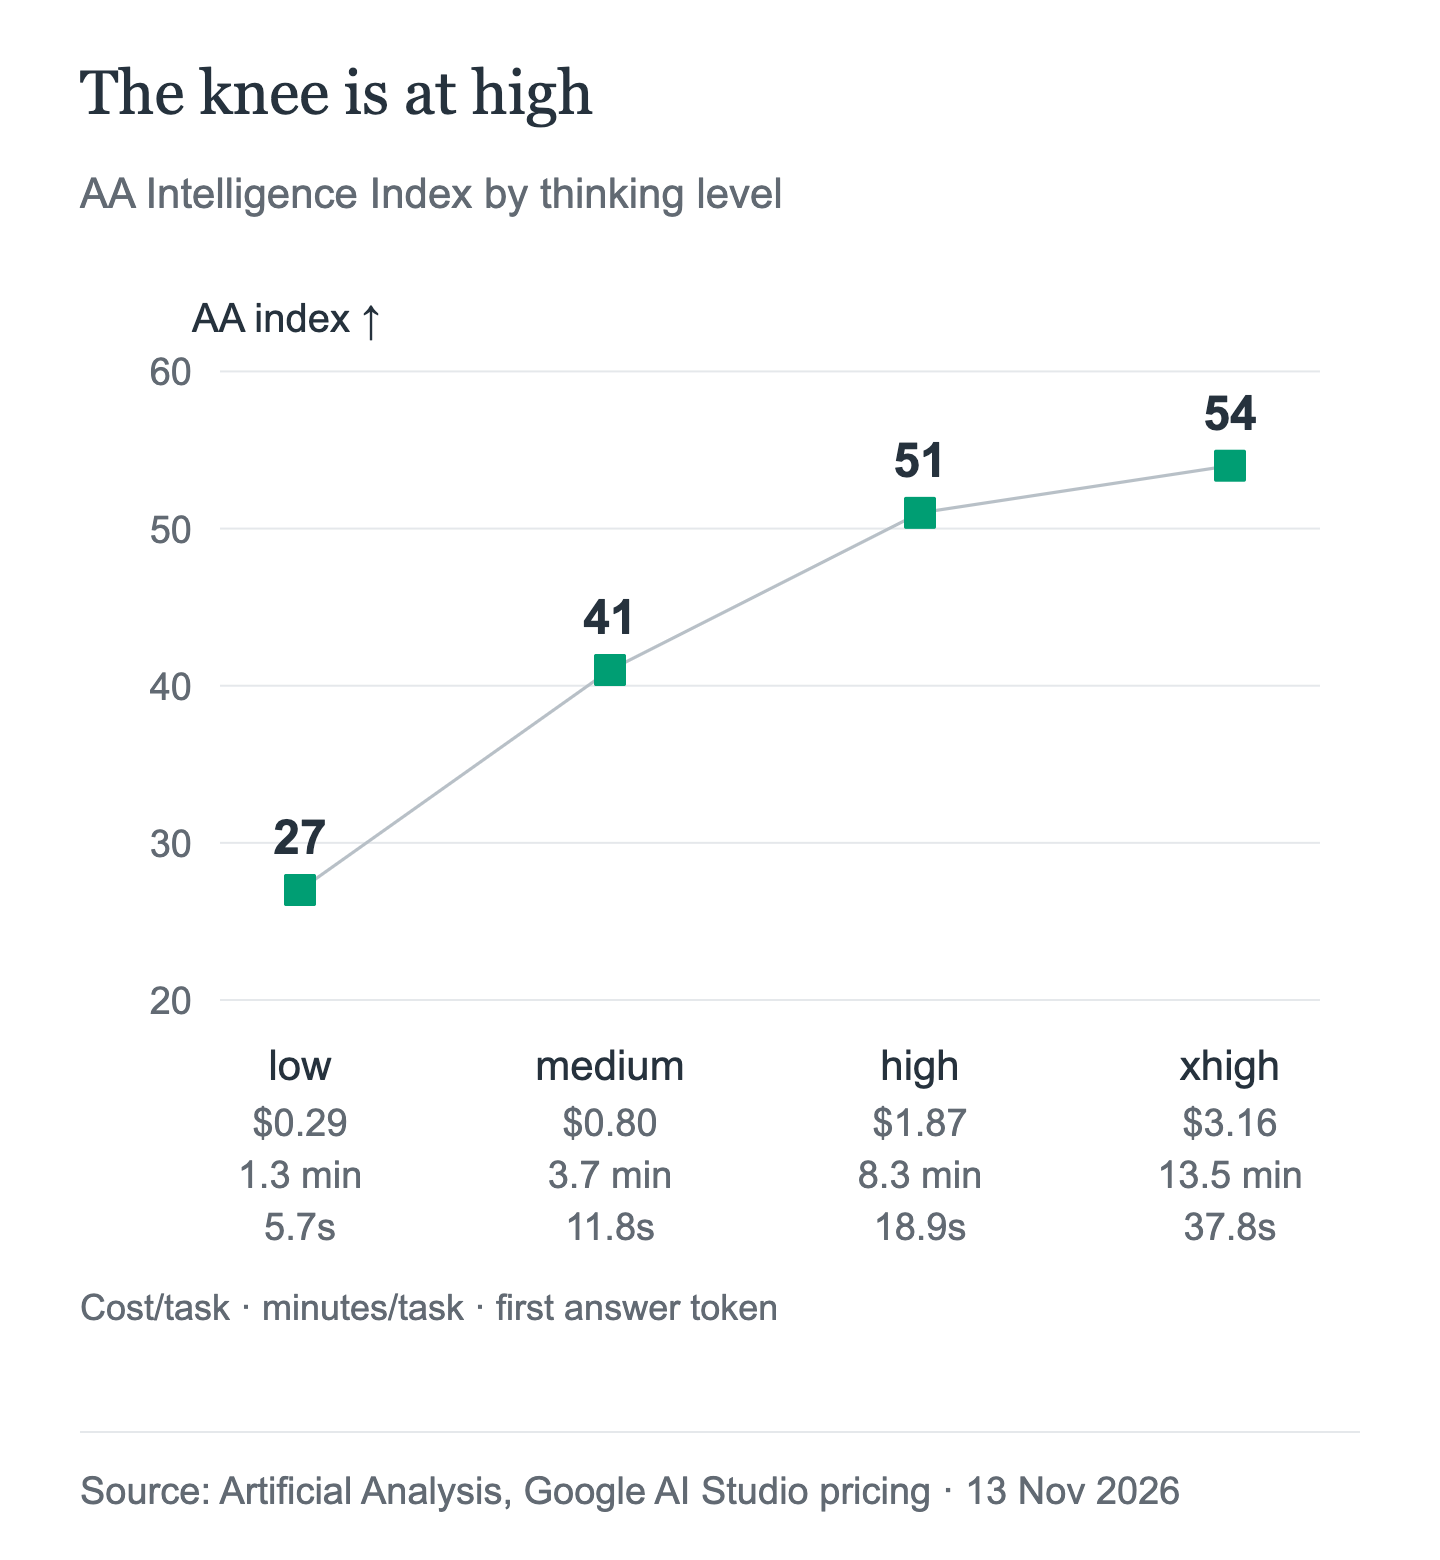
Gemini 4 Hydrogen heeft vier denkniveaus, die zich gedragen als vier verschillende modellen. Volgens de live metingen van Artificial Analysis scoort hetzelfde model 27 op low, 41 op medium, 51 op high en 54 op xhigh. De standaardinstelling is high, en xhigh is nieuw in de Gemini 4-familie: Carbon en Argon komen niet verder dan high.
De verschillen zijn groot: hetzelfde model beslaat 27 indexpunten van low tot xhigh. De stap van medium naar high levert 10 indexpunten op voor ongeveer $1.07 extra per taak. De stap van high naar xhigh levert 3 punten op voor $1.29 en laat je bijna twee keer zo lang wachten op het eerste antwoordtoken. Praktisch gezien kun je het beste beginnen met high, xhigh reserveren voor lastige taken met meerdere stappen en low en medium beschouwen als latentie-instellingen waarvan je de kwaliteit afzonderlijk moet controleren.
Hieronder lees je waarvoor elk niveau geschikt is, wat het kost, wat er in de API verandert en wat AIHubMix wel en niet documenteert.
De vier niveaus en wat er is veranderd
Gemini 4 Hydrogen ondersteunt low, medium, high en xhigh. Google's releaseopmerkingen zijn duidelijk: "Het model staat standaard op high en introduceert xhigh." Dat zijn twee veranderingen ten opzichte van Gemini 3.8 Flash, dat standaard op medium staat en niet verder komt dan high.
De rest van de familie is niet veranderd. Carbon en Argon ondersteunen low, medium en high, met medium als standaardinstelling. Hydrogen is het enige Gemini 4-model met een instelling boven high.
| Model | Niveaus | Standaard |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL maakt geen deel uit van de reeks. De documentatie over Gemini 4-denken vermeldt dat MINIMAL "niet wordt ondersteund op Gemini 4-modellen", en in de releaseopmerkingen van Hydrogen staat dat het model "minimal afwijst met een foutmelding." Er is voor dit model geen gedocumenteerde optie om denken uit te schakelen.
Wat Google aanbeveelt
De richtlijnen van Google zijn een redelijk uitgangspunt, maar zijn opgesteld voordat de onderstaande metingen beschikbaar waren. Vooral de aanbeveling om medium te gebruiken voor interactief programmeren gaat uit van een kwaliteitsniveau dat Artificial Analysis niet ziet bij medium.
| Niveau | Googles beschrijving en aanbevolen gebruik |
|---|---|
| low | "Minste tokens, laagste latentie" — snelle chats, hoge volumes |
| medium | "Minder tokens, snellere antwoorden" — interactief programmeren, UI-prototypes |
| high | "Een balans tussen intelligentie en snelheid" — standaard voor de meeste taken |
| xhigh | "Meeste tokens, diepste redenering" — lastige programmeertaken met meerdere stappen |
Bij deze tabel horen twee kanttekeningen. "Het gebruik van xhigh verhoogt de latentie en het tokengebruik en kan ervoor zorgen dat het model te lang nadenkt over eenvoudigere prompts", aldus Google. Ook het advies voor evaluaties is expliciet: "Voer je evaluaties uit op alle vier de niveaus met een hoge waarde voor max_output_tokens."
De gemeten niveaus
Artificial Analysis heeft alle vier de niveaus gemeten. Het gaat om Intelligence Index v5.0.1, met 78 gerangschikte modellen, geraadpleegd op 2026-11-13T02:40Z, tegen de standaard lijstprijzen. Dit zijn kosten per taak van AA, geen facturen van AIHubMix.
| Niveau | AA-rang | AA-index | $/taak | Min/taak | Eerste antwoordtoken |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
De verschillen tussen de niveaus zijn het meest relevant:
lownaarmedium: +14 indexpunten, +$0.51 per taak, +2.4 minuten, +6.1 seconden tot het eerste token.mediumnaarhigh: +10 indexpunten, +$1.07 per taak, +4.6 minuten, +7.1 seconden tot het eerste token.highnaarxhigh: +3 indexpunten, +$1.29 per taak, +5.2 minuten, +18.9 seconden tot het eerste token.
high is het omslagpunt. Dit is de laatste stap waarbij de kwaliteitswinst groot is in verhouding tot de extra kosten; bij xhigh verdubbelt de wachttijd tot het eerste token bijna, voor een kleine stijging van de index. Dat maakt xhigh geen slechte instelling. Het betekent dat je deze instelling gebruikt voor taken waarop high tekortschiet, precies zoals Google het beschrijft.
Ter vergelijking: in dezelfde snapshot scoort Carbon high 60 voor $5.48 per taak en 28.1 minuten, Carbon medium 58 voor $4.68, Carbon low 54 voor $5.22 en Argon high 50 voor $4.97 en 30.6 minuten. Hydrogen xhigh evenaart Carbon low met 54, tegen 39.5% lagere kosten per taak ($3.16 tegenover $5.22), al duurt het 37.77 seconden tot het eerste token, tegenover 13.61. Hydrogen high scoort één indexpunt hoger dan Argon high, tegen 62.4% lagere kosten per taak.
Waar de niveaus tekortschieten
low is niet zomaar een kleine stap terug. Met een score van 27 ligt het 24 indexpunten onder high. Wie een workload van high naar low verplaatst om $1.58 per taak te besparen, koopt niet hetzelfde product met minder denkwerk, maar een veel zwakker model. Dat kan prima zijn voor classificatie, routering of korte extractietaken. Voor programmeerwerk of agentische taken is dat zonder taakspecifieke evaluatie geen goede keuze.
medium is een latentie-instelling, geen kwaliteitsinstelling. Het scoort 41, 10 punten minder dan high, voor $0.80 tegenover $1.87. De besparing is reëel — 57% per taak — maar de kwaliteitskloof is groter dan het prijsverschil doet vermoeden. Google beveelt medium aan voor interactief programmeren; de AA-score suggereert dat je die aanbeveling eerst op je eigen taken moet testen.
xhigh kan te lang blijven nadenken. Google waarschuwt hier nadrukkelijk voor. De AA-cijfers voor kosten en tijd laten het effect zien: $3.16 per taak, 13.5 minuten en 37.77 seconden wachten op het eerste token. Voor een eenvoudige prompt is dat veel latentie voor een kleine winst. Voor een lastige programmeertaak met meerdere stappen waarop high tekortschiet, is dit het enige niveau dat verder gaat.
Woordigheid telt mee in de kosten. Artificial Analysis noemt Hydrogen "erg breedsprakig": de uitvoering op xhigh genereerde 304 miljoen uitvoertokens om de index te voltooien en stond daarmee op plek #76 van de 77, tegenover een mediaan van 72.8 miljoen. Uitvoertokens omvatten ook denk-tokens, en uitvoer kost $7.50 per miljoen tokens. Een hoger niveau denkt niet alleen langer na, maar produceert ook meer factureerbare tokens.
De kosten: hoe denken in tokens wordt uitgedrukt
De tarieven zijn eenvoudig. Hydrogen kost $1.50 per miljoen invoertokens, $7.50 per miljoen uitvoertokens en $0.075 per miljoen gecachete invoertokens. Uitvoer omvat denk-tokens. Daarom is het niveau belangrijker dan het tarief: het model rekent de redenering die het produceert aan, niet de naam van het niveau.
Drie factureringsregels zijn makkelijk over het hoofd te zien.
De standaardinstelling is veranderd. Gemini 3.8 Flash stond standaard op medium; Hydrogen staat standaard op high. Een workload waarbij nooit een niveau is ingesteld, verbruikt na de migratie meer uitvoertokens per beurt, zelfs als de prijs per token gelijk blijft. Dat is een budgetwijziging die zich voordoet als een modelwissel.
Alleen impliciete caching wordt ondersteund. Hydrogen ondersteunt impliciete caching met een minimum van 4,096 tokens en 95% korting bij cache-hits; expliciete caching wordt niet ondersteund. Op Googles enterprisepagina staat ook: "Schrijfbewerkingen naar de cache worden standaard gefactureerd tegen 1.25x de standaardprijs voor invoertokens." Dat is Googles formulering over facturering; de cachefacturering van AIHubMix voor dit model is niet gedocumenteerd.
Lange uitvoer heeft een limiet per verwerkingsronde. Een synchroon verzoek genereert maximaal 65,536 tokens per verwerkingsronde, zowel met als zonder streaming. Voor langere uitvoer heb je achtergrondverwerking of voortzettingstokens nodig, en max_output_tokens begrenst het gecombineerde aantal denk- en uitvoertokens. Als je background=true instelt zonder een waarde voor max_output_tokens, stopt de server na 65,536 tokens. Google raadt voor lange decodeerbewerkingen budgetten van 131,072 of 262,144 aan, tot maximaal 1,048,576 min de invoer.
Wat de API doet en afwijst
De parameter heet thinking_level (snake_case). In het Python-voorbeeld van Google wordt deze ingesteld binnen thinking_config; in het Node-voorbeeld staat hij onder thinkingConfig (camelCase). Op de modelpagina staan de waarden als LOW, MEDIUM, HIGH en XHIGH; in de releaseopmerkingen worden ze in kleine letters geschreven. Gebruik de enum of de gedocumenteerde tekenreeks van je SDK in plaats van zelf een variant met andere hoofdletters te typen.
Drie soorten verzoeken mislukken:
thinking_budgetgeeft op elk Gemini 4-model400: INVALID_ARGUMENTterug. Ook het instellen van zowelthinking_levelalsthinking_budgetlevert een fout op.thinking_level="MINIMAL"wordt niet ondersteund; Hydrogen wijst deze waarde af.- Aangepaste waarden voor
temperature,top_pentop_kworden genegeerd. De vaste standaardwaarden zijn temperature 1.0, topP 0.95 en topK 64.
Op het platform van Google ondersteunt Hydrogen ook functieaanroepen, code-uitvoering, URL-context en computergebruik. Gebruik in de Interactions API previous_interaction_id voor gesprekken met meerdere beurten en tool-aanroepen.
Wat AIHubMix wel en niet documenteert
De gedocumenteerde route van AIHubMix voor Hydrogen is POST https://aihubmix.com/v1/chat/completions met model="gemini-4-hydrogen". Op de modelpagina staan invoer van tekst, afbeeldingen, audio, video en PDF en tekst als uitvoer; llms.txt bevat nog een oudere regel waarin alleen tekst wordt genoemd, dus beschouw de modelpagina als de nieuwere bron. De mogelijkheden voor toolgebruik, gestructureerde uitvoer en redenering zijn "niet gepubliceerd". Het model staat niet in de modellenindex die op 2026-11-11 is gegenereerd, en er is geen protocolschema gepubliceerd.
Dat is relevant voor dit artikel, omdat AIHubMix niet documenteert hoe je voor Gemini 4-modellen een denkniveau instelt. De Gemini-gids behandelt reasoning_effort voor modellen uit het Gemini 2.5-tijdperk, maar niet thinking_level of xhigh voor Gemini 4. Ga er niet van uit dat een van beide parameters via de gateway wordt doorgestuurd, en ook niet dat de standaardinstelling die je op Googles API ziet, dezelfde is als op AIHubMix.
De veilige vorm van het verzoek is de vorm die AIHubMix documenteert:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Als controle over het niveau een harde eis is, roep dan rechtstreeks de API van Google aan of controleer het gedrag van de gateway met een klein verzoek voordat je productieverkeer ernaartoe routeert. De vergelijkingspagina van AIHubMix is nuttig om de kosten te vergelijken terwijl je een keuze maakt. Voor dit artikel is geen live test uitgevoerd.
Waar begin je per workload?
| Workload | Begin met en waarom |
|---|---|
| Snelle chat, routering, classificatie | medium, test low; low scoort 27 |
| Interactief coderen, UI-prototyping | high; medium van AA scoort 41 |
| Agentuitvoering, tool-loops | high; alleen xhigh als je vastloopt |
| Moeilijk debuggen, architectuur, planning | xhigh of Carbon; 3 punten voor 69% meer |
| Batchverwerking op grote schaal na evaluatie | low of medium; goedkoopst, maar indexscore van 27/41 |
| Strikt latentiebudget van minder dan 15 seconden | medium of low; high wacht 18.89 s |
Dit zijn startpunten, geen routeringsregels. Het juiste niveau is het laagste niveau dat slaagt voor je eigen evaluatie. Google adviseert om die evaluatie op alle vier de niveaus uit te voeren.
Veelgestelde vragen
Welke denkingsniveaus heeft Gemini 4 Hydrogen?
Vier: low, medium, high en xhigh. De standaardinstelling is high.
Wat is er veranderd ten opzichte van Gemini 3.8 Flash?
De standaardinstelling is veranderd van medium naar high en xhigh is toegevoegd boven high. Carbon en Argon hebben nog steeds medium als standaardinstelling en gaan niet verder dan high.
Is xhigh het waard?
Voor moeilijke taken met meerdere stappen waarbij high tekortschiet: ja, het levert 3 indexpunten op. Het kost per taak ook 69% meer dan high en de wachttijd tot het eerste token is bijna twee keer zo lang. Daarom is het geen goede standaardinstelling voor eenvoudige prompts.
Waarom blijft low zo ver achter?
Artificial Analysis geeft het een indexscore van 27, 24 punten lager dan high. De prijs is $0.29 per taak tegenover $1.87, maar het kwaliteitsverschil is veel groter dan het prijsverschil. Gebruik dit niveau alleen als een taakspecifieke evaluatie uitwijst dat het volstaat.
Ondersteunt AIHubMix thinking_level of xhigh?
Niet volgens de documentatie. AIHubMix publiceert geen vlag voor redeneermogelijkheden voor Hydrogen en geen handleiding voor de denkingsniveaus van Gemini 4. Controleer dit voordat je op een van beide vertrouwt.
Wat gebeurt er als ik thinking_budget meestuur?
Gemini 4 retourneert 400: INVALID_ARGUMENT. Als je zowel thinking_budget als thinking_level instelt, krijg je ook een foutmelding.
Kan ik denken uitschakelen?
Er is geen gedocumenteerde optie om dit uit te schakelen. MINIMAL wordt niet ondersteund in Gemini 4 en Hydrogen wijst deze instelling af met een foutmelding.
Lees verder: de Gemini 4 Hydrogen-reeks
- Twijfel je nog of Hydrogen de juiste upgrade is ten opzichte van Gemini 3.8 Flash? In het eerste artikel lees je over de lancering, de prijswijziging en de afwegingen op basis van benchmarks: Gemini 4 Hydrogen vs Gemini 3.8 Flash: Is de Upgrade Worth It?.
- Wil je weten hoe Hydrogen zich voor dezelfde taak verhoudt tot Carbon en Argon? Het derde artikel zet alle drie naast elkaar, met prijzen, latentie en een tabel met workloads: Gemini 4 Carbon vs Hydrogen vs Argon: Which Model for Which Job?.
Bronnen
- Google AI Studio, Gemini 4 Hydrogen: what's new
- Google, Gemini 4 thinking
- Google, Gemini 4 Hydrogen model page
- Google AI Studio, Gemini API pricing
- Artificial Analysis, Gemini 4 Hydrogen — actuele momentopname 2026-11-13T02:40Z, Intelligence Index v5.0.1


