Gemini 4 Carbon is op het niveau van het aanvraagschema een directe vervanger van Gemini 4 Argon. Dezelfde body voor chat completions werkt: de model-ID verandert, maar enkele parameterwaarden blijven niet behouden. De belangrijke problemen zitten een laag dieper: parameterfouten die 400 retourneren, uitvoerlimieten die stilzwijgend afkappen, en een time-out- en factureringsprofiel dat is afgestemd op langdurig denken.
Vier standaardinstellingen bepalen de eerste week:
- Houd
max_tokensop AIHubMix op 65,536 of lager; de gateway documenteert alleen Chat Completions en publiceert geen groter uitvoerpad. - Stel voor Google-native Interactions-/achtergrondruns
store=trueen een explicietemax_output_tokensin; deze velden zijn voor Carbon op AIHubMix niet gedocumenteerd. - Verhoog de HTTP-read-time-outs tot 15–20 minuten per stream wanneer je het leveranciersnative pad voor langdurige decodering gebruikt.
- Verwijder
temperature,top_pentop_k, die worden genegeerd, evenals penalties encandidate_count-waarden boven 1, die volgens Google's Carbon-gids een 400 retourneren.
De ongewijzigde basiszaken — toegang, beveiligingsweigeringen en kosten per taak — staan in de migratiepost over Argon. Deze post behandelt gedrag dat specifiek is voor Carbon.
Wat luidruchtig faalt en wat stilzwijgend faalt
Fouten zijn eenvoudig in te delen: een 400 vertelt het je meteen, een stilzwijgende limiet pas op de factuur.
| Wat je ziet | Categorie | Eerste stap |
|---|---|---|
| HTTP 400 bij een parameter | Luidruchtig | Verwijder het niet-ondersteunde veld |
| 400 bij een achtergrondverzoek | Luidruchtig | Voeg store=true toe |
| Antwoord stopt bij 65,536 tokens | Stilzwijgend | Verhoog max_tokens tot maximaal 65,536 |
| Lege tekst, status incomplete | Stilzwijgend | Verhoog de limiet en probeer opnieuw |
| Achtergrondrun eindigt rond 64K | Stilzwijgend | Stel max_output_tokens in |
| Antwoord lijkt oppervlakkiger | Stilzwijgend | Stel het denkniveau expliciet in |
| Factuur hoger dan geraamd | Stilzwijgend | Reken op denk- en decodeerstappen |
AIHubMix vermeldt gemini-4-carbon voor $2 aan invoer, $10 aan uitvoer en $0.10 aan gecachte tokens per miljoen tokens — de introductietarieven van Google — via Chat Completions. Deze tarieven zijn tijdelijk; zie facturering.
Luidruchtige fouten: de gedocumenteerde 400-fouten
Veel gedocumenteerde 400-fouten komen door parametervalidatie; fouten met de geschiedenis en vooraf ingevulde modelbeurten zijn fouten in de aanvraagstatus. Tenzij anders vermeld, komen de onderstaande regels uit Google's native Carbon-gids; AIHubMix documenteert momenteel alleen Chat Completions voor Carbon. De Carbon-vermelding van AIHubMix beschrijft de categorie in één regel: "400 — parameterfout; de meeste worden doorgegeven door de upstream-aanbieder." Dat beschrijft de gateway, niet een test. De details komen uit Google's Carbon-gids en de pagina met nieuwe functies.
| Aanleiding | Wat je ziet | Oplossing |
|---|---|---|
| max_output_tokens > 1M* | 400; boven limiet | Native ≤1M; gateway ≤65K* |
| frequency/presence penalty | 400; niet ondersteund | Verwijder de velden |
| candidate_count > 1 | 400; meerdere kandidaten | Laat weg of stel in op 1 |
| background zonder store* | 400; store vereist* | Voeg store=true toe |
| Geschiedenis eindigt met model | Afgewezen; niet ondersteund | Eindig met de gebruikersbeurt |
| beide instellingen | 400; kunnen niet worden gecombineerd | Verstuur één instelling |
| thinking_budget of MINIMAL | 400; Carbon-gids | Gebruik low/medium/high |
Google geeft de melding exact als volgt weer: "store=true is required for background interactions." * Alleen Google-native: max_output_tokens is begrensd op 1M en voor achtergrondverwerking is store=true vereist; AIHubMix heeft dit pad niet gedocumenteerd. Gebruik ≤65K via het Chat Completions-pad.
De rij minimal heeft twee betekenissen. In Google's native Carbon-velden retourneren thinking_budget en thinking_level=MINIMAL HTTP 400; gebruik low, medium of high. In Google's OpenAI-compatibiliteitslaag wordt reasoning_effort=minimal omgezet naar low; AIHubMix heeft niet bekendgemaakt of die omzetting ook voor Carbon geldt.
De afhandeling van tools is een verwante valkuil. Google's Carbon-gids adviseert opeenvolgende tool-uitvoeringsbeurten, en de Gemini-gids van AIHubMix documenteert tool_choice="auto"; ondersteuning van toolspecifieke functies voor Carbon op de gateway is nog niet bevestigd.
De kleinste veilige aanvraag naar /v1/chat/completions laat weg wat Carbon negeert:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Als dit 200 retourneert, is de transportlaag in orde. De rest gaat over antwoorden die nooit een fout opleveren.
Stilzwijgende fouten: geen fout, verkeerde uitvoer, verkeerde factuur
De standaarduitvoerlimiet is 65,536; langdurige decodering via de leverancier is een apart pad
De standaardlimiet voor Carbon-uitvoer is 65,536 tokens. Bij Chat Completions heet het veld voor de limiet max_tokens; Google's native gidsen noemen het max_output_tokens. Google's native pad voor langdurige decodering kan oplopen tot 1,048,576 tokens min de invoer; 131,072 en 262,144 zijn voorbeelden. De pagina met nieuwe functies van Google vermeldt de regel: "If you set background: true without defining max_output_tokens, the server stops after 64K tokens." AIHubMix heeft background of voortzetting voor Carbon niet gedocumenteerd.
Langdurige decodering via de leverancier verloopt in segmenten: 64K per stap bij background of streaming, 32K per stap zonder streaming; één REST-verzoek zonder streaming stopt na 32,768. Google's gids merkt op dat "Earlier SDK versions and the OpenAI compatibility layer can't retrieve long completions using continuation tokens." Houd voor AIHubMix max_tokens uit voorzorg op of onder 65,536; dit is een niet-geverifieerde gatewaylimiet. Plan niet om langere antwoorden aan elkaar te plakken totdat de modelpagina dit documenteert.
Een lage limiet kapt het denkproces af, en voor lege uitvoer wordt gefactureerd
De limiet geldt voor het denkproces, niet alleen voor de tekst. Google's gids voor langdurige decodering zegt: "A low value, such as 8,192, stops the model before it finishes thinking." De status wordt incomplete, en "Text can be empty if the model was still thinking." Je betaalt hoe dan ook. Reserveer ruimte voor het denkproces en het antwoord, en behandel een leeg, onvolledig antwoord als een limietprobleem: verhoog de limiet, probeer opnieuw en houd er rekening mee dat de eerste poging op de factuur staat.
Het standaarddenkniveau is medium
Carbon staat standaard op medium, net als Argon. Teams die overstappen vanaf Gemini 3.1 Pro Preview, dat standaard op high staat, verliezen een niveau zonder iets aan de code te veranderen en zien het oppervlakkigere antwoord aan voor een regressie. Google beveelt medium aan voor de meeste programmeer- en agenttaken. Stel het niveau expliciet in tijdens staging en verstuur slechts één instellingsveld: reasoning_effort en thinking_level kunnen niet worden gecombineerd.
Samplingparameters worden genegeerd
temperature, top_p en top_k worden genegeerd — geen fout en geen verandering in de sampling. Verwijder ze. Penalties en candidate_count-waarden boven 1 retourneren 400.
Expliciete caching is verdwenen
cachedContents en caches.create worden niet ondersteund. Impliciete caching geldt vanaf 4,096 tokens en levert een korting van 95% op. Verwijder code voor expliciete caching, zet de stabiele promptprefix vooraan en controleer het gebruik van gecachte tokens voordat je de korting in je begroting meerekent.
Voor de gespreksstatus geldt een regel
Google beveelt previous_interaction_id aan om een gesprek voort te zetten. Chat Completions heeft geen dergelijk veld, dus behoud de geschiedenis maar zorg dat deze eindigt met een gebruikersbeurt; een afsluitende beurt met de rol van het model of een vooraf ingevulde modelbeurt wordt niet ondersteund.
Time-outs: 15 tot 20 minuten, geen 60 seconden
Google's gids voor langdurige decodering beveelt HTTP-read-time-outs van 15 tot 20 minuten per stream aan; de migratiechecklist herhaalt een minimum van 15 minuten. Dat advies betreft verzoeken voor langdurige decodering. Een afzonderlijke meting van AA toont de wachttijd tot de eerste antwoordtoken: Carbon High duurde 67.1 seconden, Medium 23.2, Low 12.9 en Argon High 40.1. Laat een time-out van 60 seconden de eerste token überhaupt aankomen?
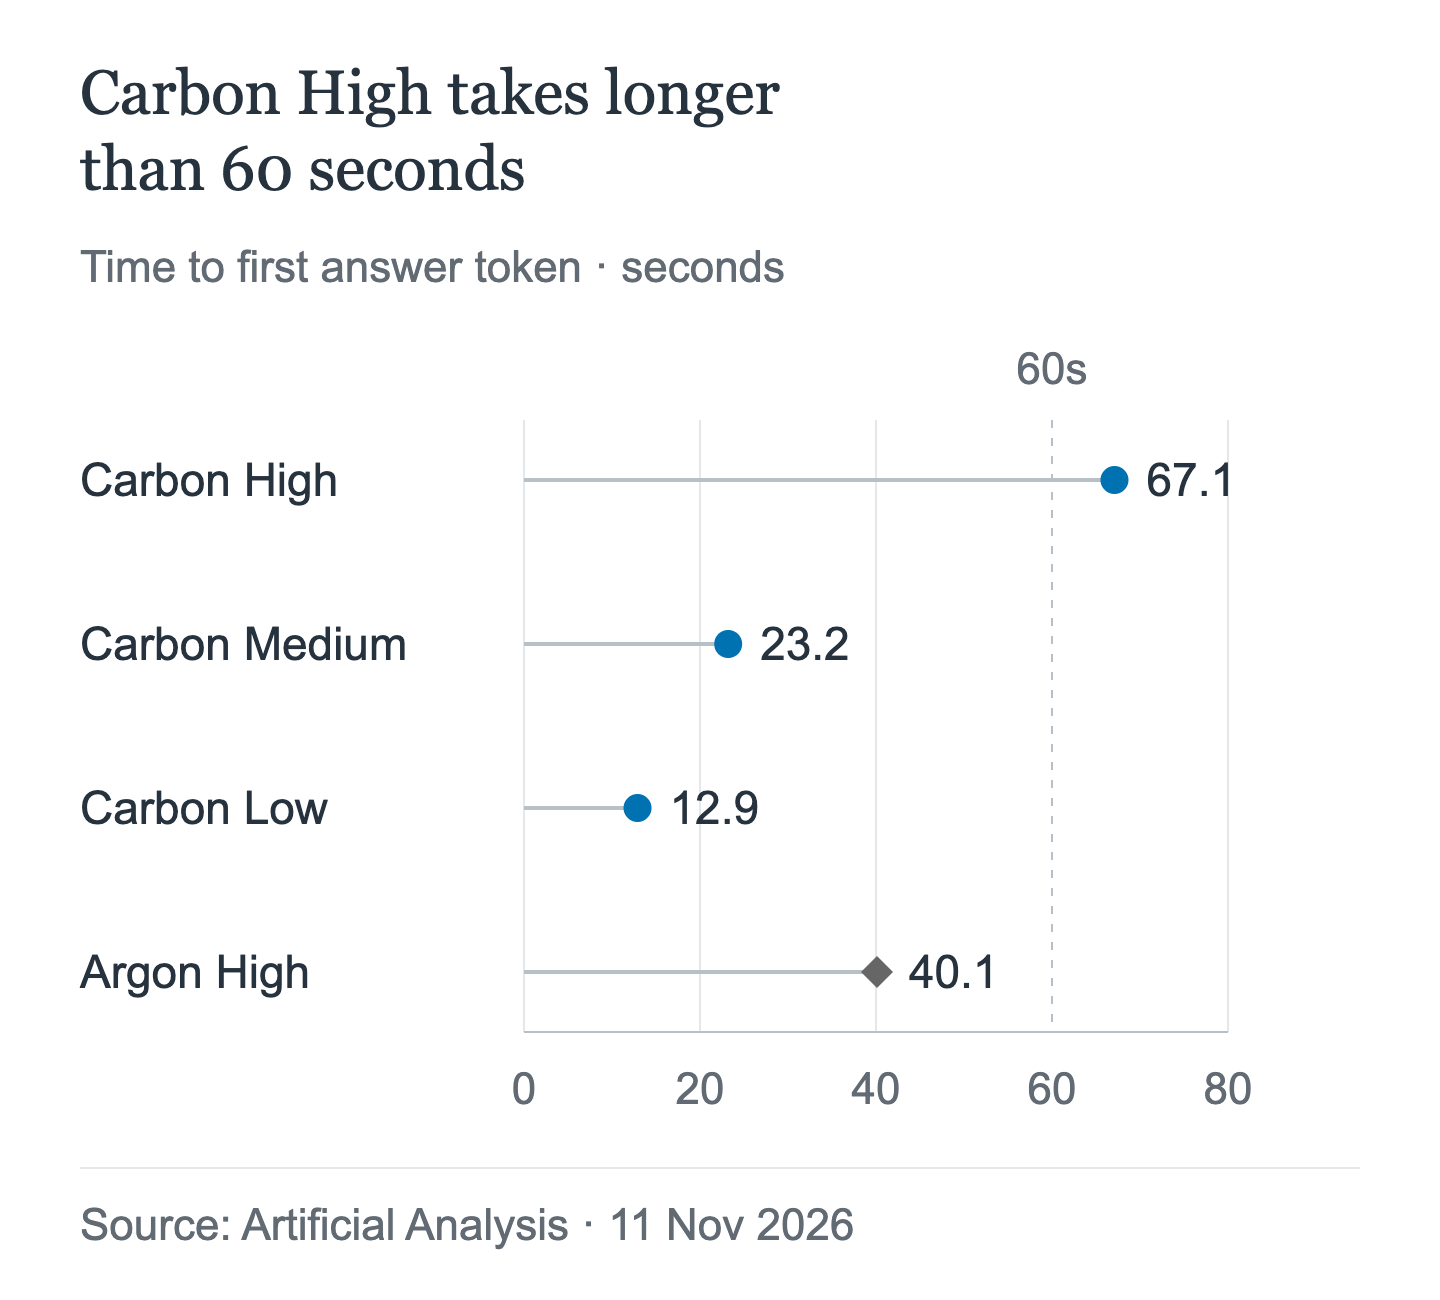
Carbon High overschrijdt in deze meting de grens van 60 seconden. De tijd tot de eerste token bepaalt niet wat een veilige time-out voor de volledige aanvraag is: het advies van 15–20 minuten hierboven komt uit Google's gids voor langdurige decodering. Dit zijn resultaten van één momentopname, geen latentiegaranties of een test van AIHubMix.
De limieten voor één stap bij Google-native clients zijn strikter dan de limiet voor achtergrondverwerking: 20 minuten voor een stream en 10 voor een aanvraag zonder streaming, tegenover 24 uur voor achtergrondverwerking. AIHubMix documenteert deze limieten voor achtergrondverwerking niet.
Minimumversies van native SDK's voor langdurige decodering: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. Claude Code's API_TIMEOUT_MS staat standaard op 10 minuten; als later wordt bevestigd dat Carbon via een Claude Code-pad beschikbaar is, verhoog deze waarde dan vóór de eerste run.
Factureringsvalkuilen
De prijs per token van Carbon is eenvoudig; de factuur niet. Verschillende mechanismen verhogen de rekening, en één geplande wijziging verdubbelt alle tarieven.
Voor het denkproces wordt gefactureerd als uitvoer
Voor denk-tokens wordt gefactureerd als uitvoer. Het uitvoertarief van Carbon is nu $10 per miljoen tokens en vanaf 1 december $20.
Voor elke stap van langdurige decodering wordt gefactureerd
Het uitgewerkte voorbeeld van Google: een prompt van 1,000 tokens die 200,000 uitvoertokens oplevert, rapporteert total_input_tokens van 397,216 over stappen van 1,000, 66,536, 132,072 en 197,608. "You pay for every token in every hop, including hops that contain only thinking." Impliciete caching geeft 95% korting op het grootste deel van de invoer, maar de stappen blijven meetellen in het gebruik. Ook voltooid werk wordt gefactureerd wanneer een run mislukt of wordt geannuleerd: "Completed segments are billed at the end of each segment even if a later segment fails or is cancelled," en "You pay for all work completed before the interaction ends."
Grounding heeft een eigen tarief
Op Google's native dienst zijn 5,000 groundingverzoeken per maand met Google Search gratis, gedeeld door Gemini 3 en nieuwer. Daarna geldt $14 per 1,000, met een maximum van 1,500 per dag. AIHubMix heeft grounding voor Carbon niet gedocumenteerd.
De voetnoot over Vertex geldt alleen voor de leverancier
De Vertex-prijspagina van Google voegt een regel toe: voor completions van meer dan 32K tokens wordt gefactureerd op basis van het gebruik van opvraagbare tokens, zelfs als de aanvraag door een client- of servertime-out mislukt; dit geldt vanaf 13 november 2026. Dit is een leveranciersregel; of de VertexAI-aanbieder van AIHubMix deze toepast, is niet bekendgemaakt. Vraag het na voordat je daarvan uitgaat.
Op 1 december verdubbelen alle tarieven
| Tarief | Tot en met 30 november | Vanaf 1 december |
|---|---|---|
| Invoer | $2 per 1M | $4 per 1M |
| Uitvoer | $10 per 1M | $20 per 1M |
| Gecachte reads | $0.10 per 1M | $0.20 per 1M |
Carbon en Argon hebben dezelfde introductietarieven; op 1 december verdubbelt elk tarief. AIHubMix vermeldt momenteel de introductietarieven en heeft de prijzen na december nog niet gepubliceerd. Ga ervan uit dat de verdubbeling zeker is en dat het gatewaytarief onbekend blijft; controleer beide voordat je een budget vastlegt.
Agents met echte machtigingen
Voor Google-native aanroepen raadt de Carbon-handleiding aan om tool-uitvoeringsbeurten sequentieel uit te voeren. Doe via deze route één aanroep tegelijk. De Gemini-handleiding van AIHubMix documenteert tool_choice="auto", maar ondersteuning voor tools specifiek voor Carbon en het gedrag van geforceerde tools via de gateway zijn niet bevestigd.
De geschiedenis mag niet eindigen met een modelbeurt en vooraf ingevulde modelbeurten worden niet ondersteund. Ontbreekt een toolresultaat, stuur dan een gebruikersbeurt waarin je om de volgende stap vraagt.
De modelkaart vermeldt dat het model soms traag is of time-outs geeft en op hogere niveaus extra tokens gebruikt; de kennisgrens is maart 2026. Bij schrijfrechten vormen time-outs het echte risico: een run die de clientlimiet overschrijdt, kan gedeeltelijk werk achterlaten, en voor voltooide segmenten wordt nog steeds afgerekend.
Codeertools: controleer de modelpagina voordat je iets configureert
De Carbon-vermelding van AIHubMix documenteert alleen Chat Completions, en Carbon staat nog niet in de openbare modellenindex. Claude Code vereist Anthropic Messages; Codex vereist Responses. Geen van beide is bevestigd voor Carbon op AIHubMix. Ga er niet van uit dat ze werken: open de hierboven gelinkte Carbon-modelpagina en controleer de lijst met protocollen. Staat daar alleen Chat Completions, gebruik dan een OpenAI-compatibele client of wacht.
De aanvraagstructuur is hetzelfde als voor Argon, maar de beschikbare protocollen verschillen: Carbon is momenteel op AIHubMix alleen gedocumenteerd voor Chat Completions. Het artikel over Claude Code behandelt ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN en API_TIMEOUT_MS; het artikel over Codex behandelt het providerblok, wire_api en model_reasoning_effort. Het verschil is of het protocol beschikbaar is.
| Client | Benodigd protocol | Carbon op AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Niet gedocumenteerd |
| Codex | Responses API | Niet gedocumenteerd |
| OpenAI SDK | Chat Completions | Gedocumenteerd |
Instellingen:
- Model-ID:
gemini-4-carbon. - Thinking: low, medium, high; standaard medium.
- Inspanningsniveau koppelen: native veld
thinking_level, compatibiliteitsveldreasoning_effort; Google koppelt waarden voor inspanning, maar AIHubMix heeft de mapping voor Carbon niet gepubliceerd. Stuur één waarde mee. - Context: 1,048,576 volgens Google; AIHubMix heeft geen limiet voor Carbon gepubliceerd, dus baseer je implementatie niet op het leverancierscijfer.
- Bekende problemen: trage eerste token bij high, advies van de leverancier om toolbeurten sequentieel uit te voeren, een conservatieve, niet-geverifieerde limiet van 65,536 uitvoertokens bij AIHubMix en een kennisgrens van maart 2026.
Smoketest, 10–15 minuten:
- Kies een kleine repository met één falende unittests en een testopdracht die in minder dan een minuut klaar is.
- Stel het model in op
gemini-4-carbon, zetmax_tokensop 65,536 of lager en stel de HTTP-time-out in op minstens 15 minuten. - Vraag de tool om de kleinst mogelijke wijziging aan te brengen waardoor de test slaagt. Voer daarna de testopdracht uit en controleer de diff.
- Geslaagd: de wijziging is minimaal en de test slaagt binnen 10–15 minuten. Mislukt: noteer of het antwoord een 400-fout, een onvolledig antwoord, een time-out of een onjuiste wijziging was; voor elk daarvan geldt een andere oplossing hierboven.
- Als de tool het niveau beschikbaar maakt, test dan medium en high en behoud het niveau dat binnen de beschikbare tijd klaar is.
Checklist voordat je de eerste productieaanvraag verstuurt
- Model-ID ingesteld op
gemini-4-carbon. - Geen
temperature,top_poftop_k. - Geen
frequency_penaltyofpresence_penalty; houdcandidate_countop 1 of laat het weg. max_tokensingesteld op 65,536 of lager.- Google-native achtergrondaanvragen versturen
store=trueen een explicietemax_output_tokens; AIHubMix heeft deze route niet gedocumenteerd. - HTTP-time-out van minstens 15 minuten; streaming heeft de voorkeur.
- Gebruik slechts één van
reasoning_effortenthinking_level. - Geef bij Google native de voorkeur aan sequentiële toolbeurten; AIHubMix documenteert
tool_choice="auto", maar ondersteuning voor Carbon is niet bevestigd. - Geen expliciete cache-aanroepen; de stabiele promptprefix komt eerst.
- Houd in het budget rekening met thinking-tokens en elke stap van een lange decode.
- Tarieven per 1 december gecontroleerd met de budgetverantwoordelijke.
- De codeertool gecontroleerd aan de hand van de modelpagina voordat je deze configureert.
Veelgestelde vragen
Moet de aanvraagbody veranderen wanneer ik van Argon naar Carbon overstap?
Nee. Het schema is ongewijzigd. Wijzig de model-ID, controleer de waarden en verwijder velden die nu een 400-fout opleveren.
Waarom geeft max_output_tokens een 400-fout?
De native Carbon-API van Google wijst waarden boven 1,048,576 af. De Chat Completions-route van AIHubMix heeft een aparte, conservatieve aanbeveling: houd max_tokens op of onder 65,536 totdat een hogere limiet is gedocumenteerd. Een lage waarde kapt juist het denkproces af, wat erger is: het antwoord kan onvolledig zijn en er wordt wel voor betaald.
Waarom is het antwoord leeg?
Als de status incomplete is, kan de tekst leeg zijn omdat het model nog aan het nadenken was. Je betaalt voor het werk. Verhoog de limiet en probeer het opnieuw.
Waarom stopt een achtergrondaanvraag bij 64K?
Bij de native achtergrondroute van Google stopt de server bij 64K als max_output_tokens ontbreekt. Stel de limiet expliciet in; native long decode kan oplopen tot 1,048,576 min de invoer. AIHubMix heeft de achtergrondmodus niet gedocumenteerd.
Wordt temperature toegepast?
Nee. temperature, top_p en top_k worden genegeerd. Penalty-waarden en candidate_count-waarden boven 1 leveren in plaats daarvan een 400-fout op.
Wordt Carbon op 1 december twee keer zo duur?
De tarieven van Google verdubbelen: invoer van $2 naar $4, uitvoer van $10 naar $20 en cache-reads van $0.10 naar $0.20. AIHubMix heeft de prijs na december niet gepubliceerd, dus bevestig die voordat je een budget vastlegt.
Kan ik Claude Code of Codex met Carbon gebruiken?
Dat is niet bevestigd. AIHubMix documenteert Chat Completions voor Carbon; Claude Code vereist Anthropic Messages en Codex vereist Responses. Controleer eerst de modelpagina.
Lees verder: de Gemini 4 Carbon-serie
- Als de migratie loopt en de resterende vraag is of Carbon zijn prijs überhaupt waard is, zet de vergelijking de gedeelde introductietarieven naast elkaar.
Gemini 4 Carbon versus Argon: dezelfde prijs, wanneer is Carbon het waard? - Kies je een codeeragent in plaats van een eindpunt te migreren, dan vergelijkt dit artikel het toolgebruik en de kosten per taak.
Gemini 4 Carbon versus Fable 5.2: welke kies je voor agentic coding?