
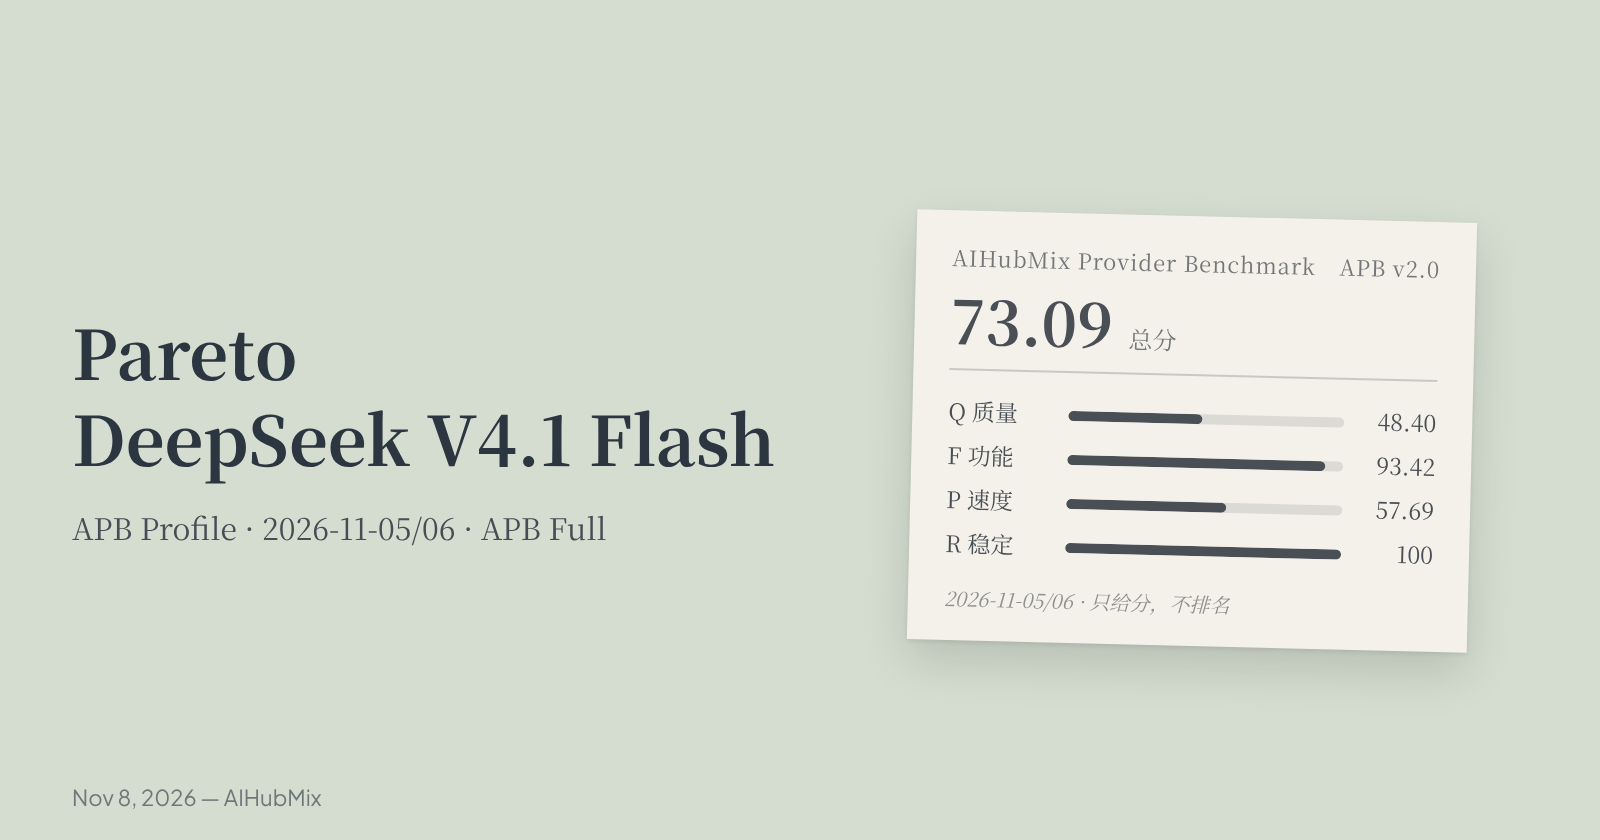
Op 2026-11-05/06 is DeepSeek V4.1 Flash 1017 getest met de volledige AIHubMix Provider Benchmark (APB)-suite op Pareto. De scores zijn Q 48.40, F 93.42, P 57.69, K 27.58 en R 100; de totaalscore is 73.09. Dit APB-profiel omvat alleen Pareto. Het model staat vermeld als DeepSeek V4.1 Flash 1017.
Dit artikel rapporteert alleen scores, zonder rangschikking of aanbeveling van een aanbieder. Q, F, P, K en R komen eerst; de totaalscore is een samenvattend getal zonder betrouwbaarheidsinterval. De norm is AIHubMix Provider Benchmark Standard v2.0.
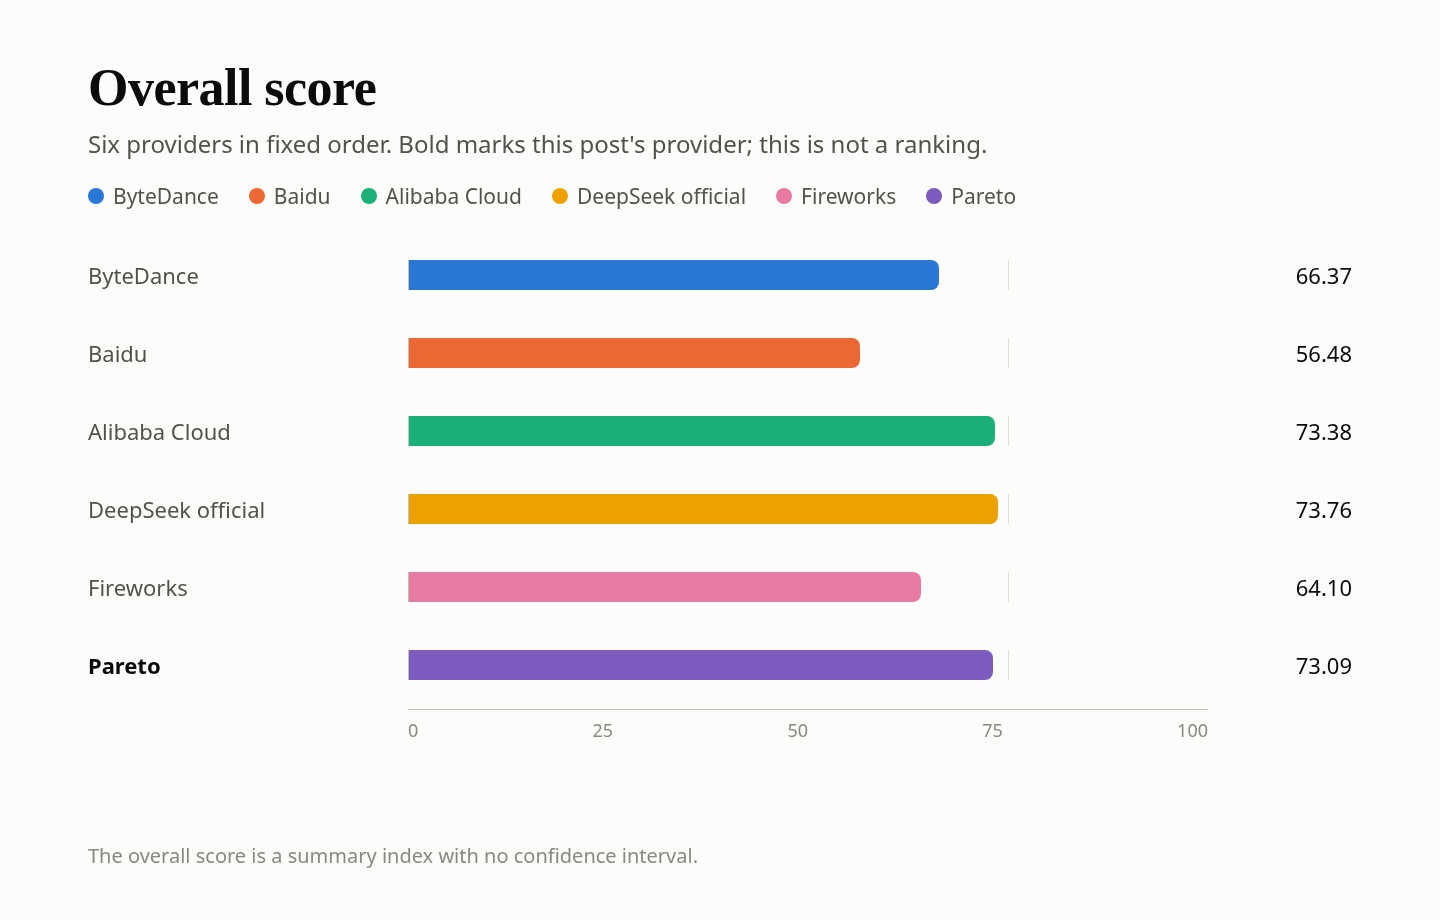
Scores bij zes aanbieders
Vetgedrukt is de aanbieder van dit artikel. Vaste volgorde van aanbieders, geen rangschikking. K is een deelscore van P en telt voor 20% mee. De totaalscore is een samenvattend getal zonder betrouwbaarheidsinterval. DeepSeek Official Channel en Alibaba Cloud verschillen 0.37 en zijn niet van elkaar te onderscheiden.
In één oogopslag
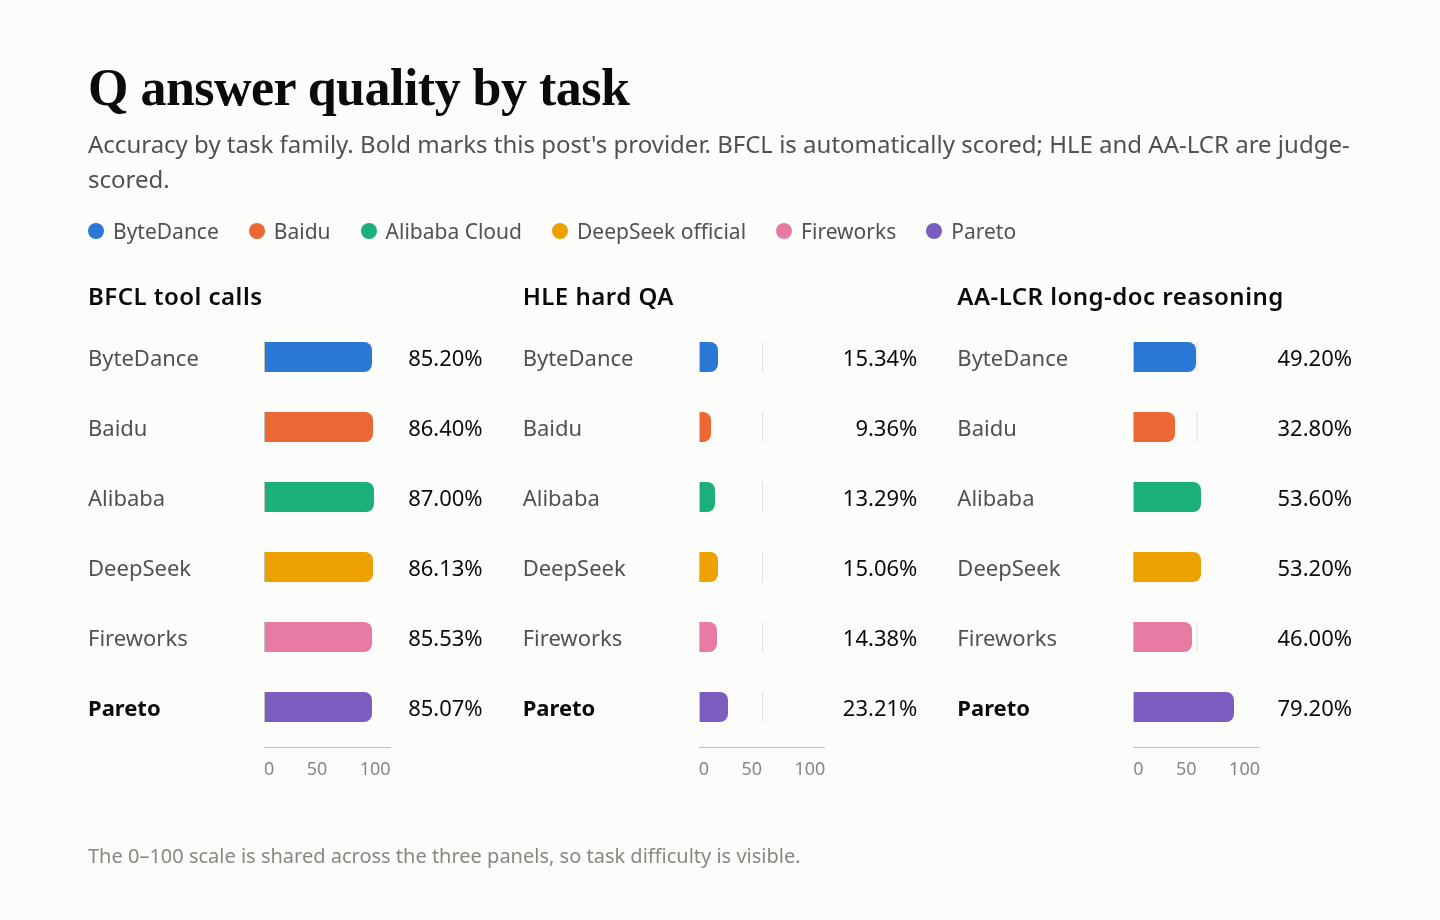
- Q — antwoordkwaliteit: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Ten opzichte van het officiële kanaal: +5.94 procentpunt, 95%-BI +3.54 tot +8.36. Bij HLE waren er 996 servicefouten; de meeste antwoorden werden afgekapt omdat het denkproces het uitvoerlengtebudget opslokte. Deze tellen als onjuist.
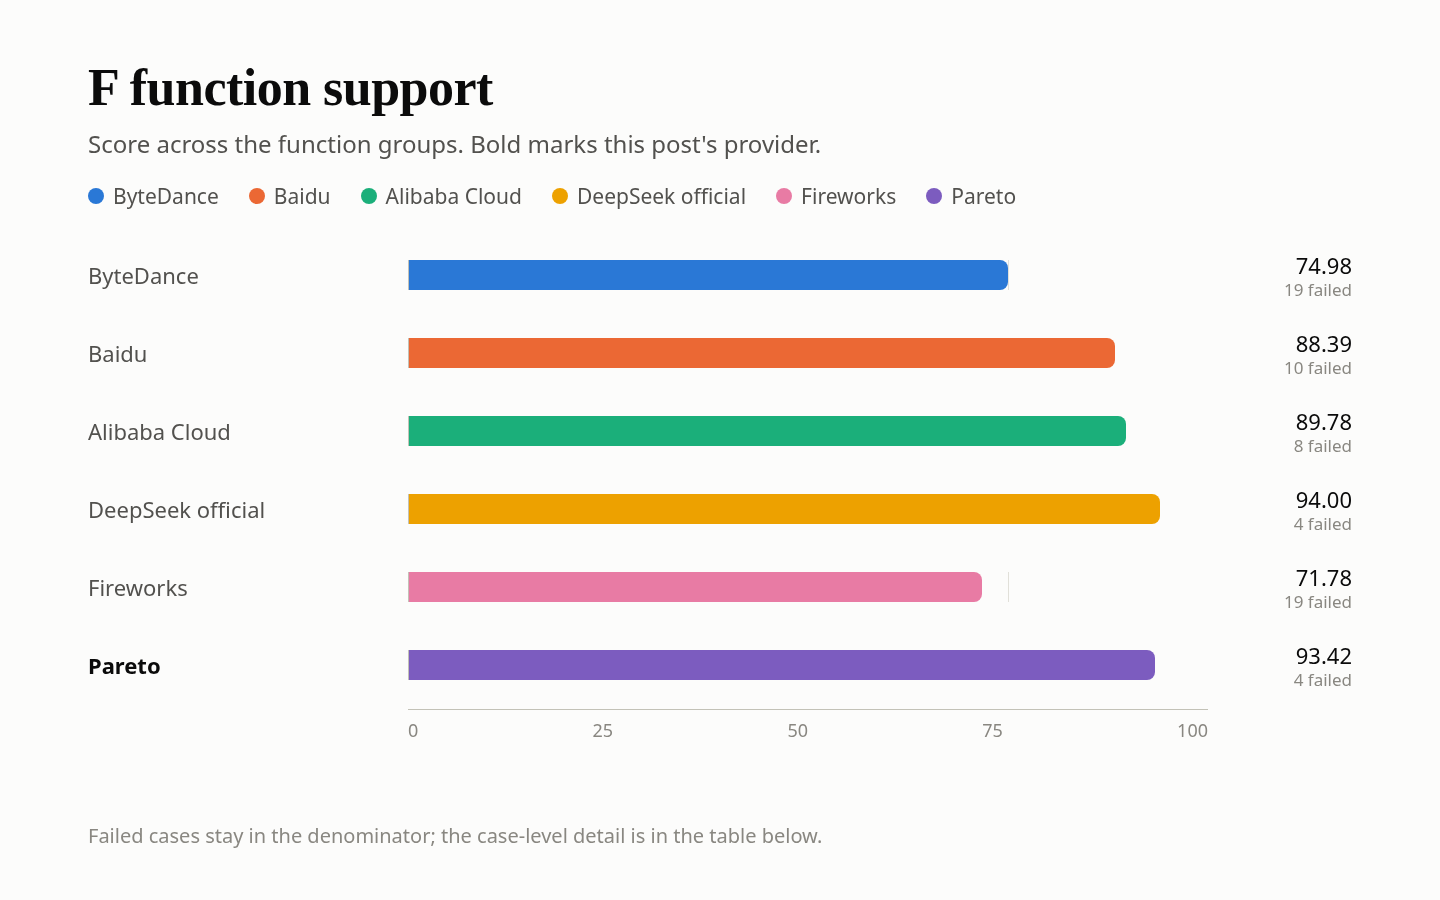
- F — functieondersteuning: 93.42. 29 van de 33 meegetelde controles geslaagd (streaming 23/27, fouten 3/3, metering 3/3). 147 controles vielen buiten de noemer. Van de 4 fouten waren er 3 lege bodies bij verzoeken met een stopreeks, en kwam 1 streaming-tekstfixture niet exact overeen.
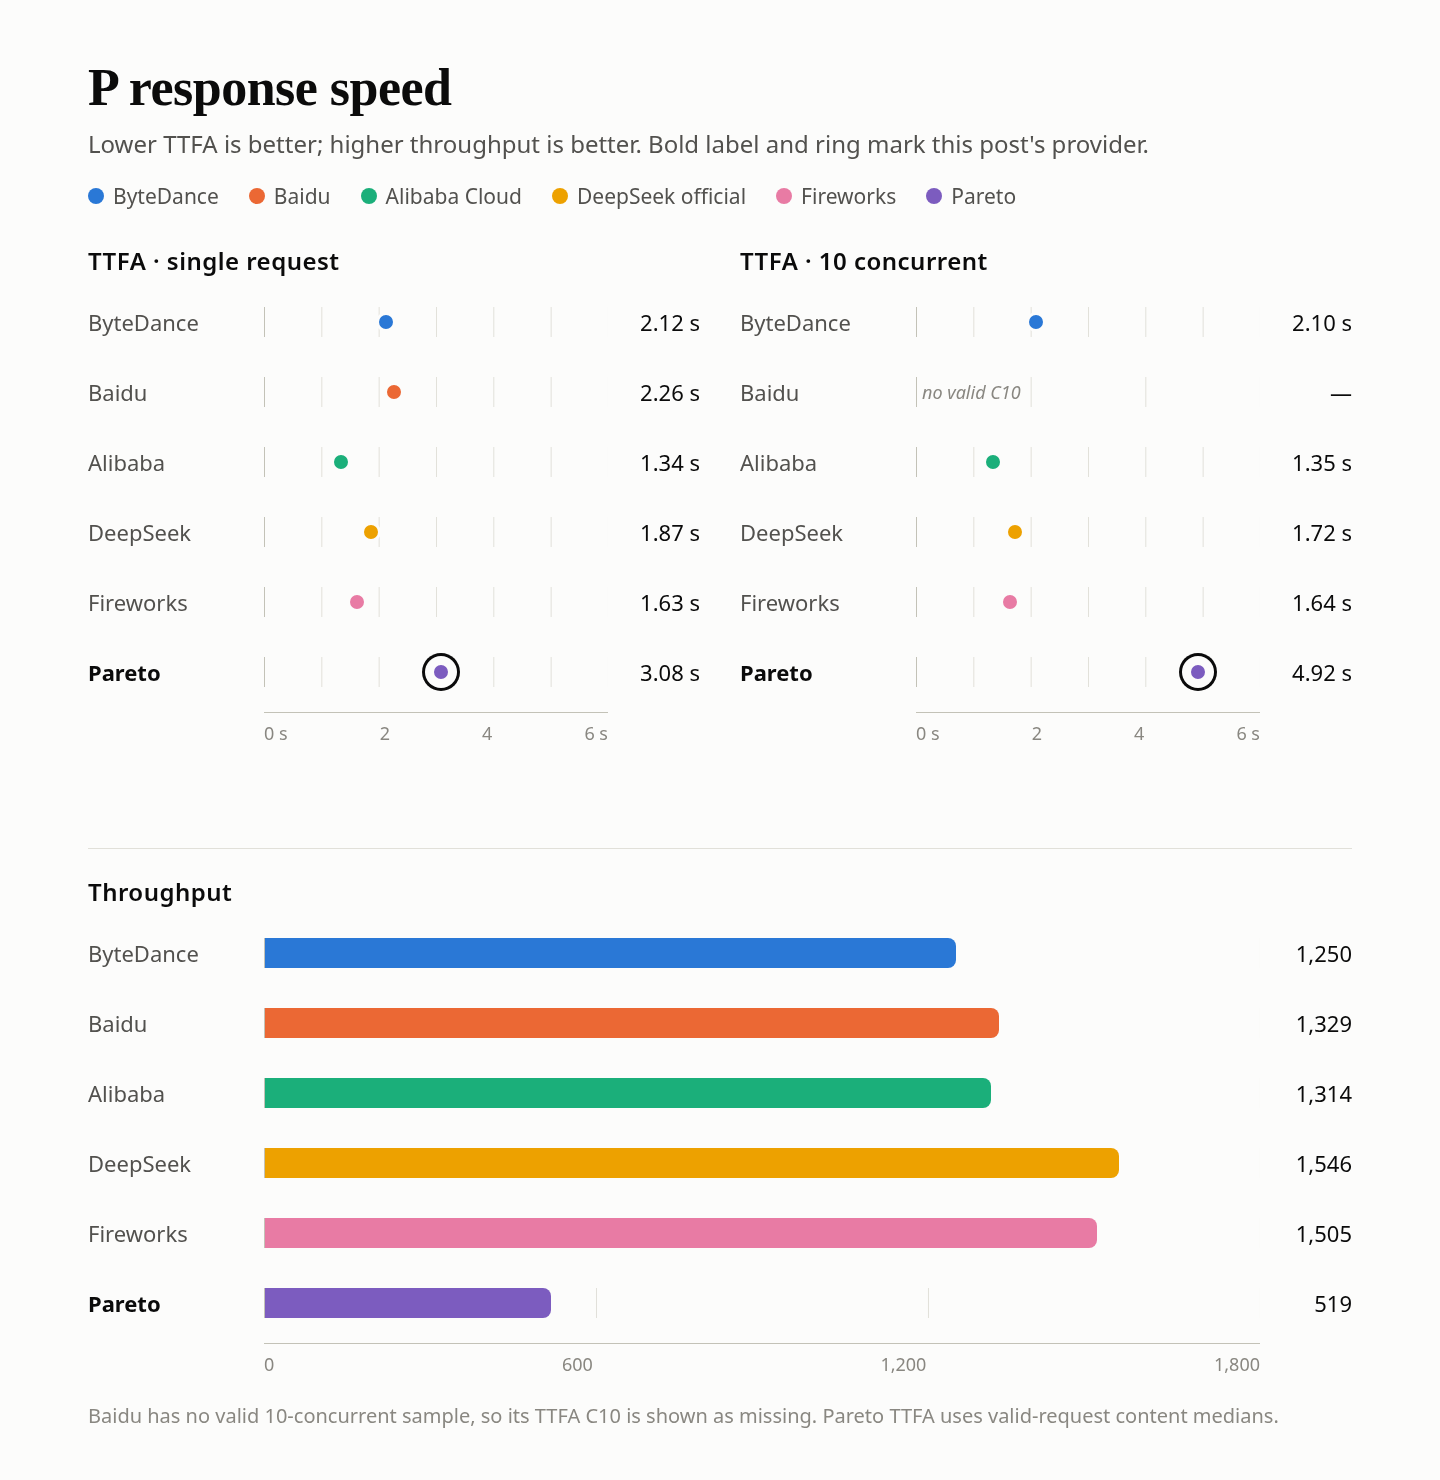
- P — reactiesnelheid: 57.69. Responsscore 65.22, met cache-K voor 20%. Mediane TTFA voor geldige verzoeken: 3.08 s bij 1 gelijktijdig verzoek en 4.92 s bij 10 gelijktijdige verzoeken; medianen voor de score, inclusief ongeldige verzoeken, zijn 5.85 s en 6.13 s. 110 van de 180 probes waren geldig; 70 waren ongeldig omdat het denkproces het uitvoerbudget van de snelheidstest opslokte.
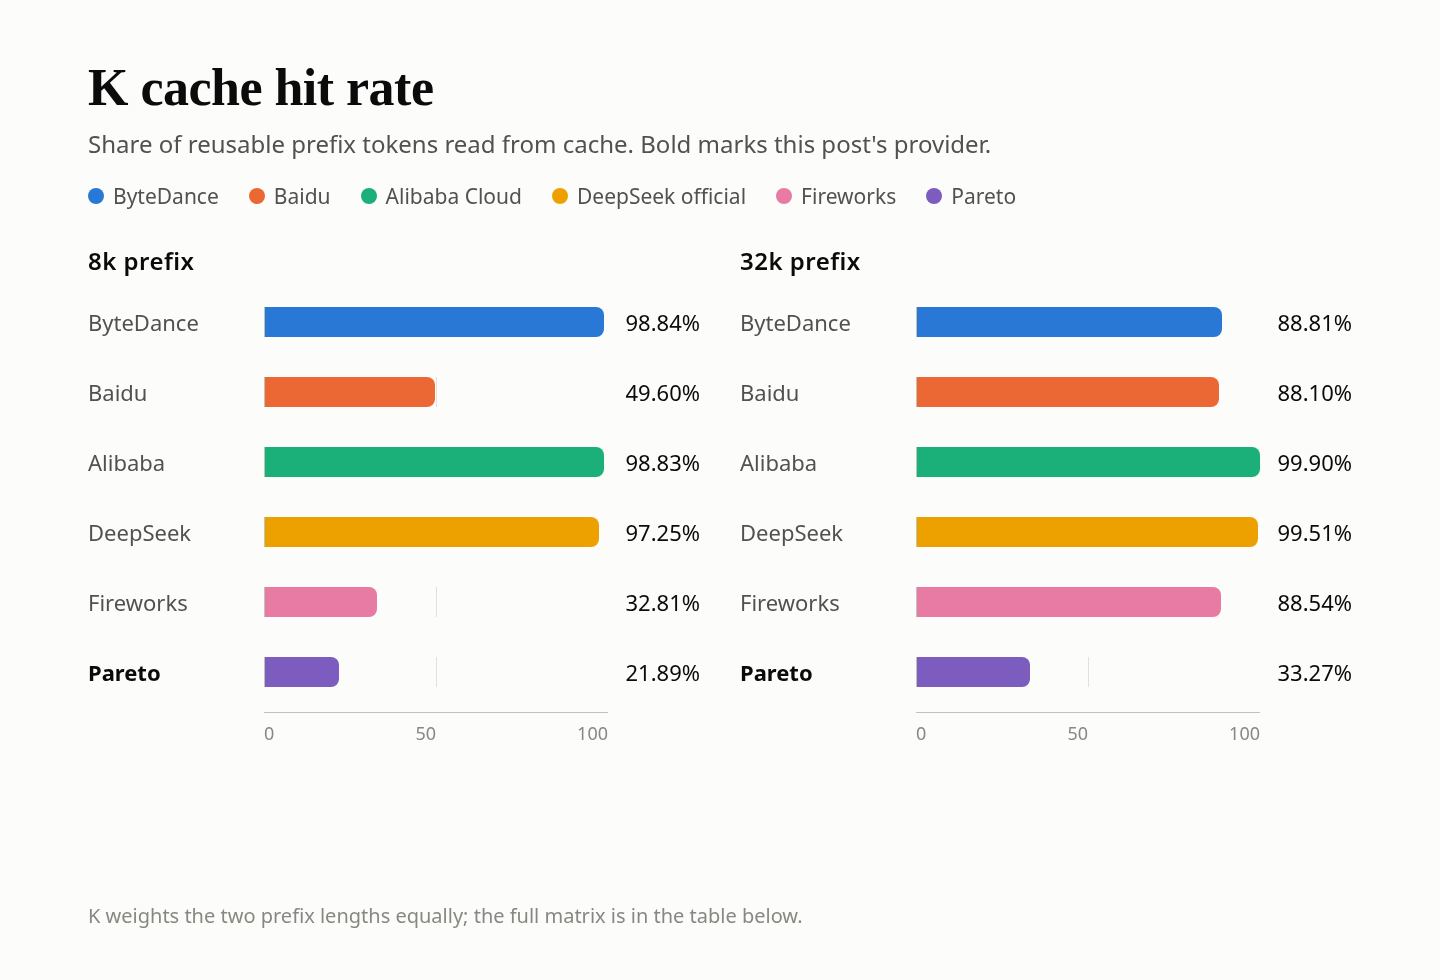
- K — cache: 27.58. 8k hot 2/9 (gelezen 15,872 / herbruikbaar 72,504); 32k hot 3/9 (gelezen 96,000 / herbruikbaar 288,513). Gescoord met de standaardconfiguratie.
- R — servicebetrouwbaarheid: 100. 300/300 speciale verzoeken slaagden bij de eerste poging.
Testopstelling
| Item | Instelling |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagd model-ID | deepseek/deepseek-v4.1-flash |
| Toegangsroute | Pareto, met het bovenstaande model-ID |
| Parameters | temperature 1.0, max_tokens 16,384, timeout 300 s; alleen streamingverzoeken |
| Denkproces | Denkproces met hoge intensiteit ingeschakeld |
| Tijd | 2026-11-05/06 UTC+8; de cache is opnieuw getest op 2026-11-06 met de standaardconfiguratie |
| Steekproeven | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Opmerkingen | In deze test stond het denkproces op hoge intensiteit; de andere vijf aanbieders in de reeks gebruikten dit niet. Functieondersteuning is gescoord op de subset waarvoor streaming beschikbaar was; voor de cache is de standaardconfiguratie gebruikt. |
Bij de verzoeken is de AIHubMix snelstartgids gebruikt; model-ID's staan op de modellenpagina.
Q — antwoordkwaliteit: 48.40
De suite bestond uit 500 BFCL-vragen × 3 rondes, 250 HLE × 10 en 25 AA-LCR × 10. BFCL is automatisch beoordeeld; HLE en AA-LCR zijn beoordeeld door deepseek-flash. De drie taakgroepen gebruiken dezelfde items als bij de andere aanbieders. Tien niet te scoren antwoorden zijn verwijderd, zodat er 4,240 beoordeelde gevallen overbleven.
| Taak | Vragen | Correct | Nauwkeurigheid | Fouten |
|---|---|---|---|---|
| BFCL-tool-aanroepen | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE moeilijke QA | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR-redenering over lange documenten | 25 × 10 | 198/250 | 79.20% | 0 |
| Totaal · 95%-BI 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Fouten blijven als onjuist in de noemer: 996 HLE-antwoorden werden afgekapt toen het denkproces het uitvoerlengtebudget opslokte. Van de 1,494 HLE-pogingen die een volledig antwoord opleverden, waren er 578 correct (ongeveer 38.7%).
| BFCL-categorie | Geslaagd | Slagingspercentage |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python slaagde voor 333/360 (92.50%), multiple voor 269/300 (89.67%), ahm_multi_turn voor 102/150 (68.00%) en irrelevance voor 104/150 (69.33%).
Vergeleken met de andere vijf
Verschil in procentpunten ten opzichte van het officiële kanaal; het interval van 95% wordt weergegeven als whiskers. Als het interval 0 kruist, zijn de resultaten niet van elkaar te onderscheiden. De beoordelaar deepseek-flash behoort tot dezelfde familie en is niet gekalibreerd, dus kan soepel beoordelen.
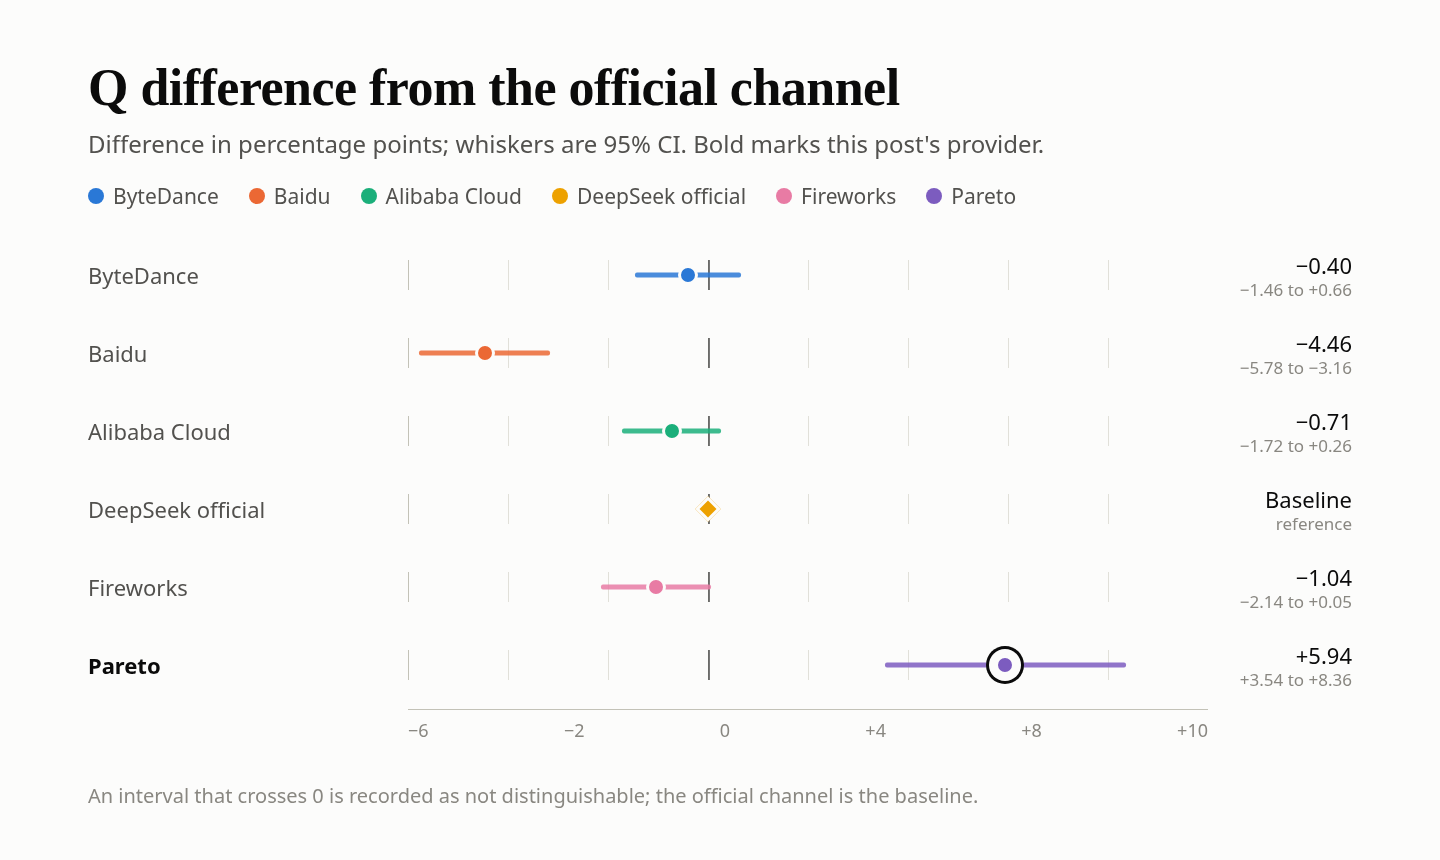
Ten opzichte van het officiële kanaal is het numerieke verschil +5.94 (+3.54 tot +8.36).
F — functieondersteuning: 93.42
Van de 33 meegetelde controles slaagden er 29; 147 zijn niet meegeteld. De score 93.42 herberekent de oorspronkelijke groepsgewichten en normaliseert ze over de waargenomen groepen (streaming 20%, fouten 15%, metering 10%; totaal 45%). Het eenvoudige slagingspercentage van 29/33 is 87.88%. Tools, beperkingen en context zijn helemaal niet meegeteld.
| Casusgroep | Gewicht | Geslaagd | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming en berichten | 20% | 23/27 | 3 | 85.19 |
| Toolinterface | 20% | — | 30 | — |
| Uitvoerbeperkingen | 20% | — | 30 | — |
| Context en status | 15% | — | 30 | — |
| Fouten en herstel | 15% | 3/3 | 27 | 100.00 |
| Metering en cache | 10% | 3/3 | 27 | 100.00 |
| Waargenomen / gewogen | — | 29/33 | 147 | 93.42 |
‘Vensters mislukt’ telt de drie vensters waarin de casus niet slaagde.
| Mislukte casus | Mislukte vensters | Reden |
|---|---|---|
| Streaming-stop | 3/3 | Lege body bij stop |
| Streaming-tekst | 1/3 | Extra punt aan het einde van de body ten opzichte van de fixture |
Vergeleken met de andere vijf
P — reactiesnelheid: 57.69
Voor de score wordt de tijd tot het eerste inhoudstoken gebruikt, niet de tijd tot het eerste token van welke aard dan ook. Met ingeschakeld denkproces genereert het model eerst denkinhoud en daarna pas zichtbare antwoordtekst, waardoor het langer duurt voordat er inhoud verschijnt dan voordat het eerste pakket binnenkomt. In elk van de drie vensters zijn 30 verzoeken verstuurd met één gelijktijdig verzoek en 30 met 10 gelijktijdige verzoeken, in totaal 180.
| Maatstaf | Resultaat |
|---|---|
| TTFA van inhoud | Medianen voor de score: 5.85 s (c=1) en 6.13 s (c=10); medianen voor geldige verzoeken: 3.08 s en 4.92 s |
| Eerste token van welke aard dan ook | Medianen voor geldige verzoeken: 1.46 s en 1.76 s |
| TPOT | Langzamere scoreband 4.87 ms/token |
| Goodput | 519 token/s bij gelijktijdigheid 10 |
| Geldig | 53/90 bij c=1 en 57/90 bij c=10, in totaal 110/180; 70 ongeldig omdat het denkproces het uitvoerbudget van de snelheidstest (~2,048 tokens) opslokte |
| Componenten | TTFA 24.59, TPOT 100.00, goodput 72.05; responsscore 65.22 |
| Samenstelling van P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Tokens voor het denkproces tellen niet mee in de teller van goodput.
K — cache: 27.58
Geaggregeerde leesgegevens van de hertest op 2026-11-06 met de standaardconfiguratie. Cachematrices per verzoek zijn niet opgenomen (onbewerkte traces zijn niet gemigreerd). K geeft beide prefixlengtes hetzelfde gewicht; K is 20% van P.
| Prefix | Hot-hits | Gelezen / herbruikbaar | Segment |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (gelijk gewicht) | 27.58 |
Alle koude controles slaagden: 6/6 bij elke lengte.
R — servicebetrouwbaarheid: 100
300 verzoeken omvatten korte tekst, lange invoer, tool-aanroepen en meerturnsgeschiedenis bij één gelijktijdig verzoek. Alleen de geldigheid en volledigheid van het eerste antwoord zijn gecontroleerd; antwoorden zijn niet beoordeeld en er is niets opnieuw geprobeerd. Fouten in Q en P worden hier niet opnieuw geteld.
| Type verzoek | Geslaagd bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Meerturnsgeschiedenis | 30/30 |
| Totaal · 95%-BI 98.78%–100% | 300/300 |
Veelgestelde vragen
Wat omvat Q 48.40?
BFCL, HLE en AA-LCR over 4,240 beoordeelde gevallen: 2,052 correct, 48.40%, 95%-BI 45.39%–51.26%. Ten opzichte van het officiële kanaal is het numerieke verschil +5.94 (+3.54 tot +8.36).
Waarom waren er 996 HLE-servicefouten?
De meeste antwoorden werden afgekapt omdat het denkproces het uitvoerlengtebudget opslokte; ze blijven als onjuist in de noemer.
Waarom is F 93.42 terwijl 147 controles zijn uitgesloten?
Alleen de subset waarvoor streaming beschikbaar was, telt mee. De groepsgewichten zijn opnieuw genormaliseerd over de waargenomen groepen; tools, beperkingen en context zijn helemaal niet meegeteld.
Waarom mislukten de stopgevallen?
Verzoeken met een stopreeks leverden in alle drie de vensters een lege body op.
Waarom waren 70 van de 180 snelheidsprobes ongeldig?
Het denkproces verbruikte het uitvoerbudget van de snelheidstest (ongeveer 2,048 tokens).
Wat omvat R 100?
300 speciale verzoeken, allemaal geldig bij de eerste poging; de ondergrens van het 95%-interval is 98.78%. Fouten in Q en P tellen niet mee in R.
Lees verder: de DeepSeek V4.1 Flash-reeks
- ByteDance rapporteerde denktokens nadat het denkproces was uitgeschakeld: DeepSeek V4.1 Flash op ByteDance: tool-aanroepen kloppen, metering niet
- Baidu noteerde Q 38.00 en P 37.77: DeepSeek V4.1 Flash op Baidu: geen beschikbaar kanaal haalt Q en P
- Alibaba Cloud noteerde een eerste token na 1.34 s en een cache-score van 99.37: DeepSeek V4.1 Flash op Alibaba Cloud: eerste token na 1.34s, cache 99.37
- Het officiële kanaal is de Q-basislijn, met F 94.00: DeepSeek V4.1 Flash op het officiële kanaal: 94.00 F, 15 ongeldige probes
- Fireworks leverde lege stop-antwoorden op en had 3/9 cache-hits bij 8k: DeepSeek V4.1 Flash op Fireworks: lege stop-antwoorden, 3/9 cache-hits


