

Op 2026-11-03/04 werd de volledige APB-suite uitgevoerd met DeepSeek V4.1 Flash 1017 bij vijf aanbieders via AIHubMix. Voor elke aanbieder werden hetzelfde model, dezelfde vragen en parameters en dezelfde aanvraagscripts gebruikt; het model staat vermeld op de AIHubMix-modelpagina en de vijf aanbiedersvermeldingen staan op de modellenpagina. Dit APB-profiel gaat alleen over Alibaba Cloud: wat elke sectie heeft gemeten en wat daaruit kwam.
Dit bericht rapporteert scores zonder aanbieders te rangschikken of een aanbieder aan te bevelen. Q, F, P, K en R komen eerst; K is een deelscore van P. De totaalscore is een samenvattende index, geen certificering, en heeft geen betrouwbaarheidsinterval. De scoreregels zijn vastgelegd in AIHubMix Provider Benchmark Standard v2.0.
Scores bij vijf aanbieders
Vetgedrukt geeft de aanbieder van dit bericht aan. Aanbieders staan in een vaste volgorde, niet in een rangschikking. K is een deelscore van P met een gewicht van 20% en wordt ter referentie afzonderlijk weergegeven. De totaalscore is een samenvattende index zonder betrouwbaarheidsinterval. DeepSeek via het officiële kanaal en Alibaba Cloud verschillen 0.37 punten in totaalscore en zijn niet van elkaar te onderscheiden.
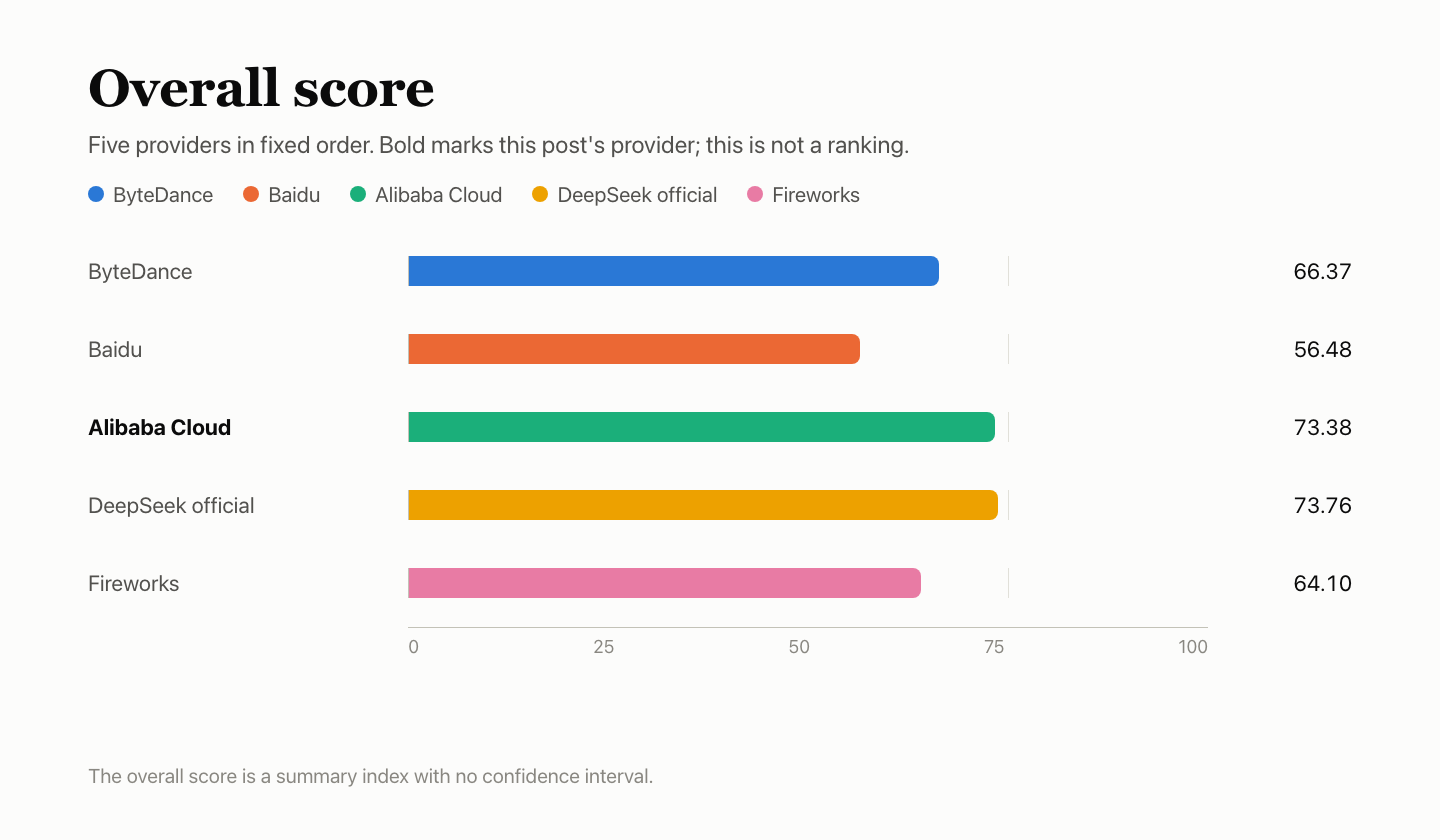
In één oogopslag
- Antwoordkwaliteit: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Ten opzichte van het officiële kanaal bedraagt het verschil −0.71 procentpunt, met een interval van 95% van −1.72 tot +0.26; de twee zijn dus niet van elkaar te onderscheiden.
- Functieondersteuning: F 89.78. 155 van de 177 controles in de noemer zijn geslaagd. Een ongeldig toolschema gaf 503 terug in plaats van een parameterfout, een contextoverschrijding gaf niet het gedocumenteerde fouttype terug en een geïsoleerd toolresultaat gaf 200 terug.
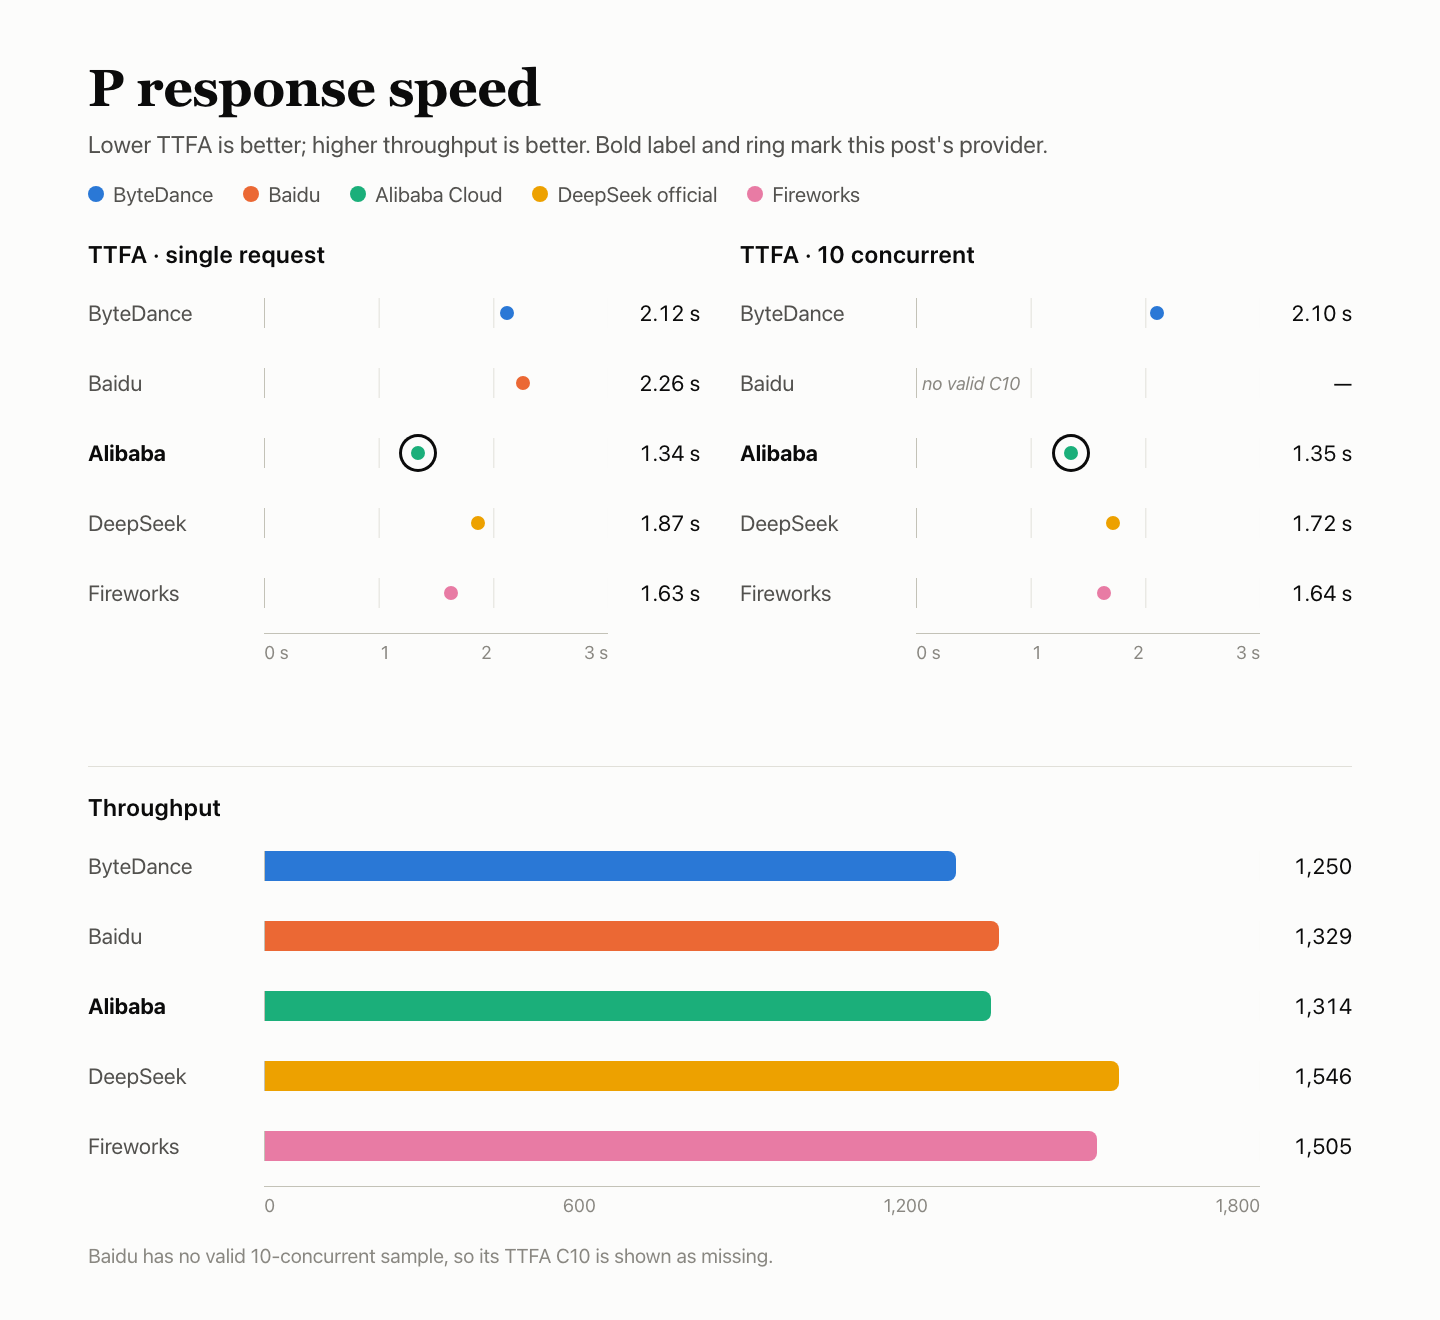
- Responssnelheid: P 88.58. De mediaan voor de eerste inhoudstoken was 1.34 s bij één gelijktijdige aanvraag en 1.35 s bij 10 gelijktijdige aanvragen, TPOT was 4.69 ms en alle 180 snelheidsaanvragen waren geldig.
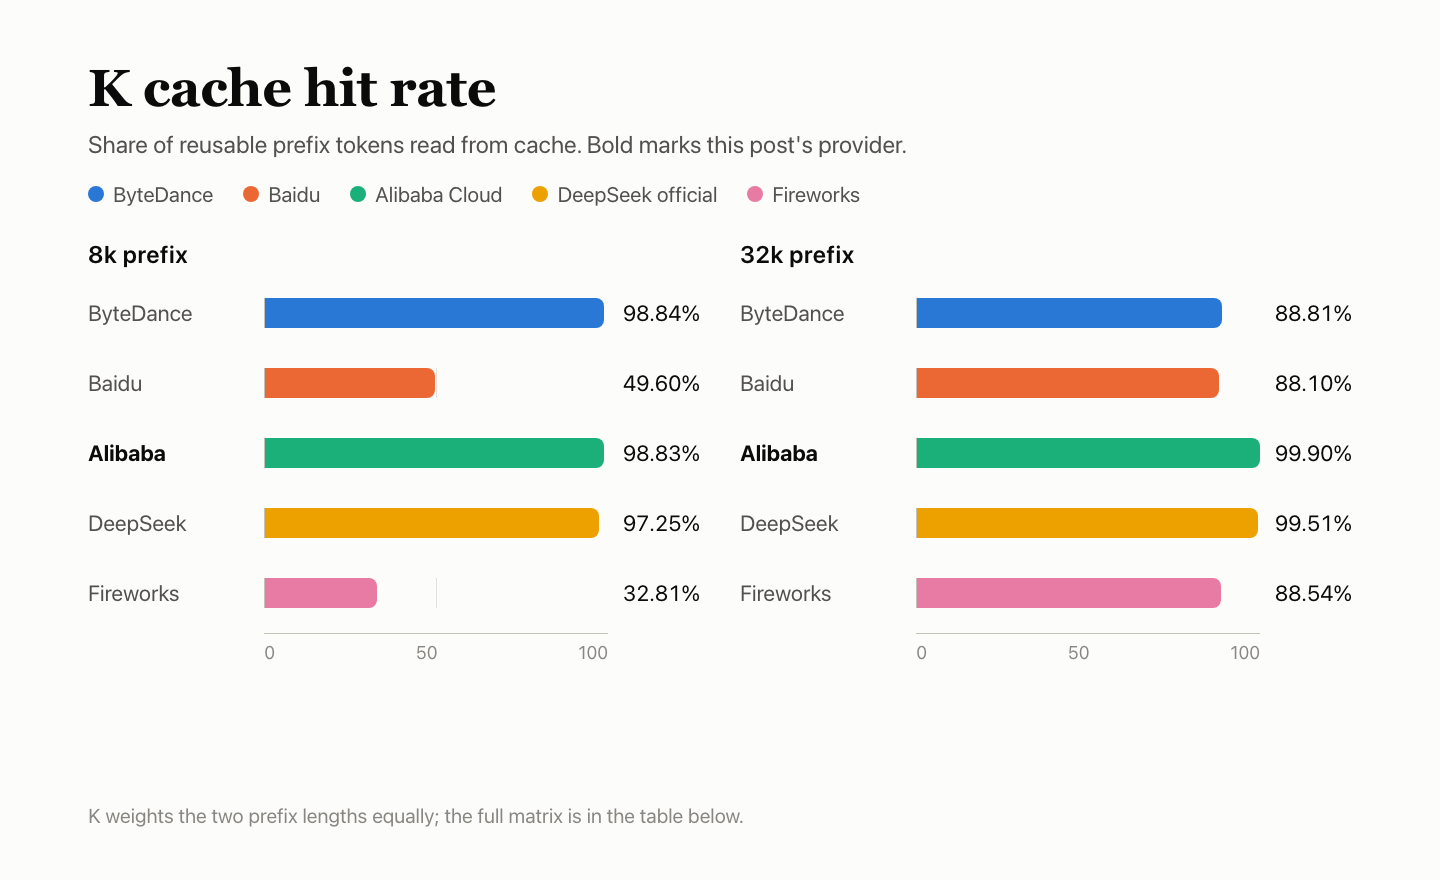
- Cache: K 99.37. Alle 18 warme aanvragen met de prefixes van 8k en 32k raakten de cache, en geen enkele koude controleaanvraag las uit de cache.
- Servicebetrouwbaarheid: R 100. Alle 300 afzonderlijke aanvragen slaagden bij de eerste poging.
Testopstelling
De test verliep via AIHubMix door de model-ID van de aanbieder te selecteren; de snelstartgids beschrijft de route. Op DeepSeeks prijspagina staan de gepubliceerde tarieven van het model.
| Onderdeel | Details |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagde model-ID | alicloud-deepseek-v4.1-flash-1017 |
| Teruggegeven modelnaam | deepseek-v4.1-flash-1017 |
| Toegangsroute | Via AIHubMix door de model-ID van de aanbieder te selecteren, niet door verbinding te maken met het eigen account van de aanbieder |
| Parameters | Niet-denkmodus, temperature 1.0, max_tokens 16,384, time-out 300 s, geen automatische nieuwe pogingen |
| Denken uitgeschakeld | Alle aanvragen gebruikten reasoning_effort=none |
| Tijd | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Vijf aanbieders gebruikten dezelfde Mac mini, hetzelfde netwerk en hetzelfde account. |
| Steekproeven | Antwoordkwaliteit: 4,250 vraaguitvoeringen (BFCL 500 × 3 rondes, HLE 250 × 10, AA-LCR 25 × 10); functiegevallen: 60 × 3 vensters; snelheid: 90 bij één gelijktijdige aanvraag en 90 bij 10 gelijktijdige aanvragen; betrouwbaarheid: 300; cache: 30 (prefixes van 8k en 32k, elk 3 groepen) |
Q — antwoordkwaliteit: 41.75
Voor de antwoordkwaliteit zijn drie vragensets gebruikt: 500 BFCL-vragen met elk 3 rondes, 250 HLE-vragen met elk 10 rondes en 25 AA-LCR-vragen met elk 10 rondes. BFCL is beoordeeld aan de hand van automatische regels; HLE en AA-LCR zijn beoordeeld door het beoordelaarsmodel deepseek-flash. Alle vijf aanbieders kregen dezelfde vragen en de drie sets zijn samengevoegd tot één nauwkeurigheidsscore. Tien antwoorden zijn verwijderd omdat de vragen niet konden worden beoordeeld; er bleven 4,240 beoordeelde vraaguitvoeringen over.
| Taak | Vragen | Correct | Nauwkeurigheid | Mislukkingen |
|---|---|---|---|---|
| BFCL-tool-aanroepen | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| HLE-moeilijke QA | 250 × 10 | 331/2,490 | 13.29% | 8 |
| AA-LCR-redeneren over lange documenten | 25 × 10 | 134/250 | 53.60% | 0 |
| Gecombineerd · interval van 95%: 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Servicemislukkingen (mislukte aanvragen of afgebroken uitvoer) blijven in de noemer en tellen als onjuist; ze worden niet verwijderd. Bij Alibaba Cloud bereikte de HLE-uitvoer 8 keer de max_tokens-limiet en werd deze afgebroken.
Voor elke BFCL-vraag zijn er 3 rondes; de tabel toont de 3 rondes samen.
| BFCL-categorie | Geslaagd | Slagingspercentage |
|---|---|---|
| simple_python: één functie, juiste aanroep en argumenten | 332/360 | 92.22% |
| multiple: de juiste functie kiezen uit meerdere opties | 270/300 | 90.00% |
| parallel: dezelfde functie meerdere keren parallel aanroepen | 273/300 | 91.00% |
| parallel_multiple: meerdere verschillende functies parallel aanroepen | 212/240 | 88.33% |
| irrelevance: geen functie is relevant, er mag niets worden aangeroepen | 113/150 | 75.33% |
| ahm_multi_turn: toolketen in drie stappen | 105/150 | 70.00% |
Vergeleken met de andere vier
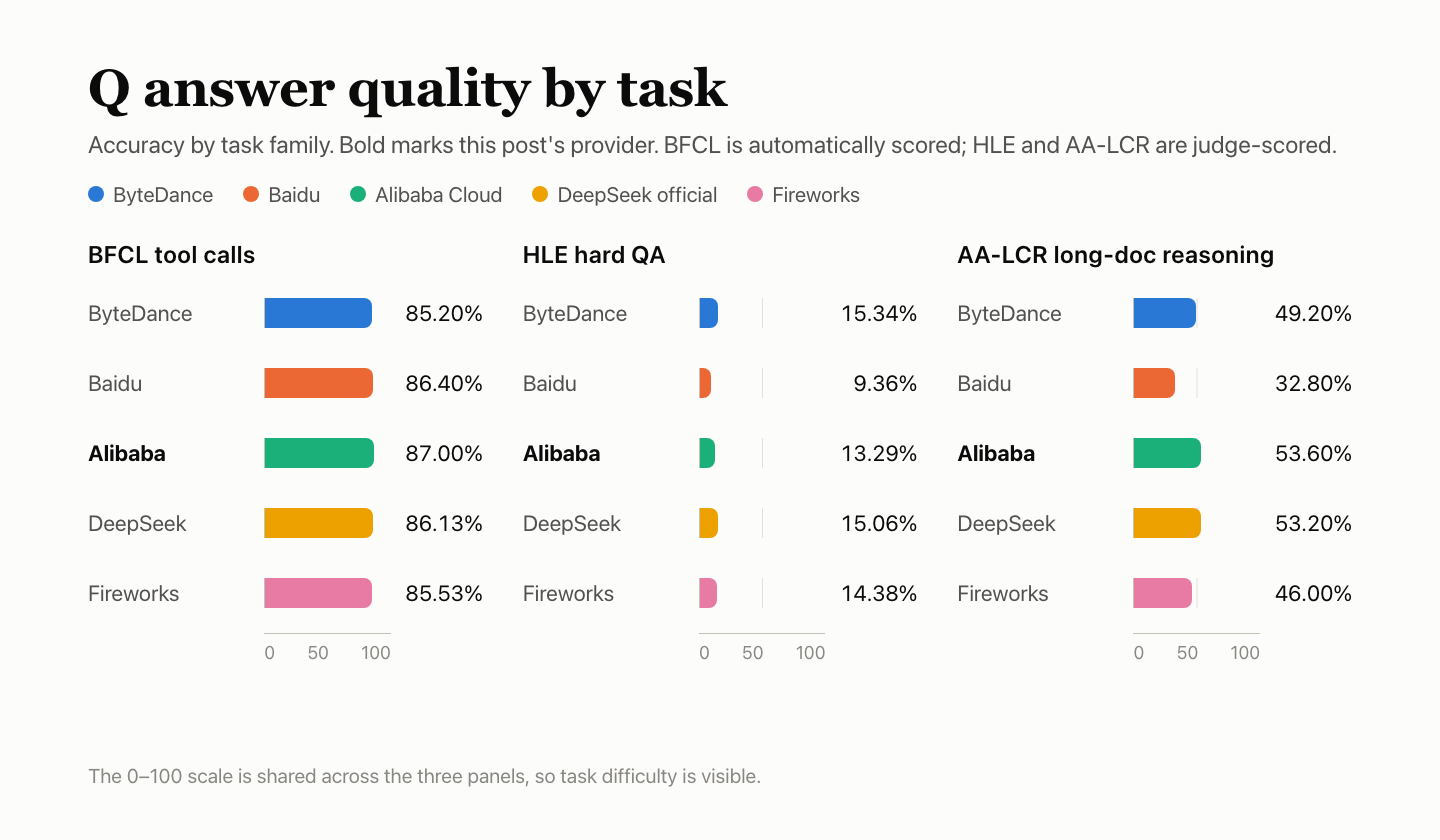
Ten opzichte van het officiële kanaal: het verschil in nauwkeurigheid in procentpunten, met het interval van 95% weergegeven als foutbalken; als een interval 0 omvat, geldt er geen onderscheid. De beoordelaar deepseek-flash voor HLE en AA-LCR behoort tot dezelfde DeepSeek-familie als het geteste model en is niet gekalibreerd, waardoor de beoordeling mogelijk mild uitvalt.
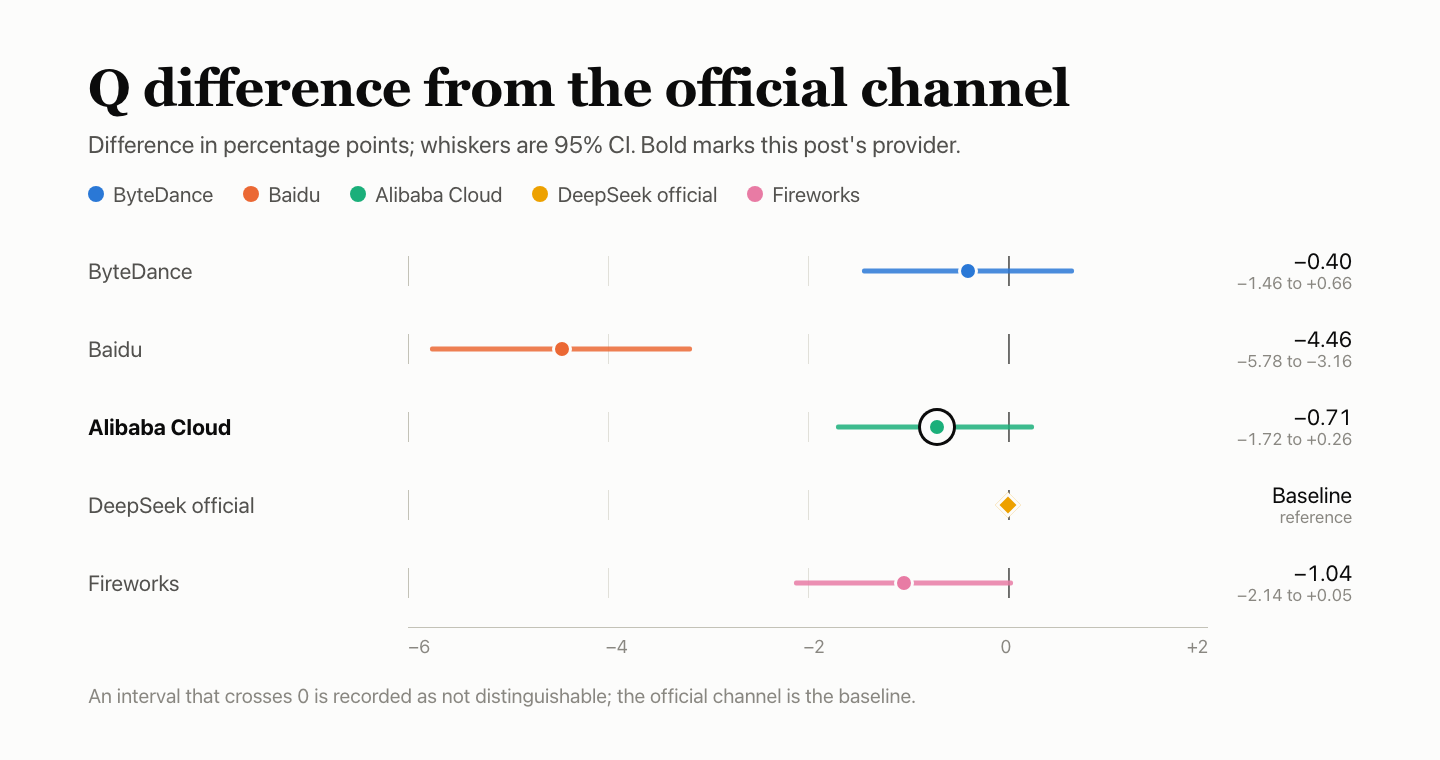
F — functieondersteuning: 89.78
Functiegevallen controleren of het gedrag van de interface het protocol volgt, niet of het model goed antwoordt. De 60 gevallen zijn verdeeld over zes groepen en worden elk in drie vensters uitgevoerd, goed voor 180 controles, beoordeeld aan de hand van het formaat dat elke aanbieder documenteert. Controles die niet van toepassing, ongeldig of niet waargenomen zijn, worden uitgesloten van de noemer. Alibaba Cloud slaagde voor 155 van de 177 controles in de noemer; met de groepsgewichten komt de score uit op 89.78.
De gewogen score wordt berekend aan de hand van groepsgewichten, niet als een eenvoudige telling van geslaagde controles op een totaal van 177.
| Groep | Gewicht | Geslaagd | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming- en berichtprotocol | 20% | 30/30 | — | 100.00 |
| Toolinterface | 20% | 30/30 | — | 100.00 |
| Uitvoerbeperkingen en parameters | 20% | 30/30 | — | 100.00 |
| Context en status | 15% | 26/30 | — | 86.67 |
| Fouten en herstel | 15% | 18/30 | — | 60.00 |
| Protocol voor meting en cache | 10% | 21/27 | 3 | 77.78 |
| Totaal · gewogen score | — | 155/177 | 3 | 89.78 |
Een venstertelling van 3/3 betekent dat het geval in alle drie de vensters is mislukt.
| Mislukt geval | Vensters mislukt | Reden |
|---|---|---|
| Contextoverschrijding (context en status) | 3/3 | Er werd een fout teruggegeven, maar niet de gedocumenteerde fout voor de contextlengte |
| Fout in het formaat van messages (fouten en herstel) | 3/3 | 400 teruggegeven met een lege antwoordtekst; geen gestructureerde foutbeschrijving |
| Ongeldig toolschema (fouten en herstel) | 3/3 | Had een parameterfout moeten teruggeven; gaf 503 terug |
| Geïsoleerd toolresultaat (fouten en herstel) | 3/3 | Had een parameterfout moeten teruggeven; gaf 200 terug |
| Fout in het formaat van stream_options (fouten en herstel) | 3/3 | 400 teruggegeven met een lege antwoordtekst; geen gestructureerde foutbeschrijving |
| Meting van redeneringstokens (protocol voor meting en cache) | 3/3 | Er werd geen aantal redeneringstokens teruggegeven |
| Tooldefinities meegeteld als invoer (protocol voor meting en cache) | 3/3 | Met tooldefinities was het gerapporteerde aantal invoertokens niet hoger dan zonder tooldefinities |
| Isolatie van aanvragen (context en status) | 1/3 | De eerste stap antwoordde niet alleen met STORED, zoals vereist, waardoor de isolatiecontrole niet kon doorgaan |
Deze controles worden uitgesloten van de noemer en tellen noch als geslaagd, noch als mislukt.
| Status | Geval | Aantal | Reden |
|---|---|---|---|
| Niet van toepassing | Expliciete cache_control | 3 | Vooraf geregistreerd als niet ondersteund door deze interface |
De gevallen met een fout in het formaat van messages en stream_options mislukten bij alle vijf aanbieders: elke aanbieder gaf 400 terug met een lege antwoordtekst, waardoor de client geen gestructureerde foutbeschrijving ontving. Omdat alle vijf hetzelfde gedrag vertonen, zit het probleem waarschijnlijker in de AIHubMix-gatewaylaag en moet het afzonderlijk worden onderzocht. De meting van redeneringstokens mislukte ook bij alle vijf, maar om verschillende redenen: ByteDance en Fireworks rapporteerden redeneringstokens terwijl denken was uitgeschakeld, terwijl de andere drie geen aantal redeneringstokens teruggaven.
Vergeleken met de andere vier
P — responssnelheid: 88.58
Elke aanvraag bevatte ongeveer 10,000 invoertokens en vroeg om ongeveer 1,100 uitvoertokens. In drie vensters werden 30 aanvragen verstuurd bij één gelijktijdige aanvraag en 30 bij 10 gelijktijdige aanvragen, 180 in totaal. De wachttijd tot de eerste inhoudstoken (TTFA) wordt per geldige aanvraag gemeten; de tabel geeft de medianen weer. TPOT wordt geschat op basis van de tijdstippen van streamingchunks, niet op basis van hardwaremetingen per token; de doorvoer is het aantal geldige uitvoertokens bij 10 gelijktijdige aanvragen gedeeld door de wandkloktijd van de batch.
| Maatstaf | Resultaat |
|---|---|
| Eerste inhoudstoken TTFA | Mediaan bij één gelijktijdige aanvraag: 1.34 s; mediaan bij 10 gelijktijdige aanvragen: 1.35 s |
| Generatiesnelheid TPOT | Bij één gelijktijdige aanvraag 4.63 ms/token; bij 10 gelijktijdige aanvragen 4.69 ms/token |
| Effectieve doorvoer (goodput) | Bij 10 gelijktijdige aanvragen 1,313.6 token/s |
| Geldige aanvragen | Bij één gelijktijdige aanvraag 90/90, bij 10 gelijktijdige aanvragen 90/90 |
| Deelscores | TTFA 59.65, TPOT 100.00, doorvoer 100.00; voor TTFA en TPOT geldt de laagste van de twee niveaus, met gewichten van 35% / 35% / 30%; responsscore 85.88 |
| P-score | Responsscore 85.88 met een gewicht van 80%, cache K 99.37 met een gewicht van 20%, totaal 88.58 |
Vergeleken met de andere vier
Alle vijf aanbieders gebruikten dezelfde machine, hetzelfde netwerk en hetzelfde account. De drie vensters werden per aanbieder ingepland, dus de meetperioden overlappen niet volledig en kleine verschillen moeten niet te zwaar worden geïnterpreteerd.
K — cache: 99.37
Elke groep bestaat uit vijf aanvragen: de eerste bevat een vaste prefix van ongeveer 8k of 32k tokens en vult de cache; aanvragen 2–4 behouden de prefix en veranderen alleen de vraag aan het einde, na 5, 30 en 120 seconden; de vijfde gebruikt een nieuwe prefix als koude controle. Drie vensters × twee lengtes leveren 30 aanvragen op. K is het aantal gecachete tokens dat bij warme aanvragen wordt gelezen, gedeeld door het aantal tokens dat volgens de regel herbruikbaar zou moeten zijn; beide lengtes wegen even zwaar. K telt voor 20% mee in P. De matrix toont de door de server gerapporteerde aantallen gelezen gecachete tokens.
| Prefix | Venster | Vulling (aanvraag 1) | Warm na 5 s | Warm na 30 s | Warm na 120 s | Koude controle (aanvraag 5) |
|---|---|---|---|---|---|---|
| 8k | Venster 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Venster 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Venster 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Venster 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Venster 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Venster 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Prefix | Cache-hits bij warme aanvragen | Gelezen tokens | Zou herbruikbaar moeten zijn | Score |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k en 32k, elk de helft) | 99.37 |
Alle 9 warme aanvragen met een prefix van 8k raakten de cache en lazen elk 7,936 tokens; alle 9 warme aanvragen met een prefix van 32k raakten de cache en lazen elk 32,000 tokens. De eerste aanvraag en de koude controle lazen niets uit de cache, dus warme en koude aanvragen zijn duidelijk van elkaar te onderscheiden.
Vergeleken met de andere vier
R — servicebetrouwbaarheid: 100
De 300 aanvragen omvatten vier typen — korte tekst, lange invoer van 10k, tool-aanroepen en meerbeurtenhistorie — en zijn bij één gelijktijdige aanvraag in drie vensters verstuurd. Alleen het eerste antwoord is gecontroleerd op geldigheid en volledigheid; de juistheid van antwoorden is niet gecontroleerd en er zijn geen nieuwe pogingen gedaan. Mislukkingen in de secties over antwoordkwaliteit en snelheid tellen respectievelijk mee in Q en P, niet nogmaals in R.
| Aanvraagtype | Geslaagd bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Meerbeurtenhistorie | 30/30 |
| Totaal · interval van 95%: 98.78%–100% | 300/300 |
Alle 300 verzoeken leverden bij de eerste poging een geldig en volledig antwoord op. R 100 heeft alleen betrekking op deze 300 specifieke verzoeken en betekent niet dat er nergens in de hele keten fouten zijn opgetreden. De ondergrens van het 95%-interval is 98.78%: zelfs bij 300/300 is de kans groot dat het foutenpercentage onder 1.22% ligt.
Vergeleken met de vier andere
R heeft alleen betrekking op deze 300 specifieke verzoeken; fouten in antwoordkwaliteit en snelheid worden geregistreerd bij Q en P en niet nogmaals meegeteld bij R.
| Aanbieder | Succes bij eerste poging | 95%-interval |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officieel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Veelgestelde vragen
Is het totale verschil van 0.37 tussen Alibaba Cloud en het officiële kanaal betekenisvol?
Nee. In deze test zijn de twee niet van elkaar te onderscheiden: het verschil in Q is −0.71 procentpunt, met een 95%-interval van −1.72 tot +0.26, dat 0 omvat. De totaalscore is bovendien een samenvattende index zonder betrouwbaarheidsinterval.
Waaruit is de Q-score opgebouwd?
Drie sets: 500 BFCL-vragen × 3 rondes, automatisch beoordeeld; HLE 250 × 10 en AA-LCR 25 × 10, beoordeeld door het beoordelingsmodel deepseek-flash. De gecombineerde nauwkeurigheid bedraagt 41.75% over 4,240 beoordeelde vraag-runs.
Waarom is F 89.78 als 155 van de 177 controles zijn geslaagd?
De score is gewogen per groep en is geen eenvoudige verhouding tussen geslaagd en totaal. Fouten en herstel scoorden 60.00 en metering en cacheprotocol scoorden 77.78, terwijl de drie protocolgroepen 100.00 scoorden.
Waarom rapporteert R 100 als er in andere onderdelen verzoeken zijn mislukt?
R heeft alleen betrekking op de 300 specifieke stabiliteitsverzoeken. Fouten in antwoordkwaliteit en snelheid worden geregistreerd bij Q en P en niet nogmaals meegeteld bij R.
Is K 99.37 een cache-hitpercentage?
Het is de verhouding tussen het aantal gelezen gecachete tokens bij hot-verzoeken en het aantal tokens dat herbruikbaar zou moeten zijn, waarbij 8k en 32k elk voor de helft meetellen. De prefix van 8k scoorde 98.83 en die van 32k scoorde 99.90.
Betekent de eerste token na 1.34 s dat het volledige antwoord binnen 1.34 s binnenkomt?
Nee. Dit is de wachttijd tot de eerste inhoudelijke token. Elk verzoek vroeg om ongeveer 1,100 outputtokens, en de TPOT bij een gelijktijdigheid van 10 was 4.69 ms per token.
Lees verder: de DeepSeek V4.1 Flash-serie
- De gecombineerde Q-score van Alibaba Cloud verschilt 0.71 procentpunt van de officiële baseline, binnen een interval dat 0 omvat; in het ByteDance-profiel wordt dezelfde vergelijking doorgetrokken naar de metering van tool-aanroepen: DeepSeek V4.1 Flash op ByteDance: tool-aanroepen komen overeen, metering niet.
- Alibaba Cloud leverde voor alle 180 snelheidsverzoeken een geldig antwoord; in het Baidu-profiel wordt hetzelfde testharnas gebruikt, waarbij geen beschikbaar kanaal invloed had op Q en P: DeepSeek V4.1 Flash op Baidu: geen beschikbaar kanaal raakt Q en P.
- Het officiële kanaal is de baseline voor de vergelijking van antwoordkwaliteit in dit artikel; het eigen profiel behandelt F 94.00 en 15 ongeldige probes bij één gelijktijdig verzoek: DeepSeek V4.1 Flash op het officiële kanaal: 94.00 F, 15 ongeldige probes.
- Alibaba Cloud haalde 9/9 hot-verzoeken bij beide prefixlengtes; het Fireworks-profiel behandelt lege antwoorden na stop en 3/9 cache-hits bij 8k: DeepSeek V4.1 Flash op Fireworks: lege antwoorden na stop, 3/9 cache-hits.


