

Op 2026-11-03/04 werd DeepSeek V4.1 Flash 1017 uitgevoerd met de APB Full-suite bij vijf aanbieders, allemaal via AIHubMix en met dezelfde vragen, parameters en aanvraagscripts. Dit APB-profiel behandelt alleen Fireworks. Het model staat vermeld als DeepSeek V4.1 Flash 1017.
De scores zijn Q 41.42, F 71.78, P 79.51, K 60.68 en R 100; de totaalscore is 64.10. Dit artikel rapporteert alleen scores, zonder ranglijst of aanbeveling van een aanbieder. Q, F, P, K en R komen eerst; de totaalscore is een samenvattend getal zonder betrouwbaarheidsinterval. De standaard is AIHubMix Provider Benchmark Standard v2.0.
Scores bij vijf aanbieders
Vetgedrukt is de aanbieder die in dit artikel wordt besproken. Vaste volgorde van aanbieders, geen rangschikking. K is een deelscore van P en weegt 20%. De totaalscore is een samenvattend getal zonder betrouwbaarheidsinterval. DeepSeek official channel en Alibaba Cloud verschillen 0.37 en zijn niet van elkaar te onderscheiden.
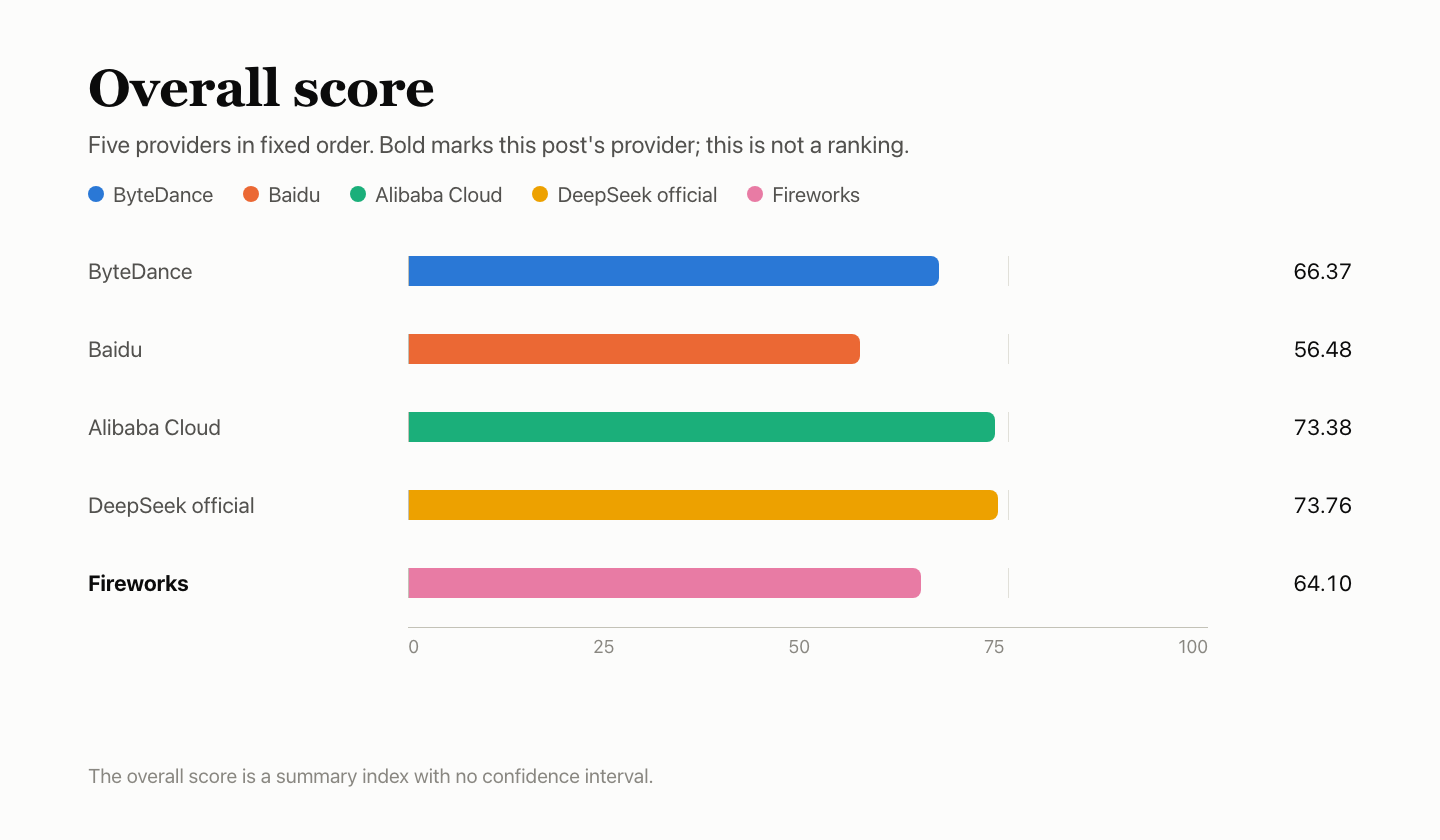
In één oogopslag
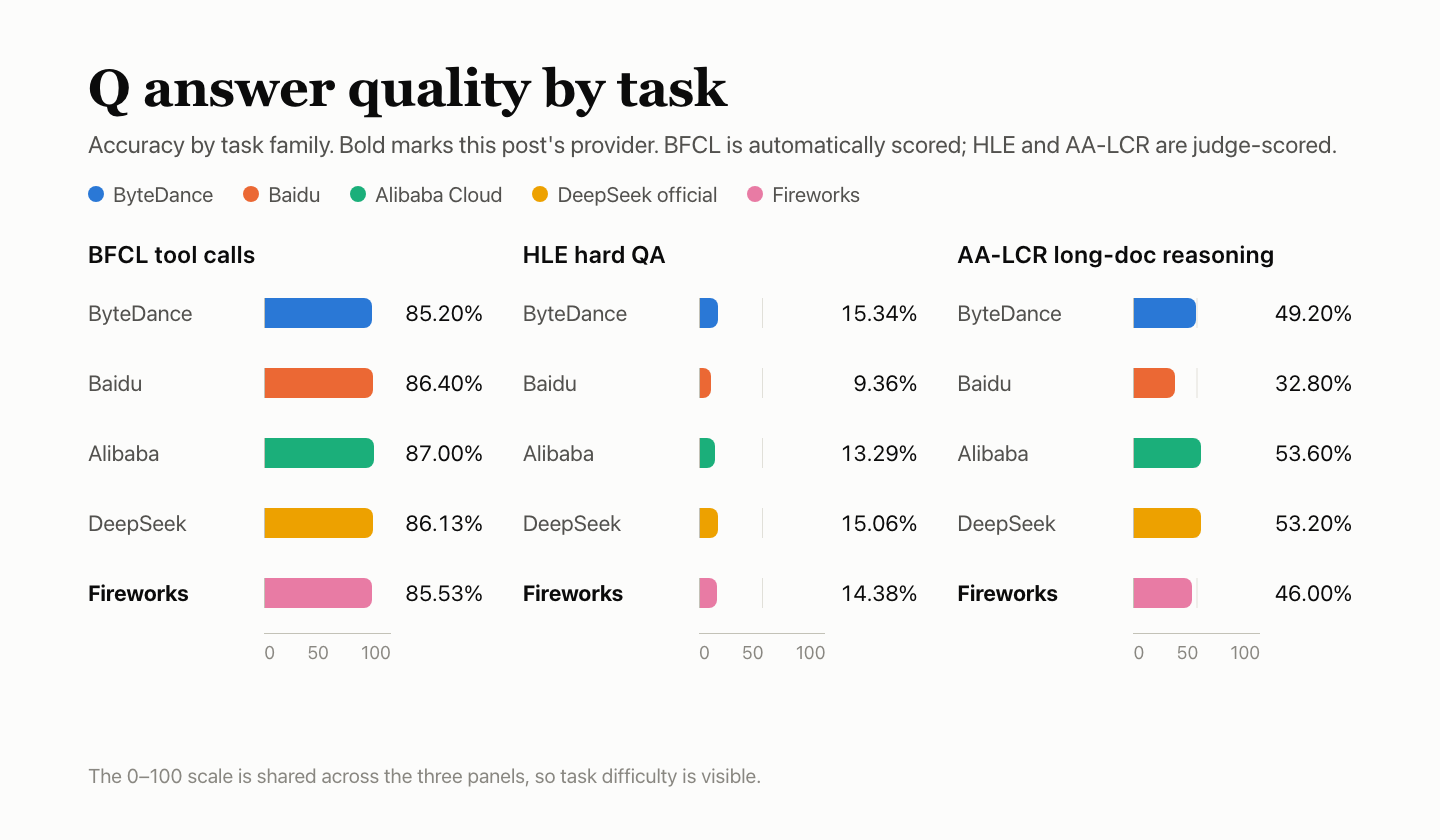
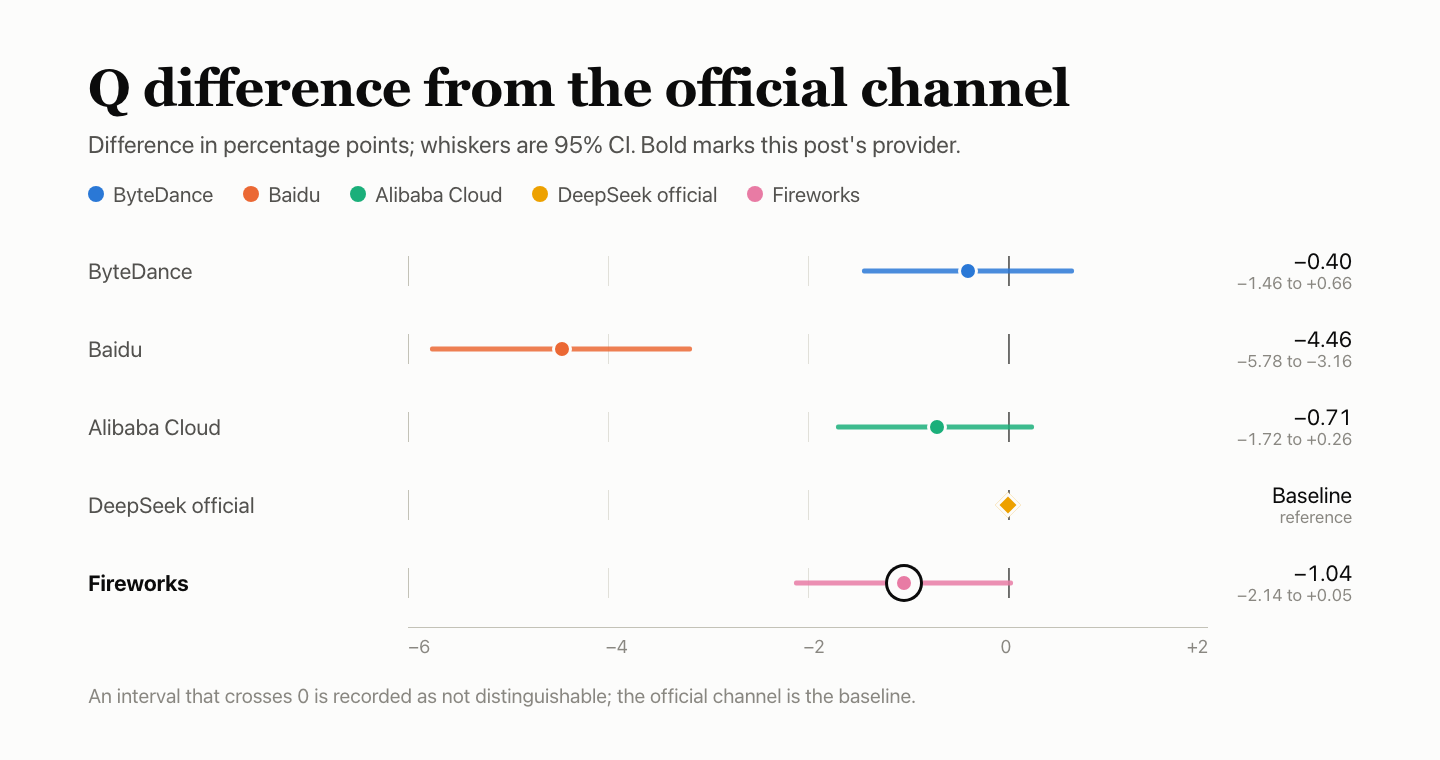
- Q — antwoordkwaliteit: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. Ten opzichte van het officiële kanaal: −1.04 procentpunt, 95%-BI −2.14 tot +0.05, niet te onderscheiden. Alle 34 AA-LCR-fouten vielen in venster 2 en werden als fout gerekend.
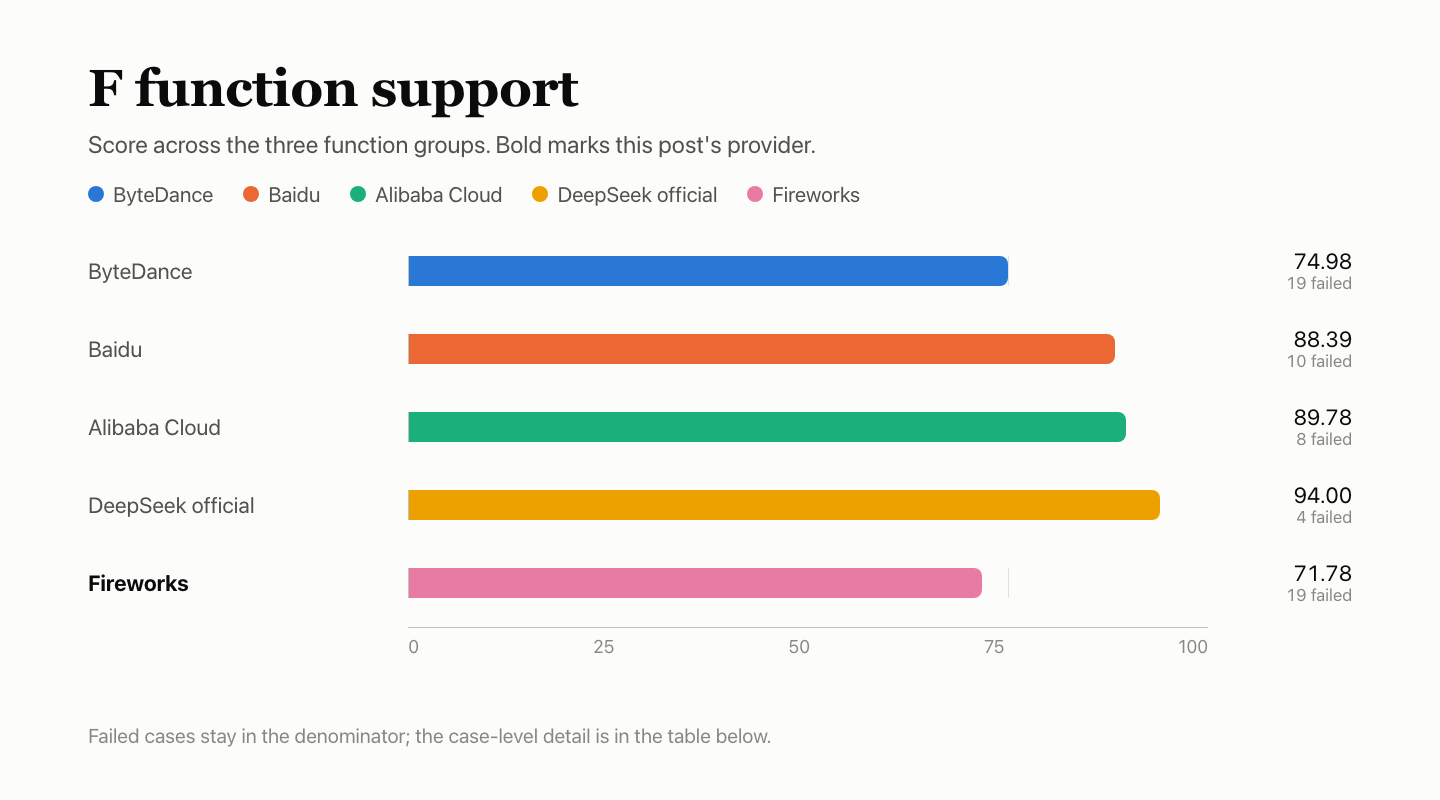
- F — functieondersteuning: 71.78. 122/177 meegetelde controles geslaagd. Beide stopgevallen leverden een lege body op;
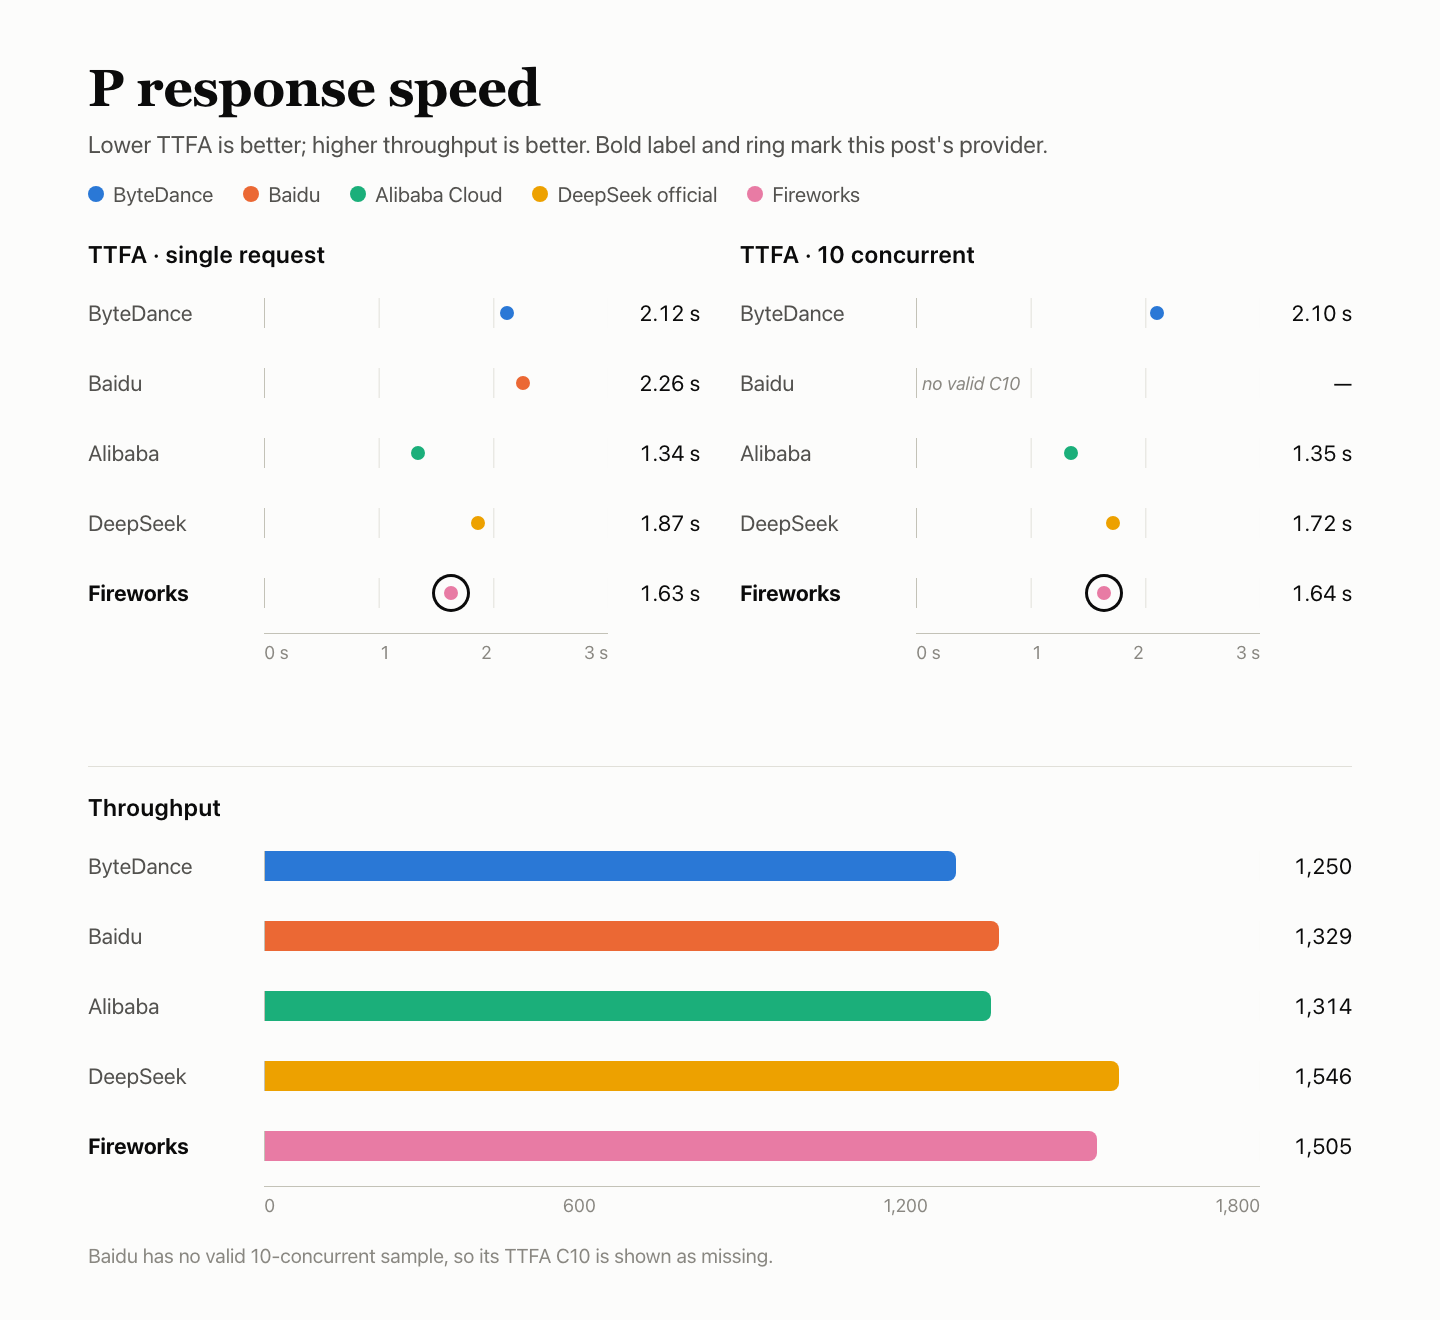
reasoning_effort=noneschakelde het denken niet uit; voor een invoer van 10k werden 10,026 tokens gerapporteerd, tegenover een native telling van 10,000. - P — reactiesnelheid: 79.51. Responsscore 84.22, cache-K telt 20% mee. Mediaan TTFA 1.63 s bij één gelijktijdige aanvraag en 1.64 s bij 10 gelijktijdige aanvragen; TPOT 3.29 ms. 1 van de 180 outputs bestond uit één token en werd als ongeldig gemarkeerd.
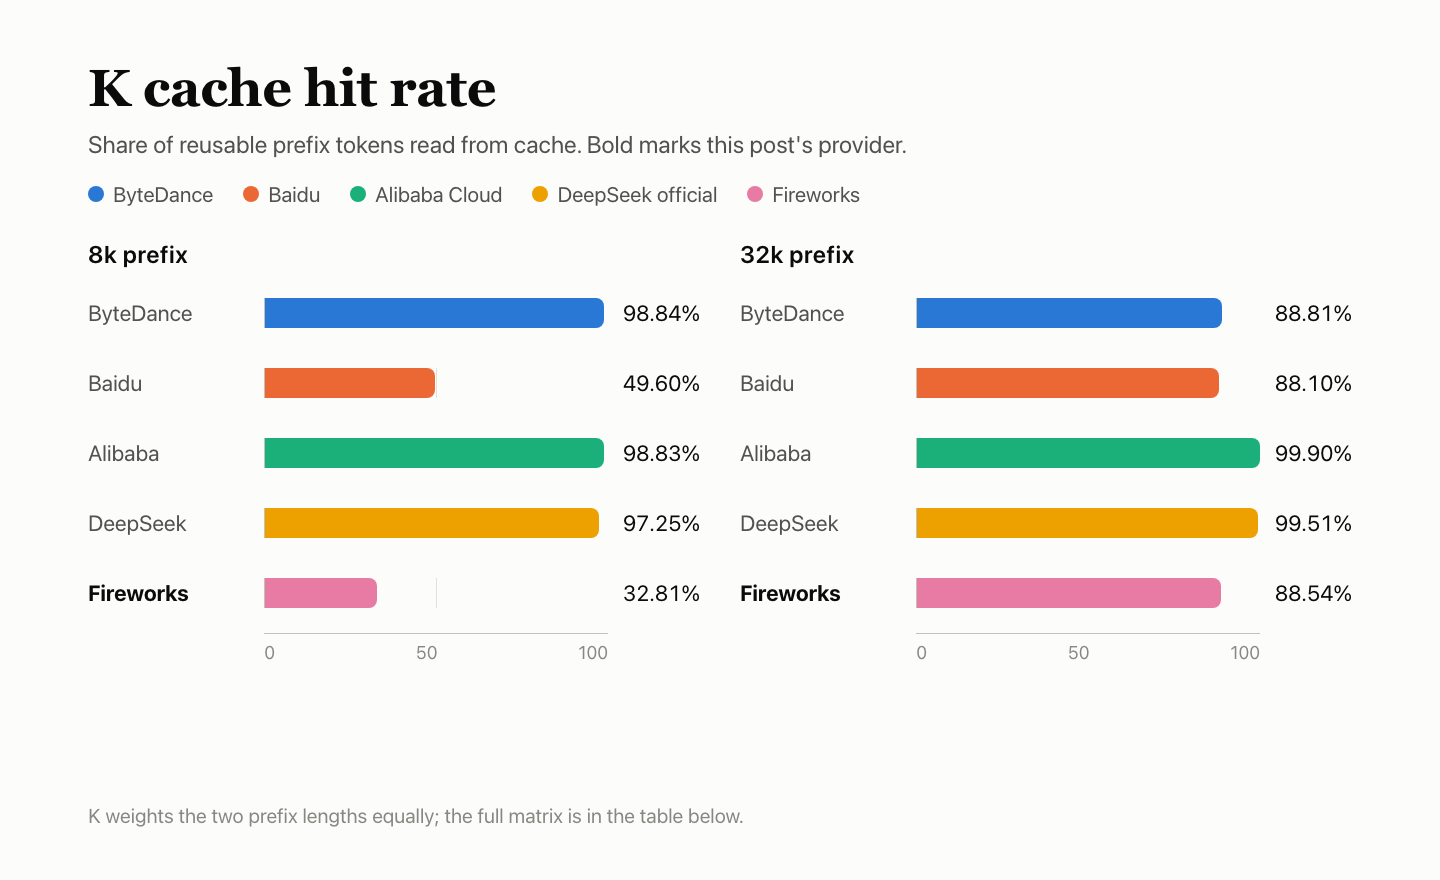
- K — cache: 60.68. Voor de K-probes werd de gedocumenteerde sessieaffiniteit gebruikt. 32k warm 8/9; 8k warm 3/9.
- R — servicebeschikbaarheid: 100. 300/300 speciale aanvragen slaagden bij de eerste poging.
Testopstelling
| Item | Instelling |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagd model-ID | fireworks-deepseek-v4.1-flash-1017 |
| Geretourneerde modelnaam | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Toegangsroute | AIHubMix-model-ID van de aanbieder, niet het eigen account van de aanbieder |
| Parameters | Denken uit, temperatuur 1.0, max_tokens 16,384, time-out 300 s, geen nieuwe poging |
| Denken uit | Native thinking.type=disabled; reasoning_effort=none schakelt het denken niet uit. Voor functiegevallen bleef reasoning_effort=none ingesteld. |
| Tijd | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Eén Mac mini, netwerk en account voor alle vijf. |
| Steekproeven | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Extra instellingen | Voor replica-affiniteit bevatten de K-probes het gedocumenteerde user-veld en de x-session-affinity-header. |
Voor aanvragen werd de quickstart van AIHubMix gebruikt; model-ID's staan op de modellenpagina. Voor denken uit werd de native instelling thinking.type=disabled gebruikt, zoals beschreven in de API-documentatie van het model.
Q — antwoordkwaliteit: 41.42
De suite omvatte 500 BFCL-vragen × 3 rondes, 250 HLE-vragen × 10 en 25 AA-LCR-vragen × 10. BFCL werd automatisch gescoord; HLE en AA-LCR werden beoordeeld door deepseek-flash. Alle vijf kregen dezelfde vragen. Tien niet-scorebare antwoorden werden verwijderd, zodat 4,240 gescoorde gevallen overbleven.
| Taak | Vragen | Correct | Nauwkeurigheid | Fouten |
|---|---|---|---|---|
| BFCL-tool-aanroepen | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| HLE-moeilijke vraag- en antwoordtaken | 250 × 10 | 358/2,490 | 14.38% | 5 |
| AA-LCR-redeneren over lange documenten | 25 × 10 | 115/250 | 46.00% | 34 |
| Totaal · 95%-BI 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Fouten blijven als fout in de noemer: BFCL 2 (vensters 2 en 3), HLE 5 afgekapt bij max_tokens, AA-LCR 34, allemaal in venster 2.
| BFCL-categorie | Geslaagd | Slagingspercentage |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python slaagde voor 333/360 (92.50%), parallel voor 270/300 (90.00%), ahm_multi_turn voor 95/150 (63.33%) en irrelevance voor 111/150 (74.00%).
Vergeleken met de andere vier
Verschil in procentpunten ten opzichte van het officiële kanaal; het 95%-interval wordt weergegeven met foutbalken. Kruising met 0 betekent dat het verschil niet te onderscheiden is. De beoordelaar deepseek-flash behoort tot dezelfde familie en is niet gekalibreerd, waardoor deze mogelijk mild oordeelt.
F — functieondersteuning: 71.78
De 60 gevallen bestaan uit zes groepen, elk uitgevoerd in drie vensters: 180 controles beoordeeld aan de hand van het gedocumenteerde formaat van de aanbieder. Niet-toepasselijke, ongeldige en niet-geobserveerde controles tellen niet mee in de noemer. 122 van de 177 meegetelde controles slaagden; met weging per groep komt de score uit op 71.78.
| Gevallengroep | Gewicht | Geslaagd | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming en berichten | 20% | 24/30 | — | 80.00 |
| Toolinterface | 20% | 29/30 | — | 96.67 |
| Uitvoerbeperkingen | 20% | 21/30 | — | 70.00 |
| Context en status | 15% | 15/30 | — | 50.00 |
| Fouten en herstel | 15% | 21/30 | — | 70.00 |
| Facturering en cache | 10% | 12/27 | 3 | 44.44 |
| Totaal · gewogen | — | 122/177 | 3 | 71.78 |
‘Mislukte vensters’ telt de drie vensters waarin het geval niet slaagde.
| Mislukt geval | Mislukte vensters | Reden |
|---|---|---|
| Streaming-stop | 3/3 | Lege body bij stop; zonder stop werkt het. |
| Redenering in body | 3/3 | reasoning_effort=none gaf nog steeds redenering terug. |
| Stopreeks | 3/3 | Lege body bij stop; zonder stop werkt het. |
| Instelling voor denken | 3/3 | reasoning_effort=none gaf nog steeds redenering terug. |
| Variatie in sampling | 3/3 | Temp 0/1 te vergelijkbaar |
| Lange invoer van 10k | 3/3 | 10,026 gerapporteerd; native 10,000. |
| Binnen de contextlimiet | 3/3 | 10,026 gerapporteerd; native 10,000. |
| Lange invoer van 32k | 3/3 | 10,026 gerapporteerd; native 10,000. |
| Lange invoer van 100k | 3/3 | 10,026 gerapporteerd; native 10,000. |
| Buiten de context | 3/3 | Had een parameterfout moeten zijn; gaf 200 terug. |
| Ongeldige berichten | 3/3 | 400, lege body |
| Losstaand toolresultaat | 3/3 | Had een parameterfout moeten zijn; gaf 200 terug. |
| Ongeldige stream_options | 3/3 | 400, lege body |
| Meting van denktokens | 3/3 | Na uitschakelen werden denktokens gerapporteerd. |
| Native invoertelling | 3/3 | 34 gerapporteerd; native 8. |
| Tooldefinities in invoer | 3/3 | De controle zonder tools kwam al niet overeen. |
| Invoertelling met cache | 3/3 | De telling van het herhaalde voorvoegsel kwam niet overeen met de native telling. |
| Overeenstemming van streaming-invoer | 3/3 | 34 gerapporteerd; native 8 |
| Eén tool tegelijk | 1/3 | Upstream 500. |
Beide stopgevallen leverden een lege body op, terwijl dezelfde invoer zonder stop werkte, in alle drie de vensters. reasoning_effort=none leverde in beide gevallen met denken nog steeds redenering terug.
Uitgesloten controles tellen niet als geslaagd of mislukt.
| Status | Geval | Aantal | Reden |
|---|---|---|---|
| Niet van toepassing | Expliciete cache_control | 3 | Vooraf geregistreerd als niet ondersteund door deze interface |
Ongeldige messages en stream_options mislukten bij alle vijf: 400 met een lege body en zonder gestructureerde foutmelding. De gedeelde uitkomst lijkt eerder op de AIHubMix-gatewaylaag te ontstaan; dit vereist afzonderlijk onderzoek. Ook de meting van denktokens mislukte bij alle vijf, maar ByteDance en Fireworks rapporteerden denktokens na uitschakeling, terwijl de andere drie geen denktelling teruggaven.
Vergeleken met de andere vier
P — reactiesnelheid: 79.51
Elke aanvraag bevatte ongeveer 10,000 invoertokens en vroeg om ongeveer 1,100 uitvoertokens. In elk van de drie vensters werden 30 aanvragen verstuurd met één gelijktijdige aanvraag en 30 met 10 gelijktijdige aanvragen, in totaal 180.
| Metriek | Resultaat |
|---|---|
| TTFA | 1.63 s bij één gelijktijdige aanvraag; 1.64 s bij 10 |
| TPOT | 3.24 ms bij één gelijktijdige aanvraag; 3.29 ms bij 10 |
| Goodput | 1,504.5 tokens/s bij 10 |
| Geldig | 90/90 bij één gelijktijdige aanvraag; 89/90 bij 10 (29/30 in venster 3), één output van één token |
| Onderdelen | TTFA 54.91, TPOT 100.00, goodput 100.00; gewichten 35/35/30 |
| Samenstelling van P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 van de 180 waren geldig; de ongeldige aanvraag leverde één token op en telt als oneindig mee in de medianen, waardoor medianen hoger kunnen zijn dan wanneer alleen geldige aanvragen worden meegenomen. TPOT is gebaseerd op streaming-chunks; goodput is het aantal geldige uitvoertokens bij 10 gelijktijdige aanvragen gedeeld door de wandkloktijd van de batch.
Eén machine, netwerk en account; de vensters werden per aanbieder ingepland.
K — cache: 60.68
Elke groep bestaat uit vijf aanvragen: eerst wordt een voorvoegsel van 8k of 32k geladen, daarna volgt hetzelfde voorvoegsel met een nieuwe laatste vraag na 5 s, 30 s en 120 s, en vervolgens een nieuw voorvoegsel als koude controle. Drie vensters × twee lengtes = 30. K is het aantal warm uit de cache gelezen tokens gedeeld door het aantal herbruikbare tokens; de lengtes wegen even zwaar. K telt voor 20% mee in P.
| Voorvoegsel | Venster | Laden | +5 s | +30 s | +120 s | Koude controle |
|---|---|---|---|---|---|---|
| 8k | Venster 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Venster 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Venster 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Venster 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Venster 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Venster 3 | 0 | 31,900 | 31,900 | 0 | 0 |
De prefix van 8k raakte 3 van de 9 warme verzoeken en las 23,706 van de 72,252 herbruikbare tokens, voor een score van 32.81. De prefix van 32k raakte 8 van de 9 verzoeken en las 255,212 van de 288,261 tokens, voor een score van 88.54. K is 60.68 wanneer beide lengtes even zwaar wegen. Koude controles lazen 0 tokens. De twee prefixlengtes gedroegen zich dus verschillend bij hetzelfde ontwerp. De K-tests gebruikten het gedocumenteerde veld user en de header x-session-affinity.
R — servicestabiliteit: 100
300 verzoeken bestreken korte tekst, lange invoer, tool-aanroepen en meerbeurtengeschiedenis, met één gelijktijdig verzoek gedurende drie vensters. Alleen de geldigheid en volledigheid van de eerste reactie werden gecontroleerd; antwoorden zijn niet beoordeeld en er is niets opnieuw geprobeerd. Fouten voor Q en P worden hier niet opnieuw meegeteld.
| Type verzoek | Succes bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Meerbeurtengeschiedenis | 30/30 |
| Totaal · 95%-BI 98.78%–100% | 300/300 |
Alle 300 verzoeken leverden bij de eerste poging een geldige, volledige reactie op. Met 300 successen is de ondergrens van het 95%-interval 98.78%, dus de gegevens ondersteunen alleen de conclusie dat het foutpercentage lager is dan 1.22%. R 100 geldt voor deze 300 verzoeken, niet voor het volledige traject.
| Aanbieder | Succes bij eerste poging | 95%-interval |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Veelgestelde vragen
Wat omvat Q 41.42?
BFCL, HLE en AA-LCR over 4,240 beoordeelde gevallen: 1,756 correct, 41.42%, 95%-BI 39.13%–43.59%; het verschil met het officiële kanaal is niet aantoonbaar.
Waarom mislukten beide gevallen met stop?
Een verzoek met stop leverde in alle drie de vensters een lege hoofdtekst op, terwijl dezelfde invoer zonder stop wel werkte. Dit gebeurde zowel bij streaming als bij niet-streaming.
Schakelt reasoning_effort=none het denken uit?
Nee. In alle drie de vensters werd nog steeds redeneerinhoud geretourneerd; voor andere verzoeken werd native thinking.type=disabled gebruikt.
Waarom wordt een invoer van 10k gerapporteerd als 10,026 tokens?
Voor het geval van 10k werden 10,026 tokens gerapporteerd, tegenover een native waarde van 10,000. Voor de gevallen van 32k en 100k werden dezelfde 10,026 tokens gerapporteerd, en een controle zonder tools vertoonde al een afwijking.
Waarom was de hitratio voor 8k 3/9, maar voor 32k 8/9?
Beide gebruikten hetzelfde ontwerp en dezelfde gedocumenteerde instellingen voor affinity. Het verschil zit in de door de server gerapporteerde reads: 8k had hits in venster 1 en 2, 32k in alle drie de vensters.
Wat omvat R 100?
300 afzonderlijke verzoeken, allemaal geldig bij de eerste poging; de ondergrens van het 95%-interval is 98.78%. Fouten voor Q en P tellen niet mee in R.
Lees verder: de DeepSeek V4.1 Flash-reeks
- ByteDance rapporteerde denktokens nadat het denken was uitgeschakeld, net als Fireworks: DeepSeek V4.1 Flash op ByteDance: tool-aanroepen komen overeen, meting niet
- Baidu noteerde Q 38.00 en P 37.77: DeepSeek V4.1 Flash op Baidu: geen beschikbaar kanaal haalt Q en P
- Alibaba Cloud noteerde een eerste token na 1.34 s en een cache van 99.37: DeepSeek V4.1 Flash op Alibaba Cloud: eerste token na 1.34s, cache 99.37
- Het officiële kanaal is de Q-baseline, met F 94.00: DeepSeek V4.1 Flash op het officiële kanaal: 94.00 F, 15 ongeldige tests


