

Op 2026-11-03/04 is de volledige APB-suite uitgevoerd met DeepSeek V4.1 Flash 1017 bij vijf aanbieders via AIHubMix. Voor elke aanbieder zijn dezelfde vragen, parameters en aanvraagscripts gebruikt; de vijf aanbiedervermeldingen staan op de modellenpagina. Dit APB-profiel omvat alleen het officiële DeepSeek-kanaal. Dit wordt bereikt via de officiële DeepSeek-aanbiedersroute van AIHubMix, niet via een rechtstreekse verbinding met de API van DeepSeek.
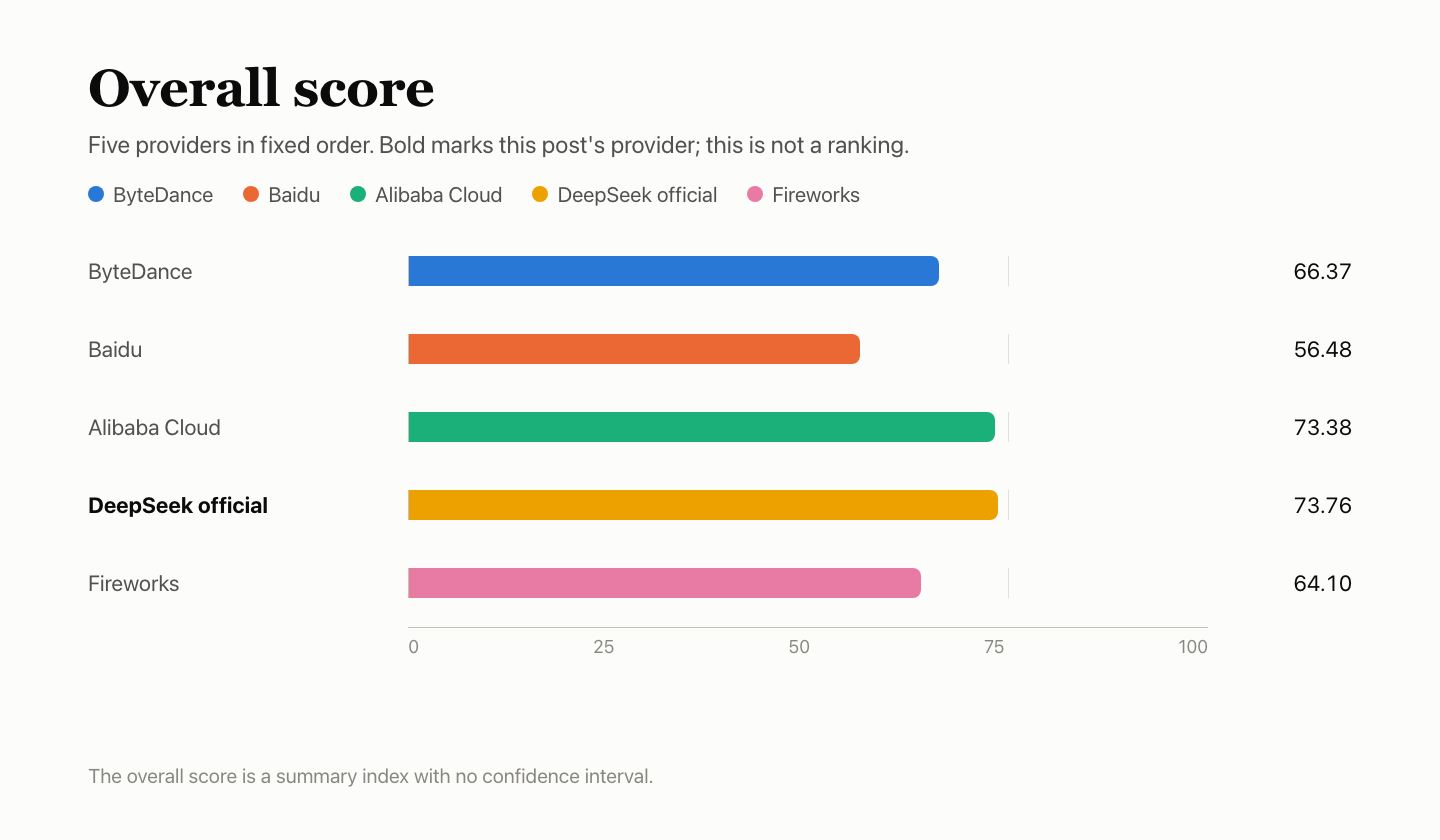
In dit artikel worden alleen scores gerapporteerd, zonder aanbieders te rangschikken of een aanbieder aan te bevelen: Q 42.45, F 94.00, P 86.14, K 98.38 en R 100. Q, F, P en R zijn de scores voor de vier secties; K is een deelscore van P. De totaalscore, 73.76, is een samenvattende index, geen certificering, en heeft geen betrouwbaarheidsinterval. De scoringsstandaard is AIHubMix Provider Benchmark Standard v2.0.
Scores van vijf aanbieders
Vetgedrukt is de aanbieder van dit artikel. De vaste volgorde van aanbieders is geen rangschikking. K is een deelscore van P met een gewicht van 20% en wordt ter referentie apart vermeld. De totaalscore is een samenvattende index zonder betrouwbaarheidsinterval. Het officiële DeepSeek-kanaal en Alibaba Cloud verschillen 0.37 in totaalscore en zijn niet van elkaar te onderscheiden.
In één oogopslag
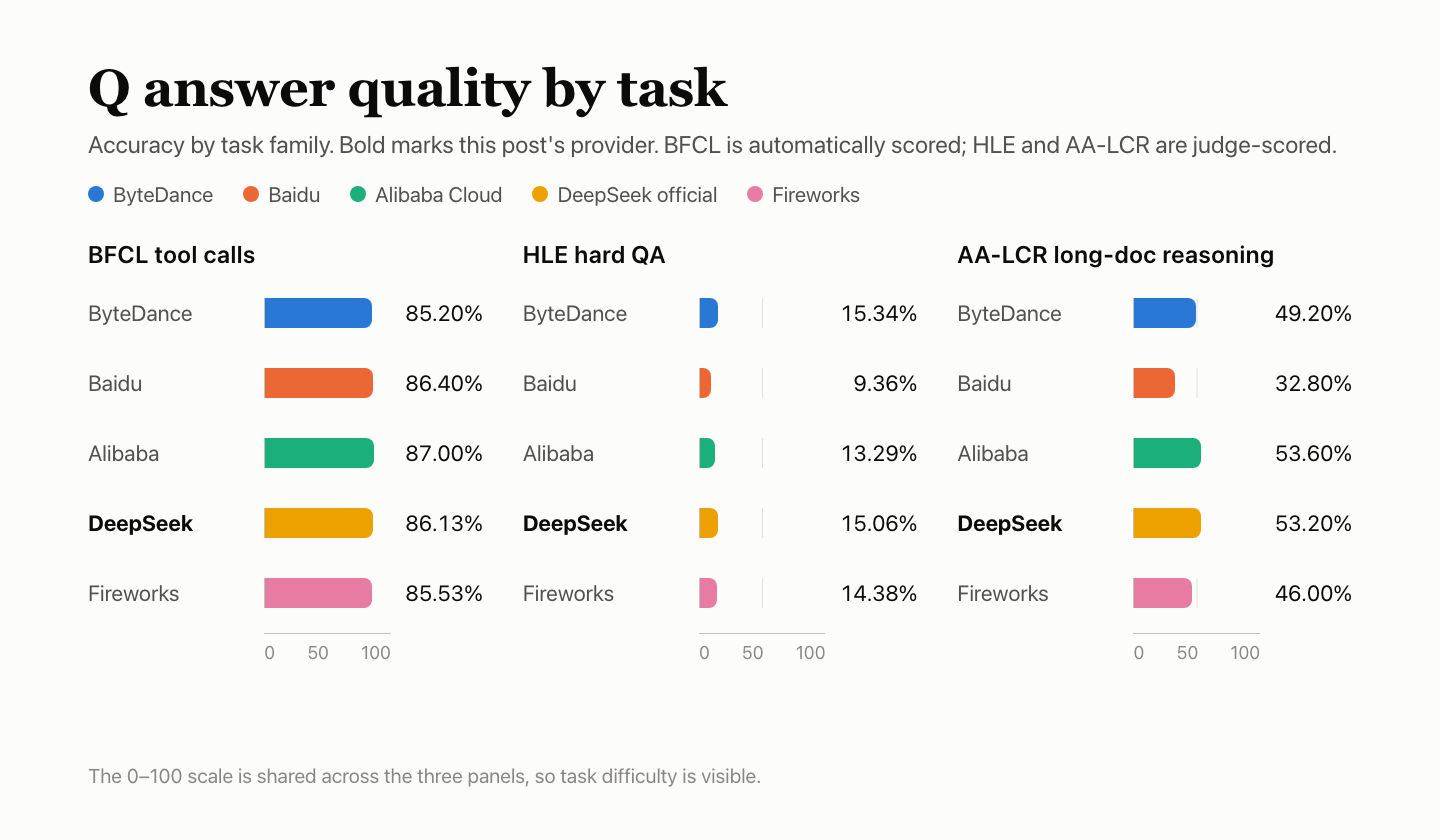
- Antwoordkwaliteit: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Zeven HLE-uitvoerresultaten zijn afgekapt bij de max_tokens-limiet en als fout geteld. Dit kanaal is de Q-baseline voor de andere vier.
- Functieondersteuning: F 94.00. 137 van de 147 meegetelde controles zijn geslaagd. Nog eens 27 controles die afhankelijk zijn van exacte tokenaantallen zijn ongeldig verklaard en buiten de noemer gelaten.
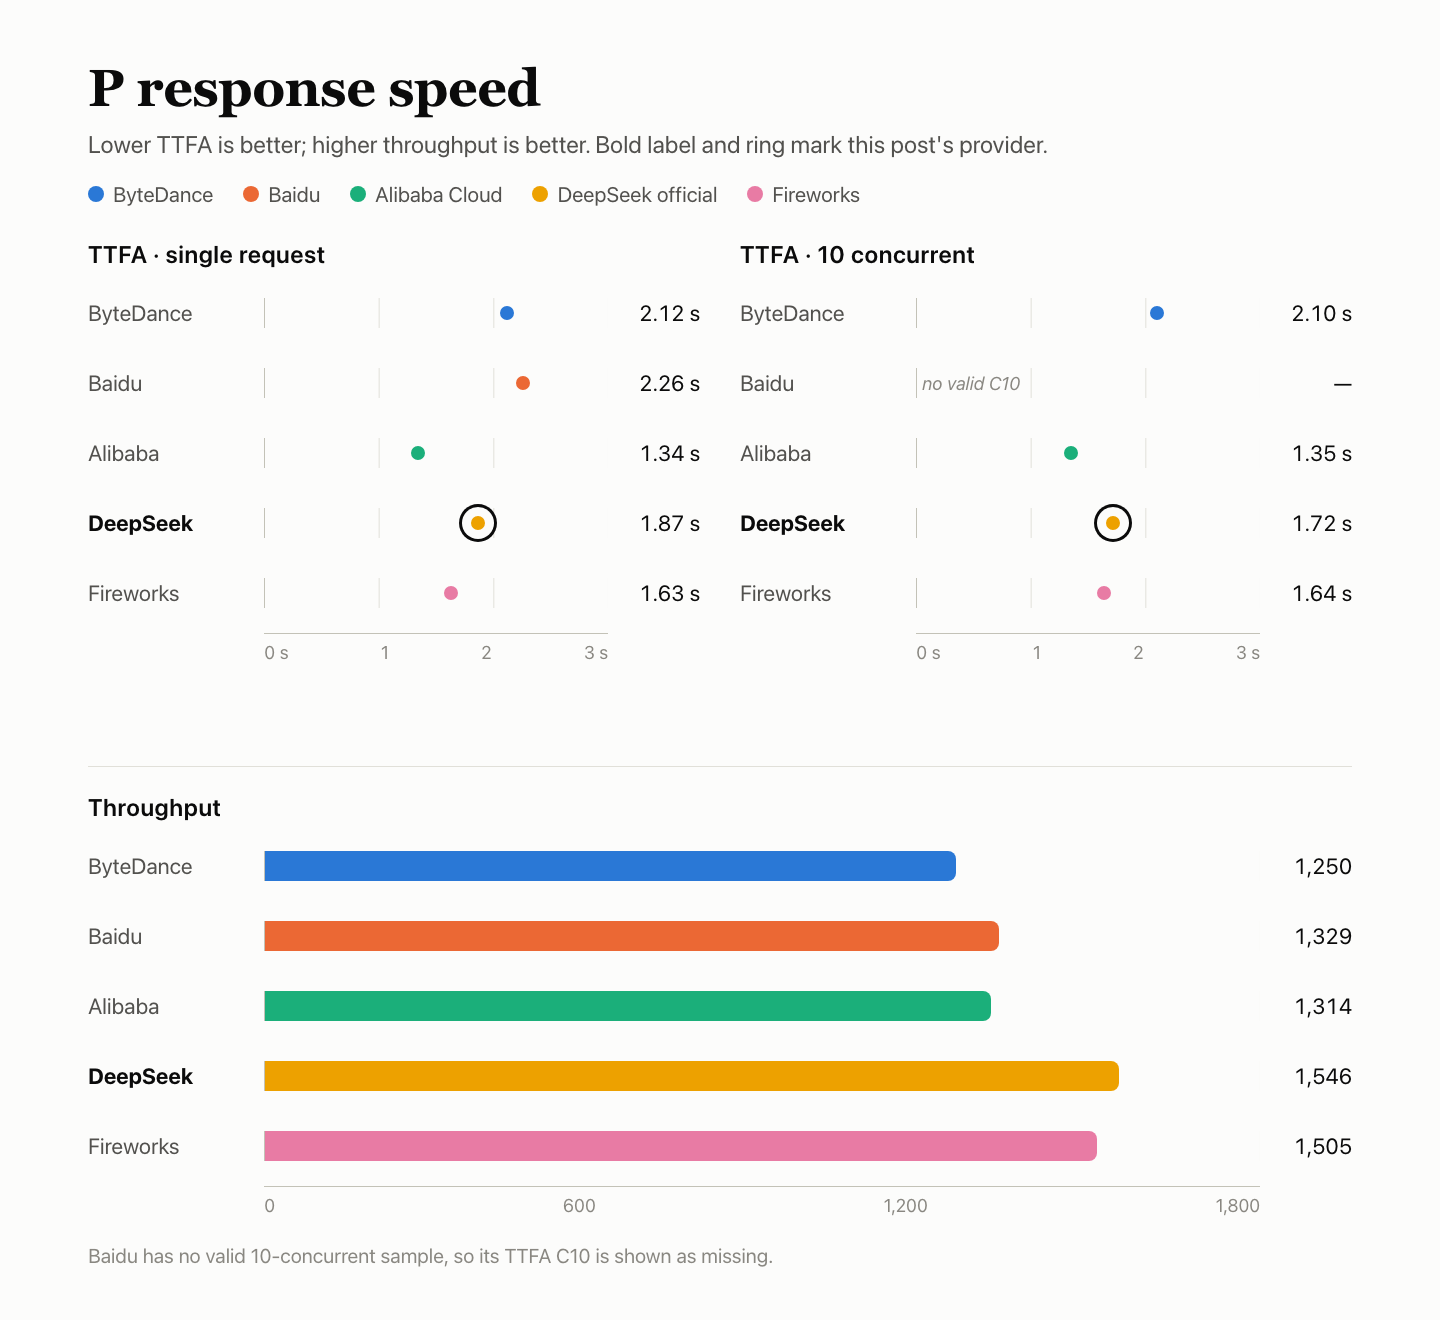
- Responssnelheid: P 86.14. In het eerste venster met één gelijktijdige aanvraag waren 15 van de 30 aanvragen ongeldig (12 × 503, 2 × deadline, 1 × read timeout), en ze zijn meegeteld als oneindig; mediaan eerste token 1.87 s (1.72 s als alleen geldige aanvragen worden meegerekend); 1.72 s bij 10 gelijktijdige aanvragen; TPOT 2.84 ms.
- Cache: K 98.38. Alle 18 hot requests op 8k en 32k leverden een cache-hit op; cold controls lazen niets uit de cache.
- Servicestabiliteit: R 100. Alle 300 afzonderlijke aanvragen zijn bij de eerste poging geslaagd.
Testopzet
De aanvragen liepen via AIHubMix door de officiële DeepSeek-aanbiedersroute te selecteren; de snelstartgids behandelt de toegangsconfiguratie.
| Item | Details |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagd model-ID | deepseek-flash |
| Geretourneerde modelnaam | deepseek-flash |
| Toegangsroute | Officiële DeepSeek-aanbiedersroute van AIHubMix; geen rechtstreekse verbinding met de API van DeepSeek |
| Parameters | Niet-denkmodus, temperature 1.0, max_tokens 16,384, timeout 300 s, geen automatische nieuwe pogingen |
| Denken uit | Voor alle aanvragen is reasoning_effort=none gebruikt |
| Tijd | 2026-11-03 18:07 – 11-04 16:33 UTC+8; de vijf aanbieders deelden één Mac mini, netwerk en account |
| Steekproeven | Antwoordkwaliteit: 4,250 pogingen (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); functiegevallen: 60 × 3 vensters; snelheid: 90 met één gelijktijdige aanvraag en 90 met 10 gelijktijdige aanvragen; stabiliteit: 300; cache: 30 (drie groepen elk met prefixes van 8k en 32k) |
Q — antwoordkwaliteit: 42.45
De suite combineert BFCL 500 vragen × 3 runs, HLE 250 × 10 en AA-LCR 25 × 10. BFCL wordt beoordeeld met automatische regels; HLE en AA-LCR worden beoordeeld door het judge-model deepseek-flash. Alle vijf aanbieders kregen dezelfde vragen. Tien antwoorden konden niet worden beoordeeld en zijn verwijderd, zodat er 4,240 beoordeelde pogingen overbleven.
| Benchmark | Vragen | Correct | Nauwkeurigheid | Fouten |
|---|---|---|---|---|
| BFCL-tool-aanroepen | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| HLE-vragen en antwoorden op hoog niveau | 250 × 10 | 375/2,490 | 15.06% | 7 |
| AA-LCR-redenering over lange documenten | 25 × 10 | 133/250 | 53.20% | 0 |
| Totaal · 95% BI 40.08%–44.73% | 4,240 beoordeeld | 1,800/4,240 | 42.45% | 7 |
Servicefouten — een mislukte aanvraag of afgekapt uitvoerresultaat — blijven in de noemer en tellen als fout. In dit geval gaat het om zeven HLE-uitvoerresultaten die de max_tokens-limiet bereikten. BFCL wordt automatisch beoordeeld; HLE en AA-LCR worden door een judge beoordeeld.
De BFCL-noemers zijn totalen van drie runs.
| BFCL-categorie | Geslaagd | Slagingspercentage |
|---|---|---|
| simple_python — één functie, juiste aanroep en argumenten | 334/360 | 92.78% |
| multiple — de juiste kiezen uit meerdere functies | 268/300 | 89.33% |
| parallel — dezelfde functie meerdere keren parallel aanroepen | 271/300 | 90.33% |
| parallel_multiple — meerdere verschillende functies parallel aanroepen | 207/240 | 86.25% |
| irrelevance — geen functie is relevant, dus er mag geen worden aangeroepen | 113/150 | 75.33% |
| ahm_multi_turn — toolketen in drie stappen | 99/150 | 66.00% |
Vergeleken met de andere vier
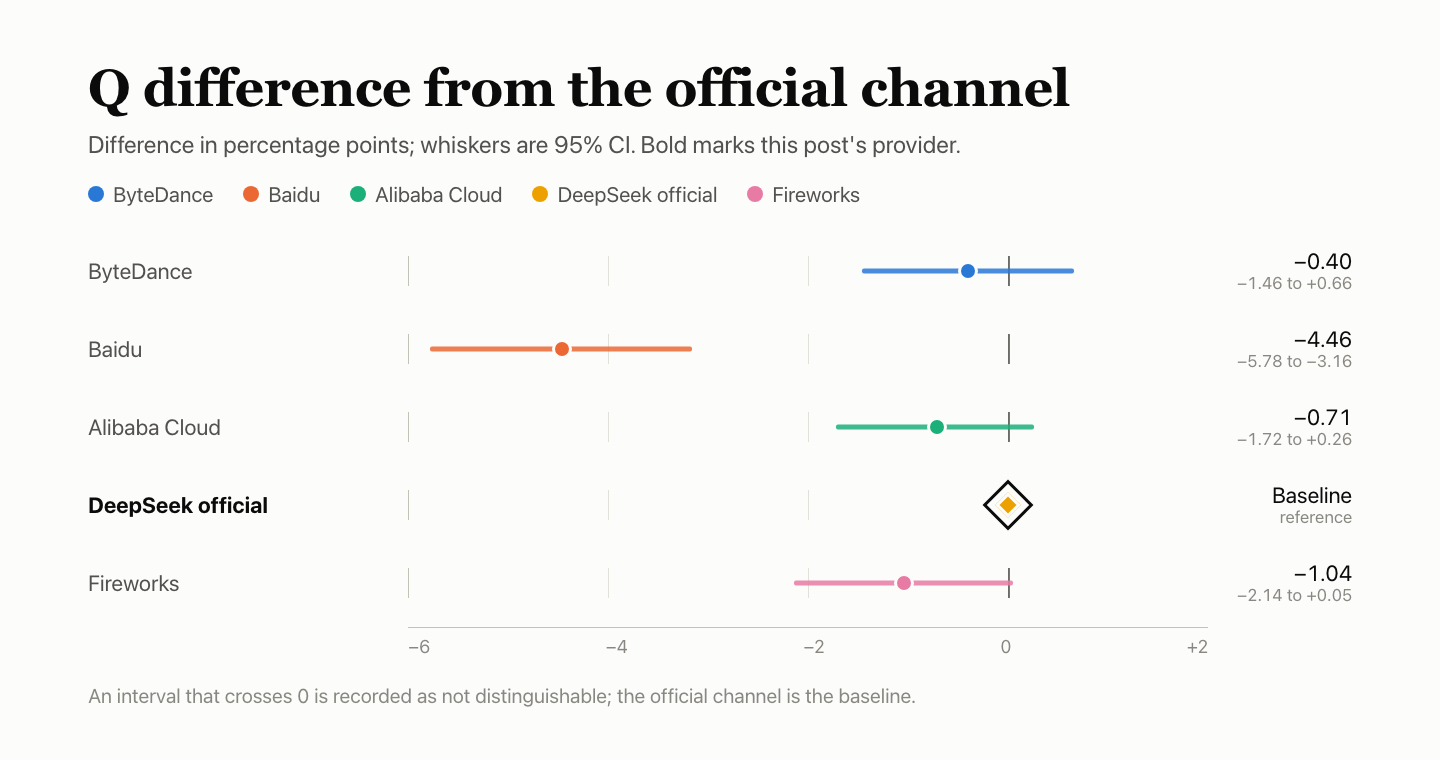
Elk verschil is uitgedrukt in procentpunten ten opzichte van deze baseline, met een interval van 95% weergegeven als whiskers; als een interval 0 omvat, zijn de resultaten niet van elkaar te onderscheiden. De judge komt uit dezelfde DeepSeek-familie als het geteste model en is niet gekalibreerd, dus de beoordeling van HLE en AA-LCR kan mild uitvallen.
F — functieondersteuning: 94.00
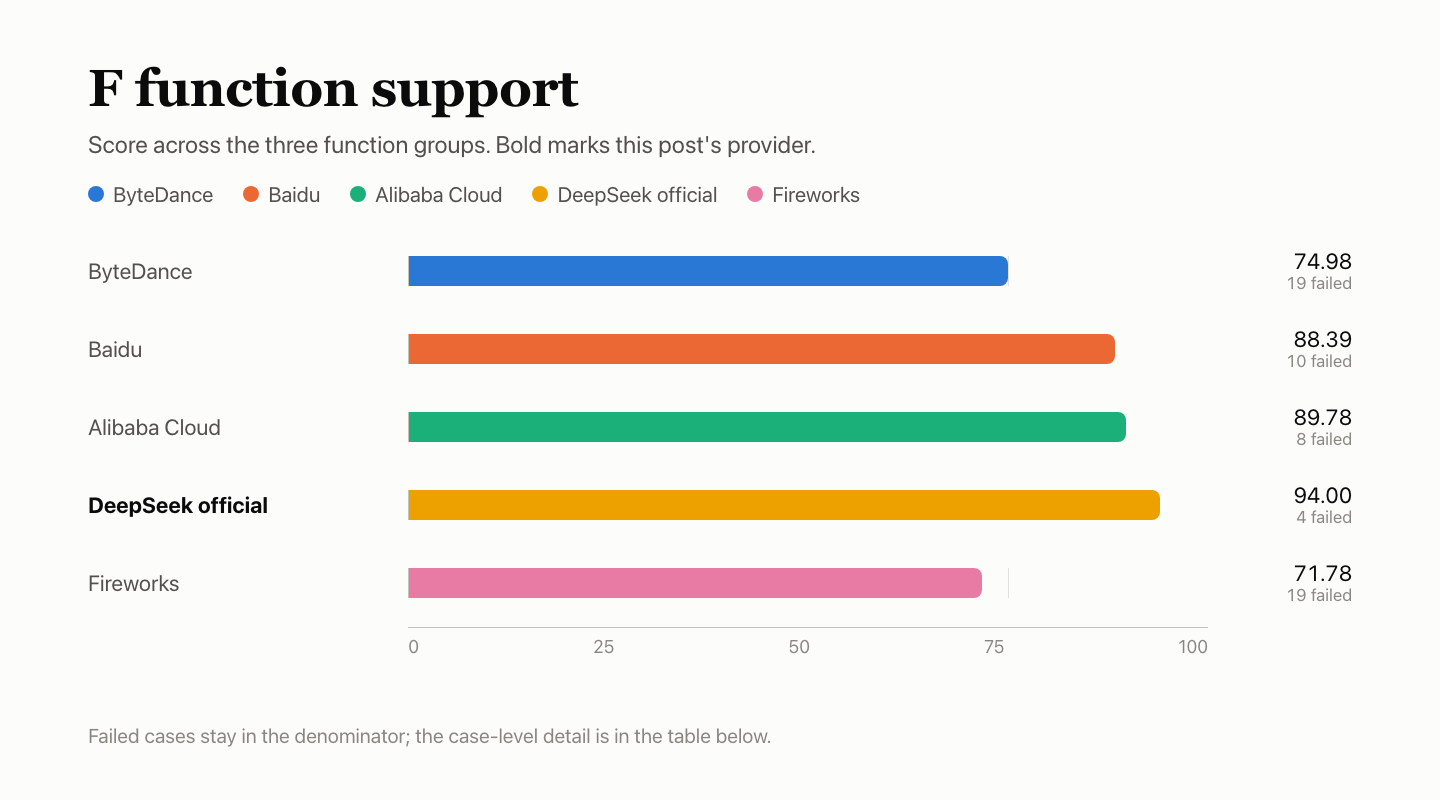
Functiegevallen testen protocolgedrag, niet de antwoordkwaliteit. In elk van drie vensters zijn 60 gevallen in zes groepen uitgevoerd — 180 controles — beoordeeld aan de hand van de indeling die in de documentatie van elke aanbieder staat. Niet-toepasselijke, ongeldige en niet-waargenomen controles tellen niet mee in de noemer. Dit kanaal slaagde voor 137 van de 147 meegetelde controles, met een gewogen score van 94.00; de gewogen score is niet simpelweg 137/147.
| Groep | Gewicht | Geslaagd | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming- en berichtprotocol | 20% | 27/27 | 3 | 100.00 |
| Toolinterface | 20% | 30/30 | — | 100.00 |
| Uitvoerbeperkingen en parameters | 20% | 30/30 | — | 100.00 |
| Context en status | 15% | 14/15 | 15 | 93.33 |
| Fouten en herstel | 15% | 24/30 | — | 80.00 |
| Verbruiksmeting en cacheprotocol | 10% | 12/15 | 15 | 80.00 |
| Totaal · gewogen | — | 137/147 | 33 | 94.00 |
De gewogen score volgt de groepsgewichten; het is niet het aantal geslaagde controles gedeeld door 147.
| Mislukt geval | Mislukte vensters | Reden |
|---|---|---|
| Ongeldige berichten (Fouten en herstel) | 3/3 | 400 geretourneerd, maar de body was leeg, zonder gestructureerde foutbeschrijving |
| Ongeldige stream_options (Fouten en herstel) | 3/3 | 400 geretourneerd, maar de body was leeg, zonder gestructureerde foutbeschrijving |
| Verbruiksmeting van denktokens (Verbruiksmeting en cacheprotocol) | 3/3 | Er is geen aantal denktokens geretourneerd |
| Aanvraagisolatie (Context en status) | 1/3 | De eerste stap antwoordde niet uitsluitend met STORED zoals vereist, waardoor de isolatiecontrole niet kon worden voortgezet |
Uitgesloten controles tellen niet als geslaagd of mislukt.
| Status | Geval | Aantal | Reden |
|---|---|---|---|
| Niet waargenomen | Streaming-stopsequentie | 3 | Na de vorige stap is de aanvraag voor deze stap niet verzonden, dus kon deze niet worden beoordeeld |
| Ongeldig | Lange invoer van 10k; binnen de contextlimiet; lange invoer van 32k; lange invoer van 100k; buiten de contextlimiet; native invoeraantal; tooldefinities meegeteld in de invoer; invoeraantal consistent vóór en na cache; invoer consistent bij streaming en niet-streaming | 27 | De vastgezette native-aantalsjabloon aan de testzijde kwam niet overeen met het gerapporteerde verbruik van dit kanaal, dus controles die afhankelijk zijn van exacte aantallen zijn ongeldig verklaard en buiten de noemer gelaten |
| Niet van toepassing | Expliciete cache_control | 3 | Vooraf geregistreerd als niet ondersteund door deze interface |
De 27 ongeldige controles zijn de gevallen voor lange invoer, contextlimiet, native aantallen en cacheconsistentie in de lijst. Omdat de vastgezette sjabloon niet overeenkwam met het verbruik dat dit kanaal rapporteerde, is elke controle die afhankelijk was van een exact aantal uitgesloten in plaats van gescoord.
Twee gevallen mislukten bij alle vijf aanbieders: ongeldige messages en ongeldige stream_options. Beide retourneerden een 400 met een lege body, waardoor de client geen gestructureerde foutbeschrijving ontving. Dit gedeelde patroon wijst eerder op de gatewaylaag van AIHubMix, die apart onderzocht moet worden. Ook de verbruiksmeting van denktokens mislukte bij alle vijf, maar om verschillende redenen: ByteDance en Fireworks rapporteerden nog denktokens nadat het denken was uitgeschakeld, terwijl de andere drie geen aantal denktokens retourneerden.
Vergeleken met de andere vier
P — responssnelheid: 86.14
Elke aanvraag bevatte ongeveer 10,000 invoertokens en vroeg om ongeveer 1,100 uitvoertokens. In elk van drie vensters zijn 30 aanvragen verstuurd met één gelijktijdige aanvraag en 30 met 10 gelijktijdige aanvragen, in totaal 180.
| Maatstaf | Waarde |
|---|---|
| TTFA tot het eerste token | Eén gelijktijdige aanvraag: mediaan 1.87 s (mediaan van geldige aanvragen 1.72 s). 10 gelijktijdige aanvragen: mediaan 1.72 s |
| TPOT | Eén gelijktijdige aanvraag: 2.84 ms/token. 10 gelijktijdige aanvragen: 2.67 ms/token |
| Geldige doorvoer (goodput) | 10 gelijktijdige aanvragen: 1,546.0 token/s |
| Geldige aanvragen | Eén gelijktijdige aanvraag: 75/90 (venster 1: 15/30); 10 gelijktijdige aanvragen: 90/90. Ongeldig: 12 × 503 service_unavailable_error, 2 × deadline bereikt, 1 × read timeout |
| Deelscores | TTFA 51.65, TPOT 100.00, doorvoer 100.00; voor TTFA en TPOT geldt de laagste van de twee niveaus, gewogen met 35% / 35% / 30%; responsscore 83.08 |
| Samenstelling van P | Responsscore 83.08 met een gewicht van 80%, cache K 98.38 met een gewicht van 20%; P 86.14 |
De 15 ongeldige aanvragen zaten allemaal in het eerste venster met één gelijktijdige aanvraag: 12 retourneerden 503, 2 liepen tegen de deadline aan en 1 kreeg een read timeout. Ongeldige aanvragen worden geteld als oneindig, dus de gerapporteerde mediaan is 1.87 s. Alleen voor geldige aanvragen is de mediaan 1.72 s. Bij 10 gelijktijdige aanvragen is de mediaan ook 1.72 s. TPOT is 2.84 ms/token bij één gelijktijdige aanvraag en 2.67 ms/token bij 10 gelijktijdige aanvragen.
Vergeleken met de andere vier
De vijf aanbieders deelden één Mac mini, netwerk en account. De drie vensters zijn per aanbieder ingepland, dus de verzamelperiodes overlappen niet volledig; interpreteer kleine verschillen daarom niet te zwaar.
K — cache: 98.38
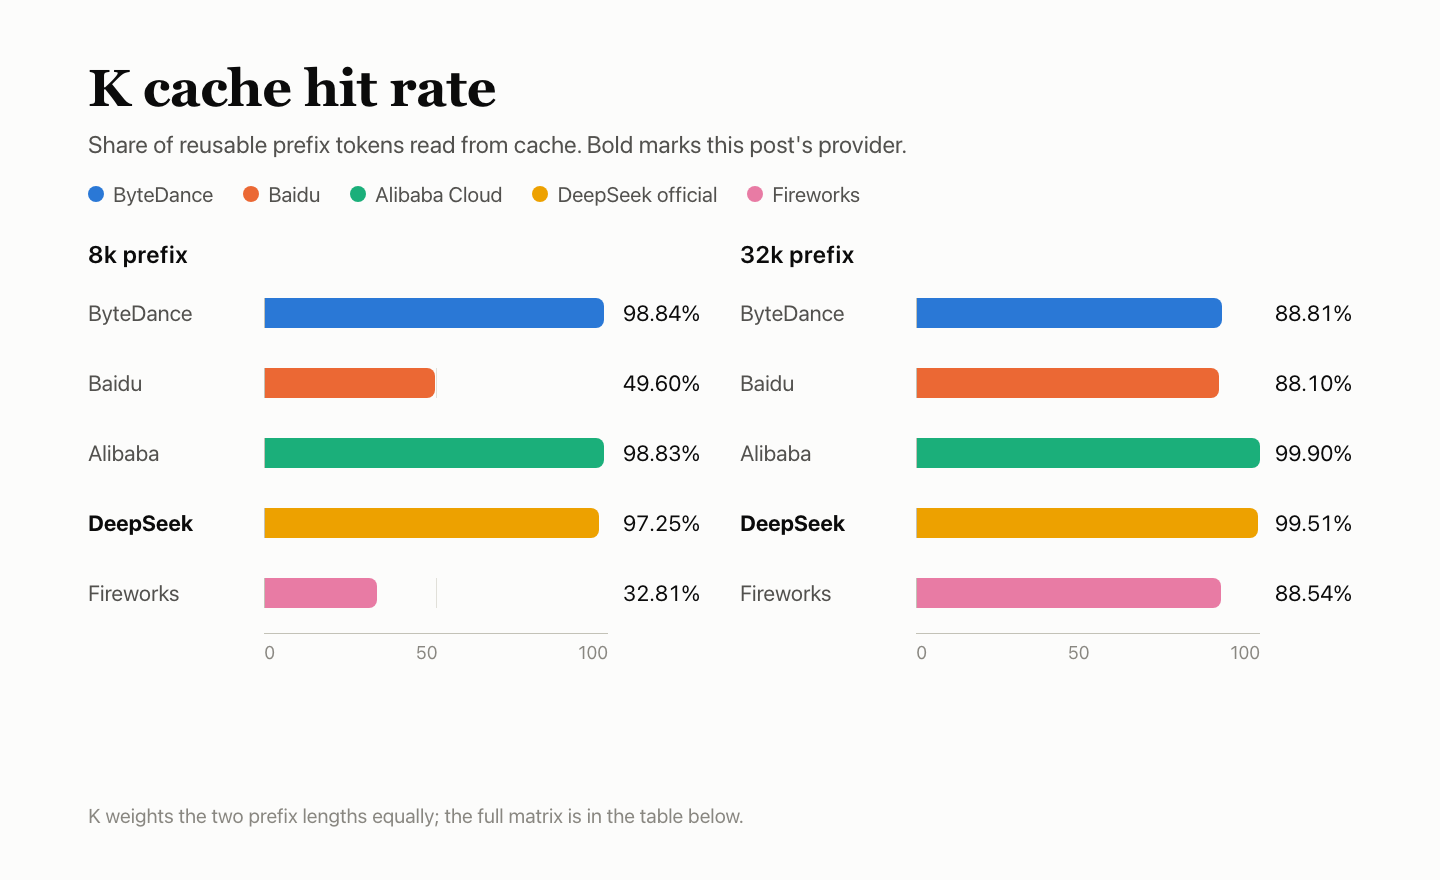
Elke groep verstuurt vijf aanvragen. De eerste vult een vaste prefix van 8k of 32k. Bij aanvragen twee tot en met vier blijft de prefix gelijk en verandert alleen de laatste vraag, op 5, 30 en 120 seconden. De vijfde gebruikt een nieuwe prefix als cold control. Drie vensters × twee lengtes leveren 30 aanvragen op. K deelt het aantal cachetokens dat bij hot requests is gelezen door het aantal tokens dat hergebruikt zou moeten kunnen worden, waarbij elke lengte voor de helft meetelt; K vormt 20% van P. De API-documentatie van DeepSeek behandelt contextcaching.
| Prefix | Venster | Vulaanvraag | +5 s | +30 s | +120 s | Cold control |
|---|---|---|---|---|---|---|
| 8k | Venster 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Venster 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Venster 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Venster 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Venster 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Venster 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Bij hot requests van 8k leverden 9 van de 9 een cache-hit op en werden telkens 7,808 tokens gelezen: 70,272 gelezen tegenover 72,261 herbruikbare tokens, 97.25. Bij hot requests van 32k leverden 9 van de 9 een cache-hit op en werden telkens 31,872 tokens gelezen: 286,848 tegenover 288,270, 99.51. Cold controls lazen niets uit de cache. K is 98.38 over de twee lengtes.
Vergeleken met de andere vier
R — servicestabiliteit: 100
300 aanvragen omvatten korte tekst, lange invoer van 10k, tool-aanroepen en de geschiedenis van meerdere beurten, verzonden met één gelijktijdige aanvraag in drie vensters. Alleen de geldigheid en volledigheid bij de eerste poging worden gecontroleerd — niet de juistheid van het antwoord — en er worden geen nieuwe pogingen gedaan. Fouten in antwoordkwaliteit en snelheid worden meegeteld in Q en P, niet nogmaals in R.
| Aanvraagtype | Geslaagd bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Geschiedenis van meerdere beurten | 30/30 |
| Totaal · 95% BI 98.78%–100% | 300/300 |
Alle 300 verzoeken leverden bij de eerste poging een geldig, volledig antwoord op. R 100 omvat alleen deze 300 speciaal hiervoor verstuurde verzoeken; het betekent niet dat er nergens in het hele traject fouten waren. Bij 300 successen is de ondergrens van het 95%-interval 98.78%, wat erop wijst dat het foutenpercentage waarschijnlijk lager is dan 1.22%.
Vergeleken met de andere vier
R omvat alleen de 300 speciaal hiervoor verstuurde verzoeken; fouten in antwoordkwaliteit en snelheid worden geregistreerd onder Q en P en niet nogmaals meegeteld in R.
| Aanbieder | Succes bij eerste poging | 95%-BI |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officieel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Veelgestelde vragen
Is dit een directe verbinding met de API van DeepSeek?
Nee. De verzoeken lopen via de officiële DeepSeek-aanbiedersroute van AIHubMix; ze worden niet rechtstreeks naar de API van DeepSeek gestuurd.
Waarom is het officiële DeepSeek-kanaal de Q-baseline?
Dit is het officiële kanaal van DeepSeek voor hetzelfde model, dus de resultaten voor antwoordkwaliteit van de andere vier aanbieders worden uitgedrukt als verschillen ten opzichte daarvan. De rol als baseline impliceert geen rangschikking op antwoordkwaliteit.
Wat gebeurde er in het eerste snelheidsvenster met één gelijktijdig verzoek?
Vijftien van de 30 verzoeken waren ongeldig: 12 leverden 503 op, 2 haalden de deadline en 1 liep tegen een time-out bij het lezen aan. Ze worden als oneindig meegeteld, waardoor de mediaan 1.87 s is; alleen bij geldige verzoeken is die 1.72 s.
Wat zijn de 27 ongeldige functiecontroles?
Die zijn afhankelijk van exacte tokentellingen: lange invoer, contextlimieten, native invoertellingen en consistentie van cache-invoer. De vastgezette template aan de testkant voor native tellingen kwam niet overeen met het gebruik dat dit kanaal rapporteerde. Daarom zijn deze controles buiten de noemer gelaten in plaats van als fouten te worden beoordeeld.
Waarom garandeert R 100 niet dat de route foutloos is?
R omvat alleen de 300 speciale stabiliteitsverzoeken. Fouten tijdens de runs voor antwoordkwaliteit en snelheid worden geregistreerd onder Q en P. Bij 300 successen op 300 verzoeken is de ondergrens van het 95%-interval 98.78%, wat erop wijst dat het foutenpercentage waarschijnlijk lager is dan 1.22%; het is niet bewezen dat het nul is.
Hoe maakt de cachetest onderscheid tussen warme en koude reads?
Elke groep vult een prefix van 8k of 32k en herhaalt die na 5, 30 en 120 seconden met een nieuwe slotvraag. Daarna wordt een nieuwe prefix verstuurd als koude controle. Voor beide lengtes hadden 9 van de 9 warme verzoeken een cache-hit, en elke koude controleread las nul gecachte tokens.
Lees verder: de DeepSeek V4.1 Flash-serie
- De Q-score van ByteDance ligt binnen 0.40 punten van deze baseline, maar de resultaten voor functieondersteuning en caching verschillen: DeepSeek V4.1 Flash op ByteDance: tool-aanroepen komen overeen, metering niet.
- Bij Baidu gingen verzoeken verloren door
no_available_channel, wat zichtbaar is in zowel Q als P: DeepSeek V4.1 Flash op Baidu: geen beschikbaar kanaal beïnvloedt Q en P. - Alibaba Cloud wijkt in totaal 0.37 af en is niet te onderscheiden: DeepSeek V4.1 Flash op Alibaba Cloud: eerste token in 1.34s, 99.37 cache.
- Fireworks behaalde 3 van de 9 bij warme verzoeken van 8k, tegenover 9 van de 9 hier: DeepSeek V4.1 Flash op Fireworks: lege antwoorden na stop, 3/9 cache-hits.


