

In de APB Full-run van 2026-11-03/04 zijn Pareto's vier scores Q 44.58, F 93.42, P 57.69 en R 100, met een totaalscore van 68.72. De warme verzoeken van 8k leverden 2 hits op 9 op en die van 32k 3 op 9.
Op 2026-11-03/04 is DeepSeek V4.1 Flash 1017 via AIHubMix getest bij zes aanbieders met de APB Full-suite, met dezelfde vragen, parameters en verzoekscripts voor elk. Dit APB-profiel gaat alleen over Pareto: wat elk onderdeel mat en wat de resultaten waren.
De onderstaande getallen zijn scores, geen ranglijst of aanbeveling van een aanbieder. Eerst komen de vier scores, Q, F, P en R; de totaalscore is een samenvattende index, geen certificering, en heeft geen betrouwbaarheidsinterval. De scoringsregels staan in AIHubMix Provider Benchmark Standard v2.0.
Scores van zes aanbieders
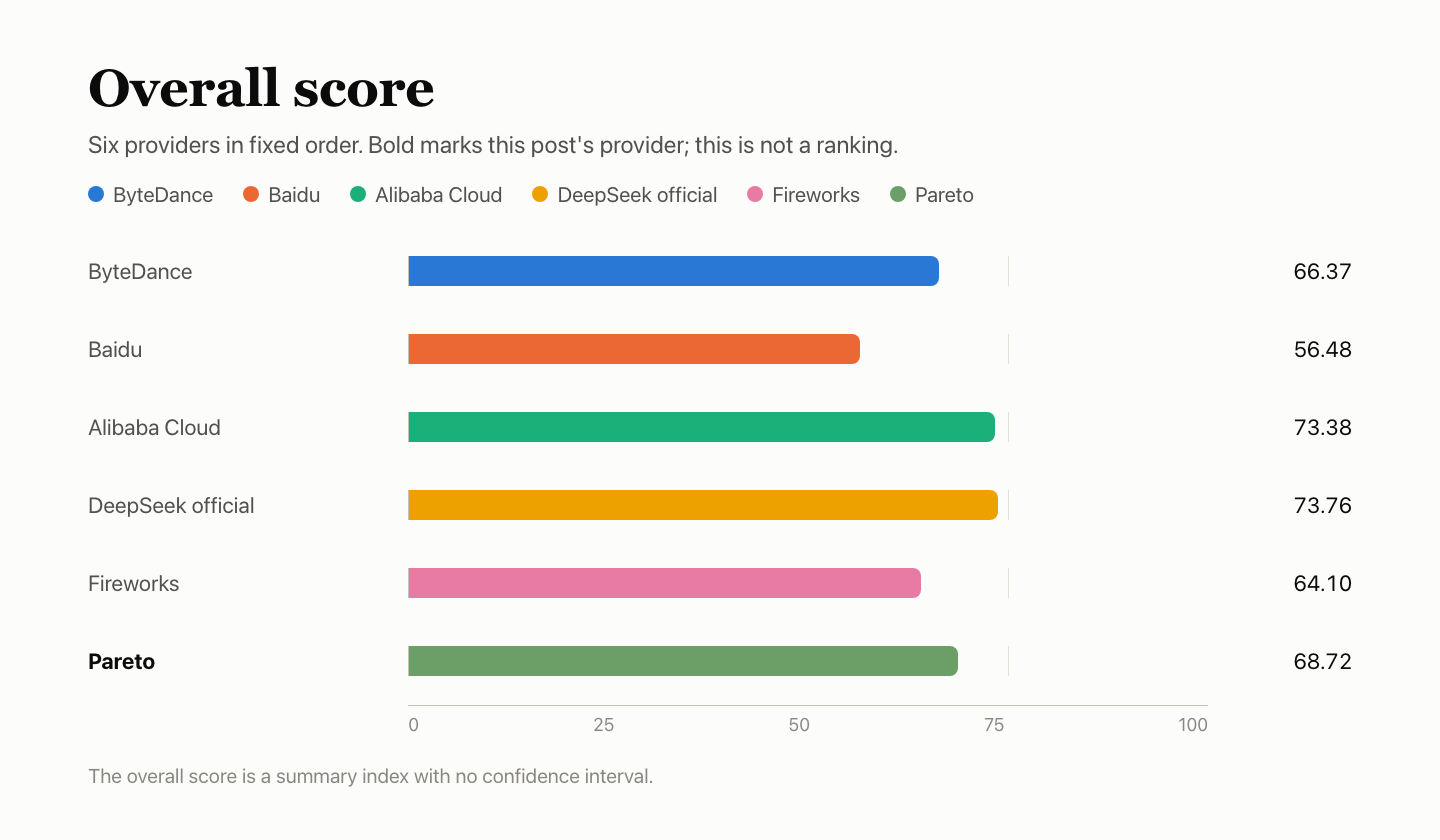
| Aanbieder | Q kwaliteit | F functies | P snelheid | K cache | R stabiliteit | Totaalscore |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Officieel DeepSeek-kanaal | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (dit artikel) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
De aanbieders staan in een vaste volgorde, niet in een ranglijst. K is een deelscore van P, telt voor 20% mee en wordt ter referentie apart vermeld. De totaalscore wordt berekend volgens de samenstellingsregels van AIHubMix Provider Benchmark Standard, waarin ook de vergelijking met het officiële kanaal en de volledigheid van het bewijs worden meegenomen; het is geen rechtstreekse weging van de vier scores in de tabel. Het is een samenvattende index zonder betrouwbaarheidsinterval. Het verschil in totaalscore tussen het officiële DeepSeek-kanaal en Alibaba Cloud bedraagt slechts 0.37 en is niet te onderscheiden.
In één oogopslag
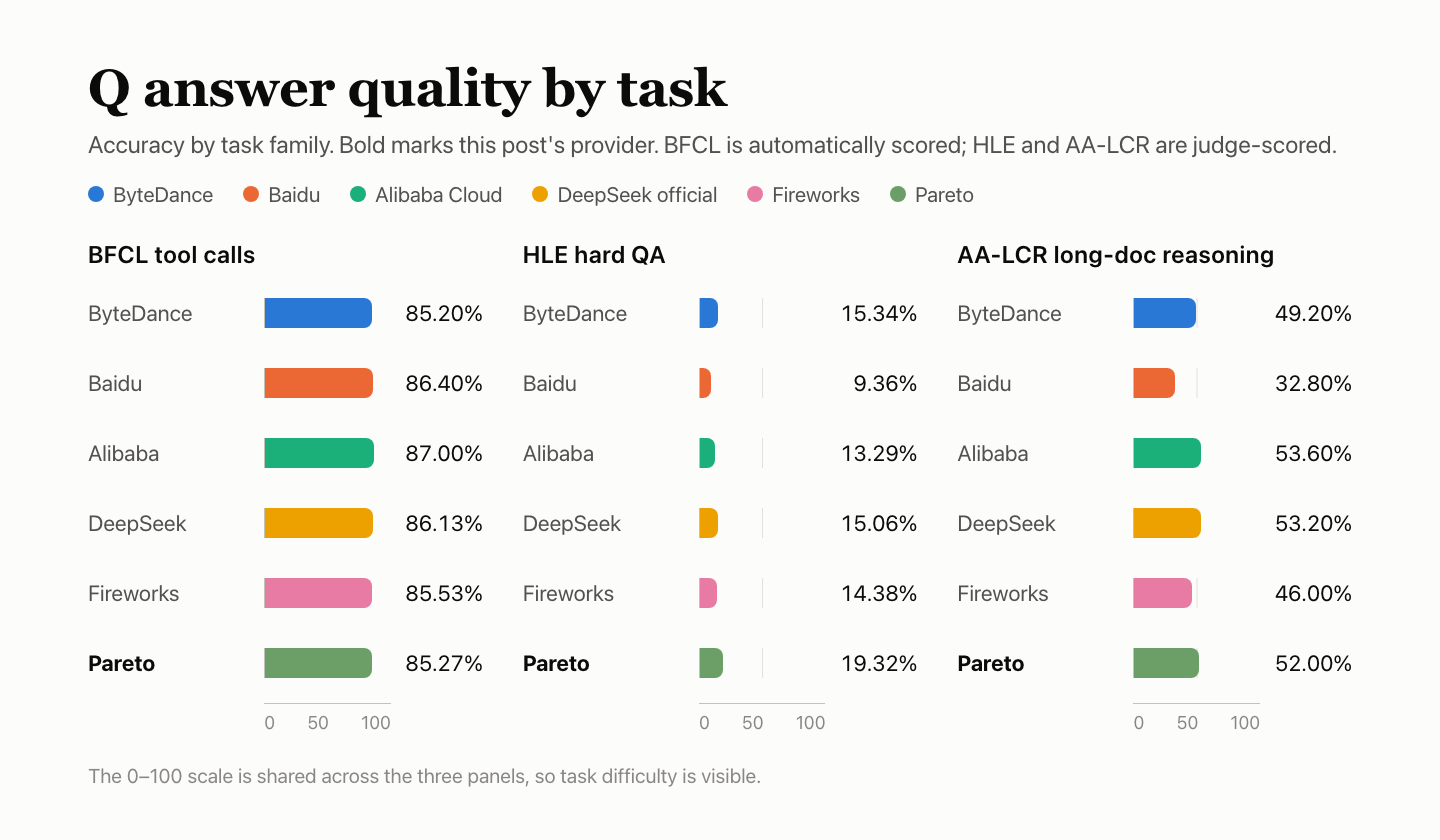
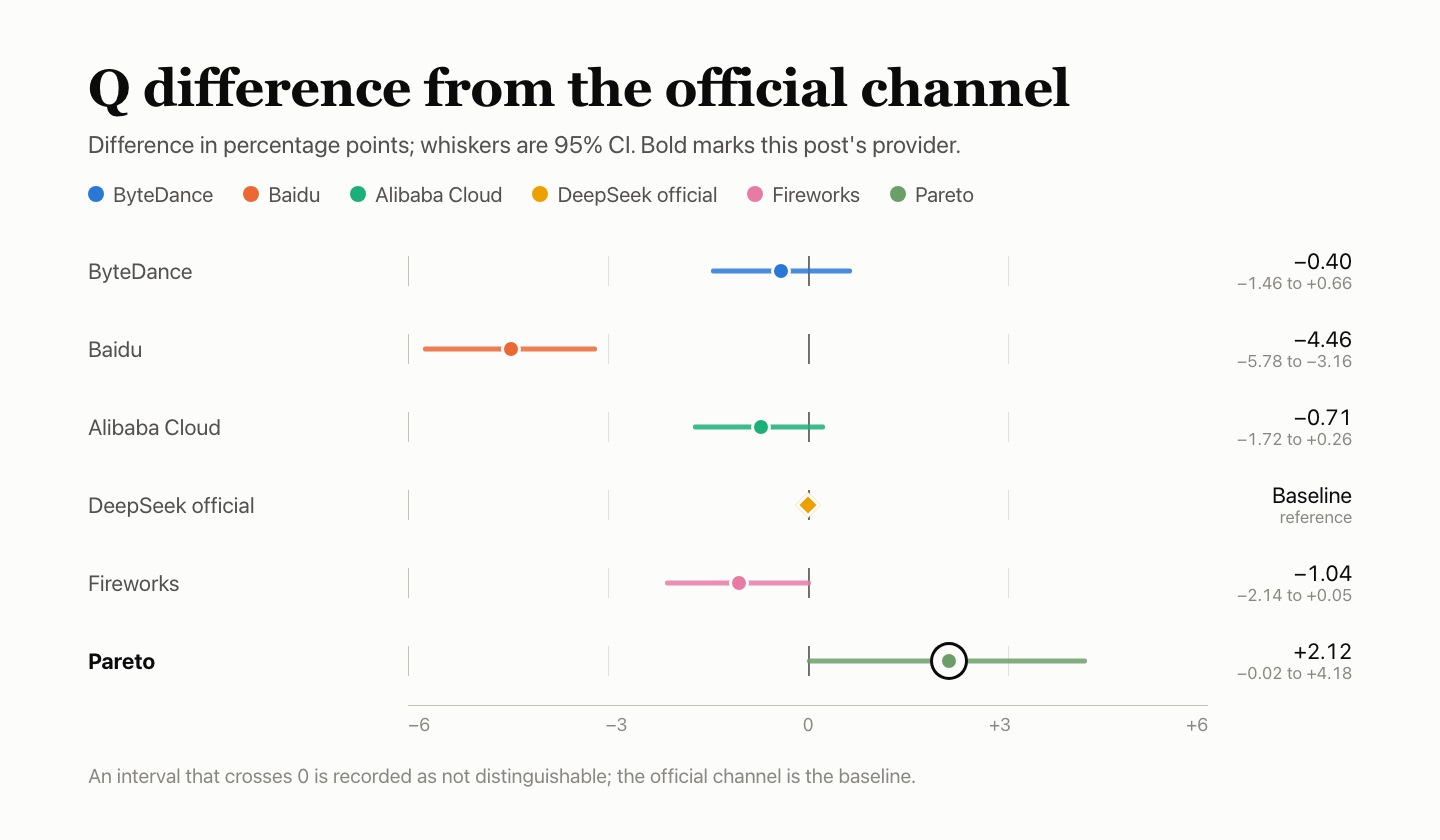
- Antwoordkwaliteit: Q 44.58, met BFCL 85.27%, HLE 19.32% en AA-LCR 52.00%. Het verschil met het officiële kanaal is +2.12 procentpunt, met een interval van 95% van −0.02 tot +4.18: niet te onderscheiden.
- Functieondersteuning: F 93.42, waarbij 29/33 oorspronkelijk gescoorde controles zijn geslaagd. Tool-aanroepen en de round-trip van toolresultaten, parallelle en benoemde aanroepen, de JSON-modus en gespreksgeschiedenis hebben aanvullende geslaagde streamingregistraties; de scores behouden hun oorspronkelijke waarden.
- Reactiesnelheid: P 57.69. De mediaan voor het eerste bodytoken is 5.85 s bij gelijktijdigheid 1 en 6.13 s bij gelijktijdigheid 10, TPOT 4.63 ms; 110 van de 180 snelheidsverzoeken waren geldig.
- Cache: K 27.58. De 8k warme verzoeken leverden 2 hits op 9 op en de 32k warme verzoeken 3 op 9; geen enkele koude controle las uit de cache.
- Servicestabiliteit: R 100. Alle 300 speciale verzoeken slaagden bij de eerste poging.
Testopstelling
| Onderdeel | Details |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagd model-ID | deepseek/deepseek-v4.1-flash |
| Geretourneerde modelnaam | deepseek/deepseek-v4.1-flash |
| Toegangsroute | Via AIHubMix met een aanbieder-specifiek model-ID, niet rechtstreeks verbonden met het account van de aanbieder |
| Parameters | Vast APB v2-verzoekprofiel, temperature 1.0, max_tokens 16,384, time-out van 300 s, geen automatische nieuwe pogingen |
| Tijd | 2026-11-03 18:07 – 11-04 16:33; cacheverzoeken 11-05 19:31 – 11-06 10:35; alle tijden UTC+8. Alle zes aanbieders gebruikten dezelfde Mac mini, hetzelfde netwerk en hetzelfde account. |
| Steekproeven | Q 4,250 vraaginstanties; F 180 controles; P 180 verzoeken; R 300; K 30 |
De verzoeken gebruikten de snelstart-route van AIHubMix met een aanbieder-specifiek model-ID; de ID's van de andere aanbieders staan op de modellenpagina. De parameters van het model zelf worden beschreven in de API-documentatie van DeepSeek.
Q — antwoordkwaliteit: 44.58
De antwoordkwaliteit is gebaseerd op drie suites: 500 BFCL-vragen die elk 3 keer zijn beantwoord, 250 HLE-vragen die elk 10 keer zijn beantwoord en 25 AA-LCR-vragen die elk 10 keer zijn beantwoord. BFCL wordt beoordeeld met automatische regels; HLE en AA-LCR worden door het beoordelingsmodel deepseek-flash als goed of fout beoordeeld. Alle zes aanbieders kregen dezelfde vragen, en de drie suites zijn samengevoegd tot één nauwkeurigheidsscore. Tien antwoorden zijn verwijderd omdat de vraag niet kon worden gescoord, waardoor 4,240 gescoorde vraaginstanties overbleven.
| Suite | Vragen × rondes | Correct | Nauwkeurigheid | Servicefouten |
|---|---|---|---|---|
| BFCL-tool-aanroepen, automatisch gescoord | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE-moeilijke QA, beoordeeld door een beoordelingsmodel | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR-redenering op basis van lange documenten, beoordeeld door een beoordelingsmodel | 25 × 10 | 130/250 | 52.00% | 0 |
| Totaal · interval van 95% 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Elke vraaginstantie kreeg een volledig antwoord; er waren geen servicefouten.
| BFCL-categorie | Geslaagd | Slagingspercentage |
|---|---|---|
| simple_python: één functie, juiste aanroep en argumenten | 333/360 | 92.50% |
| multiple: de juiste kiezen uit meerdere functies | 269/300 | 89.67% |
| parallel: één functie meerdere keren tegelijk aanroepen | 265/300 | 88.33% |
| parallel_multiple: meerdere functies tegelijk | 203/240 | 84.58% |
| irrelevance: geen relevante functie, dus geen aanroep | 109/150 | 72.67% |
| ahm_multi_turn: toolketen in drie stappen | 100/150 | 66.67% |
Elke BFCL-vraag is 3 keer beantwoord; de tabel telt de 3 rondes bij elkaar op.
Vergeleken met de andere vijf
| Aanbieder | BFCL | HLE | AA-LCR | Gecombineerd | T.o.v. officieel |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 tot +0.66), niet te onderscheiden |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 tot −3.16), lager dan officieel |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 tot +0.26), niet te onderscheiden |
| Officieel DeepSeek-kanaal | 86.13% | 15.06% | 53.20% | 42.45% | Referentie |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 tot +0.05), niet te onderscheiden |
| Pareto (dit artikel) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 tot +4.18), niet te onderscheiden |
T.o.v. officieel: het verschil in nauwkeurigheid in procentpunten, met het interval van 95% tussen haakjes; als het interval 0 omvat, wordt het verschil als niet te onderscheiden genoteerd. De beoordelaar voor HLE en AA-LCR, deepseek-flash, behoort tot dezelfde DeepSeek-familie als het geteste model en is niet gekalibreerd, waardoor de beoordelingen mogelijk mild uitvallen.
F — functieondersteuning: 93.42
De functiegevallen controleren of het gedrag van de interface overeenkomt met het protocol. F 93.42 is gebaseerd op de 33 meegetelde controles (waarvan er 29 zijn geslaagd), na hernormalisatie van de waargenomen groepsgewichten; de overige 147 geplande controleplaatsen in de oorspronkelijke suite zijn uitgesloten van de score.
| Casusgroep | Gewicht | Geslaagde observaties / streamingobservaties | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming- en berichtprotocol | 20% | 23/27 | 3 | 85.19 |
| Toolinterface Tool-aanroepen, round-trip van toolresultaten, parallelle en benoemde aanroepen | 20% | Geslaagde streamingobservaties* | 30 | — |
| Uitvoerbeperkingen en parameters JSON-modus en redeneren uitgeschakeld | 20% | Geslaagde streamingobservaties* | 30 | — |
| Context en status Gespreksgeschiedenis en systeeminstructies | 15% | Geslaagde streamingobservaties* | 30 | — |
| Fouten en herstel | 15% | 3/3 | 27 | 100.00 |
| Protocol voor gebruiksmeting en cache | 10% | 3/3 | 27 | 100.00 |
| Totaal · gewogen score | 29/33 | 147 | 93.42 | |
- De vermelde functies hebben geslaagde streamingregistraties; dat levert niet de maximale score op voor de hele groep. Er zijn geen controles aan de score toegevoegd. F 93.42 en de totaalscore van 68.72 behouden hun oorspronkelijke waarden.
| Mislukte casus | Vensters | Reden |
|---|---|---|
| Streaming-stopreeks Streaming- en berichtprotocol | 3/3 | Lege body met een stopreeks; dezelfde invoer werkte zonder stopreeks |
| Exacte teksta uitvoer Streaming- en berichtprotocol | 1/3 | Een extra punt aan het einde brak de overeenkomst met de exacte tekst |
‘Vensters’ geeft aan in hoeveel van de 3 vensters de controle mislukte.
De gevallen met ongeldige berichten en ongeldige streamingopties retourneerden bij meerdere aanbieders 400 met een lege responsebody. De meting van redeneringstokens verschilde per aanbieder.
Vergeleken met de andere vijf
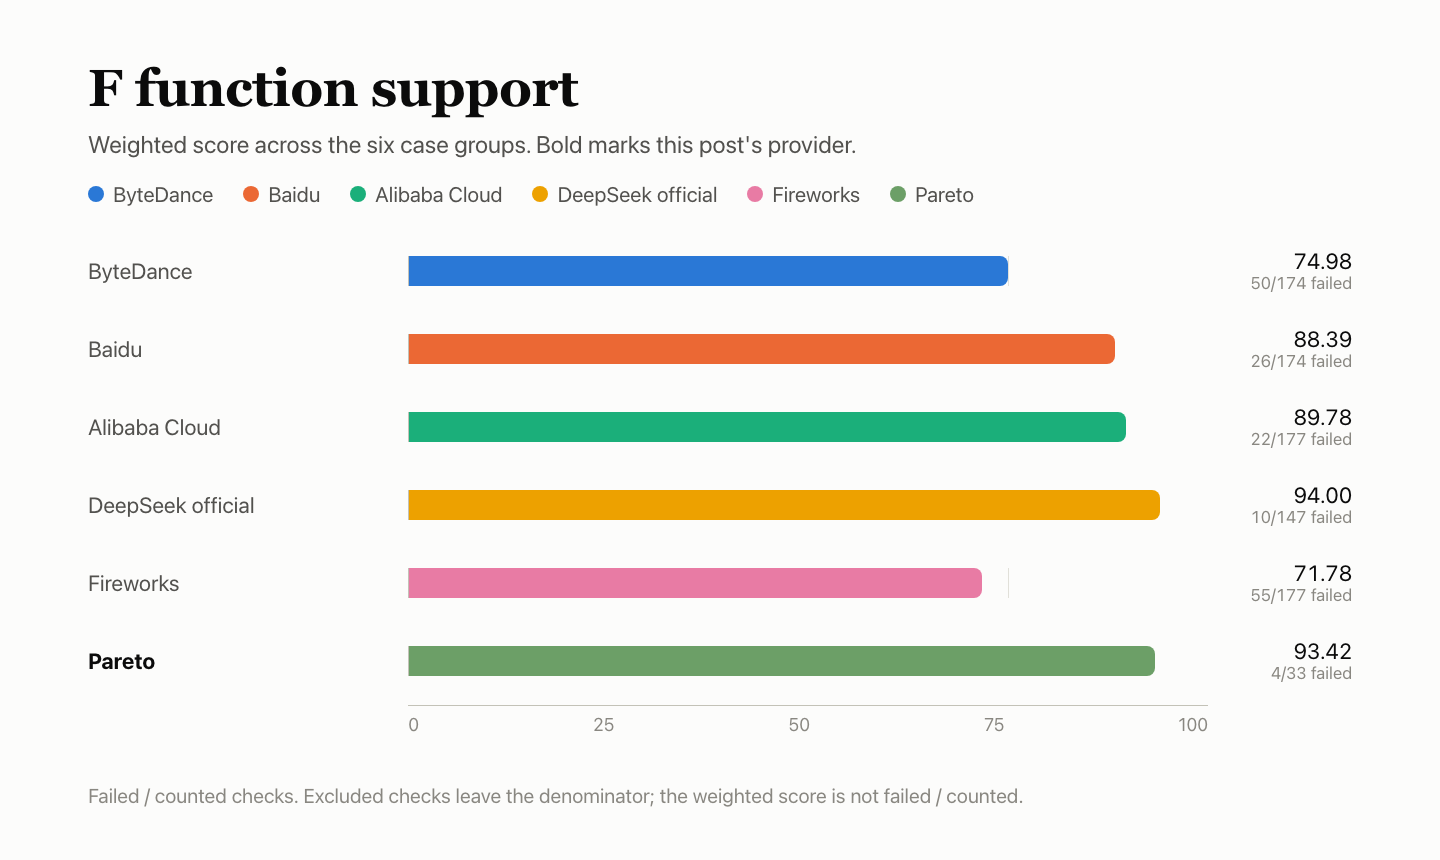
| Aanbieder | Geslaagd | Mislukt | Uitgesloten | Gewogen score |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Officieel DeepSeek-kanaal | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (dit artikel) | 29 | 4 | 147 | 93.42 |
P — reactiesnelheid: 57.69
Elk verzoek bevatte ongeveer 10,000 invoertokens en vroeg om ongeveer 1,100 uitvoertokens aan bodytekst. In elk van de drie vensters werden 30 verzoeken uitgevoerd met gelijktijdigheid 1 en 30 met gelijktijdigheid 10: in totaal 180 verzoeken.
| Onderdeel | Details |
|---|---|
| Eerste bodytoken (TTFA) | Mediaan 5.85 s bij gelijktijdigheid 1 (alleen geldige verzoeken: 3.08 s), 6.13 s bij gelijktijdigheid 10 (alleen geldige verzoeken: 4.92 s) |
| Generatiesnelheid (TPOT) | 4.42 ms/token bij gelijktijdigheid 1, 4.63 ms/token bij gelijktijdigheid 10 |
| Effectieve doorvoer | 519.4 token/s bij gelijktijdigheid 10 |
| Geldige verzoeken | 53/90 bij gelijktijdigheid 1 (vensters 1–3: 15/30, 18/30, 20/30), 57/90 bij gelijktijdigheid 10 (23/30, 16/30, 18/30); ongeldig: 70 retourneerden 200 met None |
| Deelscores | TTFA 24.59, TPOT 100.00, doorvoer 72.05; TTFA en TPOT vallen in de lagere categorie en wegen 35% / 35% / 30%: reactiescore 65.22 |
| P-score | Reactiescore 65.22 × 80% + cache K 27.58 × 20% = 57.69 |
Ongeldige verzoeken worden gescoord als oneindig, waardoor de medianen in de tabel hoger kunnen liggen dan de medianen voor alleen geldige verzoeken. TPOT wordt geschat op basis van gestreamde chunks en niet per token op de hardware gemeten. De doorvoer is het aantal geldige uitvoertokens bij gelijktijdigheid 10, gedeeld door de wandkloktijd van de batch.
Vergeleken met de andere vijf
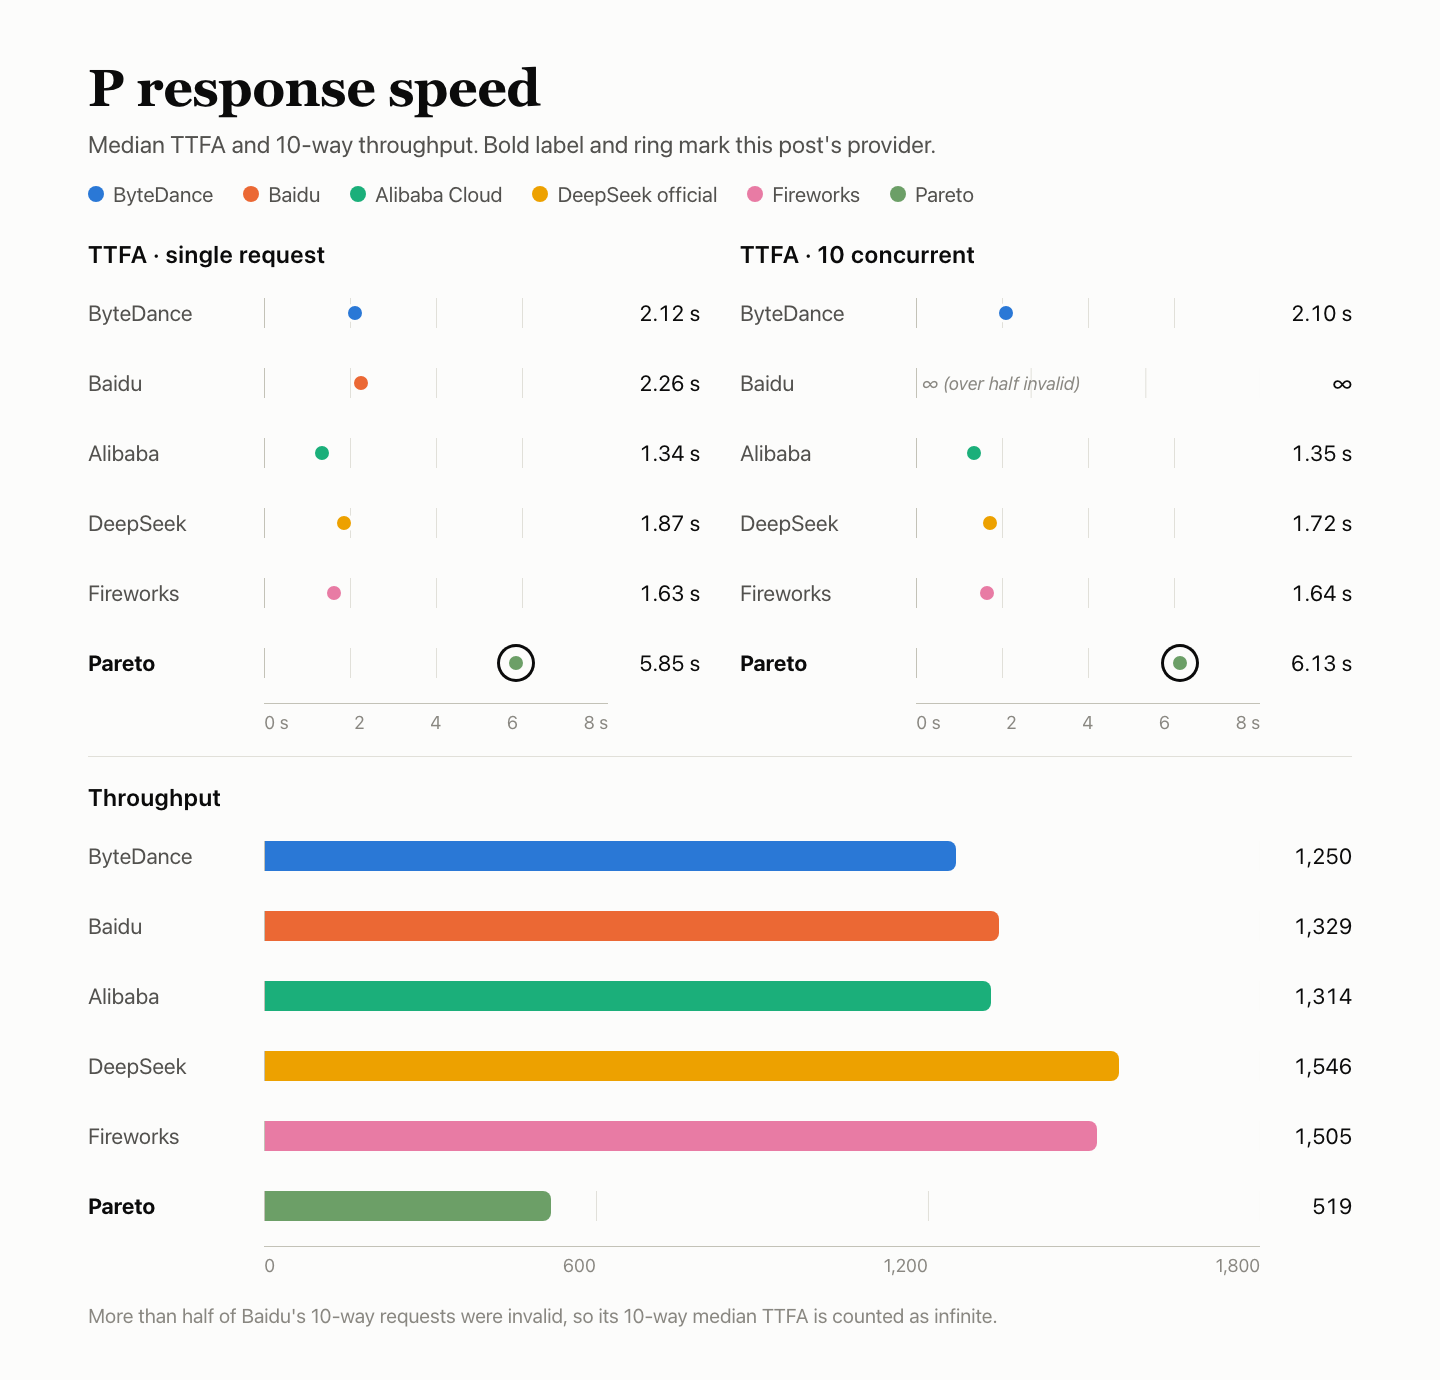
| Aanbieder | Geldige verzoeken | TTFA bij gelijktijdigheid 1 | TTFA bij gelijktijdigheid 10 | TPOT (trager) | Doorvoer tok/s | Reactie |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Officieel kanaal van DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (dit artikel) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Alle zes gebruikten dezelfde machine, hetzelfde netwerk en hetzelfde account. De drie meetvensters waren per aanbieder ingepland, waardoor de meetperioden niet volledig overlappen; kleine verschillen moet je dus niet overinterpreteren. ∞ betekent dat meer dan de helft van de verzoeken ongeldig was, waardoor de mediaan als oneindig telt.
K — cache: 27.58
Elke groep verstuurt vijf verzoeken. Het eerste bevat een vaste prefix van ongeveer 8k of 32k tokens en vult de cache. Verzoeken 2–4 behouden de prefix en wijzigen alleen de laatste vraag, met tussenpozen van 5 s, 30 s en 120 s. Het vijfde gebruikt een nieuwe prefix als koude controle. Drie vensters × twee lengtes leveren 30 verzoeken op. K is het aantal cachetokens dat door warme verzoeken is gelezen, gedeeld door het aantal tokens dat volgens de regels herbruikbaar zou moeten zijn; beide lengtes wegen even zwaar mee. K vormt 20% van P.
| Venster | 1 · vullen | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · koud |
|---|---|---|---|---|---|
| 8k-prefix · warme cache-hits 2/9 · 15,872 van 72,504 herbruikbare tokens gelezen · 21.89 | — | — | — | — | — |
| Venster 1 | 0 | 0 | 7,936 | 0 | 0 |
| Venster 2 | 0 | 0 | 0 | 0 | 0 |
| Venster 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k-prefix · warme cache-hits 3/9 · 96,000 van 288,513 herbruikbare tokens gelezen · 33.27 | — | — | — | — | — |
| Venster 1 | 0 | 0 | 32,000 | 0 | 0 |
| Venster 2 | 0 | 0 | 0 | 0 | 0 |
| Venster 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k en 32k wegen even zwaar mee) | — | — | — | — | 27.58 |
De waarden zijn de door de server gemelde cachetokens die zijn gelezen; ‘Niet geretourneerd’ betekent dat het veld ontbrak in het antwoord.
De warme verzoeken met 8k-prefix hadden 2 hits op 9 en lazen bij elke hit 7,936 tokens; de warme verzoeken met 32k-prefix hadden 3 hits op 9 en lazen bij elke hit 32,000 tokens. Koude verzoeken lazen niets uit de cache, waardoor warm en koud duidelijk van elkaar te onderscheiden zijn.
Vergeleken met de andere vijf
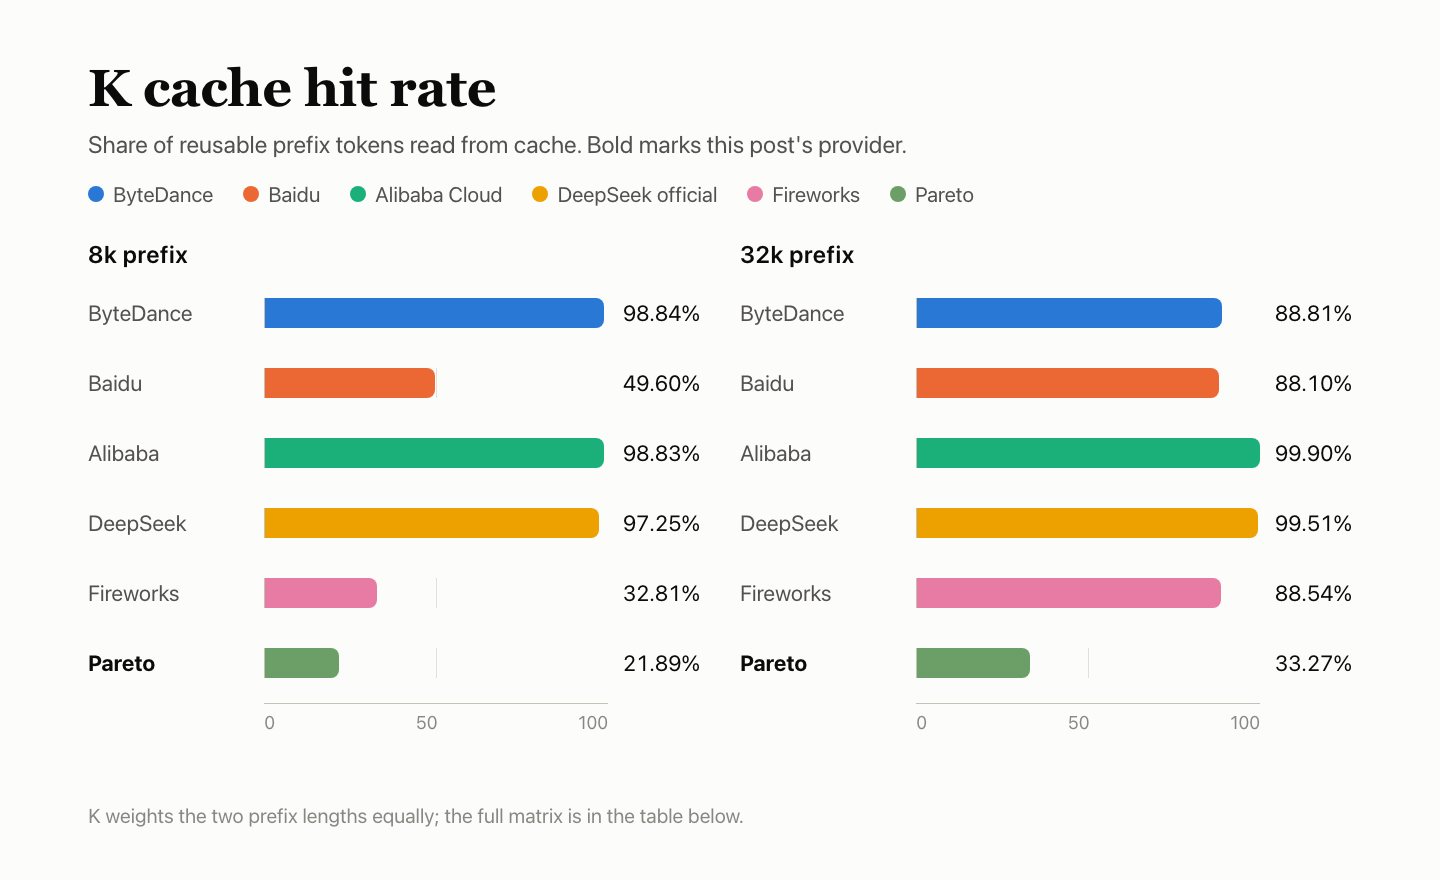
| Aanbieder | 8k-hits | 8k | 32k-hits | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Officieel kanaal van DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (dit artikel) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — servicebetrouwbaarheid: 100
De 300 verzoeken zijn verdeeld over vier typen: korte tekst, lange invoer, tool-aanroepen en conversatiegeschiedenis met meerdere beurten. Ze zijn in drie vensters met één gelijktijdig verzoek uitgevoerd. Alleen is gecontroleerd of de eerste poging een geldig, volledig antwoord opleverde; antwoorden zijn niet beoordeeld en er is niets opnieuw geprobeerd. Mislukkingen in de secties over antwoordkwaliteit en snelheid tellen mee voor Q en P, niet nogmaals voor R.
| Type verzoek | Succes bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Conversatiegeschiedenis met meerdere beurten | 30/30 |
| Totaal · 95%-interval 98.78%–100% | 300/300 |
Alle 300 verzoeken leverden bij de eerste poging een geldig, volledig antwoord op. R = 100 geldt alleen voor deze 300 afzonderlijke verzoeken; het betekent niet dat de hele keten foutloos was. De ondergrens van het 95%-interval is 98.78%: 300 successen uit 300 kunnen alleen aantonen dat het foutpercentage waarschijnlijk lager is dan 1.22%.
Vergeleken met de andere vijf
| Aanbieder | Succes bij eerste poging | 95%-interval |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Officieel kanaal van DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (dit artikel) | 300/300 | 98.78%–100% |
R omvat alleen deze 300 afzonderlijke verzoeken; mislukkingen in de secties over antwoordkwaliteit en snelheid worden geregistreerd bij Q en P en tellen niet nogmaals mee voor R.
Veelgestelde vragen
Waarom is F 93.42 als er maar 33 controles zijn geteld?
Van de 33 daadwerkelijk getelde controles slaagden er 29. Na herweging van de waargenomen groepsgewichten kwam F uit op 93.42; de overige 147 geplande controleplaatsen zijn buiten de scoreberekening gehouden. De streamingregistraties beschrijven specifieke werkende functies en voegen geen controles toe aan de score. De weergegeven totaalscore blijft 68.72.
Waarom is P 57.69 terwijl TPOT 100.00 scoorde?
Slechts 110 van de 180 snelheidsverzoeken waren geldig; bij 70 werd 200 geretourneerd met None. Ongeldige verzoeken tellen als oneindig, waardoor de mediaan voor de eerste bodytoken 5.85 s is bij één gelijktijdig verzoek en 6.13 s bij 10 gelijktijdige verzoeken (respectievelijk 3.08 s en 4.92 s voor alleen de geldige verzoeken). TTFA scoorde 24.59 en de doorvoer 72.05, wat een responsscore van 65.22 oplevert; met cache-K 27.58, die voor 20% meetelt, komt P uit op 57.69.
Waarom is K slechts 27.58?
Bij de warme verzoeken waren er 2 hits op 9 bij 8k (21.89) en 3 op 9 bij 32k (33.27); beide lengtes wegen even zwaar mee. Bij een hit werden 7,936 of 32,000 tokens gelezen; geen enkele koude controle las uit de cache.
Is de antwoordkwaliteit van Pareto beter dan die van het officiële kanaal?
Niet aantoonbaar. De gecombineerde nauwkeurigheid is 44.58% tegenover 42.45%, een verschil van +2.12 procentpunt, maar het 95%-interval loopt van −0.02 tot +4.18 en omvat 0. De beoordelaar voor HLE en AA-LCR, deepseek-flash, was niet gekalibreerd en kan soepel beoordelen.
Welke F-tests zijn mislukt?
Twee. Bij de streaming-stopreeks kwam in alle drie de vensters een lege body terug, terwijl dezelfde invoer zonder stopreeks wel werkte. Bij de exacte tekstuitvoer stond in één van de drie vensters een extra punt aan het einde.
Lees verder: de DeepSeek V4.1 Flash-serie
- De Q-kloof van Pareto, +2.12, is gemeten ten opzichte van het officiële kanaal; de eigen test van de baseline staat in Review van DeepSeek V4.1 Flash via het officiële DeepSeek-kanaal: vergelijkingsbaseline, 15 ongeldige verzoeken bij één gelijktijdig verzoek.
- Ook Fireworks retourneerde lege bodies bij stopverzoeken en had 3 hits op 9 bij 8k: Review van DeepSeek V4.1 Flash op Fireworks: stopverzoeken leveren een lege body op, 3 van de 9 warme cacheverzoeken met 8k-prefix zijn hits.
- Bij Alibaba Cloud waren alle 18 warme verzoeken een hit, tegenover 5 van de 18 bij Pareto: Review van DeepSeek V4.1 Flash op Alibaba Cloud: eerste bodytoken na 1.34s, alle 18 warme verzoeken zijn cache-hits, antwoorden niet te onderscheiden van die van het officiële kanaal.
- Alle snelheidsverzoeken bij ByteDance waren geldig; de eerste bodytoken verscheen na 2.12 s: Review van DeepSeek V4.1 Flash op ByteDance: antwoorden niet te onderscheiden van die van het officiële kanaal, invoeraantallen komen niet overeen.
- Ook bij Baidu vielen veel snelheidsverzoeken uit door no_available_channel: Review van DeepSeek V4.1 Flash op Baidu: toolaanroepen even goed als bij het officiële kanaal, frequente no-available-channel-fouten drukken de antwoordkwaliteit en snelheid.
Bronnen
- DeepSeek V4.1 Flash-modelpagina 1017 (AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0 (AIHubMix-documentatie)
- Snel aan de slag (AIHubMix-documentatie)
- Modellen (AIHubMix)
- DeepSeek API-documentatie (DeepSeek)


