

Gemini 4 Hydrogenのトークン単価は、Gemini 3.8 Flashの導入価格の2倍です。入力トークン100万個あたり$1.50、出力トークン100万個あたり$7.50で、Flashはそれぞれ$0.75と$3.75です。Artificial Analysisのリアルタイム測定では、Hydrogenはインデックスタスクを$1.87で完了します。一方、Gemini 3.8 Flashは$7.77かかります。トークン単価は2倍になりましたが、タスク完了あたりのコストは約4分の1に下がりました。
このアップグレードが異例なのはこの点です。GoogleはGemini 3.8 Flashや、それ以前のGemini 3および2.5モデルからのアップグレード先としてHydrogenを推奨していますが、Flashの刷新版ではありません。モデルカードには、率直にこう記されています。「Gemini 4 HydrogenはGemini 4 Carbonを基に調整されています」。Gemini 4のコンテキストウィンドウ、Gemini 4の長文デコード経路、新しい思考レベルxhighを受け継ぎながら、Flash向けの役割、つまり高速かつ大規模な実行に特化しています。
その結果、トークン単価よりもタスク単位の予算で正当化しやすいモデルになっています。以下では、何が変わったのか、測定結果が示すこと、アップグレードの限界、そしてAIHubMix経由での呼び出し方を解説します。
Hydrogenとは
Gemini APIの変更履歴によると、Hydrogenは2026-11-12に一般提供が開始され、モデルカードも同日付です。Googleはリリース記事でHydrogenを「エージェントワークフローのための、日常使いのモデル」と呼び、CarbonとArgonを「深く長期的な推論のために構築された」モデルとして位置付けています。モデルカードによれば、Hydrogenは「多様なエージェントワークフローを迅速に実行するために構築された」モデルで、単独でも、最先端モデルと並ぶサブエージェントとしても実行できます。
APIユーザーにとって重要なリリース情報は3つあります。Gemini 4モデルで唯一、無料枠があり、Googleは「Google AI StudioとGemini APIの無料枠と有料枠の両方で利用可能」としています。また、xhigh思考モードに対応するGemini 4モデルもHydrogenだけです。さらに、変更履歴によると、Gemini Managed AgentsのAntigravityエージェントでデフォルトモデルに設定されています。
注意点を先に挙げておきましょう。Googleのエンタープライズ向けドキュメントでは、Hydrogenは「廃止の最低45日前通知ポリシーが適用される、短期の一般提供(GA)リリース」とされています。非推奨モデルのページには終了日が記載されていませんが、長期にわたる依存関係を計画するチームは、この一文をモデル文字列を設定可能にしておくべき警告と受け取るのがよいでしょう。
Gemini 3.8 Flashからの変更点
2つのモデルは、価格帯から想像される以上に多くの点を共有しています。GoogleのAPIでは、どちらも1,048,576トークンのコンテキストに対応し、テキスト、画像、音声、動画を入力でき、無料枠でも利用できます。AIHubMixのモデルページでは、Hydrogenはテキスト、画像、音声、動画、PDFの入力とテキスト出力に対応しています。Googleのエンタープライズ向けページにはOfficeとOpenDocumentも記載されていますが、ゲートウェイのページにはありません。違いは、出力上限、思考モードのデフォルト、API仕様の範囲にあります。
| 項目 | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| コンテキストウィンドウ | 1,048,576 トークン | 1,048,576 トークン |
| 最大出力 | 長文デコードで1,048,576トークン | 65,536トークン |
| 同期出力 | 1ホップあたり65,536トークン(ストリーミングの有無を問わず) | 65,536トークン |
| 思考レベル | low、medium、high(デフォルト)、xhigh | low、medium(デフォルト)、high |
| 入力モダリティ | テキスト、画像、音声、動画、PDF、Office | テキスト、画像、音声、動画、PDF |
| 無料枠 | あり | あり |
| キャッシュ | 暗黙的のみ、最低4,096トークン | 暗黙的および明示的 |
Hydrogenは4つ目のレベルxhighを追加し、デフォルトをmediumからhighに変更しています。また、ストリーミングと非ストリーミングの両方で、同期処理の1ホップあたり最大65,536トークンを許可します。CarbonとArgonでは、ストリーミング時のみ65,536トークンで、その他の場合は32,768トークンです。長い出力には、Gemini 4ファミリーの他モデルと同じバックグラウンドまたは継続トークンの経路を使い、入力分を差し引いた最大1,048,576トークンまで出力できます。
ターンあたりのコストはデフォルト設定に左右されます。Hydrogenは、mediumがデフォルトのモデルよりも1ターンあたりに多くの思考トークンを消費し、出力トークンには思考トークンも含まれます。レベルを指定せずにワークロードを移行すると、トークン単価の差を考慮する前から、通常は3.8 Flashよりもターンあたりのコストが高くなります。
測定結果が示すアップグレード:タスクあたりのコストを抑えつつ、インデックスが20ポイント向上
Artificial Analysisの測定では、Hydrogenはhigh設定でIntelligence Index 51、78モデル中21位でした。Gemini 3.8 Flashはhigh設定で31、54位です。一方、タスク料金は逆の結果となり、Hydrogenが$1.87、Flashが$7.77でした。
| モデル/effort | AA順位 | AA Index | $/タスク | 分/タスク | 最初の回答トークン |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
これらの数値は、2026-11-13T02:40Z時点で取得したArtificial Analysisのリアルタイム測定値で、Intelligence Index v5.0.1の78モデルを対象としています。標準価格を使用しており、AIHubMixの請求額ではありません。どちらもhigh設定での結果なので条件はそろっていますが、highはHydrogenのデフォルトであり、Flashのデフォルトではない点に注意してください。デフォルト設定同士で比較すると、Flashはmedium設定で30、タスクあたり$6.26となります。数値は変わりますが、傾向は変わりません。
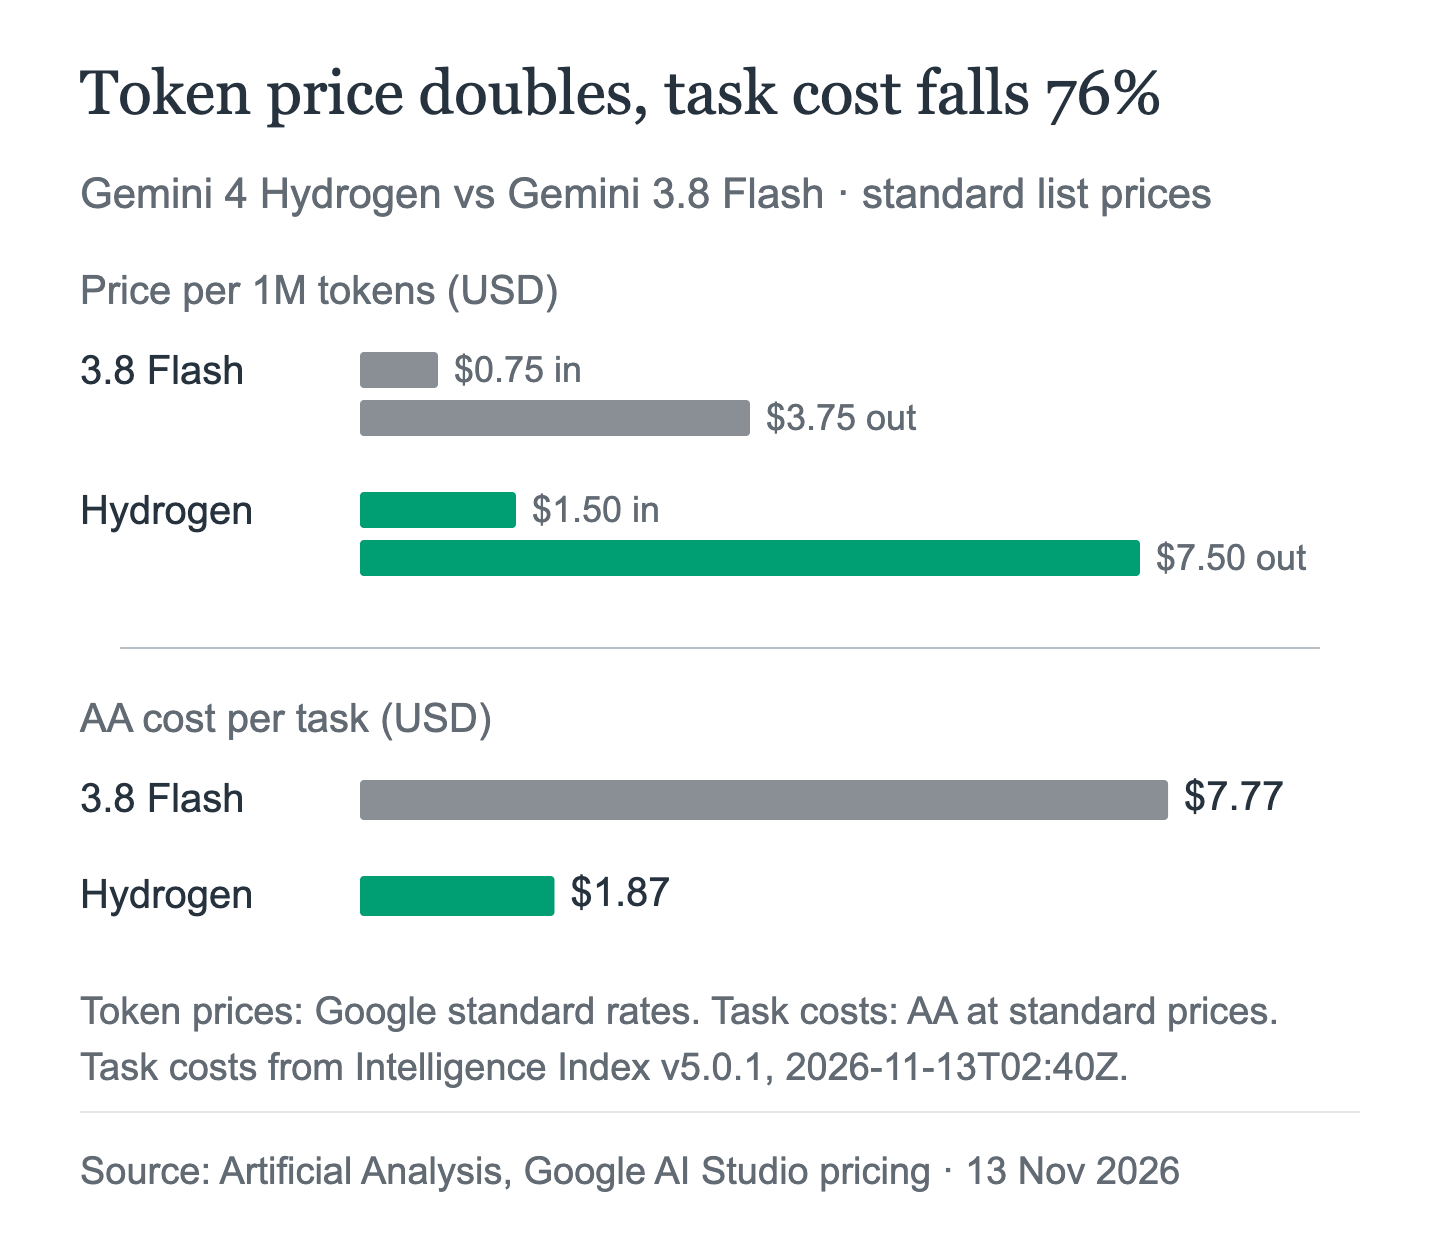
注目すべきなのは、タスクあたりの結果です。Hydrogenのトークン単価はFlashの導入価格の2倍ですが、測定上のタスクあたりコストは75.9%低くなっています。この差は、同じ作業を終えるのに各モデルが消費するトークン数によるもので、トークン単価だけでは分かりません。Hydrogenの最初の回答トークンが届くまでの時間は18.89秒で、Flashの17.53秒より約1.4秒遅い一方、タスク完了までの時間は8.3分で、Flashの14.7分を下回ります。
xhighでは、Hydrogenは54を記録し、タスクあたり$3.16、所要時間13.5分、最初のトークンまで37.77秒です。同じスナップショットにおけるGemini 4 Argonのhigh(50)を4ポイント上回り、Carbonのhigh(60)を6ポイント下回ります。このシリーズでは4つのレベルをそれぞれ取り上げています。要点だけ述べると、highはコストパフォーマンス重視の設定、xhighは難しいタスク向けです。
Googleのベンチマーク表と、Hydrogenが負ける3項目
Googleのモデルカードはベンダー資料であり、2026-11-12に公開された自己申告の結果で、旧世代のGeminiモデルではなく2つの競合モデルを比較対象としています。Hydrogenは、掲載された10項目中7項目で首位です。参考になるのは、負けた3項目です。
| ベンチマーク | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
Terminal-Bench 4.1には、モデルカードで「不正行為調整済み」と記されています。Sonnet 5.5はTerminal-Bench 4.1(63.9対57.0)、OSWorld-2.1(83.9対77.6)、Terminal-Bench-Science 0.1(59.9対51.4)で勝っています。より高価なモデルに追加料金を払う価値があるのは、こうした項目です。Anthropicの価格表ではSonnet 5.5は入力$2、出力$10です。つまり、Hydrogenはトークン単価が25%安く、モデルカードの大半で勝つ一方、エージェント性や科学的な能力が特に問われる3項目では負けています。
この表にCarbonの数値を並べないでください。CarbonのモデルカードではTerminal-Bench4.0が65.2、HydrogenのモデルカードではTerminal-Bench4.1が57.0です。ベンチマークのバージョンも比較対象も異なるため、同じ列で比較することはできません。
Googleのリリース記事には、モデルカードにはない主張もあります。HydrogenはGemini 3.8 Flashより「デフォルトのhigh設定で2.5倍速く」タスクを完了し、捏造された主張を「5倍以上」減らすとしています。また、Agent Arenaで5位、Vals Tax Agent Benchで1位(52.3%)、Vals Legal Research Benchで首位タイ(55.8%)と主張しています。これらはベンダーの報告値であり、ここでは独立した再現検証を行っていません。
価格:トークン単価は2倍でも、タスクあたりのコストは低い
Hydrogenの標準価格は、入力$1.50、出力$7.50、キャッシュ済み入力$0.075です。BatchとFlexはその半額、Priorityはそれぞれ$2.70と$13.50です。コンテキストウィンドウ全体で価格は一律です。
| モデル/プラン | 入力 | キャッシュ済み入力 | 出力 | 適用期間 |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | 現在 |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | 現在 |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | 現在 |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | 2026-12-31まで |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | 2027-01-01から |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | 2026-11-30まで |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | 2026-12-01から |
公式価格(USD、トークン100万個あたり)。Googleの価格ページから。2026-11-13に確認。Hydrogenの今後の価格変更は発表されていません。
この表から2つの比較ができます。Hydrogenの入力・出力単価は、2027-01-01以降のGemini 3.8 Flashの標準単価とまったく同じなので、「2倍高い」という差は元日に解消されます。CarbonとArgonと比べると、Hydrogenは11月30日まではトークン単価が25%安く、12月1日に両モデルの価格が2倍になった後は62.5%安くなります。
AIHubMixのHydrogen価格は$1.50、$7.50、$0.075で、Googleの標準価格と一致しています。無料枠はGoogleのもので、ゲートウェイのものではありません。AIHubMix経由の利用は有料です。
Hydrogenがアップグレード先にならないケース
対応プロトコルの範囲が狭い。CarbonとArgonのスキーマには、Chat Completions、Responses、Anthropic Messages、ネイティブGeminiの各項目があります。2026-11-11時点のモデルインデックスのスナップショットにはHydrogenのスキーマ項目がなく、ドキュメントに記載されているのはPOST /v1/chat/completionsのみです。Codex形式のResponsesクライアントやClaude Code形式のAnthropicクライアントを使う場合は、確認せずにHydrogenが動作すると想定しないでください。
短期のGAリリースである。廃止の45日前通知ポリシーは計画上の制約ですが、このモデルを避けるべき理由ではありません。モデル IDをコードに直接書かず、設定で管理すべき理由です。
一部のプラットフォーム機能に対応していない。Googleのエンタープライズ向けページでは、HydrogenはGemini Live API、RAG Engine、Tuning、固定クォータに非対応とされています。Batch推論には対応しています。
安全性の評価は一長一短。モデルカードによると、テキストの安全性はGemini 3.8 Flashより高い一方(テキスト間で+0.80pp、多言語で+1.10pp)、正当な理由のない拒否は5.57パーセントポイント多く、特にマルチモーダルのプロンプトでその傾向が見られます。トーンの評価も0.65ポイント低くなっています。これらは自動評価の結果であり、レッドチームテストではありません。
Carbonはいまも品質の上限です。Hydrogen highは51で、Carbon highの60に及ばず、Hydrogen xhighの54も6ポイント届きません。難しいデバッグ、アーキテクチャ、科学研究、セキュリティ分析では、Carbonの追加の思考能力こそが製品の強みです。
低いレベルを選べば、品質を犠牲にすることになります。Hydrogen mediumのAAスコアは41、lowは27です。mediumに落として旧モデルのデフォルト設定に実質的に合わせる移行では、トークン料金の節約を大きく上回る品質低下が起きます。
AIHubMix経由での呼び出し方法
ドキュメントに記載された接続方法は、OpenAI互換のチャット補完エンドポイントです。モデルページには、VertexAIとGoogle AI Studioの2つのプロバイダーが記載されており、自動再試行にも対応しています。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
エンドポイントはPOST /v1/chat/completionsです。AIHubMixでは、Hydrogenの入力形式としてテキスト、画像、音声、動画、PDFが記載され、出力はテキストに対応しています。一方、reasoning、ツール使用、構造化出力の機能フラグは公開されていません。また、Geminiガイドで扱っているのはGemini 2.5時代の思考制御であり、Gemini 4のレベルではありません。Googleのthinking_levelパラメーターや、新しい値xhighがゲートウェイ経由で渡されるとは限らないため、前提にしないでください。ルートで長時間のデコードが確認されるまでは、max_tokensを同期処理の上限である65,536以内にしてください。この記事では実際のテストを行っていないため、サンプルはリクエストの形式を示すものであり、レスポンスを検証したものではありません。
今すぐ切り替えるべき人
Gemini 3.8 Flashを使っていて、トークンごとに料金を支払っているなら、今すぐ切り替えましょう。Artificial Analysisの測定では、インデックスが20ポイント高い一方、タスク完了あたりのコストは76%低くなっています。また、無料枠を使えば、費用をかけずに自分のプロンプトで品質を確認できます。ワークロードの量が多く、テキスト出力のChat Completionsで処理できる場合や、マルチモデルのループでCarbonと併用する安価な実行モデルを探している場合も、切り替えを検討してください。
クライアントがResponsesまたはAnthropic Messagesプロトコルに依存している場合、タスクがデバッグ、アーキテクチャ、セキュリティなどの特に難しい領域でCarbonの上限性能が重要な場合、または45日前の廃止通知ではリリースサイクルに対応できない場合は、切り替えを待ちましょう。
どちらとも言えない場合は、まずテストしましょう。実際のリクエストを20〜50件、Hydrogen highとデフォルト設定のGemini 3.8 Flashで実行し、トークンあたりのコストではなく、タスク完了あたりのコストを比較してください。この判断でCarbonを比較する際には、AIHubMixの比較ページが役立ちます。
よくある質問
HydrogenはGemini 3.8 Flashより安いですか?
トークンあたりの料金なら、いいえ。$1.50/$7.50で、導入価格の$0.75/$3.75より高くなります。一方、タスク完了あたりでは、Artificial Analysisの測定値は$1.87対$7.77で、約76%低くなっています。タスクあたりのコストは、料金表だけでなくトークンの使用量にも左右されます。
HydrogenはGemini 3.8 Flashの改名モデルですか?
いいえ。Googleのモデルカードによると、HydrogenはGemini 4 Carbonをベースに調整されており、Googleは3.8 Flashからのアップグレード先として推奨しています。コンテキストの扱いが異なり、思考レベルが4段階あり、デフォルト設定も異なります。
Hydrogenは画像を受け付けますか?
はい。Googleのプラットフォームは、テキスト、画像、音声、動画、PDF、Officeファイルを受け付けます。AIHubMixのモデルページには、テキスト、画像、音声、動画、PDFの入力とテキスト出力が記載されていますが、OfficeとOpenDocumentは記載されていません。
AIHubMixでは無料枠を利用できますか?
いいえ。無料枠はGoogleがAI StudioとGemini APIで提供しているものです。AIHubMix経由の利用は有料で、料金は$1.50/$7.50です。
思考レベルのデフォルト設定は何ですか?
highです。Gemini 3.8 Flashのデフォルトはmediumでした。Hydrogenではhighより上にxhighが追加されています。
HydrogenはCarbonより優れていますか?
いいえ。AAインデックスでCarbon highは60で、Hydrogen highの51やxhighの54を上回り、タスクあたりのコストも高くなります。Hydrogenは安価な実行モデルであり、最先端モデルではありません。
AIHubMix経由で思考レベルを設定できますか?
ドキュメント上では確認できません。AIHubMixはHydrogenのreasoning機能フラグを公開しておらず、GeminiガイドにもGemini 4のレベルは記載されていません。設定に依存する前に確認してください。
続きを読む:Gemini 4 Hydrogenシリーズ
- どの思考レベルを使うべきかが気になる場合は、次の記事で4つのレベルを同じインデックスで測定し、どの段階から効果が頭打ちになるかを示します。Gemini 4 Hydrogenの思考レベル:low、medium、high、xhigh。
- HydrogenをCarbonやArgonと併用すべきかが気になる場合は、3つ目の記事で価格、レイテンシ、ワークロード表とともに3モデルを比較します。Gemini 4 Carbon vs Hydrogen vs Argon:用途に応じたモデルの選び方。
出典
- Google、Gemini 4 Hydrogenの紹介
- Google AI Studio、Gemini 4 Hydrogen:新機能
- Google DeepMind、Gemini 4 Hydrogenモデルカード
- AIHubMix、Gemini 4 Hydrogen
- Artificial Analysis、Gemini 4 Hydrogen — 2026-11-13T02:40Z時点のライブスナップショット、Intelligence Index v5.0.1


