Gemini 4 Carbonは新しいモデルファミリーではありません。Gemini 4 Argonを1ターンあたり多く思考させたモデルで、トークン単価は同じです。2026年11月30日までは導入価格として入力トークン100万個あたり$2、出力トークン100万個あたり$10、12月1日以降はそれぞれ$4と$20です。問題は、どちらのトークン単価が安いかではありません。両者は同じです。問題は、追加の思考によってタスク完了あたりの価値が十分に高まり、最初の応答が遅くなることを正当化できるかどうかです。
Artificial Analysisのリアルタイムデータは、ある種の作業には明確な答えを示し、別の作業にははっきりと注意を促しています。Carbon HighはAA Intelligence Indexで104モデル中4位、スコアは60.03で、Argon Highの50.41を上回っています。タスクあたりのコストはArgon Highの$9.95に対して$7.76、完了時間は29.0分に対して25.6分です。しかし、最初の回答トークンが届くまでの時間は、Argonの40.1秒に対して67.1秒です。キュー処理ならCarbonのほうが優れています。対話ならArgonのほうが適しています。
この記事の要点はこの違いです。以下では、何が変わったのか、測定結果が何を示しているのか、Googleのモデルカードから何が分かるのか、12月1日に価格がどう変わるのか、そしてどのワークロードではArgonを使い続けるべきかを説明します。
Argonからの変更点
Googleのモデルカードには、両モデルの関係が明記されています。「Gemini 4 CarbonはGemini 4 Argonをベースにしています」。モデル IDはgemini-4-carbonで、AIHubMixでも同じです。Googleが公開しているコンテキストウィンドウは1,048,576トークンです。思考レベルはlow、medium、highの3段階で、デフォルトはmediumです。標準の出力上限は65,536トークンです。Google独自の長時間デコード経路では、入力分を差し引いた最大1,048,576トークンまで対応し、131,072と262,144が例として挙げられています。AIHubMixが現時点で案内しているのはChat Completionsのみなので、より大きな上限の経路が明記されるまでは、ゲートウェイへのリクエストを65,536以下にしてください。知識のカットオフは2026年3月です。Googleはこのモデルを無料枠では提供していません。
変更点はGoogle AI Studioのリリースノートで説明されています。「Carbonは各ターンでより多くの思考トークンを使い、徹底的な検討と回答の検証を行います。そのため、Argonと比べて1ターンあたりのトークン使用量とレイテンシが増加します」。この一文で、この記事の後半に出てくる違いのほとんどを説明できます。思考を増やすことで、難しいタスクでの性能上限が上がり、1ターンあたりの料金が高くなり、最初のトークンを待つ時間も長くなります。
移行はあえてシンプルです。「Argonからアップグレードする際、リクエストのスキーマを変更する必要はありません」。APIレベルではモデル名を置き換えるだけで十分です。Googleは運用上のアドバイスとして、「ワークロードでhighが必要な場合を除き、thinking_levelはmedium(デフォルト)のままにしてください。また、max_output_tokensとHTTPタイムアウトが、より長い推論処理に対応できることを確認してください」と述べています。
測定結果が示すトレードオフ:思考は増えるが、タスクあたりのコストは下がる
以下の数値は、2026-11-11T05:23Zに確認したArtificial Analysisのリアルタイム測定値です(モデルページは06:01Zに再確認し、変更はありません)。標準価格は入力トークン100万個あたり$4、出力トークン100万個あたり$20です。
有用な比較指標は、品質とタスク完了あたりのコストです。Carbonはコストを抑えながら、より高いスコアを獲得しているでしょうか。グラフでは、4つのモデル構成を個別に示しています。
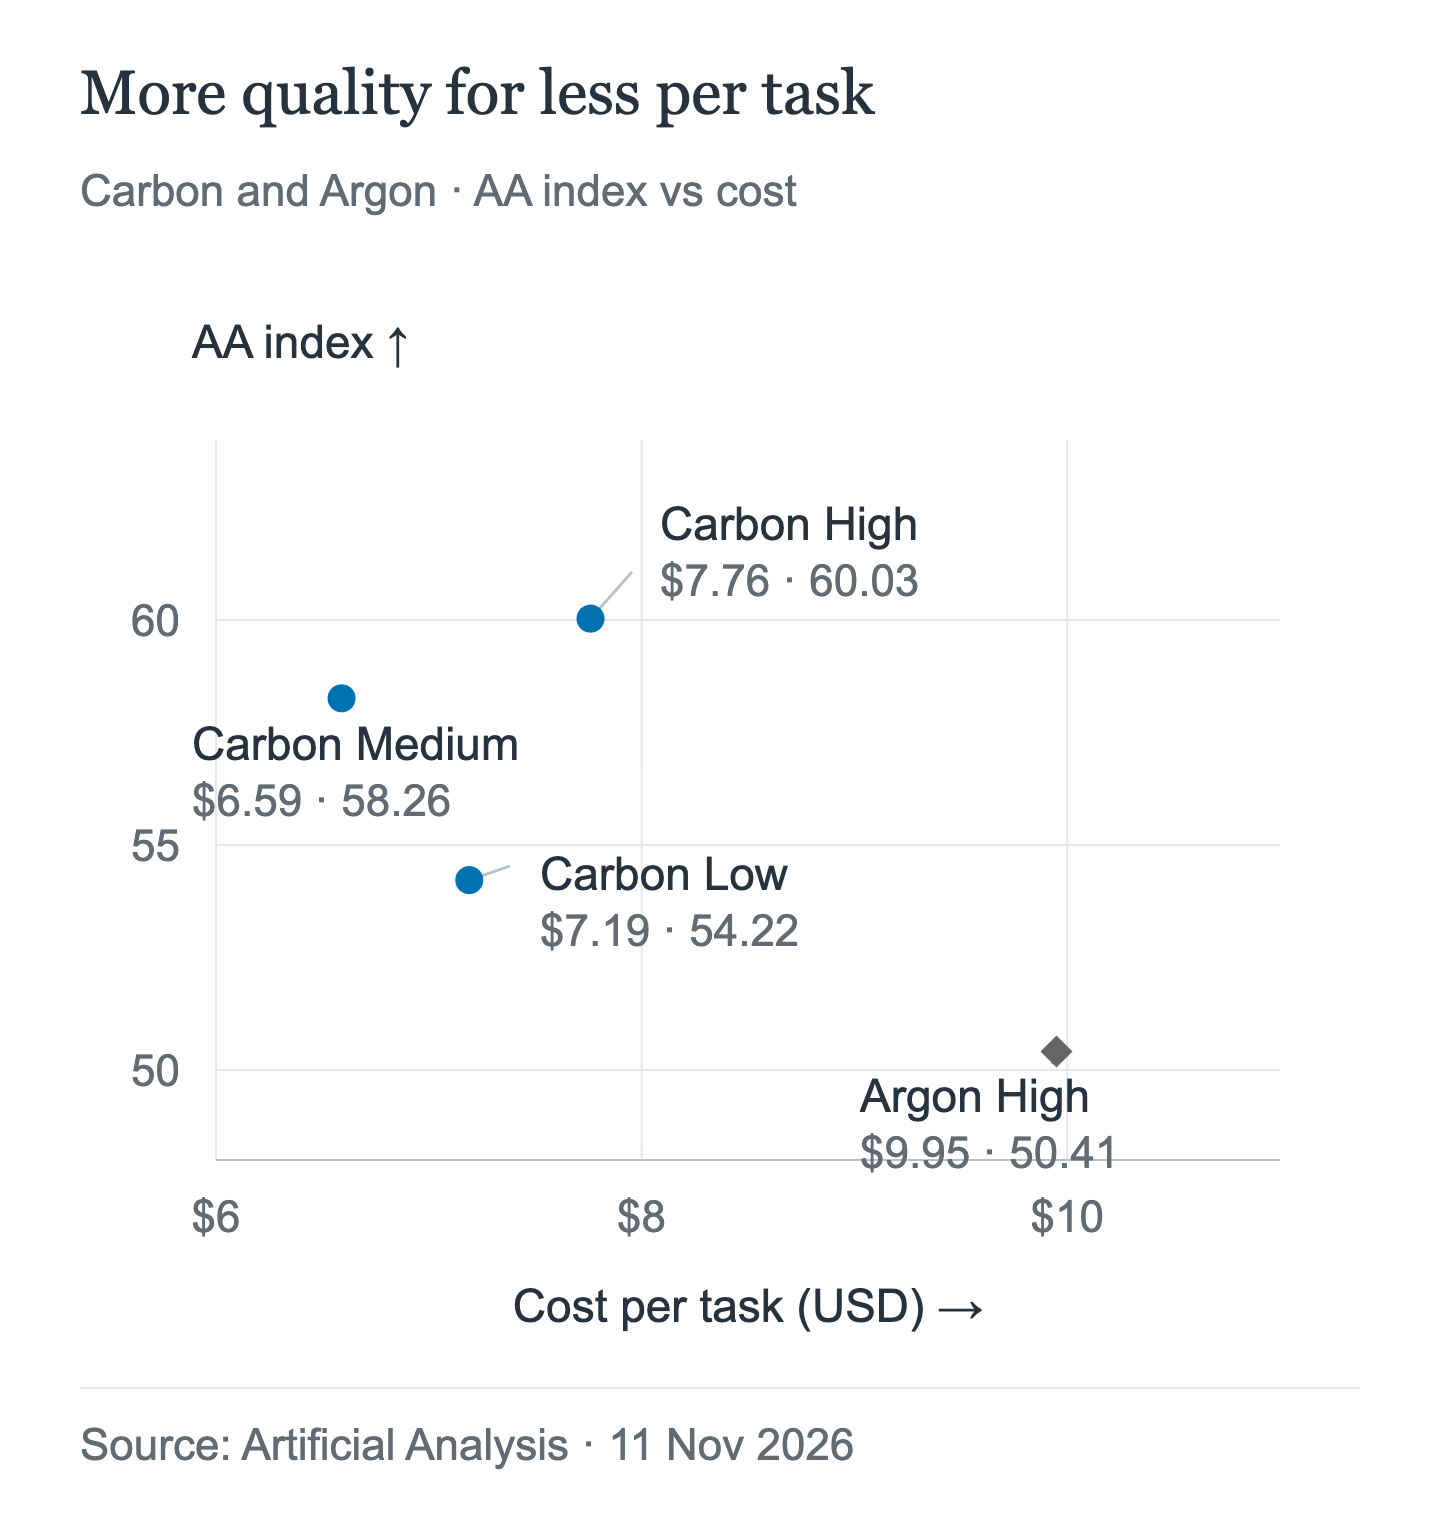
Carbon HighはArgon Highより左上に位置します。今回の測定では、Carbon Mediumが最も低コストの設定です。Lowはレイテンシを優先する設定であり、最安の設定ではありません。ここでの数値は標準価格で算出したAAのタスクコストで、AIHubMixのリクエスト料金ではありません。
| モデル | AA Index | タスクあたりの$ | タスクあたりの分数 | 最初のトークン | 出力トークン/秒 |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High、Medium、Lowの順位はそれぞれ104モデル中4位、6位、14位で、Argon Highはその下に位置します。Carbon Highより上位の3モデルはいずれもClaude Fable 5.2の構成です。「最初のトークン」は最初の回答トークンが届くまでの時間です。Carbon HighとArgon Highを比べると、AA Indexは+9.62ポイント、タスクあたりのコストは22.0%安く、完了時間は29.0分に対して25.6分です。一方、最初の回答トークンが届くまでの時間は40.1秒に対して67.1秒です。
AA Indexの差は、リーダーボードの順位が変わるほど大きなものです。レイテンシの差は、人が待つかどうかを左右するほど大きなものです。どちらも同じ行の数値が示しています。
Artificial AnalysisはCarbonについて「タスクあたりの処理が著しく遅く、非常に冗長」と評し、Indexの算出に2億500万トークンを生成したと報告しています。Argonの1億1,300万トークン、測定対象モデル全体の中央値である7,280万トークンを上回ります。今回のAA測定では、出力トークン量が大幅に多い一方で、タスクあたりのコストは低くなっています。同じ価格表でより多くのトークンを使いながら、タスク全体のコストは低いという結果です。
ひとつ、特筆すべき例外があります。Carbon Lowはタスクあたり$7.19で、思考量が少ないにもかかわらず、Mediumの$6.59より高くなっています。原因が何であれ、Lowは割引設定ではなくレイテンシを抑える設定として機能しています。大量のリクエストを振り分ける前に、タスクあたりのコストを測定してください。
コーディングエージェントでの比較
Intelligence Indexは多くのタスクの平均値です。Coding Agent Index v2は、同じハーネスを使ってエンドツーエンドで測定した、ツールを使うコーディングエージェントのため、APIユーザーが実際に動かす環境により近い指標です。Carbon Highは4位、Argon Highは11位です。
| 順位 | エージェント+モデル | Index | タスクあたりの$ | タスクあたりの分数 | キャッシュヒット |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
同じエージェント、同じハーネスでモデルだけが異なるため、足場ではなくモデル自体を比較できます。Carbonはタスクあたりのコストが34.0%安く、Indexは+6.2ポイント高く、処理時間は4.9分短い一方、タスクあたりの出力はほぼ同じです。Carbonは109,031トークン、Argonは109,236トークンです。キャッシュヒット率はCarbonのほうが高く、0.87に対して0.95です。また、入力トークン使用量は1,376万トークンに対して1,244万トークンと少なくなっています。
注意点は2つあります。CarbonはこのIndexで4位です。首位はClaude CodeとOpus 5.5 Maxの組み合わせで61.7、続いてDevin Fusion CLI、GitHub Copilot Fusionです。また、Fable 5.2はIndexに含まれていないため、この表ではCarbonとFableの優劣を判断できません。
Googleのモデルカードで分かること、分からないこと
Googleのモデルカードはベンダーの資料です。2026年10月時点の結果を自己申告したもので、上記のリアルタイムデータとは異なるスナップショットです。以下の項目では、すべてGoogleのCarbonの数値が上回っています。
| ベンチマーク | Carbon | Argon |
|---|---|---|
| AA Index v5.0(ベンダー公表値) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
AAの行にある数値は、Googleが公表した丸め後の59であり、前の表にあるリアルタイムの60.03ではありません。2つの数値は別々のスナップショットに由来するため、混同しないでください。モデルカードの外部比較対象はFable 5.2ではなくFable 5.1です。
有用なのは、複数のベンチマークで一貫している点です。性能向上は1つのベンチマークに限られません。一方、限界も明らかです。ベンダーのモデルカードでは、タスクの料金や最初のトークンまでのレイテンシは測定されず、エージェントが何ターンかかるのかも分かりません。この資料から「Carbonは平均的に優れたモデルだ」とは言えます。しかし、「あなたのループにとってCarbonのほうが優れたモデルだ」とまでは言えません。
価格:同じ料金表、12月1日に同じ価格変更
CarbonとArgonの料金は完全に一致しています。どちらも2026年11月30日までは導入価格で、12月1日に倍になります。
| モデル | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| Carbon、導入価格(11月30日まで) | $2.00 | $10.00 | $0.10 |
| Carbon、12月1日以降 | $4.00 | $20.00 | $0.20 |
| Argon、導入価格(11月30日まで) | $2.00 | $10.00 | $0.10 |
| Argon、12月1日以降 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview(≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
2026年11月11日時点の公式価格。単位はトークン100万個あたりの米ドルです。Gemini 3.1 Pro Previewは、200kを超えるプロンプトトークンに対して入力/出力/キャッシュ読み取りが$4/$18/$0.40で、さらにストレージ料金として1時間あたりトークン100万個につき$4.50がかかります。Fable 5.2のキャッシュ書き込みは、5分間で$10、1時間で$16です。バッチは50%割引です。CarbonとArgonの導入価格は11月30日に終了し、両モデルの料金は12月1日にすべて倍になります。
AIHubMixではCarbonが$2/$10/$0.10で、Googleの導入価格と一致しています。この記事では、11月30日以降のゲートウェイ料金を想定していません。現在の価格はモデルページで確認してください。
Artificial Analysisが測定したトークン数を導入価格で再計算すると、タスクあたりの概算はCarbon Highが$3.88、Mediumが$3.30、Lowが$3.60、Argon Highが$4.98です。これはAAの測定値ではなく、計算による推定値です。各タスクのトークン構成が変わらないと仮定しているため、実際のプロンプトやキャッシュヒット率によって結果は変わります。
トークン単価で比べると、Fable 5.2は標準価格ではCarbonの2倍、導入価格では4倍です。これは価格差であって、品質の判定ではありません。シリーズ第3回で両者を比較します。
Carbonがより適しているとは限らない場面
Carbonに対する反論は、性能が劣るということではありません。Carbonが提供する、1ターンあたりの思考量の増加こそ、対話型プロダクトでは費やせないものだということです。
最初のトークンが届くまで時間がかかります。Carbon Highでは最初の回答トークンが届くまで67.1秒かかり、Argon Highでは40.1秒です。Mediumなら待ち時間は23.2秒、Lowなら12.9秒まで短縮されますが、どちらもIndexのスコアは下がります。1分も応答が止まるチャットインターフェースでは、回答が届いたときの内容にかかわらず、その時点でユーザーは会話を離れています。
Googleは、速度を重視するならArgonを使い続けるよう勧めています。Argonは「より速い応答と、1ターンあたりのトークン使用量の抑制」を実現するモデルとして、「対話型コーディング、日常的な機能開発、迅速な本番環境の開発サイクル」向けに位置付けられています。移行ノートの指示は明快です。「速度が重要な場合はArgonを使い続けてください」。Googleの発表記事も同じ点を繰り返しています。「Argonは、ソフトウェア開発とナレッジワークの大半に最適な選択肢であり続けます」。
タスクあたりのコストが低くても、1ターンあたりの支出は増えます。トークン単価は同じですが、Carbonは1ターンあたりにより多くの思考トークンを使います。1ターンあたりのトークン支出を監視しているチームや、トークンのクォータをやりくりしているチームにとって、Carbonはより高価なモデルです。Indexの測定で、Argonの1億1,300万トークンに対してCarbonが2億500万トークンを使ったことは、この影響が極端に表れた例です。
Lowは最安の選択肢ではありません。Carbon Lowはタスクあたり$7.19で、Mediumの$6.59より高くつきます。タスク完了あたりのコストをルーティング基準にするなら、Lowは条件を満たしません。
ベンチマークで勝っても、待ち時間は取り戻せません。Googleの表ではOSWorld-2.1とFrontierSWE 2の両方でCarbonが優位ですが、いずれもベンダー公表値であり、最初のトークンまでの待ち時間は変わりません。ベンチマークが測るのは最終結果であり、ユーザーが体験するのは応答の始まりです。
今すぐ切り替えるべき人、Argonを使い続けるべき人
今すぐCarbonに切り替えるべきなのは、ベンダー独自のバッチ処理やバックグラウンドのエージェントジョブを実行している場合(これらの利用方法はAIHubMixではCarbon向けに文書化されていません)、品質の失敗による損失が処理時間を上回る場合、リクエストで長いタイムアウトと大きな出力予算を許容できる場合、またはCarbonなら回避できる可能性のある再試行にすでに費用をかけている場合です。
Argonを使い続けるべきなのは、チャットやオートコンプリート、人が待っている状態でのあらゆるループを構築している場合、予算やクォータがターンごとに計測される場合、または約30秒未満というレイテンシ目標が製品の要件である場合です。
どちらとも言えない場合は、まずテストしてください。同じ実際のリクエストを20~50件、両方のモデルに送信し、最初のトークンが返るまでの時間とタスク完了あたりのコストを記録して、インデックスではなく、その結果に基づいて振り分けましょう。AIHubMixの比較ページでは、2つのモデルページを並べて確認できます。
AIHubMix経由での呼び出し方法
Carbonは、AIHubMixで共通のモデル ID パターンと、文書化されているchat-completionsエンドポイントを使用します。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
エンドポイントはPOST /v1/chat/completionsです。これはAIHubMixがこのモデル向けに文書化している唯一のルートです。入力モダリティとして記載されているのはテキストです。画像やPDFの入力、Responses API、Anthropic Messages、Geminiネイティブのエンドポイントは、AIHubMixではCarbon向けに文書化されていないため、未確認として扱ってください。reasoning_effortのマッピングも同様です。ゲートウェイが思考レベルのパラメーターをそのまま渡すとは想定しないでください。max_tokensは標準の出力上限である65,536以内にしてください。それより大きな上限にはGoogleのバックグラウンドモードが必要ですが、AIHubMixでは確認されていません。この記事では実際のテストを行っていないため、サンプルはリクエストの形式を示すものであり、レスポンスが検証済みであることを示すものではありません。
よくある質問
CarbonとArgonは同じ価格ですか?
はい。Googleの公式料金は同じです。2026年11月30日までは入力トークン100万件あたり$2、出力トークン100万件あたり$10で、その後はそれぞれ$4と$20になります。キャッシュ読み取り料金は$0.10、その後は$0.20です。
CarbonはArgonより優れていますか?
Artificial Analysisの測定では、品質とタスク完了あたりのコストに関しては優れています。Intelligence Indexでは60.03対50.41、タスクあたりのコストは$7.76対$9.95です。一方、応答性では劣ります。最初の回答トークンが返るまで67.1秒かかり、Argonは40.1秒です。
Carbonはタスクをより速く完了するのに、なぜ応答が遅いのですか?
回答を返すまでの待ち時間は長い一方、タスク全体はより早く完了します。25.6分に対し、Argonは29.0分です。最初のトークンが返るまでの待ち時間とタスク全体の所要時間は別々の指標であり、正反対の傾向を示しています。
リクエストを変更する必要がありますか?
いいえ。Googleによると、Argonからアップグレードする際にスキーマの変更は不要です。モデル文字列をgemini-4-carbonに変更します。より長い思考時間に対応できるよう、出力上限とHTTPタイムアウトを引き上げてください。
Carbon LowはなぜMediumよりタスクあたりのコストが高いのですか?
Artificial Analysisの測定では、Lowは$7.19、Mediumは$6.59でした。Lowは割引設定ではなくレイテンシ設定として扱い、大量のリクエストを送る前にタスクあたりのコストを測定してください。
Artificial AnalysisでCarbonは何位ですか?
Intelligence Indexで#4です。上位にはClaude Fable 5.2の3つの構成があります。Googleのモデルカードでは同じインデックスのスコアが59に丸めて表示されていますが、実際の数値は60.03です。両者を混同しないでください。
Carbonは無料枠で利用できますか?
いいえ。GoogleはGemini 4 Carbonを無料枠で提供していないため、有料のAPI料金またはAIHubMixなどのゲートウェイ経由で利用します。
続きを読む:Gemini 4 Carbonシリーズ
- この記事を読んでCarbonを試すことにしたものの、最初のリクエストが失敗した場合は、思考時間の長い処理で変わる400エラー、タイムアウト設定、出力上限について、移行ガイドで解説しています。Gemini 4 Carbon APIの移行:400エラー、タイムアウト、出力上限。
- Carbonでエージェント型コーディングに十分なのか、それともFable 5.2のプレミアムに価値があるのかが気になる場合は、第3回の記事で同じ実測値をFable 5.2と並べて比較しています。Gemini 4 Carbon vs Fable 5.2:エージェント型コーディングにはどちらを選ぶべきか?
出典
- Google AI Studio、Gemini 4 Carbon:新機能
- Google DeepMind、Gemini 4 Carbonモデルカード
- Google AI Studio、Gemini APIの料金
- Artificial Analysis、Gemini 4 Carbon
- AIHubMix、Gemini 4 Carbon