

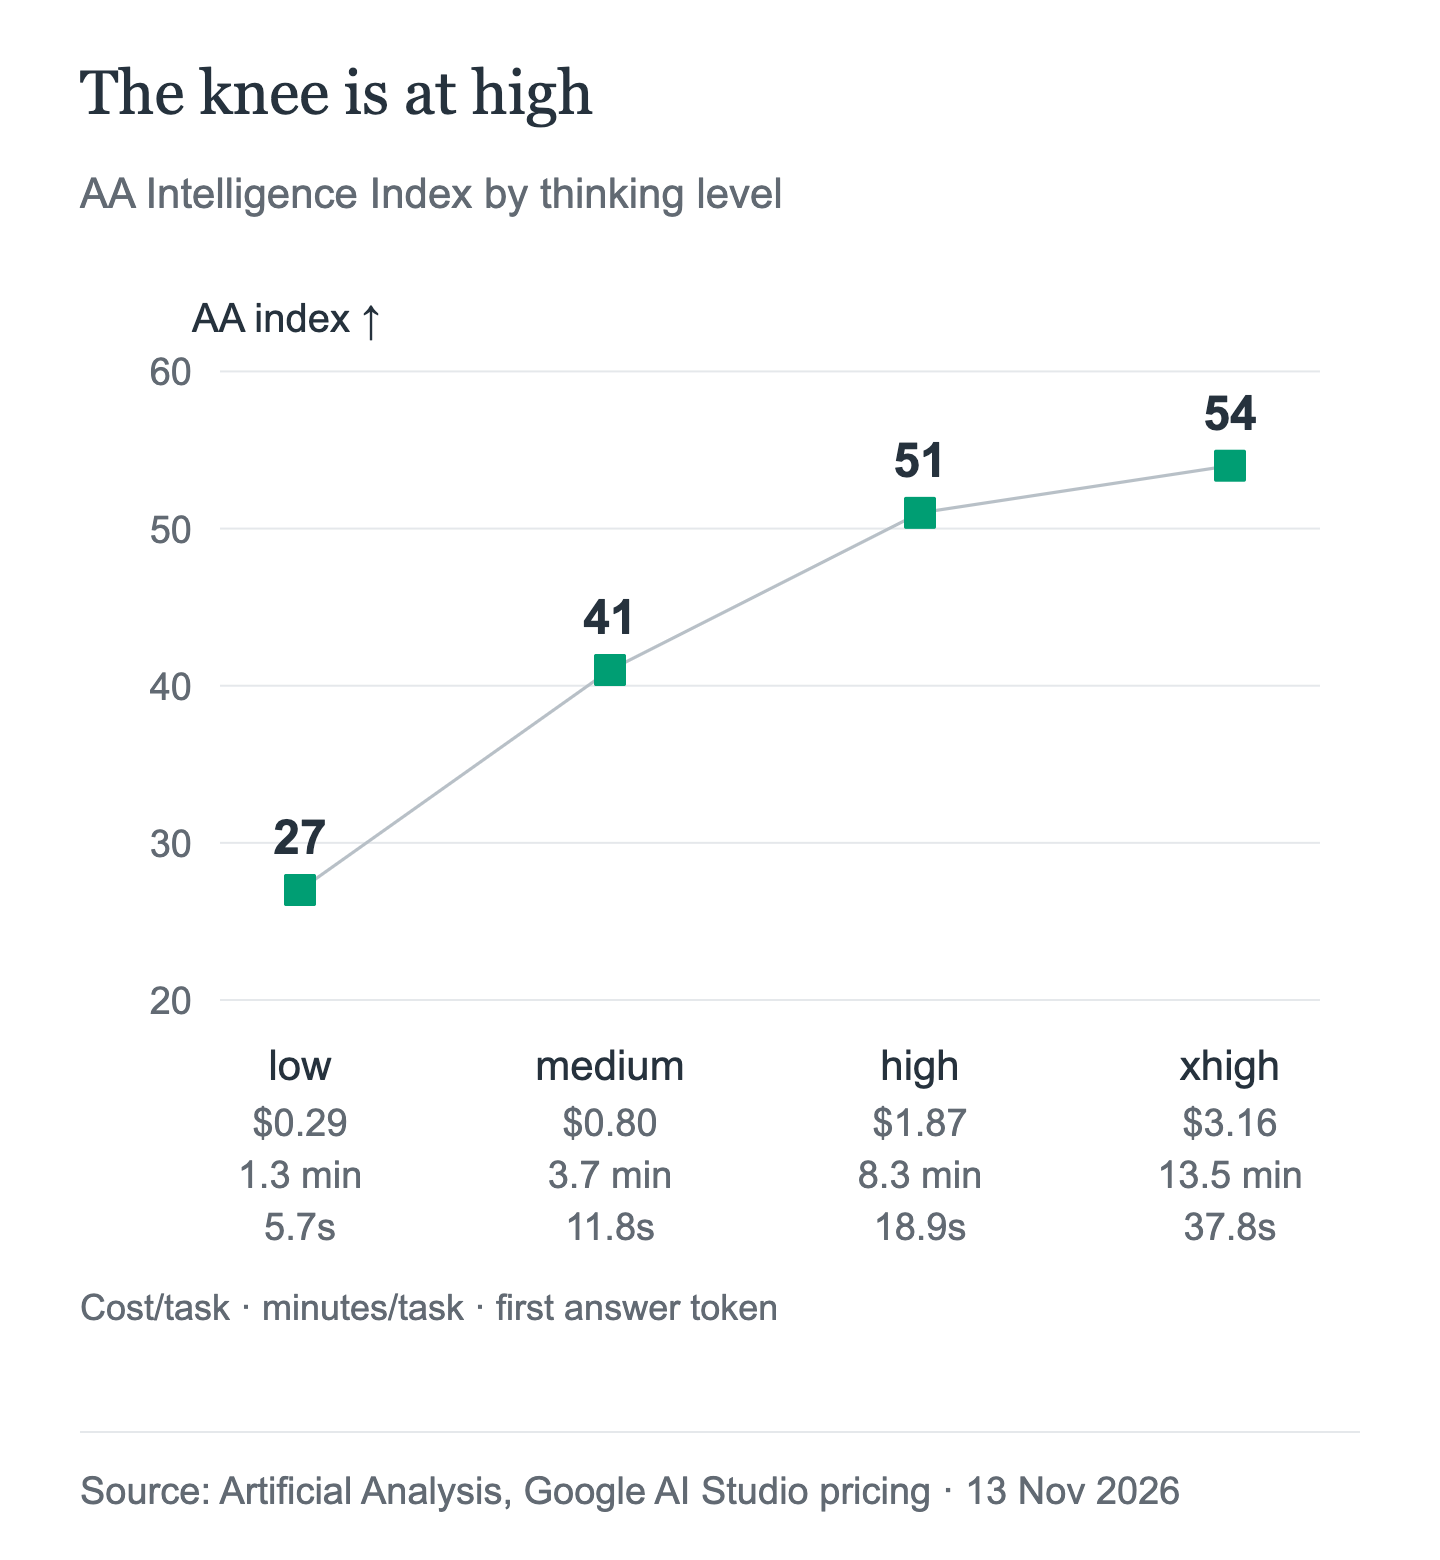
Gemini 4 Hydrogenには4つの思考レベルがあり、それぞれ別のモデルのように振る舞います。Artificial Analysisのリアルタイム測定では、同じモデルのスコアはlowで27、mediumで41、highで51、xhighで54です。デフォルトはhighで、xhighはGemini 4ファミリーに新たに加わったレベルです。CarbonとArgonはhighまでです。
差は大きく、同じモデルでもlowからxhighまででインデックスが27ポイント違います。mediumからhighに上げると、タスクあたり約$1.07の追加でインデックスが10ポイント上がります。highからxhighでは、$1.29の追加で3ポイント上がりますが、最初の回答トークンが返るまでの待ち時間はほぼ倍になります。実用上はhighから始め、難しい多段階タスクではxhighを使い、lowとmediumは品質を個別に確認したうえでレイテンシ重視の設定として扱うのがよいでしょう。
以下では、各レベルの用途、コスト、APIでの変更点、そしてAIHubMixが公開している情報と公開していない情報を解説します。
4つのレベルと変更点
Gemini 4 Hydrogenはlow、medium、high、xhighに対応しています。Googleのリリースノートには、端的にこう記されています。「モデルのデフォルトはhighで、xhighが新たに導入されます。」デフォルトがmediumで、highまでしか対応していないGemini 3.8 Flashと比べて、変更点は2つです。
ファミリーのほかのモデルに変更はありません。CarbonとArgonはlow、medium、highに対応し、デフォルトはmediumです。highを超える設定があるのは、Gemini 4ではHydrogenだけです。
| モデル | レベル | デフォルト |
|---|---|---|
| Gemini 4 Hydrogen | low、medium、high、xhigh | high |
| Gemini 4 Carbon | low、medium、high | medium |
| Gemini 4 Argon | low、medium、high | medium |
MINIMALは選択肢に含まれません。Gemini 4の思考に関するドキュメントでは、MINIMALは「Gemini 4モデルではサポートされていない」と説明されており、GoogleのHydrogenリリースノートにも「モデルはminimalをエラーで拒否する」と記載されています。このモデルで思考を無効にする方法は、ドキュメントに記載されていません。
Googleの推奨
Googleのガイダンスは最初の目安として妥当ですが、以下の測定結果が出る前に書かれたものです。特に、インタラクティブなコーディングにmediumを推奨する内容は、Artificial Analysisがmediumで確認できていない品質水準を前提としています。
| レベル | Googleの説明と推奨用途 |
|---|---|
| low | 「トークン数が最少、レイテンシが最低」—高速チャット、大量処理 |
| medium | 「トークン使用量を抑え、応答を高速化」—インタラクティブなコーディング、UIプロトタイプ |
| high | 「知能と速度のバランス」—ほとんどのタスクでのデフォルト |
| xhigh | 「トークン数が最多、最も深い推論」—難しい多段階のコーディング |
この表には注意点が2つあります。Googleは「xhighを使うとレイテンシとトークン使用量が増え、単純なプロンプトでは過剰に考えることがあります」と述べています。また、評価方法についても明確に助言しています。「max_output_tokensを大きく設定し、4つすべてのレベルで評価を実行してください。」
測定値で見るレベル差
Artificial Analysisは4つすべてのレベルを測定しました。対象はIntelligence Index v5.0.1で、ランキング対象は78モデルです。2026-11-13T02:40Z時点で、標準の定価を使用しています。これらはAAのタスクあたりコストであり、AIHubMixの請求額ではありません。
| レベル | AA順位 | AA Index | $/タスク | 分/タスク | 最初の回答トークン |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
特に参考になるのは、各段階での変化幅です。
lowからmedium:インデックス+14ポイント、タスクあたり+$0.51、+2.4分、最初のトークンまで+6.1秒。mediumからhigh:インデックス+10ポイント、タスクあたり+$1.07、+4.6分、最初のトークンまで+7.1秒。highからxhigh:インデックス+3ポイント、タスクあたり+$1.29、+5.2分、最初のトークンまで+18.9秒。
highが分岐点です。追加コストに対する品質向上が大きい最後の段階であり、xhighではインデックスの上昇が小さい一方、最初のトークンを待つ時間がほぼ倍になります。だからといってxhighが悪い設定というわけではありません。highではうまくいかないタスク向けの設定ということであり、これはまさにGoogleの説明どおりです。
参考までに、同じ時点のデータでは、Carbon highはスコア60、タスクあたり$5.48、28.1分、Carbon mediumは58、$4.68、Carbon lowは54、$5.22です。Argon highはスコア50、$4.97、30.6分です。HydrogenのxhighはCarbon lowと同じ54ですが、タスクあたりコストは39.5%低く($3.16対$5.22)、最初のトークンが返るまでの時間は37.77秒(対13.61秒)です。HydrogenのhighはArgon highをインデックスポイントで1上回り、タスクあたりコストは62.4%低くなっています。
レベル間で明らかになる問題点
lowは、少し性能を下げた程度ではありません。スコアは27で、highを24ポイント下回ります。タスクあたり$1.58を節約するためにワークロードをhighからlowに変更しても、思考量を抑えた同じ製品が手に入るわけではなく、大幅に弱いモデルを使うことになります。分類、ルーティング、短い情報抽出なら問題ないかもしれません。一方、コーディングやエージェント型の作業では、タスクに応じた評価なしに使うべきではありません。
mediumは品質設定ではなく、レイテンシの設定です。スコアは41で、highを10ポイント下回り、料金は$0.80に対して$1.87です。タスクあたり57%の節約になるのは確かですが、品質の差は価格差から受ける印象以上に大きいものです。Googleは対話型コーディングにmediumを推奨していますが、AAの数値を見る限り、この推奨を採用する前に自分のタスクで検証する必要があります。
xhighでは考えすぎることがあります。Googleもこれを明確に警告しています。AAのコストと所要時間の数値にも、その影響が表れています。タスクあたり$3.16、13.5分、最初のトークンまで37.77秒です。単純なプロンプトに対しては、小さな性能向上のために払うレイテンシとしては大きすぎます。一方、highでは解決できない難しい多段階のコーディングタスクにおいては、さらに上のレベルとして唯一の選択肢です。
出力の多さも請求額に影響します。Artificial AnalysisはHydrogenを「非常に冗長」と評しています。xhighでの実行では、インデックスの算出に出力トークンを304 million生成しており、77モデル中76位でした。中央値は72.8 millionです。出力トークンには思考トークンも含まれ、出力料金は100万トークンあたり$7.50です。レベルを上げると、考える時間が長くなるだけでなく、課金対象のトークンも増えます。
コストの仕組み:思考がトークンになるまで
料金体系はシンプルです。Hydrogenの料金は、入力トークン100万あたり$1.50、出力トークン100万あたり$7.50、キャッシュ済み入力トークン100万あたり$0.075です。出力には思考トークンも含まれます。そのため重要なのはレベル名よりも思考レベルです。課金対象となるのは設定名ではなく、モデルが生成する推論の量だからです。
見落としやすい課金ルールが3つあります。
デフォルトが変わりました。Gemini 3.8 Flashのデフォルトはmediumでしたが、Hydrogenのデフォルトはhighです。レベルを指定していないワークロードは、トークンあたりの料金が変わらなくても、移行後は1ターンあたりの出力トークンが増え、支出も増えます。これは、モデルの入れ替えに見せかけた予算変更です。
キャッシュは暗黙のもののみです。Hydrogenは、最低4,096トークンでの暗黙的キャッシュに対応し、キャッシュヒットには95%の割引が適用されます。明示的キャッシュには対応していません。Googleのエンタープライズ向けページには、「デフォルトではキャッシュへの書き込みに標準の入力トークン料金の1.25倍が課金されます」とも記されています。これはGoogleの課金に関する説明であり、AIHubMixにおけるこのモデルのキャッシュ料金は公開されていません。
長い出力には1回あたりの上限があります。同期リクエストでは、ストリーミングの有無にかかわらず、1回につき最大65,536トークンが生成されます。それを超える出力にはバックグラウンド実行または継続トークンが必要で、max_output_tokensは思考と出力を合わせた上限になります。background=trueをmax_output_tokensなしで設定すると、サーバーは65,536トークンで停止します。Googleが推奨する長いデコードの予算は131,072または262,144で、最大は入力分を差し引いた1,048,576です。
APIでできること、拒否されること
パラメーターはthinking_level(スネークケース)です。GoogleのPythonサンプルではthinking_config内に設定し、NodeのサンプルではthinkingConfig(キャメルケース)の下にネストします。モデルページに記載されている値はLOW、MEDIUM、HIGH、XHIGHで、リリースノートでは小文字で表記されています。大文字・小文字を変えて手入力するのではなく、SDKの列挙型またはドキュメントに記載された文字列を使ってください。
次の3種類のリクエストは失敗します。
- Gemini 4モデルで
thinking_budgetを指定すると、400: INVALID_ARGUMENTが返されます。thinking_levelとthinking_budgetの両方を設定した場合もエラーになります。 thinking_level="MINIMAL"はサポートされておらず、Hydrogenはこれを拒否します。- カスタムの
temperature、top_p、top_kは無視されます。固定のデフォルト値はtemperature 1.0、topP 0.95、topK 64です。
Googleのプラットフォームでは、Hydrogenは関数呼び出し、コード実行、URLコンテキスト、コンピューター操作にも対応しています。Interactions APIで複数ターンのやりとりやツール呼び出しのセッションを行う場合は、previous_interaction_idを使用してください。
AIHubMixが公開している情報と公開していない情報
AIHubMixが公開しているHydrogenのルートは、POST https://aihubmix.com/v1/chat/completionsで、model="gemini-4-hydrogen"を指定します。モデルページによると、入力はテキスト、画像、音声、動画、PDFに対応し、出力はテキストです。一方、llms.txtには古いテキストのみの記述が残っているため、より新しい情報としてモデルページを参照してください。ツール使用、構造化出力、推論の機能フラグは「公開されていません」。このモデルは2026-11-11に生成されたモデルインデックスにも掲載されておらず、プロトコルスキーマも公開されていません。
この投稿にとって重要なのは、AIHubMixがGemini 4モデルの思考レベルの設定方法を公開していない点です。AIHubMixのGeminiガイドが扱っているのは、Gemini 2.5世代モデルのreasoning_effortであり、Gemini 4のthinking_levelやxhighではありません。どちらのパラメーターもゲートウェイをそのまま通過すると想定しないでください。また、GoogleのAPIで確認されたデフォルトがAIHubMixでも適用されると決めつけないでください。
安全なリクエスト形式は、AIHubMixが公開しているものです。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
レベルの制御が必須であれば、GoogleのAPIを直接呼び出すか、本番トラフィックを振り分ける前に小規模なリクエストでゲートウェイの挙動を確認してください。検討中のコストを比較するには、AIHubMixの比較ページが参考になります。この投稿ではライブテストを実施していません。
ワークロード別の開始レベル
| ワークロード | 開始レベルとその理由 |
|---|---|
| 高速なチャット、ルーティング、分類 | mediumから始め、lowをテスト。lowのスコアは27 |
| 対話型コーディング、UIプロトタイピング | high。AAのmediumは41 |
| エージェントの実行、ツールループ | high。行き詰まった場合にのみxhigh |
| 難しいデバッグ、アーキテクチャ、計画立案 | xhighまたはCarbon。69%多くかけて3ポイント上昇 |
| 評価後の大量バッチ処理 | lowまたはmediumが最安。ただし指数は27/41 |
| 15秒未満の厳しいレイテンシ予算 | mediumまたはlow。highは18.89秒かかる |
これらは開始時の目安であり、ルーティングルールではありません。適切なレベルは、自分で行う評価に合格する最低のレベルです。Googleも、4つすべてのレベルで評価を実施することを推奨しています。
よくある質問
Gemini 4 Hydrogenにはどのような思考レベルがありますか?
low、medium、high、xhighの4つです。デフォルトはhighです。
Gemini 3.8 Flashから何が変わりましたか?
デフォルトがmediumからhighに変わり、highより上のレベルとしてxhighが追加されました。CarbonとArgonのデフォルトは引き続きmediumで、上限はhighです。
xhighを使う価値はありますか?
highでは解けない難しい複数ステップのタスクなら、価値があります。指数が3ポイント上がります。一方、タスクあたりのコストはhighより69%高く、最初のトークンが出るまでの待ち時間もほぼ倍になるため、単純なプロンプトのデフォルトには適しません。
lowの性能がこれほど低いのはなぜですか?
Artificial Analysisの指数では27で、highを24ポイント下回ります。コストはタスクあたり$0.29で、$1.87より低いものの、品質の差は価格の差よりはるかに大きいです。タスク固有の評価で十分だと確認できた場合にのみ使用してください。
AIHubMixはthinking_levelやxhighに対応していますか?
ドキュメント上では対応を確認できません。AIHubMixはHydrogenのreasoning capabilityフラグも、Gemini 4の思考レベルに関するガイドも公開していません。どちらかを前提にする前に、対応状況を確認してください。
thinking_budgetを送信するとどうなりますか?
Gemini 4は400: INVALID_ARGUMENTを返します。thinking_budgetとthinking_levelの両方を設定した場合も、エラーが返されます。
思考をオフにできますか?
オフにする方法はドキュメントに記載されていません。Gemini 4ではMINIMALはサポートされておらず、Hydrogenはこれをエラーとして拒否します。
続きを読む:Gemini 4 Hydrogenシリーズ
- HydrogenがGemini 3.8 Flashからの適切なアップグレードかどうか、まだ検討中であれば、最初の記事でリリース、価格変更、ベンチマークのトレードオフを取り上げています。Gemini 4 Hydrogen vs Gemini 3.8 Flash: Is the Upgrade Worth It?
- 同じタスクでHydrogenをCarbonやArgonと比較したい場合は、3本目の記事で、価格、レイテンシ、ワークロード別の表とともに3モデルを並べて比較しています。Gemini 4 Carbon vs Hydrogen vs Argon: Which Model for Which Job?
出典
- Google AI Studio、Gemini 4 Hydrogen: what's new
- Google、Gemini 4 thinking
- Google、Gemini 4 Hydrogen model page
- Google AI Studio、Gemini API pricing
- Artificial Analysis、Gemini 4 Hydrogen — 2026-11-13T02:40Z時点のライブスナップショット、Intelligence Index v5.0.1


