Gemini 4 Carbon は、リクエストスキーマのレベルでは Gemini 4 Argon とそのまま置き換えられます。同じチャット補完のリクエスト本文が使えます。変わるのはモデル ID で、一部のパラメーター値は引き継がれません。重要な問題はその一段下で発生します。400 を返すパラメーターエラー、ひっそりと出力を切り詰める上限、そして長い思考を前提としたタイムアウトと課金の仕組みです。
最初の1週間を左右するデフォルト設定は4つです。
- AIHubMix では
max_tokensを 65,536 以下に保ってください。ゲートウェイがドキュメント化しているのは Chat Completions のみで、それを超える出力経路は公開されていません。 - Google ネイティブの Interactions/バックグラウンド実行では、
store=trueと明示的なmax_output_tokensを設定してください。AIHubMix では、これらのフィールドは Carbon 向けにドキュメント化されていません。 - ベンダーネイティブの長時間デコード経路を使う場合、ストリームごとの HTTP 読み取りタイムアウトを15~20分に延長してください。
- 無視される
temperature、top_p、top_kとペナルティを削除してください。また、Google の Carbon ガイドでは、candidate_countが 1 を超えると 400 が返されます。
変更のない基本事項(アクセス、セキュリティ上の拒否、タスクあたりのコスト)はArgon の移行記事をご覧ください。この記事では Carbon 固有の動作を取り上げます。
明確に失敗するケース、気づきにくい失敗
失敗はきれいに二分できます。400 はすぐに分かりますが、気づきにくい上限は請求書を見て初めて分かります。
| 発生する事象 | 分類 | まず行うこと |
|---|---|---|
| パラメーターによる HTTP 400 | 明確 | サポートされていないフィールドを削除する |
| バックグラウンドリクエストで 400 | 明確 | store=true を追加する |
| 回答が 65,536 トークンで止まる | 気づきにくい | max_tokens を 65,536 まで引き上げる |
| テキストが空で、ステータスが incomplete | 気づきにくい | 上限を引き上げて再試行する |
| バックグラウンド実行が 64K 付近で終了する | 気づきにくい | max_output_tokens を設定する |
| 回答が浅くなったように見える | 気づきにくい | 思考レベルを明示的に設定する |
| 見積もりを超える請求 | 気づきにくい | 思考とデコードの各段階を計上する |
AIHubMix は gemini-4-carbon を、Chat Completions 経由で、Google の導入価格である入力 $2、出力 $10、キャッシュ済みトークン $0.10(いずれも100万トークンあたり)で掲載しています。これは期間限定です。料金をご確認ください。
明確な失敗:ドキュメントに記載された 400
ドキュメントに記載された 400 の多くはパラメーター検証によるものです。履歴や、モデルのターンで終わる事前入力は、リクエスト状態に関する失敗です。以下のルールは、特記がない限り Google のネイティブ Carbon ガイドに基づいています。AIHubMix が現在 Carbon 向けにドキュメント化しているのは Chat Completions のみです。AIHubMix の Carbon の掲載ページでは、400 の種類を「400 — パラメーターエラー。ほとんどはアップストリームのプロバイダーから引き継がれたもの」と一行で説明しています。これはゲートウェイの説明であり、テスト結果ではありません。詳細は Google のCarbon ガイドと新機能ページを参照してください。
| 原因 | 発生する事象 | 対処法 |
|---|---|---|
| max_output_tokens > 1M* | 400;上限超過 | ネイティブは ≤1M、ゲートウェイは ≤65K* |
| frequency/presence penalty | 400;未サポート | フィールドを削除する |
| candidate_count > 1 | 400;複数候補 | 省略するか、1 に設定する |
| store なしの background* | 400;store が必須* | store=true を追加する |
| 履歴がモデルで終わる | 拒否;未サポート | ユーザーのターンで終える |
| 両方の制御フィールド | 400;併用不可 | どちらか一方を送る |
| thinking_budget または MINIMAL | 400;Carbon ガイド | low/medium/high を使う |
Google はエラーメッセージをそのまま次のように表示します:「store=true is required for background interactions.」* Google ネイティブのみ:max_output_tokens の上限は 1M で、バックグラウンド実行には store=true が必要です。AIHubMix ではこの経路はドキュメント化されていません。Chat Completions 経路では ≤65K を使用してください。
minimal には2つの意味があります。Google ネイティブの Carbon フィールドでは、thinking_budget と thinking_level=MINIMAL は HTTP 400 を返すため、low、medium、high を使ってください。Google の OpenAI 互換レイヤーでは、reasoning_effort=minimal は low にマッピングされます。AIHubMix がこのマッピングを Carbon に適用するかどうかは公開されていません。
ツールの扱いにも関連する落とし穴があります。Google の Carbon ガイドでは、ツール実行を順次行うターンを推奨しています。また、AIHubMix の Gemini ガイドでは tool_choice="auto" がドキュメント化されています。ゲートウェイでの Carbon 固有のツールサポートは、まだ確認されていません。
/v1/chat/completions で使える最小限の安全なリクエストでは、Carbon が無視する項目を省きます。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
これで 200 が返れば、通信レイヤーの問題は解決です。以降は、エラーを出さずに起きる問題について説明します。
気づきにくい失敗:エラーは出ないのに、出力や請求額が違う
標準の出力上限は 65,536。ベンダーの長時間デコードは別経路
Carbon の標準出力上限は 65,536 トークンです。Chat Completions で上限を指定するフィールドは max_tokens で、Google のネイティブガイドでは max_output_tokens と呼ばれています。Google ネイティブの長時間デコード経路では、入力分を差し引いて最大 1,048,576 トークンまで生成できます。131,072 と 262,144 はその例です。Google の新機能ページには、次のルールが記されています:「background: true を設定し、max_output_tokens を定義しない場合、サーバーは 64K トークンで停止します。」AIHubMix では Carbon のバックグラウンド実行や継続生成はドキュメント化されていません。
ベンダーネイティブの長時間デコードは複数の区間で実行されます。バックグラウンド実行またはストリーミングでは1区間あたり64K、非ストリーミングでは1区間あたり32Kです。非ストリーミングの REST リクエストは1回につき 32,768 で停止します。Google のガイドには、「以前の SDK バージョンと OpenAI 互換レイヤーでは、継続トークンを使って長い補完を取得できません」とあります。AIHubMix では、保守的に max_tokens を 65,536 以下にしてください。これは未検証のゲートウェイ上限です。モデルページに記載されるまでは、より長い回答をつなぎ合わせる計画を立てないでください。
上限が低いと「思考」が途中で切れ、空の出力にも課金される
上限の対象にはテキストだけでなく思考も含まれます。Google の長時間デコードガイドには、「8,192 など低い値を設定すると、モデルは思考を終える前に停止します」とあります。ステータスは incomplete となり、「モデルがまだ思考中であれば、テキストが空になることがあります」。どちらの場合も料金が発生します。思考と回答の両方を見込んで上限を設定し、出力が空の incomplete 応答は上限の問題として扱ってください。上限を引き上げて再試行し、最初の試行分も請求されることを見込んでください。
思考のデフォルトは medium
Carbon のデフォルトは Argon と同じ medium です。デフォルトが high の Gemini 3.1 Pro Preview から移行したチームは、コードを変えなくても1段階下がり、回答が浅くなったのを回帰と捉えることがあります。Google は、ほとんどのコーディングやエージェント作業には medium を推奨しています。ステージング環境でレベルを明示的に設定し、制御フィールドは1つだけ送ってください。reasoning_effort と thinking_level は併用できません。
サンプリングパラメーターは無視される
temperature、top_p、top_k は無視されます。エラーもなく、サンプリング結果も変わりません。これらは削除してください。ペナルティと、1 を超える candidate_count の値は 400 を返します。
明示的なキャッシュは廃止
cachedContents と caches.create はサポートされていません。暗黙的なキャッシュは 4,096 トークン以上で適用され、95%の割引となります。明示的キャッシュのコードを削除し、安定したプロンプトのプレフィックスを先頭に置いたうえで、割引を予算に織り込む前にキャッシュ済みトークンの使用量を確認してください。
会話状態にはルールがある
Google は継続生成に previous_interaction_id を推奨しています。Chat Completions にはこのフィールドがないため、履歴を維持しつつ、ユーザーのターンで終えてください。モデルロールで終わる履歴や、事前入力されたモデルのターンはサポートされていません。
タイムアウトは60秒ではなく15~20分
Google の長時間デコードガイドでは、ストリームごとの HTTP 読み取りタイムアウトを15~20分にするよう推奨しており、移行チェックリストでも最低15分としています。この推奨は長時間デコードのリクエストに関するものです。一方、AA の別の測定では、最初の回答トークンが届くまでの時間は Carbon High が 67.1 秒、Medium が 23.2 秒、Low が 12.9 秒、Argon High が 40.1 秒でした。60秒で打ち切る設定では、最初のトークンすら届かないことがあるのではないでしょうか。
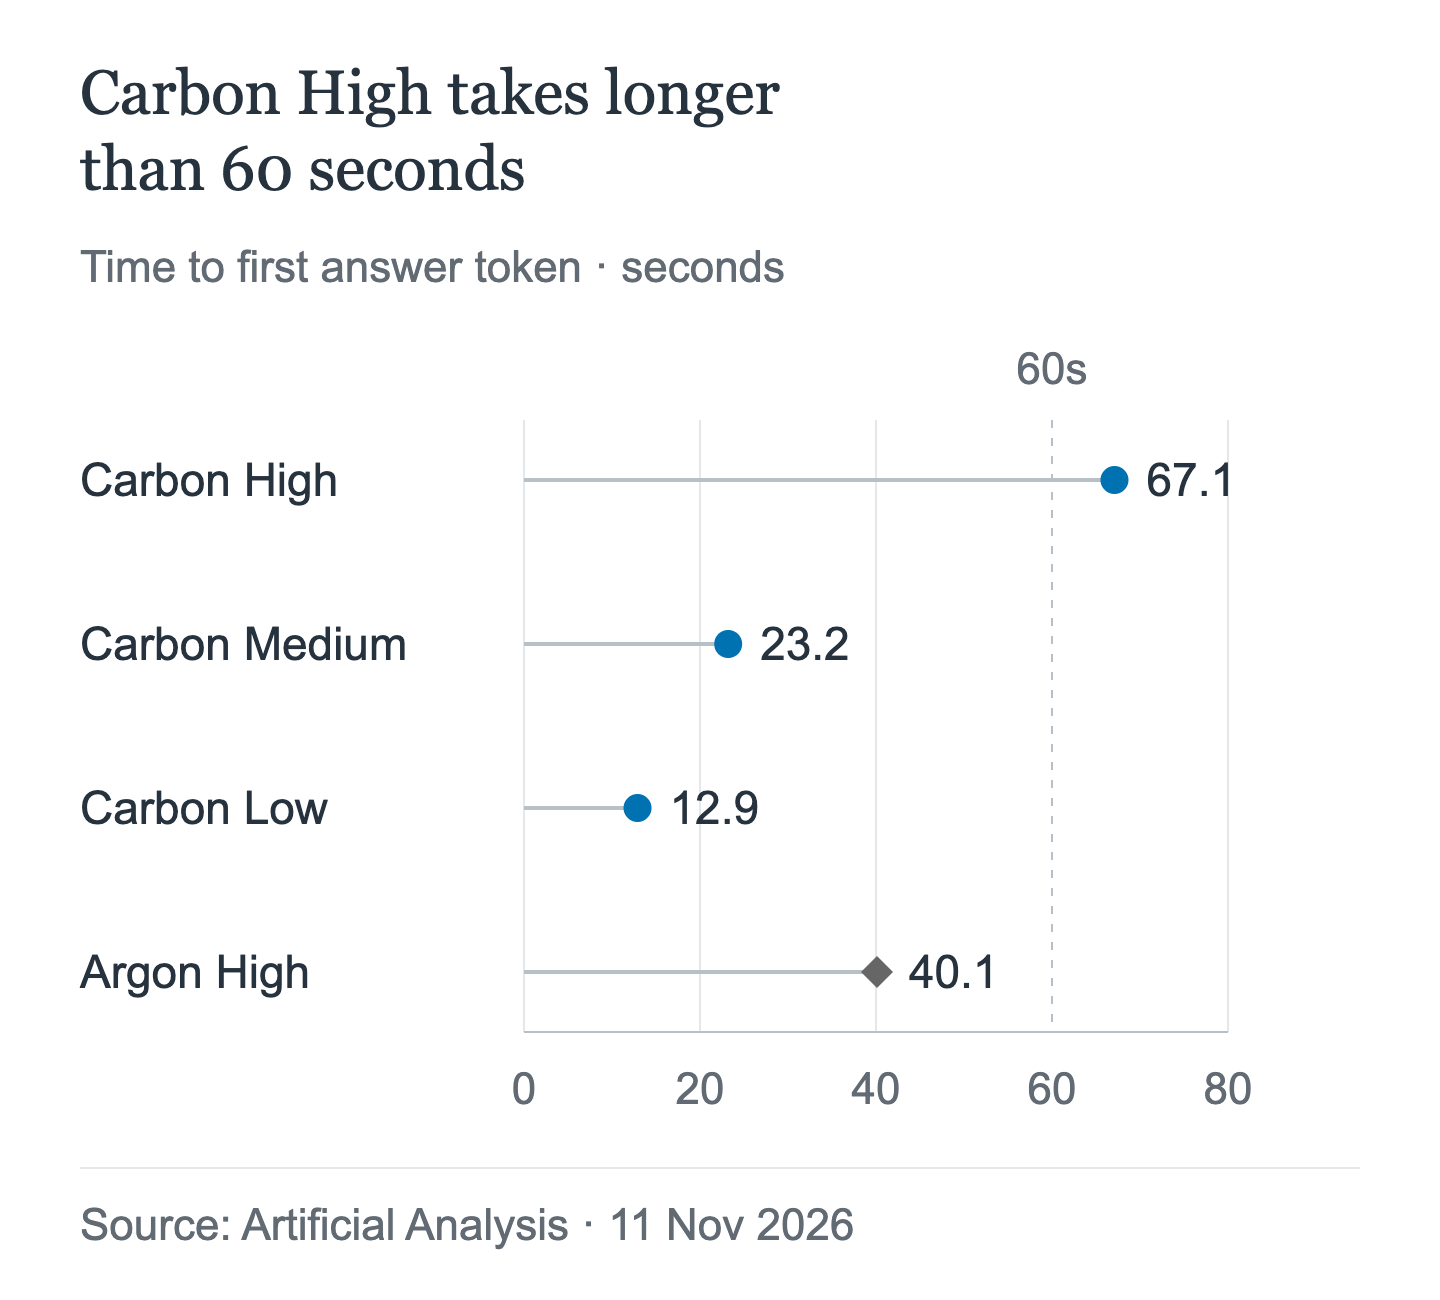
この測定では Carbon High が60秒の基準を超えています。最初のトークンまでの時間だけでは、リクエスト全体に対する安全なタイムアウトは判断できません。前述の15~20分という推奨は、Google の長時間デコードガイドに基づいています。これはある時点での測定結果であり、レイテンシの保証でも、AIHubMix でのテスト結果でもありません。
Google ネイティブのクライアント側ホップ制限は、バックグラウンド実行の制限より厳しく、ストリームは20分、非ストリーミング呼び出しは10分です。一方、バックグラウンド実行は24時間です。AIHubMix では、これらのバックグラウンド制限はドキュメント化されていません。
長時間デコードに必要なネイティブ SDK の最低バージョン:Python 2.34.0、JS 2.32.0、Go 1.77.0、Java 1.80.0、.NET 1.28.0。Claude Code の API_TIMEOUT_MS はデフォルトで10分です。今後、Carbon で Claude Code 経由の利用が確認された場合に備え、最初の実行前に値を引き上げてください。
課金の落とし穴
Carbon のトークン単価は単純ですが、請求額はそうではありません。請求額を押し上げる仕組みがいくつかあるうえ、予定されている料金改定では全単価が2倍になります。
思考は出力として課金される
思考トークンは出力として課金されます。現在の Carbon の出力料金は100万トークンあたり $10、12月1日からは $20 です。
長時間デコードの各ホップに課金される
Google の計算例では、1,000トークンのプロンプトから200,000トークンを出力すると、1,000、66,536、132,072、197,608 の各ホップを合計した total_input_tokens は397,216になります。「思考のみのホップも含め、すべてのホップのすべてのトークンに課金されます。」暗黙的なキャッシュによって入力の大半は95%割引になりますが、ホップ分は使用量に含まれます。実行が失敗またはキャンセルされた場合も、完了した処理には課金されます。「後続の区間が失敗またはキャンセルされても、完了した区間は各区間の終了時に課金されます」「インタラクションが終了するまでに完了したすべての処理に課金されます。」
グラウンディングには別の料金体系がある
Google のネイティブサービスでは、Google Search を使ったグラウンディングに月5,000件の無料リクエストが含まれます。Gemini 3 以降で共有され、それを超えると1,000件あたり $14 で、1日あたりの上限は1,500件です。AIHubMix では Carbon のグラウンディングはドキュメント化されていません。
Vertex の注記はベンダー限定
Google の Vertex 料金ページには、追加ルールが記載されています。2026年11月13日以降、32K トークンを超える補完は、クライアントまたはサーバーのタイムアウトでリクエストが失敗した場合でも、取得可能なトークンの使用量に対して課金されます。これはベンダー側のルールです。AIHubMix の VertexAI プロバイダーにも適用されるかどうかは公開されていません。前提を決める前に確認してください。
12月1日に全料金が2倍
| 料金項目 | 11月30日まで | 12月1日以降 |
|---|---|---|
| 入力 | 100万あたり $2 | 100万あたり $4 |
| 出力 | 100万あたり $10 | 100万あたり $20 |
| キャッシュ読み取り | 100万あたり $0.10 | 100万あたり $0.20 |
Carbon と Argon は導入価格を共有しており、12月1日に全料金が2倍になります。AIHubMix は現在、導入価格を掲載していますが、12月以降の料金は公開していません。値上げは確実、ゲートウェイ経由の料金は不明として扱い、予算を確定する前に両方を確認してください。
実際の権限を持つエージェント
Googleネイティブの呼び出しでは、Carbonのガイドはツール実行を逐次的なターンに分けることを推奨しています。この方法を使う場合は、一度に1つずつ呼び出してください。AIHubMixのGeminiガイドではtool_choice="auto"が記載されていますが、ゲートウェイでのCarbon固有のツールサポートと強制ツールの動作は確認されていません。
履歴の最後をモデルのターンにしてはいけません。また、モデルのターンを事前入力することもサポートされていません。ツールの結果が欠けている場合は、次のステップを尋ねるユーザーターンを送信してください。
モデルカードには、まれに遅延やタイムアウトが発生すること、高いレベルではトークンが増えることが記載されています。知識のカットオフは2026年3月です。書き込み権限がある場合、実際のリスクはタイムアウトです。実行がクライアントの制限時間を超えると、作業の一部が残ることがあり、完了したセグメントには課金されます。
コーディングツール:設定する前にモデルページを確認
AIHubMixのCarbonの掲載情報で記載されているのはChat Completionsのみで、Carbonはまだ公開モデルインデックスにありません。Claude CodeにはAnthropic Messagesが、CodexにはResponsesが必要です。AIHubMixでCarbonにどちらが使えるかは確認されていません。どちらも動作すると決めつけないでください。上記リンク先のCarbonモデルページを開き、プロトコルの一覧を確認してください。Chat Completionsしか表示されない場合は、OpenAI互換クライアントを使うか、対応を待ってください。
リクエストの形式はArgonと同じですが、利用できるプロトコルは異なります。現在、AIHubMixでCarbonについて記載されているのはChat Completionsのみです。Claude Codeの投稿ではANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN、API_TIMEOUT_MSを、Codexの投稿ではプロバイダーブロック、wire_api、model_reasoning_effortを取り上げています。異なるのは、プロトコルが利用可能かどうかです。
| クライアント | 必要なプロトコル | AIHubMixでのCarbon |
|---|---|---|
| Claude Code | Anthropic Messages | 記載なし |
| Codex | Responses API | 記載なし |
| OpenAI SDK | Chat Completions | 記載あり |
設定:
- モデル ID:
gemini-4-carbon。 - 思考:low、medium、high。デフォルトはmedium。
- effortのマッピング:ネイティブフィールドは
thinking_level、互換フィールドはreasoning_effortです。Googleはeffortの値をマッピングしていますが、AIHubMixはCarbonのマッピングを公開していません。どちらか一方を送信してください。 - コンテキスト:Googleでは1,048,576です。AIHubMixはCarbonの上限を公開していないため、ベンダーの数値を前提に構築しないでください。
- 既知の問題:highで最初のトークンが遅いこと、ベンダーがツールの逐次ターンを推奨していること、AIHubMixの保守的な未確認上限が65,536出力トークンであること、カットオフが2026年3月であること。
スモークテスト(10~15分):
- 失敗するユニットテストが1つあり、1分以内に終わるテストコマンドを実行できる、小規模なリポジトリを選びます。
- モデルを
gemini-4-carbonに設定し、max_tokensを65,536以下に、HTTPタイムアウトを少なくとも15分に設定します。 - テストを成功させる最小限の変更を行うようツールに指示し、テストコマンドを実行して差分を確認します。
- 合格:編集が最小限で、10~15分以内にテストが成功する。不合格:応答が400だったか、回答が不完全だったか、タイムアウトしたか、編集に問題があったかを記録してください。それぞれ必要な修正は上記のとおり異なります。
- ツールでレベルを指定できる場合はmediumとhighをテストし、制限時間内に完了するほうを選びます。
本番環境で最初のリクエストを送る前のチェックリスト
- モデル IDを
gemini-4-carbonに設定。 temperature、top_p、top_kを指定しない。frequency_penaltyとpresence_penaltyを指定しない。candidate_countは1にするか、省略する。max_tokensを65,536以下に設定。- Googleネイティブのバックグラウンドリクエストでは
store=trueと明示的なmax_output_tokensを指定します。AIHubMixではこの方法について記載されていません。 - HTTPタイムアウトを15分以上に設定。ストリーミングを推奨。
reasoning_effortとthinking_levelのどちらか一方だけを指定。- Googleネイティブではツールの逐次ターンを推奨します。AIHubMixでは
tool_choice="auto"が記載されていますが、Carbonのサポートは未確認です。 - キャッシュ呼び出しは明示的に行わない。安定したプロンプトプレフィックスを先頭に置く。
- 予算には思考トークンと、長いデコードの各ホップを含める。
- 12月1日の料金を、予算の担当者と確認。
- 設定前に、コーディングツールがモデルページに対応しているか確認。
よくある質問
ArgonからCarbonに移行するとき、リクエストボディを変更する必要がありますか?
いいえ。スキーマは変わりません。モデル IDを変更し、値を確認して、400エラーを返すようになったフィールドを削除してください。
max_output_tokensが400エラーになるのはなぜですか?
GoogleのネイティブCarbon APIは、1,048,576を超える値を拒否します。AIHubMixのChat Completions経路には別の保守的な推奨値があり、より大きな上限に対応する経路が公開されるまではmax_tokensを65,536以下にしてください。値が小さすぎると、代わりに思考が途中で切られてしまい、さらに悪い結果になります。回答が不完全でも課金される可能性があります。
応答が空なのはなぜですか?
ステータスがincompleteの場合、モデルがまだ思考中だったためにテキストが空になっていることがあります。処理の料金は発生します。上限を引き上げて再試行してください。
バックグラウンドリクエストが64Kで止まるのはなぜですか?
Googleのネイティブバックグラウンド経路では、max_output_tokensを省略するとサーバーは64Kで停止します。上限を明示的に設定してください。ネイティブの長時間デコードでは、入力分を差し引いた最大1,048,576まで利用できます。AIHubMixではバックグラウンドモードについて記載されていません。
temperatureは反映されますか?
いいえ。temperature、top_p、top_kは無視されます。ペナルティと、1を超えるcandidate_countの値は、代わりに400エラーを返します。
12月1日にCarbonの料金は2倍になりますか?
Googleの料金は2倍になります。入力は$2から$4に、出力は$10から$20に、キャッシュ読み取りは$0.10から$0.20になります。AIHubMixは12月以降の料金を公開していないため、予算を確定する前に確認してください。
CarbonでClaude CodeやCodexを使えますか?
確認されていません。AIHubMixでCarbonについて記載されているのはChat Completionsです。Claude CodeにはAnthropic Messagesが、CodexにはResponsesが必要です。まずモデルページを確認してください。
続けて読む:Gemini 4 Carbonシリーズ
- 移行が進んでいて、残る疑問がCarbonに価格分の価値があるかどうかなら、比較記事で共通の導入価格を並べて確認できます。
Gemini 4 Carbon vs Argon:同じ価格で、Carbonを選ぶ価値があるのはどんなとき? - エンドポイントを移行するのではなく、コーディングエージェントを選んでいるなら、直接比較した記事でツール利用とタスクあたりのコストを確認できます。
Gemini 4 Carbon vs Fable 5.2:エージェント型コーディングにはどちらが向いている?