
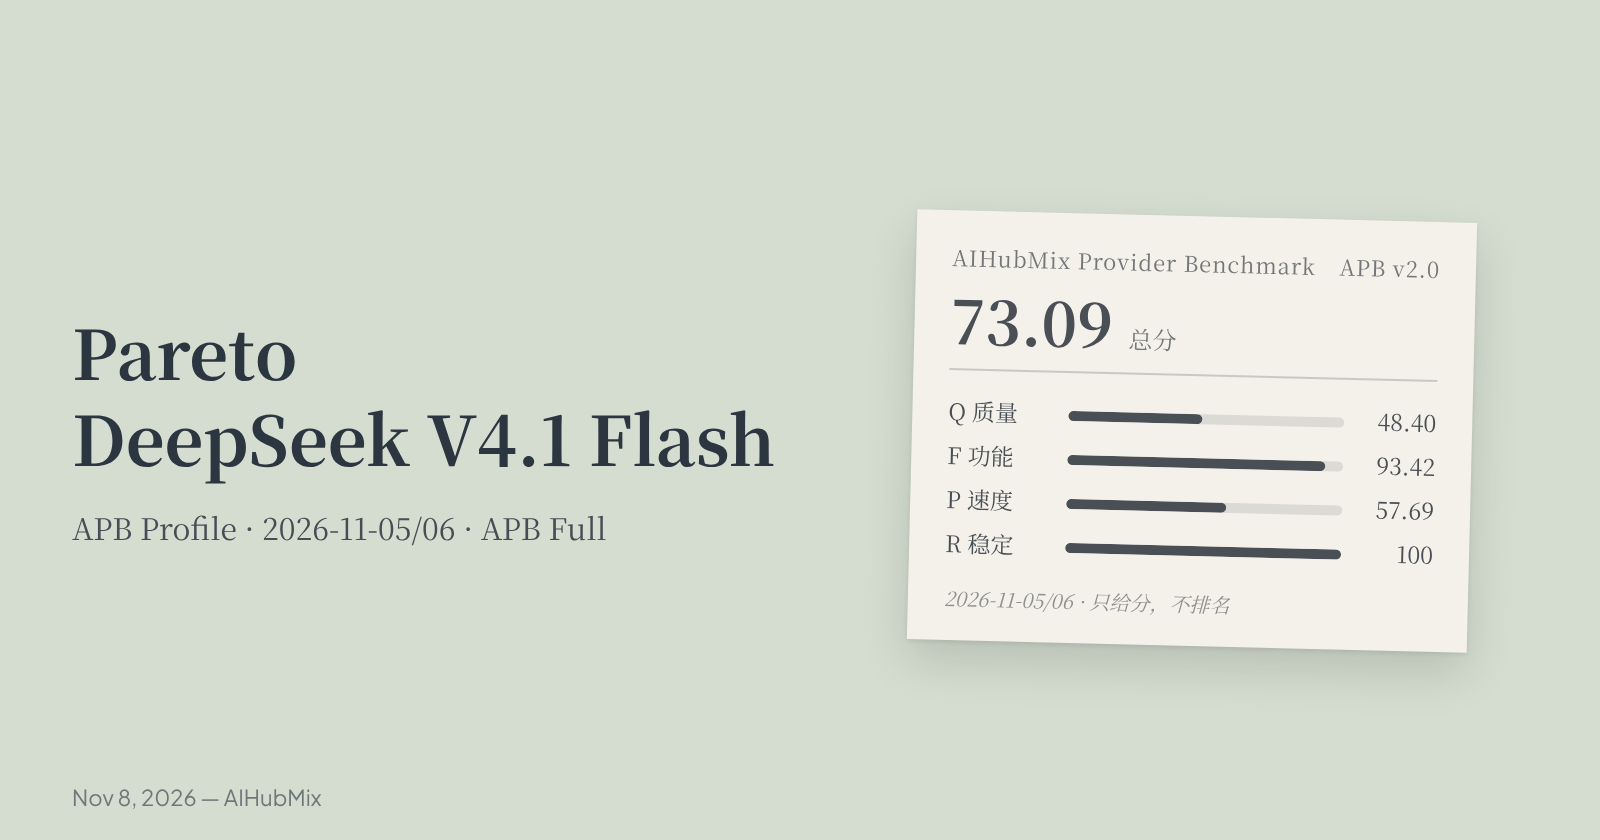
2026-11-05/06、DeepSeek V4.1 Flash 1017をParetoでAIHubMix Provider Benchmark(APB)Fullスイートにかけました。スコアはQ 48.40、F 93.42、P 57.69、K 27.58、R 100で、総合指数は73.09です。このAPB Profileの対象はParetoのみです。モデル名はDeepSeek V4.1 Flash 1017です。
この記事ではスコアのみを報告し、順位付けやプロバイダーの推奨は行いません。まずQ、F、P、K、Rを示し、総合指数は信頼区間のない要約値です。基準はAIHubMix Provider Benchmark Standard v2.0です。
6プロバイダーのスコア
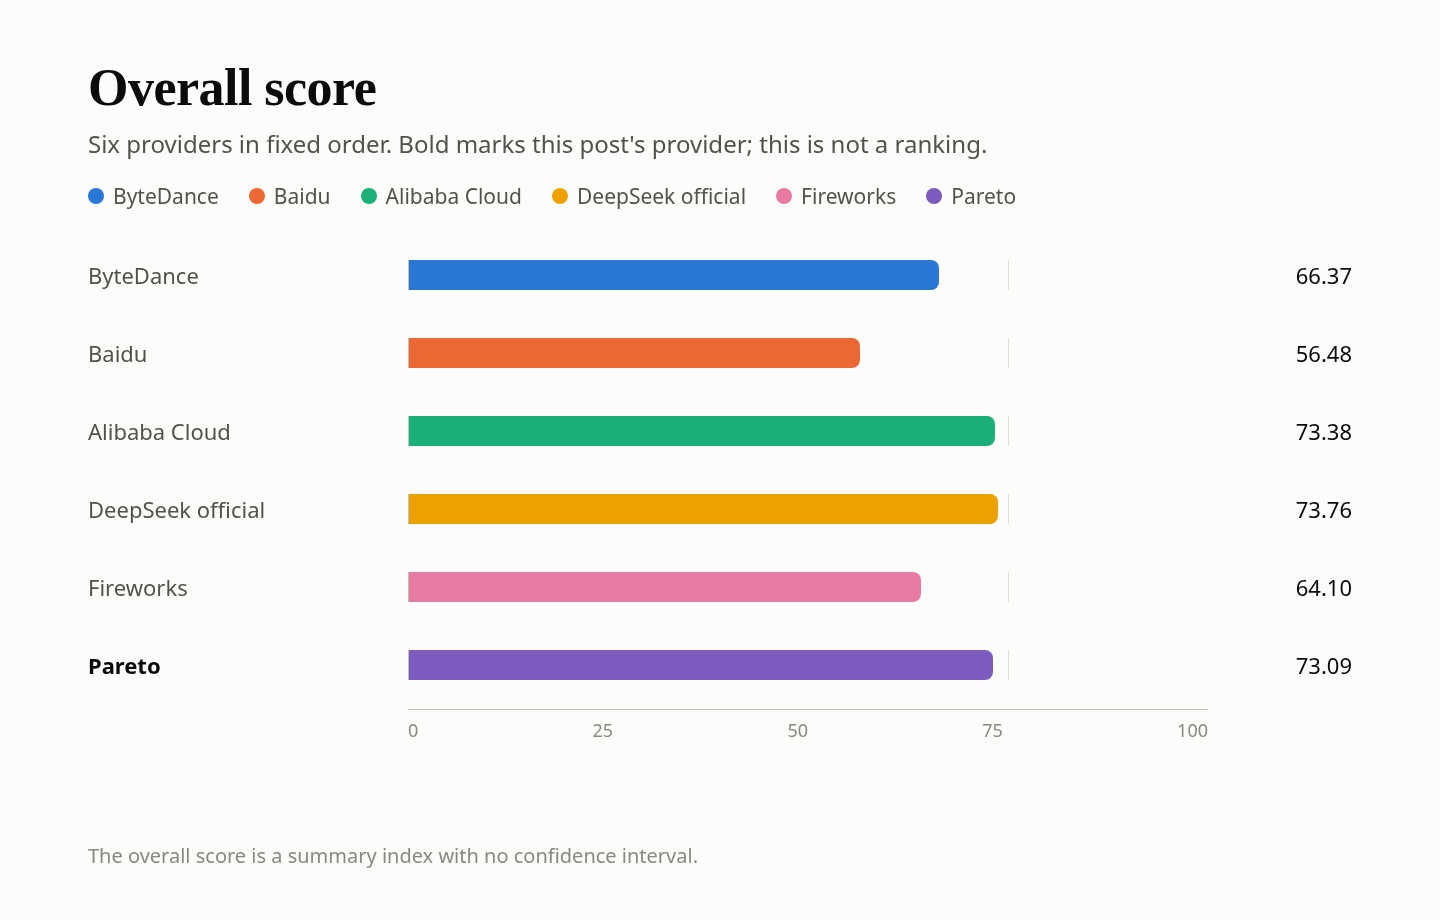
太字はこの記事の対象プロバイダーです。表示順は固定で、順位ではありません。KはPのサブスコアで、ウェイトは20%です。総合指数は信頼区間のない要約値です。DeepSeek公式チャネルとAlibaba Cloudの差は0.37で、区別できません。
概要
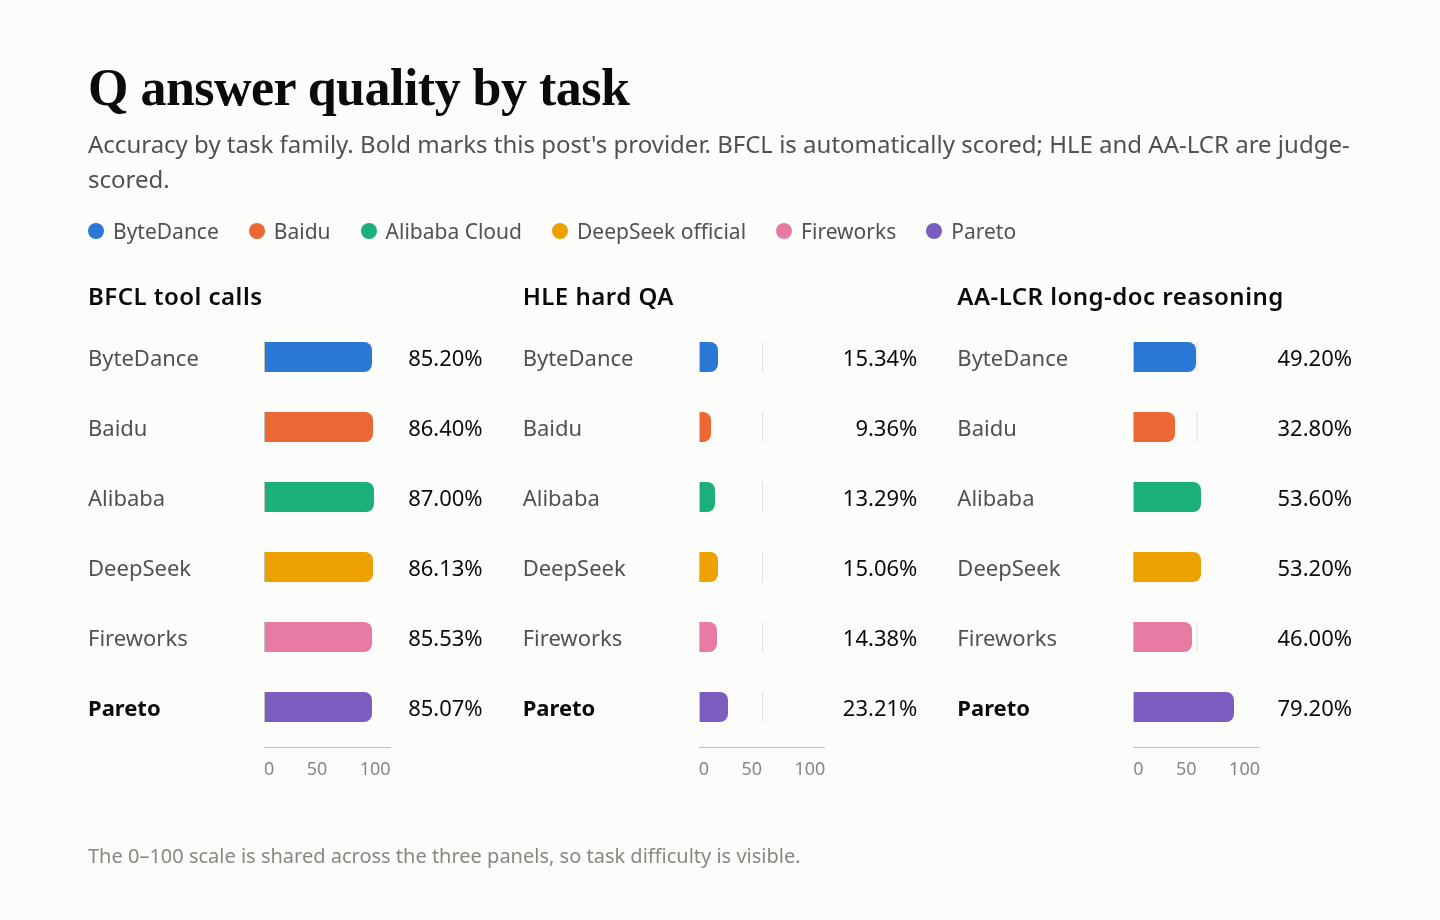
- Q — 回答品質:48.40。BFCL 85.07%、HLE 23.21%、AA-LCR 79.20%。公式チャネルとの差:+5.94パーセントポイント、95% CIは+3.54~+8.36。HLEではサービス障害が996件あり、その大半は思考によって出力長の上限を使い切ったために途中で切れました。これらは不正解として集計しています。
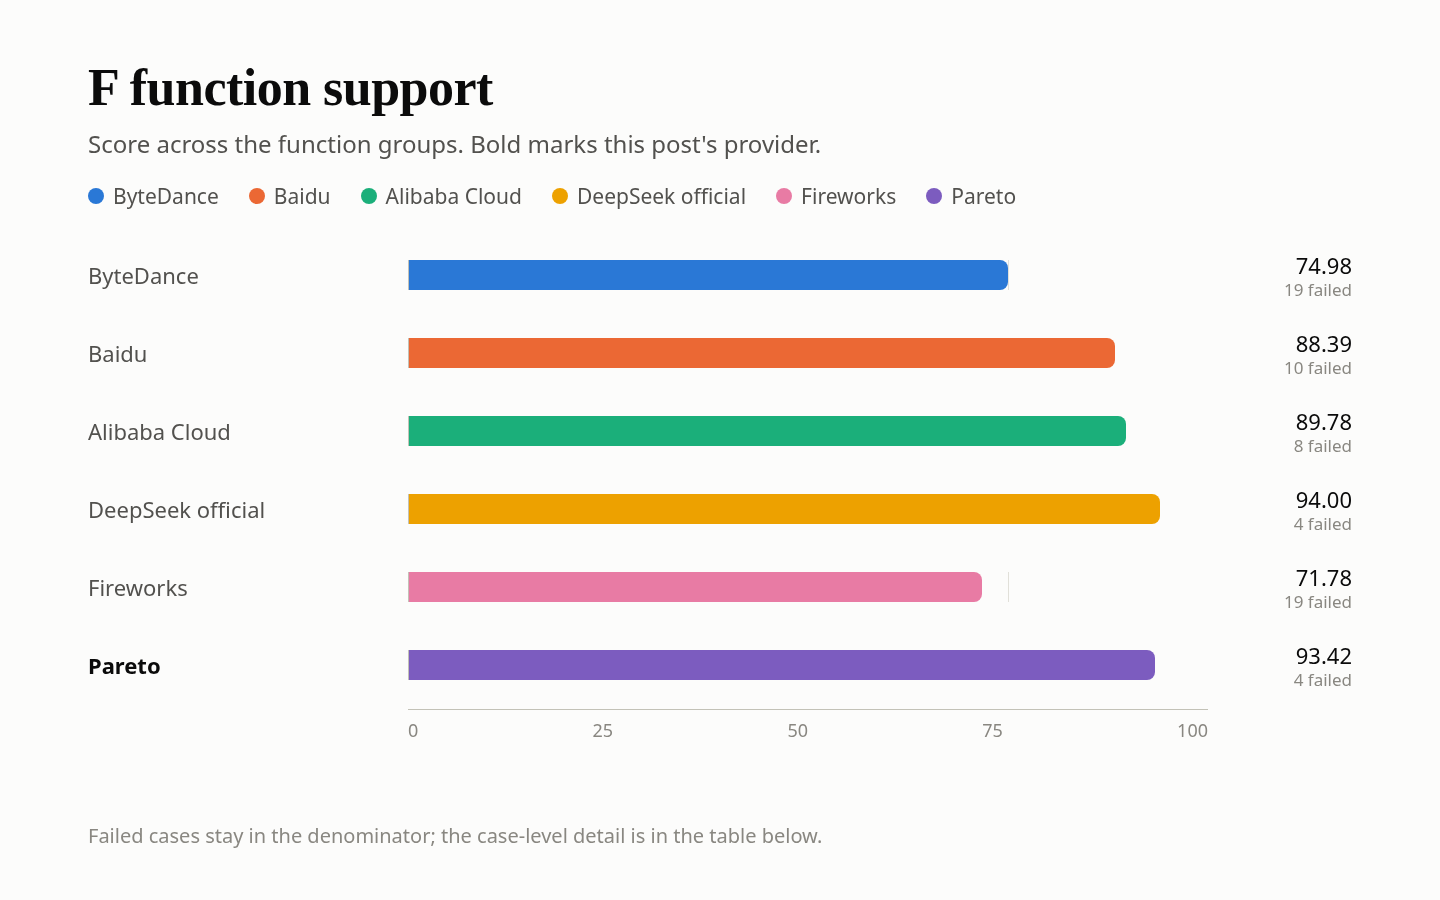
- F — 機能サポート:93.42。集計対象の33項目中29項目に合格(ストリーミング23/27、エラー3/3、計測3/3)。147項目は分母から除外しました。不合格4項目のうち、3項目はstop sequenceを含むリクエストで本文が空になり、1項目はストリーミングテキストのテストデータと完全一致しませんでした。
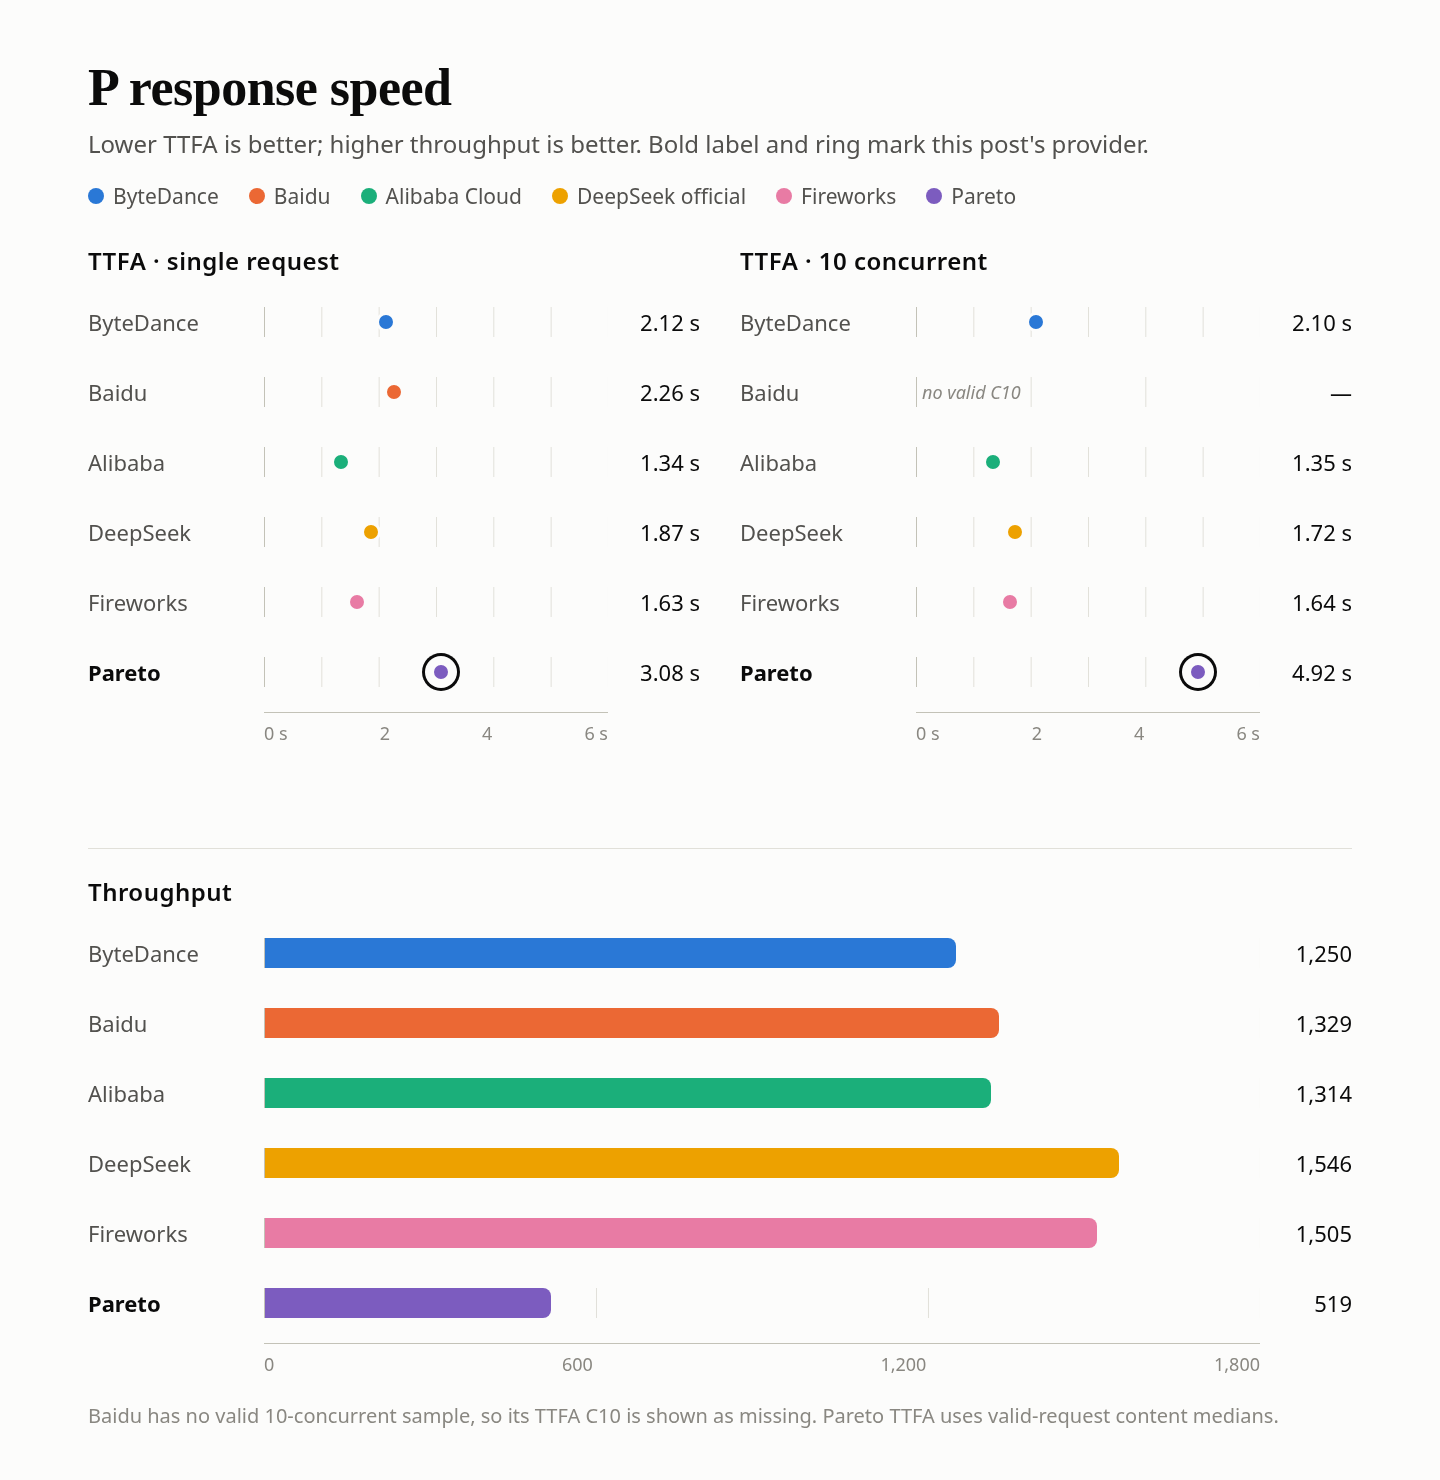
- P — 応答速度:57.69。応答スコア65.22、キャッシュKは20%。有効リクエストのTTFA中央値は同時実行数1で3.08秒、10で4.92秒。無効リクエストも含むスコア計算用の中央値は5.85秒と6.13秒です。180件のプローブのうち有効だったのは110件で、70件は思考によって速度テストの出力上限を使い切ったため無効でした。
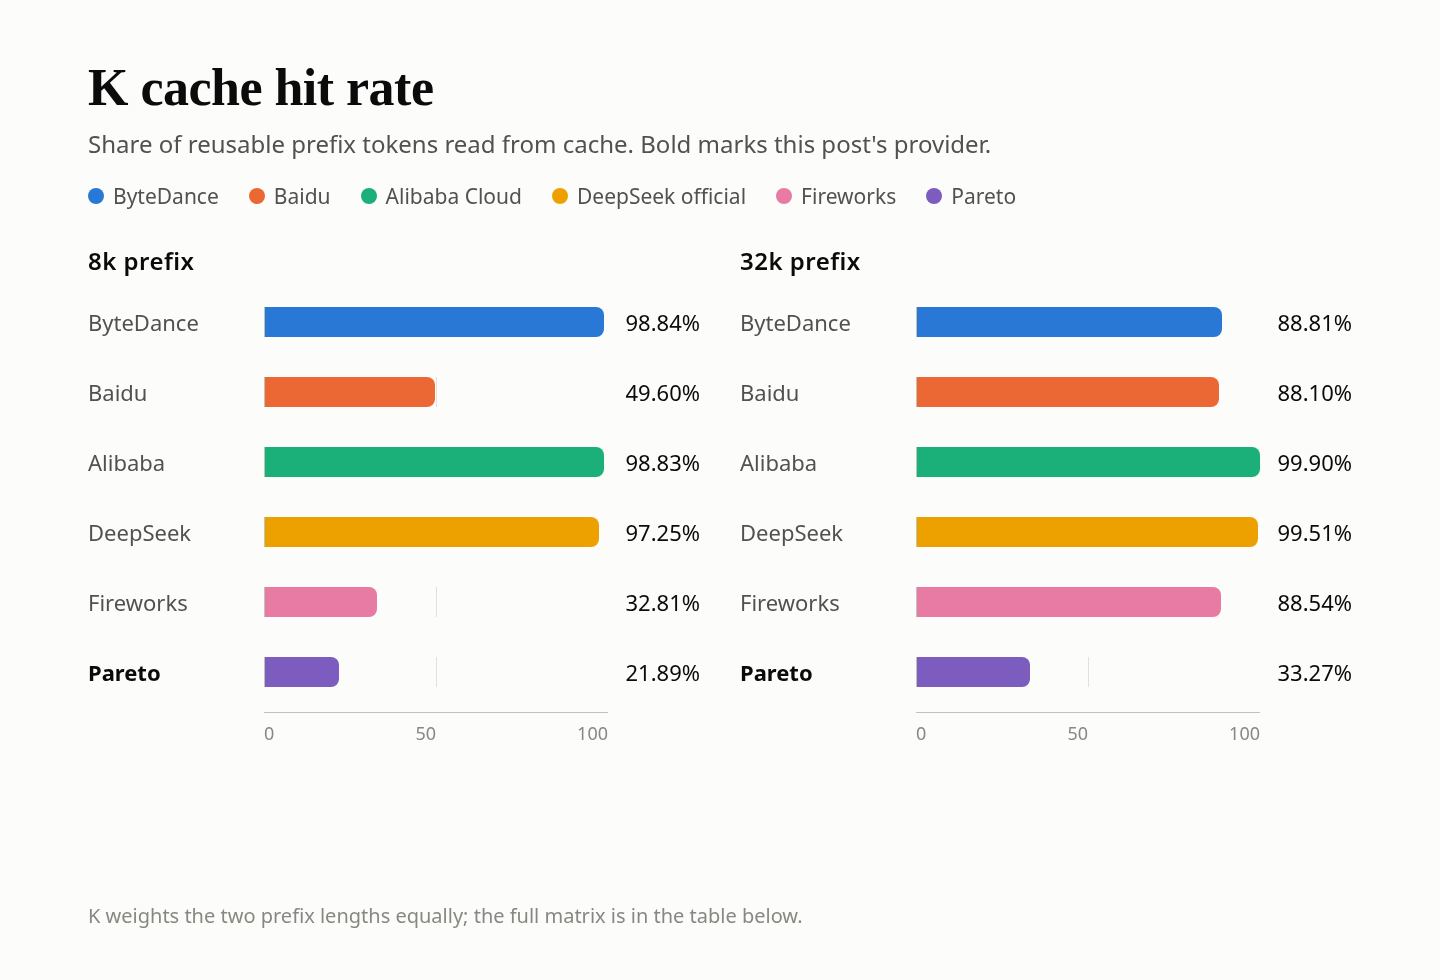
- K — キャッシュ:27.58。8k hotは2/9(読み取り15,872/再利用可能72,504)、32k hotは3/9(読み取り96,000/再利用可能288,513)。デフォルト構成で採点しました。
- R — サービス安定性:100。専用リクエスト300/300件が初回で成功しました。
テスト設定
| 項目 | 設定 |
|---|---|
| モデル | DeepSeek V4.1 Flash 1017 |
| リクエストしたモデル ID | deepseek/deepseek-v4.1-flash |
| アクセス経路 | Pareto、上記のモデル IDを使用 |
| パラメーター | temperature 1.0、max_tokens 16,384、タイムアウト300秒;ストリーミングリクエストのみ |
| 思考 | 高強度の思考を有効化 |
| 日時 | 2026-11-05/06 UTC+8;キャッシュは2026-11-06にデフォルト構成で再テスト |
| サンプル数 | Q 4,250(BFCL 500×3、HLE 250×10、AA-LCR 25×10);F 60×3;P 90+90;R 300;K 30 |
| 注記 | 今回の実行では高強度の思考を有効化しました。同シリーズの他の5プロバイダーでは思考を使用していません。機能サポートはストリーミング対応サブセットを対象に採点し、キャッシュはデフォルト構成を使用します。 |
リクエストにはAIHubMixのクイックスタートを使用しました。モデル IDはモデルページに掲載されています。
Q — 回答品質:48.40
スイートではBFCLを500問×3ラウンド、HLEを250問×10、AA-LCRを25問×10実行しました。BFCLは自動採点し、HLEとAA-LCRはdeepseek-flashで評価しました。3種類のテストでは、他プロバイダーと同じ項目を使用しています。採点できない回答10件を除外し、採点対象は4,240件となりました。
| タスク | 質問数 | 正解数 | 正答率 | 失敗数 |
|---|---|---|---|---|
| BFCLツール呼び出し | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE難問QA | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR長文推論 | 25 × 10 | 198/250 | 79.20% | 0 |
| 合計 · 95% CI 45.39%~51.26% | — | 2,052/4,240 | 48.40% | 996 |
失敗は不正解として分母に含めています。HLEでは996件が思考によって出力長の上限を使い切ったため途中で切れました。完全な回答が返されたHLEの1,494件のうち、正解は578件(約38.7%)でした。
| BFCLカテゴリ | 合格数 | 合格率 |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_pythonは333/360(92.50%)、multipleは269/300(89.67%)、ahm_multi_turnは102/150(68.00%)、irrelevanceは104/150(69.33%)に合格しました。
他の5プロバイダーとの比較
公式チャネルとの差をパーセントポイントで表示。95%区間はエラーバーで示します。0をまたぐ場合は区別できません。判定に用いたdeepseek-flashは同じファミリーに属し、較正されていないため、甘めに判定する可能性があります。
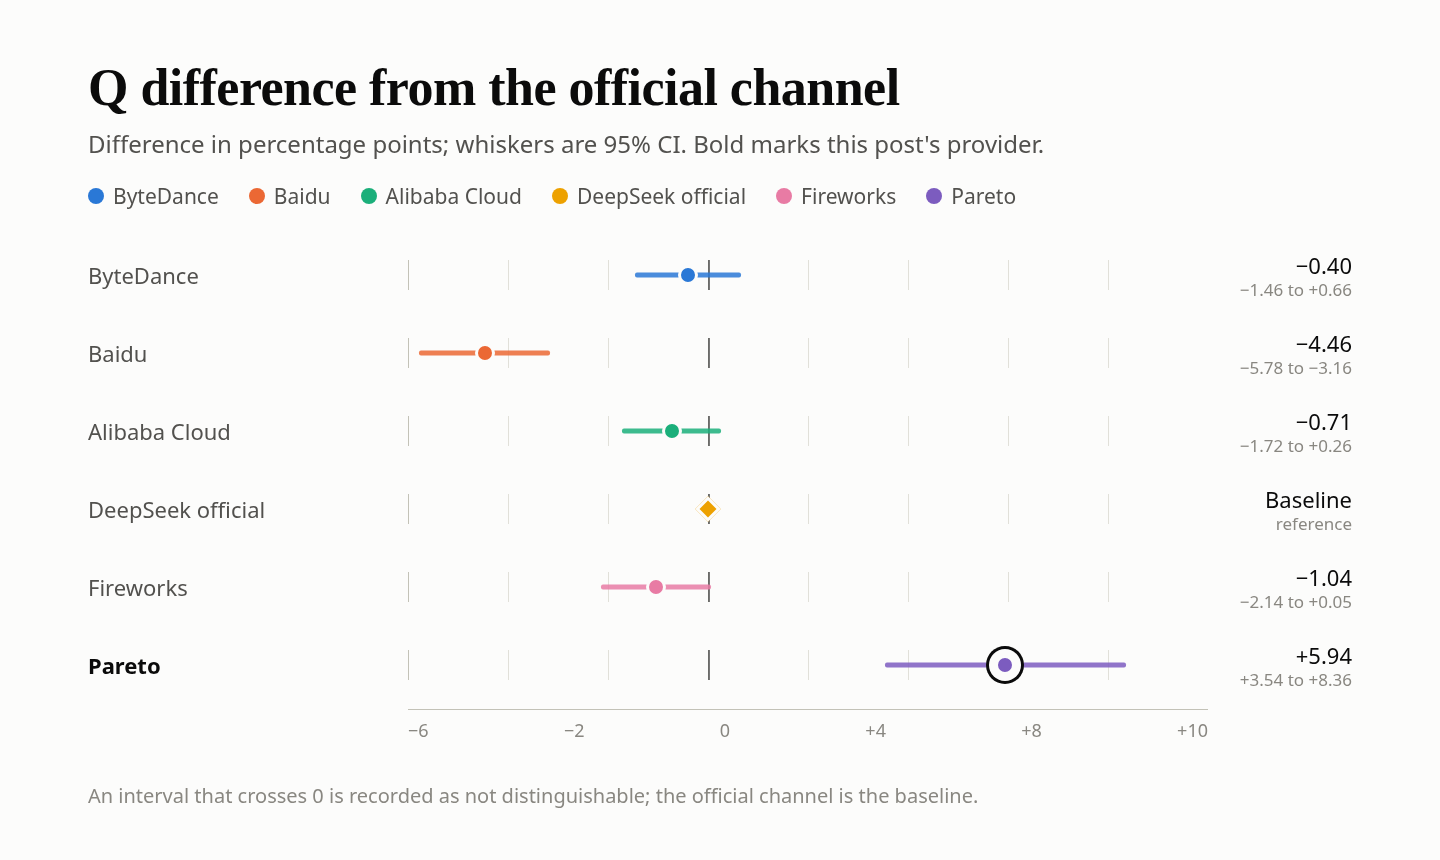
公式チャネルとの差は数値上、+5.94(+3.54~+8.36)です。
F — 機能サポート:93.42
集計対象33項目のうち29項目に合格し、147項目は集計対象外でした。93.42という値は、実測したグループ間で元のグループウェイトを再正規化したものです(ストリーミング20%、エラー15%、計測10%;合計45%)。単純な合格率は29/33で87.88%です。ツール、制約、コンテキストはすべて集計対象外でした。
| テストケースのグループ | ウェイト | 合格数 | 除外数 | グループスコア |
|---|---|---|---|---|
| ストリーミングとメッセージング | 20% | 23/27 | 3 | 85.19 |
| ツールインターフェース | 20% | — | 30 | — |
| 出力制約 | 20% | — | 30 | — |
| コンテキストと状態 | 15% | — | 30 | — |
| エラーと復旧 | 15% | 3/3 | 27 | 100.00 |
| 計測とキャッシュ | 10% | 3/3 | 27 | 100.00 |
| 実測値/ウェイト調整後 | — | 29/33 | 147 | 93.42 |
「失敗したウィンドウ」は、テストケースに合格しなかった3つのウィンドウを数えています。
| 不合格のテストケース | 失敗したウィンドウ数 | 理由 |
|---|---|---|
| ストリーミングstop | 3/3 | stop指定時に本文が空 |
| ストリーミングテキスト | 1/3 | 本文末尾に余分なピリオドがあり、テストデータと不一致 |
他の5プロバイダーとの比較
P — 応答速度:57.69
採点には最初のトークンまでの時間ではなく、最初のコンテンツトークンまでの時間を使用します。思考を有効にすると、モデルはユーザーに見える回答テキストより先に思考内容を生成するため、コンテンツが届くまでの待ち時間は最初のパケットまでの待ち時間より長くなります。3つのウィンドウそれぞれで、同時実行数1のリクエストを30件、同時実行数10のリクエストを30件送信し、合計180件となりました。
| 指標 | 結果 |
|---|---|
| コンテンツTTFA | スコア計算用の中央値は5.85秒(c=1)、6.13秒(c=10);有効リクエストの中央値は3.08秒、4.92秒 |
| 最初のトークンまでの時間 | 有効リクエストの中央値は1.46秒、1.76秒 |
| TPOT | 遅い方のスコア帯は4.87 ms/トークン |
| Goodput | 同時実行数10で519 token/s |
| 有効数 | c=1で53/90、c=10で57/90、合計110/180;70件は思考によって速度テストの出力上限(約2,048トークン)を使い切ったため無効 |
| 構成要素 | TTFA 24.59、TPOT 100.00、goodput 72.05;応答スコア65.22 |
| Pの内訳 | 65.22 × 80% + 27.58 × 20% = 57.69 |
Goodputの分子には思考トークンを含めません。
K — キャッシュ:27.58
2026-11-06にデフォルト構成で再テストした際の読み取り数を集計。リクエストごとのキャッシュマトリクスは含まれていません(生のトレースは移行されていません)。Kは2種類のプレフィックス長を同じウェイトで評価し、Pの20%を占めます。
| プレフィックス | hotヒット数 | 読み取り数/再利用可能数 | セグメント |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K(同一ウェイト) | 27.58 |
coldコントロールは各長さで6/6に合格しました。
R — サービス安定性:100
同時実行数1で、短文、長い入力、ツール呼び出し、マルチターン履歴を対象に300件のリクエストを実行しました。確認したのは初回応答の有効性と完全性のみで、回答の採点やリトライは行っていません。QとPの失敗はここでは再集計していません。
| リクエストの種類 | 初回成功率 |
|---|---|
| 短文 | 120/120 |
| 10kの長い入力 | 90/90 |
| ツール呼び出し | 60/60 |
| マルチターン履歴 | 30/30 |
| 合計 · 95% CI 98.78%~100% | 300/300 |
よくある質問
Q 48.40は何を対象にしていますか?
BFCL、HLE、AA-LCRの採点対象4,240件の結果です。正解は2,052件、正答率は48.40%、95% CIは45.39%~51.26%です。公式チャネルとの差は数値上、+5.94(+3.54~+8.36)です。
HLEでサービス障害が996件あったのはなぜですか?
大半は思考によって出力長の上限を使い切ったために途中で切れました。不正解として分母に含めています。
147項目が除外されているのに、Fが93.42なのはなぜですか?
ストリーミング対応サブセットのみを集計しています。実測したグループ間でウェイトを再正規化しており、ツール、制約、コンテキストはすべて集計対象外です。
stopのテストケースが失敗したのはなぜですか?
stop sequenceを含むリクエストは、3つのウィンドウすべてで本文が空でした。
速度プローブ180件のうち70件が無効だったのはなぜですか?
思考によって速度テストの出力上限(約2,048トークン)を使い切ったためです。
R 100は何を対象にしていますか?
専用リクエスト300件がすべて初回で有効でした。95%信頼区間の下限は98.78%です。QとPの失敗はRには含めていません。
続けて読む:DeepSeek V4.1 Flashシリーズ
- 思考を無効にした後もByteDanceが思考トークンを報告:ByteDanceでのDeepSeek V4.1 Flash:ツール呼び出しは一致、使用量計測は不一致
- Baiduの記録はQ 38.00、P 37.77:BaiduでのDeepSeek V4.1 Flash:QとPを満たす利用可能チャネルなし
- Alibaba Cloudの記録は最初のトークンまで1.34秒、キャッシュ99.37:Alibaba CloudでのDeepSeek V4.1 Flash:最初のトークンまで1.34秒、キャッシュ99.37
- 公式チャネルをQの基準値とし、Fは94.00:公式チャネルでのDeepSeek V4.1 Flash:F 94.00、無効なプローブ15件
- Fireworksではstop要求で空の応答が返り、8kでキャッシュヒットは3/9:FireworksでのDeepSeek V4.1 Flash:stop要求で空の応答、キャッシュヒット3/9


