

2026-11-03/04、5つのプロバイダー経由でDeepSeek V4.1 Flash 1017をAPB Fullスイートで実行しました。いずれも同じ質問、パラメーター、リクエストスクリプトを使用し、すべてAIHubMix経由でアクセスしました。このAPB ProfileではFireworksのみを取り上げます。モデルはDeepSeek V4.1 Flash 1017として掲載されています。
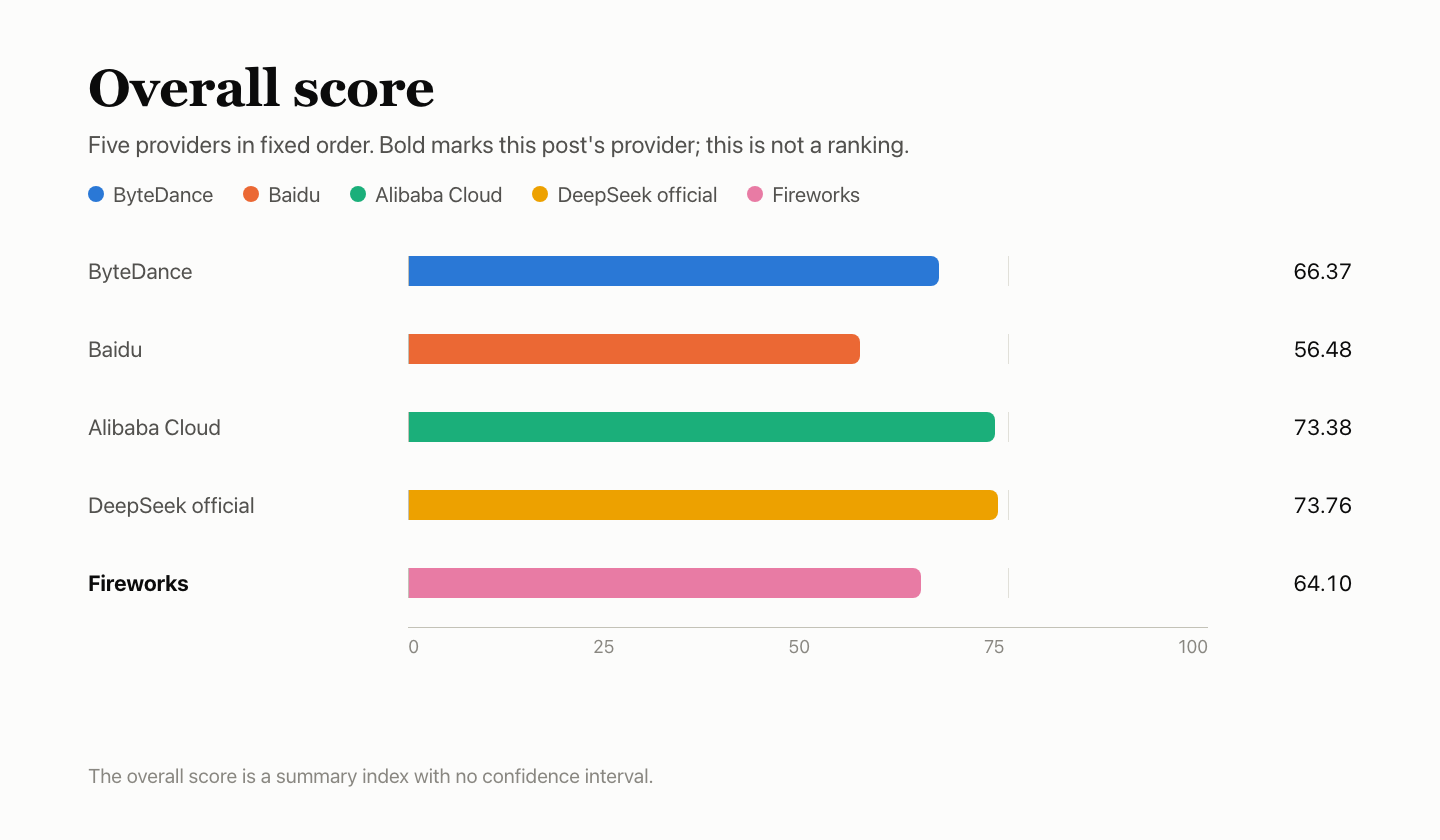
スコアはQ 41.42、F 71.78、P 79.51、K 60.68、R 100で、総合指数は64.10です。この記事ではスコアのみを報告し、順位付けやプロバイダーの推奨は行いません。まずQ、F、P、K、Rを示し、総合指数は信頼区間のない要約値です。基準はAIHubMix Provider Benchmark Standard v2.0です。
5つのプロバイダーのスコア
太字はこの記事で取り上げるプロバイダーです。プロバイダーの順序は固定で、順位を示すものではありません。KはPのサブスコアで、比重は20%です。総合指数は信頼区間のない要約値です。DeepSeek公式チャネルとAlibaba Cloudの差は0.37で、区別できません。
概要
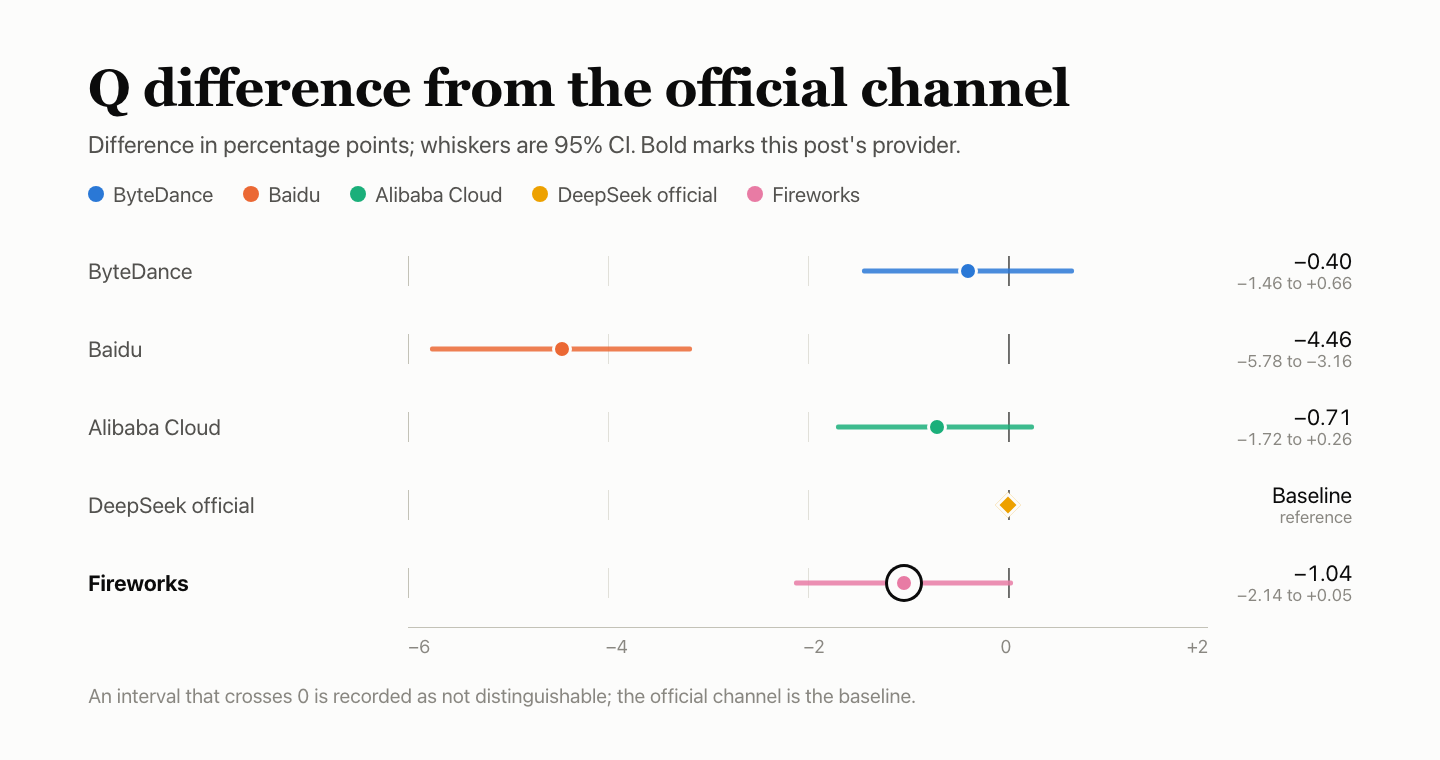
- Q — 回答品質:41.42。 BFCL 85.53%、HLE 14.38%、AA-LCR 46.00%。公式チャネルとの差は−1.04ポイント、95% CIは−2.14~+0.05ポイントで、区別できません。AA-LCRの失敗34件はすべてウィンドウ2で発生し、不正解としてカウントしました。
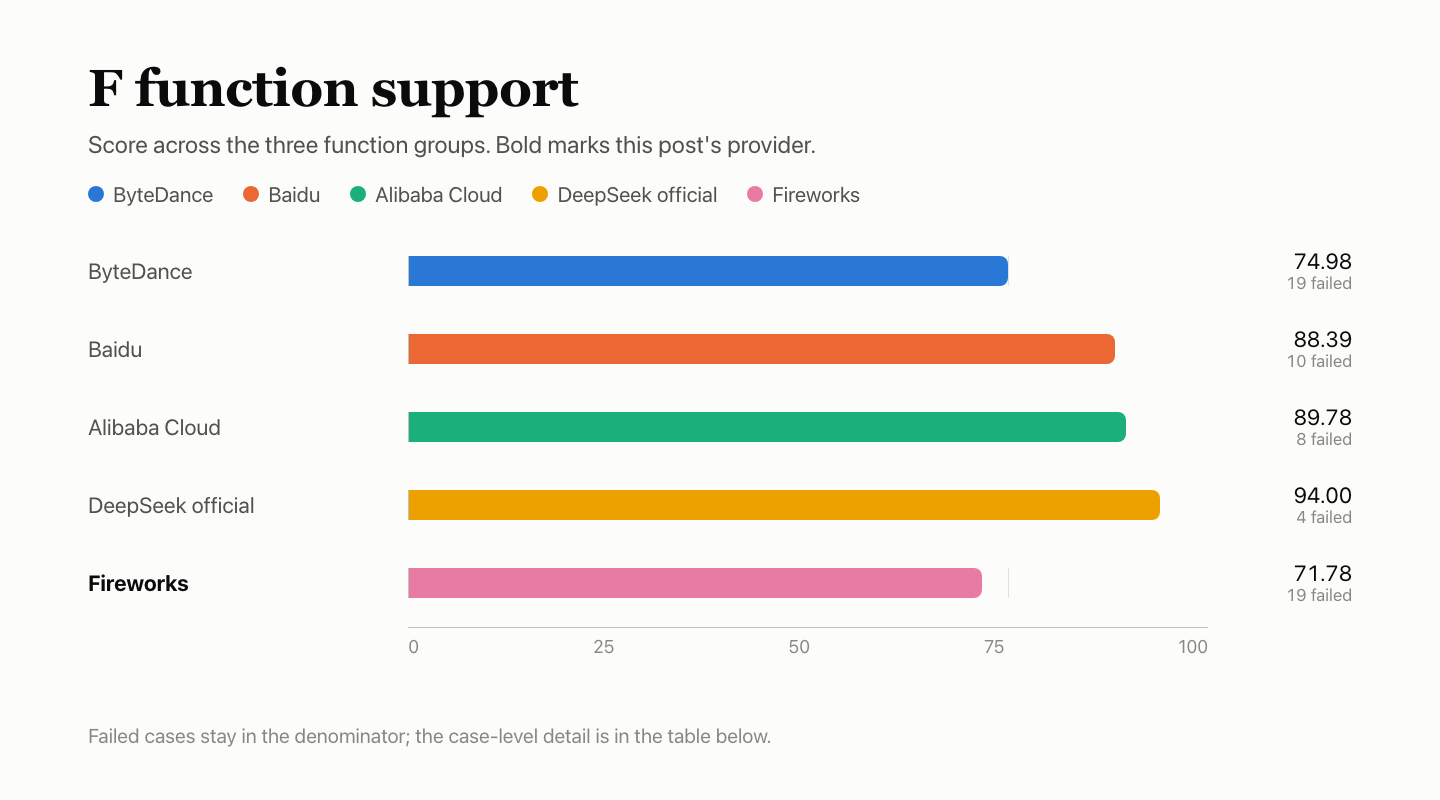
- F — 機能サポート:71.78。 カウント対象の177項目中122項目に合格しました。stopを指定した2つのケースはいずれも空の本文を返しました。
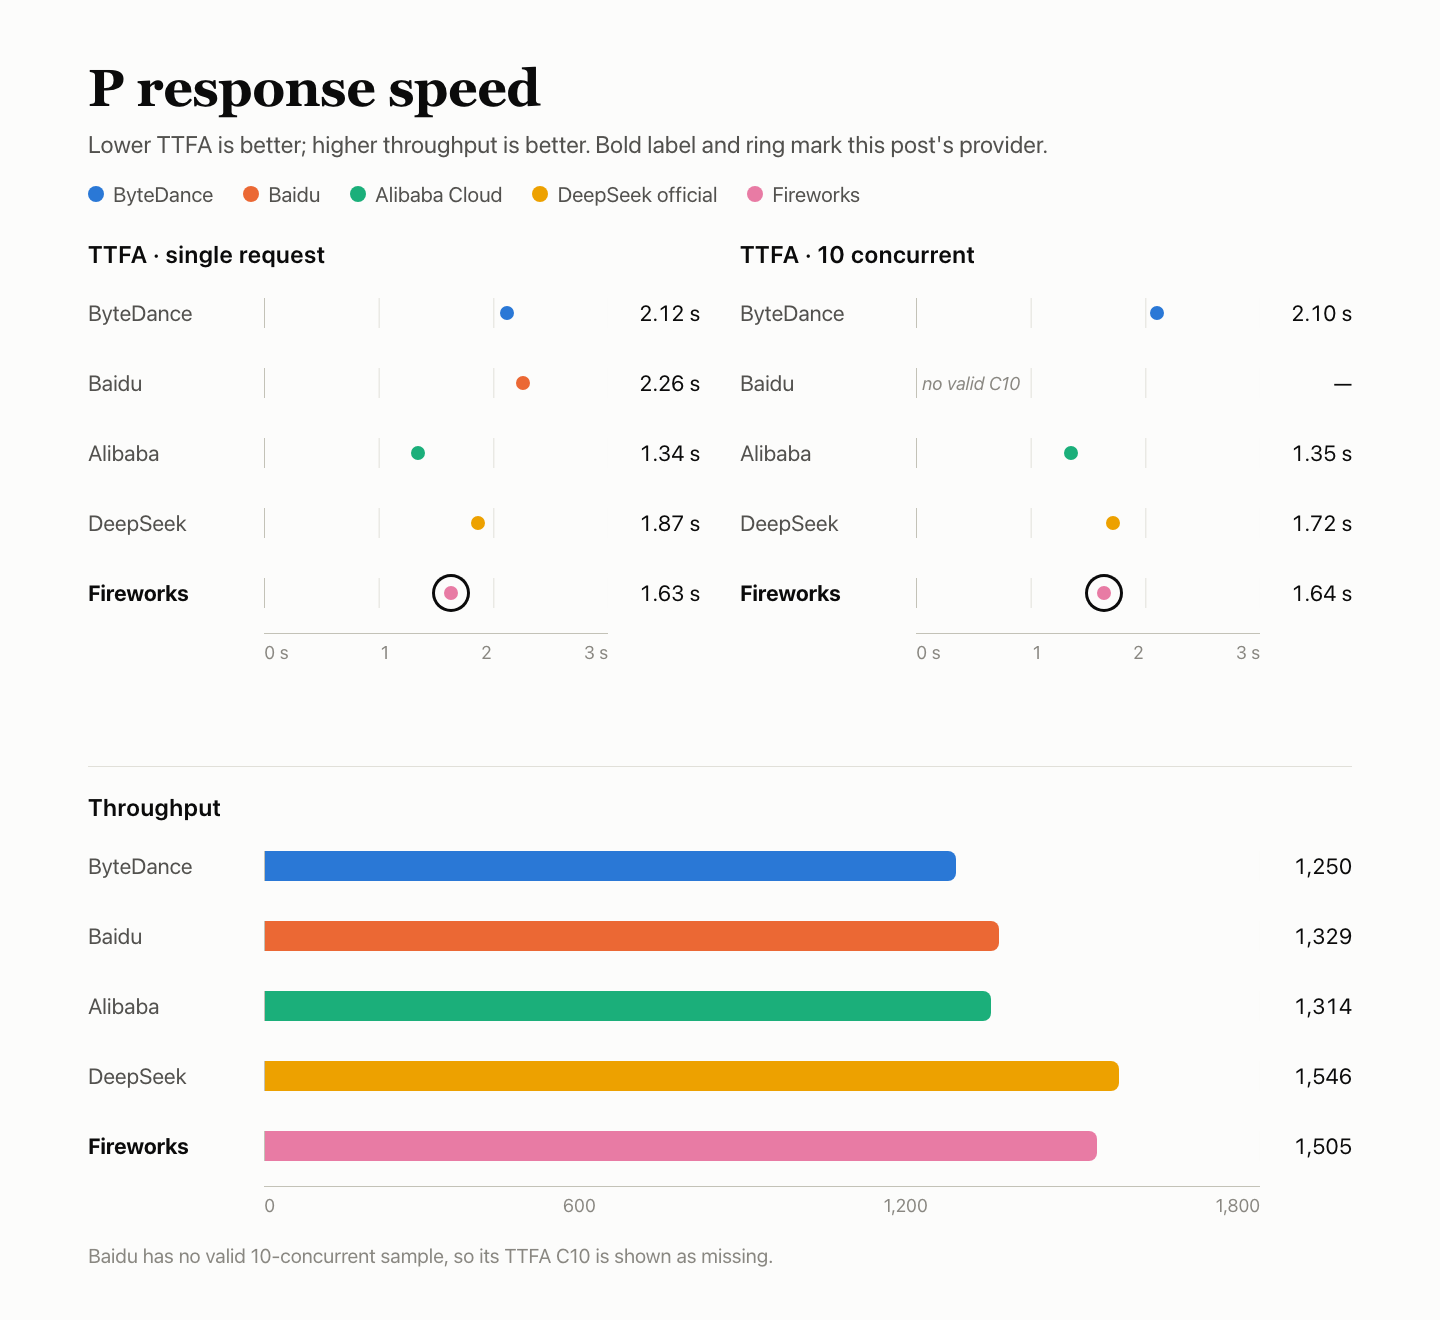
reasoning_effort=noneを指定しても思考モードはオフにならず、10kの入力は、ネイティブのカウントが10,000であるのに対し、10,026トークンと報告されました。 - P — 応答速度:79.51。 応答スコアは84.22、キャッシュKの比重は20%。TTFA中央値は単一同時実行で1.63 s、同時実行数10で1.64 s、TPOTは3.29 msでした。180件の出力のうち1件は単一トークンで、無効と判定されました。
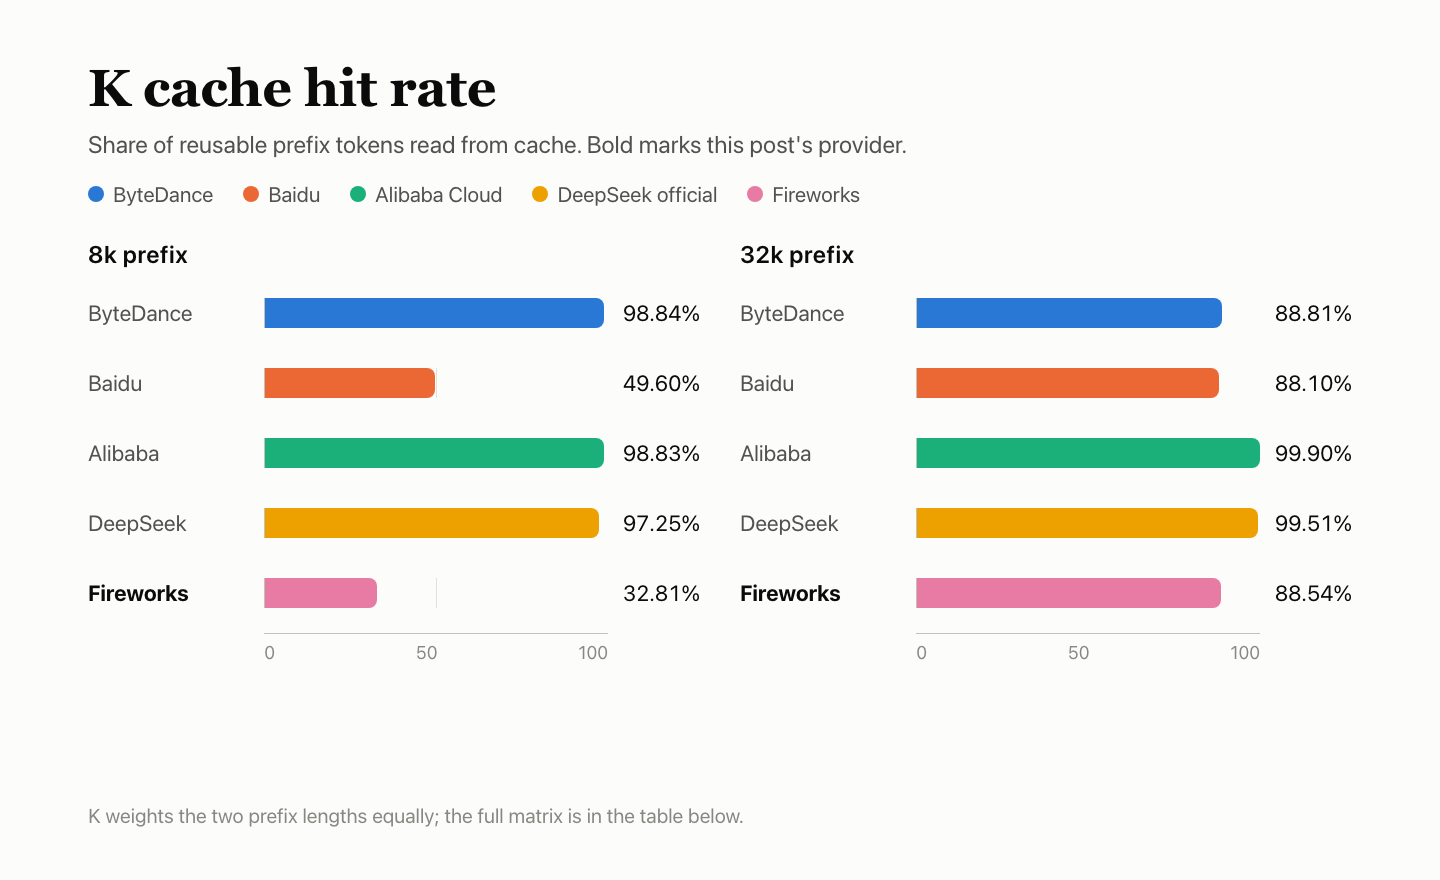
- K — キャッシュ:60.68。 Kのプローブでは、文書に記載されたセッションアフィニティを使用しました。32kのホットキャッシュは8/9、8kのホットキャッシュは3/9でした。
- R — サービス安定性:100。 専用リクエスト300件中300件が、初回の試行で成功しました。
テスト設定
| 項目 | 設定 |
|---|---|
| モデル | DeepSeek V4.1 Flash 1017 |
| 指定したモデル ID | fireworks-deepseek-v4.1-flash-1017 |
| 返されたモデル名 | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| アクセス経路 | AIHubMixのプロバイダーモデル ID。プロバイダー自身のアカウントではありません |
| パラメーター | 非思考モード、temperature 1.0、max_tokens 16,384、タイムアウト300 s、リトライなし |
| 思考モードをオフ | ネイティブのthinking.type=disabledを使用。reasoning_effort=noneでは思考モードはオフになりません。機能テストではreasoning_effort=noneを維持しました。 |
| 実施時刻 | 2026-11-03 18:07 – 11-04 16:33 UTC+8。5つすべてで同じMac mini、ネットワーク、アカウントを使用。 |
| サンプル数 | Q 4,250(BFCL 500×3、HLE 250×10、AA-LCR 25×10);F 60×3;P 90+90;R 300;K 30 |
| 追加設定 | Kのプローブでは、レプリカのアフィニティを得るため、文書に記載されたuserフィールドとx-session-affinityヘッダーを付与しました。 |
リクエストにはAIHubMixのクイックスタートを使用しました。モデル IDはモデルページに記載されています。思考モードをオフにするには、モデルのAPIドキュメントに記載されたネイティブのthinking.type=disabledを使用しました。
Q — 回答品質:41.42
スイートではBFCLの質問500件を3ラウンド、HLEの質問250件を10ラウンド、AA-LCRの質問25件を10ラウンド実行しました。BFCLは自動採点し、HLEとAA-LCRはdeepseek-flashで判定しました。5つすべてに同じ質問を与えました。採点不能な回答10件を除外し、採点対象は4,240インスタンスとなりました。
| タスク | 質問数 | 正解数 | 正答率 | 失敗数 |
|---|---|---|---|---|
| BFCLツール呼び出し | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| HLE難問QA | 250 × 10 | 358/2,490 | 14.38% | 5 |
| AA-LCR長文書推論 | 25 × 10 | 115/250 | 46.00% | 34 |
| 合計 · 95% CI 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
失敗は分母に含め、不正解として扱います。BFCLは2件(ウィンドウ2と3)、HLEはmax_tokensで切り詰められた5件、AA-LCRはすべてウィンドウ2で発生した34件です。
| BFCLカテゴリ | 合格数 | 合格率 |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_pythonは333/360(92.50%)、parallelは270/300(90.00%)、ahm_multi_turnは95/150(63.33%)、irrelevanceは111/150(74.00%)が合格しました。
他の4つとの比較
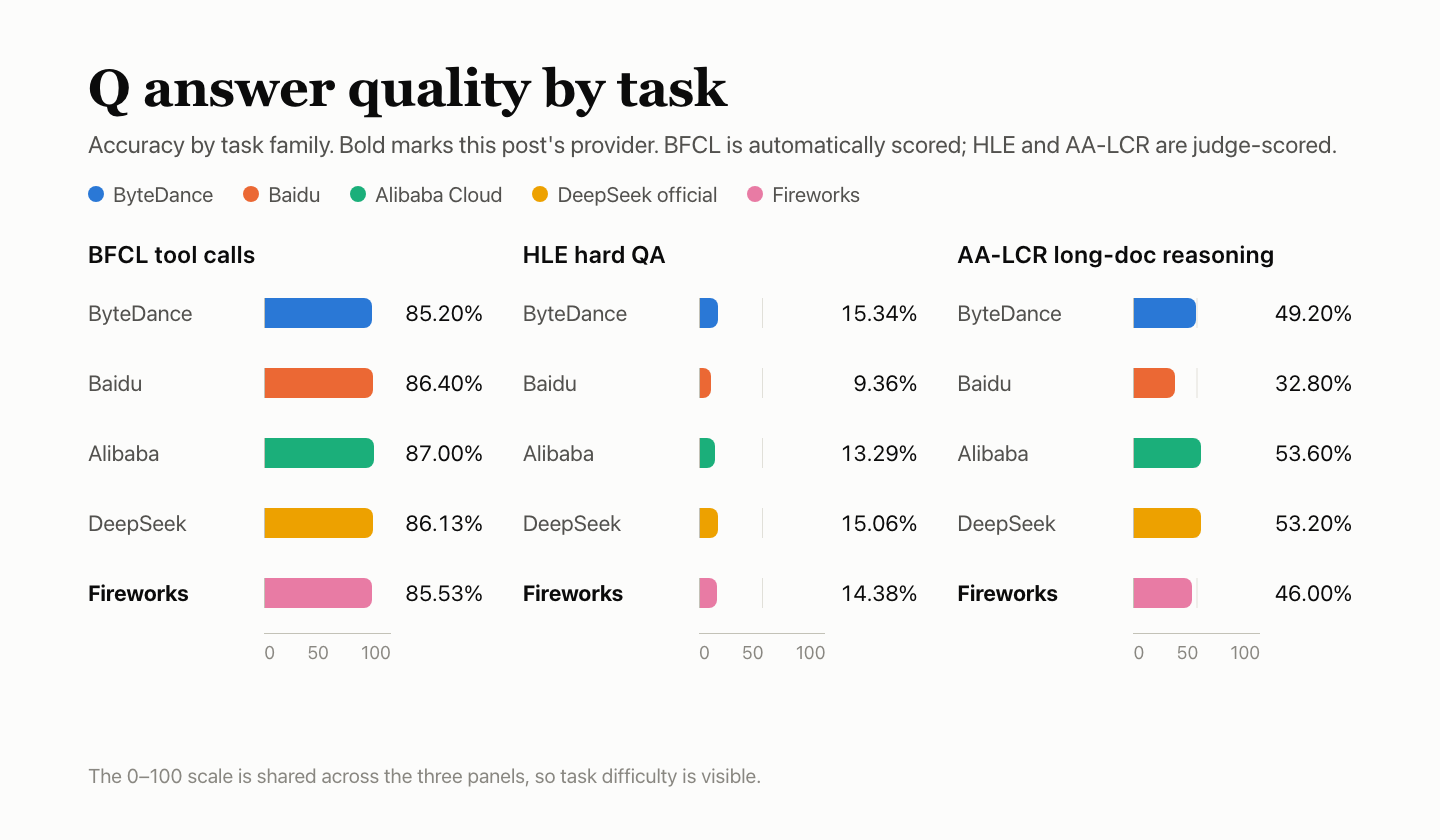
公式チャネルとの差をポイントで示し、95%区間をひげで表示しています。0をまたぐ場合は区別できません。deepseek-flashの判定モデルは同じファミリーに属し、キャリブレーションされていないため、判定が甘い可能性があります。
F — 機能サポート:71.78
60ケースは6グループに分け、各ケースを3つのウィンドウで実行しました。合計180項目を、プロバイダーが文書に記載した形式に照らして判定しました。該当しない項目、無効な項目、観測されなかった項目は分母から除外しています。カウント対象177項目中122項目が合格し、グループごとの重み付けスコアは71.78でした。
| ケースグループ | 重み | 合格数 | 除外数 | グループスコア |
|---|---|---|---|---|
| ストリーミングとメッセージング | 20% | 24/30 | — | 80.00 |
| ツールインターフェース | 20% | 29/30 | — | 96.67 |
| 出力制約 | 20% | 21/30 | — | 70.00 |
| コンテキストと状態 | 15% | 15/30 | — | 50.00 |
| エラーと復旧 | 15% | 21/30 | — | 70.00 |
| 計測とキャッシュ | 10% | 12/27 | 3 | 44.44 |
| 合計 · 加重 | — | 122/177 | 3 | 71.78 |
「失敗したウィンドウ数」は、そのケースが合格しなかったウィンドウの数です。
| 失敗したケース | 失敗したウィンドウ数 | 理由 |
|---|---|---|
| ストリーミング停止 | 3/3 | stop指定時は本文が空。stopなしでは正常に動作。 |
| 本文内の推論 | 3/3 | reasoning_effort=noneでも推論が返されました。 |
| 停止シーケンス | 3/3 | stop指定時は本文が空。stopなしでは正常に動作。 |
| 思考設定 | 3/3 | reasoning_effort=noneでも推論が返されました。 |
| サンプリングの多様性 | 3/3 | Temp 0/1の出力が類似しすぎています |
| 10kの長文入力 | 3/3 | 報告値は10,026、ネイティブ値は10,000。 |
| コンテキスト上限内 | 3/3 | 報告値は10,026、ネイティブ値は10,000。 |
| 32kの長文入力 | 3/3 | 報告値は10,026、ネイティブ値は10,000。 |
| 100kの長文入力 | 3/3 | 報告値は10,026、ネイティブ値は10,000。 |
| コンテキスト上限超過 | 3/3 | パラメーターエラーになるはずが、200が返されました。 |
| 不正なメッセージ | 3/3 | 400、本文は空 |
| 孤立したツール結果 | 3/3 | パラメーターエラーになるはずが、200が返されました。 |
| 不正なstream_options | 3/3 | 400、本文は空 |
| 思考トークンの計測 | 3/3 | 無効化後も思考トークンが報告されました。 |
| ネイティブの入力カウント | 3/3 | 報告値は34、ネイティブ値は8。 |
| 入力内のツール定義 | 3/3 | ツールなしの対照テストでもすでに不一致。 |
| キャッシュをまたいだ入力カウント | 3/3 | 繰り返しのプレフィックスのカウントがネイティブ値と不一致。 |
| ストリーミング時の入力一致 | 3/3 | 報告値は34、ネイティブ値は8 |
| 一度に1つのツール | 1/3 | 上流で500エラー。 |
stopを指定した2つのケースは、同じ入力でstopを指定しない場合は正常に動作した一方、3つのウィンドウすべてで空の本文を返しました。思考に関する2つのケースでは、どちらもreasoning_effort=noneを指定しても推論が返されました。
除外された項目は合格にも失敗にもカウントしません。
| ステータス | ケース | 件数 | 理由 |
|---|---|---|---|
| 該当なし | 明示的なcache_control | 3 | このインターフェースでは未対応として事前登録 |
不正なmessagesとstream_optionsは5つすべてで失敗し、400と空の本文が返され、構造化エラーはありませんでした。この共通の結果はAIHubMixゲートウェイ層に起因する可能性が高く、別途調査が必要です。思考トークンの計測も5つすべてで失敗しましたが、ByteDanceとFireworksは無効化後も思考トークンを報告し、他の3つは思考のカウントを返しませんでした。
他の4つとの比較
P — 応答速度:79.51
各リクエストには約10,000の入力トークンを含め、約1,100の出力トークンを要求しました。3つのウィンドウそれぞれで、同時実行数1のリクエストを30件、同時実行数10のリクエストを30件送り、合計180件を実行しました。
| 指標 | 結果 |
|---|---|
| TTFA | 同時実行数1で1.63 s、同時実行数10で1.64 s |
| TPOT | 同時実行数1で3.24 ms、同時実行数10で3.29 ms |
| Goodput | 同時実行数10で1,504.5 token/s |
| 有効 | 同時実行数1では90/90、同時実行数10では89/90(ウィンドウ3では29/30)。単一トークンの出力が1件。 |
| 構成要素 | TTFA 54.91、TPOT 100.00、goodput 100.00。重みは35/35/30 |
| Pの内訳 | 84.22 × 80% + 60.68 × 20% = 79.51 |
180件中179件が有効でした。無効なリクエストは1トークンを返し、中央値の計算では無限大として扱うため、有効なリクエストだけの場合より中央値が高くなることがあります。TPOTはストリームのチャンクから算出し、goodputは同時実行数10での有効な出力トークン数をバッチの所要時間で割って算出しています。
1台のマシン、1つのネットワーク、1つのアカウントを使用。実施ウィンドウはプロバイダーごとに設定しました。
K — キャッシュ:60.68
各グループは5件のリクエストで構成されます。まず8kまたは32kのプレフィックスをシードし、その後、同じプレフィックスに新しい最後の質問を加えたリクエストを5 s、30 s、120 s後に送り、最後に新しいプレフィックスをコールド対照として送信しました。3つのウィンドウ×2つの長さで合計30件です。Kはホットキャッシュから読み取られたトークン数を再利用可能なトークン数で割った値で、長さは均等に重み付けしています。KはPの20%を占めます。
| プレフィックス | ウィンドウ | シード | +5 s | +30 s | +120 s | コールド対照 |
|---|---|---|---|---|---|---|
| 8k | ウィンドウ1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | ウィンドウ2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | ウィンドウ3 | 0 | 0 | 0 | 0 | 0 |
| 32k | ウィンドウ1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | ウィンドウ2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | ウィンドウ3 | 0 | 31,900 | 31,900 | 0 | 0 |
8kのプレフィックスはホットリクエスト9件中3件でヒットし、再利用可能な72,252トークンのうち23,706トークンが読み取られ、スコアは32.81でした。32kのプレフィックスは9件中8件でヒットし、288,261トークンのうち255,212トークンが読み取られ、スコアは88.54でした。2つの長さを同じ重みで評価したKは60.68です。コールドコントロールでは読み取りは0でした。したがって、同じ設計でも2つのプレフィックス長で挙動は異なりました。Kのプローブでは、文書に記載されたuserフィールドとx-session-affinityヘッダーを使用しました。
R — サービスの安定性:100
3つのウィンドウで、同時実行数1のもと、短文、長文入力、ツール呼び出し、複数ターンの履歴を含むリクエストを300件実施しました。確認したのは初回応答の有効性と完全性のみで、回答の採点は行わず、再試行もしませんでした。QとPの失敗はここでは再計上していません。
| リクエストの種類 | 初回試行の成功率 |
|---|---|
| 短文 | 120/120 |
| 10kの長文入力 | 90/90 |
| ツール呼び出し | 60/60 |
| 複数ターンの履歴 | 30/30 |
| 合計 · 95%信頼区間 98.78%~100% | 300/300 |
300件すべてで、初回に有効かつ完全な応答が返されました。300件すべて成功した場合、95%信頼区間の下限は98.78%であるため、このデータから裏付けられるのは失敗率が1.22%未満であることに限られます。R 100が対象とするのは、この300件のリクエストであり、経路全体ではありません。
| プロバイダー | 初回試行の成功率 | 95%信頼区間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek公式 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
よくある質問
Q 41.42は何を対象にしていますか?
BFCL、HLE、AA-LCRの採点対象インスタンス4,240件です。正解は1,756件、正答率は41.42%、95%信頼区間は39.13%~43.59%で、公式チャネルとの差は統計的に区別できません。
2つのstopケースがどちらも失敗したのはなぜですか?
stopを指定したリクエストは、3つのウィンドウすべてで空の本文を返しました。一方、同じ入力でstopを指定しなければ正常に動作しました。ストリーミングと非ストリーミングの両方で発生しています。
reasoning_effort=noneにすると、思考はオフになりますか?
いいえ。3つのウィンドウすべてで推論内容が返されました。ほかのリクエストでは、ネイティブのthinking.type=disabledを使用しました。
10kの入力が10,026トークンと報告されるのはなぜですか?
10kのケースでは、ネイティブの10,000に対して10,026と報告されました。32kと100kのケースでも同じ10,026と報告され、ツールなしのコントロールでもすでに不一致がありました。
8kでは3/9でヒットし、32kでは8/9でヒットしたのはなぜですか?
どちらも同じ設計と、文書に記載されたアフィニティ設定を使用しました。違いはサーバーが報告した読み取り数にあります。8kはウィンドウ1と2でヒットし、32kは3つすべてでヒットしました。
R 100は何を対象にしていますか?
専用のリクエスト300件すべてが初回で有効な応答を返し、95%信頼区間の下限は98.78%でした。QとPの失敗はRには計上していません。
続けて読む:DeepSeek V4.1 Flashシリーズ
- Fireworksと同様に、ByteDanceでは思考を無効にした後も思考トークンが報告されました:ByteDanceのDeepSeek V4.1 Flash:ツール呼び出しは一致、計測値は不一致
- BaiduではQ 38.00、P 37.77を記録しました:BaiduのDeepSeek V4.1 Flash:利用可能なチャネルでQもPも達成できず
- Alibaba Cloudでは初回トークンが1.34 s、キャッシュが99.37でした:Alibaba CloudのDeepSeek V4.1 Flash:初回トークン1.34s、キャッシュ99.37
- 公式チャネルはQのベースラインで、F 94.00を記録しました:公式チャネルのDeepSeek V4.1 Flash:F 94.00、無効なプローブ15件


