

2026-11-03/04、APB FullスイートをAIHubMix経由で5つのプロバイダーに対して実行し、DeepSeek V4.1 Flash 1017をテストしました。すべてのプロバイダーで同じモデル、質問、パラメーター、リクエストスクリプトを使用しました。モデルはAIHubMixのモデルページに掲載されており、5つのプロバイダーのエントリーはモデルページで確認できます。このAPB ProfileではAlibaba Cloudのみを取り上げ、各セクションで測定した内容と得られた結果を紹介します。
この記事ではスコアを報告しますが、プロバイダーの順位付けや推奨は行いません。まずQ、F、P、K、Rの順に示します。KはPのサブスコアです。総合スコアは要約指標であり、認証ではなく、信頼区間もありません。採点ルールはAIHubMix Provider Benchmark Standard v2.0で定義されています。
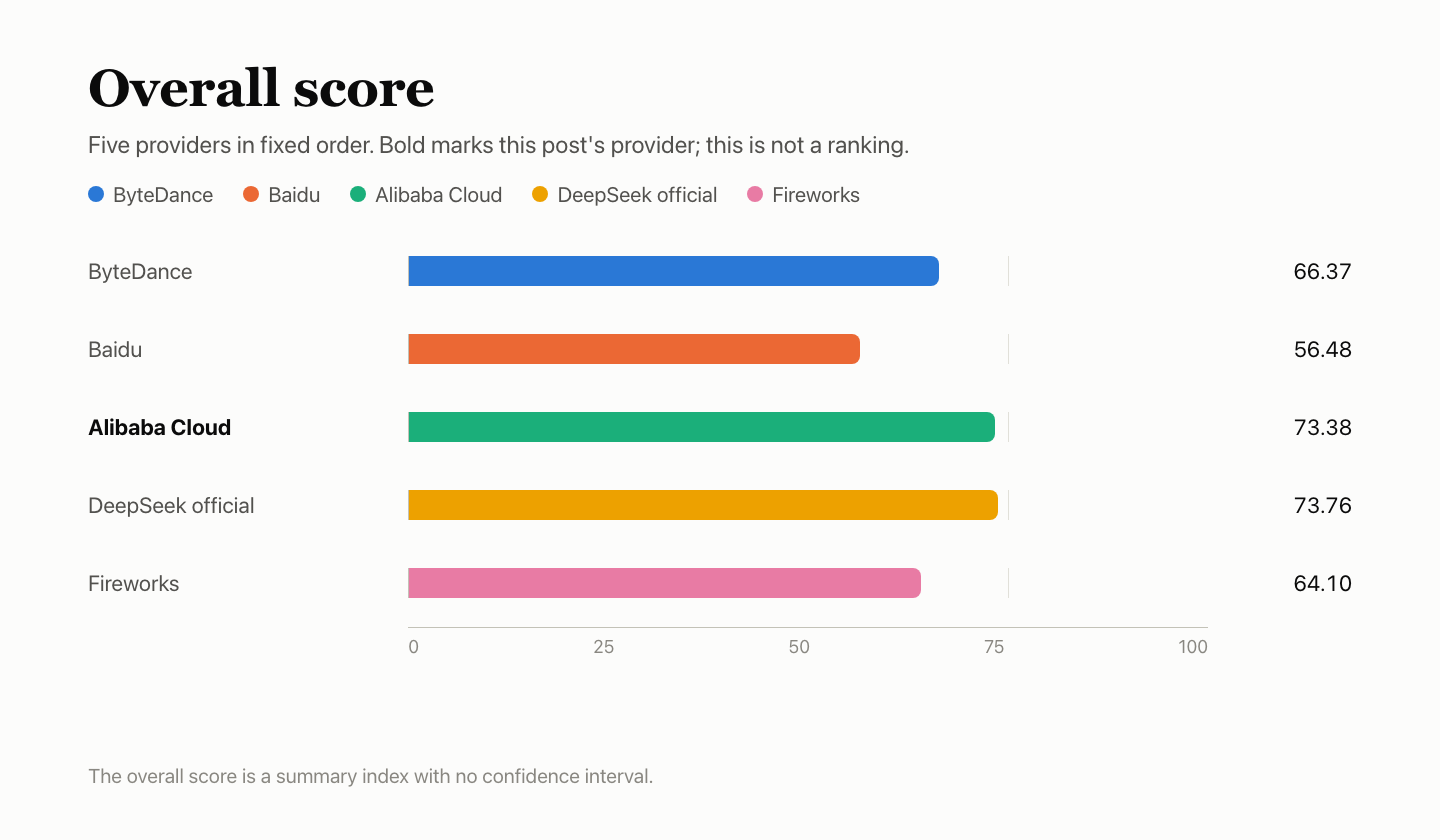
5つのプロバイダーのスコア
太字はこの記事で取り上げるプロバイダーを示します。プロバイダーは固定順で掲載しており、順位ではありません。KはPの20%を占めるサブスコアで、参考として別途表示しています。総合スコアは信頼区間のない要約指標です。DeepSeek公式チャネルとAlibaba Cloudの総合スコアの差は0.37で、両者を区別できる差ではありません。
概要
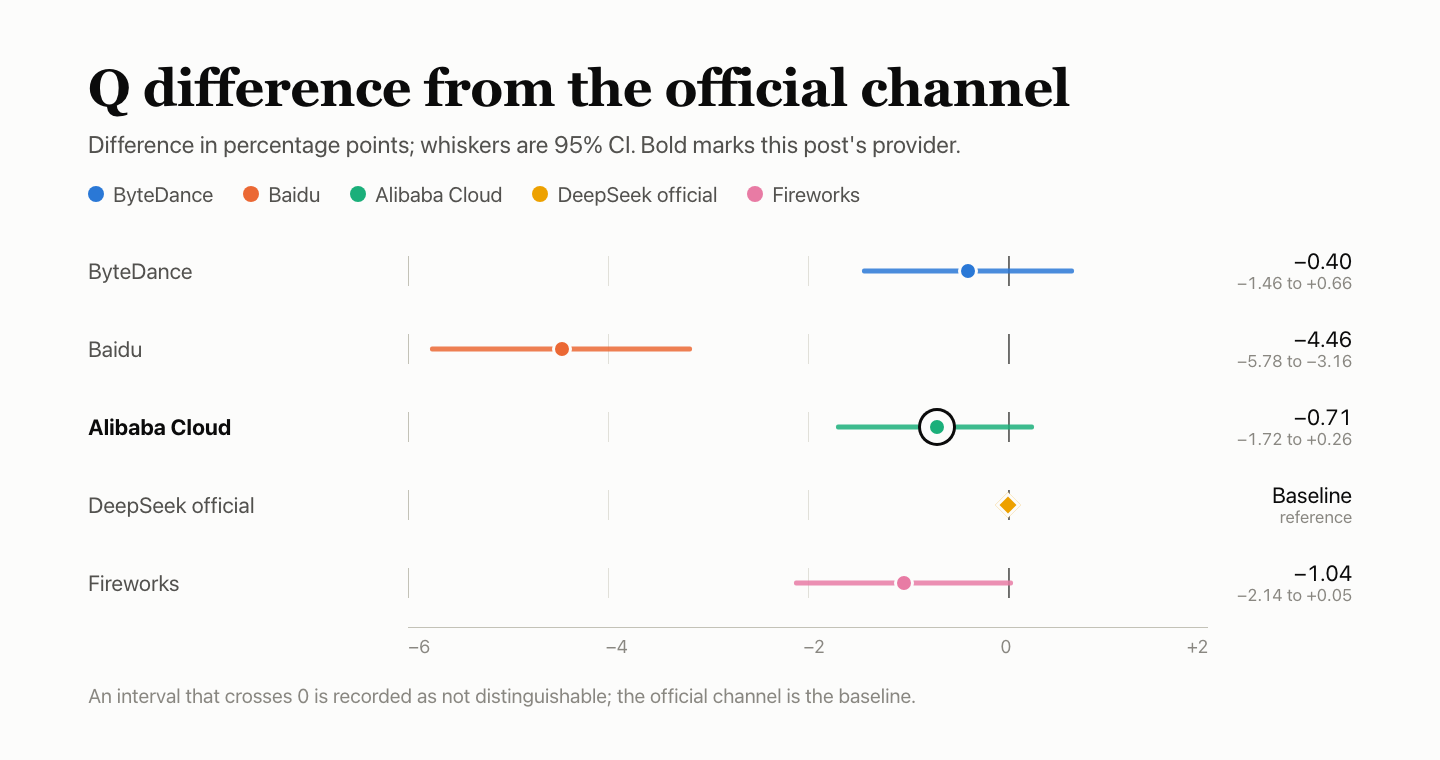
- 回答品質:Q 41.75。 BFCL 87.00%、HLE 13.29%、AA-LCR 53.60%。公式チャネルとの差は−0.71パーセントポイントで、95%信頼区間は−1.72~+0.26です。このため、両者を区別できる差はありません。
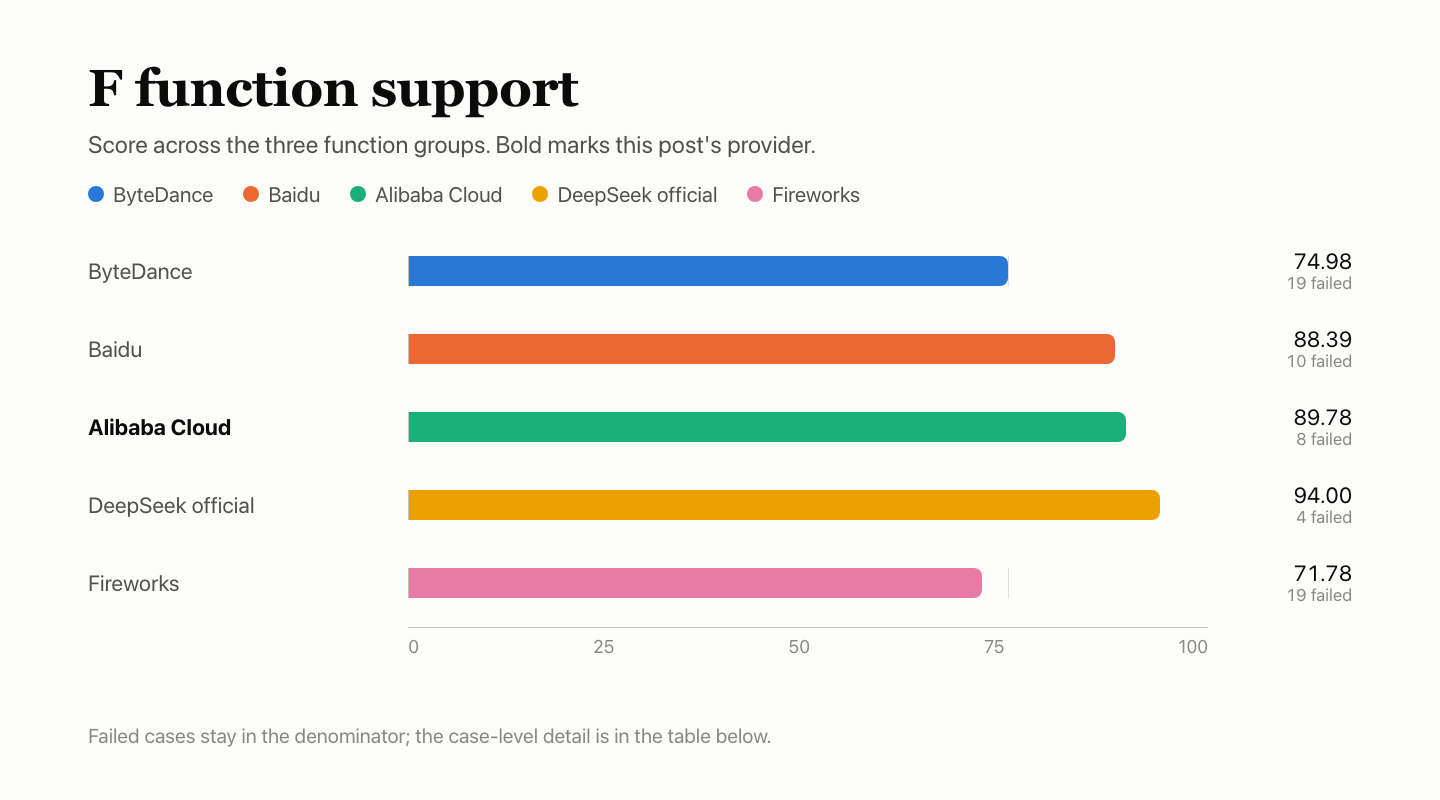
- 関数サポート:F 89.78。 分母に含まれる177件のチェックのうち、155件に合格しました。無効なツールスキーマに対してパラメーターエラーではなく503が返され、コンテキスト超過ではドキュメントに記載されたエラータイプが返されず、単独のツール結果には200が返されました。
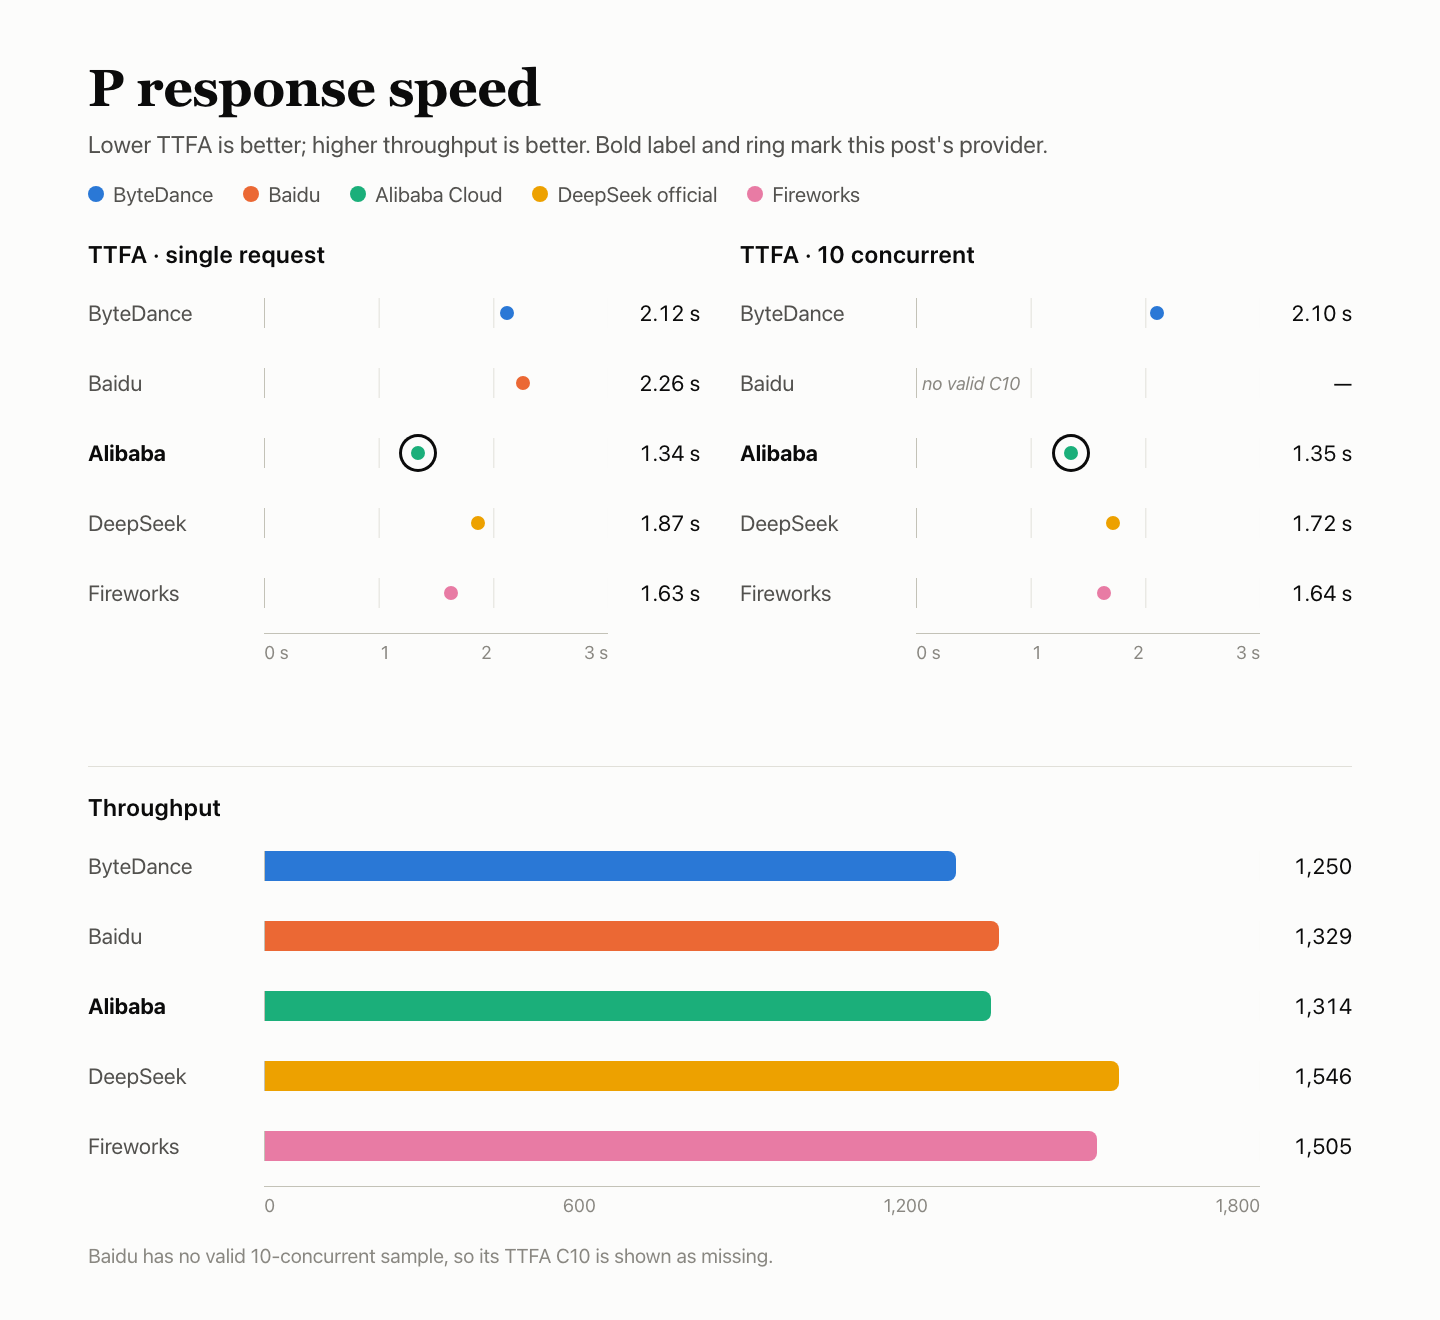
- 応答速度:P 88.58。 初回コンテンツトークンの中央値は、同時実行数1で1.34秒、同時実行数10で1.35秒でした。TPOTは4.69 msで、速度テストの180件すべてが有効でした。
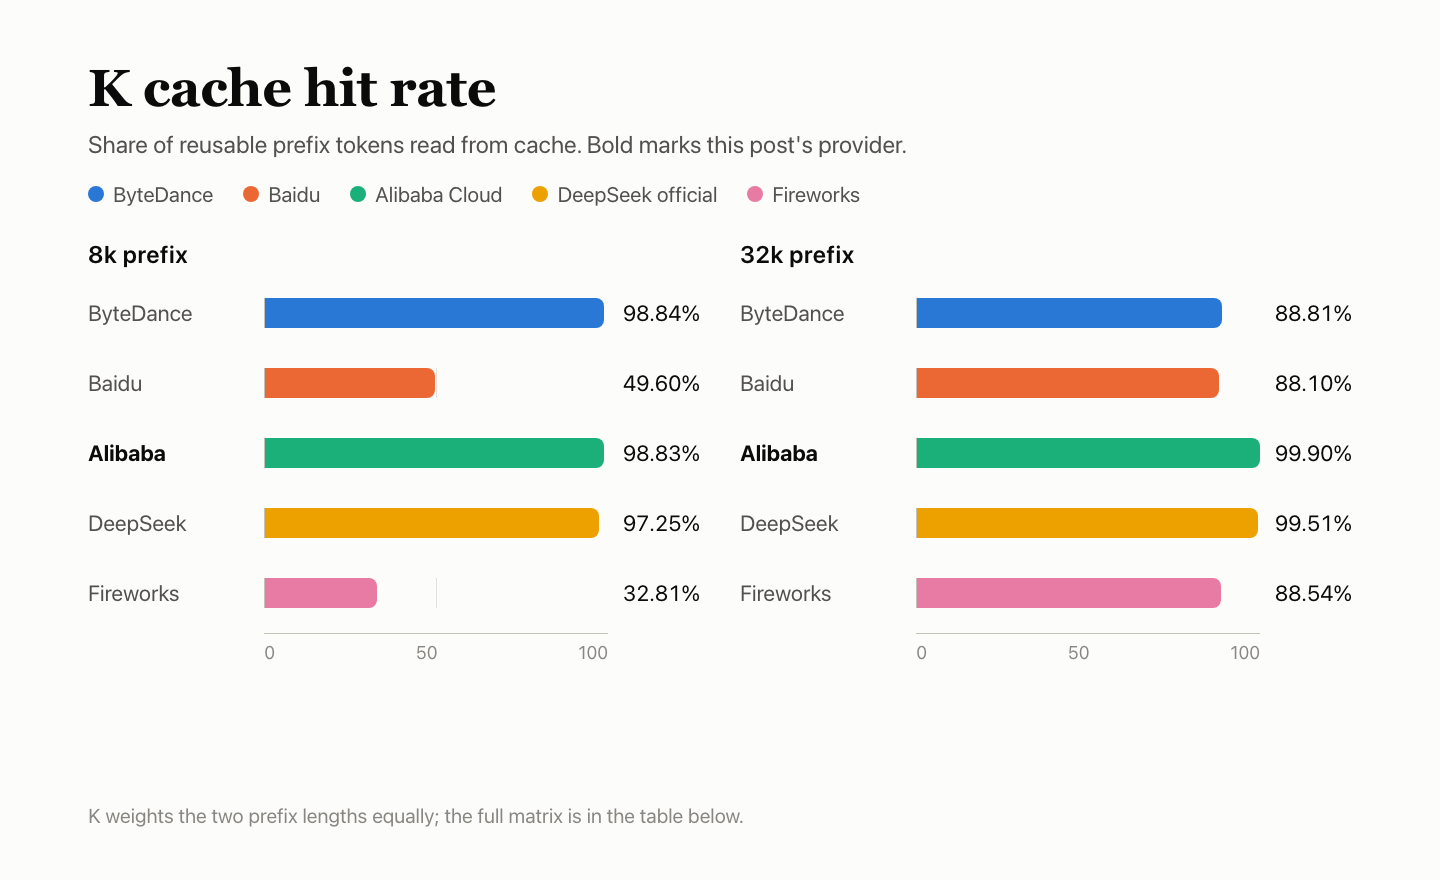
- キャッシュ:K 99.37。 8kおよび32kのプレフィックスを使ったホットリクエスト18件すべてがキャッシュヒットし、コールド対照リクエストではキャッシュの読み取りはありませんでした。
- サービス安定性:R 100。 専用リクエスト300件すべてが初回で成功しました。
テスト設定
プロバイダーのモデル IDを選択し、AIHubMix経由で実行しました。ルートについてはクイックスタートで説明しています。DeepSeekの料金ページには、モデルの公開料金が掲載されています。
| 項目 | 詳細 |
|---|---|
| モデル | DeepSeek V4.1 Flash 1017 |
| リクエストしたモデル ID | alicloud-deepseek-v4.1-flash-1017 |
| 返されたモデル名 | deepseek-v4.1-flash-1017 |
| アクセス経路 | プロバイダー自身のアカウントに接続するのではなく、プロバイダーのモデル IDを選択してAIHubMix経由でアクセス |
| パラメーター | 非思考モード、temperature 1.0、max_tokens 16,384、タイムアウト300 s、自動リトライなし |
| 思考モードはオフ | すべてのリクエストでreasoning_effort=noneを使用 |
| 実施時間 | 2026-11-03 18:07 – 11-04 16:33 UTC+8。5つのプロバイダーは、1台のMac mini、同じネットワーク、同じアカウントを共有しました。 |
| サンプル数 | 回答品質:質問実行4,250件(BFCL 500 × 3ラウンド、HLE 250 × 10、AA-LCR 25 × 10);関数ケース:60 × 3ウィンドウ;速度:同時実行数1で90件、同時実行数10で90件;安定性:300件;キャッシュ:30件(8kおよび32kのプレフィックス、各3グループ) |
Q — 回答品質:41.75
回答品質は3つの質問セットで測定しました。BFCLは500問を各3ラウンド、HLEは250問を各10ラウンド、AA-LCRは25問を各10ラウンド実施しました。BFCLは自動ルールで採点し、HLEとAA-LCRは判定モデルdeepseek-flashで評価しました。5つのプロバイダーすべてに同じ質問を提示し、3つのセットをまとめて正答率を算出しました。採点できない質問が10件あったため、その回答を除外し、採点対象は質問実行4,240件となりました。
| タスク | 質問数 | 正解数 | 正答率 | 失敗数 |
|---|---|---|---|---|
| BFCLツール呼び出し | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| HLE難問QA | 250 × 10 | 331/2,490 | 13.29% | 8 |
| AA-LCR長文書推論 | 25 × 10 | 134/250 | 53.60% | 0 |
| 合計 · 95%信頼区間39.56%~43.85% | — | 1,770/4,240 | 41.75% | 8 |
サービス障害(リクエスト失敗または出力の途中切れ)は分母に含め、不正解として数えます。除外はしません。Alibaba Cloudでは、HLEの出力がmax_tokensの上限に達して途中で切れたケースが8件ありました。
BFCLでは各質問に3ラウンドで回答します。表は3ラウンドを合算した結果です。
| BFCLカテゴリ | 合格数 | 合格率 |
|---|---|---|
| simple_python:1つの関数を、正しい呼び出しと引数で実行 | 332/360 | 92.22% |
| multiple:複数の関数から正しいものを選択 | 270/300 | 90.00% |
| parallel:同じ関数を複数回並列呼び出し | 273/300 | 91.00% |
| parallel_multiple:複数の異なる関数を並列呼び出し | 212/240 | 88.33% |
| irrelevance:該当する関数がなく、呼び出しを行わない | 113/150 | 75.33% |
| ahm_multi_turn:3段階のツールチェーン | 105/150 | 70.00% |
他の4つとの比較
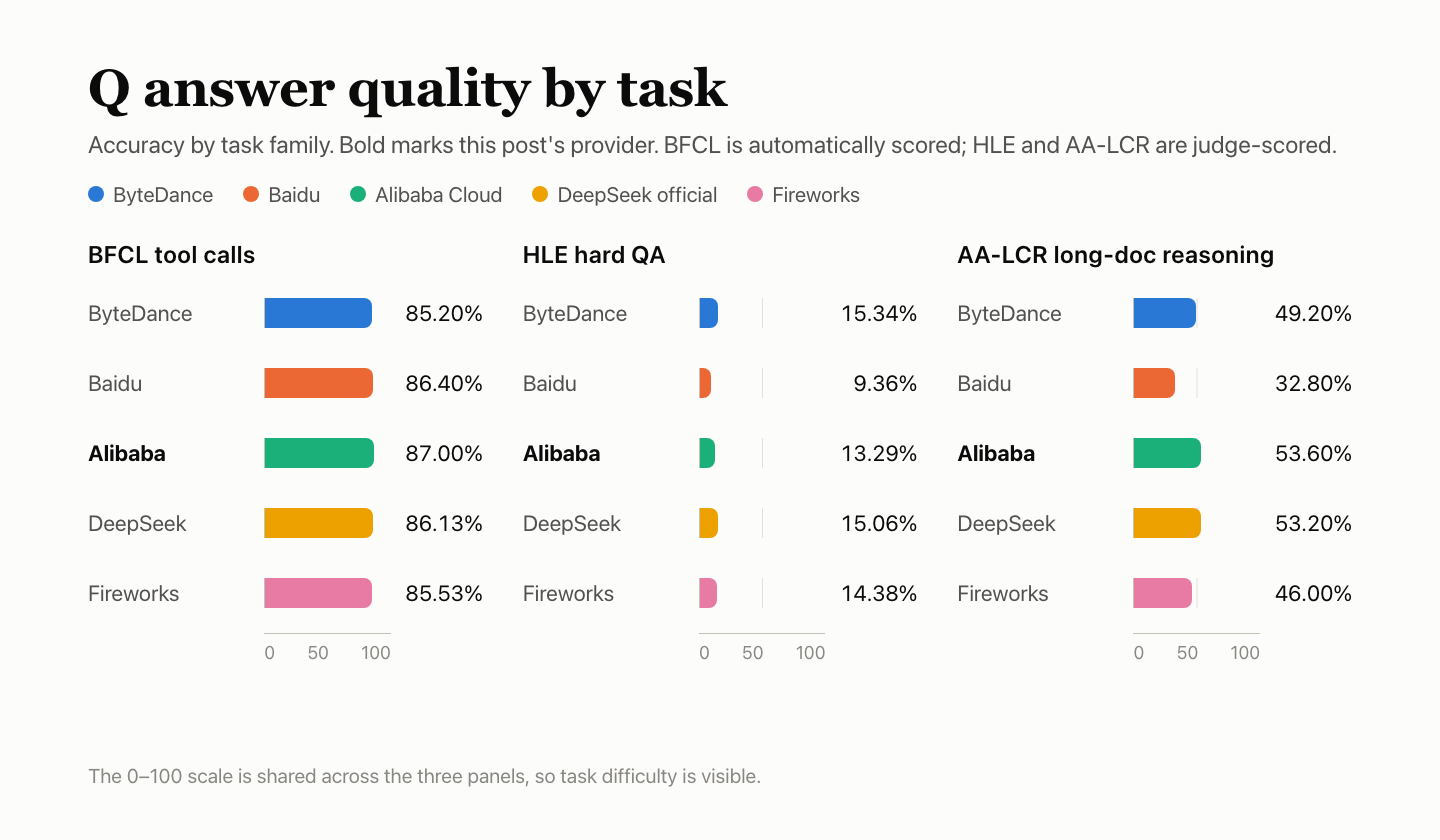
公式チャネルとの差をパーセントポイントで示し、95%信頼区間をエラーバーで表示しています。信頼区間が0をまたぐ場合、差はないものとみなします。HLEとAA-LCRの判定に使ったdeepseek-flashは、テスト対象モデルと同じDeepSeekファミリーに属し、調整も行われていないため、採点が甘くなる可能性があります。
F — 関数サポート:89.78
関数ケースでは、モデルの回答品質ではなく、インターフェースの動作がプロトコルに従っているかを確認します。60件のケースは6グループに分かれ、各3ウィンドウで実行するため、チェック数は180件です。各プロバイダーがドキュメントで説明している形式に照らして評価しました。該当しない、無効、または観測できなかったチェックは分母から除外しています。Alibaba Cloudは分母に含まれる177件のチェックのうち155件に合格し、グループごとの重み付けスコアは89.78でした。
加重スコアはグループごとの重みに基づいて計算され、177件中の単純な合格数ではありません。
| グループ | 重み | 合格数 | 除外数 | グループスコア |
|---|---|---|---|---|
| ストリーミングとメッセージプロトコル | 20% | 30/30 | — | 100.00 |
| ツールインターフェース | 20% | 30/30 | — | 100.00 |
| 出力制約とパラメーター | 20% | 30/30 | — | 100.00 |
| コンテキストと状態 | 15% | 26/30 | — | 86.67 |
| エラーと復旧 | 15% | 18/30 | — | 60.00 |
| 課金計測とキャッシュプロトコル | 10% | 21/27 | 3 | 77.78 |
| 合計 · 加重スコア | — | 155/177 | 3 | 89.78 |
ウィンドウ数が3/3の場合、そのケースは3つすべてのウィンドウで失敗しています。
| 失敗したケース | 失敗したウィンドウ数 | 理由 |
|---|---|---|
| コンテキスト超過(コンテキストと状態) | 3/3 | エラーは返されたものの、ドキュメントに記載されたコンテキスト長エラーではなかった |
| messages形式エラー(エラーと復旧) | 3/3 | 400が返されたが、レスポンスボディは空で、構造化されたエラー説明がなかった |
| ツールスキーマが無効(エラーと復旧) | 3/3 | パラメーターエラーが返されるべきところ、503が返された |
| 単独のツール結果(エラーと復旧) | 3/3 | パラメーターエラーが返されるべきところ、200が返された |
| stream_options形式エラー(エラーと復旧) | 3/3 | 400が返されたが、レスポンスボディは空で、構造化されたエラー説明がなかった |
| reasoningトークンの計測(課金計測とキャッシュプロトコル) | 3/3 | reasoningトークン数が返されなかった |
| ツール定義を入力として計上(課金計測とキャッシュプロトコル) | 3/3 | ツール定義を含めても、報告された入力トークン数が、含めない場合より多くならなかった |
| リクエストの分離(コンテキストと状態) | 1/3 | 最初のステップで、要件どおりSTOREDのみが返されなかったため、分離チェックを続行できなかった |
これらのチェックは分母から除外され、合格にも不合格にも数えられません。
| ステータス | ケース | 件数 | 理由 |
|---|---|---|---|
| 該当なし | 明示的なcache_control | 3 | このインターフェースでは未対応として事前に登録済み |
messages形式エラーとstream_options形式エラーのケースは、5つすべてのプロバイダーで失敗しました。いずれも400と空のボディを返し、クライアントは構造化されたエラー説明を受け取れませんでした。5つすべてで同じ動作が見られるため、AIHubMixのゲートウェイ層に起因する可能性が高く、別途調査が必要です。reasoningトークンの計測も5つすべてで失敗しましたが、理由は異なります。ByteDanceとFireworksは思考モードがオフでもreasoningトークンを報告した一方、残りの3つはreasoningトークン数を返しませんでした。
他の4つとの比較
P — 応答速度:88.58
各リクエストには約10,000入力トークンを含め、約1,100トークンの出力を要求しました。3つのウィンドウで、同時実行数1のリクエストを30件、同時実行数10のリクエストを30件ずつ送信し、合計180件を実行しました。初回コンテンツトークンまでの待ち時間(TTFA)は有効なリクエストごとに測定し、表には中央値を示しています。TPOTはストリーミングチャンクのタイミングから推定した値であり、ハードウェアレベルのトークンごとの時間ではありません。スループットは、同時実行数10での有効出力トークン数をバッチ全体の経過時間で割って算出しています。
| 指標 | 結果 |
|---|---|
| 初回コンテンツトークン TTFA | 同時実行数1の中央値1.34 s、同時実行数10の中央値1.35 s |
| 生成速度 TPOT | 同時実行数1で4.63 ms/トークン、同時実行数10で4.69 ms/トークン |
| 実効スループット(goodput) | 同時実行数10で1,313.6 token/s |
| 有効なリクエスト | 同時実行数1:90/90、同時実行数10:90/90 |
| 構成スコア | TTFA 59.65、TPOT 100.00、スループット100.00。TTFAとTPOTは2つの同時実行数のうち低い方を採用し、重みは35% / 35% / 30%。応答スコアは85.88 |
| Pスコア | 応答スコア85.88を80%、キャッシュK 99.37を20%として、合計88.58 |
他の4つとの比較
5つすべてのプロバイダーが同じマシン、ネットワーク、アカウントを共有しました。3つのウィンドウはプロバイダーごとに順番に実施したため、データ収集期間は完全には重なっていません。わずかな差を過度に解釈しないでください。
K — キャッシュ:99.37
各グループは5件のリクエストで構成されます。最初のリクエストには約8kまたは32kトークンの固定プレフィックスを含め、キャッシュに登録します。リクエスト2~4ではプレフィックスを維持し、末尾の質問だけを変更して、5、30、120秒後に送信します。5件目は新しいプレフィックスを使うコールド対照です。3つのウィンドウ × 2種類の長さで、合計30件です。Kは、ホットリクエストで読み取られたキャッシュ済みトークン数を、ルール上再利用可能なトークン数で割り、各長さを同じ重みで計算した値です。KはPの20%を占めます。表はサーバーが報告したキャッシュトークンの読み取り数を示しています。
| プレフィックス | ウィンドウ | シード(リクエスト1) | 5秒後のホット | 30秒後のホット | 120秒後のホット | コールド対照(リクエスト5) |
|---|---|---|---|---|---|---|
| 8k | ウィンドウ1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | ウィンドウ2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | ウィンドウ3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | ウィンドウ1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | ウィンドウ2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | ウィンドウ3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| プレフィックス | ホットヒット数 | 読み取られたトークン数 | 再利用可能なはずの数 | スコア |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K(8kと32k、それぞれ半分の重み) | 99.37 |
8kのホットリクエスト9件すべてがキャッシュヒットし、各リクエストで7,936トークンが読み取られました。32kのホットリクエスト9件すべてもキャッシュヒットし、各リクエストで32,000トークンが読み取られました。シードリクエストとコールド対照ではキャッシュが読み取られず、ホットとコールドのリクエストは明確に分かれています。
他の4つとの比較
R — サービス安定性:100
リクエスト300件では、短文、10kの長文入力、ツール呼び出し、複数ターンの履歴という4種類を、3つのウィンドウで同時実行数1にして送信しました。初回の応答のみを確認し、有効性と完全性を評価しました。回答の正しさは確認せず、リトライも行っていません。回答品質と速度のセクションで発生した失敗は、それぞれQとPに計上しており、Rには重複して計上していません。
| リクエストの種類 | 初回成功率 |
|---|---|
| 短文 | 120/120 |
| 10kの長文入力 | 90/90 |
| ツール呼び出し | 60/60 |
| 複数ターンの履歴 | 30/30 |
| 合計 · 95%信頼区間98.78%~100% | 300/300 |
300件のリクエストすべてが、初回の試行で有効かつ完全な応答を返しました。R 100が対象とするのは、この専用リクエスト300件のみであり、処理チェーン全体で障害がなかったことを意味するものではありません。95%信頼区間の下限は98.78%です。300/300件が成功した場合でも、障害率は1.22%未満である可能性が高いといえます。
ほかの4つと比較
Rが対象とするのは、この専用リクエスト300件のみです。回答品質と速度に関する失敗はQとPに記録され、Rでは重複してカウントされません。
| プロバイダー | 初回試行の成功率 | 95%信頼区間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek公式 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Alibaba Cloudと公式チャネルの全体スコアの差0.37に意味はありますか?
いいえ。今回の実行では、両者を区別できません。Qの差は−0.71パーセントポイントで、95%信頼区間は−1.72~+0.26と0を含んでいます。また、全体スコアは要約指標であり、信頼区間はありません。
Qスコアには何が含まれますか?
3つのテストセットです。BFCLは500問を3ラウンド実施し、自動採点します。HLEは250問×10回、AA-LCRは25問×10回で、judge modelのdeepseek-flashが採点します。採点対象となった4,240回の問題実行における総合正答率は41.75%です。
177件のチェックのうち155件が合格したのに、Fが89.78なのはなぜですか?
スコアは単純な合格率ではなく、グループごとに重み付けされています。エラーと復旧は60.00、従量課金とキャッシュプロトコルは77.78で、残り3つのプロトコルグループは100.00でした。
ほかのセクションでリクエストが失敗しているのに、Rが100なのはなぜですか?
Rが対象とするのは、安定性を確認する専用リクエスト300件のみです。回答品質と速度に関する失敗はQとPに記録され、Rでは重複してカウントされません。
K 99.37はキャッシュヒット率ですか?
ホットリクエストで読み取られたキャッシュ済みトークン数を、再利用可能なトークン数で割った比率です。8kと32kはそれぞれ半分の重みで計算しています。8kプレフィックスは98.83、32kプレフィックスは99.90でした。
初回トークンまで1.34秒というのは、回答全体が1.34秒で届くという意味ですか?
いいえ。最初のコンテンツトークンが届くまでの待ち時間です。各リクエストでは約1,100個の出力トークンを求め、同時実行数10でのTPOTはトークンあたり4.69 msでした。
続きを読む:DeepSeek V4.1 Flashシリーズ
- Alibaba Cloudの総合Qは公式ベースラインとの差が0.71パーセントポイントで、0を含む信頼区間の範囲内です。ByteDanceのプロファイルでは、同じ比較をツール呼び出しの従量課金まで追っています:ByteDanceのDeepSeek V4.1 Flash:ツール呼び出しは一致、従量課金は不一致。
- Alibaba Cloudでは速度テストのリクエスト180件すべてが有効でした。Baiduのプロファイルでは、利用可能なチャネルがQとPに影響しなかった同じテストハーネスを取り上げています:BaiduのDeepSeek V4.1 Flash:利用可能なチャネルがなく、QとPに影響。
- 公式チャネルは、この記事における回答品質比較のベースラインです。公式チャネル自体のプロファイルでは、F 94.00と、同時実行数1で無効だった15件のプローブを取り上げています:公式チャネルのDeepSeek V4.1 Flash:F 94.00、無効なプローブ15件。
- Alibaba Cloudでは、どちらのプレフィックス長でもホットリクエスト9件中9件がヒットしました。Fireworksのプロファイルでは、空のstop応答と、8kでのキャッシュヒット9件中3件を取り上げています:FireworksのDeepSeek V4.1 Flash:空のstop応答、キャッシュヒットは9件中3件。


