

2026-11-03/04のAPB Full実行では、Paretoの4つのスコアはQ 44.58、F 93.42、P 57.69、R 100で、総合スコアは68.72です。8kの高負荷リクエストでは9件中2件、32kでは9件中3件がヒットしました。
2026-11-03/04に、DeepSeek V4.1 Flash 1017をAIHubMix経由で6つのプロバイダーから利用し、各プロバイダーに同じ質問、パラメーター、リクエストスクリプトを使ってAPB Fullスイートでテストしました。このAPB ProfileではParetoのみを取り上げ、各セクションで測定した内容と結果を説明します。
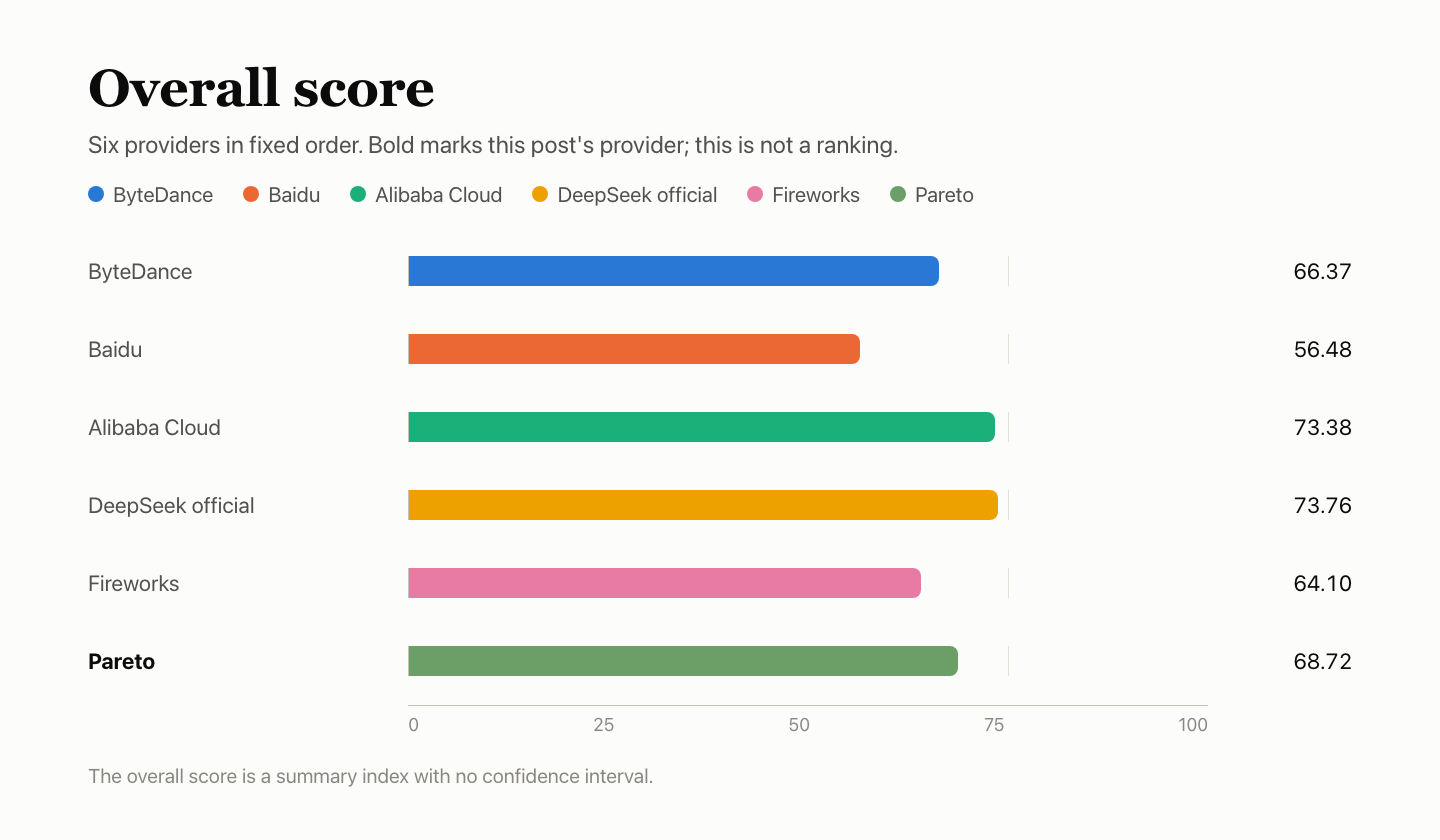
以下の数値はスコアであり、ランキングやプロバイダーの推奨ではありません。まず4つのスコアQ、F、P、Rを示し、総合スコアは要約指標です。認証を示すものではなく、信頼区間もありません。採点ルールはAIHubMix Provider Benchmark Standard v2.0で定義されています。
6つのプロバイダーのスコア
| プロバイダー | Q 品質 | F 機能 | P 速度 | K キャッシュ | R 安定性 | 総合 |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| DeepSeek公式チャネル | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto(本記事) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
プロバイダーは固定順で記載しており、ランキングではありません。KはPのサブスコアで、Pの20%を占め、参考として別途記載しています。総合スコアはAIHubMix Provider Benchmark Standardの構成ルールに基づいて算出され、公式チャネルとの比較とエビデンスの網羅性も考慮されます。表の4つのスコアを直接加重したものではありません。信頼区間のない要約指標です。DeepSeek公式チャネルとAlibaba Cloudの総合スコアの差はわずか0.37で、区別できる差ではありません。
概要
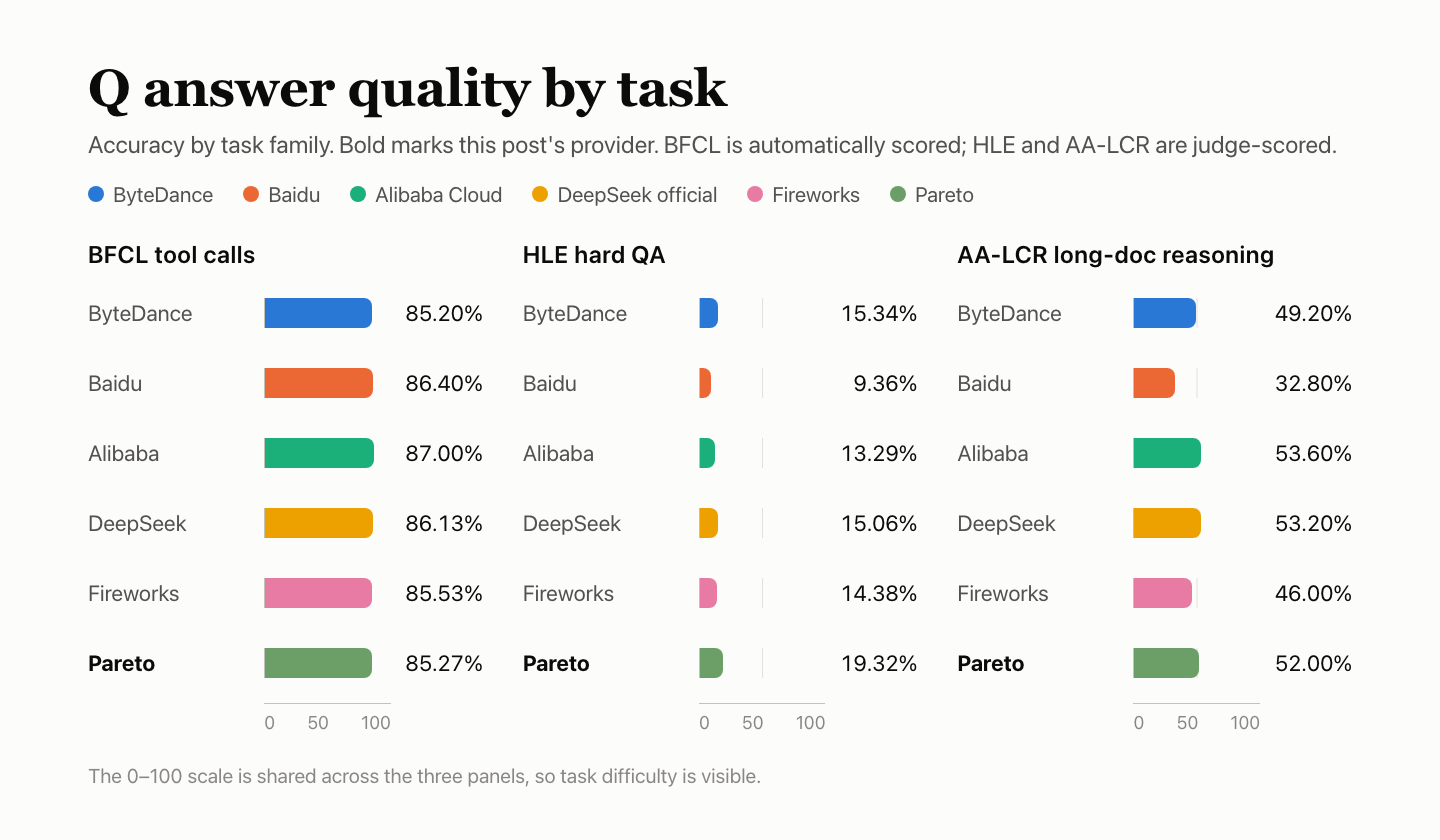
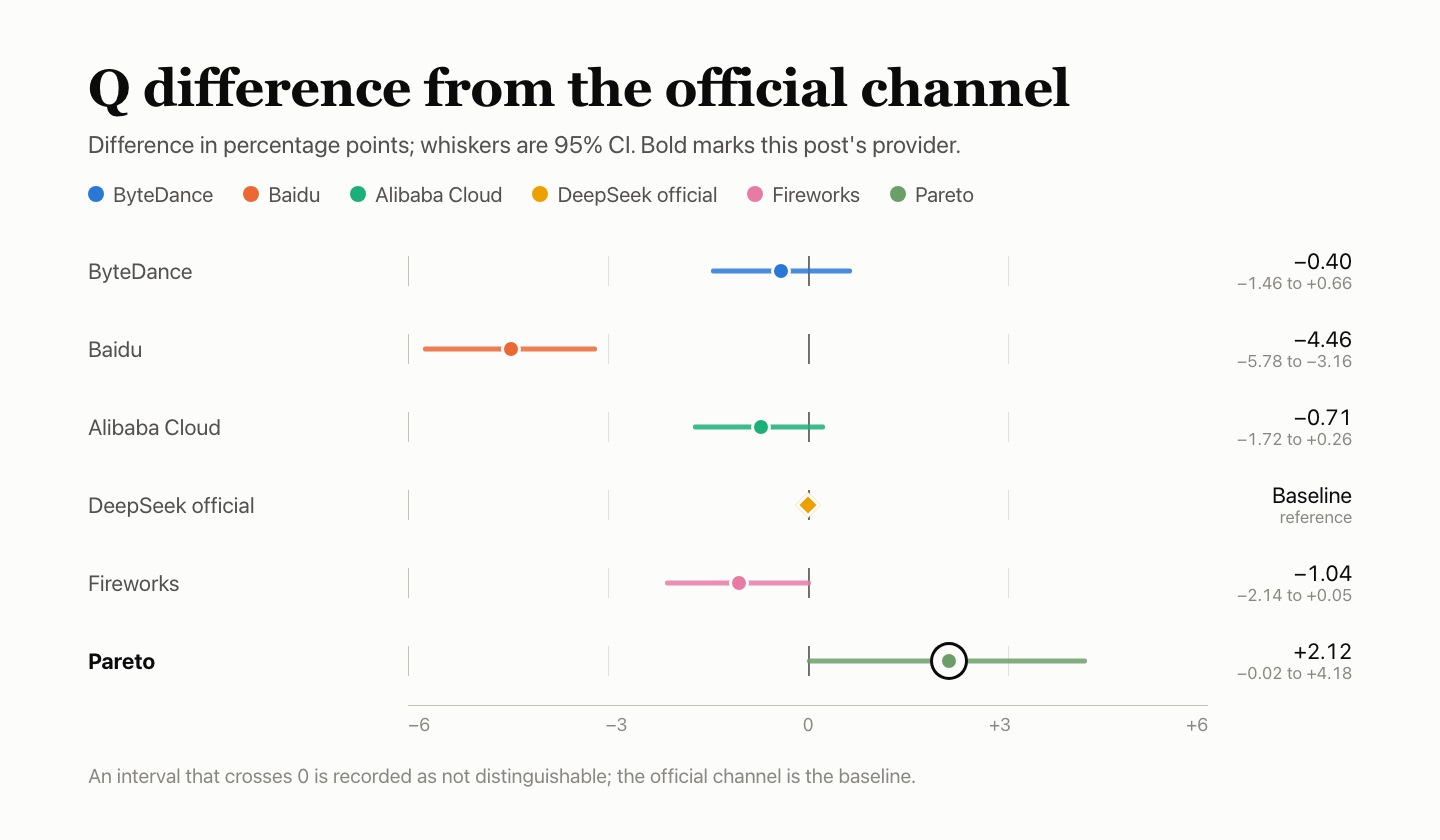
- 回答品質:Q 44.58。BFCLは85.27%、HLEは19.32%、AA-LCRは52.00%です。公式チャネルとの差は+2.12パーセントポイントで、95%区間は−0.02~+4.18。区別できる差ではありません。
- 機能サポート:F 93.42。採点対象となった元のチェック33件中29件に合格しました。ツール呼び出しとツール結果の往復、並列呼び出しと名前付き呼び出し、JSONモード、会話履歴については、ストリーミングでの追加成功記録があります。スコアは元の値を維持しています。
- 応答速度:P 57.69。本文の最初のトークンまでの時間の中央値は、同時実行数1で5.85秒、10並列で6.13秒、TPOTは4.63 msです。速度リクエスト180件中110件が有効でした。
- キャッシュ:K 27.58。8kの高負荷リクエストでは9件中2件、32kでは9件中3件がヒットしました。コールド制御リクエストでキャッシュが読み取られることはありませんでした。
- サービスの安定性:R 100。専用リクエスト300件すべてが初回で成功しました。
テスト設定
| 項目 | 詳細 |
|---|---|
| モデル | DeepSeek V4.1 Flash 1017 |
| リクエストしたモデル ID | deepseek/deepseek-v4.1-flash |
| 返されたモデル名 | deepseek/deepseek-v4.1-flash |
| アクセス経路 | プロバイダー固有のモデル IDを使ってAIHubMix経由で利用。プロバイダーのアカウントへの直接接続ではありません |
| パラメーター | 固定のAPB v2リクエストプロファイル、temperature 1.0、max_tokens 16,384、タイムアウト300 s、自動リトライなし |
| 日時 | 2026-11-03 18:07 – 11-04 16:33。キャッシュリクエストは11-05 19:31 – 11-06 10:35。すべてUTC+8。6つのプロバイダーすべてで、同じMac mini、ネットワーク、アカウントを使用しました。 |
| サンプル数 | Q:質問インスタンス4,250件、F:チェック180件、P:リクエスト180件、R:300件、K:30件 |
リクエストには、プロバイダー固有のモデル IDを使ったAIHubMixのクイックスタート経路を使用しました。他のプロバイダーのIDはモデルページに記載されています。モデル自体のパラメーターについては、DeepSeekのAPIドキュメントで説明されています。
Q — 回答品質:44.58
回答品質は3つのスイートに基づいて評価します。BFCLの質問500件にそれぞれ3回回答し、HLEの質問250件にそれぞれ10回、AA-LCRの質問25件にそれぞれ10回回答しました。BFCLは自動ルールで採点し、HLEとAA-LCRは判定モデルdeepseek-flashが正誤を判定します。6つのプロバイダーにはすべて同じ質問を出し、3つのスイートをまとめて1つの正答率を算出しました。質問を採点できなかったため10件の回答を除外し、採点対象の質問インスタンスは4,240件となりました。
| スイート | 質問数 × 実行回数 | 正解 | 正答率 | サービス障害 |
|---|---|---|---|---|
| BFCLツール呼び出し、自動採点 | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE難問QA、判定モデルによる採点 | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR長文書推論、判定モデルによる採点 | 25 × 10 | 130/250 | 52.00% | 0 |
| 合計 · 95%区間41.57%~47.49% | — | 1,890/4,240 | 44.58% | 0 |
すべての質問インスタンスで完全な回答が得られ、サービス障害はありませんでした。
| BFCLカテゴリ | 合格 | 合格率 |
|---|---|---|
| simple_python:関数1つ、正しい呼び出しと引数 | 333/360 | 92.50% |
| multiple:複数の関数から正しいものを選択 | 269/300 | 89.67% |
| parallel:1つの関数を一度に複数回呼び出す | 265/300 | 88.33% |
| parallel_multiple:複数の関数を一度に呼び出す | 203/240 | 84.58% |
| irrelevance:関連する関数がないため、呼び出しなし | 109/150 | 72.67% |
| ahm_multi_turn:3段階のツールチェーン | 100/150 | 66.67% |
各BFCLの質問には3回回答し、表には3回分の合計を示しています。
他の5つとの比較
| プロバイダー | BFCL | HLE | AA-LCR | 合算 | 公式との差 |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40(−1.46~+0.66)、区別できる差ではない |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46(−5.78~−3.16)、公式を下回る |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71(−1.72~+0.26)、区別できる差ではない |
| DeepSeek公式チャネル | 86.13% | 15.06% | 53.20% | 42.45% | ベースライン |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04(−2.14~+0.05)、区別できる差ではない |
| Pareto(本記事) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12(−0.02~+4.18)、区別できる差ではない |
公式との差:正答率の差をパーセントポイントで示し、括弧内に95%区間を記載しています。区間が0をまたぐ場合は「区別できる差ではない」としています。判定モデルdeepseek-flashは、テスト対象モデルと同じDeepSeekファミリーに属しており、較正もされていないため、判定が甘くなる可能性があります。
F — 機能サポート:93.42
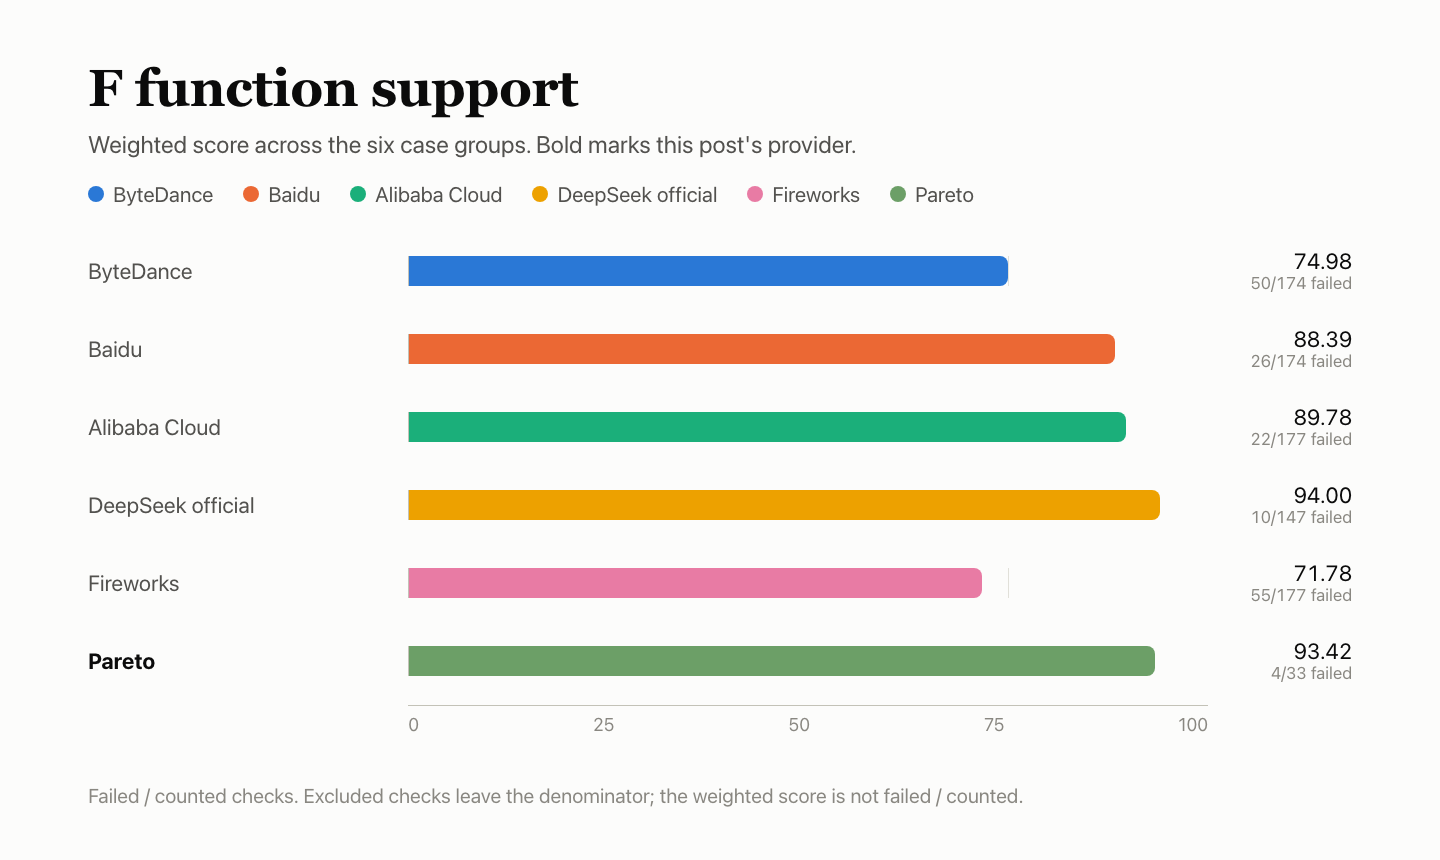
機能ケースでは、インターフェースの挙動がプロトコルに準拠しているかを確認します。F 93.42は、カウント対象のチェック33件(合格29件)から、観測されたグループの重みを再正規化して算出したものです。元のスイートで予定されていた残り147件のチェック枠は、採点対象から除外しました。
| ケースグループ | 重み | 合格数/ストリーミングでの観測 | 除外 | グループスコア |
|---|---|---|---|---|
| ストリーミングとメッセージのプロトコル | 20% | 23/27 | 3 | 85.19 |
| ツールインターフェース ツール呼び出し、ツール結果の往復、並列呼び出しと名前付き呼び出し | 20% | ストリーミングでの合格を確認* | 30 | — |
| 出力制約とパラメーター JSONモードと思考モード無効 | 20% | ストリーミングでの合格を確認* | 30 | — |
| コンテキストと状態 会話履歴とシステム指示 | 15% | ストリーミングでの合格を確認* | 30 | — |
| エラーと復旧 | 15% | 3/3 | 27 | 100.00 |
| 使用量計測とキャッシュのプロトコル | 10% | 3/3 | 27 | 100.00 |
| 合計 · 加重スコア | 29/33 | 147 | 93.42 | |
- 記載した機能にはストリーミングでの成功記録がありますが、グループ全体に満点を与えるものではありません。採点にはチェックを追加していません。F 93.42と総合スコア68.72は元の値を維持しています。
| 失敗したケース | ウィンドウ | 理由 |
|---|---|---|
| ストリーミングの停止シーケンス ストリーミングとメッセージのプロトコル | 3/3 | 停止シーケンスありでは本文が空。停止シーケンスなしの同じ入力では正常に動作 |
| テキストの完全一致出力 ストリーミングとメッセージのプロトコル | 1/3 | 末尾に余分なピリオドがあり、完全一致チェックに失敗 |
「ウィンドウ」は、チェックに失敗した3つのウィンドウの数です。
不正なメッセージと不正なストリームオプションのケースでは、複数のプロバイダーで400が返り、応答本文は空でした。reasoning tokenの使用量計測はプロバイダーごとに挙動が異なりました。
他の5つとの比較
| プロバイダー | 合格 | 失敗 | 除外 | 加重スコア |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| DeepSeek公式チャネル | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto(本記事) | 29 | 4 | 147 | 93.42 |
P — 応答速度:57.69
各リクエストでは約10,000入力トークンを送り、本文テキストを約1,100出力トークン生成するよう指定しました。3つの各ウィンドウで、同時実行数1のリクエストを30件、10並列のリクエストを30件実行し、合計180件を処理しました。
| 項目 | 詳細 |
|---|---|
| 本文の最初のトークン(TTFA) | 中央値は同時実行数1で5.85秒(有効リクエストのみでは3.08秒)、10並列で6.13秒(有効リクエストのみでは4.92秒) |
| 生成速度(TPOT) | 同時実行数1で4.42 ms/token、10並列で4.63 ms/token |
| 実効スループット | 10並列で519.4 token/s |
| 有効なリクエスト | 同時実行数1では53/90(ウィンドウ1~3:15/30、18/30、20/30)、10並列では57/90(23/30、16/30、18/30)。無効:70件はNoneを伴って200を返しました |
| サブスコア | TTFA 24.59、TPOT 100.00、スループット72.05。TTFAとTPOTは低いほうのティアを採用し、重みは35% / 35% / 30%。応答スコアは65.22 |
| Pスコア | 応答スコア65.22 × 80% + キャッシュK 27.58 × 20% = 57.69 |
無効なリクエストは無限大として採点されるため、表の中央値は有効リクエストのみの中央値より高くなる場合があります。TPOTはストリーミングチャンクから推定した値で、ハードウェア上でトークンごとに測定したものではありません。スループットは、10並列での有効な出力トークン数をバッチの経過時間で割った値です。
他の5つとの比較
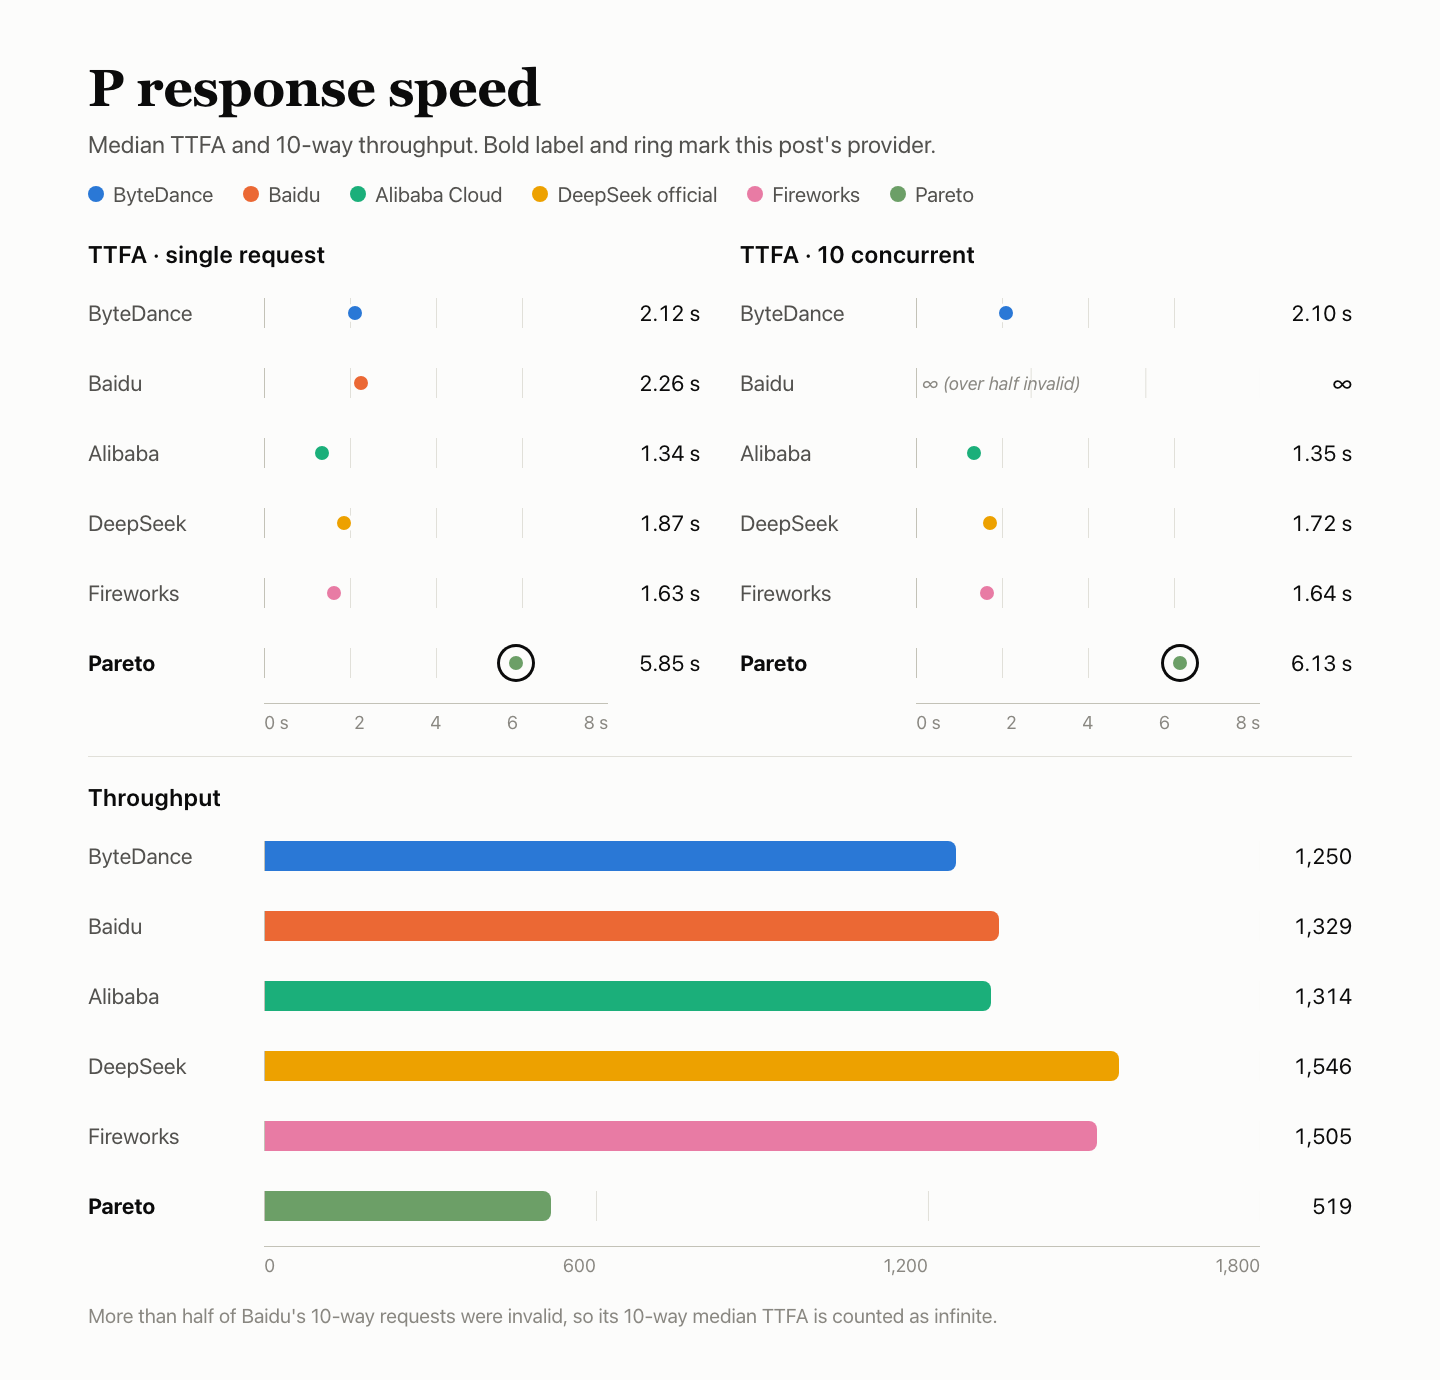
| プロバイダー | 有効なリクエスト | 同時実行数1のTTFA | 10並列のTTFA | TPOT(遅いほう) | スループット tok/s | 応答 |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| DeepSeek公式チャネル | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto(この記事) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
6つのプロバイダーはすべて同じマシン、ネットワーク、アカウントを使用しました。3つの測定時間帯はプロバイダーごとに設定したため、データ収集期間は完全には重なりません。小さな差を過度に解釈すべきではありません。∞はリクエストの半数超が無効だったことを示し、中央値は無限大として扱います。
K — キャッシュ:27.58
各グループで5件のリクエストを送信します。最初のリクエストには約8kまたは32kトークンの固定プレフィックスを含め、キャッシュを作成します。2~4件目はプレフィックスを維持し、最後の質問だけを変更して、5秒、30秒、120秒間隔で送信します。5件目は新しいプレフィックスを使うコールドコントロールです。3つの時間帯と2つの長さを組み合わせ、合計30件のリクエストを実行します。Kは、ホットリクエストで読み取られたキャッシュトークン数を、ルール上再利用可能なトークン数で割った値です。2つの長さは同じ重みで計算し、KはPの20%を占めます。
| 時間帯 | 1 · キャッシュ作成 | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · コールド |
|---|---|---|---|---|---|
| 8kプレフィックス · ホットヒット2/9 · 再利用可能な72,504トークン中15,872を読み取り · 21.89 | — | — | — | — | — |
| 時間帯1 | 0 | 0 | 7,936 | 0 | 0 |
| 時間帯2 | 0 | 0 | 0 | 0 | 0 |
| 時間帯3 | 0 | 0 | 7,936 | 0 | 0 |
| 32kプレフィックス · ホットヒット3/9 · 再利用可能な288,513トークン中96,000を読み取り · 33.27 | — | — | — | — | — |
| 時間帯1 | 0 | 0 | 32,000 | 0 | 0 |
| 時間帯2 | 0 | 0 | 0 | 0 | 0 |
| 時間帯3 | 0 | 0 | 0 | 32,000 | 0 |
| K(8kと32kを同じ重みで計算) | — | — | — | — | 27.58 |
サーバーが報告したキャッシュ読み取りトークン数です。「返却なし」は、レスポンスにこのフィールドがなかったことを意味します。
8kのホットリクエストは9件中2件がヒットし、各ヒットで7,936トークンを読み取りました。32kのホットリクエストは9件中3件がヒットし、各ヒットで32,000トークンを読み取りました。コールドリクエストはキャッシュを読み取らなかったため、ホットとコールドを明確に区別できます。
他の5社との比較
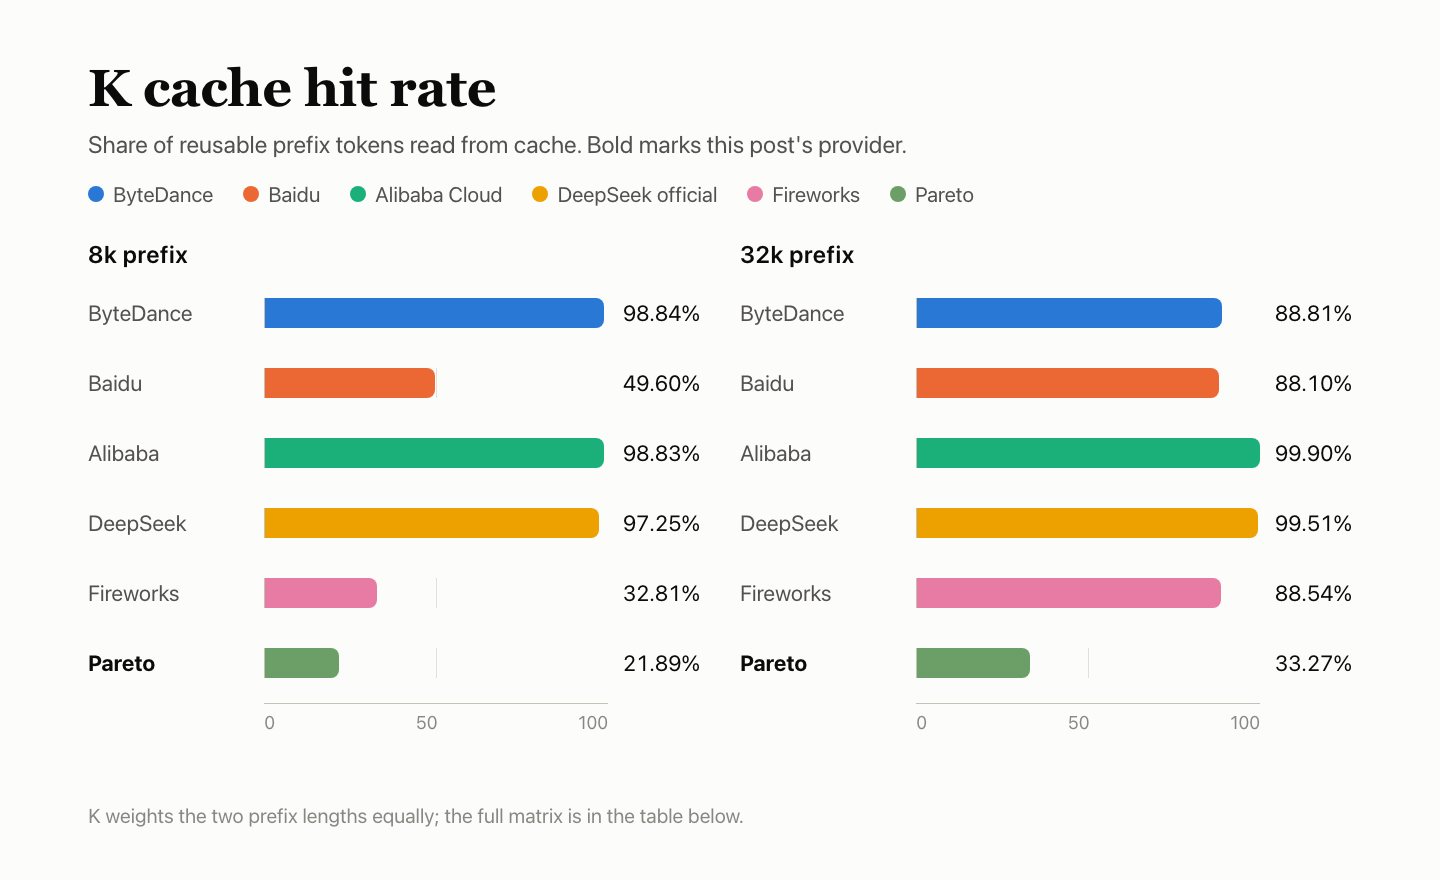
| プロバイダー | 8kのヒット数 | 8k | 32kのヒット数 | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| DeepSeek公式チャネル | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto(この記事) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — サービスの安定性:100
300件のリクエストは、短文、長文入力、ツール呼び出し、複数ターンの履歴の4種類です。3つの時間帯で同時実行数1として実行しました。確認するのは初回で有効かつ完全なレスポンスが返ったかどうかだけで、回答の採点や再試行は行いません。回答品質と速度のセクションでの失敗はQとPに計上され、Rには重複して計上されません。
| リクエストの種類 | 初回成功率 |
|---|---|
| 短文 | 120/120 |
| 10kの長文入力 | 90/90 |
| ツール呼び出し | 60/60 |
| 複数ターンの履歴 | 30/30 |
| 合計 · 95%信頼区間 98.78%~100% | 300/300 |
300件すべてのリクエストで、初回に有効かつ完全なレスポンスが返りました。R = 100は、この300件の専用リクエストだけを対象とした値であり、チェーン全体で失敗がなかったことを意味するわけではありません。95%信頼区間の下限は98.78%です。300件中300件が成功した結果から言えるのは、失敗率が1.22%未満である可能性が高いということだけです。
他の5社との比較
| プロバイダー | 初回成功率 | 95%信頼区間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek公式チャネル | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto(この記事) | 300/300 | 98.78%–100% |
Rの対象はこの300件の専用リクエストのみです。回答品質と速度のセクションでの失敗はQとPに記録され、Rには重複して計上されません。
よくある質問
チェック項目が33件しかないのに、なぜFは93.42なのですか?
元の集計では33件中29件のチェックに合格し、観測されたグループの重みを再正規化した結果、Fは93.42となりました。予定されていた残り147件のチェック項目は採点から除外されました。ストリーミングの記録は、特定の機能が動作したことを示すものであり、採点対象のチェック項目は追加されません。表示されている総合スコアは68.72のままです。
TPOTが100.00なのに、なぜPは57.69なのですか?
速度リクエスト180件のうち、有効だったのは110件だけで、70件は200を返したものの値はNoneでした。無効なリクエストは無限大として扱われるため、最初の本文トークンまでの時間の中央値は、同時実行数1で5.85秒、同時実行数10で6.13秒です(有効なリクエストのみでは、それぞれ3.08秒と4.92秒)。TTFAは24.59、スループットは72.05で、レスポンススコアは65.22でした。キャッシュKの27.58を20%の重みで加えると、Pは57.69になります。
Kが27.58にとどまるのはなぜですか?
ホットリクエストは8kで9件中2件(21.89)、32kで9件中3件(33.27)がヒットし、2つの長さは同じ重みで計算されます。ヒットした場合は7,936または32,000トークンが読み取られ、コールドコントロールではキャッシュが読み取られませんでした。
Paretoの回答品質は公式チャネルより高いのですか?
明確な差はありません。総合正解率は44.58%対42.45%で、差は+2.12ポイントですが、95%信頼区間は−0.02から+4.18までで、0をまたいでいます。HLEとAA-LCRの判定に使われたdeepseek-flashは較正されておらず、判定が甘い可能性があります。
Fで失敗したケースはどれですか?
2つあります。ストリーミングの停止シーケンスでは3つの時間帯すべてで空の本文が返りましたが、停止シーケンスを指定しない同じ入力は正常に動作しました。完全一致が必要なテキスト出力では、3つの時間帯のうち1回、最後に余分なピリオドが付きました。
続けて読む:DeepSeek V4.1 Flashシリーズ
- ParetoのQの差+2.12は公式チャネルとの比較で測定したものです。ベースライン自体の測定結果は、DeepSeek公式チャネル DeepSeek V4.1 Flashレビュー:比較ベースライン、同時実行数1で無効なリクエストが15件をご覧ください。
- Fireworksでも停止リクエストで空の本文が返り、8kでは9件中3件がヒットしました。Fireworks DeepSeek V4.1 Flashレビュー:停止リクエストで空の本文が返る、8kのホットリクエストは9件中3件がヒット
- Alibaba Cloudではホットリクエスト18件中18件がヒットしたのに対し、Paretoでは18件中5件でした。Alibaba Cloud DeepSeek V4.1 Flashレビュー:最初の本文トークンまで1.34秒、ホットリクエスト18件すべてでキャッシュヒット、回答は公式と見分けがつかない
- ByteDanceでは速度リクエストがすべて有効で、最初の本文トークンまで2.12秒でした。ByteDance DeepSeek V4.1 Flashレビュー:回答は公式と見分けがつかない、入力数が一致しない
- Baiduでも速度リクエストの多くがno_available_channelで失敗しました。Baidu DeepSeek V4.1 Flashレビュー:ツール呼び出しは公式と同等、頻発するno-available-channelにより回答品質と速度が低下
出典
- DeepSeek V4.1 Flash 1017モデルページ (AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0 (AIHubMixドキュメント)
- クイックスタート (AIHubMixドキュメント)
- モデル (AIHubMix)
- DeepSeek APIドキュメント (DeepSeek)


