

Gemini 4 Hydrogen costa il doppio per token rispetto alla tariffa promozionale di Gemini 3.8 Flash: 1,50 $ per milione di token in input e 7,50 $ per milione di token in output, contro 0,75 $ e 3,75 $. Nelle misurazioni in tempo reale di Artificial Analysis, Hydrogen completa un’attività di indicizzazione al costo di 1,87 $; Gemini 3.8 Flash costa 7,77 $. Il prezzo per token è raddoppiato, ma il costo per attività completata è sceso di circa tre quarti.
Ecco l’aspetto insolito di questo aggiornamento. Google consiglia Hydrogen come upgrade rispetto a Gemini 3.8 Flash e ai precedenti modelli Gemini 3 e 2.5, ma non si tratta di un aggiornamento di Flash. La scheda del modello afferma chiaramente: «Gemini 4 Hydrogen è stato adattato da Gemini 4 Carbon». Eredita la finestra di contesto di Gemini 4, il percorso di decodifica lunga di Gemini 4 e un nuovo livello di ragionamento, xhigh, mantenendo però una vocazione da Flash: esecuzione rapida e ad alto volume.
Il risultato è un modello più facile da giustificare in base al budget per attività che al costo per token. Di seguito: cosa è cambiato, cosa indicano le misurazioni, quali sono i limiti dell’upgrade e come utilizzarlo tramite AIHubMix.
Che cos’è Hydrogen
Hydrogen è disponibile al pubblico dal 2026-11-12, secondo il changelog dell’API Gemini; la scheda del modello riporta la stessa data. Nel post di lancio, Google lo definisce «il nostro modello di riferimento quotidiano per i flussi di lavoro agentici» e presenta Carbon e Argon come modelli «pensati per il ragionamento profondo e su orizzonti temporali estesi». Hydrogen, secondo la scheda del modello, è invece «pensato per l’esecuzione rapida in diversi flussi di lavoro agentici» e può essere eseguito da solo o come subagente accanto ai modelli frontier.
Per chi usa le API, contano tre fatti relativi al lancio. È l’unico modello Gemini 4 disponibile nel piano gratuito: Google afferma che è disponibile «sia nei piani gratuiti che in quelli a pagamento di Google AI Studio e dell’API Gemini». È anche l’unico modello Gemini 4 con il livello di ragionamento xhigh. Inoltre, secondo il changelog, è il modello predefinito per l’agente Antigravity in Gemini Managed Agents.
È bene tenere presente un’avvertenza fin dall’inizio. La documentazione enterprise di Google definisce Hydrogen «una versione GA generalmente disponibile a breve termine, soggetta a una policy di preavviso minimo di 45 giorni per il ritiro». La pagina delle dismissioni non indica una data di chiusura, ma un team che pianifica una dipendenza di lunga durata dovrebbe considerare questa frase un avvertimento: mantenere configurabile la stringa del modello.
Cosa cambia rispetto a Gemini 3.8 Flash
I due modelli condividono più di quanto suggerisca la loro fascia di prezzo. Sull’API di Google, entrambi accettano una finestra di contesto di 1,048,576 token, input di testo, immagini, audio e video e sono disponibili in un piano gratuito. La pagina del modello di AIHubMix indica per Hydrogen input di testo, immagini, audio, video e PDF, con output di testo; la pagina enterprise di Google elenca anche Office e OpenDocument, non menzionati nella pagina del gateway. Le differenze riguardano la capacità massima di output, i valori predefiniti per il ragionamento e la struttura delle API disponibili.
| Voce | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| Finestra di contesto | 1,048,576 token | 1,048,576 token |
| Output massimo | 1,048,576 token tramite decodifica lunga | 65,536 token |
| Output sincrono | 65,536 token per passaggio, con o senza streaming | 65,536 token |
| Livelli di ragionamento | low, medium, high (predefinito), xhigh | low, medium (predefinito), high |
| Modalità di input | testo, immagini, audio, video, PDF, Office | testo, immagini, audio, video, PDF |
| Piano gratuito | Sì | Sì |
| Caching | solo implicito, minimo di 4,096 token | implicito ed esplicito |
Hydrogen aggiunge un quarto livello, xhigh, e sposta il valore predefinito da medium a high. Consente inoltre un passaggio sincrono da 65,536 token sia in modalità streaming che non-streaming; Carbon e Argon consentono 65,536 token solo in streaming e 32,768 negli altri casi. Per gli output lunghi, Hydrogen usa lo stesso percorso in background o tramite token di continuazione del resto della famiglia Gemini 4 e può arrivare a 1,048,576 token meno quelli dell’input.
Il costo per turno deriva dal valore predefinito. Hydrogen usa più token di ragionamento per turno rispetto a un modello con impostazione predefinita medium, e i token di output includono quelli di ragionamento. Se si esegue una migrazione del carico di lavoro senza impostare un livello, in genere ogni turno costerà più che con 3.8 Flash, anche prima di considerare la differenza di prezzo per token.
L’upgrade misurato: 20 punti in più nell’indice, a un costo inferiore per attività
Artificial Analysis ha assegnato a Hydrogen, con l’impostazione high, un punteggio di 51 nell’Intelligence Index, posizionandolo al posto #21 su 78. Gemini 3.8 Flash, con la stessa impostazione high, ha ottenuto 31 punti, classificandosi al posto #54. Il costo dell’attività è andato nella direzione opposta: 1,87 $ contro 7,77 $.
| Modello / impegno | Posizione AA | Indice AA | $/attività | Min/attività | Primo token di risposta |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
Queste cifre sono misurazioni in tempo reale di Artificial Analysis, consultate il 2026-11-13T02:40Z, basate su Intelligence Index v5.0.1 con 78 modelli in classifica. Usano i prezzi di listino standard e non corrispondono alle fatture di AIHubMix. Entrambe le righe riportano risultati con impegno high, quindi il confronto è a parità di impostazione; va però ricordato che high è il valore predefinito di Hydrogen, ma non di Flash. Con l’impostazione predefinita medium, Flash ottiene 30 punti e costa 6,26 $ per attività: un confronto tra valori predefiniti cambia le cifre, ma non la tendenza.
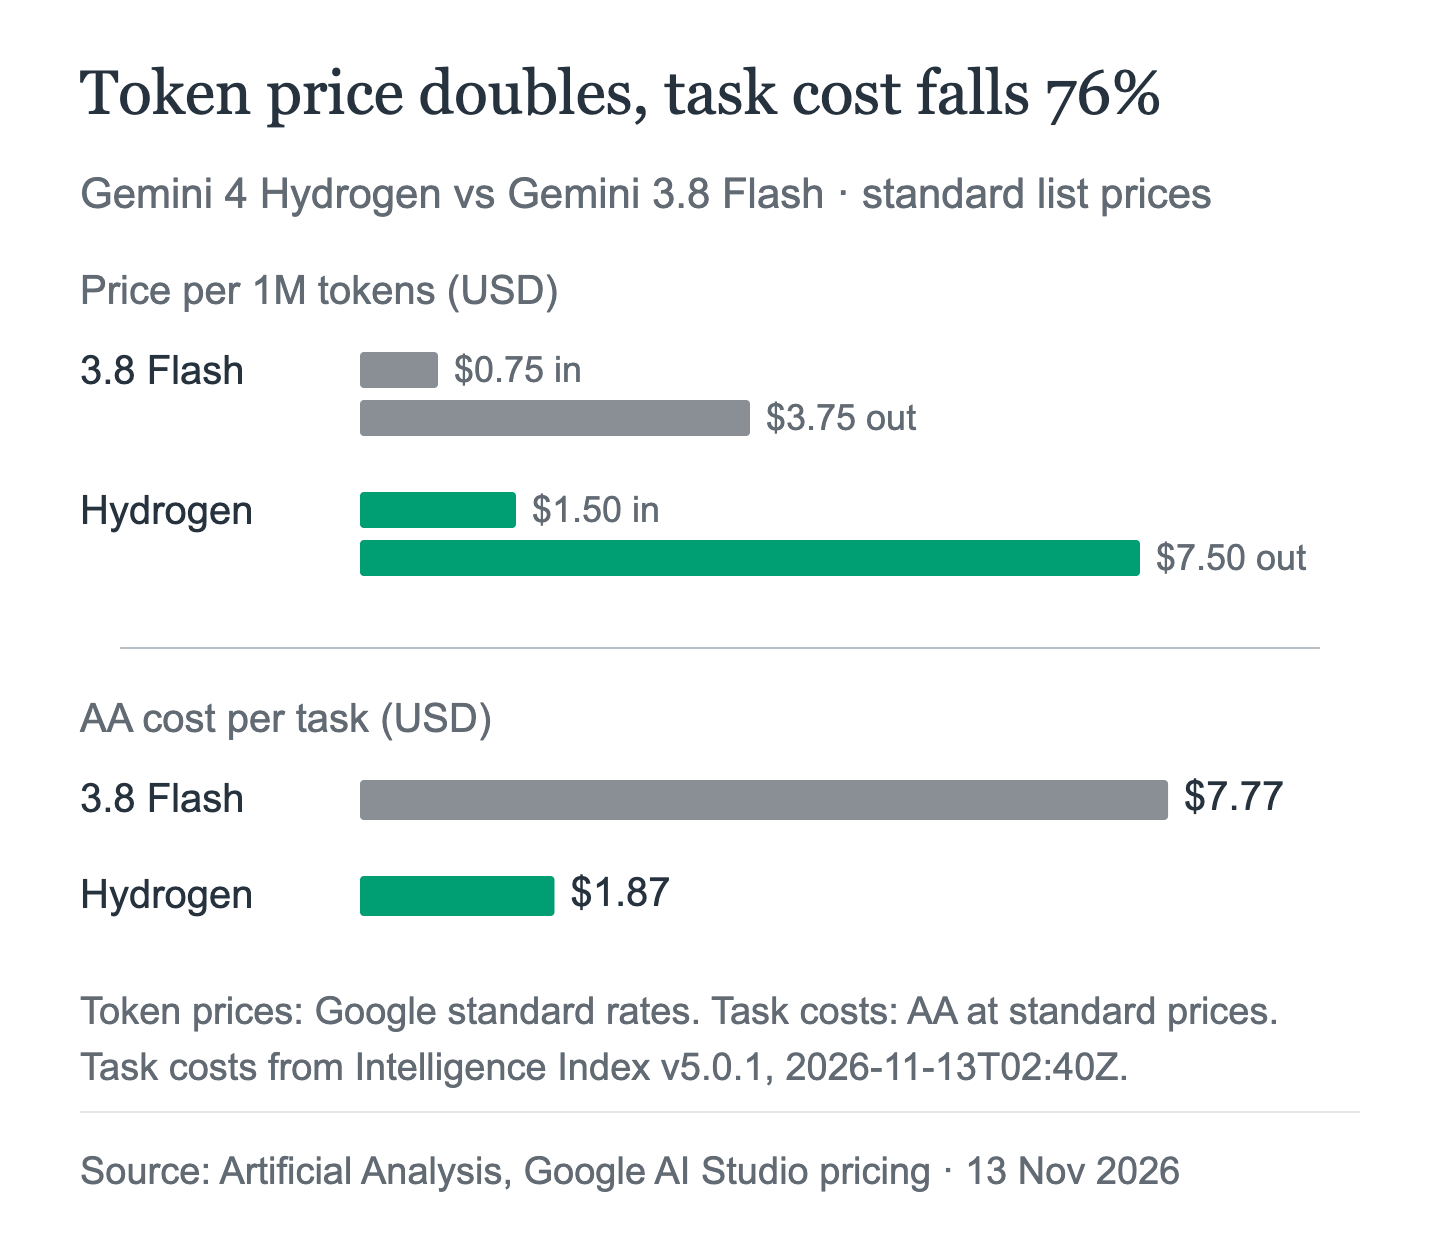
Il dato da considerare è il costo per attività. Il prezzo per token di Hydrogen è il doppio della tariffa promozionale di Flash, ma il suo costo misurato per attività è inferiore del 75.9%. La differenza dipende dal numero di token che ciascun modello usa per completare lo stesso lavoro, un aspetto che il prezzo per token non mostra. Il primo token di risposta di Hydrogen arriva dopo 18.89 secondi, circa 1.4 secondi più tardi rispetto ai 17.53 di Flash, ma completa l’attività in 8.3 minuti contro 14.7.
Con xhigh, Hydrogen ottiene 54 punti, costa 3.16 $ per attività e impiega 13.5 minuti, con il primo token dopo 37.77 secondi. Si tratta di quattro punti in più rispetto a Gemini 4 Argon high (50) e sei in meno rispetto a Carbon high (60) nella stessa rilevazione. In questa serie i quattro livelli sono trattati separatamente; in breve, high è l’impostazione più conveniente e xhigh è adatta alle attività difficili.
La tabella dei benchmark di Google e le tre voci in cui Hydrogen perde
La scheda del modello di Google è un documento del fornitore: dati dichiarati dall’azienda, pubblicati il 2026-11-12 e incentrati su due concorrenti anziché sul precedente modello Gemini. Hydrogen è in testa in 7 dei 10 confronti elencati. Le tre sconfitte sono la parte più interessante.
| Benchmark | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
Nella scheda del modello, Terminal-Bench 4.1 è indicato come «corretto per i casi di cheating». Sonnet 5.5 prevale in Terminal-Bench 4.1 (63.9 contro 57.0), OSWorld-2.1 (83.9 contro 77.6) e Terminal-Bench-Science 0.1 (59.9 contro 51.4). Sono i casi in cui un modello più costoso offre comunque un vantaggio. Nel listino prezzi di Anthropic, Sonnet 5.5 costa 2 $ per l’input e 10 $ per l’output: Hydrogen è quindi più economico del 25% per token e prevale nella maggior parte dei benchmark della scheda, ma perde nei tre più orientati agli agenti o alle discipline scientifiche.
Non affiancare i risultati di Carbon a questa tabella. La scheda di Carbon riporta 65.2 in Terminal-Bench 4.0; quella di Hydrogen riporta 57.0 in Terminal-Bench 4.1. Versioni diverse del benchmark e insiemi di confronto diversi: non sono colonne confrontabili.
Il post di lancio di Google aggiunge affermazioni non riprese nella scheda del modello: secondo l’azienda, con l’impostazione predefinita high Hydrogen completa le attività «2.5 volte più velocemente» di Gemini 3.8 Flash e riduce le affermazioni inventate di «oltre 5 volte». Google dichiara inoltre il posto #5 in Agent Arena, il primo posto nel Vals Tax Agent Bench (52.3%) e un pareggio al primo posto nel Vals Legal Research Bench (55.8%). Si tratta di dati dichiarati dal fornitore, non verificati indipendentemente in questa sede.
Prezzo: tariffa per token raddoppiata, costo per attività inferiore
Il prezzo standard di Hydrogen è di 1.50 $ per l’input, 7.50 $ per l’output e 0.075 $ per l’input memorizzato nella cache. Batch e Flex costano la metà, mentre Priority costa 2.70 $ e 13.50 $. Il prezzo resta invariato per l’intera finestra di contesto.
| Modello / piano | Input | Input memorizzato nella cache | Output | Periodo |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | Attuale |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Attuale |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | Attuale |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | Fino al 2026-12-31 |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | Dal 2027-01-01 |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | Fino al 2026-11-30 |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | Dal 2026-12-01 |
Prezzi ufficiali in USD per milione di token, tratti dalla pagina dei prezzi di Google, consultata il 2026-11-13. Non sono state annunciate variazioni future per Hydrogen.
Dalla tabella emergono due confronti. Le tariffe di Hydrogen per input e output corrispondono esattamente ai prezzi standard di Gemini 3.8 Flash a partire dal 2027-01-01: il divario del «doppio del costo» scompare quindi a Capodanno. Rispetto a Carbon e Argon, fino al 30 novembre Hydrogen costa il 25% in meno per token; dal 1° dicembre, quando i loro prezzi raddoppieranno, costerà il 62.5% in meno.
AIHubMix indica per Hydrogen i prezzi di 1.50 $, 7.50 $ e 0.075 $, in linea con il prezzo standard di Google. Il piano gratuito è offerto da Google, non dal gateway: AIHubMix è un canale a pagamento.
Quando Hydrogen non è l’upgrade giusto
Il supporto ai protocolli è più limitato. Carbon e Argon hanno voci nello schema che elencano Chat Completions, Responses, Anthropic Messages e Gemini nativo. Hydrogen non compare nello snapshot dell’indice dei modelli del 2026-11-11 e l’unico endpoint documentato è POST /v1/chat/completions. Chi usa client Responses in stile Codex o client Anthropic in stile Claude Code non dovrebbe dare per scontato che Hydrogen funzioni senza prima verificarlo.
È una versione GA a breve termine. La policy di preavviso di 45 giorni per il ritiro è un vincolo da considerare nella pianificazione, non un motivo per evitare il modello. È un motivo per mantenere l’ID del modello nella configurazione anziché inserirlo direttamente nel codice.
Mancano alcune funzionalità della piattaforma. Nella pagina enterprise di Google, Gemini Live API, RAG Engine, Tuning e quota fissa sono indicati come non supportati per Hydrogen; l’inferenza Batch è supportata.
Il profilo di sicurezza è contrastante. La scheda del modello riporta risultati migliori rispetto a Gemini 3.8 Flash per la sicurezza del testo (+0.80pp per testo-testo, +1.10pp multilingue), ma 5.57 punti percentuali in più di rifiuti ingiustificati, soprattutto con prompt multimodali, e un punteggio sul tono peggiore di 0.65 punti. Si tratta di valutazioni automatizzate, non di red teaming.
Carbon resta il limite massimo della qualità. Hydrogen high ottiene 51 contro i 60 di Carbon high, e Hydrogen xhigh, con 54, è ancora indietro di sei punti. Per il debugging complesso, l’architettura, il lavoro scientifico e l’analisi della sicurezza, il ragionamento aggiuntivo di Carbon fa la differenza.
I livelli più bassi non mantengono la stessa qualità. Hydrogen medium ottiene 41 e low 27 nell’indice AA. Una migrazione che, di fatto, mantenga la vecchia impostazione predefinita passando a medium perderà molta più qualità di quanto si risparmi sul costo dei token.
Come utilizzarlo tramite AIHubMix
Il percorso documentato è l’endpoint chat completions compatibile con OpenAI. La pagina del modello indica due fornitori, VertexAI e Google AI Studio, con nuovo tentativo automatico.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
L’endpoint è POST /v1/chat/completions. AIHubMix indica che Hydrogen accetta input di testo, immagini, audio, video e PDF e produce testo; non pubblica flag di funzionalità per ragionamento, uso degli strumenti o output strutturato, e la sua guida a Gemini descrive i controlli del ragionamento dell’era Gemini 2.5, non i livelli di Gemini 4. Non dare per scontato che il parametro thinking_level di Google, o il nuovo valore xhigh, venga inoltrato dal gateway. Mantieni max_tokens entro il limite sincrono di 65,536, a meno che il supporto alla generazione prolungata non sia confermato per il tuo percorso. Per questo articolo non è stato eseguito alcun test dal vivo, quindi l’esempio mostra la struttura della richiesta, non una risposta verificata.
Chi dovrebbe passare subito
Passa subito se usi Gemini 3.8 Flash e paghi a token: Artificial Analysis rileva un costo per attività completata inferiore del 76% a fronte di un indice superiore di 20 punti, e il piano gratuito ti consente di verificare la qualità sui tuoi prompt senza costi. Passa se il tuo carico di lavoro è elevato e può essere gestito con Chat Completions e output testuale, oppure se vuoi affiancare a Carbon un modello di esecuzione più economico in un flusso multi-modello.
Attendi se il tuo client dipende dal protocollo Responses o Anthropic Messages; se le tue attività riguardano gli aspetti più complessi di debugging, architettura o sicurezza, dove il limite massimo di Carbon conta ancora; oppure se un preavviso di dismissione di 45 giorni è incompatibile con il tuo ciclo di rilascio.
Fai prima una prova se sei indeciso. Esegui da 20 a 50 richieste reali con Hydrogen high e Gemini 3.8 Flash alle sue impostazioni predefinite, poi confronta il costo per attività completata, non il costo per token. La pagina di confronto di AIHubMix è utile per valutare Carbon.
FAQ
Hydrogen costa meno di Gemini 3.8 Flash?
Per token, no: $1.50/$7.50 contro le tariffe introduttive di $0.75/$3.75. Per attività completata, Artificial Analysis rileva $1.87 contro $7.77, circa il 76% in meno. Il costo per attività dipende dall’uso dei token, non solo dal tariffario.
Hydrogen è Gemini 3.8 Flash con un nuovo nome?
No. La scheda del modello di Google afferma che Hydrogen è una versione adattata di Gemini 4 Carbon e Google lo consiglia come aggiornamento da 3.8 Flash. Ha un diverso percorso di contesto, un quarto livello di ragionamento e un’impostazione predefinita diversa.
Hydrogen accetta immagini?
Sì. La piattaforma di Google accetta testo, immagini, audio, video, PDF e file Office. La pagina del modello di AIHubMix indica input di testo, immagini, audio, video e PDF con output testuale; Office e OpenDocument non sono elencati.
Il piano gratuito è disponibile su AIHubMix?
No. Il piano gratuito è di Google, su AI Studio e Gemini API. AIHubMix è un servizio a pagamento, con tariffe di $1.50/$7.50.
Qual è il livello di ragionamento predefinito?
high. Gemini 3.8 Flash aveva medium come valore predefinito; Hydrogen aggiunge xhigh al di sopra di high.
Hydrogen è migliore di Carbon?
No. Carbon high ottiene 60 nell’indice AA, contro 51 di Hydrogen high e 54 di xhigh, e costa di più per attività. Hydrogen è il modello di esecuzione più economico, non il modello di punta.
Posso impostare il livello di ragionamento tramite AIHubMix?
La documentazione non lo specifica. AIHubMix non pubblica alcun flag di funzionalità di ragionamento per Hydrogen e la sua guida a Gemini non tratta i livelli di Gemini 4. Verifica prima di farci affidamento.
Continua a leggere: la serie Gemini 4 Hydrogen
- Se vuoi sapere quale livello di ragionamento usare, il prossimo articolo misura tutti e quattro i livelli sullo stesso indice e mostra fino a che punto la progressione continua a essere vantaggiosa: Livelli di ragionamento di Gemini 4 Hydrogen: low, medium, high, xhigh.
- Se vuoi sapere se usare Hydrogen accanto a Carbon o Argon, il terzo articolo mette a confronto i tre modelli, includendo prezzi, latenza e una tabella dei carichi di lavoro: Gemini 4 Carbon vs Hydrogen vs Argon: quale modello scegliere per ogni attività?.
Fonti
- Google, Presentazione di Gemini 4 Hydrogen
- Google AI Studio, Gemini 4 Hydrogen: le novità
- Google DeepMind, Scheda del modello Gemini 4 Hydrogen
- AIHubMix, Gemini 4 Hydrogen
- Artificial Analysis, Gemini 4 Hydrogen — istantanea aggiornata al 2026-11-13T02:40Z, Intelligence Index v5.0.1


