Gemini 4 Carbon non è una nuova famiglia di modelli. È Gemini 4 Argon con più ragionamento per turno, venduto allo stesso prezzo per token: $2 per milione di token in input e $10 per milione di token in output con le tariffe introduttive valide fino al 30 novembre 2026, poi $4 e $20 dal 1° dicembre. La domanda non è quale modello costi meno per token. Costano uguale. La domanda è se il ragionamento aggiuntivo consenta di completare ogni attività con un costo sufficientemente inferiore da giustificare una prima risposta più lenta.
I dati in tempo reale di Artificial Analysis danno una risposta chiara per un tipo di attività e un chiaro avvertimento per un altro. Carbon High è al 4° posto su 104 nell'AA Intelligence Index, con 60.03, contro 50.41 di Argon High. Costa $7.76 per attività, contro $9.95, e impiega 25.6 minuti, contro 29.0. Ma il tempo necessario per ricevere il primo token di risposta è di 67.1 secondi, contro 40.1 per Argon. Carbon è il modello migliore per una coda di attività. Argon è il modello migliore per una conversazione.
È tutto qui. Di seguito: cosa è cambiato, cosa dicono le misurazioni, cosa aggiunge la scheda del modello di Google, come cambieranno i prezzi il 1° dicembre e quali carichi di lavoro dovrebbero restare su Argon.
Cosa è cambiato rispetto ad Argon
La scheda del modello di Google chiarisce il rapporto: «Gemini 4 Carbon si basa su Gemini 4 Argon». L'ID del modello è gemini-4-carbon, lo stesso su AIHubMix. Google documenta una finestra di contesto di 1,048,576 token. I livelli di ragionamento sono low, medium e high, con medium come impostazione predefinita. L'output standard è di 65,536 token; il percorso nativo di Google per la generazione lunga può arrivare fino a 1,048,576 token meno l'input, con 131,072 e 262,144 come esempi. Al momento AIHubMix documenta solo Chat Completions, quindi mantieni le richieste al gateway a 65,536 token o meno, finché non viene documentato un percorso più ampio. La data limite delle conoscenze è marzo 2026. Google non offre il modello nel piano gratuito.
Il cambiamento è descritto nelle note di Google AI Studio: «Carbon utilizza più token di ragionamento per turno per esplorare a fondo e verificare il proprio lavoro, aumentando l'uso di token e la latenza per turno rispetto ad Argon». Questa frase spiega quasi tutte le differenze illustrate più avanti. Più ragionamento alza il livello massimo raggiungibile nelle attività complesse, aumenta il costo per turno e allunga l'attesa prima del primo token.
La migrazione è volutamente semplice. «Per passare da Argon non occorre modificare lo schema delle richieste». A livello di API basta cambiare la stringa del modello. Il consiglio operativo di Google è di «mantenere thinking_level su medium (valore predefinito), a meno che un carico di lavoro non richieda high, e assicurarsi che max_output_tokens e i timeout HTTP consentano passaggi di ragionamento più lunghi».
Il compromesso misurato: più ragionamento, meno spesa per attività
Le cifre qui sotto sono misurazioni in tempo reale di Artificial Analysis, rilevate il 2026-11-11T05:23Z (pagine dei modelli ricontrollate alle 06:01Z, senza variazioni), con i prezzi standard di $4 per milione di token in input e $20 per milione di token in output.
Il confronto utile è tra qualità e costo per attività completata: Carbon raggiunge un indice più alto con una spesa inferiore? Il grafico mantiene separate le quattro configurazioni dei modelli.
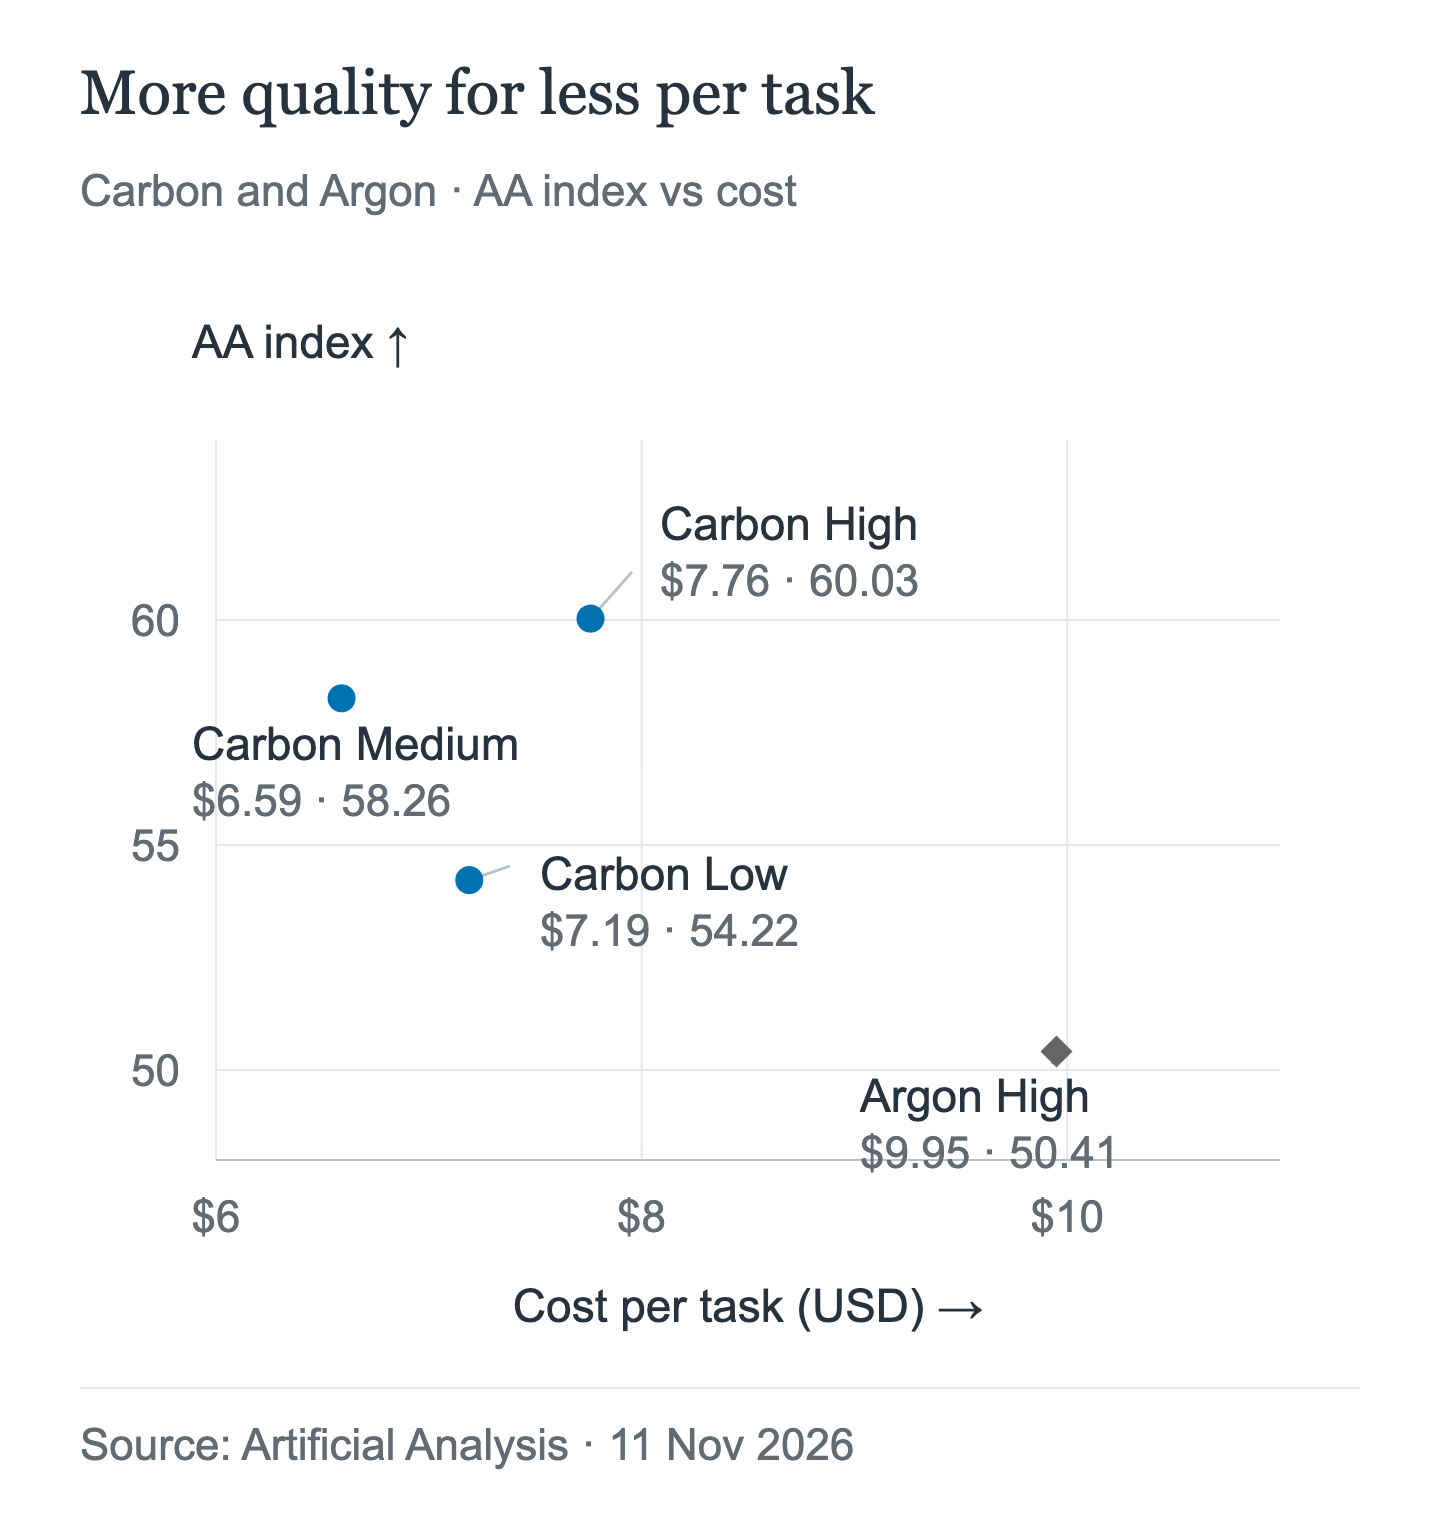
Carbon High si colloca più in alto e più a sinistra rispetto ad Argon High. In questa misurazione, Medium è l'impostazione Carbon meno costosa; Low è un'opzione per ridurre la latenza, non per ridurre al minimo i costi. Sono i costi per attività di AA ai prezzi standard, non gli importi delle richieste su AIHubMix.
| Modello | Indice AA | $/attività | Min/attività | Primo token | Token output/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium e Low occupano rispettivamente il 4°, 6° e 14° posto su 104; Argon High è più in basso. Le tre configurazioni davanti a Carbon High sono tutte varianti di Claude Fable 5.2. «Primo token» indica il tempo necessario per ricevere il primo token di risposta. Carbon High rispetto ad Argon High: +9.62 punti dell'indice, 22.0% in meno per attività, 25.6 contro 29.0 minuti, ma 67.1 contro 40.1 secondi prima del primo token di risposta.
Il divario nell'indice è abbastanza ampio da cambiare posizione in classifica. Quello nella latenza è abbastanza ampio da cambiare il tempo che una persona deve aspettare. Entrambe le affermazioni si basano sulla stessa riga.
Artificial Analysis definisce Carbon «notevolmente lento per attività e molto prolisso» e riporta che per calcolare l'indice ha generato 205 milioni di token, contro i 113 milioni di Argon e una mediana di 72.8 milioni tra i modelli misurati. In questa misurazione di AA, il costo per attività è inferiore nonostante un volume di output molto più alto: stesso prezzo di listino, molti più token e un costo complessivo per attività inferiore.
Un'anomalia merita una menzione a parte. Carbon Low costa $7.19 per attività, più di Medium, che costa $6.59, pur usando meno ragionamento. Qualunque ne sia la causa, Low si comporta come un'impostazione per ridurre la latenza, non come un'opzione scontata: misura il costo per attività prima di instradarvi grandi volumi.
La prospettiva degli agenti di programmazione
L'Intelligence Index calcola la media di molte attività. Il Coding Agent Index v2 è più vicino a ciò che esegue un cliente API: un agente di programmazione dotato di strumenti, misurato da inizio a fine con lo stesso harness. Carbon High è al 4° posto; Argon High all'11°.
| Posizione | Agente + modello | Indice | $/attività | Min/attività | Cache hit |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Stesso agente, stesso harness, modello diverso: il confronto isola il modello, non l'infrastruttura. Carbon costa il 34.0% in meno per attività, guadagna +6.2 punti nell'indice, è più veloce di 4.9 minuti e produce quasi lo stesso output per attività: 109,031 token contro 109,236. Il suo tasso di cache hit è più alto, 0.95 contro 0.87, e usa meno token in input: 12.44 milioni contro 13.76 milioni.
Due avvertenze. Carbon è al 4° posto in questo indice: Claude Code con Opus 5.5 Max è in testa con 61.7, seguito da Devin Fusion CLI e GitHub Copilot Fusion. Inoltre, Fable 5.2 non compare nell'indice, quindi questa tabella non permette di risolvere il confronto tra Carbon e Fable.
Cosa aggiunge la scheda del modello di Google e cosa non dice
La scheda del modello di Google è un documento del fornitore: presenta risultati aggiornati a ottobre 2026, autodichiarati e riferiti a uno snapshot diverso dai dati in tempo reale riportati sopra. Nelle righe qui sotto, il punteggio di Carbon indicato da Google è sempre più alto.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (dati del fornitore) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
La riga dell'AA riporta il 59 arrotondato di Google, non il 60.03 in tempo reale della tabella precedente: i due valori provengono da snapshot diversi e non vanno mescolati. Il confronto esterno nella scheda riguarda Fable 5.1, non Fable 5.2.
L'aspetto utile è la coerenza: il vantaggio non si limita a un solo benchmark. Il limite è altrettanto evidente. Una scheda del fornitore non indica il costo di un'attività, non misura la latenza del primo token e non dice quanti turni richiederà il tuo agente. Avvalora l'affermazione «in media, Carbon è il modello più potente». Non avvalora l'affermazione «Carbon è il modello migliore per il tuo ciclo di lavoro».
Prezzo: stesso tariffario, stessa variazione dal 1° dicembre
Carbon e Argon hanno prezzi identici voce per voce. Entrambi sono disponibili alle tariffe introduttive fino al 30 novembre 2026, che raddoppiano dal 1° dicembre.
| Modello | Input | Output | Lettura dalla cache |
|---|---|---|---|
| Carbon, introduttivo (fino al 30 nov) | $2.00 | $10.00 | $0.10 |
| Carbon, dal 1° dic | $4.00 | $20.00 | $0.20 |
| Argon, introduttivo (fino al 30 nov) | $2.00 | $10.00 | $0.10 |
| Argon, dal 1° dic | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Prezzi ufficiali in USD per milione di token, all'11 novembre 2026. Gemini 3.1 Pro Preview costa $4/$18/$0.40 oltre 200k token di prompt, più $4.50 per milione di token per ora di archiviazione. Le scritture nella cache di Fable 5.2 costano $10 per cinque minuti o $16 per un'ora; il batch ha uno sconto del 50%. Le tariffe introduttive di Carbon e Argon terminano il 30 novembre; tutte le tariffe di Carbon e Argon raddoppiano dal 1° dicembre.
AIHubMix indica Carbon a $2/$10/$0.10, in linea con le tariffe introduttive di Google. Questo articolo non ipotizza quali saranno i prezzi applicati dal gateway dopo il 30 novembre: controlla il prezzo aggiornato nella pagina del modello.
Applicando le tariffe introduttive ai volumi di token misurati da Artificial Analysis si ottengono stime indicative per attività di $3.88 per Carbon High, $3.30 per Medium, $3.60 per Low e $4.98 per Argon High. Si tratta di stime calcolate, non di misurazioni di AA: il calcolo mantiene costante la composizione dei token di ciascuna attività, mentre i tuoi prompt e il tasso di cache hit influiranno sul risultato.
Per token, Fable 5.2 costa il doppio di Carbon alle tariffe standard e il quadruplo alle tariffe introduttive. È una differenza di prezzo, non un giudizio sulla qualità: il terzo articolo della serie approfondisce il confronto.
Quando Carbon non è la scelta migliore
L'argomento contro Carbon non è che sia peggiore. È che ciò che offre, più ragionamento per turno, è proprio ciò che un prodotto interattivo non può permettersi di aspettare.
Il primo token arriva tardi. Carbon High impiega 67.1 secondi prima di restituire il primo token di risposta; Argon High ne impiega 40.1. Medium riduce l'attesa a 23.2 secondi e Low a 12.9, ma entrambi cedono punti nell'indice. Un'interfaccia di chat che si ferma per un minuto ha già perso il turno, qualunque sia la risposta quando arriva.
Google consiglia di mantenere Argon per la velocità. Argon è pensato per «risposte più rapide e un minore consumo di token per turno» nell'ambito di «programmazione interattiva, lavoro quotidiano sulle funzionalità e cicli di produzione rapidi». Le note sulla migrazione sono esplicite: «Mantieni Argon quando la velocità è importante». Anche il post di annuncio di Google ribadisce il concetto: «Argon resta la scelta ideale per la maggior parte delle attività di ingegneria del software e di conoscenza».
La spesa per turno è più alta, anche se il costo per attività è più basso. Il prezzo per token è identico, ma Carbon usa più token di ragionamento per turno. Un team che controlla la spesa per turno o deve razionare una quota di token percepisce Carbon come il modello più costoso. I 205 milioni di token usati per calcolare l'indice contro i 113 milioni di Argon rappresentano il caso estremo di questo effetto.
Low non è l'opzione più economica. A $7.19 per attività, Carbon Low costa più di Medium, che costa $6.59. Se la regola di instradamento è il costo per attività completata, Low non la soddisfa.
Vincere i benchmark non fa recuperare il tempo perso. OSWorld-2.1 e FrontierSWE 2 favoriscono entrambi Carbon nella tabella di Google, ma i risultati sono autodichiarati dal fornitore e nessuno dei due cambia l'attesa prima del primo token. I benchmark misurano il risultato finale; gli utenti vivono l'attesa iniziale.
Chi dovrebbe passare subito e chi dovrebbe restare su Argon
Passa subito a Carbon se esegui batch nativi del fornitore o processi in background per agenti (questi flussi non sono documentati per Carbon su AIHubMix), se un errore di qualità costa più del tempo di esecuzione, se le tue richieste possono tollerare timeout più lunghi e un budget di output maggiore oppure se stai già pagando per tentativi ripetuti che Carbon potrebbe evitare.
Resta su Argon se sviluppi chat, completamento automatico o qualsiasi flusso in cui una persona è in attesa; se il tuo budget o la tua quota sono calcolati per turno; oppure se il prodotto prevede un obiettivo di latenza inferiore a circa 30 secondi.
Fai prima un test se sei indeciso. Invia le stesse 20–50 richieste reali a entrambi i modelli, registra il tempo al primo token e il costo per attività completata, quindi instrada le richieste in base a questi dati, non all'indice. La pagina di confronto di AIHubMix affianca le pagine dei due modelli.
Come effettuare chiamate tramite AIHubMix
Carbon usa lo stesso schema di ID del modello su AIHubMix e l'endpoint documentato per le chat completion.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
L'endpoint è POST /v1/chat/completions; è l'unica route che AIHubMix documenta per questo modello. Il testo è la modalità di input indicata. L'input di immagini e PDF, la Responses API, Anthropic Messages e l'endpoint Gemini nativo non sono documentati per Carbon su AIHubMix, quindi considerali non confermati. Lo stesso vale per la mappatura di reasoning_effort: non dare per scontato che il gateway inoltri un parametro relativo al livello di ragionamento. Mantieni max_tokens entro il limite standard di output di 65,536; i limiti più elevati richiedono la modalità in background di Google e non sono confermati su AIHubMix. Per questo articolo non è stato eseguito alcun test dal vivo, quindi l'esempio mostra la struttura della richiesta, non una risposta verificata.
FAQ
Carbon costa quanto Argon?
Sì. Le tariffe ufficiali di Google sono identiche: $2 per milione di token di input e $10 per milione di token di output fino al 30 novembre 2026, poi $4 e $20. Le letture dalla cache costano rispettivamente $0.10 e poi $0.20.
Carbon è migliore di Argon?
Per qualità e costo per attività completata, sì, secondo le misurazioni di Artificial Analysis: 60.03 contro 50.41 nell'Intelligence Index e $7.76 contro $9.95 per attività. In termini di reattività, no: il primo token della risposta arriva dopo 67.1 secondi, contro 40.1.
Perché Carbon è più lento se completa le attività più velocemente?
Attende più a lungo prima di rispondere, ma poi completa l'intera attività prima: 25.6 minuti contro 29.0. L'attesa prima del primo token e il tempo totale dell'attività sono misure diverse e indicano direzioni opposte.
È necessario modificare le richieste?
No. Google afferma che l'aggiornamento da Argon non richiede modifiche allo schema; la stringa del modello diventa gemini-4-carbon. Aumenta il limite di output e il timeout HTTP per tenere conto di un ragionamento più lungo.
Perché Carbon Low costa di più per attività rispetto a Medium?
Artificial Analysis ha misurato un costo di $7.19 per Low contro $6.59 per Medium. Considera Low un'impostazione di latenza, non uno sconto, e misura il costo per attività prima di inviarvi un volume elevato di richieste.
Che posizione occupa Carbon nella classifica di Artificial Analysis?
È al #4 nell'Intelligence Index, dietro a tre configurazioni di Claude Fable 5.2. La scheda modello di Google riporta un 59 arrotondato per lo stesso indice; il valore aggiornato è 60.03 e i due dati non vanno confusi.
Carbon è disponibile nel piano gratuito?
No. Google non offre Gemini 4 Carbon nel piano gratuito, quindi l'accesso è disponibile tramite le tariffe API a pagamento o un gateway come AIHubMix.
Continua a leggere: la serie su Gemini 4 Carbon
- Se questo articolo ti ha convinto a provare Carbon, ma la tua prima richiesta non è riuscita, la guida alla migrazione illustra gli errori 400, le impostazioni di timeout e i limiti di output che cambiano quando i passaggi di ragionamento si allungano: Migrazione dell'API Gemini 4 Carbon: errori 400, timeout e limiti di output.
- Se la domanda ancora aperta è se Carbon sia un modello abbastanza potente per la programmazione agentica, oppure se il sovrapprezzo di Fable 5.2 valga la pena, il terzo articolo mette a confronto gli stessi valori misurati con Fable 5.2: Gemini 4 Carbon contro Fable 5.2: quale scegliere per la programmazione agentica?.
Fonti
- Google AI Studio, Gemini 4 Carbon: le novità
- Google DeepMind, scheda modello Gemini 4 Carbon
- Google AI Studio, prezzi dell'API Gemini
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon