
Il 2026-11-05/06, DeepSeek V4.1 Flash 1017 è stato sottoposto alla suite completa dell’AIHubMix Provider Benchmark (APB) su Pareto. I punteggi sono Q 48.40, F 93.42, P 57.69, K 27.58 e R 100; l’indice complessivo è 73.09. Questo profilo APB riguarda solo Pareto. Il modello è indicato come DeepSeek V4.1 Flash 1017.
Questo post riporta solo i punteggi, senza classifiche né consigli sui fornitori. Q, F, P, K e R vengono prima; l’indice complessivo è un numero riepilogativo senza intervallo di confidenza. Lo standard adottato è AIHubMix Provider Benchmark Standard v2.0.
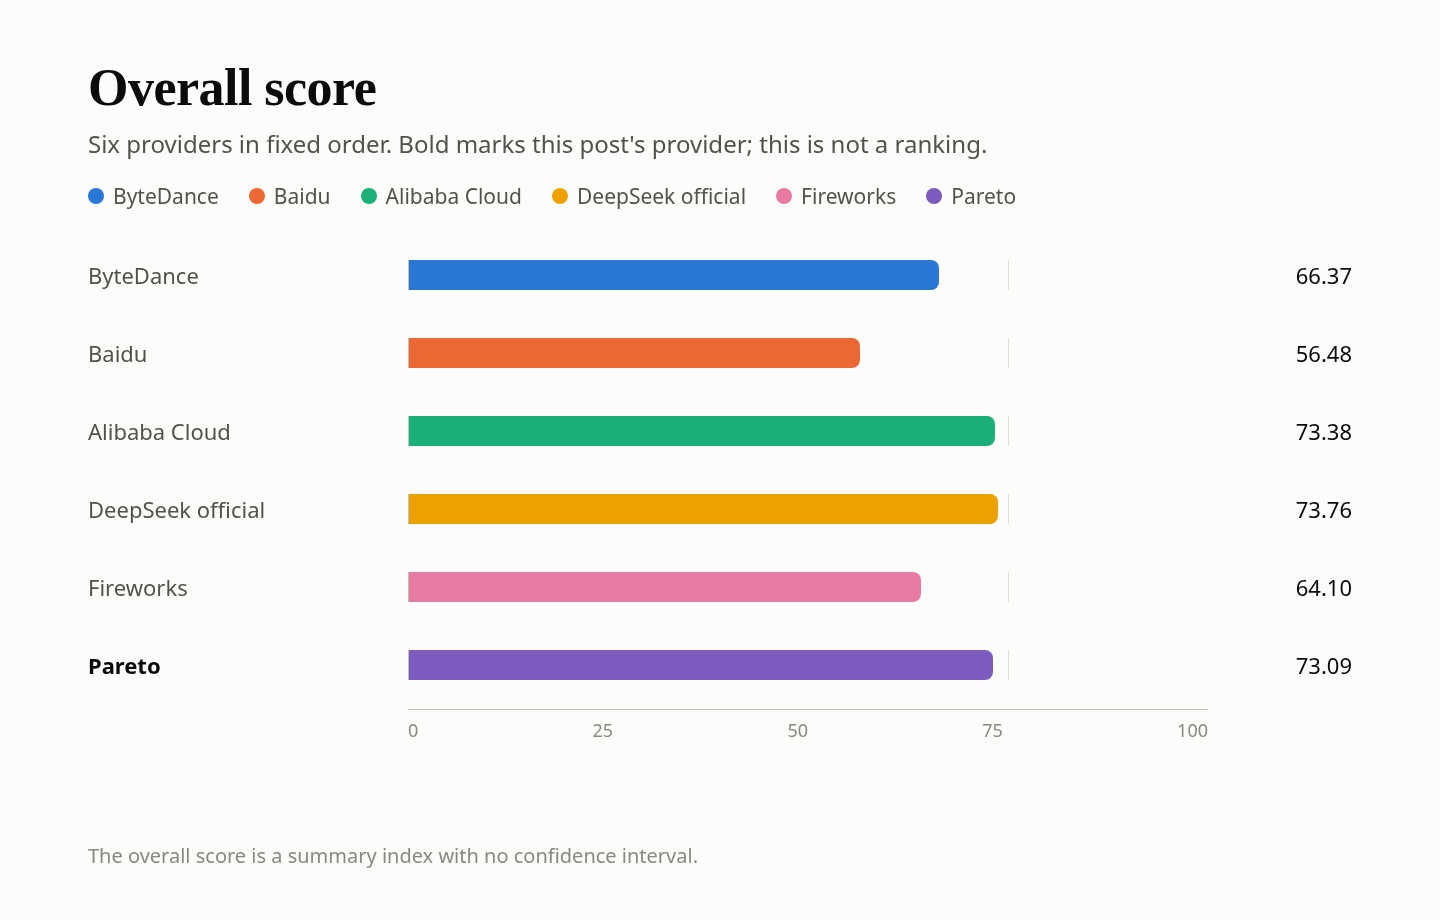
Punteggi su sei fornitori
Il grassetto indica il fornitore di questo post. Ordine fisso dei fornitori, non una classifica. K è un sottopunteggio di P con un peso del 20%. L’indice complessivo è un numero riepilogativo senza intervallo di confidenza. Il canale ufficiale di DeepSeek e Alibaba Cloud differiscono di 0.37 e non sono distinguibili.
In breve
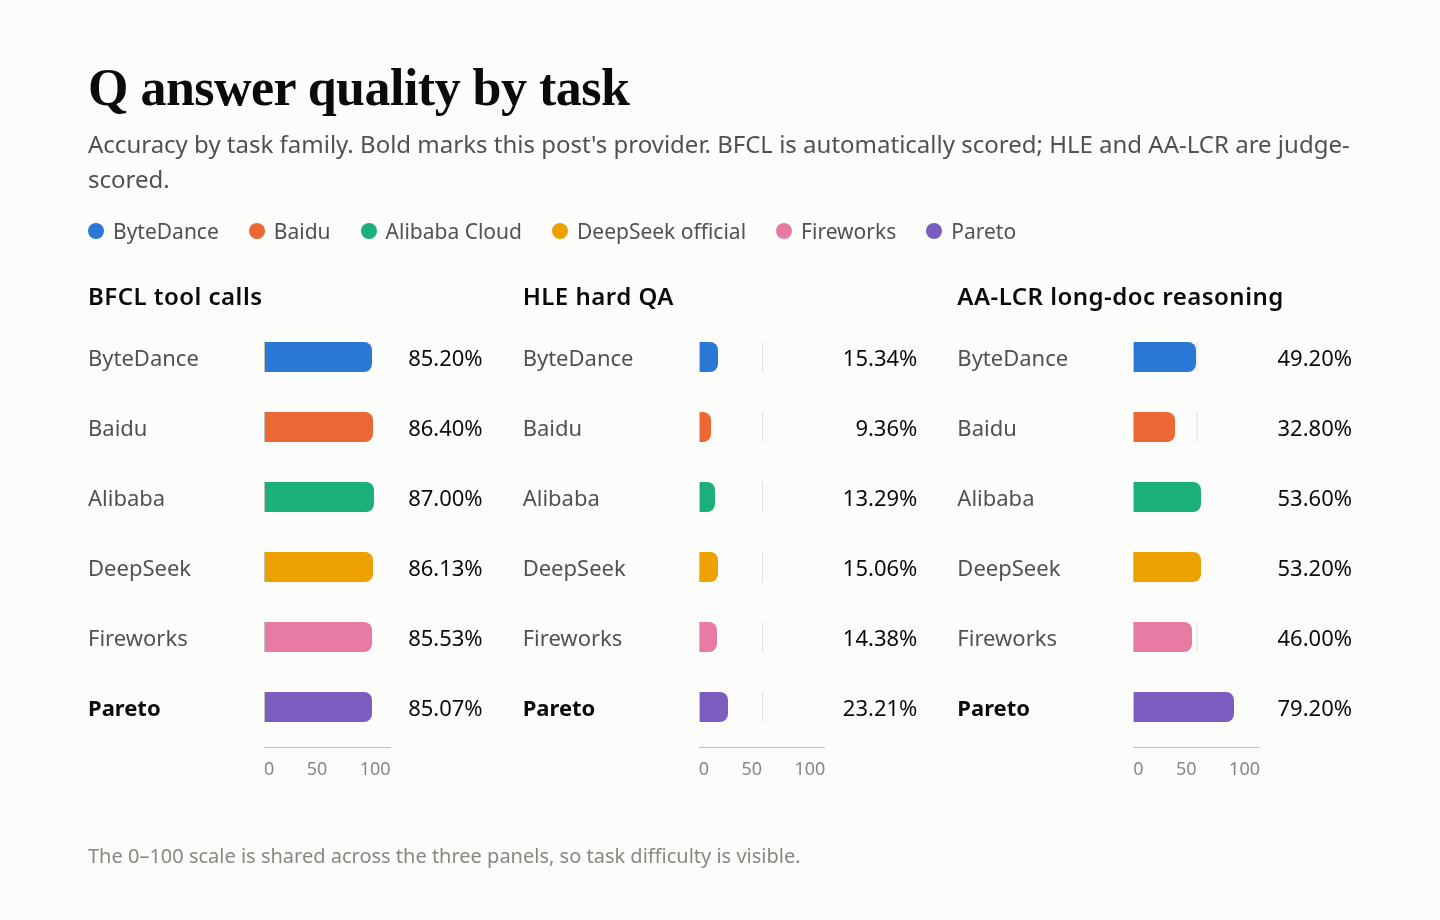
- Q — qualità delle risposte: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Rispetto al canale ufficiale: +5.94 punti percentuali, IC 95% da +3.54 a +8.36. HLE ha registrato 996 errori del servizio, perlopiù dovuti a risposte troncate perché il ragionamento ha esaurito il budget di lunghezza dell’output; sono conteggiate come errate.
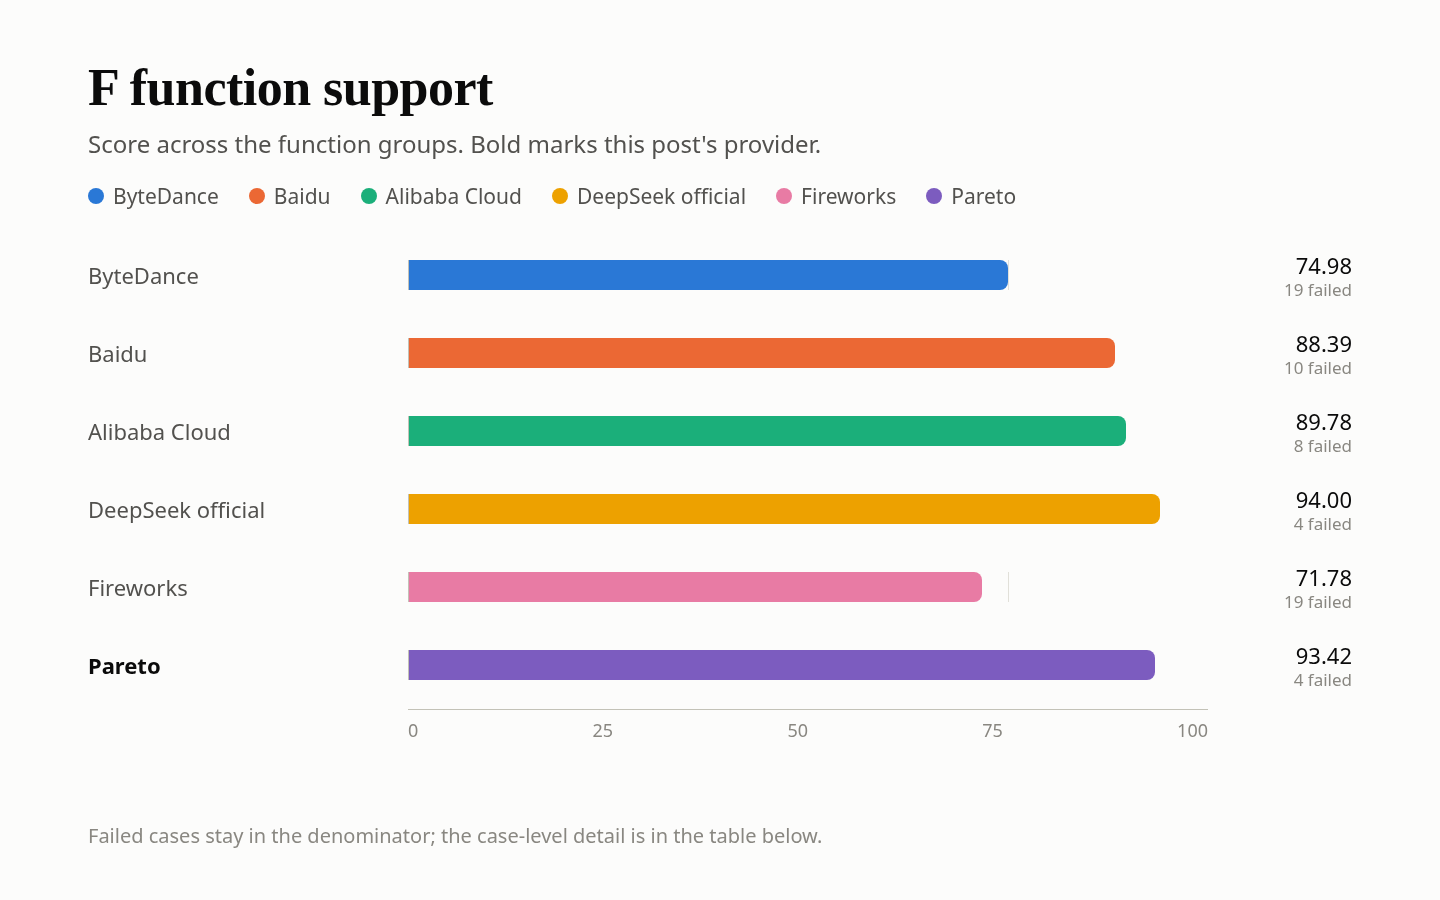
- F — supporto alle funzioni: 93.42. Superati 29 dei 33 controlli conteggiati (streaming 23/27, errori 3/3, misurazione 3/3). 147 controlli sono stati esclusi dal denominatore. Dei 4 insuccessi, 3 erano corpi vuoti nelle richieste con sequenze di stop e 1 riguardava una fixture di testo in streaming che non corrispondeva esattamente.
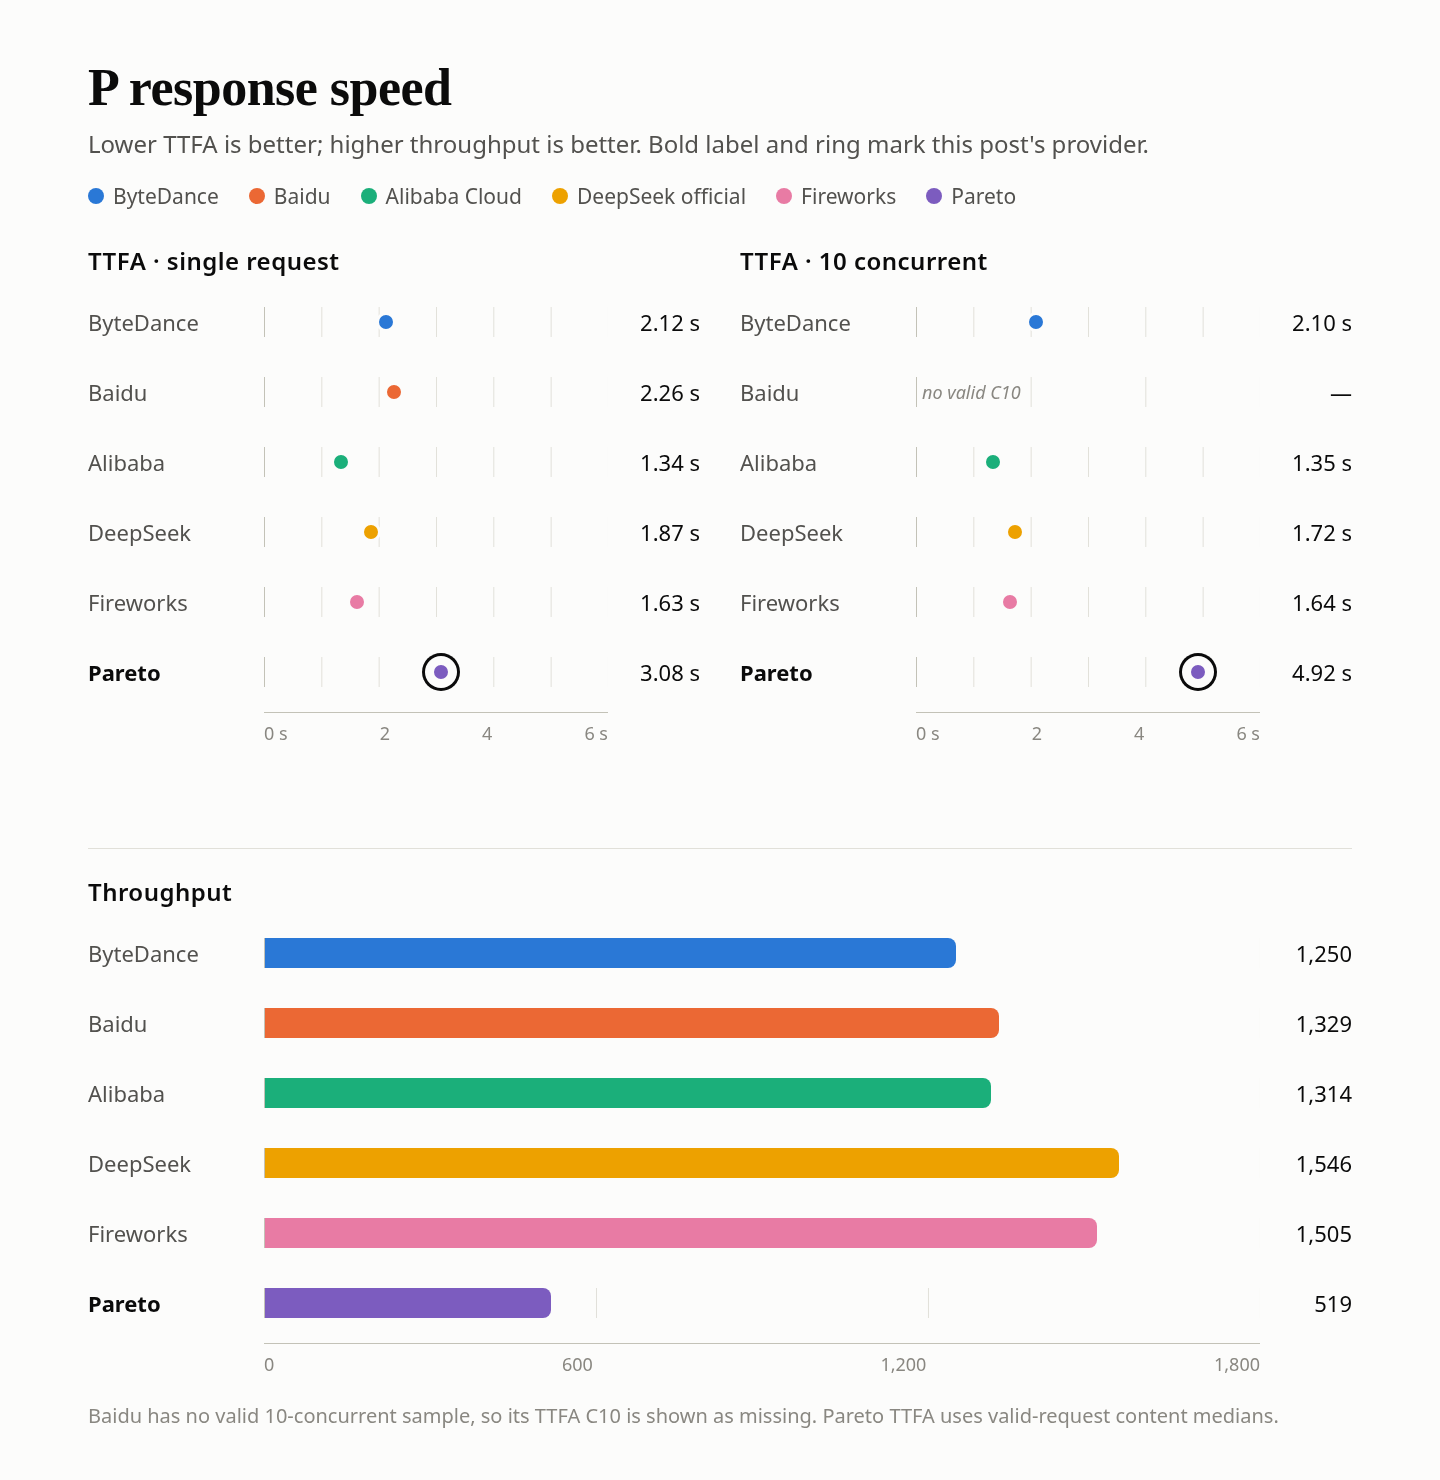
- P — velocità di risposta: 57.69. Punteggio della risposta 65.22, con cache K al 20%. Mediane TTFA delle richieste valide: 3.08 s con concorrenza singola e 4.92 s con concorrenza 10; mediane di scoring, incluse le richieste non valide: 5.85 s e 6.13 s. 110 delle 180 prove erano valide; 70 non valide perché il ragionamento ha esaurito il budget di output del test di velocità.
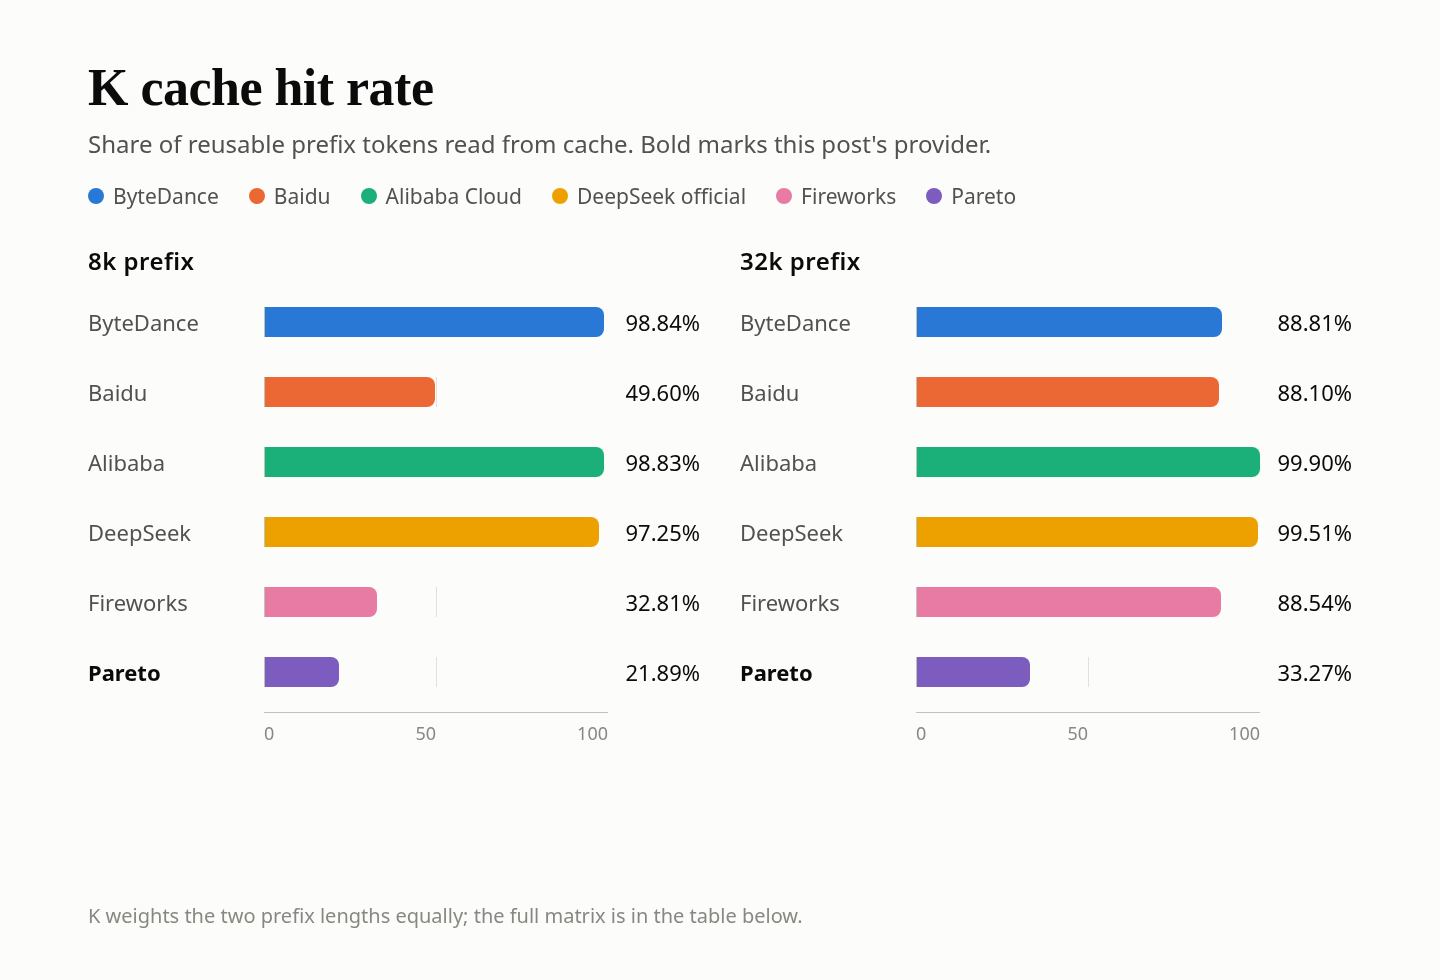
- K — cache: 27.58. Cache hit a caldo 8k: 2/9 (lettura 15,872 / riutilizzabili 72,504); cache hit a caldo 32k: 3/9 (lettura 96,000 / riutilizzabili 288,513). Punteggio calcolato con la configurazione predefinita.
- R — stabilità del servizio: 100. 300/300 richieste dedicate riuscite al primo tentativo.
Configurazione del test
| Voce | Impostazione |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | deepseek/deepseek-v4.1-flash |
| Percorso di accesso | Pareto, utilizzando l’ID modello sopra indicato |
| Parametri | temperature 1.0, max_tokens 16,384, timeout 300 s; solo richieste in streaming |
| Ragionamento | Ragionamento ad alta intensità attivato |
| Data | 2026-11-05/06 UTC+8; la cache è stata sottoposta a un nuovo test il 2026-11-06 con la configurazione predefinita |
| Campioni | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Note | In questa esecuzione il ragionamento ad alta intensità era attivo; gli altri cinque fornitori della serie non lo hanno usato. Il supporto delle funzionalità viene valutato sul sottoinsieme disponibile in streaming; la cache usa la configurazione predefinita. |
Le richieste hanno utilizzato la guida rapida di AIHubMix; gli ID modello sono disponibili nella pagina dei modelli.
Q — qualità delle risposte: 48.40
La suite ha eseguito 500 domande BFCL × 3 round, 250 HLE × 10 e 25 AA-LCR × 10. BFCL è stato valutato automaticamente; HLE e AA-LCR sono stati valutati da deepseek-flash. Le tre famiglie usano gli stessi elementi degli altri fornitori. Sono state rimosse dieci risposte non valutabili, lasciando 4,240 istanze valutate.
| Attività | Domande | Corrette | Accuratezza | Errori |
|---|---|---|---|---|
| Chiamate agli strumenti BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Domande e risposte difficili HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Ragionamento su documenti lunghi AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Totale · IC 95% 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Gli errori restano nel denominatore e vengono conteggiati come risposte errate: 996 risposte HLE sono state troncate quando il ragionamento ha esaurito il budget di lunghezza dell’output. Tra i 1,494 tentativi HLE che hanno restituito una risposta completa, 578 erano corretti (circa il 38.7%).
| Categoria BFCL | Superati | Tasso di superamento |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python ha superato 333/360 (92.50%), multiple 269/300 (89.67%), ahm_multi_turn 102/150 (68.00%) e irrelevance 104/150 (69.33%).
Confronto con gli altri cinque
Differenza in punti percentuali rispetto al canale ufficiale; l’intervallo al 95% è indicato dalle barre di errore. Se l’intervallo attraversa lo 0, i risultati non sono distinguibili. Il valutatore deepseek-flash appartiene alla stessa famiglia e non è calibrato, quindi potrebbe essere indulgente.
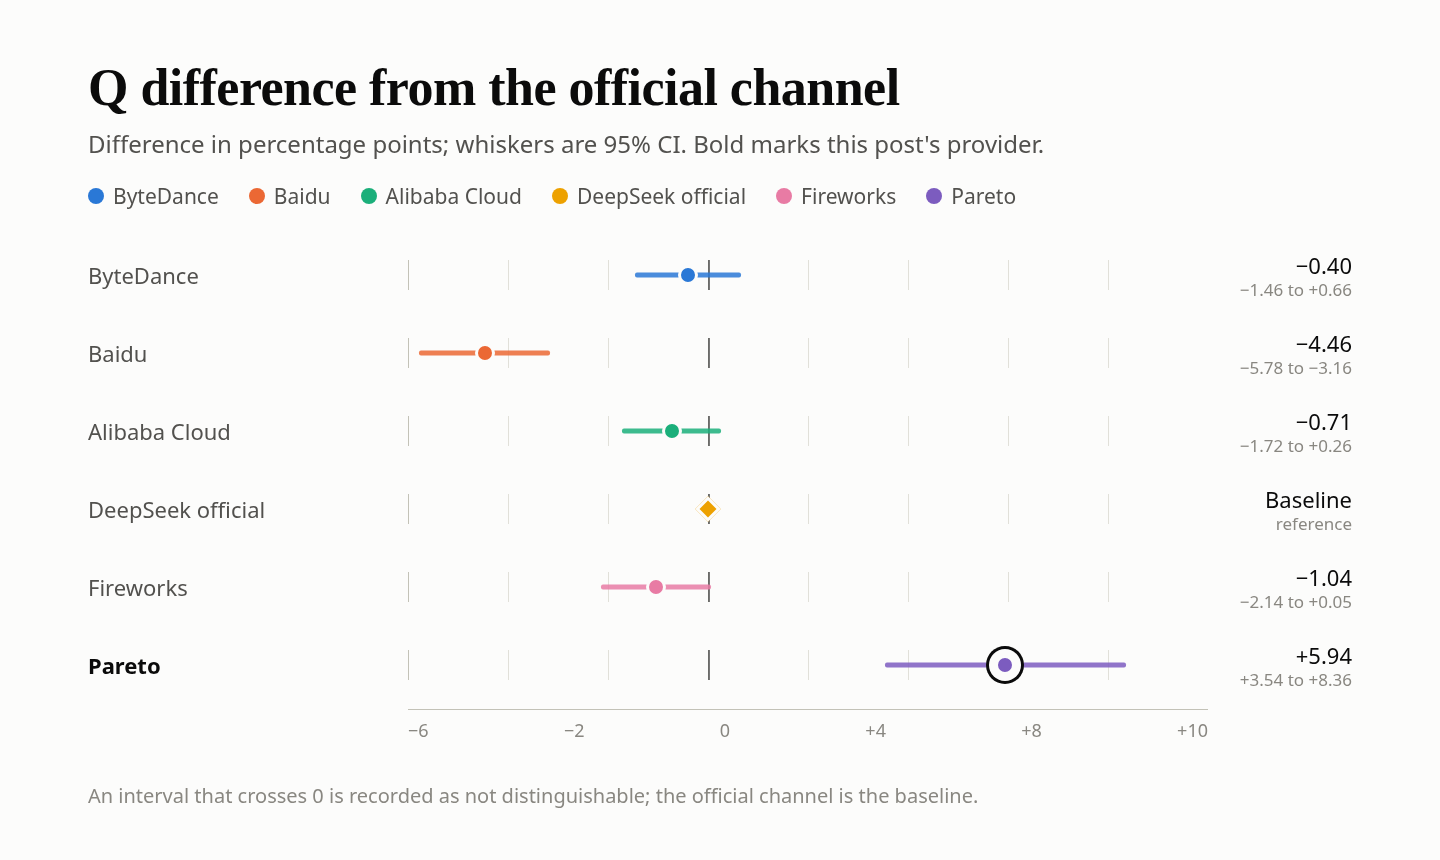
Rispetto al canale ufficiale, la differenza numerica è +5.94 (da +3.54 a +8.36).
F — supporto alle funzioni: 93.42
33 controlli conteggiati, 29 superati; 147 esclusi. Il punteggio 93.42 rinormalizza i pesi originali dei gruppi in base ai gruppi osservati (streaming 20%, errori 15%, misurazione 10%; totale 45%). Il semplice tasso di superamento 29/33 è 87.88%. Strumenti, vincoli e contesto non sono stati conteggiati.
| Gruppo di casi | Peso | Superati | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Streaming e messaggistica | 20% | 23/27 | 3 | 85.19 |
| Interfaccia degli strumenti | 20% | — | 30 | — |
| Vincoli dell’output | 20% | — | 30 | — |
| Contesto e stato | 15% | — | 30 | — |
| Errori e recupero | 15% | 3/3 | 27 | 100.00 |
| Misurazione e cache | 10% | 3/3 | 27 | 100.00 |
| Osservato / ponderato | — | 29/33 | 147 | 93.42 |
"Finestre non superate" indica le tre finestre in cui il caso non è stato superato.
| Caso non superato | Finestre non superate | Motivo |
|---|---|---|
| Stop in streaming | 3/3 | Corpo vuoto con stop |
| Testo in streaming | 1/3 | Punto aggiuntivo alla fine del corpo rispetto alla fixture |
Confronto con gli altri cinque
P — velocità di risposta: 57.69
Il punteggio si basa sul tempo fino al primo token di contenuto, non sul tempo fino al primo token di qualsiasi tipo. Con il ragionamento attivo, il modello genera contenuto di ragionamento prima del testo visibile della risposta, quindi l’attesa del contenuto è più lunga dell’attesa del primo pacchetto. In ognuna delle tre finestre sono state inviate 30 richieste con concorrenza singola e 30 con concorrenza 10, per un totale di 180.
| Metrica | Risultato |
|---|---|
| TTFA del contenuto | Mediane di scoring: 5.85 s (c=1) e 6.13 s (c=10); mediane delle richieste valide: 3.08 s e 4.92 s |
| Primo token di qualsiasi tipo | Mediane delle richieste valide: 1.46 s e 1.76 s |
| TPOT | Fascia di scoring più lenta: 4.87 ms/token |
| Throughput utile | 519 token/s con concorrenza 10 |
| Valide | 53/90 con c=1 e 57/90 con c=10, totale 110/180; 70 non valide perché il ragionamento ha esaurito il budget di output del test di velocità (circa 2,048 token) |
| Componenti | TTFA 24.59, TPOT 100.00, throughput utile 72.05; punteggio della risposta 65.22 |
| Composizione di P | 65.22 × 80% + 27.58 × 20% = 57.69 |
I token di ragionamento sono esclusi dal numeratore del throughput utile.
K — cache: 27.58
Letture aggregate dal nuovo test del 2026-11-06 con la configurazione predefinita. Le matrici della cache per richiesta non sono incluse (le tracce grezze non sono state migrate). K attribuisce lo stesso peso a entrambe le lunghezze di prefisso; K rappresenta il 20% di P.
| Prefisso | Cache hit a caldo | Letti / riutilizzabili | Segmento |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (peso uguale) | 27.58 |
I controlli a freddo sono stati superati 6/6 per ciascuna lunghezza.
R — stabilità del servizio: 100
Le 300 richieste comprendevano testo breve, input lungo, chiamate agli strumenti e cronologia multi-turno, con concorrenza singola. Sono stati verificati solo la validità e il completamento della prima risposta; le risposte non sono state valutate e non sono stati effettuati nuovi tentativi. Gli errori di Q e P non vengono conteggiati di nuovo qui.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo 10k | 90/90 |
| Chiamate agli strumenti | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · IC 95% 98.78%–100% | 300/300 |
FAQ
Cosa comprende Q 48.40?
BFCL, HLE e AA-LCR su 4,240 istanze valutate: 2,052 corrette, 48.40%, IC 95% 45.39%–51.26%. Rispetto al canale ufficiale, la differenza numerica è +5.94 (da +3.54 a +8.36).
Perché ci sono stati 996 errori del servizio HLE?
La maggior parte delle risposte è stata troncata perché il ragionamento ha esaurito il budget di lunghezza dell’output; restano nel denominatore e sono conteggiate come errate.
Perché F è 93.42 con 147 controlli esclusi?
Viene conteggiato solo il sottoinsieme disponibile in streaming. I pesi dei gruppi sono rinormalizzati in base ai gruppi osservati; strumenti, vincoli e contesto sono completamente esclusi dal conteggio.
Perché i casi con stop non sono stati superati?
Le richieste con una sequenza di stop hanno restituito un corpo vuoto in tutte e tre le finestre.
Perché 70 delle 180 prove di velocità non erano valide?
Il ragionamento ha esaurito il budget di output del test di velocità (circa 2,048 token).
Cosa comprende R 100?
300 richieste dedicate, tutte valide al primo tentativo; il limite inferiore al 95% è 98.78%. Gli errori di Q e P non vengono conteggiati in R.
Continua a leggere: la serie DeepSeek V4.1 Flash
- ByteDance ha riportato token di ragionamento anche dopo aver disattivato il ragionamento: DeepSeek V4.1 Flash su ByteDance: le chiamate agli strumenti coincidono, la misurazione no
- Baidu ha registrato Q 38.00 e P 37.77: DeepSeek V4.1 Flash su Baidu: nessun canale disponibile raggiunge Q e P
- Alibaba Cloud ha registrato un primo token in 1.34 s e cache 99.37: DeepSeek V4.1 Flash su Alibaba Cloud: primo token in 1.34s, cache 99.37
- Il canale ufficiale è il riferimento per Q, con F 94.00: DeepSeek V4.1 Flash sul canale ufficiale: 94.00 F, 15 prove non valide
- Fireworks ha restituito risposte vuote con stop e 3/9 cache hit a 8k: DeepSeek V4.1 Flash su Fireworks: risposte vuote con stop, 3/9 cache hit


