

Il 2026-11-03/04, la suite APB Full ha testato DeepSeek V4.1 Flash 1017 su cinque fornitori tramite AIHubMix. Per tutti i fornitori sono stati usati lo stesso modello, le stesse domande e gli stessi parametri e script di richiesta; il modello è elencato nella pagina del modello di AIHubMix e le cinque voci dei fornitori sono nella pagina dei modelli. Questo profilo APB riguarda solo Alibaba Cloud: cosa ha misurato ciascuna sezione e quali risultati ha restituito.
Questo post riporta i punteggi senza stilare classifiche tra i fornitori né consigliarne uno. Si parte da Q, F, P, K e R; K è un sottopunteggio di P. Il punteggio complessivo è un indice di sintesi, non una certificazione, e non ha un intervallo di confidenza. Le regole di valutazione sono definite nell'AIHubMix Provider Benchmark Standard v2.0.
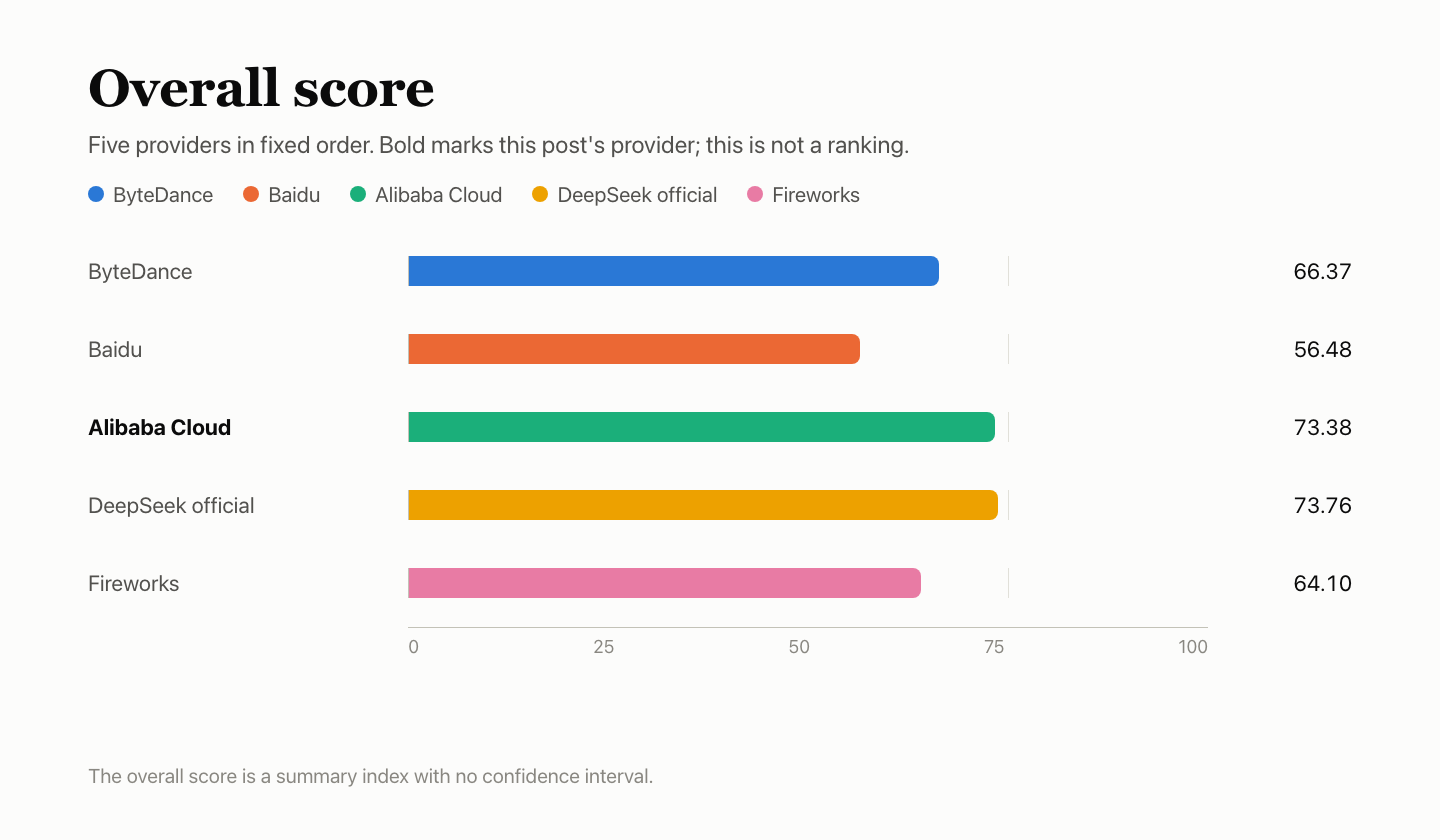
Punteggi dei cinque fornitori
Il grassetto indica il fornitore di questo post. I fornitori sono presentati in un ordine fisso, non in una classifica. K è un sottopunteggio di P, con un peso del 20%, mostrato separatamente come riferimento. Il punteggio complessivo è un indice di sintesi senza intervallo di confidenza. Il canale ufficiale DeepSeek e Alibaba Cloud differiscono di 0.37 nel punteggio complessivo e non sono distinguibili.
In breve
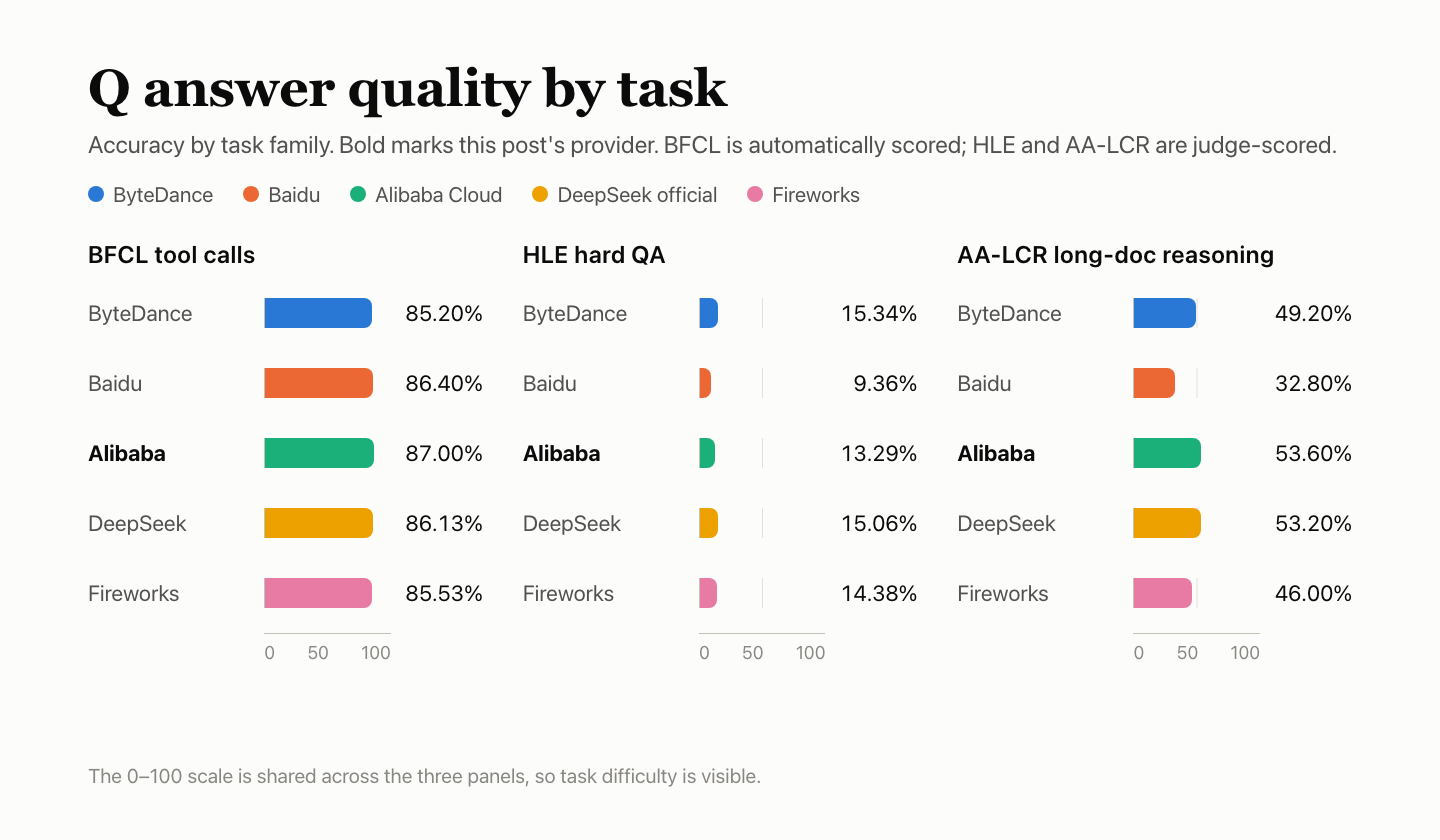
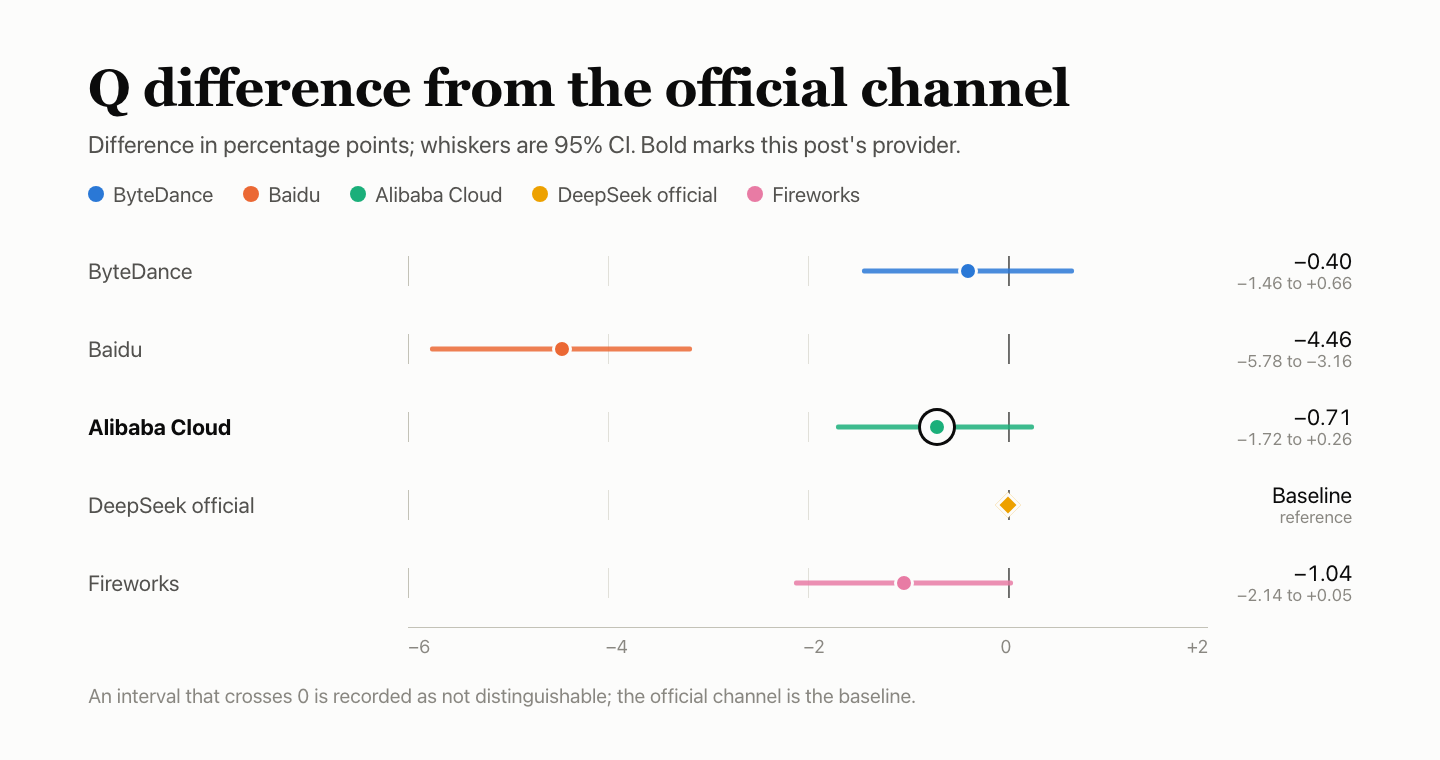
- Qualità delle risposte: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Rispetto al canale ufficiale, la differenza è di −0.71 punti percentuali, con un intervallo al 95% da −1.72 a +0.26; pertanto, i due risultati non sono distinguibili.
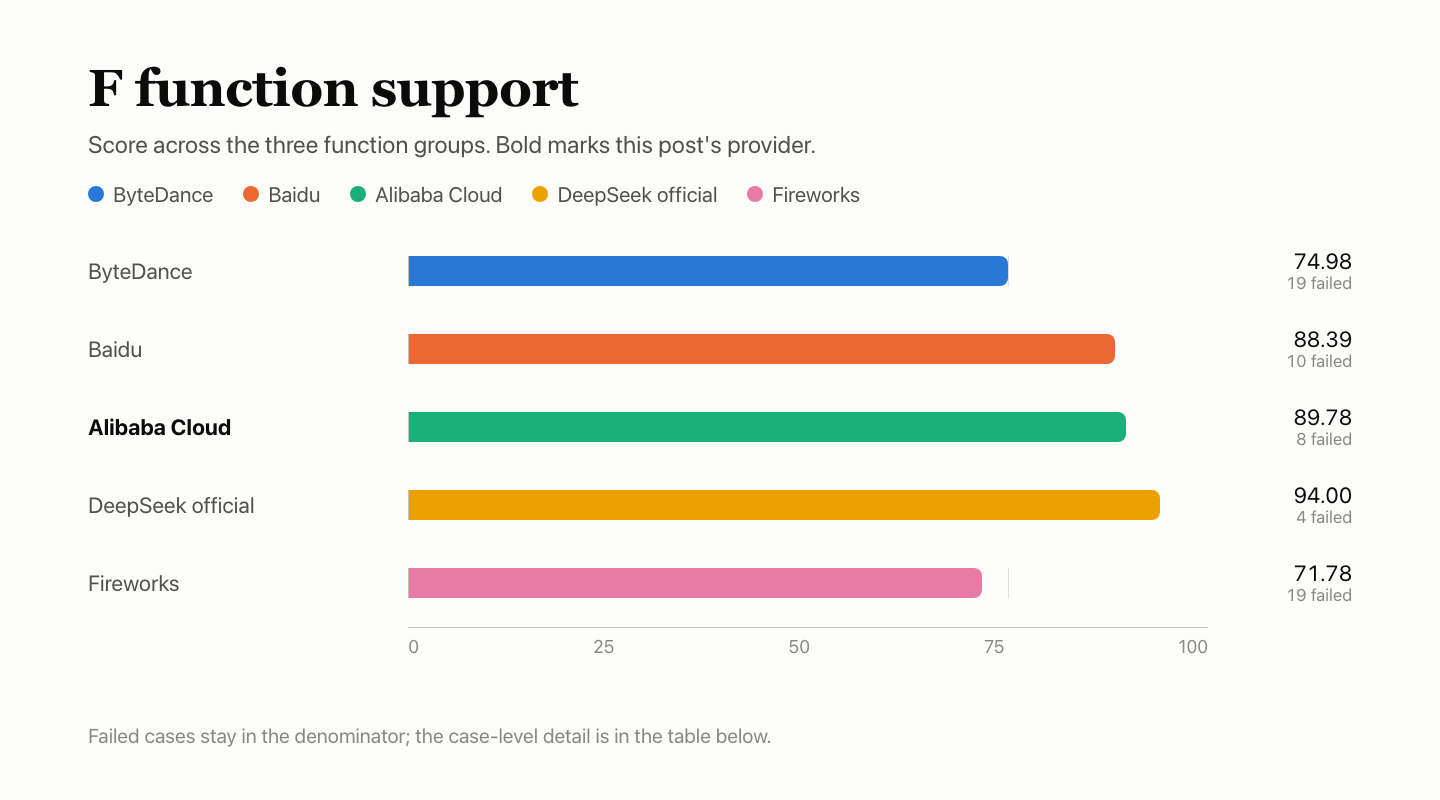
- Supporto delle funzioni: F 89.78. Sono stati superati 155 dei 177 controlli inclusi al denominatore. Uno schema dello strumento non valido ha restituito 503 invece di un errore di parametro; il superamento del contesto non ha restituito il tipo di errore documentato e un risultato isolato dello strumento ha restituito 200.
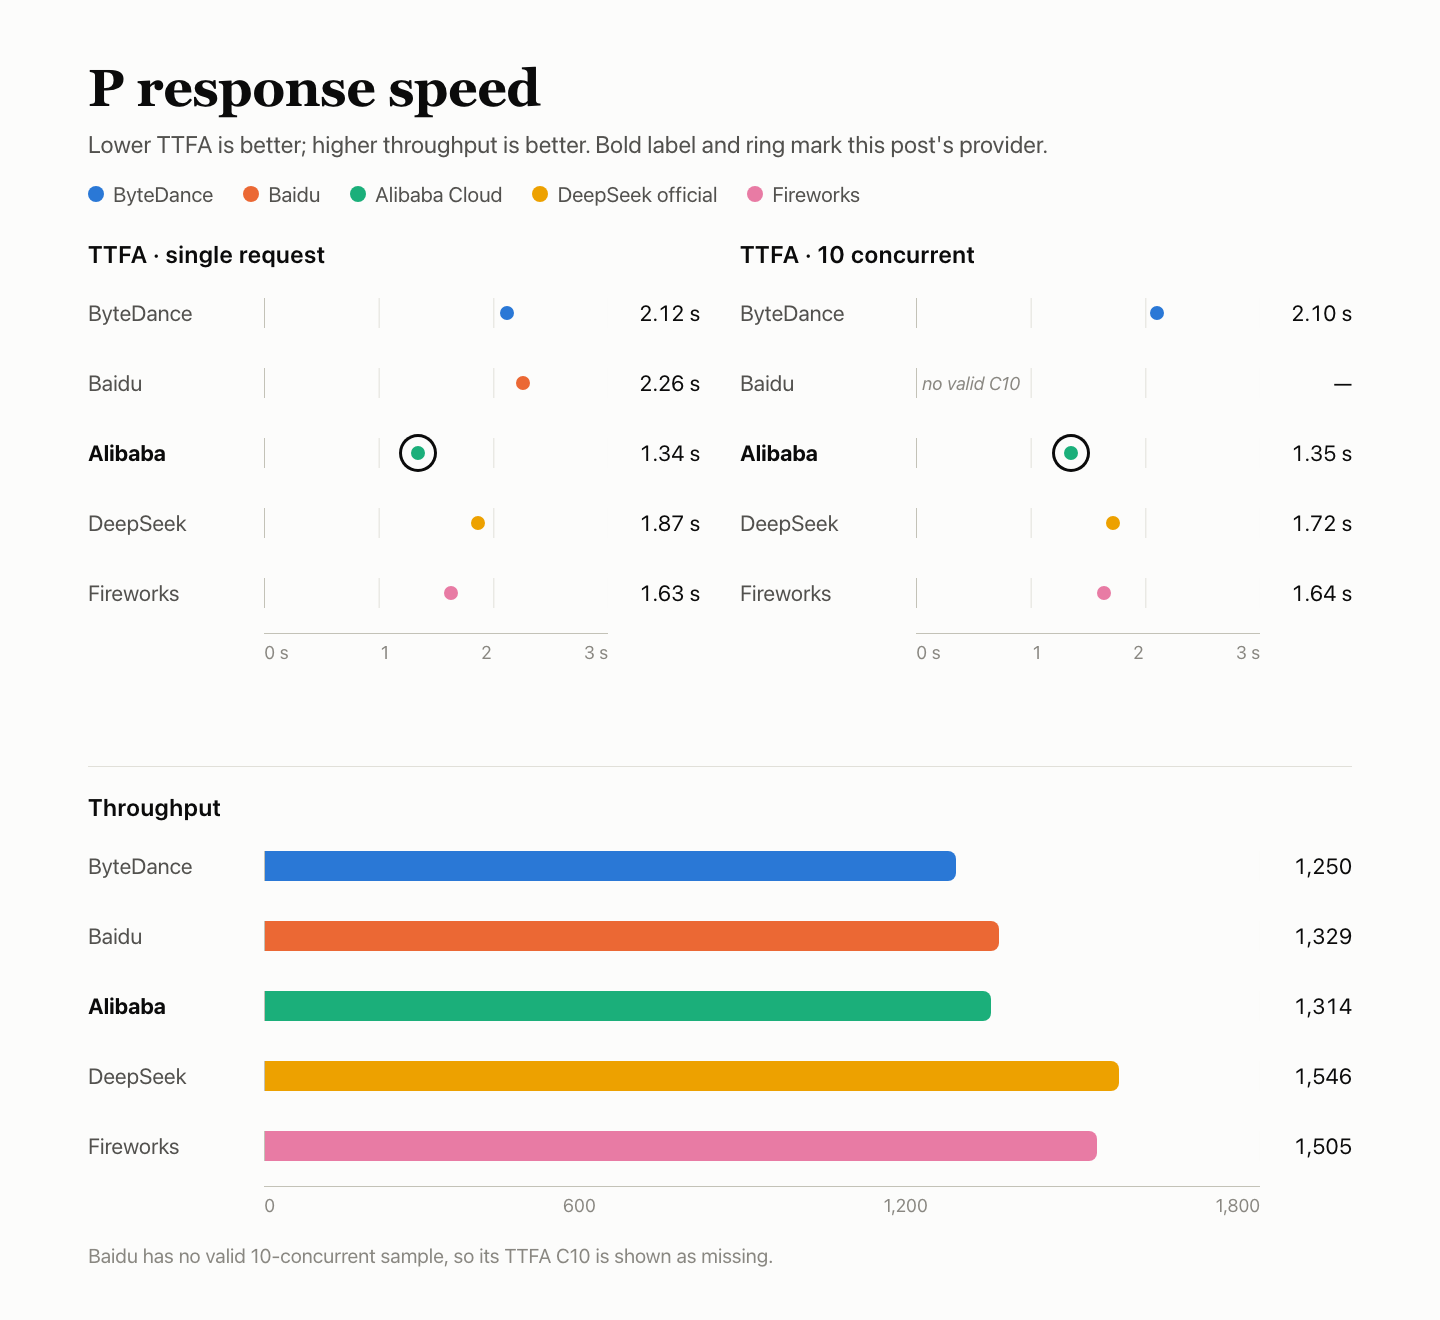
- Velocità di risposta: P 88.58. La mediana del tempo al primo token di contenuto è stata di 1.34 s con concorrenza singola e di 1.35 s con concorrenza 10; TPOT è stato di 4.69 ms e tutte le 180 richieste di velocità erano valide.
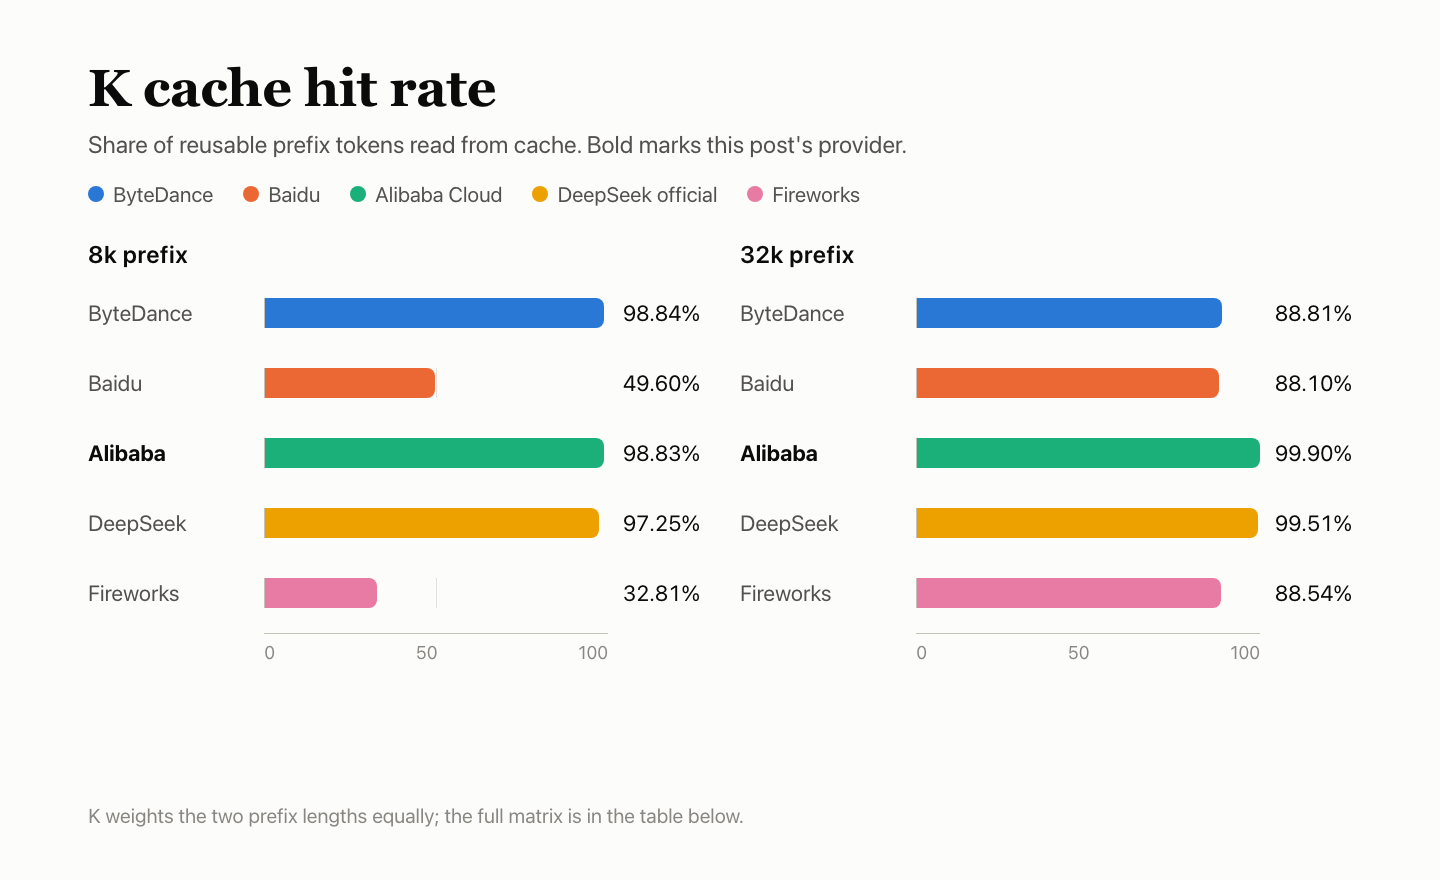
- Cache: K 99.37. Tutte le 18 richieste hot con prefissi da 8k e 32k hanno fatto cache hit e nessuna richiesta di controllo cold ha letto dalla cache.
- Stabilità del servizio: R 100. Tutte le 300 richieste dedicate sono riuscite al primo tentativo.
Configurazione del test
Il test è stato eseguito tramite AIHubMix selezionando l'ID modello del fornitore; la guida rapida documenta il percorso. La pagina dei prezzi di DeepSeek elenca le tariffe pubblicate del modello.
| Voce | Dettaglio |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | alicloud-deepseek-v4.1-flash-1017 |
| Nome modello restituito | deepseek-v4.1-flash-1017 |
| Percorso di accesso | Tramite AIHubMix, selezionando l'ID modello del fornitore, non collegandosi all'account del fornitore |
| Parametri | Modalità senza ragionamento, temperature 1.0, max_tokens 16,384, timeout 300 s, nessun nuovo tentativo automatico |
| Ragionamento disattivato | Tutte le richieste usavano reasoning_effort=none |
| Orario | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Cinque fornitori hanno condiviso lo stesso Mac mini, la stessa rete e lo stesso account. |
| Campioni | Qualità delle risposte: 4,250 esecuzioni di domande (BFCL 500 × 3 round, HLE 250 × 10, AA-LCR 25 × 10); casi di supporto delle funzioni: 60 × 3 finestre; velocità: 90 richieste a concorrenza singola e 90 a concorrenza 10; stabilità: 300; cache: 30 (prefissi da 8k e 32k, 3 gruppi ciascuno) |
Q — qualità delle risposte: 41.75
La qualità delle risposte è stata valutata usando tre insiemi di domande: 500 domande BFCL con 3 round ciascuna, 250 domande HLE con 10 round ciascuna e 25 domande AA-LCR con 10 round ciascuna. BFCL è stato valutato con regole automatiche; HLE e AA-LCR sono stati giudicati dal modello valutatore deepseek-flash. Tutti e cinque i fornitori hanno risposto alle stesse domande e i tre insiemi sono stati combinati in un'unica accuratezza. Dieci risposte sono state escluse perché non era possibile valutare le domande, lasciando 4,240 esecuzioni di domande valutate.
| Attività | Domande | Corrette | Accuratezza | Errori |
|---|---|---|---|---|
| Chiamate allo strumento BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Domande e risposte difficili HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Ragionamento su documenti lunghi AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Combinato · intervallo al 95% 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Gli errori di servizio (richieste non riuscite o output troncato) restano al denominatore e vengono conteggiati come errati; non vengono rimossi. Per Alibaba Cloud, l'output HLE ha raggiunto il limite max_tokens ed è stato troncato 8 volte.
BFCL prevede 3 round per ogni domanda; la tabella mostra i risultati combinati dei 3 round.
| Categoria BFCL | Superate | Tasso di superamento |
|---|---|---|
| simple_python: una funzione, chiamata e argomenti corretti | 332/360 | 92.22% |
| multiple: scegliere la funzione giusta tra diverse opzioni | 270/300 | 90.00% |
| parallel: chiamare più volte la stessa funzione in parallelo | 273/300 | 91.00% |
| parallel_multiple: chiamare più funzioni diverse in parallelo | 212/240 | 88.33% |
| irrelevance: nessuna funzione è pertinente, quindi non va chiamata nessuna funzione | 113/150 | 75.33% |
| ahm_multi_turn: catena di strumenti in tre fasi | 105/150 | 70.00% |
Confronto con gli altri quattro
Rispetto al canale ufficiale: differenza di accuratezza in punti percentuali, con l'intervallo al 95% indicato dalle barre; se l'intervallo attraversa lo 0, non si considera una differenza. Il modello valutatore deepseek-flash usato per HLE e AA-LCR appartiene alla stessa famiglia DeepSeek del modello testato e non è stato calibrato, quindi potrebbe assegnare punteggi più generosi.
F — supporto delle funzioni: 89.78
I casi relativi alle funzioni verificano se il comportamento dell'interfaccia rispetta il protocollo, non se il modello risponde bene. I 60 casi sono suddivisi in sei gruppi, ciascuno eseguito in tre finestre, per un totale di 180 controlli, valutati rispetto al formato documentato da ciascun fornitore. I controlli non applicabili, non validi o non osservati sono esclusi dal denominatore. Alibaba Cloud ha superato 155 dei 177 controlli inclusi al denominatore; l'applicazione dei pesi dei gruppi dà un punteggio di 89.78.
Il punteggio ponderato è calcolato applicando i pesi dei gruppi, non contando semplicemente i superamenti su 177.
| Gruppo | Peso | Superati | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Streaming e protocollo dei messaggi | 20% | 30/30 | — | 100.00 |
| Interfaccia degli strumenti | 20% | 30/30 | — | 100.00 |
| Vincoli di output e parametri | 20% | 30/30 | — | 100.00 |
| Contesto e stato | 15% | 26/30 | — | 86.67 |
| Errori e ripristino | 15% | 18/30 | — | 60.00 |
| Misurazione dell'utilizzo e protocollo della cache | 10% | 21/27 | 3 | 77.78 |
| Totale · punteggio ponderato | — | 155/177 | 3 | 89.78 |
Un conteggio delle finestre pari a 3/3 indica che il caso non è riuscito in tutte e tre le finestre.
| Caso non superato | Finestre non superate | Motivo |
|---|---|---|
| Superamento del contesto (contesto e stato) | 3/3 | È stato restituito un errore, ma non l'errore documentato relativo alla lunghezza del contesto |
| Errore di formato messages (errori e ripristino) | 3/3 | È stato restituito 400 con un corpo della risposta vuoto, senza una descrizione strutturata dell'errore |
| Schema dello strumento non valido (errori e ripristino) | 3/3 | Avrebbe dovuto restituire un errore di parametro; ha restituito 503 |
| Risultato isolato dello strumento (errori e ripristino) | 3/3 | Avrebbe dovuto restituire un errore di parametro; ha restituito 200 |
| Errore di formato stream_options (errori e ripristino) | 3/3 | È stato restituito 400 con un corpo della risposta vuoto, senza una descrizione strutturata dell'errore |
| Misurazione dei token di ragionamento (misurazione dell'utilizzo e protocollo della cache) | 3/3 | Nessun conteggio dei token di ragionamento restituito |
| Definizioni degli strumenti conteggiate come input (misurazione dell'utilizzo e protocollo della cache) | 3/3 | Con le definizioni degli strumenti, il numero di token di input riportato non era superiore a quello senza di esse |
| Isolamento delle richieste (contesto e stato) | 1/3 | Il primo passaggio non ha risposto solo STORED come richiesto, quindi non è stato possibile procedere con il controllo dell'isolamento |
Questi controlli sono esclusi dal denominatore e non vengono conteggiati né come superati né come non superati.
| Stato | Caso | Conteggio | Motivo |
|---|---|---|---|
| Non applicabile | cache_control esplicito | 3 | Registrato in anticipo come non supportato da questa interfaccia |
I casi di errore di formato messages e di errore di formato stream_options non sono riusciti per tutti e cinque i fornitori: ciascuno ha restituito 400 con un corpo vuoto, quindi il client non ha ricevuto una descrizione strutturata dell'errore. Poiché tutti e cinque si comportano allo stesso modo, è più probabile che il problema si trovi nel livello gateway di AIHubMix e vada esaminato separatamente. Anche la misurazione dei token di ragionamento non è riuscita per tutti e cinque, ma per ragioni diverse: ByteDance e Fireworks hanno riportato token di ragionamento anche con il ragionamento disattivato, mentre gli altri tre non hanno restituito alcun conteggio dei token di ragionamento.
Confronto con gli altri quattro
P — velocità di risposta: 88.58
Ogni richiesta conteneva circa 10,000 token di input e richiedeva circa 1,100 token di output. In tre finestre sono state inviate 30 richieste a concorrenza singola e 30 a concorrenza 10, per un totale di 180. L'attesa fino al primo token di contenuto (TTFA) viene misurata per ogni richiesta valida; la tabella riporta le mediane. TPOT è stimato dai tempi dei chunk in streaming, non dalla misurazione hardware per token; il throughput è dato dai token di output validi a concorrenza 10 divisi per il tempo totale di esecuzione del batch.
| Metrica | Risultato |
|---|---|
| Tempo al primo token di contenuto (TTFA) | Mediana a concorrenza singola: 1.34 s; mediana a concorrenza 10: 1.35 s |
| Velocità di generazione TPOT | Concorrenza singola: 4.63 ms/token; concorrenza 10: 4.69 ms/token |
| Throughput effettivo (goodput) | Concorrenza 10: 1,313.6 token/s |
| Richieste valide | Concorrenza singola: 90/90; concorrenza 10: 90/90 |
| Punteggi delle componenti | TTFA 59.65, TPOT 100.00, throughput 100.00; per TTFA e TPOT si usa il valore più basso tra i due livelli, con pesi del 35% / 35% / 30%; punteggio di risposta 85.88 |
| Punteggio P | Punteggio di risposta 85.88 con un peso dell'80%, cache K 99.37 con un peso del 20%, totale 88.58 |
Confronto con gli altri quattro
Tutti e cinque i fornitori hanno condiviso la stessa macchina, la stessa rete e lo stesso account. Le tre finestre sono state pianificate un fornitore alla volta, quindi i periodi di raccolta non si sovrappongono del tutto e non bisogna attribuire eccessiva importanza a piccole differenze.
K — cache: 99.37
Ogni gruppo comprende cinque richieste: la prima include un prefisso fisso di circa 8k o 32k token e inizializza la cache; le richieste da 2 a 4 mantengono il prefisso e modificano solo la domanda finale, dopo 5, 30 e 120 secondi; la quinta usa un nuovo prefisso come controllo cold. Tre finestre × due lunghezze equivalgono a 30 richieste. K è il numero di token letti dalla cache nelle richieste hot diviso per i token che, secondo la regola, dovrebbero poter essere riutilizzati, con un peso pari alla metà per ciascuna lunghezza; K costituisce il 20% di P. La matrice mostra le letture di token dalla cache riportate dal server.
| Prefisso | Finestra | Inizializzazione (richiesta 1) | Hot dopo 5 s | Hot dopo 30 s | Hot dopo 120 s | Controllo cold (richiesta 5) |
|---|---|---|---|---|---|---|
| 8k | Finestra 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Finestra 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Finestra 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Finestra 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Finestra 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Finestra 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Prefisso | Cache hit hot | Token letti | Dovrebbero essere riutilizzabili | Punteggio |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k e 32k, metà ciascuno) | 99.37 |
Tutte le 9 richieste hot con prefisso da 8k hanno fatto cache hit, leggendo 7,936 token ciascuna; tutte le 9 richieste hot con prefisso da 32k hanno fatto cache hit, leggendo 32,000 token ciascuna. La richiesta di inizializzazione e il controllo cold non hanno letto dalla cache, separando nettamente le richieste hot da quelle cold.
Confronto con gli altri quattro
R — stabilità del servizio: 100
Le 300 richieste riguardavano quattro tipi: testo breve, input lungo da 10k, chiamate agli strumenti e cronologia multi-turno; sono state inviate a concorrenza singola in tre finestre. È stata controllata solo la prima risposta, per verificarne validità e completezza; la correttezza delle risposte non è stata verificata e non sono stati effettuati nuovi tentativi. Gli errori nelle sezioni sulla qualità delle risposte e sulla velocità sono conteggiati rispettivamente in Q e P, non di nuovo in R.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo da 10k | 90/90 |
| Chiamate agli strumenti | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · intervallo al 95% 98.78%–100% | 300/300 |
Tutte le 300 richieste hanno restituito una risposta valida e completa al primo tentativo. R 100 riguarda solo queste 300 richieste dedicate e non significa che l’intera catena non abbia avuto errori. Il limite inferiore dell’intervallo al 95% è 98,78%: anche con 300/300, è probabile che il tasso di errore sia inferiore all’1,22%.
Rispetto agli altri quattro
R riguarda solo queste 300 richieste dedicate; gli errori nella qualità e nella velocità delle risposte vengono registrati in Q e P, e non conteggiati di nuovo in R.
| Fornitore | Successo al primo tentativo | Intervallo al 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek ufficiale | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
La differenza complessiva di 0.37 tra Alibaba Cloud e il canale ufficiale è significativa?
No. In questa esecuzione i due risultati non sono distinguibili: la differenza di Q è −0,71 punti percentuali, con un intervallo al 95% compreso tra −1,72 e +0,26, che include 0; inoltre, il punteggio complessivo è un indice riepilogativo senza intervallo di confidenza.
Che cosa comprende il punteggio Q?
Tre gruppi di test: 500 domande BFCL × 3 round, valutate automaticamente; HLE 250 × 10 e AA-LCR 25 × 10, valutate dal modello giudice deepseek-flash. L’accuratezza combinata è del 41,75% su 4,240 esecuzioni valutate delle domande.
Perché F è 89.78 se 155 verifiche su 177 sono state superate?
Il punteggio è ponderato per gruppo, non è un semplice rapporto tra verifiche superate e totali. Errori e recupero hanno ottenuto 60.00, mentre la misurazione e il protocollo della cache hanno ottenuto 77.78; i tre gruppi di protocollo hanno invece ottenuto 100.00.
Perché R indica 100 se in altre sezioni ci sono state richieste non riuscite?
R riguarda solo le 300 richieste dedicate alla stabilità. Gli errori nella qualità e nella velocità delle risposte vengono registrati in Q e P, e non conteggiati di nuovo in R.
K 99.37 è un tasso di cache hit?
È il rapporto tra i token letti dalla cache nelle richieste ripetute e i token che dovrebbero poter essere riutilizzati, con un peso pari al 50% ciascuno per 8k e 32k. Il prefisso 8k ha ottenuto 98.83 e quello 32k 99.90.
Il primo token in 1.34 s significa che la risposta completa arriva in 1.34 s?
No. È il tempo di attesa per il primo token di contenuto. Ogni richiesta prevedeva circa 1,100 token in output e, con una concorrenza di 10, il TPOT era di 4.69 ms per token.
Continua a leggere: la serie DeepSeek V4.1 Flash
- Il Q combinato di Alibaba Cloud differisce dal valore di riferimento ufficiale di 0,71 punti percentuali, entro un intervallo che include 0; il profilo di ByteDance estende lo stesso confronto alla misurazione delle chiamate allo strumento: DeepSeek V4.1 Flash su ByteDance: le chiamate allo strumento coincidono, la misurazione no.
- Alibaba Cloud ha restituito risultati validi per tutte le 180 richieste di velocità; il profilo di Baidu applica lo stesso harness, in cui nessun canale disponibile ha influito su Q e P: DeepSeek V4.1 Flash su Baidu: nessun canale disponibile influisce su Q e P.
- Per questo articolo, il canale ufficiale è il riferimento per il confronto sulla qualità delle risposte; il relativo profilo comprende F 94.00 e 15 sonde non valide a concorrenza singola: DeepSeek V4.1 Flash sul canale ufficiale: F 94.00, 15 sonde non valide.
- Alibaba Cloud ha ottenuto 9/9 richieste ripetute a entrambe le lunghezze di prefisso; il profilo di Fireworks riguarda risposte di stop vuote e 3/9 cache hit a 8k: DeepSeek V4.1 Flash su Fireworks: risposte di stop vuote, 3/9 cache hit.


