

Il 2026-11-03/04, la suite APB Full è stata eseguita su DeepSeek V4.1 Flash 1017 tramite cinque fornitori attraverso AIHubMix. Per ogni fornitore sono state usate le stesse domande, gli stessi parametri e gli stessi script di richiesta; le cinque voci dei fornitori sono disponibili nella pagina dei modelli. Questo profilo APB riguarda solo il canale ufficiale DeepSeek. È raggiunto tramite il percorso del fornitore ufficiale DeepSeek di AIHubMix, non con una connessione diretta all'API di DeepSeek.
Questo post riporta solo i punteggi, senza classificare i fornitori né consigliarne uno: Q 42.45, F 94.00, P 86.14, K 98.38 e R 100. Q, F, P e R sono i punteggi delle quattro sezioni; K è un sottopunteggio di P. Il punteggio complessivo, 73.76, è un indice riepilogativo, non una certificazione, e non ha un intervallo di confidenza. Lo standard di valutazione è AIHubMix Provider Benchmark Standard v2.0.
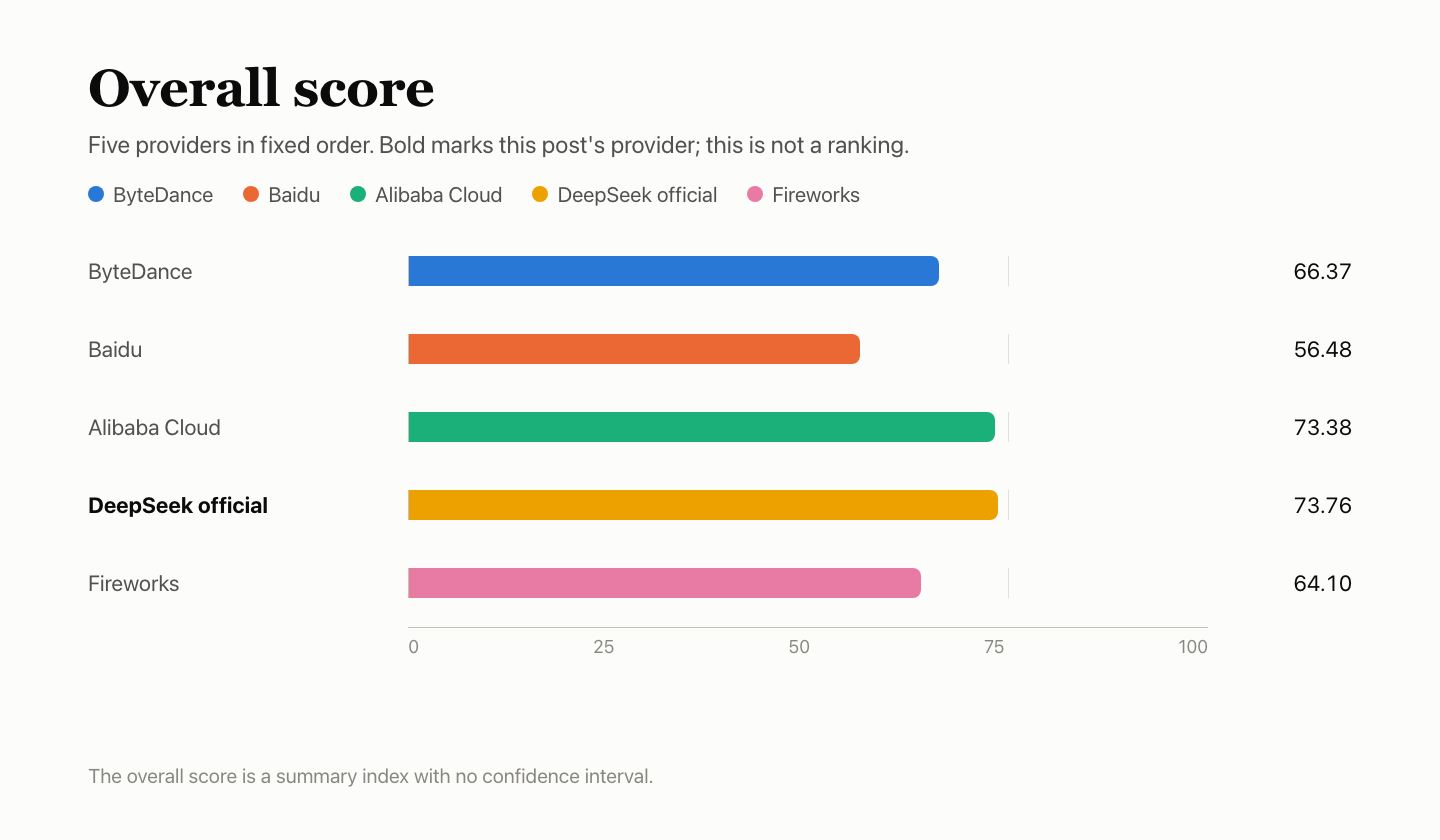
Punteggi dei cinque fornitori
Il grassetto indica il fornitore di questo post. Ordine dei fornitori fisso, non una classifica. K è un sottopunteggio di P con peso del 20% ed è riportato separatamente come riferimento. Il punteggio complessivo è un indice riepilogativo senza intervallo di confidenza. Il canale ufficiale DeepSeek e Alibaba Cloud differiscono di 0.37 sul punteggio complessivo e non sono distinguibili.
In sintesi
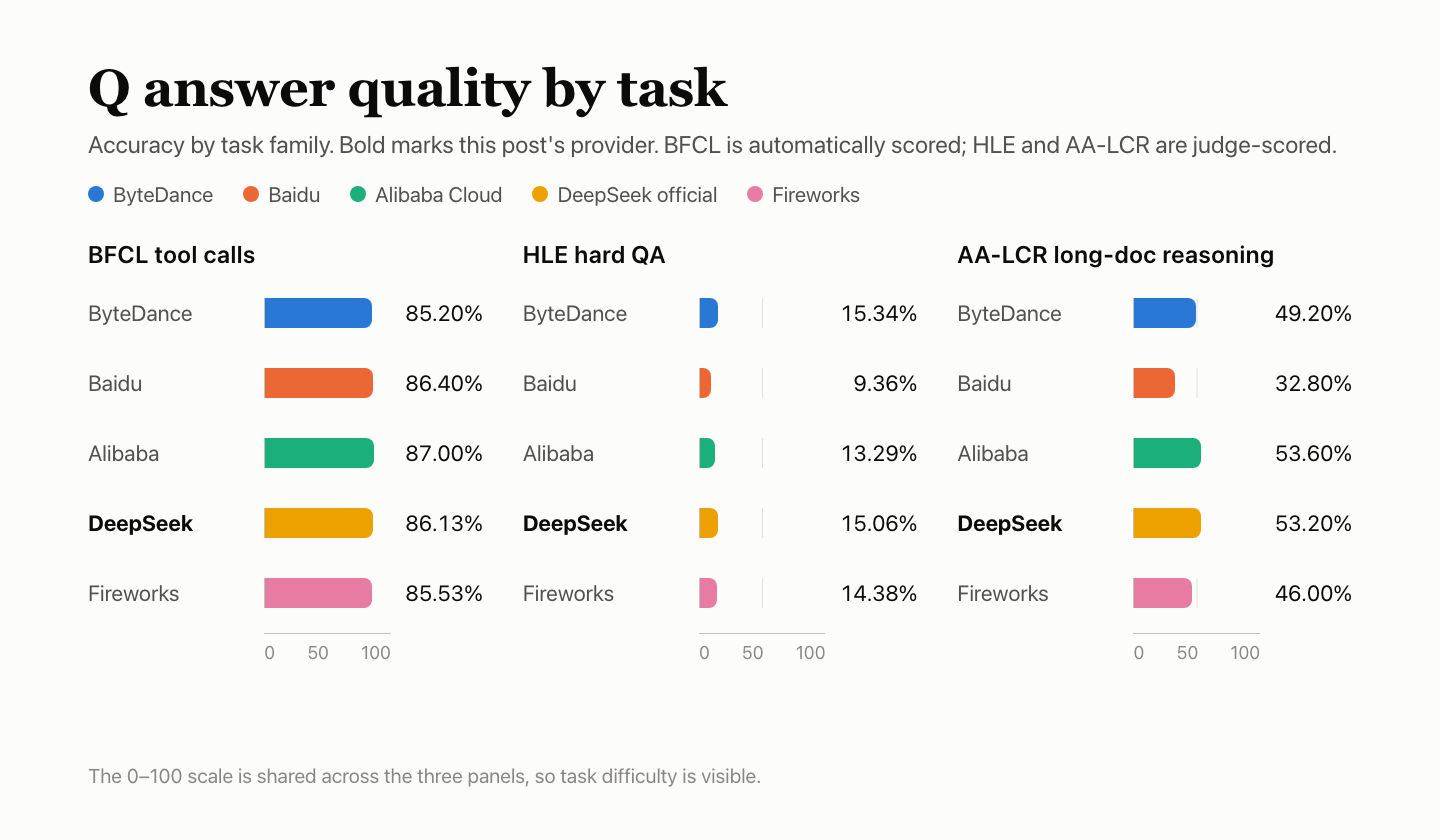
- Qualità delle risposte: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Sette output HLE sono stati troncati al limite max_tokens e conteggiati come errati. Questo canale costituisce la baseline Q per gli altri quattro.
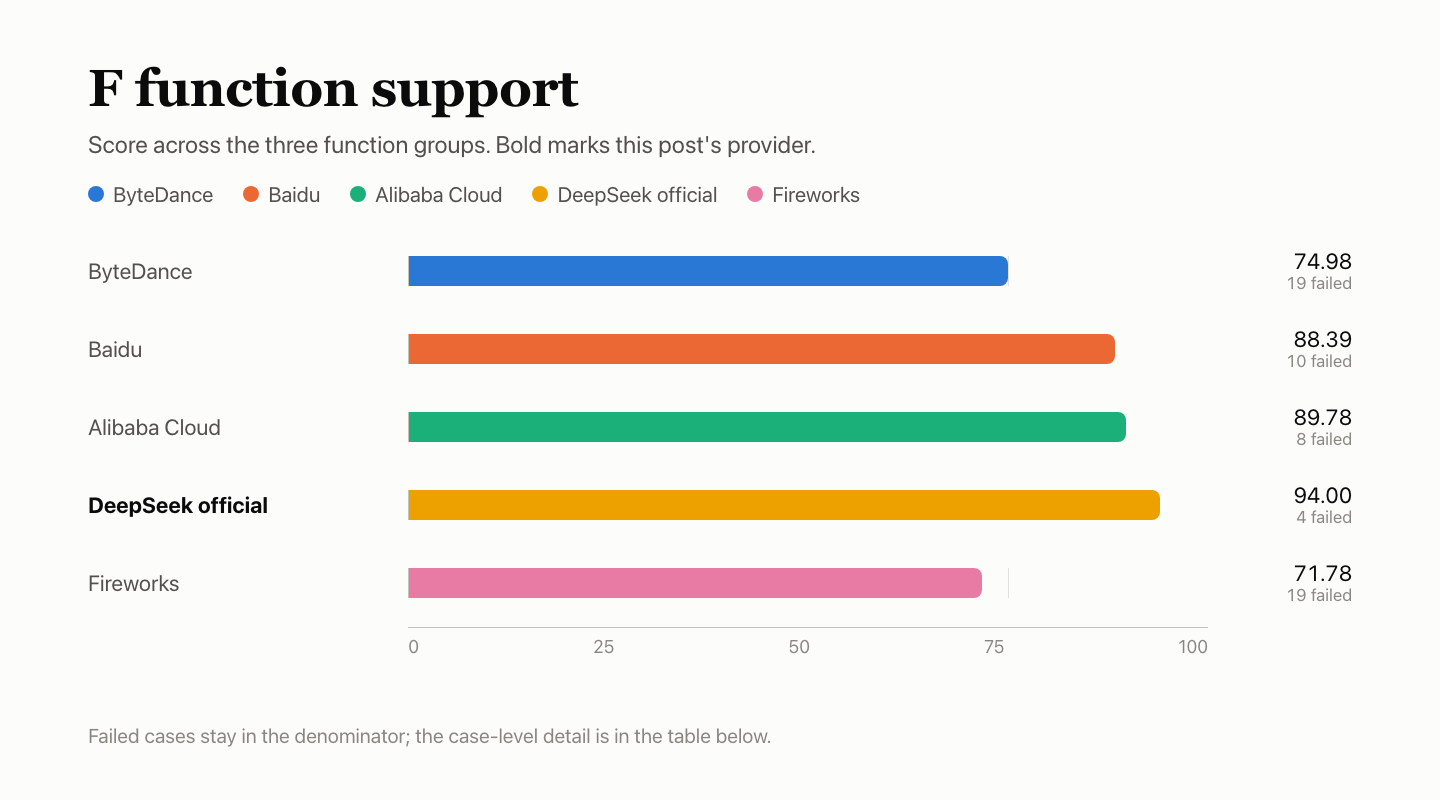
- Supporto alle funzioni: F 94.00. Superati 137 dei 147 controlli conteggiati. Altri 27 controlli dipendenti da conteggi esatti dei token sono stati dichiarati non validi ed esclusi dal denominatore.
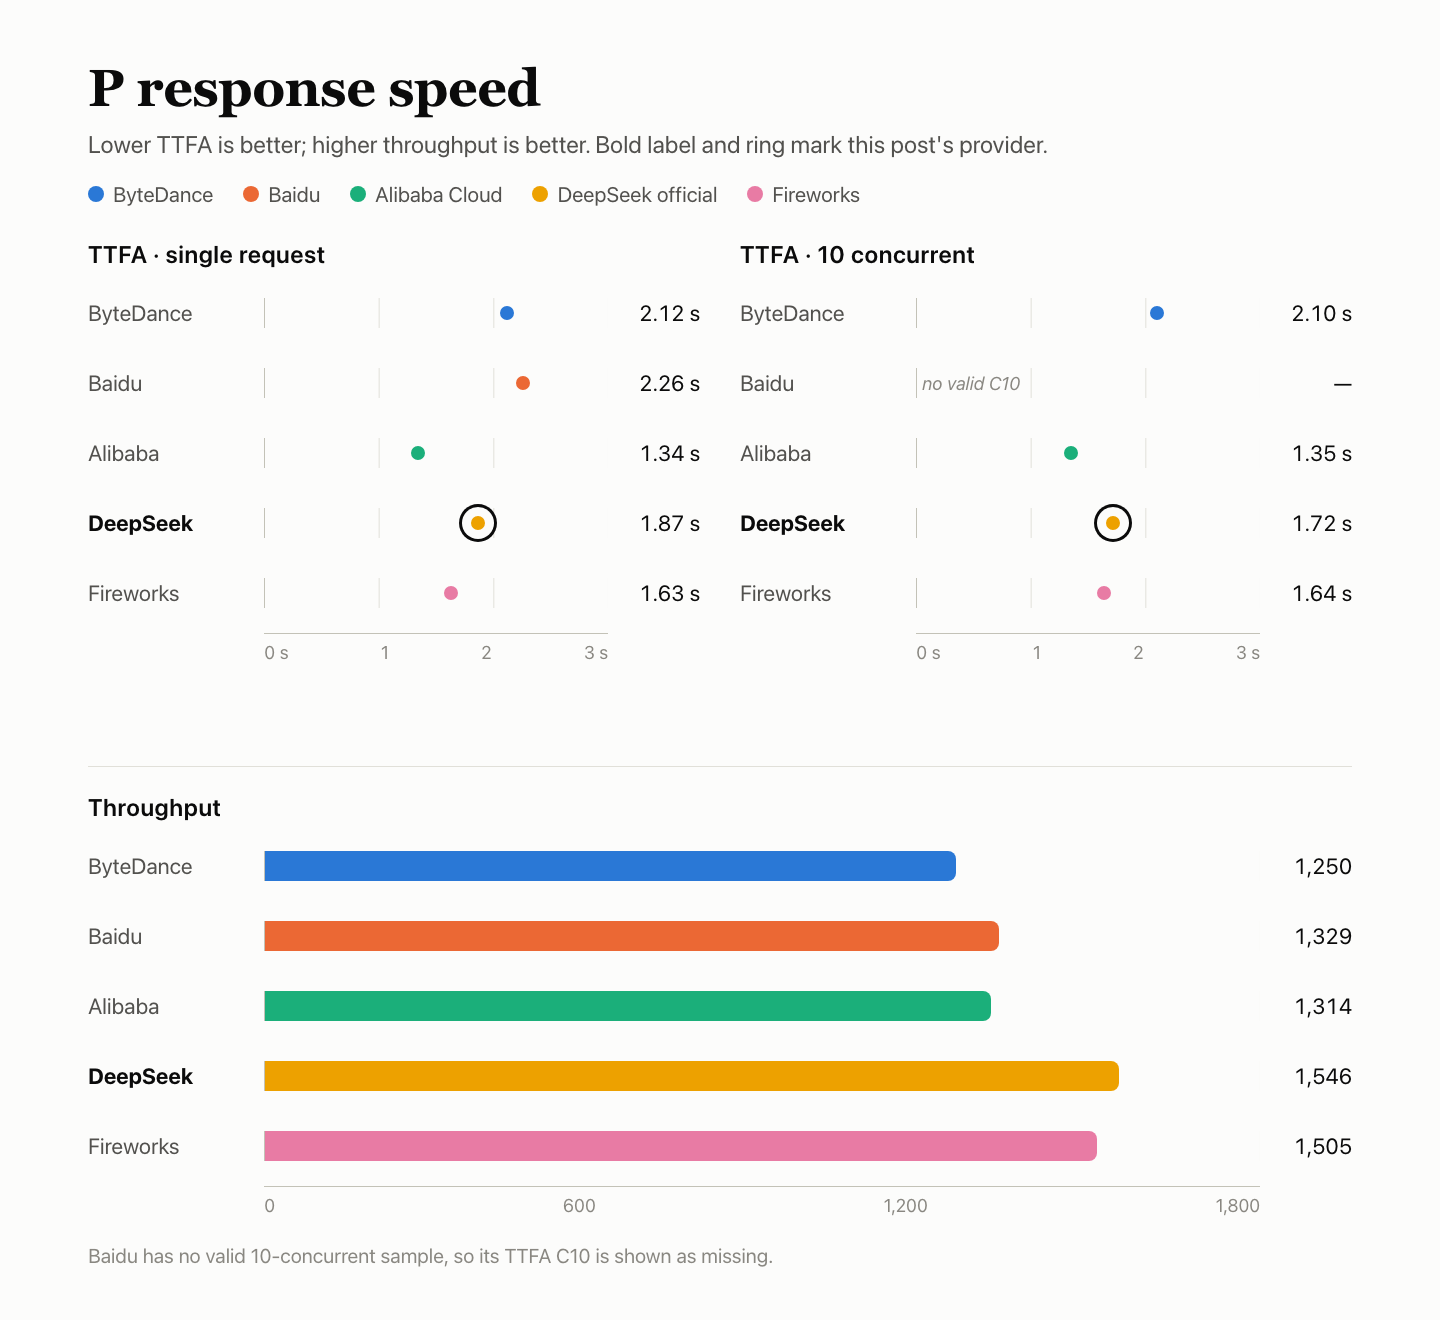
- Velocità di risposta: P 86.14. Nella prima finestra a concorrenza singola, 15 richieste non valide su 30 (12 × 503, 2 × deadline, 1 × read timeout), conteggiate come infinite; mediana del primo token 1.87 s (1.72 s considerando solo le richieste valide); 1.72 s a concorrenza 10; TPOT 2.84 ms.
- Cache: K 98.38. Tutte le 18 richieste hot con prefissi da 8k e 32k hanno avuto un cache hit; i controlli cold non hanno letto alcuna cache.
- Stabilità del servizio: R 100. Tutte le 300 richieste dedicate sono riuscite al primo tentativo.
Configurazione del test
Le richieste sono passate attraverso AIHubMix selezionando il percorso del fornitore ufficiale DeepSeek; la guida introduttiva spiega come configurare l'accesso.
| Voce | Dettaglio |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | deepseek-flash |
| Nome modello restituito | deepseek-flash |
| Percorso di accesso | Percorso del fornitore ufficiale DeepSeek di AIHubMix; non è una connessione diretta all'API di DeepSeek |
| Parametri | Modalità non-thinking, temperature 1.0, max_tokens 16,384, timeout 300 s, nessun nuovo tentativo automatico |
| Thinking disattivato | Tutte le richieste hanno usato reasoning_effort=none |
| Orario | 2026-11-03 18:07 – 11-04 16:33 UTC+8; i cinque fornitori hanno condiviso un Mac mini, la rete e l'account |
| Campioni | Qualità delle risposte: 4,250 tentativi (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); casi sulle funzioni 60 × 3 finestre; velocità 90 a concorrenza singola e 90 a concorrenza 10; stabilità 300; cache 30 (tre gruppi ciascuno con prefissi da 8k e 32k) |
Q — qualità delle risposte: 42.45
La suite combina BFCL 500 domande × 3 esecuzioni, HLE 250 × 10 e AA-LCR 25 × 10. BFCL viene valutato con regole automatiche; HLE e AA-LCR sono valutati dal modello giudice deepseek-flash. Tutti e cinque i fornitori hanno risposto alle stesse domande. Dieci risposte non sono state valutabili e sono state rimosse, lasciando 4,240 tentativi valutati.
| Benchmark | Domande | Corrette | Accuratezza | Errori |
|---|---|---|---|---|
| Chiamate agli strumenti BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| QA difficile HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Ragionamento su documenti lunghi AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Totale · IC 95% 40.08%–44.73% | 4,240 valutati | 1,800/4,240 | 42.45% | 7 |
Gli errori del servizio — una richiesta non riuscita o un output troncato — restano nel denominatore e vengono conteggiati come errati. In questo caso si tratta di sette output HLE che hanno raggiunto il limite max_tokens. BFCL è valutato automaticamente; HLE e AA-LCR sono valutati da un modello giudice.
I denominatori BFCL sono totali su tre esecuzioni.
| Categoria BFCL | Superati | Percentuale di superamento |
|---|---|---|
| simple_python — una funzione, chiamata e argomenti corretti | 334/360 | 92.78% |
| multiple — scegliere quella giusta tra diverse funzioni | 268/300 | 89.33% |
| parallel — chiamare la stessa funzione più volte in parallelo | 271/300 | 90.33% |
| parallel_multiple — chiamare più funzioni diverse in parallelo | 207/240 | 86.25% |
| irrelevance — nessuna funzione pertinente, non va chiamata alcuna funzione | 113/150 | 75.33% |
| ahm_multi_turn — catena di strumenti in tre fasi | 99/150 | 66.00% |
Confronto con gli altri quattro
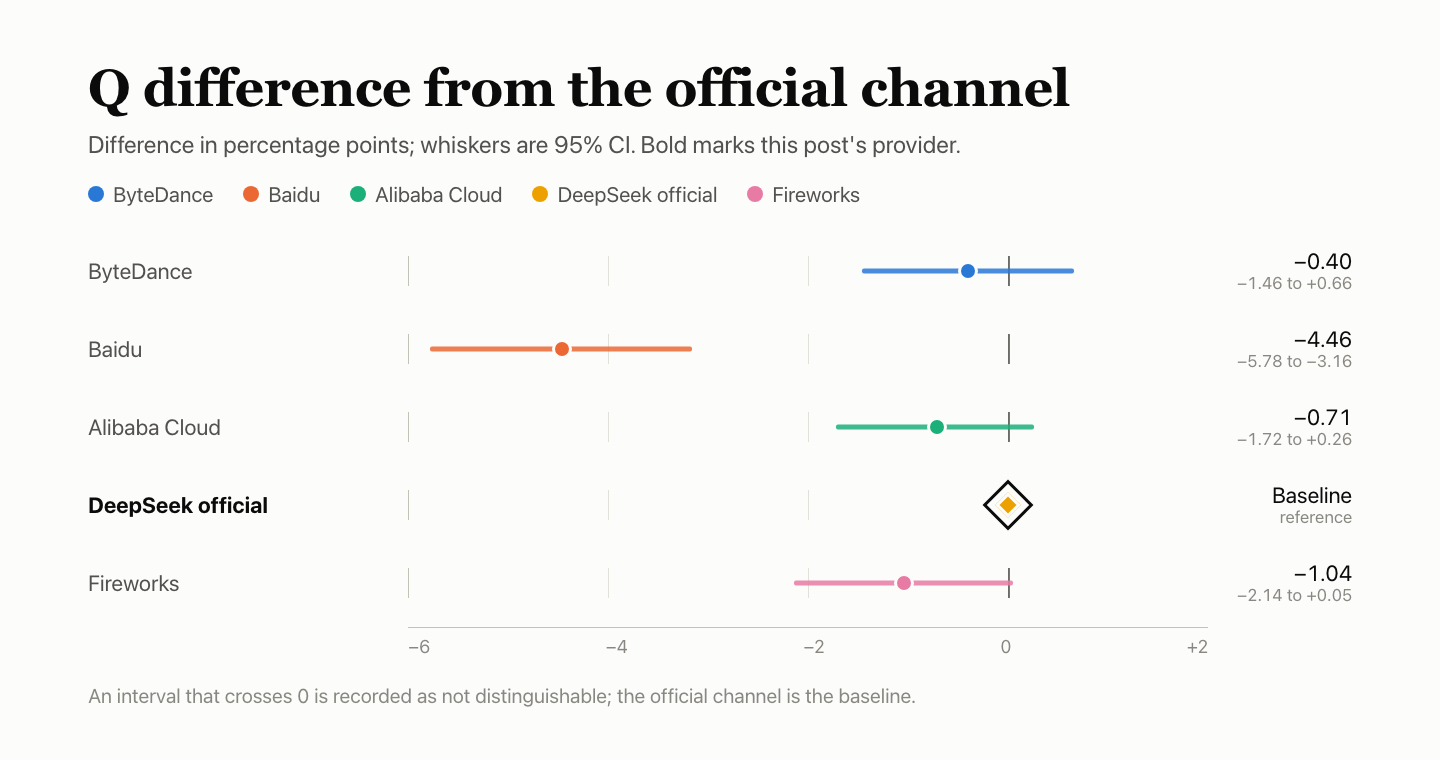
Ogni differenza è espressa in punti percentuali rispetto a questa baseline, con un intervallo di confidenza del 95% mostrato dalle barre; un intervallo che attraversa 0 indica che i risultati non sono distinguibili. Il giudice appartiene alla stessa famiglia DeepSeek del modello testato e non è stato calibrato, quindi la valutazione HLE e AA-LCR potrebbe essere permissiva.
F — supporto alle funzioni: 94.00
I casi sulle funzioni verificano il comportamento del protocollo, non la qualità delle risposte. Sessanta casi in sei gruppi sono stati eseguiti in ciascuna delle tre finestre — 180 controlli — e valutati rispetto al formato specificato nella documentazione di ciascun fornitore. I controlli non applicabili, non validi e non osservati sono esclusi dal denominatore. Questo canale ha superato 137 dei 147 controlli conteggiati, per un punteggio ponderato di 94.00; il punteggio ponderato non è un semplice 137/147.
| Gruppo | Peso | Superati | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Protocollo di streaming e messaggi | 20% | 27/27 | 3 | 100.00 |
| Interfaccia degli strumenti | 20% | 30/30 | — | 100.00 |
| Vincoli di output e parametri | 20% | 30/30 | — | 100.00 |
| Contesto e stato | 15% | 14/15 | 15 | 93.33 |
| Errori e recupero | 15% | 24/30 | — | 80.00 |
| Protocollo di fatturazione e cache | 10% | 12/15 | 15 | 80.00 |
| Totale · ponderato | — | 137/147 | 33 | 94.00 |
Il punteggio ponderato segue i pesi dei gruppi; non equivale ai controlli superati divisi per 147.
| Caso non superato | Finestre non superate | Motivo |
|---|---|---|
| Messaggi malformati (Errori e recupero) | 3/3 | Restituito 400, ma il corpo era vuoto, senza una descrizione strutturata dell'errore |
| stream_options malformato (Errori e recupero) | 3/3 | Restituito 400, ma il corpo era vuoto, senza una descrizione strutturata dell'errore |
| Contabilizzazione dei token di thinking (Protocollo di fatturazione e cache) | 3/3 | Nessun conteggio dei token di thinking restituito |
| Isolamento delle richieste (Contesto e stato) | 1/3 | Il primo passaggio non ha risposto solo con STORED, come richiesto, quindi non è stato possibile procedere con il controllo dell'isolamento |
I controlli esclusi non vengono conteggiati né come superati né come non superati.
| Stato | Caso | Conteggio | Motivo |
|---|---|---|---|
| Non osservato | Sequenza di arresto dello streaming | 3 | Dopo il passaggio precedente, la richiesta di questo passaggio non è stata inviata, quindi non è stato possibile valutarla |
| Non valido | Input lungo da 10k; entro il limite di contesto; input lungo da 32k; input lungo da 100k; oltre il limite di contesto; conteggio input nativo; definizioni degli strumenti conteggiate nell'input; conteggio input coerente prima e dopo la cache; input coerente tra streaming e modalità non streaming | 27 | Il template di conteggio nativo fissato lato test non corrispondeva ai dati di utilizzo riportati da questo canale, quindi i controlli che dipendevano da conteggi esatti sono stati dichiarati non validi ed esclusi dal denominatore |
| Non applicabile | cache_control esplicito | 3 | Registrato in anticipo come non supportato da questa interfaccia |
I 27 controlli non validi sono i casi relativi a input lunghi, limite di contesto, conteggio nativo e coerenza della cache presenti nell'elenco. Poiché il template fissato non corrispondeva ai dati di utilizzo riportati da questo canale, tutti i controlli dipendenti da un conteggio esatto sono stati esclusi anziché valutati.
Due casi sono falliti su tutti e cinque i fornitori: messages e stream_options malformati. Entrambi hanno restituito un 400 con il corpo vuoto, quindi il client non ha ricevuto alcuna descrizione strutturata dell'errore. Questo schema condiviso fa pensare più al livello del gateway di AIHubMix, che richiede un'indagine separata. Anche la contabilizzazione dei token di thinking è fallita su tutti e cinque, ma per ragioni diverse: ByteDance e Fireworks hanno continuato a riportare i token di thinking anche dopo aver disattivato il thinking, mentre gli altri tre non hanno restituito alcun conteggio dei token di thinking.
Confronto con gli altri quattro
P — velocità di risposta: 86.14
Ogni richiesta conteneva circa 10,000 token di input e chiedeva circa 1,100 token di output. In ciascuna delle tre finestre sono state inviate 30 richieste a concorrenza singola e 30 a concorrenza 10, per un totale di 180.
| Metrica | Valore |
|---|---|
| TTFA del primo token | Concorrenza singola: mediana 1.87 s (mediana delle richieste valide 1.72 s). Concorrenza 10: mediana 1.72 s |
| TPOT | Concorrenza singola: 2.84 ms/token. Concorrenza 10: 2.67 ms/token |
| Throughput valido (goodput) | Concorrenza 10: 1,546.0 token/s |
| Richieste valide | Concorrenza singola 75/90 (finestra 1: 15/30); concorrenza 10: 90/90. Non valide: 12 × 503 service_unavailable_error, 2 × deadline reached, 1 × read timeout |
| Punteggi delle componenti | TTFA 51.65, TPOT 100.00, throughput 100.00; TTFA e TPOT prendono il valore più basso dei due livelli, ponderati rispettivamente al 35% / 35% / 30%; punteggio di risposta 83.08 |
| Composizione di P | Punteggio di risposta 83.08 con peso dell'80%, cache K 98.38 con peso del 20%; P 86.14 |
Le 15 richieste non valide si sono verificate tutte nella prima finestra a concorrenza singola: 12 hanno restituito 503, 2 hanno raggiunto il deadline e 1 ha avuto un read timeout. Le richieste non valide vengono conteggiate come infinite, quindi la mediana riportata è 1.87 s. Considerando solo le richieste valide, la mediana è 1.72 s. A concorrenza 10, la mediana è anch'essa 1.72 s. Il TPOT è di 2.84 ms/token a concorrenza singola e di 2.67 ms/token a concorrenza 10.
Confronto con gli altri quattro
I cinque fornitori hanno condiviso un Mac mini, la rete e l'account. Le tre finestre sono state programmate un fornitore alla volta, quindi i periodi di raccolta non si sovrappongono del tutto; è meglio non attribuire troppo significato alle piccole differenze.
K — cache: 98.38
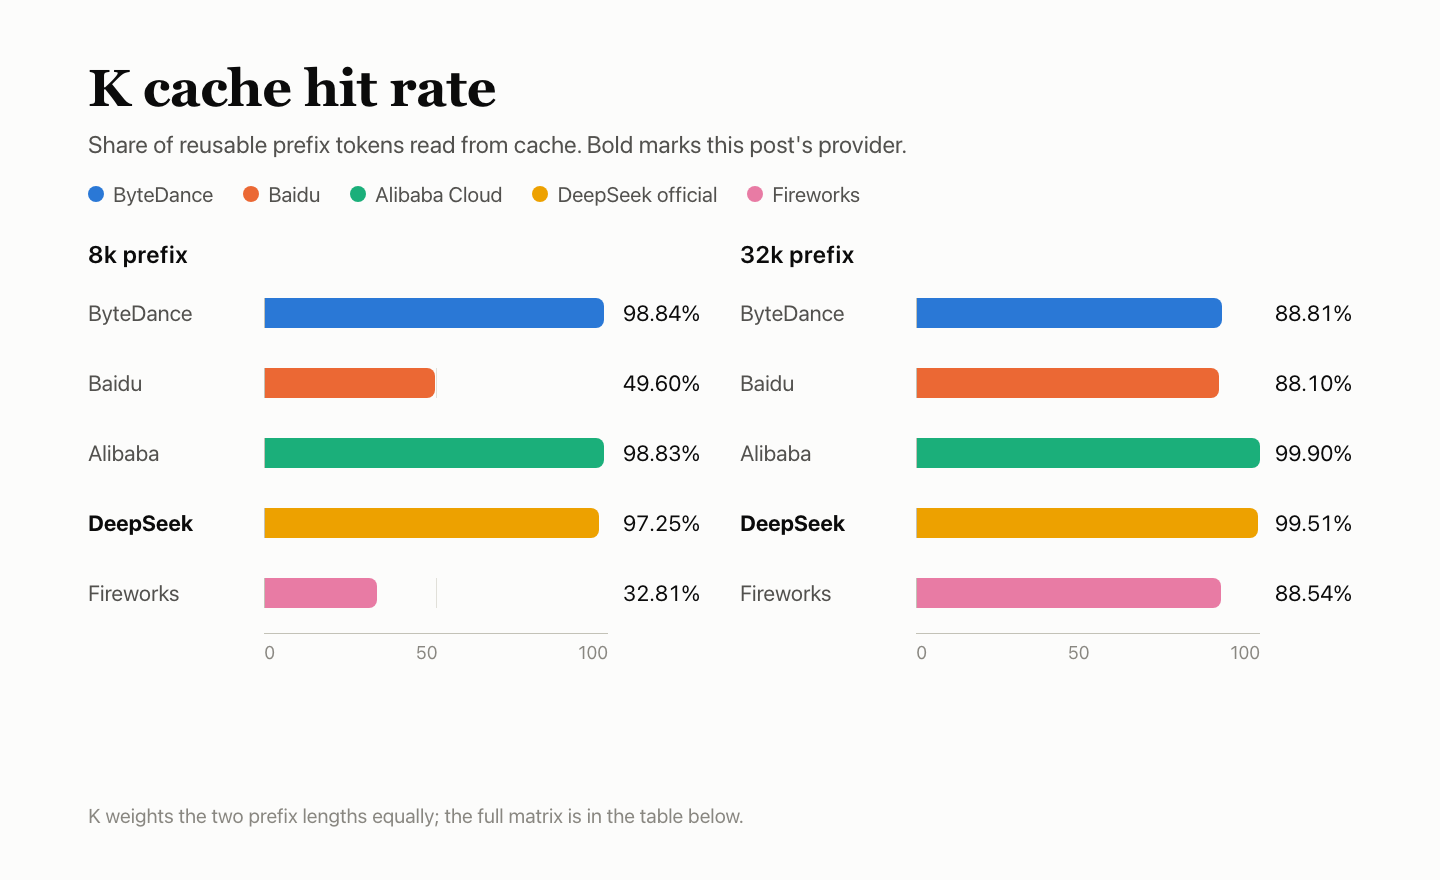
Ogni gruppo invia cinque richieste. La prima inizializza un prefisso fisso da 8k o 32k. Le richieste dalla seconda alla quarta mantengono il prefisso e modificano solo la domanda finale, dopo 5, 30 e 120 secondi. La quinta usa un nuovo prefisso come controllo cold. Tre finestre × due lunghezze danno 30 richieste. K divide i token letti dalla cache nelle richieste hot per il numero di token che dovrebbero essere riutilizzabili, attribuendo a ciascuna lunghezza un peso del 50%; K rappresenta il 20% di P. La documentazione API di DeepSeek spiega la cache del contesto.
| Prefisso | Finestra | Inizializzazione | +5 s | +30 s | +120 s | Controllo cold |
|---|---|---|---|---|---|---|
| 8k | Finestra 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Finestra 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Finestra 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Finestra 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Finestra 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Finestra 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Le richieste hot da 8k hanno avuto un cache hit in 9 casi su 9 e hanno letto 7,808 token ciascuna: 70,272 letti su 72,261 riutilizzabili, 97.25. Le richieste hot da 32k hanno avuto un cache hit in 9 casi su 9 e hanno letto 31,872 token ciascuna: 286,848 su 288,270, 99.51. I controlli cold non hanno letto alcuna cache. K è 98.38 considerando entrambe le lunghezze.
Confronto con gli altri quattro
R — stabilità del servizio: 100
Le 300 richieste coprono testo breve, input lungo da 10k, chiamate agli strumenti e cronologia multi-turno, inviate a concorrenza singola nel corso di tre finestre. Si verificano solo la validità e la completezza al primo tentativo — non la correttezza delle risposte — e non si effettuano nuovi tentativi. Gli errori di qualità delle risposte e di velocità sono conteggiati in Q e P, non di nuovo in R.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo da 10k | 90/90 |
| Chiamate agli strumenti | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · IC 95% 98.78%–100% | 300/300 |
Tutte le 300 richieste hanno restituito una risposta valida e completa al primo tentativo. R 100 riguarda solo queste 300 richieste dedicate; non significa che l'intero percorso non abbia avuto errori. Con 300 successi, il limite inferiore dell'intervallo al 95% è 98.78%, quindi i dati indicano che il tasso di errore è probabilmente inferiore a 1.22%.
Confronto con gli altri quattro
R riguarda solo le 300 richieste dedicate; gli errori nella qualità delle risposte e nella velocità sono registrati in Q e P, senza essere conteggiati di nuovo in R.
| Fornitore | Successi al primo tentativo | IC al 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek ufficiale | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Si tratta di una connessione diretta all'API di DeepSeek?
No. Le richieste passano attraverso il percorso del fornitore ufficiale DeepSeek di AIHubMix; non vengono inviate direttamente all'API di DeepSeek.
Perché il canale ufficiale DeepSeek è la baseline Q?
È il canale ufficiale di DeepSeek per lo stesso modello, quindi i risultati sulla qualità delle risposte degli altri quattro fornitori sono espressi come differenze rispetto a esso. Il ruolo di baseline non implica una classifica della qualità delle risposte.
Che cosa è successo nella prima finestra di test della velocità con concorrenza singola?
Quindici delle 30 richieste non erano valide: 12 hanno restituito 503, 2 hanno raggiunto la scadenza e 1 ha superato il timeout di lettura. Vengono conteggiate come infinito, quindi la mediana è 1.87 s; considerando solo le richieste valide, è 1.72 s.
Che cosa sono i 27 controlli di funzione non validi?
Dipendono dal conteggio esatto dei token: input lunghi, limiti della finestra di contesto, conteggi nativi dell'input e coerenza dell'input della cache. Il modello di conteggio nativo fissato sul lato del test non corrispondeva all'utilizzo riportato da questo canale, quindi i controlli sono stati esclusi dal denominatore invece di essere valutati come errori.
Perché R 100 non garantisce che il percorso sia privo di errori?
R riguarda solo le 300 richieste dedicate alla stabilità. Gli errori durante le prove sulla qualità delle risposte e sulla velocità sono registrati in Q e P. Con 300 successi su 300, il limite inferiore dell'intervallo al 95% è 98.78%, quindi il tasso di errore è probabilmente inferiore a 1.22%, ma non è dimostrato che sia zero.
In che modo il test della cache distingue le letture a caldo da quelle a freddo?
Ogni gruppo inizializza un prefisso di 8k o 32k, lo ripete dopo 5, 30 e 120 secondi con una nuova domanda finale, quindi invia un nuovo prefisso come controllo a freddo. Entrambe le lunghezze hanno registrato 9 hit su 9 richieste a caldo e ogni lettura di controllo a freddo ha restituito zero token memorizzati nella cache.
Continua a leggere: la serie DeepSeek V4.1 Flash
- Il valore Q di ByteDance è inferiore di appena 0.40 punti rispetto a questa baseline, mentre i risultati del supporto alle funzioni e della cache sono diversi: DeepSeek V4.1 Flash su ByteDance: le chiamate agli strumenti coincidono, la misurazione no.
- Baidu ha perso richieste a causa di
no_available_channel, un problema che compare sia in Q che in P: DeepSeek V4.1 Flash su Baidu: il canale non disponibile colpisce Q e P. - Il risultato complessivo di Alibaba Cloud differisce di 0.37 e non è distinguibile: DeepSeek V4.1 Flash su Alibaba Cloud: primo token in 1.34s, cache al 99.37.
- Fireworks ha registrato 3 hit su 9 nelle richieste a caldo da 8k, rispetto a 9 su 9 qui: DeepSeek V4.1 Flash su Fireworks: risposte stop vuote, 3/9 cache hit.


