

Il 2026-11-03/04, DeepSeek V4.1 Flash 1017 è stato testato con la suite APB Full su cinque provider, tutti raggiunti tramite AIHubMix con le stesse domande, gli stessi parametri e gli stessi script di richiesta. Questo APB Profile riguarda solo Fireworks. Il modello è indicato come DeepSeek V4.1 Flash 1017.
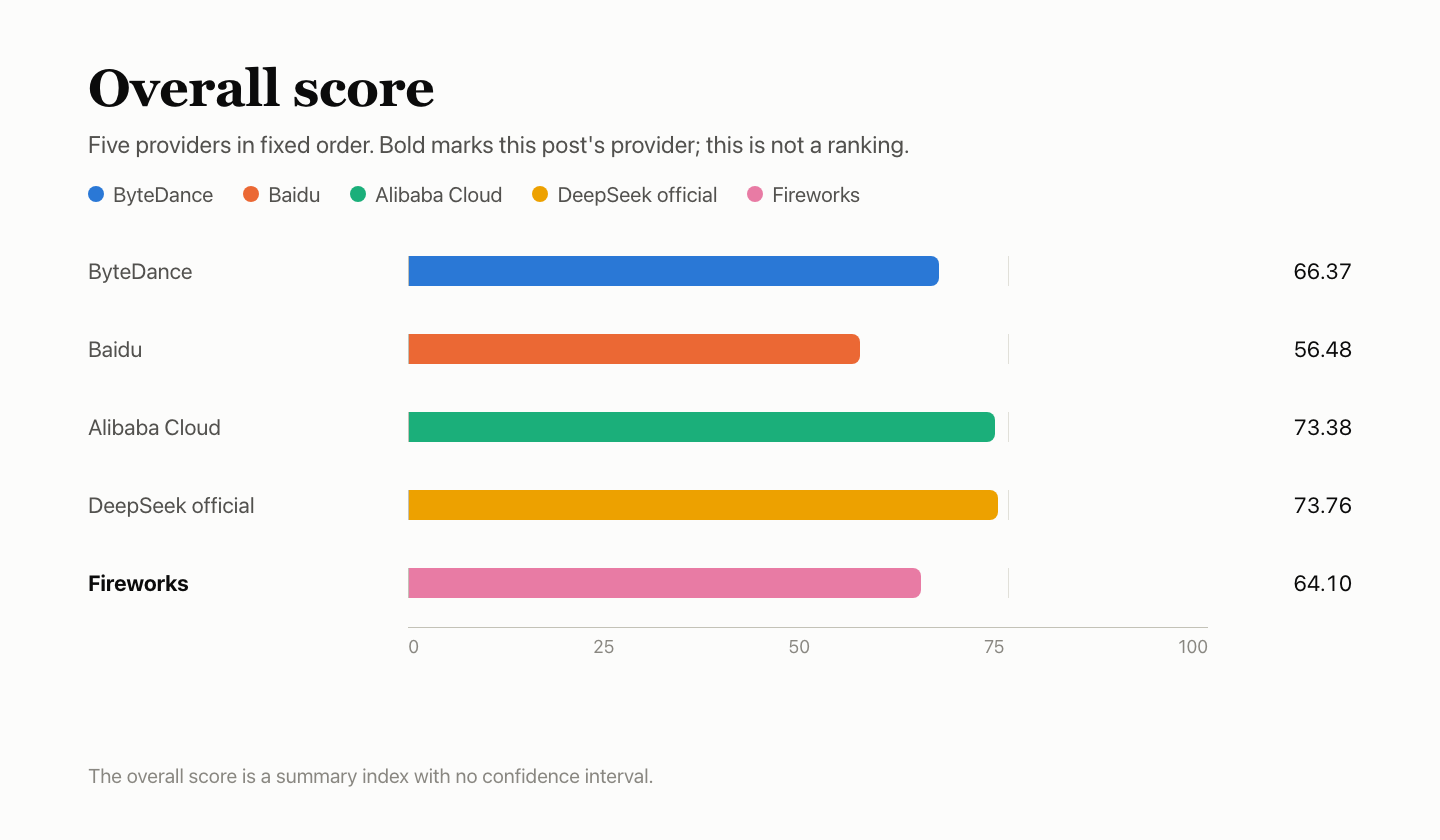
I punteggi sono Q 41.42, F 71.78, P 79.51, K 60.68 e R 100; l'indice complessivo è 64.10. Questo articolo riporta solo i punteggi, senza classifiche né raccomandazioni sui provider. Q, F, P, K e R vengono per primi; l'indice complessivo è un numero riepilogativo senza intervallo di confidenza. Lo standard è AIHubMix Provider Benchmark Standard v2.0.
Punteggi dei cinque provider
Il grassetto indica il provider di questo articolo. Ordine dei provider fisso, non una classifica. K è un sottopunteggio di P che vale il 20%. L'indice complessivo è un numero riepilogativo senza intervallo di confidenza. Il canale ufficiale DeepSeek e Alibaba Cloud differiscono di 0.37 e non sono distinguibili.
In breve
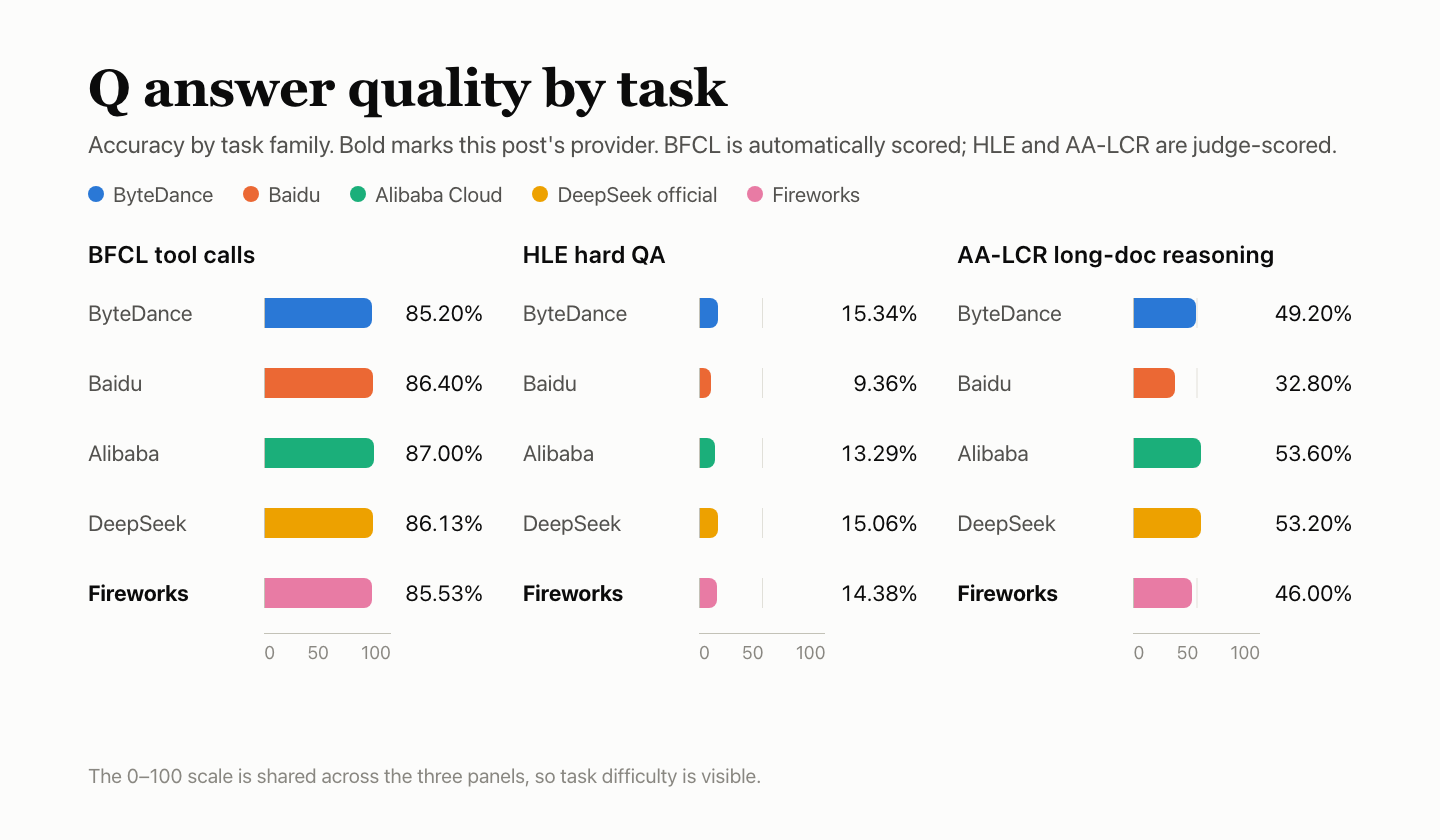
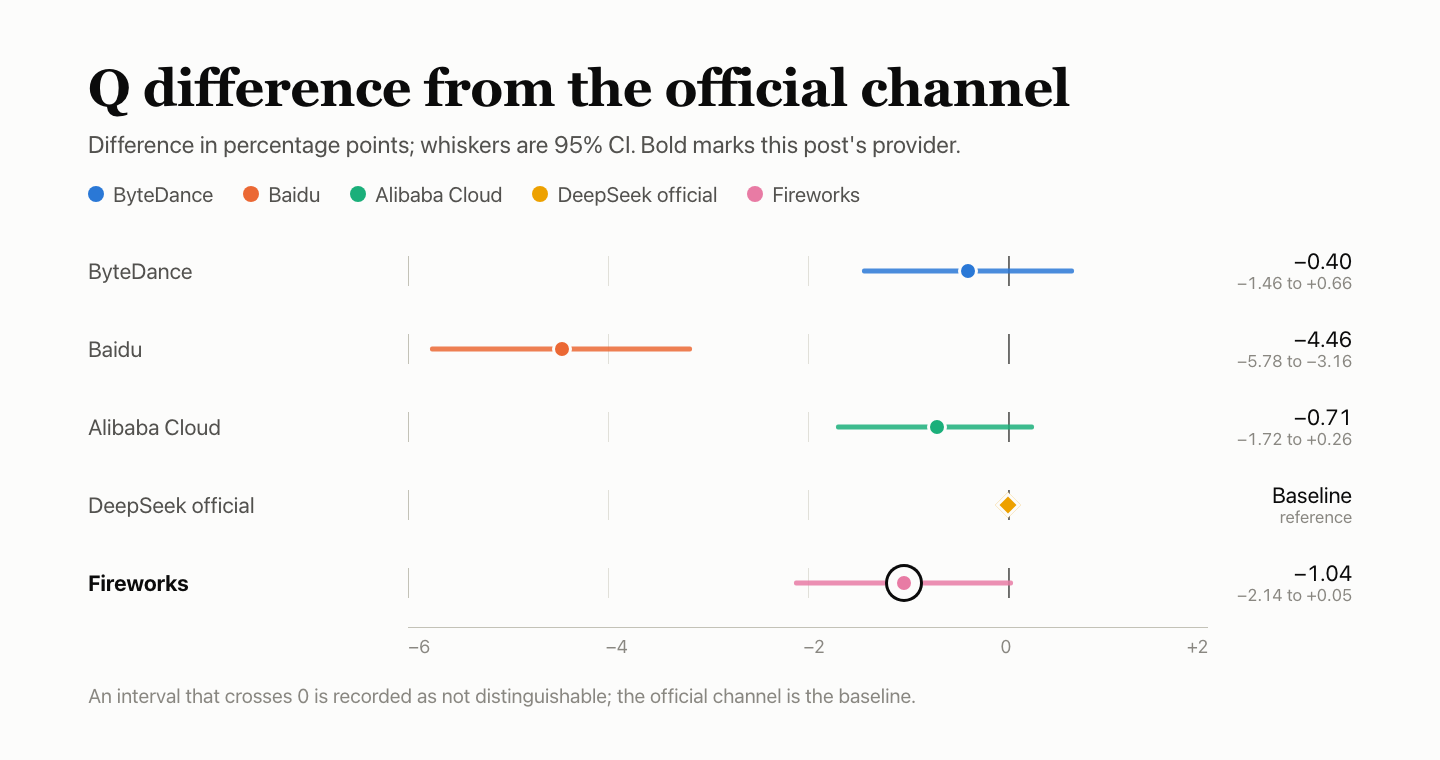
- Q — qualità delle risposte: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. Rispetto al canale ufficiale: −1.04 punti percentuali, IC al 95% da −2.14 a +0.05, differenza non distinguibile. Tutti e 34 gli errori AA-LCR erano nella finestra 2 e sono stati conteggiati come risposte errate.
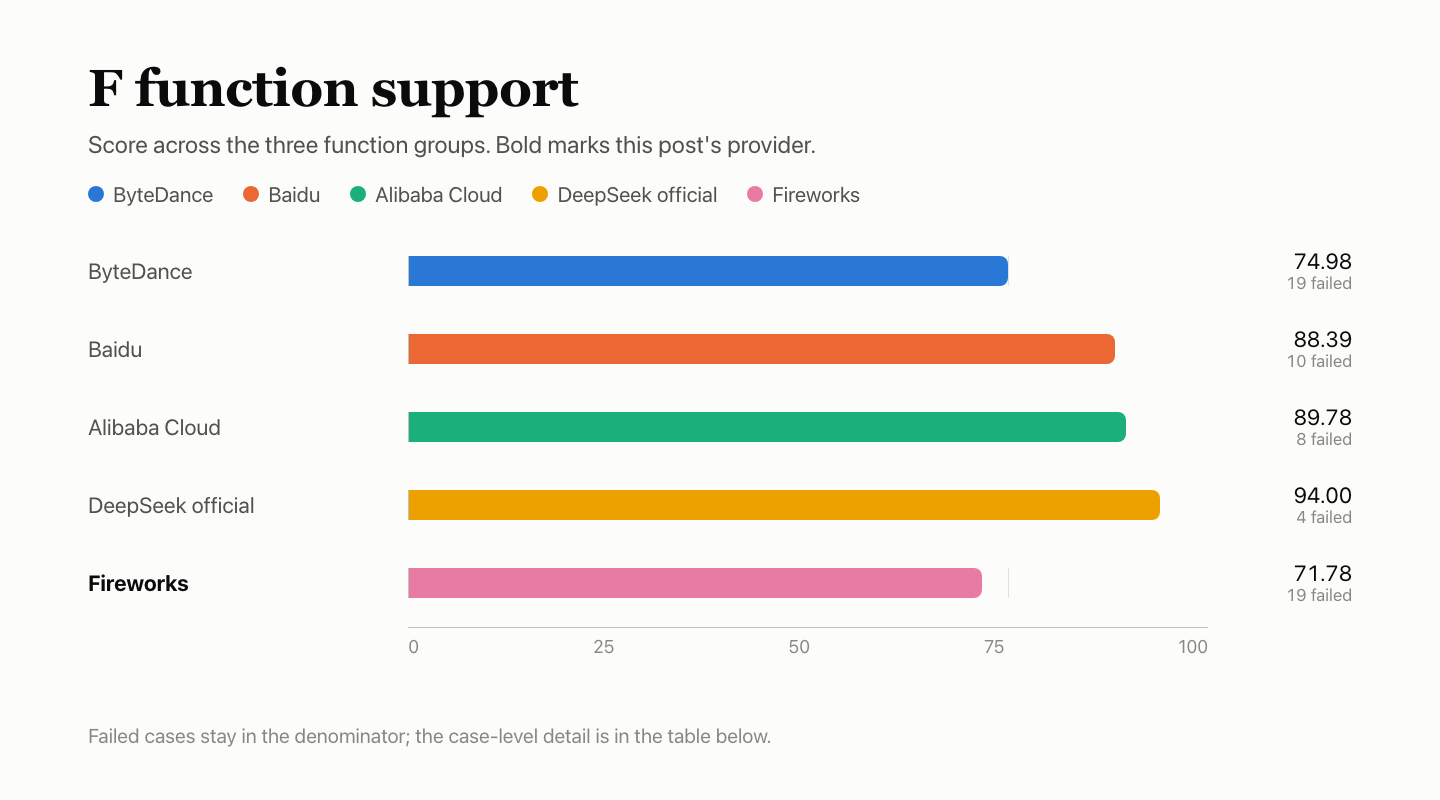
- F — supporto delle funzioni: 71.78. Superati 122/177 controlli conteggiati. Entrambi i casi con stop hanno restituito un corpo vuoto;
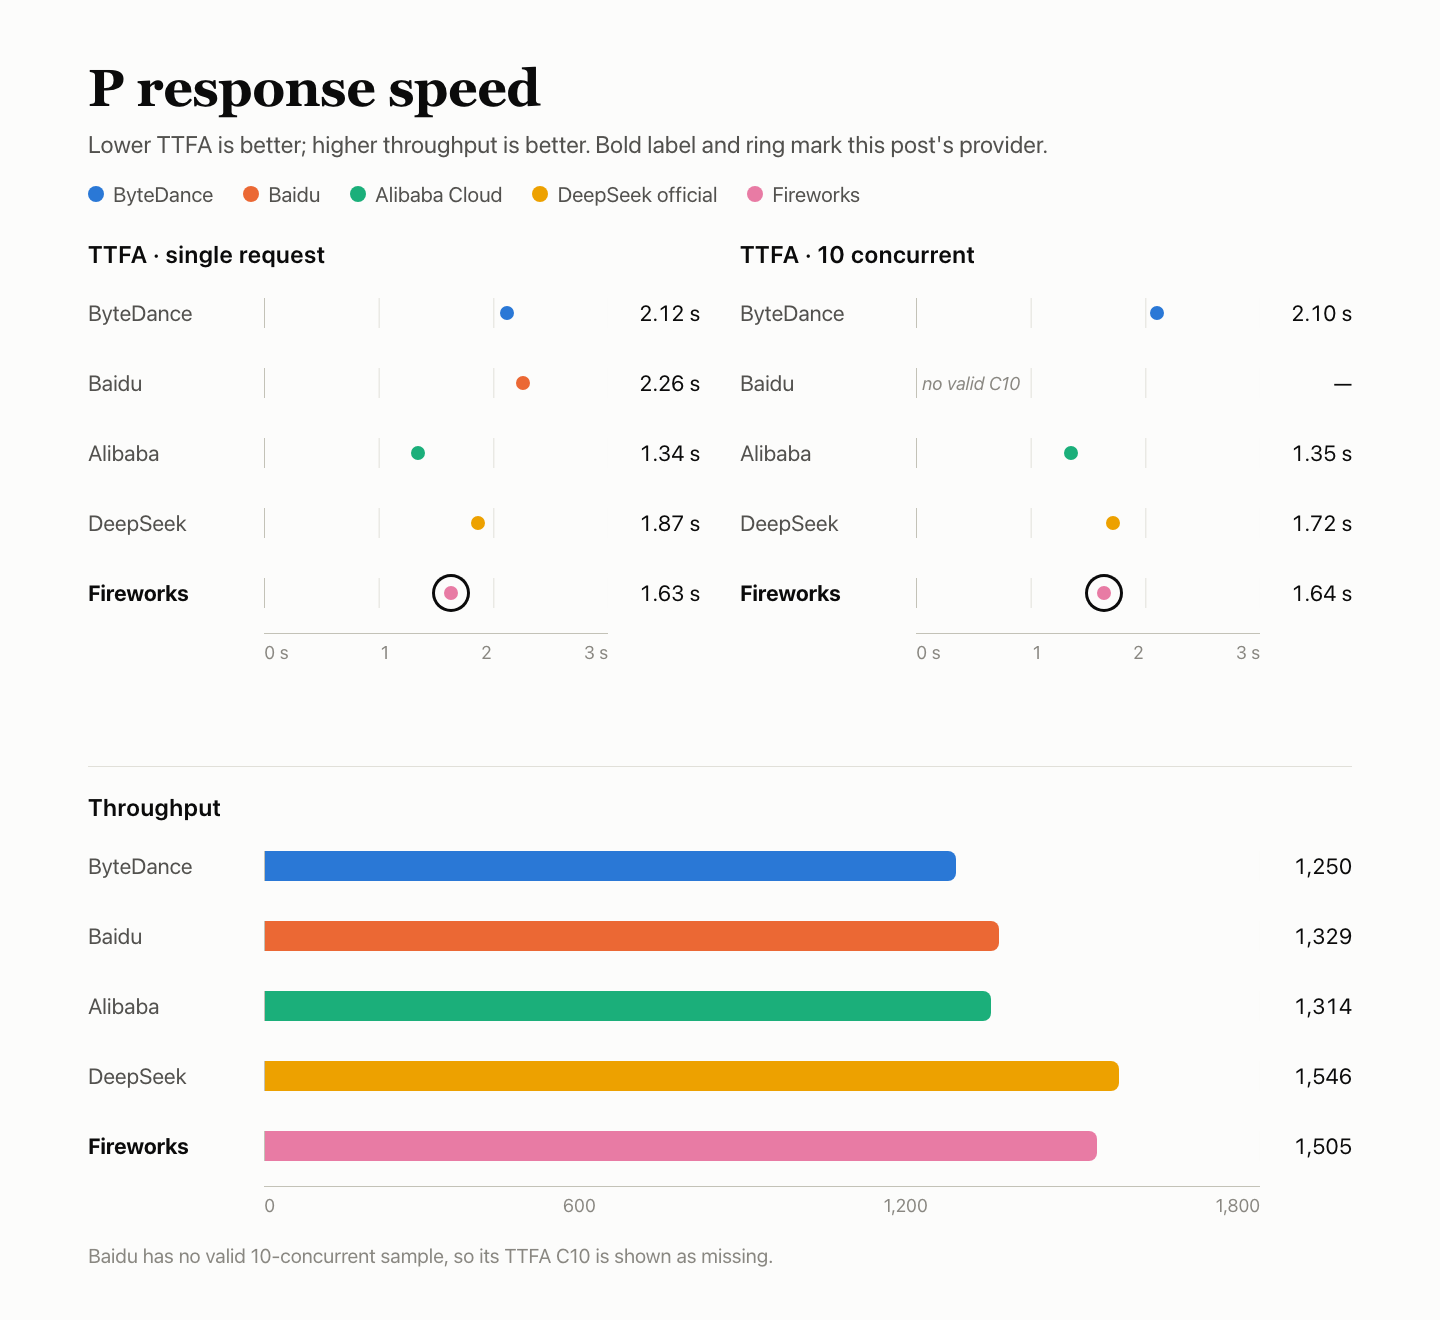
reasoning_effort=nonenon ha disattivato il thinking; un input da 10k è stato conteggiato come 10,026 token, contro un conteggio nativo di 10,000. - P — velocità di risposta: 79.51. Punteggio di risposta 84.22, cache K al 20%. TTFA mediana 1.63 s con concorrenza singola, 1.64 s con 10 richieste concorrenti; TPOT 3.29 ms. 1 dei 180 output era composto da un solo token ed è stato contrassegnato come non valido.
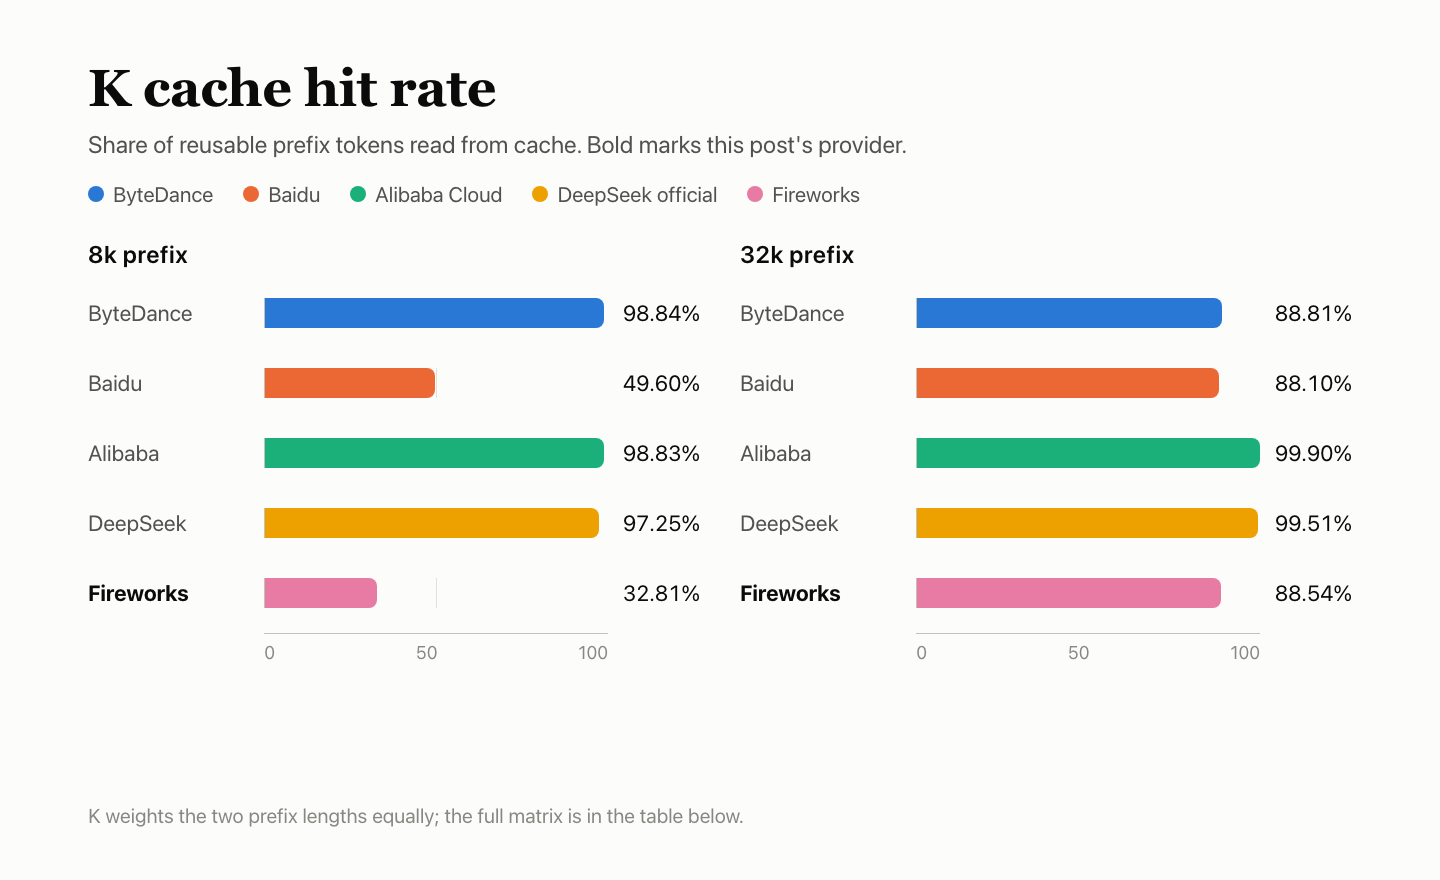
- K — cache: 60.68. Le probe K hanno usato l'affinità di sessione documentata. Cache calda 32k: 8/9; cache calda 8k: 3/9.
- R — stabilità del servizio: 100. 300/300 richieste dedicate sono riuscite al primo tentativo.
Configurazione del test
| Voce | Impostazione |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | fireworks-deepseek-v4.1-flash-1017 |
| Nome modello restituito | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Percorso di accesso | ID modello del provider AIHubMix, non l'account del provider |
| Parametri | Thinking disattivato, temperature 1.0, max_tokens 16,384, timeout 300 s, nessun nuovo tentativo |
| Thinking disattivato | Impostazione nativa thinking.type=disabled; reasoning_effort=none non disattiva il thinking. I casi con funzioni hanno mantenuto reasoning_effort=none. |
| Orario | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Un Mac mini, la stessa rete e lo stesso account per tutti e cinque. |
| Campioni | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Impostazioni aggiuntive | Le probe K includevano il campo user documentato e l'header x-session-affinity per l'affinità con la replica. |
Le richieste hanno usato la guida rapida di AIHubMix; gli ID modello sono disponibili nella pagina dei modelli. Per disattivare il thinking è stato usato il parametro nativo thinking.type=disabled della documentazione API del modello.
Q — qualità delle risposte: 41.42
La suite ha eseguito 500 domande BFCL × 3 round, 250 HLE × 10 e 25 AA-LCR × 10. BFCL è stato valutato automaticamente; HLE e AA-LCR sono stati valutati da deepseek-flash. Tutti e cinque hanno ricevuto le stesse domande. Dieci risposte non valutabili sono state rimosse, lasciando 4,240 istanze valutate.
| Attività | Domande | Corrette | Accuratezza | Errori |
|---|---|---|---|---|
| Chiamate agli strumenti BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Domande e risposte difficili HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Ragionamento su documenti lunghi AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Totale · IC al 95% 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Gli errori restano nel denominatore e sono conteggiati come risposte errate: 2 BFCL (finestre 2 e 3), 5 HLE troncate al limite max_tokens, 34 AA-LCR, tutte nella finestra 2.
| Categoria BFCL | Superati | Tasso di superamento |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python ha superato 333/360 (92.50%), parallel 270/300 (90.00%), ahm_multi_turn 95/150 (63.33%) e irrelevance 111/150 (74.00%).
Confronto con gli altri quattro
Differenza in punti percentuali rispetto al canale ufficiale; l'intervallo al 95% è indicato dalle barre. Se attraversa lo 0, la differenza non è distinguibile. Il valutatore deepseek-flash appartiene alla stessa famiglia e non è calibrato, quindi potrebbe essere indulgente.
F — supporto delle funzioni: 71.78
I 60 casi sono suddivisi in sei gruppi, ciascuno eseguito in tre finestre: 180 controlli valutati rispetto al formato documentato dal provider. I controlli non applicabili, non validi e non osservati sono esclusi dal denominatore. Sono stati superati 122 dei 177 controlli conteggiati; la ponderazione dei gruppi dà 71.78.
| Gruppo di casi | Peso | Superati | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Streaming e messaggistica | 20% | 24/30 | — | 80.00 |
| Interfaccia degli strumenti | 20% | 29/30 | — | 96.67 |
| Vincoli sull'output | 20% | 21/30 | — | 70.00 |
| Contesto e stato | 15% | 15/30 | — | 50.00 |
| Errori e ripristino | 15% | 21/30 | — | 70.00 |
| Conteggio e cache | 10% | 12/27 | 3 | 44.44 |
| Totale · ponderato | — | 122/177 | 3 | 71.78 |
"Finestre non superate" conta le tre finestre in cui il caso non è stato superato.
| Caso non superato | Finestre non superate | Motivo |
|---|---|---|
| Stop durante lo streaming | 3/3 | Corpo vuoto con stop; senza stop funziona. |
| Ragionamento nel corpo | 3/3 | reasoning_effort=none ha comunque restituito il ragionamento. |
| Sequenza di stop | 3/3 | Corpo vuoto con stop; senza stop funziona. |
| Impostazione del thinking | 3/3 | reasoning_effort=none ha comunque restituito il ragionamento. |
| Diversità del campionamento | 3/3 | Temp 0/1 troppo simili |
| Input lungo da 10k | 3/3 | Conteggio riportato: 10,026; nativo: 10,000. |
| Entro il limite di contesto | 3/3 | Conteggio riportato: 10,026; nativo: 10,000. |
| Input lungo da 32k | 3/3 | Conteggio riportato: 10,026; nativo: 10,000. |
| Input lungo da 100k | 3/3 | Conteggio riportato: 10,026; nativo: 10,000. |
| Oltre il contesto | 3/3 | Avrebbe dovuto essere un errore di parametro; è stato restituito 200. |
| Messaggi non validi | 3/3 | 400, corpo vuoto |
| Risultato di uno strumento senza chiamata corrispondente | 3/3 | Avrebbe dovuto essere un errore di parametro; è stato restituito 200. |
| stream_options non valido | 3/3 | 400, corpo vuoto |
| Conteggio dei token di thinking | 3/3 | Token di thinking conteggiati dopo la disattivazione. |
| Conteggio nativo dell'input | 3/3 | Conteggio riportato: 34; nativo: 8. |
| Definizioni degli strumenti nell'input | 3/3 | Il controllo senza strumenti era già incoerente. |
| Conteggio dell'input nella cache | 3/3 | Il conteggio del prefisso ripetuto non corrispondeva a quello nativo. |
| Coerenza dell'input in streaming | 3/3 | Conteggio riportato: 34; nativo: 8 |
| Un solo strumento alla volta | 1/3 | Errore 500 upstream. |
Entrambi i casi con stop hanno restituito un corpo vuoto, mentre lo stesso input senza stop funzionava, in tutte e tre le finestre. reasoning_effort=none ha comunque restituito il ragionamento in entrambi i casi di thinking.
I controlli esclusi non contano né come superati né come falliti.
| Stato | Caso | Conteggio | Motivo |
|---|---|---|---|
| Non applicabile | cache_control esplicito | 3 | Pre-registrato come non supportato da questa interfaccia |
messages e stream_options non validi hanno fallito su tutti e cinque: 400 con corpo vuoto e nessun errore strutturato. È più probabile che il risultato condiviso dipenda dal gateway AIHubMix, che richiede un'indagine separata. Anche il conteggio dei token di thinking è fallito su tutti e cinque, ma ByteDance e Fireworks hanno conteggiato token di thinking dopo la disattivazione, mentre gli altri tre non hanno restituito alcun conteggio del thinking.
Confronto con gli altri quattro
P — velocità di risposta: 79.51
Ogni richiesta conteneva circa 10,000 token di input e chiedeva circa 1,100 token di output. In ognuna delle tre finestre sono state inviate 30 richieste con concorrenza singola e 30 con concorrenza 10, per un totale di 180.
| Metrica | Risultato |
|---|---|
| TTFA | 1.63 s con concorrenza singola; 1.64 s con 10 richieste concorrenti |
| TPOT | 3.24 ms con concorrenza singola; 3.29 ms con 10 |
| Goodput | 1,504.5 token/s con 10 richieste concorrenti |
| Validi | 90/90 con concorrenza singola; 89/90 con 10 (29/30 nella finestra 3), un output composto da un solo token |
| Componenti | TTFA 54.91, TPOT 100.00, goodput 100.00; pesi 35/35/30 |
| Composizione di P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 su 180 erano validi; la richiesta non valida ha restituito un token e nei calcoli delle mediane vale infinito, quindi le mediane possono essere superiori a quelle dei soli output validi. Il TPOT deriva dai blocchi dello streaming; il goodput è dato dai token di output validi con concorrenza 10, divisi per il tempo totale del batch.
Una sola macchina, rete e account; finestre programmate per provider.
K — cache: 60.68
Ogni gruppo comprende cinque richieste: si inizializza un prefisso da 8k o 32k, poi si invia lo stesso prefisso con una nuova domanda finale dopo 5 s, 30 s e 120 s, quindi un nuovo prefisso come controllo a cache fredda. Tre finestre × due lunghezze = 30. K è il numero di token letti dalla cache calda diviso per i token riutilizzabili; le lunghezze hanno lo stesso peso. K vale il 20% di P.
| Prefisso | Finestra | Inizializzazione | +5 s | +30 s | +120 s | Controllo a cache fredda |
|---|---|---|---|---|---|---|
| 8k | Finestra 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Finestra 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Finestra 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Finestra 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Finestra 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Finestra 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Il prefisso da 8k ha registrato 3 cache hit su 9 richieste frequenti, leggendo 23,706 token riutilizzabili su 72,252, pari a 32.81. Il prefisso da 32k ha registrato 8 cache hit su 9, leggendo 255,212 token su 288,261, pari a 88.54. K è 60.68, con i due valori di lunghezza ponderati allo stesso modo. I controlli a cache fredda hanno letto 0 token. Le due lunghezze del prefisso si sono quindi comportate in modo diverso a parità di configurazione. Le verifiche K includevano il campo user e l'intestazione x-session-affinity documentati.
R — stabilità del servizio: 100
300 richieste hanno coperto testo breve, input lungo, chiamate agli strumenti e cronologia multi-turno, con concorrenza singola in tre finestre. Sono state verificate solo la validità e la completezza della prima risposta; le risposte non sono state valutate e non è stato effettuato alcun nuovo tentativo. Gli errori Q e P non vengono conteggiati di nuovo qui.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo da 10k | 90/90 |
| Chiamate agli strumenti | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · IC al 95% 98.78%–100% | 300/300 |
Tutte le 300 richieste hanno restituito una risposta valida e completa al primo tentativo. Con 300 successi, il limite inferiore al 95% è 98.78%, quindi i dati supportano solo un tasso di errore inferiore all'1.22%. R 100 copre queste 300 richieste, non l'intero percorso.
| Fornitore | Successo al primo tentativo | Intervallo al 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek ufficiale | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Cosa copre Q 41.42?
BFCL, HLE e AA-LCR su 4,240 casi valutati: 1,756 risposte corrette, 41.42%, IC al 95% 39.13%–43.59%; la differenza rispetto al canale ufficiale non è statisticamente distinguibile.
Perché entrambi i casi con stop non sono riusciti?
Una richiesta con stop ha restituito un corpo vuoto in tutte e tre le finestre, mentre lo stesso input senza stop ha funzionato. Il problema si è verificato sia con lo streaming sia senza.
reasoning_effort=none disattiva il ragionamento?
No. Ha comunque restituito contenuti di ragionamento in tutte e tre le finestre; per le altre richieste è stato usato il parametro nativo thinking.type=disabled.
Perché un input da 10k è indicato come 10,026 token?
Il caso da 10k ha riportato 10,026 token invece dei 10,000 previsti. I casi da 32k e 100k hanno riportato lo stesso valore, 10,026, e anche un controllo senza strumenti presentava già questa discrepanza.
Perché 8k ha ottenuto 3 cache hit su 9, mentre 32k ne ha ottenuti 8 su 9?
Entrambi hanno usato la stessa configurazione e le stesse impostazioni di affinità documentate. La differenza riguarda le letture riportate dal server: 8k ha ottenuto cache hit nelle finestre 1 e 2, 32k in tutte e tre.
Cosa copre R 100?
300 richieste dedicate, tutte valide al primo tentativo; il limite inferiore al 95% è 98.78%. Gli errori Q e P non sono conteggiati in R.
Continua a leggere: la serie DeepSeek V4.1 Flash
- ByteDance ha riportato token di ragionamento dopo che il ragionamento era stato disattivato, come ha fatto Fireworks: DeepSeek V4.1 Flash su ByteDance: le chiamate agli strumenti corrispondono, la contabilizzazione no
- Baidu ha registrato Q 38.00 e P 37.77: DeepSeek V4.1 Flash su Baidu: nessun canale disponibile raggiunge Q e P
- Alibaba Cloud ha registrato un tempo al primo token di 1.34 s e una cache di 99.37: DeepSeek V4.1 Flash su Alibaba Cloud: 1.34s al primo token, cache 99.37
- Il canale ufficiale è il riferimento per Q, con F 94.00: DeepSeek V4.1 Flash sul canale ufficiale: F 94.00, 15 verifiche non valide


