

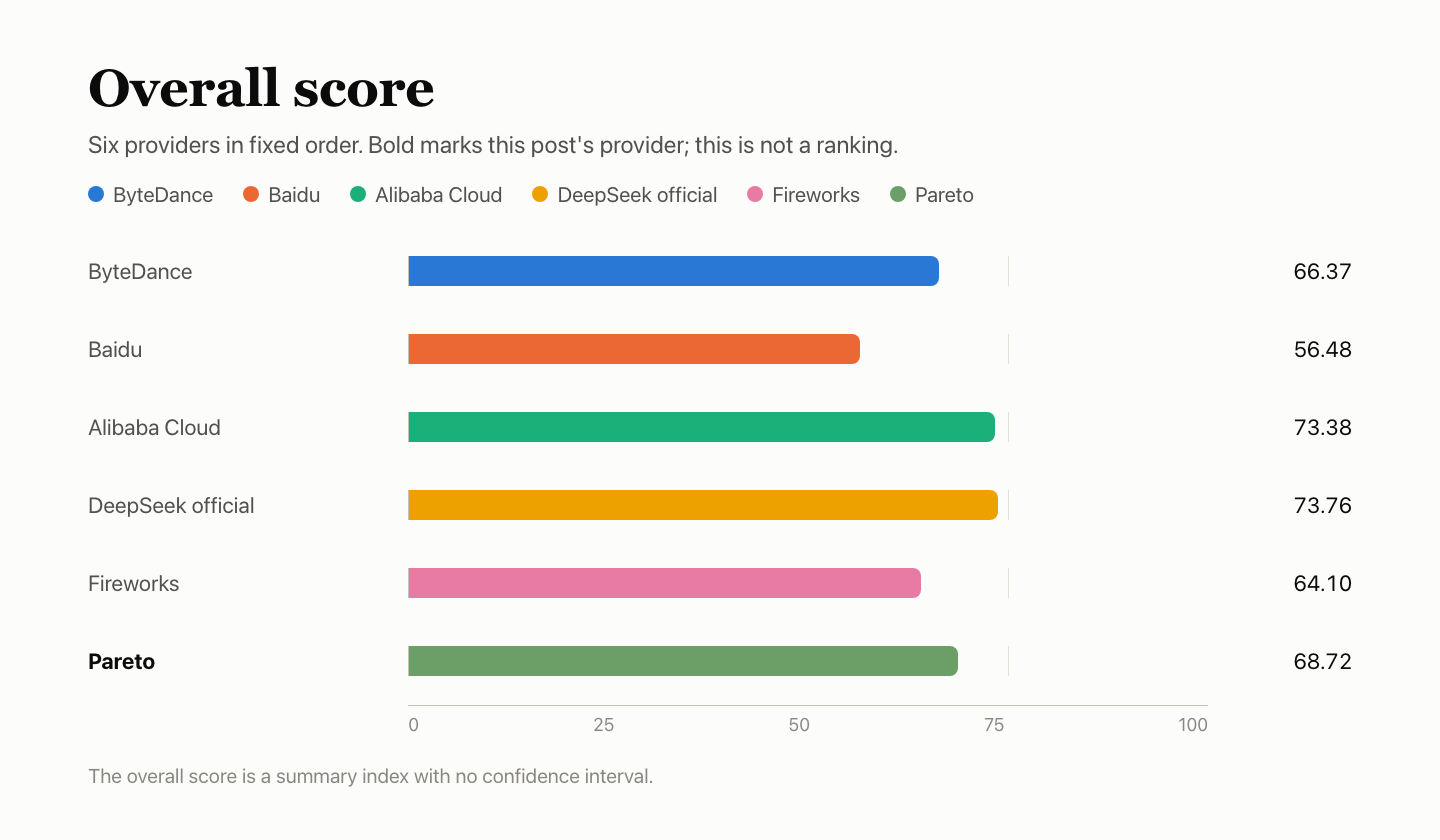
Nel run APB Full del 2026-11-03/04, i quattro punteggi di Pareto sono Q 44.58, F 93.42, P 57.69 e R 100, con un punteggio complessivo di 68.72. Le richieste hot da 8k hanno registrato 2 hit su 9 e quelle da 32k 3 su 9.
Il 2026-11-03/04, DeepSeek V4.1 Flash 1017 è stato testato su sei fornitori tramite AIHubMix con la suite APB Full, usando le stesse domande, gli stessi parametri e gli stessi script di richiesta per ciascuno. Questo profilo APB riguarda solo Pareto: cosa ha misurato ogni sezione e quali sono stati i risultati.
I numeri riportati di seguito sono punteggi, non una classifica né una raccomandazione di un fornitore. I quattro punteggi, Q, F, P e R, vengono presentati per primi; il punteggio complessivo è un indice riassuntivo, non una certificazione, e non ha un intervallo di confidenza. Le regole di calcolo sono definite in AIHubMix Provider Benchmark Standard v2.0.
Punteggi dei sei fornitori
| Fornitore | Q qualità | F funzionalità | P velocità | K cache | R stabilità | Complessivo |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Canale ufficiale DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (questo articolo) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
L'ordine dei fornitori è fisso, non costituisce una classifica. K è un sottopunteggio di P, a cui contribuisce per il 20%, ed è riportato separatamente come riferimento. Il punteggio complessivo viene calcolato secondo le regole di composizione di AIHubMix Provider Benchmark Standard, che tengono conto anche del confronto con il canale ufficiale e della completezza delle evidenze; non è una ponderazione diretta dei quattro punteggi in tabella. È un indice riassuntivo senza intervallo di confidenza. La differenza complessiva tra il canale ufficiale DeepSeek e Alibaba Cloud è di appena 0.37, quindi non è distinguibile.
In breve
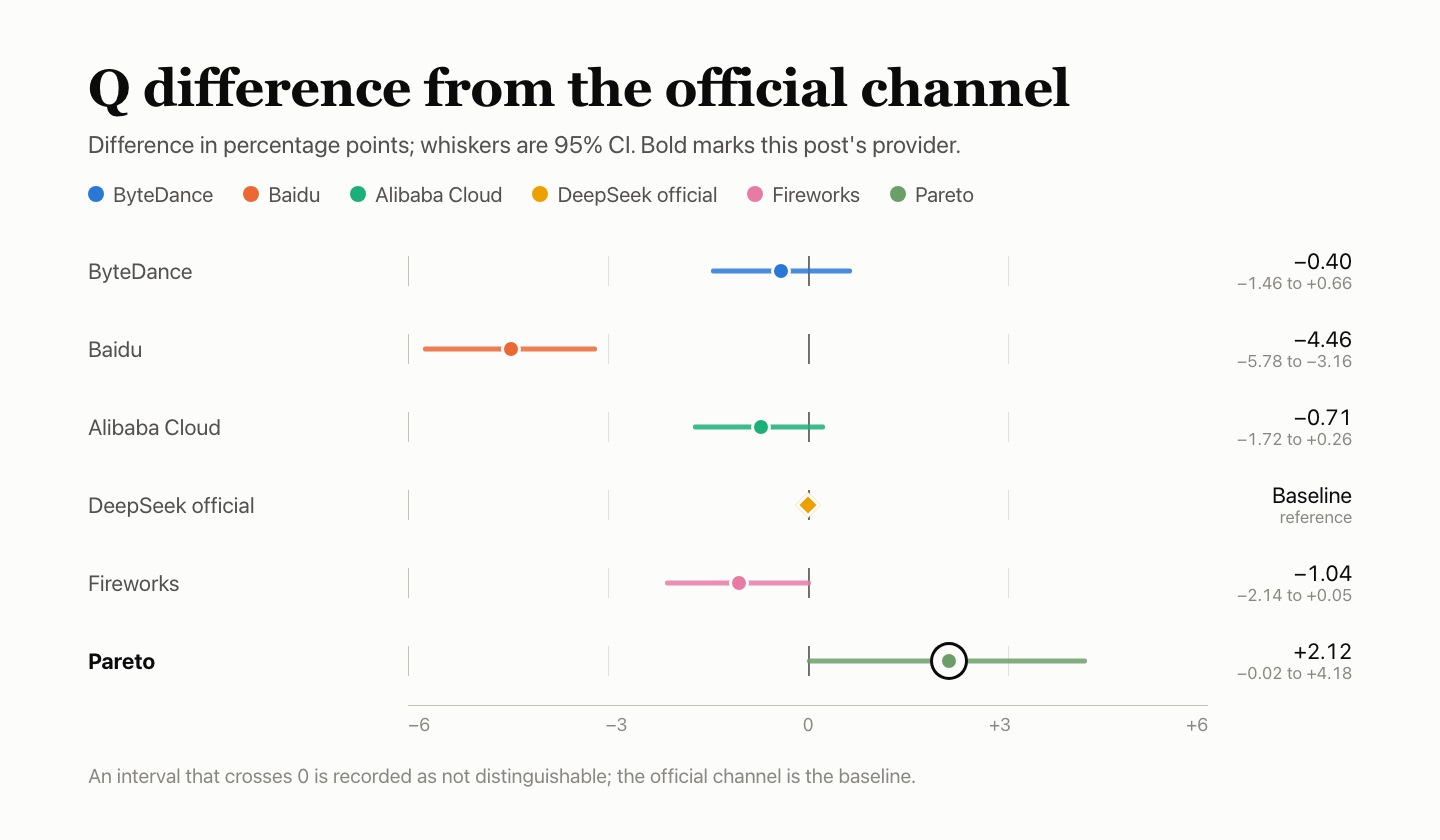
- Qualità delle risposte: Q 44.58, con BFCL 85.27%, HLE 19.32% e AA-LCR 52.00%. Il divario rispetto al canale ufficiale è di +2.12 punti percentuali, con un intervallo al 95% da −0.02 a +4.18: non distinguibile.
- Supporto delle funzionalità: F 93.42, con 29/33 controlli conteggiati superati. Chiamate allo strumento e round-trip dei risultati degli strumenti, chiamate parallele e con nome, modalità JSON e cronologia della conversazione hanno inoltre prodotto registrazioni streaming riuscite; i punteggi mantengono i valori originali.
- Velocità di risposta: P 57.69. Mediana del primo token del corpo: 5.85 s con concorrenza singola e 6.13 s a 10 vie; TPOT 4.63 ms; 110 delle 180 richieste di velocità erano valide.
- Cache: K 27.58. Le richieste hot da 8k hanno registrato 2 hit su 9 e quelle da 32k 3 su 9; nessuna lettura di controllo cold ha usato la cache.
- Stabilità del servizio: R 100. Tutte le 300 richieste dedicate sono riuscite al primo tentativo.
Configurazione del test
| Voce | Dettaglio |
|---|---|
| Modello | DeepSeek V4.1 Flash 1017 |
| ID modello richiesto | deepseek/deepseek-v4.1-flash |
| Nome del modello restituito | deepseek/deepseek-v4.1-flash |
| Percorso di accesso | Tramite AIHubMix con un ID modello specifico del fornitore, non con una connessione diretta all'account del fornitore |
| Parametri | Profilo di richiesta APB v2 fisso, temperature 1.0, max_tokens 16,384, timeout 300 s, nessun tentativo automatico |
| Orario | 2026-11-03 18:07 – 11-04 16:33; richieste cache 11-05 19:31 – 11-06 10:35; tutto in UTC+8. Tutti e sei i fornitori hanno condiviso un Mac mini, una rete e un account. |
| Campioni | Q 4,250 istanze di domande; F 180 controlli; P 180 richieste; R 300; K 30 |
Le richieste hanno usato il percorso guida rapida di AIHubMix con un ID modello specifico del fornitore; gli ID degli altri fornitori sono elencati nella pagina dei modelli. I parametri del modello sono descritti nella documentazione API di DeepSeek.
Q — qualità delle risposte: 44.58
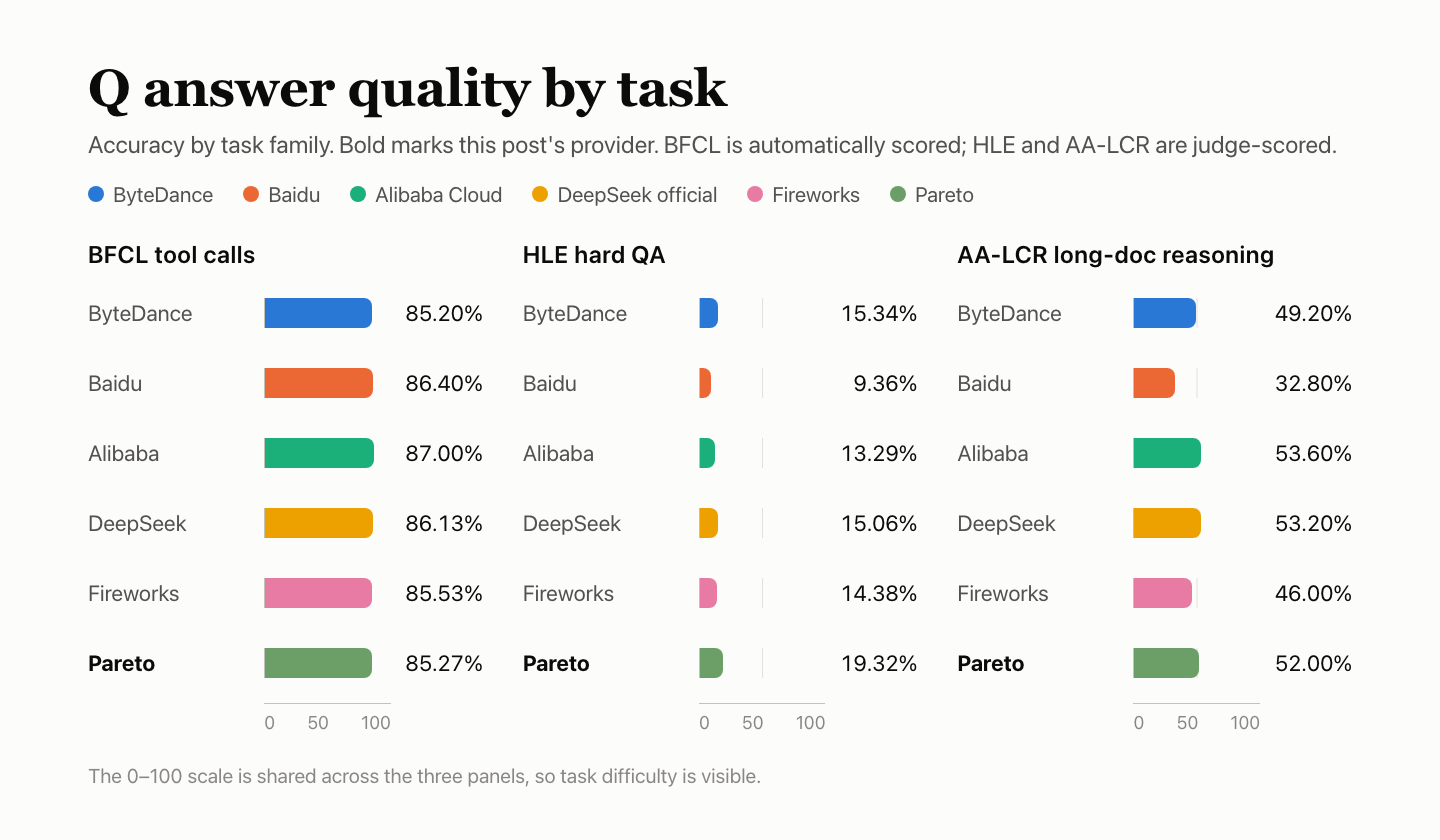
La qualità delle risposte si basa su tre suite: 500 domande BFCL con 3 risposte ciascuna, 250 domande HLE con 10 risposte ciascuna e 25 domande AA-LCR con 10 risposte ciascuna. BFCL viene valutato con regole automatiche; HLE e AA-LCR vengono giudicati giusti o sbagliati dal modello giudice deepseek-flash. Tutti e sei i fornitori hanno ricevuto le stesse domande e i risultati delle tre suite sono aggregati in un'unica accuratezza. Dieci risposte sono state rimosse perché la domanda non era valutabile, lasciando 4,240 istanze di domande valutate.
| Suite | Domande × turni | Corrette | Accuratezza | Errori del servizio |
|---|---|---|---|---|
| Chiamate agli strumenti BFCL, valutazione automatica | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Domande difficili HLE, valutazione del giudice | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Ragionamento su documenti lunghi AA-LCR, valutazione del giudice | 25 × 10 | 130/250 | 52.00% | 0 |
| Totale · intervallo al 95% 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Per ogni istanza di domanda è stata fornita una risposta completa; non si sono verificati errori del servizio.
| Categoria BFCL | Superate | Percentuale superata |
|---|---|---|
| simple_python: una funzione, chiamata e argomenti corretti | 333/360 | 92.50% |
| multiple: selezionare la funzione corretta tra diverse | 269/300 | 89.67% |
| parallel: chiamare più volte la stessa funzione contemporaneamente | 265/300 | 88.33% |
| parallel_multiple: chiamare più funzioni contemporaneamente | 203/240 | 84.58% |
| irrelevance: nessuna funzione pertinente, quindi nessuna chiamata | 109/150 | 72.67% |
| ahm_multi_turn: catena di strumenti in tre fasi | 100/150 | 66.67% |
Ogni domanda BFCL ha ricevuto 3 risposte; la tabella somma i risultati dei 3 turni.
Confronto con gli altri cinque
| Fornitore | BFCL | HLE | AA-LCR | Combinato | Rispetto all'ufficiale |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (da −1.46 a +0.66), non distinguibile |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (da −5.78 a −3.16), inferiore all'ufficiale |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (da −1.72 a +0.26), non distinguibile |
| Canale ufficiale DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Baseline |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (da −2.14 a +0.05), non distinguibile |
| Pareto (questo articolo) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (da −0.02 a +4.18), non distinguibile |
Rispetto all'ufficiale: il divario di accuratezza in punti percentuali, con l'intervallo al 95% tra parentesi; se l'intervallo comprende 0, il risultato è indicato come non distinguibile. Il giudice di HLE e AA-LCR, deepseek-flash, appartiene alla stessa famiglia DeepSeek del modello testato e non è stato calibrato, quindi i suoi giudizi potrebbero essere indulgenti.
F — supporto delle funzionalità: 93.42
I casi relativi alle funzionalità verificano se il comportamento dell'interfaccia è conforme al protocollo. F 93.42 deriva dai 33 controlli conteggiati (29 superati), dopo aver rinormalizzato i pesi dei gruppi osservati; gli altri 147 controlli previsti nella suite originale sono stati esclusi dal punteggio.
| Gruppo di casi | Peso | Osservazioni superate / streaming | Esclusi | Punteggio del gruppo |
|---|---|---|---|---|
| Protocollo di streaming e messaggi | 20% | 23/27 | 3 | 85.19 |
| Interfaccia degli strumenti Chiamate agli strumenti, round-trip dei risultati degli strumenti, chiamate parallele e con nome | 20% | Superamenti rilevati in streaming* | 30 | — |
| Vincoli di output e parametri Modalità JSON e ragionamento disattivato | 20% | Superamenti rilevati in streaming* | 30 | — |
| Contesto e stato Cronologia della conversazione e istruzioni di sistema | 15% | Superamenti rilevati in streaming* | 30 | — |
| Errori e ripristino | 15% | 3/3 | 27 | 100.00 |
| Protocollo di misurazione e cache | 10% | 3/3 | 27 | 100.00 |
| Totale · punteggio ponderato | 29/33 | 147 | 93.42 | |
- Le funzionalità elencate hanno registrazioni streaming riuscite; ciò non assegna il punteggio massimo all'intero gruppo. Non sono stati aggiunti controlli al calcolo del punteggio. F 93.42 e il punteggio complessivo di 68.72 mantengono i valori originali.
| Caso non superato | Finestre | Motivo |
|---|---|---|
| Sequenza di arresto dello streaming Protocollo di streaming e messaggi | 3/3 | Corpo vuoto con una sequenza di arresto; lo stesso input senza sequenza ha funzionato |
| Output testuale esatto Protocollo di streaming e messaggi | 1/3 | Un punto finale aggiuntivo ha impedito la corrispondenza esatta del testo |
“Finestre” indica quante delle 3 finestre non hanno superato il controllo.
I casi con messaggi malformati e opzioni di streaming malformate hanno restituito 400 con un corpo della risposta vuoto su diversi fornitori. La misurazione dei token di ragionamento ha avuto comportamenti diversi tra i fornitori.
Confronto con gli altri cinque
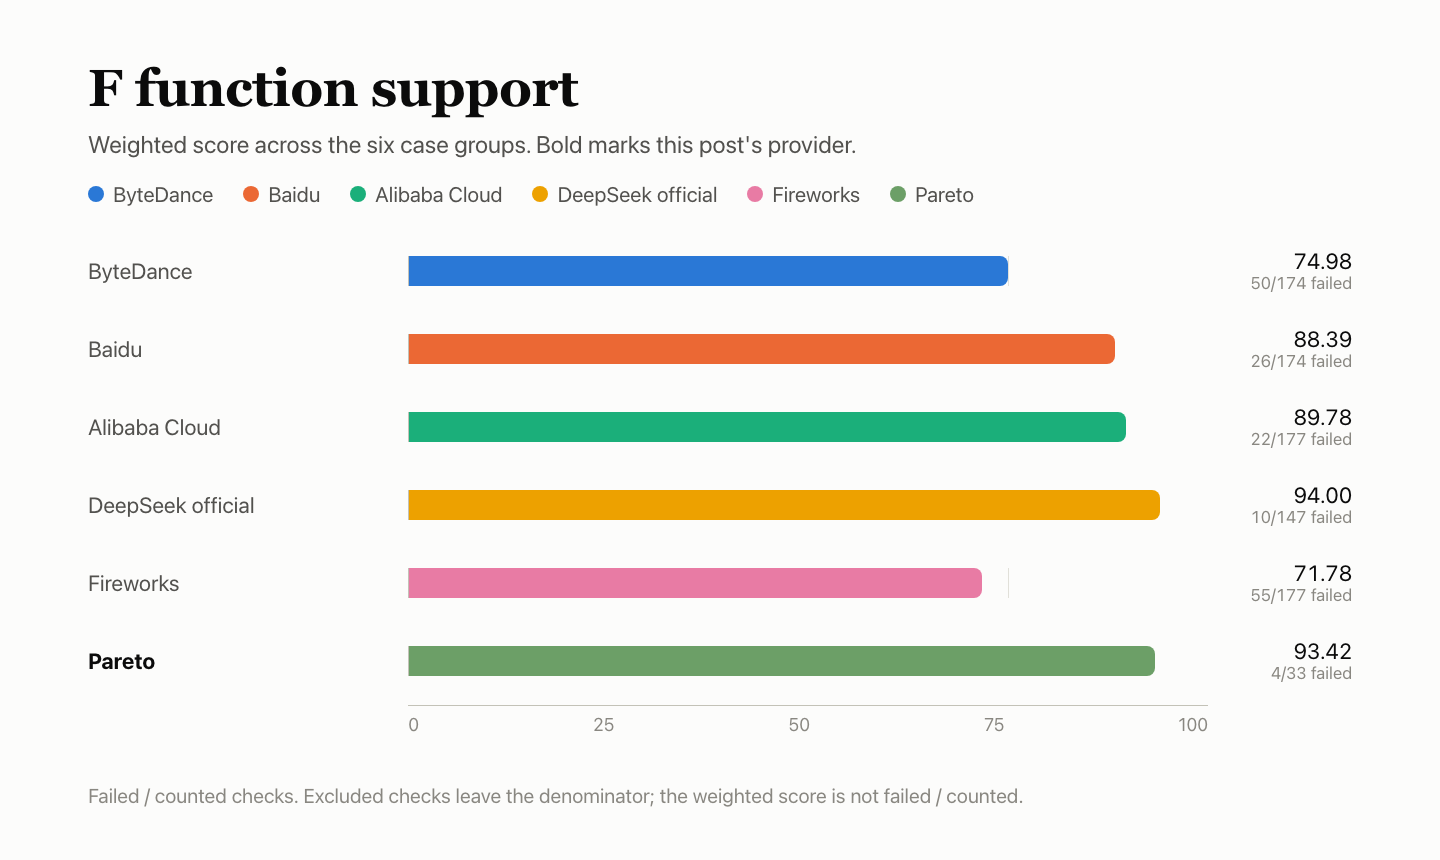
| Fornitore | Superati | Non superati | Esclusi | Punteggio ponderato |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Canale ufficiale DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (questo articolo) | 29 | 4 | 147 | 93.42 |
P — velocità di risposta: 57.69
Ogni richiesta conteneva circa 10,000 token di input e chiedeva circa 1,100 token di testo nel corpo della risposta. In ciascuna delle tre finestre, 30 richieste sono state eseguite con concorrenza singola e 30 con concorrenza a 10 vie: 180 richieste in totale.
| Voce | Dettaglio |
|---|---|
| Primo token del corpo (TTFA) | Mediana 5.85 s con concorrenza singola (3.08 s considerando solo le valide), 6.13 s a 10 vie (4.92 s considerando solo le valide) |
| Velocità di generazione (TPOT) | 4.42 ms/token con concorrenza singola, 4.63 ms/token a 10 vie |
| Throughput effettivo | 519.4 token/s a 10 vie |
| Richieste valide | 53/90 con concorrenza singola (finestre 1–3: 15/30, 18/30, 20/30), 57/90 a 10 vie (23/30, 16/30, 18/30); non valide: 70 hanno restituito 200 con None |
| Sottopunteggi | TTFA 24.59, TPOT 100.00, throughput 72.05; TTFA e TPOT rientrano nella fascia inferiore, ponderati rispettivamente al 35% / 35% / 30%: punteggio di risposta 65.22 |
| Punteggio P | Punteggio di risposta 65.22 × 80% + cache K 27.58 × 20% = 57.69 |
Le richieste non valide vengono conteggiate come infinite, quindi le mediane in tabella possono essere superiori alle mediane calcolate solo sulle richieste valide. Il TPOT è stimato dai blocchi trasmessi in streaming, non misurato per token sull'hardware. Il throughput è dato dai token di output validi a concorrenza 10 divisi per il tempo totale del batch.
Confronto con gli altri cinque
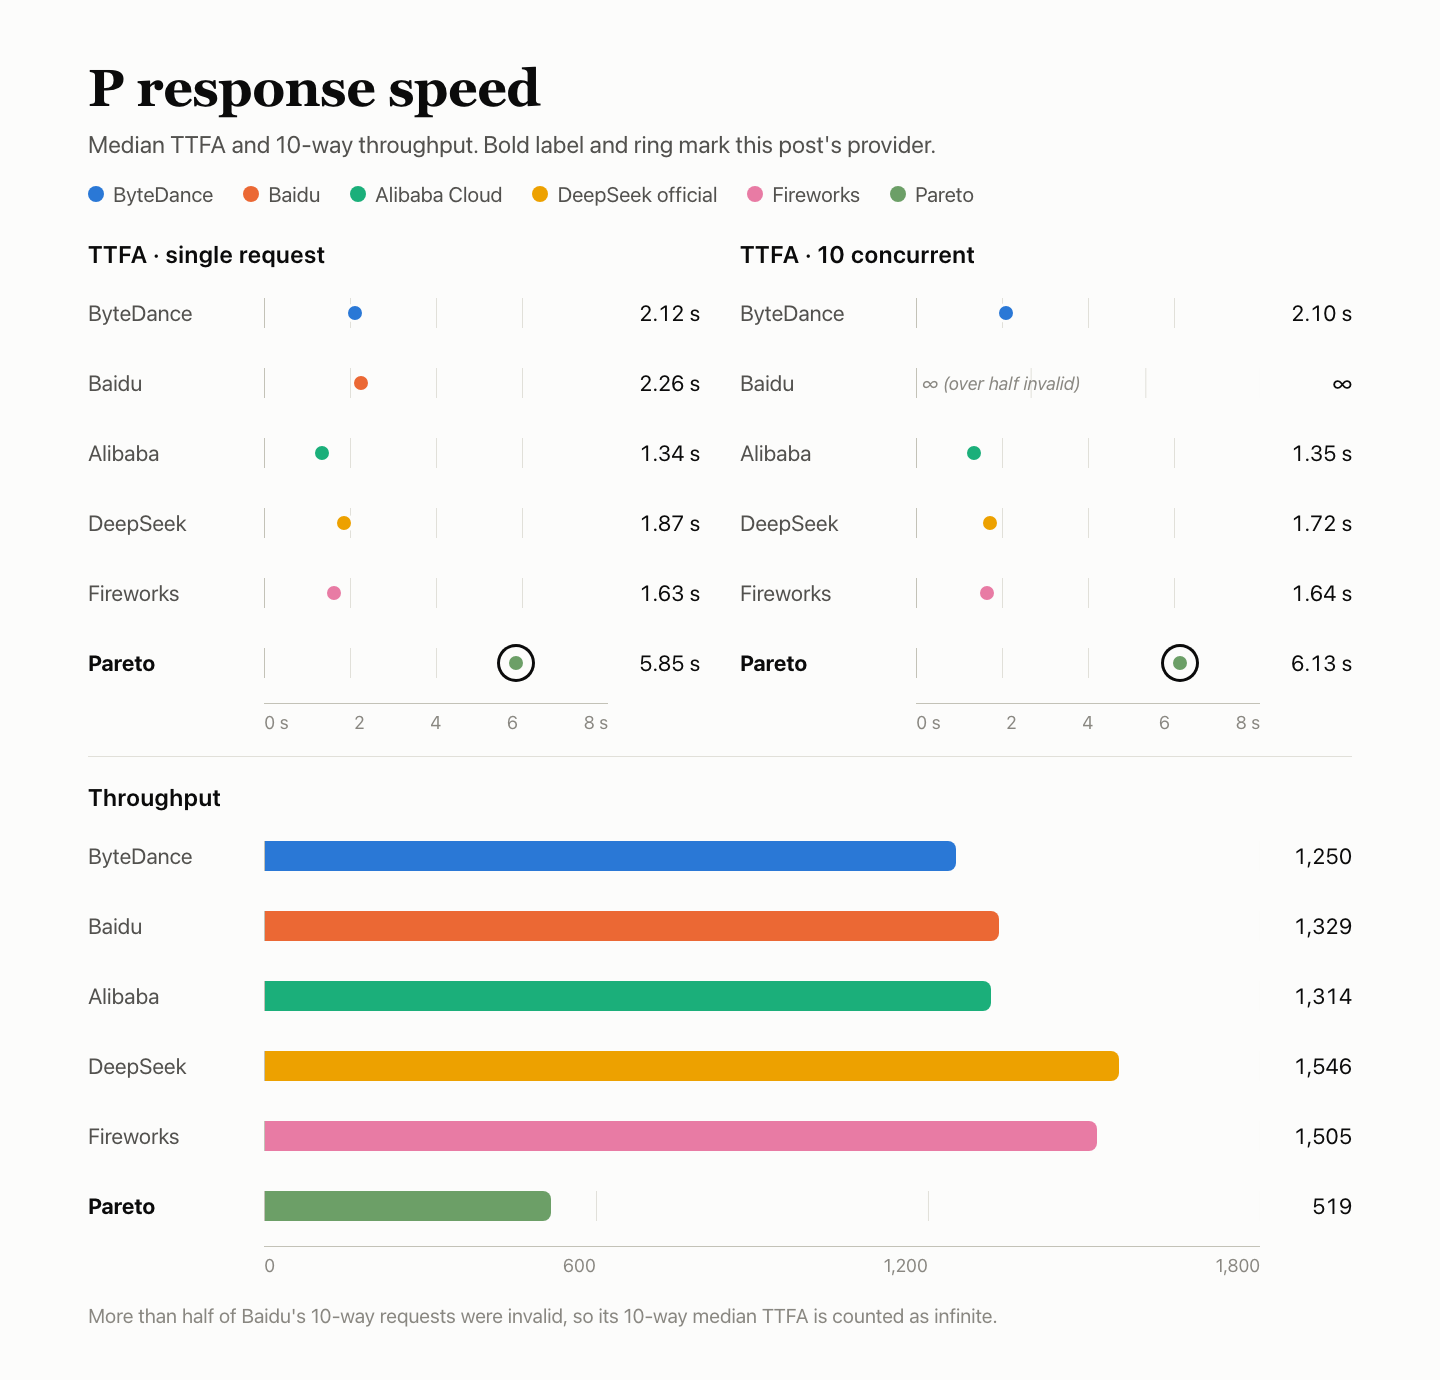
| Fornitore | Richieste valide | TTFA con concorrenza singola | TTFA a 10 vie | TPOT (più lento) | Throughput tok/s | Risposta |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Canale ufficiale DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (questo articolo) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Tutti e sei hanno condiviso macchina, rete e account. Le tre finestre sono state pianificate un fornitore alla volta, quindi i periodi di raccolta non si sovrappongono completamente; è meglio non attribuire troppo peso alle piccole differenze. ∞ indica che più della metà delle richieste non era valida, quindi la mediana è considerata infinita.
K — cache: 27.58
Ogni gruppo invia cinque richieste. La prima contiene un prefisso fisso di circa 8k o 32k token e inizializza la cache. Le richieste da 2 a 4 mantengono il prefisso e cambiano solo la domanda finale, con intervalli di 5 s, 30 s e 120 s. La quinta usa un nuovo prefisso come controllo a freddo. Tre finestre × due lunghezze equivalgono a 30 richieste. K è il numero di token letti dalla cache nelle richieste hot diviso per i token che, in base alle regole, dovrebbero essere riutilizzabili, con le due lunghezze ponderate allo stesso modo; K vale il 20% di P.
| Finestra | 1 · inizializzazione | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · freddo |
|---|---|---|---|---|---|
| Prefisso 8k · hit hot 2/9 · letti 15,872 dei 72,504 riutilizzabili · 21.89 | — | — | — | — | — |
| Finestra 1 | 0 | 0 | 7,936 | 0 | 0 |
| Finestra 2 | 0 | 0 | 0 | 0 | 0 |
| Finestra 3 | 0 | 0 | 7,936 | 0 | 0 |
| Prefisso 32k · hit hot 3/9 · letti 96,000 dei 288,513 riutilizzabili · 33.27 | — | — | — | — | — |
| Finestra 1 | 0 | 0 | 32,000 | 0 | 0 |
| Finestra 2 | 0 | 0 | 0 | 0 | 0 |
| Finestra 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k e 32k ponderati allo stesso modo) | — | — | — | — | 27.58 |
Valori dei token letti dalla cache segnalati dal server; «Non restituito» significa che il campo era assente nella risposta.
Le richieste hot da 8k hanno registrato 2 hit su 9, leggendo 7,936 token per ciascun hit; quelle hot da 32k hanno registrato 3 hit su 9, leggendo 32,000 token per ciascun hit. Le richieste cold non hanno letto la cache, quindi hot e cold si distinguono nettamente.
Confronto con gli altri cinque
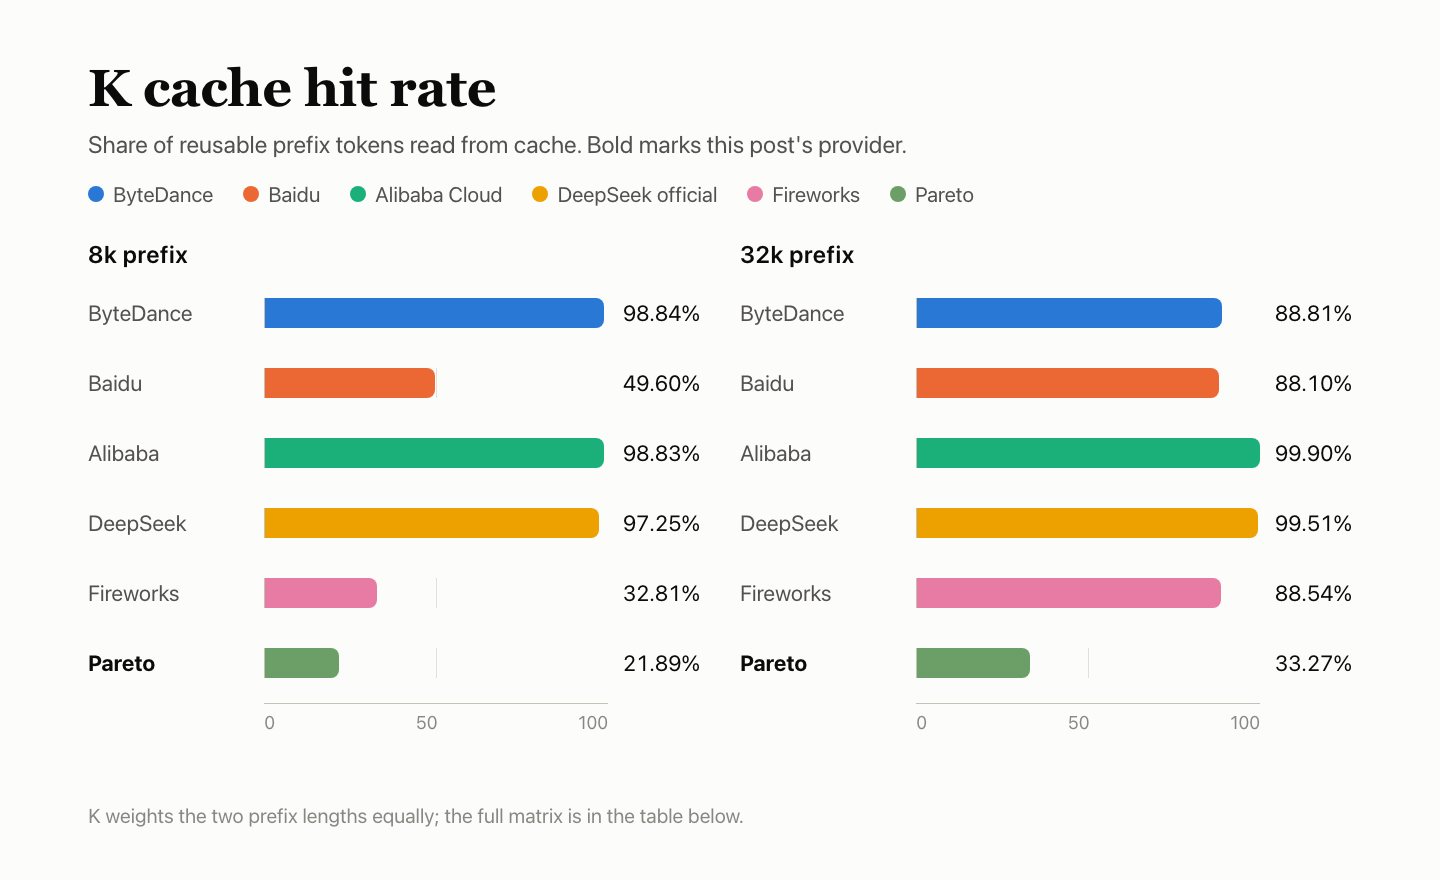
| Fornitore | Hit 8k | 8k | Hit 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Canale ufficiale DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (questo articolo) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — stabilità del servizio: 100
Le 300 richieste si dividono in quattro tipi: testo breve, input lungo, chiamate agli strumenti e cronologia multi-turno. Sono state eseguite con concorrenza singola in tre finestre. Si verifica solo se il primo tentativo ha restituito una risposta valida e completa; le risposte non vengono valutate e non si riprova. Gli errori nelle sezioni sulla qualità delle risposte e sulla velocità sono conteggiati in Q e P, non di nuovo in R.
| Tipo di richiesta | Successo al primo tentativo |
|---|---|
| Testo breve | 120/120 |
| Input lungo da 10k | 90/90 |
| Chiamate agli strumenti | 60/60 |
| Cronologia multi-turno | 30/30 |
| Totale · intervallo al 95% 98.78%–100% | 300/300 |
Tutte le 300 richieste hanno restituito una risposta valida e completa al primo tentativo. R = 100 descrive solo queste 300 richieste dedicate; non significa che l'intera catena non abbia avuto errori. Il limite inferiore dell'intervallo al 95% è 98.78%: 300 successi su 300 consentono solo di affermare che il tasso di errore è probabilmente inferiore all'1.22%.
Confronto con gli altri cinque
| Fornitore | Successo al primo tentativo | Intervallo al 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Canale ufficiale DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (questo articolo) | 300/300 | 98.78%–100% |
R riguarda solo queste 300 richieste dedicate; gli errori nelle sezioni sulla qualità delle risposte e sulla velocità sono registrati in Q e P e non vengono conteggiati di nuovo in R.
FAQ
Perché F è 93.42 se sono stati conteggiati solo 33 controlli?
I controlli conteggiati in origine hanno superato 29 verifiche su 33, ottenendo F 93.42 dopo la rinormalizzazione dei pesi dei gruppi osservati; gli altri 147 controlli previsti sono stati esclusi dal punteggio. I record di streaming descrivono funzionalità operative specifiche e non aggiungono verifiche valutate. Il punteggio complessivo mostrato resta 68.72.
Perché P è 57.69 se TPOT ha ottenuto 100.00?
Solo 110 delle 180 richieste di velocità erano valide; 70 hanno restituito 200 con None. Le richieste non valide sono considerate infinite, quindi la mediana del tempo al primo token nel corpo è di 5.85 s in singola concorrenza e 6.13 s con concorrenza a 10 (3.08 s e 4.92 s considerando solo quelle valide). TTFA ha ottenuto 24.59 e il throughput 72.05, per un punteggio di risposta di 65.22; con K della cache a 27.58, che pesa il 20%, P è 57.69.
Perché K è solo 27.58?
Le richieste hot hanno registrato 2 hit su 9 a 8k (21.89) e 3 su 9 a 32k (33.27), con le due lunghezze ponderate allo stesso modo. Quando si è verificato un hit, sono stati letti 7,936 o 32,000 token; nessun controllo cold ha letto la cache.
La qualità delle risposte di Pareto è superiore a quella del canale ufficiale?
Non in modo distinguibile. L'accuratezza combinata è del 44.58% contro il 42.45%, con uno scarto di +2.12 punti, ma l'intervallo al 95% va da −0.02 a +4.18 e include lo 0. Il giudice HLE e AA-LCR, deepseek-flash, non è stato calibrato e potrebbe essere permissivo.
Quali casi F non hanno superato il controllo?
Due. La sequenza di arresto dello streaming ha restituito un corpo vuoto in tutte e tre le finestre, mentre lo stesso input senza stop ha funzionato. L'output di testo esatto aveva un punto finale aggiuntivo in una delle tre finestre.
Continua a leggere: la serie DeepSeek V4.1 Flash
- Lo scarto Q di Pareto, pari a +2.12, è misurato rispetto al canale ufficiale; l'esecuzione di riferimento è disponibile in Recensione di DeepSeek V4.1 Flash sul canale ufficiale DeepSeek: benchmark di confronto, 15 richieste non valide con concorrenza singola.
- Anche Fireworks ha restituito corpi vuoti con le richieste stop e ha registrato 3 hit su 9 a 8k: Recensione di DeepSeek V4.1 Flash su Fireworks: le richieste stop restituiscono un corpo vuoto, 3 hit su 9 per le richieste hot con cache da 8k.
- Le richieste hot di Alibaba Cloud hanno registrato 18 hit su 18, contro le 5 su 18 di Pareto: Recensione di DeepSeek V4.1 Flash su Alibaba Cloud: primo token nel corpo in 1.34 s, hit della cache per tutte le 18 richieste hot, risposte indistinguibili da quelle del canale ufficiale.
- Tutte le richieste di velocità di ByteDance erano valide, con un tempo al primo token nel corpo di 2.12 s: Recensione di DeepSeek V4.1 Flash su ByteDance: risposte indistinguibili da quelle del canale ufficiale, conteggi degli input non corrispondenti.
- Anche Baidu ha perso molte richieste di velocità a causa di no_available_channel: Recensione di DeepSeek V4.1 Flash su Baidu: chiamate agli strumenti alla pari con il canale ufficiale, frequenti errori no-available-channel penalizzano qualità delle risposte e velocità.
Fonti
- Pagina del modello DeepSeek V4.1 Flash 1017 (AIHubMix)
- Standard di benchmark dei fornitori AIHubMix v2.0 (documentazione AIHubMix)
- Guida rapida (documentazione AIHubMix)
- Modelli (AIHubMix)
- Documentazione API di DeepSeek (DeepSeek)


