
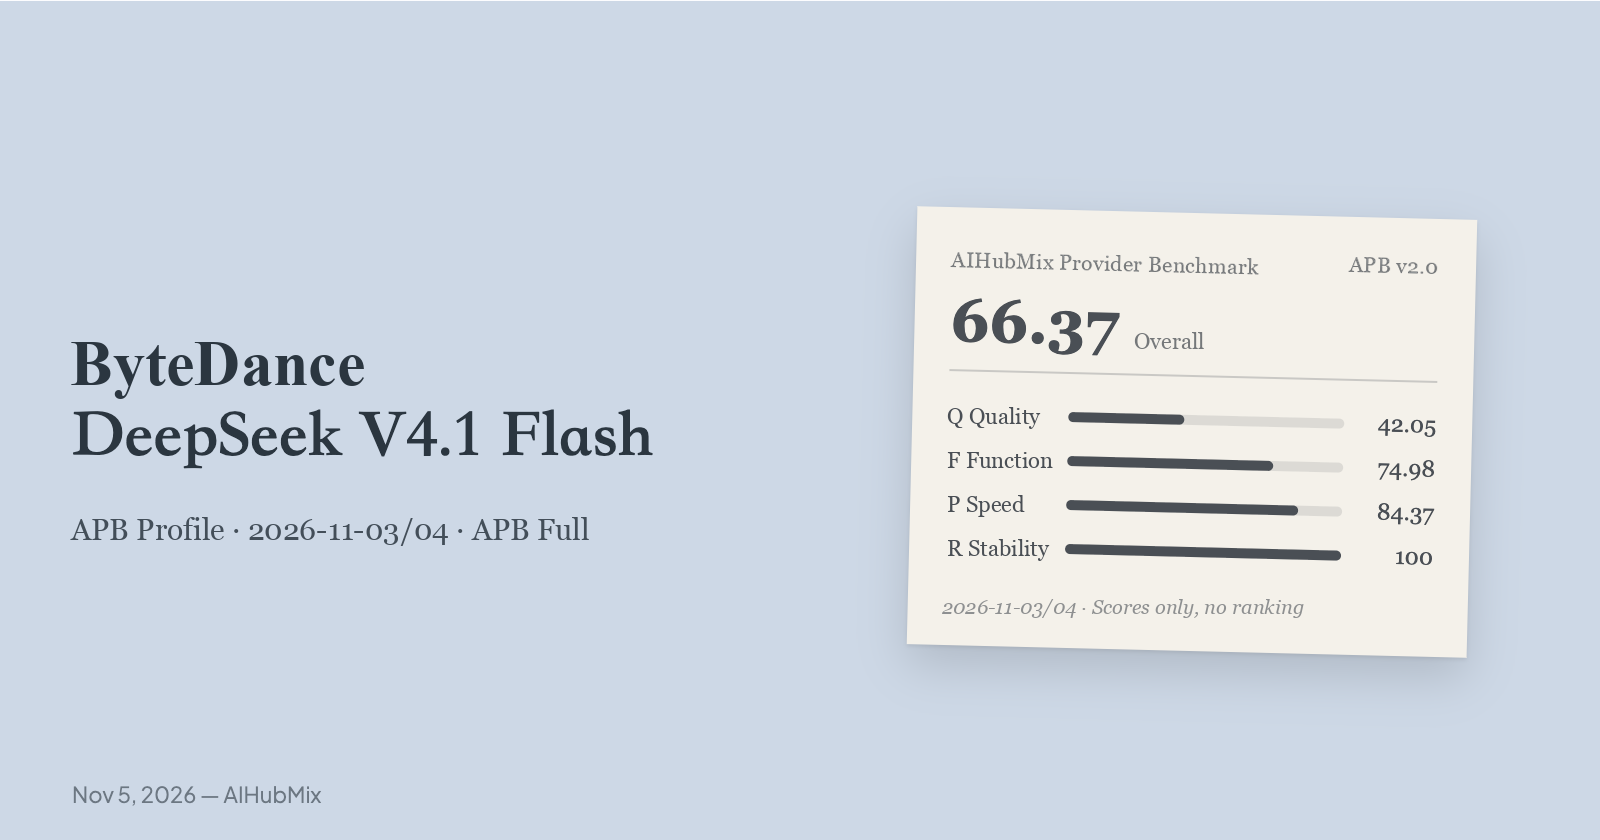
Les 2026-11-03/04, DeepSeek V4.1 Flash 1017 a été testé chez cinq fournisseurs via AIHubMix avec la suite APB Full : les mêmes questions, paramètres et scripts de requête à chaque fois. Ce profil APB couvre uniquement le test sur ByteDance, section par section.
Les chiffres ci-dessous sont des scores, pas un classement ni une recommandation de fournisseur. Q, F, P, K et R viennent en premier ; le score global est un indice récapitulatif, pas une certification, et il n’a pas d’intervalle de confiance. Les règles de notation sont définies dans AIHubMix Provider Benchmark Standard v2.0.
Scores chez cinq fournisseurs
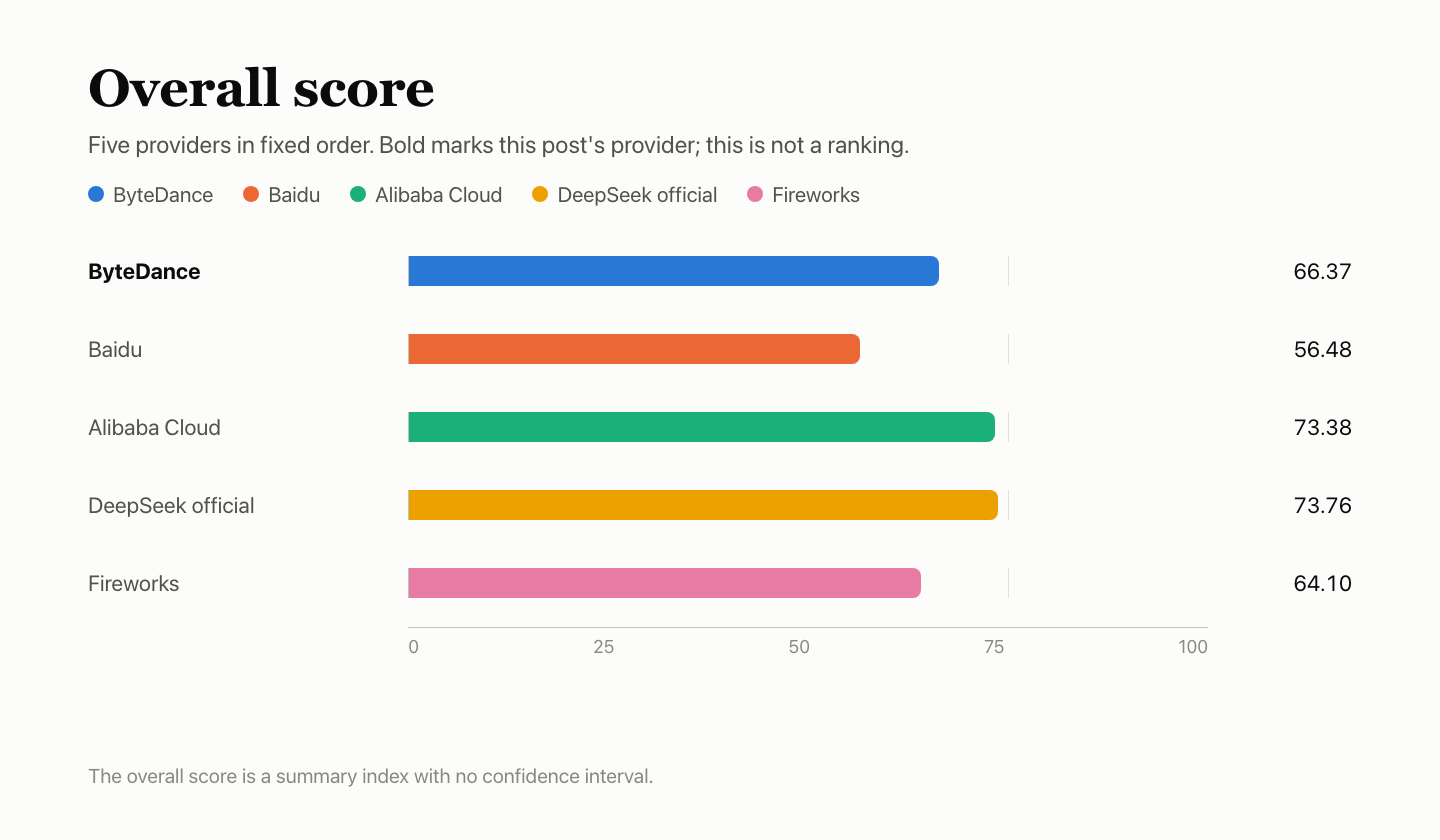
Le gras désigne le fournisseur de cet article. Ordre fixe des fournisseurs, pas un classement. K est un sous-score de P et compte pour 20% de celui-ci. Le score global est un indice récapitulatif sans intervalle de confiance. La différence entre le canal officiel de DeepSeek et Alibaba Cloud est de 0.37 et n’est pas significative.
En bref
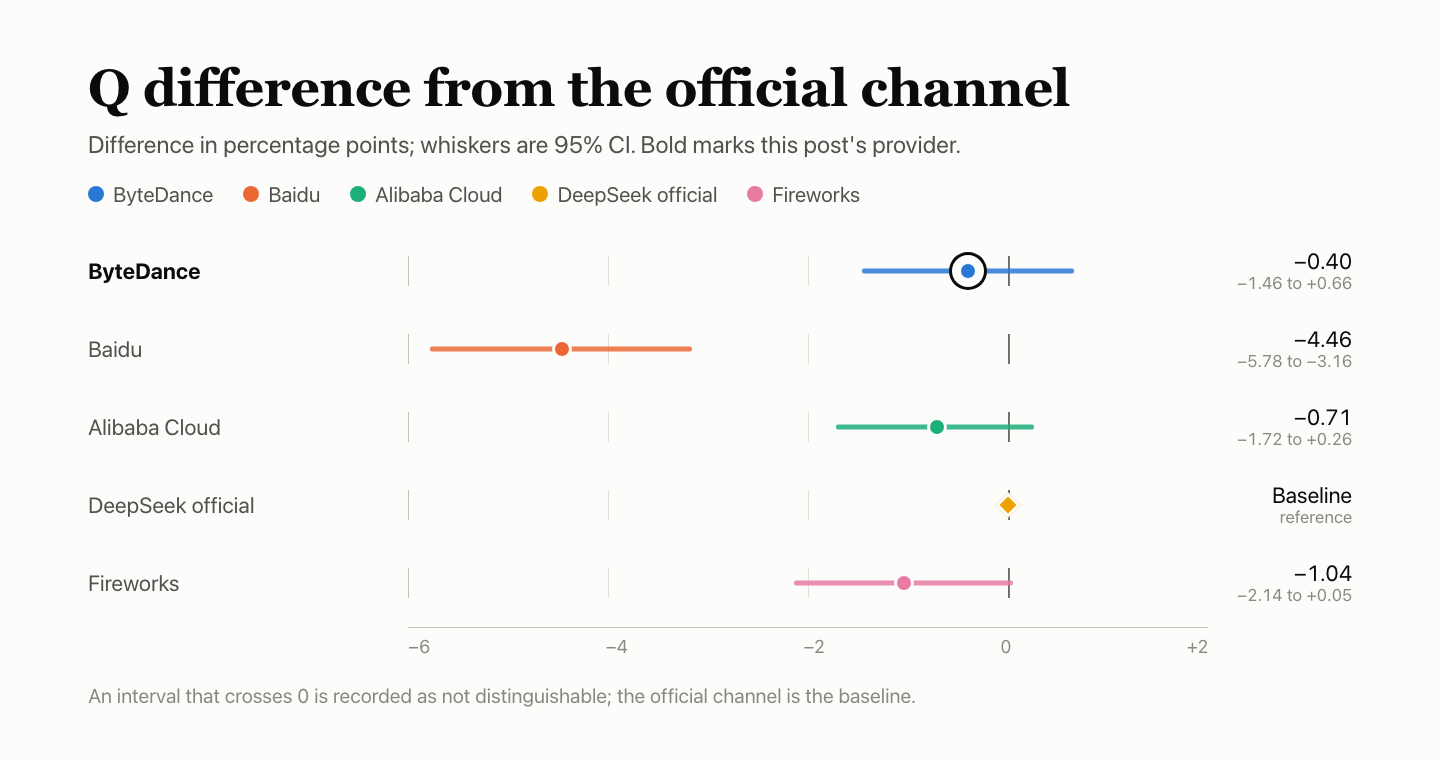
- Q 42.05. BFCL 85.20%, HLE 15.34%, AA-LCR 49.20%. L’écart avec le canal officiel est de −0.40 point de pourcentage, avec un intervalle à 95% de −1.46 à +0.66 : la différence n’est pas significative. AA-LCR a enregistré 28 échecs de requête, tous dans la fenêtre 1, comptabilisés comme des réponses incorrectes.
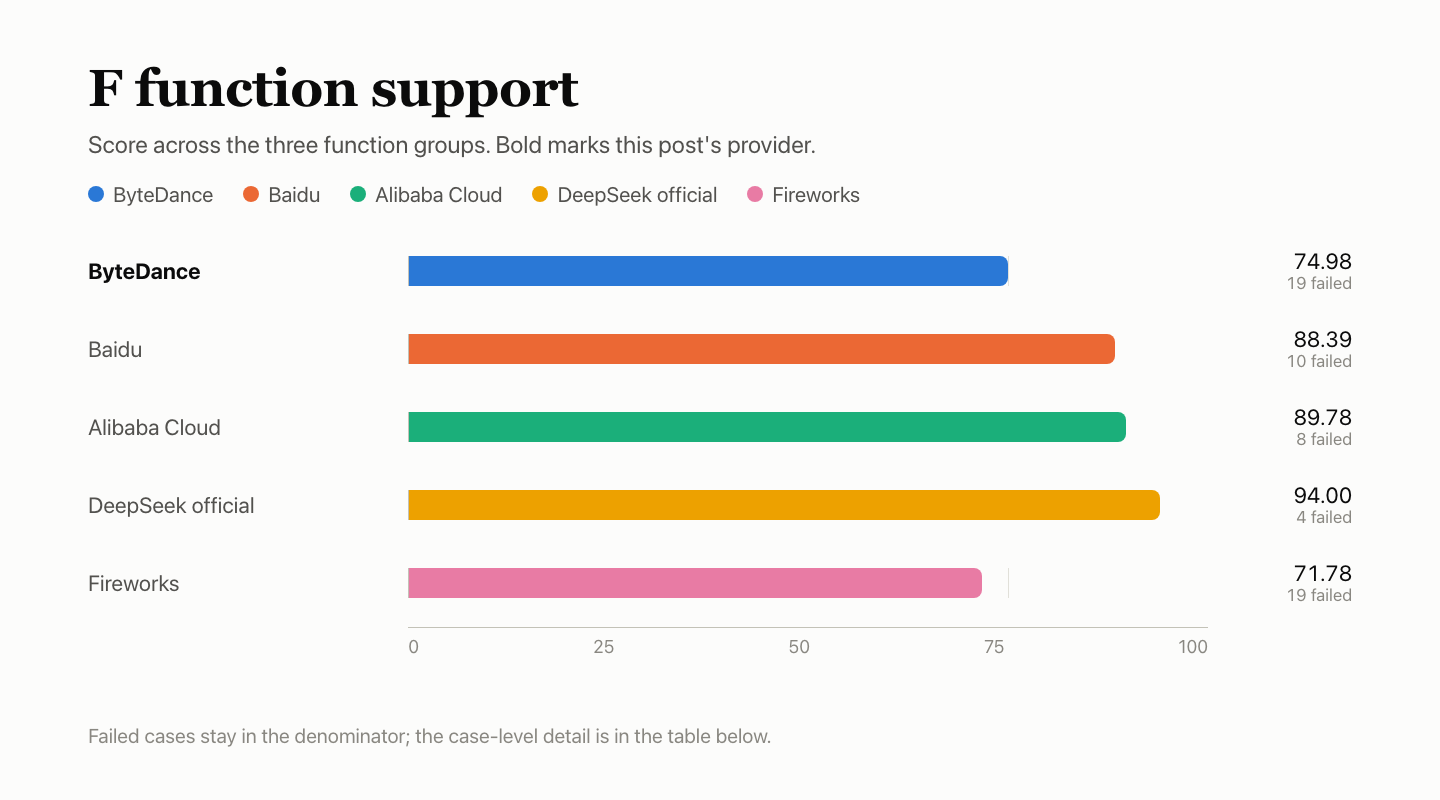
- F 74.98. 124 des 174 vérifications comptabilisées ont été réussies.
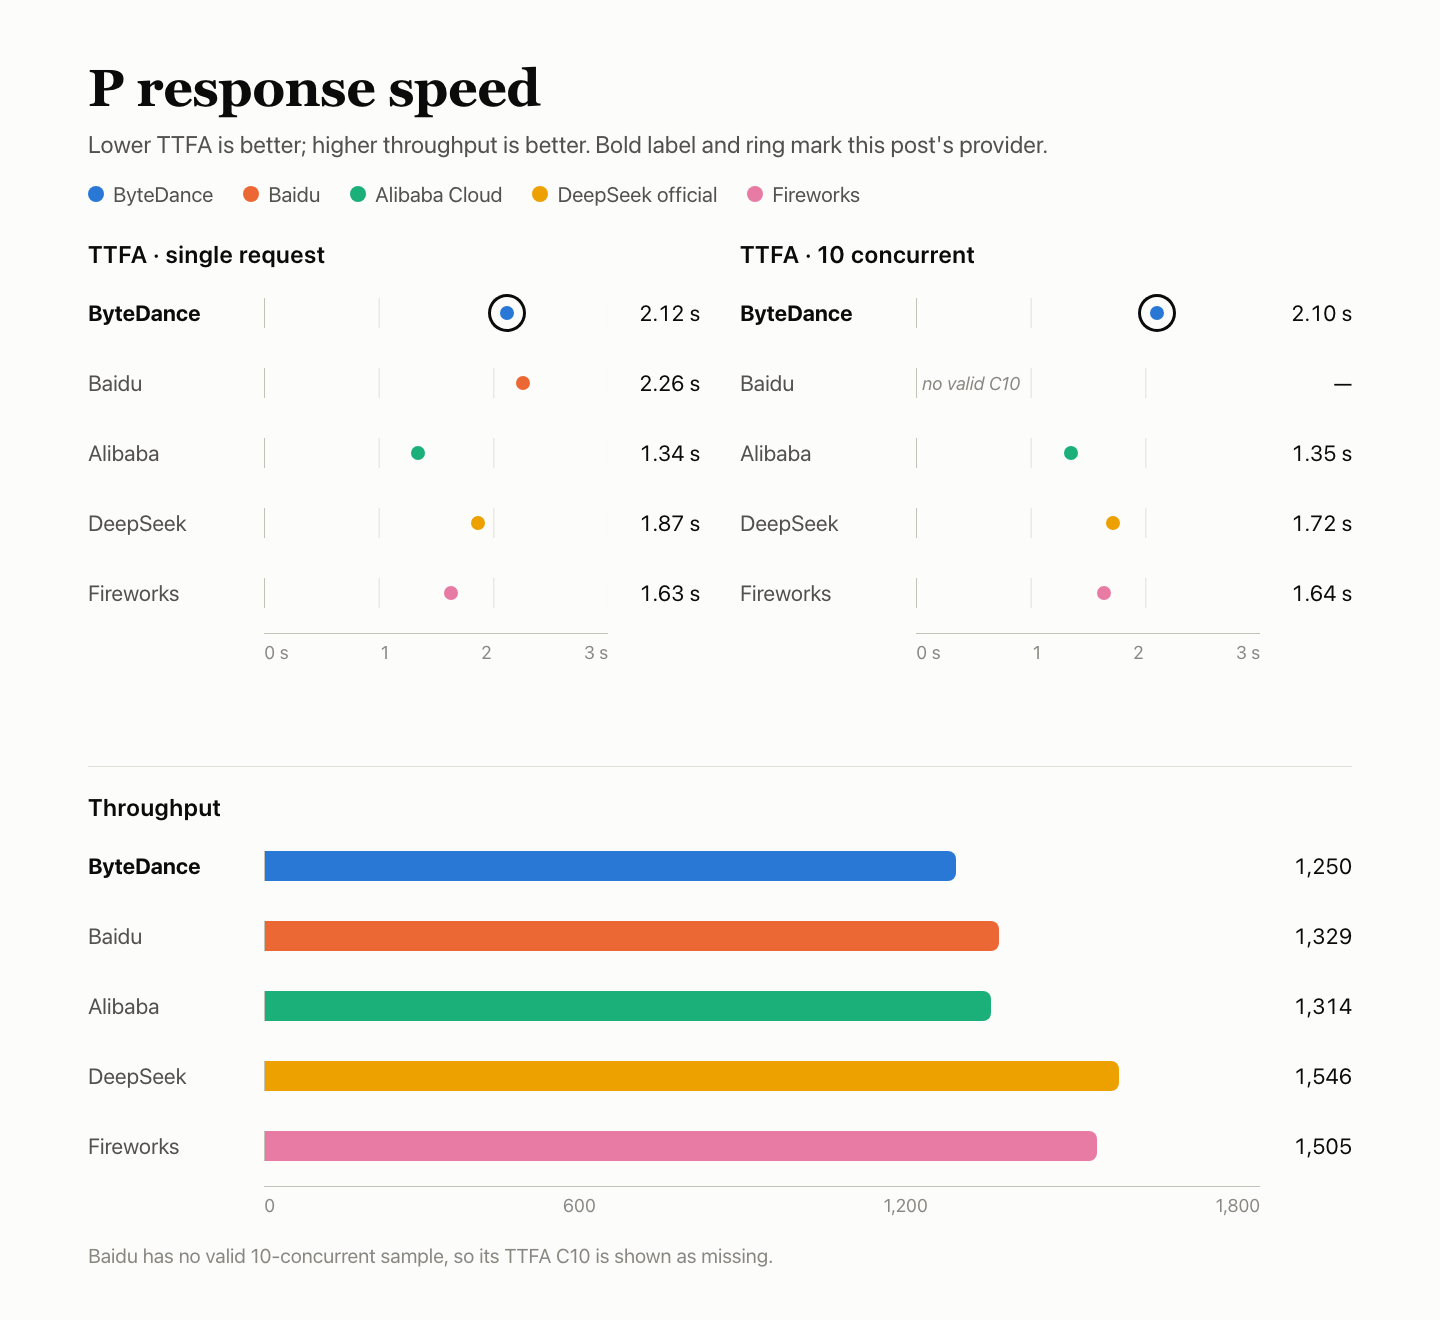
reasoning_effort=nonene désactive pas la réflexion. Une entrée de 10k tokens a été comptabilisée comme 10,026 tokens (comptage natif : 10,000) ; une entrée de 8 tokens a été comptabilisée comme 34. - P 84.37. Délai jusqu’au premier token du corps : médiane de 2.12 s à concurrence unique et de 2.10 s à 10 requêtes simultanées ; TPOT de 3.43 ms/token ; les 180 requêtes de mesure de la vitesse étaient toutes valides.
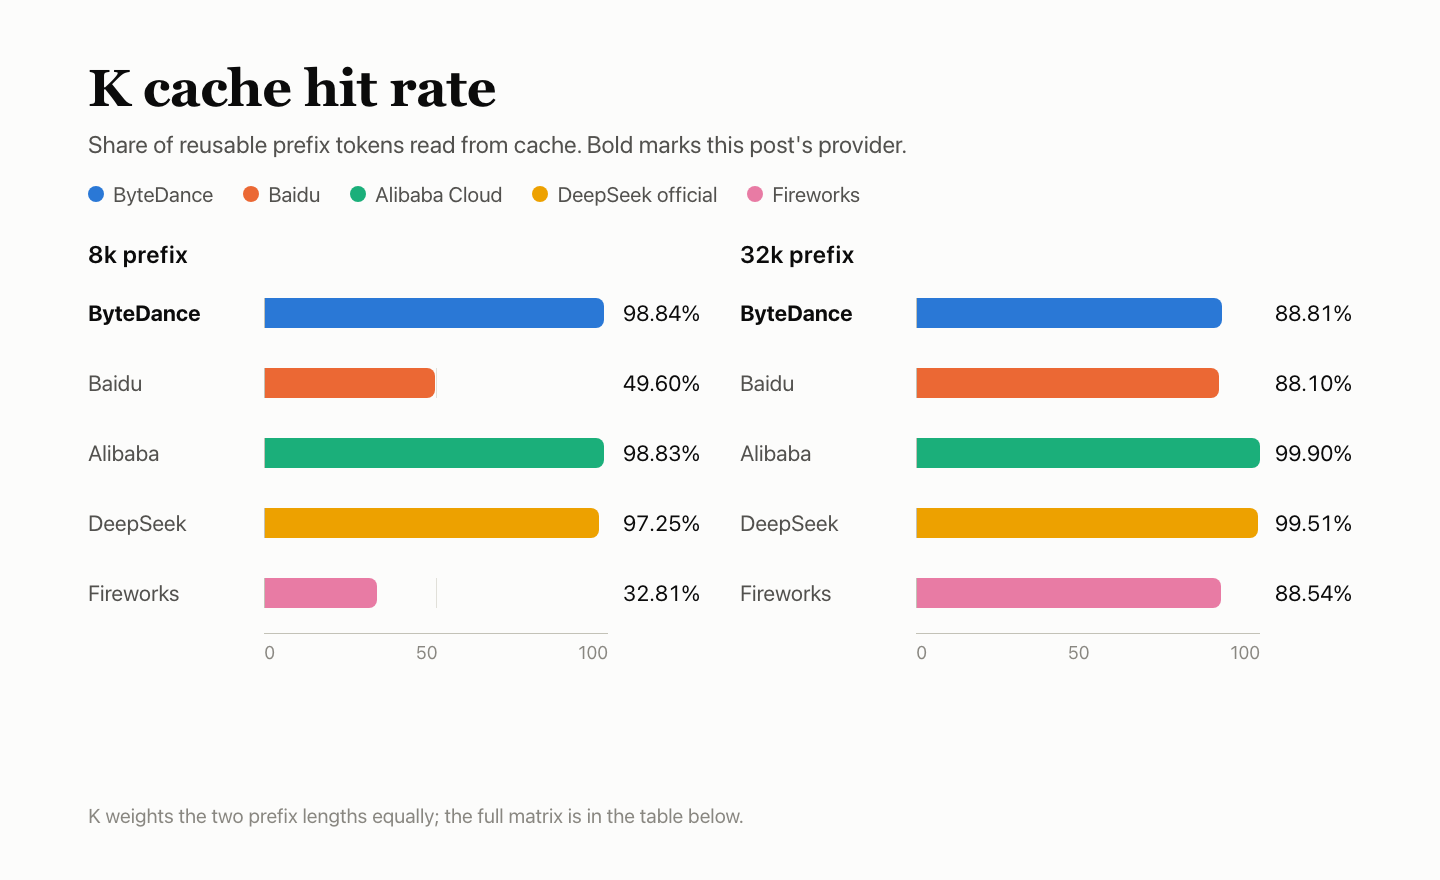
- K 93.83. Les requêtes à chaud de 8k ont réussi 9/9 fois ; celles de 32k, 8 fois, et une requête n’a pas abouti avant l’échéance de 300 s.
- R 100. Les 300 requêtes dédiées ont toutes réussi dès la première tentative.
Configuration du test
| Élément | Détail |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | doubao-deepseek-v4.1-flash-1017 |
| Nom du modèle renvoyé | deepseek-v4-1-flash-261017 |
| Route d’accès | Via AIHubMix, avec un ID de modèle propre au fournisseur, et non via une connexion directe au compte du fournisseur |
| Paramètres | Mode sans réflexion, temperature 1.0, max_tokens 16,384, délai d’expiration 300 s, aucune nouvelle tentative automatique |
| Réflexion désactivée | Les requêtes de qualité des réponses, de vitesse, de cache et de stabilité utilisaient thinking.type=disabled natif (pour ce fournisseur, reasoning_effort=none ne désactivait pas la réflexion) ; les cas de fonction conservaient reasoning_effort=none afin de vérifier si le paramètre prenait effet |
| Période | 2026-11-03 18:07 – 11-04 16:33 UTC+8 ; les cinq fournisseurs partageaient un Mac mini, un réseau et un compte |
| Échantillons | Qualité des réponses : 4,250 instances de questions (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10) ; fonctions : 60 cas × 3 fenêtres ; vitesse : 90 à concurrence unique et 90 à 10 requêtes simultanées ; stabilité : 300 ; cache : 30 (trois groupes chacun avec des préfixes de 8k et 32k) |
Les requêtes passaient par la route de démarrage rapide d’AIHubMix avec un ID propre au fournisseur, et les paramètres suivent la documentation de l’API de DeepSeek ; les autres ID de fournisseurs figurent sur la page des modèles.
Q — qualité des réponses : 42.05
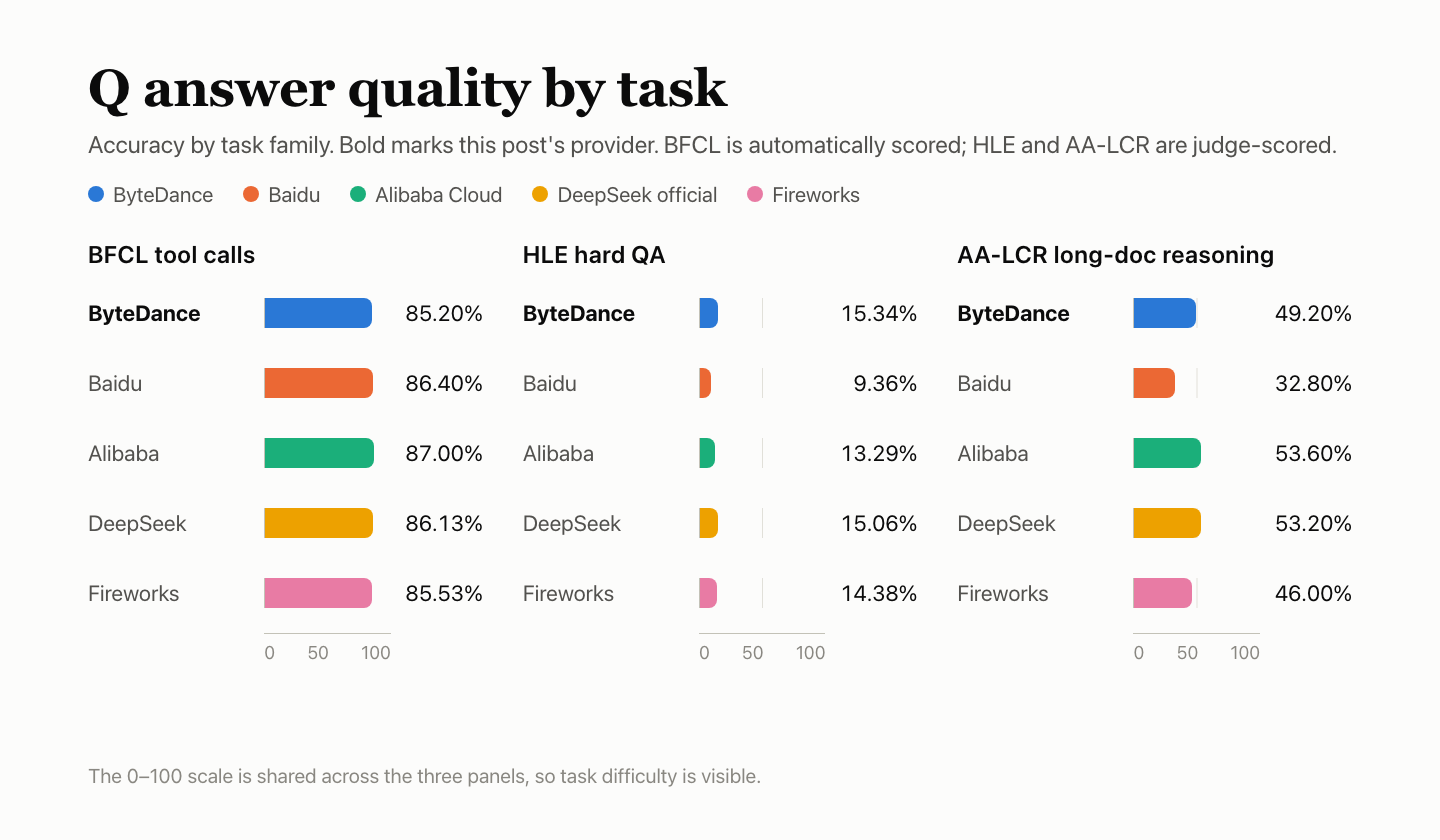
La qualité des réponses repose sur trois suites : 500 questions BFCL avec 3 tours chacune, 250 questions HLE avec 10 tours chacune et 25 questions AA-LCR avec 10 tours chacune. BFCL est évalué selon des règles automatiques ; HLE et AA-LCR sont évalués par le modèle deepseek-flash. Les cinq fournisseurs ont reçu les mêmes questions, et les trois suites sont regroupées en une seule mesure de précision. Dix réponses ont été retirées car la question ne pouvait pas être évaluée, ce qui laisse 4,240 instances de questions évaluées.
| Suite | Questions | Correctes | Précision | Échecs |
|---|---|---|---|---|
| Appels d’outil BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Questions-réponses difficiles HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Raisonnement sur de longs documents AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Combiné · intervalle à 95% : 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Les échecs de service — échecs de requête ou sortie tronquée — restent au dénominateur et sont comptabilisés comme des réponses incorrectes. La sortie HLE a atteint la limite max_tokens 7 fois ; AA-LCR a enregistré 28 échecs de requête, tous dans la fenêtre 1. BFCL est évalué automatiquement ; HLE et AA-LCR le sont par un modèle évaluateur.
Chaque question BFCL a reçu 3 réponses ; le tableau additionne les 3 tours.
| Catégorie BFCL | Réussites | Taux de réussite |
|---|---|---|
| simple_python — une fonction, appel et arguments corrects | 329/360 | 91.39% |
| multiple — choisir parmi plusieurs fonctions | 268/300 | 89.33% |
| parallel — appeler plusieurs fois la même fonction | 271/300 | 90.33% |
| parallel_multiple — appeler plusieurs fonctions différentes | 207/240 | 86.25% |
| irrelevance — aucune fonction n’est pertinente, ne pas faire d’appel | 102/150 | 68.00% |
| ahm_multi_turn — chaîne d’outils en trois étapes | 101/150 | 67.33% |
Comparaison avec les quatre autres
Différence par rapport au canal officiel, en points de pourcentage, avec l’intervalle à 95% représenté par des barres d’erreur. Si l’intervalle comprend 0, la différence est considérée comme non significative. Le modèle évaluateur de HLE et AA-LCR, deepseek-flash, appartient à la même famille DeepSeek que le modèle testé et n’a pas été calibré ; ses évaluations peuvent donc être indulgentes.
F — prise en charge des fonctions : 74.98
La suite de fonctions porte uniquement sur la conformité du comportement de l’interface au protocole, et non sur la qualité des réponses du modèle. Soixante cas répartis en six groupes ont été exécutés trois fois, une fois par fenêtre : 180 vérifications, évaluées selon le format documenté par chaque fournisseur. Les vérifications non applicables, invalides ou non observées sont exclues du dénominateur. ByteDance a réussi 124 des 174 vérifications comptabilisées et obtenu un score de 74.98 selon les pondérations des groupes.
Le score pondéré applique les pondérations des groupes ; il ne correspond pas au nombre de vérifications réussies divisé par 174.
| Groupe | Pondération | Réussites | Exclues | Score du groupe |
|---|---|---|---|---|
| Streaming et protocole de messages | 20% | 23/27 | 3 | 85.19 |
| Interface d’outil | 20% | 30/30 | — | 100.00 |
| Contraintes de sortie et paramètres | 20% | 24/30 | — | 80.00 |
| Contexte et état | 15% | 14/30 | — | 46.67 |
| Erreurs et récupération | 15% | 21/30 | — | 70.00 |
| Comptabilisation et protocole de cache | 10% | 12/27 | 3 | 44.44 |
| Total · score pondéré | — | 124/174 | 6 | 74.98 |
« Fenêtres échouées » indique le nombre des 3 fenêtres où la vérification a échoué.
| Cas en échec | Fenêtres en échec | Raison |
|---|---|---|
| Le raisonnement ne fuit pas dans le contenu — streaming et protocole de messages | 3/3 | Avec reasoning_effort=none, le contenu de réflexion était tout de même renvoyé |
| La configuration de la réflexion est prise en compte — contraintes de sortie et paramètres | 3/3 | Avec reasoning_effort=none, le contenu de réflexion était tout de même renvoyé |
| Diversité de l’échantillonnage — contraintes de sortie et paramètres | 3/3 | Les sorties avec une température de 0 et de 1 n’étaient pas suffisamment différentes ; elles n’atteignaient pas le seuil prédéfini |
| Entrée longue de 10k — contexte et état | 3/3 | Entrée comptabilisée : 10,026 tokens ; le comptage natif devrait être de 10,000 |
| Respect de la limite de contexte — contexte et état | 3/3 | Entrée comptabilisée : 10,026 tokens ; le comptage natif devrait être de 10,000 |
| Entrée longue de 32k — contexte et état | 3/3 | Entrée comptabilisée : 10,026 tokens ; le comptage natif devrait être de 10,000 |
| Entrée longue de 100k — contexte et état | 3/3 | Entrée comptabilisée : 10,026 tokens ; le comptage natif devrait être de 10,000 |
| Dépassement de la limite de contexte — contexte et état | 3/3 | Échec de connexion en amont ou délai d’attente dépassé (1) ; aurait dû renvoyer une erreur de paramètre, mais a renvoyé 200 (2) |
| Historique de 12 tours — contexte et état | 1/3 | Échec de connexion en amont ou délai d’attente dépassé |
| Erreur de format messages — erreurs et récupération | 3/3 | A renvoyé 400 avec un corps vide ; aucune explication structurée de l’erreur |
| Résultat d’outil orphelin — erreurs et récupération | 3/3 | Aurait dû renvoyer une erreur de paramètre, mais a renvoyé 200 |
| Erreur de format stream_options — erreurs et récupération | 3/3 | A renvoyé 400 avec un corps vide ; aucune explication structurée de l’erreur |
| Comptabilisation des tokens de réflexion — comptabilisation et protocole de cache | 3/3 | Tokens de réflexion comptabilisés alors que la réflexion était désactivée |
| Comptage natif de l’entrée — comptabilisation et protocole de cache | 3/3 | 34 tokens comptabilisés ; le comptage natif devrait être de 8 |
| Définitions d’outils incluses dans le comptage de l’entrée — comptabilisation et protocole de cache | 3/3 | La requête de contrôle sans outils ne correspondait déjà pas au comptage natif de l’entrée |
| Comptage de l’entrée cohérent avant et après le cache — comptabilisation et protocole de cache | 3/3 | Lorsque le même préfixe était répété, les tokens d’entrée comptabilisés ne correspondaient pas au comptage natif |
| Entrée cohérente en streaming et hors streaming — comptabilisation et protocole de cache | 3/3 | 34 tokens comptabilisés dans les deux cas ; le comptage natif devrait être de 8 |
| Texte de sortie exact — streaming et protocole de messages | 1/3 | Un point supplémentaire à la fin du corps ; le texte ne correspond pas exactement à celui demandé |
Ces vérifications sont exclues du dénominateur ; elles ne comptent ni comme réussites ni comme échecs.
| Statut | Cas | Nombre | Raison |
|---|---|---|---|
| Non observé | Séquences d’arrêt du streaming | 3 | Après l’étape précédente, cette requête n’a pas été envoyée ; impossible de l’évaluer |
| Non applicable | cache_control explicite | 3 | Enregistré à l’avance comme non pris en charge par cette interface |
Les cas d’erreur de format messages et stream_options ont échoué chez les cinq fournisseurs : les deux ont renvoyé 400 avec un corps vide, de sorte que les clients ne reçoivent aucune explication structurée de l’erreur. Un échec commun aux cinq se situe probablement au niveau de la passerelle AIHubMix et nécessite une enquête distincte. La comptabilisation des tokens de réflexion a également échoué chez les cinq, mais pour des raisons différentes : ByteDance et Fireworks ont comptabilisé des tokens de réflexion alors que celle-ci était désactivée ; les trois autres n’ont pas renvoyé de comptage des tokens de réflexion.
Comparaison avec les quatre autres
P — vitesse de réponse : 84.37
Chaque requête comportait environ 10,000 tokens d’entrée et demandait environ 1,100 tokens de texte dans le corps de la sortie. Dans chacune des trois fenêtres, 30 requêtes ont été exécutées à concurrence unique et 30 avec 10 requêtes simultanées : 180 requêtes au total.
| Métrique | Résultat |
|---|---|
| Attente jusqu’au premier token du corps (TTFA) | Médiane de 2.12 s à concurrence unique ; médiane de 2.10 s avec 10 requêtes simultanées |
| Vitesse de génération (TPOT) | 3.43 ms/token à concurrence unique ; 3.41 ms/token avec 10 requêtes simultanées |
| Débit effectif | 1,250.0 token/s avec 10 requêtes simultanées |
| Requêtes valides | 90/90 à concurrence unique ; 90/90 avec 10 requêtes simultanées |
| Scores des composantes | TTFA 48.59, TPOT 100.00, débit 100.00 ; les scores TTFA et TPOT retiennent le niveau le plus bas des deux paliers ; pondérations : 35% / 35% / 30% ; score de réponse : 82.00 |
| Score P | Score de réponse 82.00, pondéré à 80% ; cache K 93.83, pondéré à 20% ; total 84.37 |
Le TPOT est estimé à partir des segments diffusés en streaming ; il n’est pas mesuré token par token sur le matériel. Le débit correspond au nombre de tokens de sortie valides à concurrence de 10, divisé par la durée murale du lot.
Comparaison avec les quatre autres
Les cinq fournisseurs partageaient une machine, un réseau et un compte. Les trois fenêtres ont été planifiées fournisseur par fournisseur ; les périodes de collecte ne se chevauchent donc pas complètement. Il ne faut pas surinterpréter les petits écarts.
K — cache : 93.83
Chaque groupe envoie cinq requêtes. La première contient un préfixe fixe d’environ 8k ou 32k tokens et amorce le cache. Les requêtes 2–4 conservent le préfixe et ne changent que la question finale, respectivement après 5 s, 30 s et 120 s. La cinquième utilise un nouveau préfixe comme contrôle à froid. Trois fenêtres et deux longueurs, avec cinq requêtes par groupe, donnent 30 requêtes. K correspond aux tokens lus depuis le cache dans les requêtes à chaud, divisés par les tokens qui devraient être réutilisables selon les règles, avec une pondération égale pour les deux longueurs ; K compte pour 20% de P.
| Préfixe | Fenêtre | Amorçage | +5 s | +30 s | +120 s | Contrôle à froid |
|---|---|---|---|---|---|---|
| 8k | Fenêtre 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Fenêtre 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Fenêtre 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Fenêtre 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Fenêtre 2 | 0 | 32,000 | 32,000 | échec | 0 |
| 32k | Fenêtre 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Valeurs correspondant aux tokens lus depuis le cache et signalés par le serveur.
Les neuf requêtes à chaud de 8k ont toutes atteint le cache, en lisant chacune 7,936 tokens. Huit des neuf requêtes à chaud de 32k ont atteint le cache, en lisant chacune 32,000 tokens ; une requête a échoué. K est de 93.83, avec une pondération égale des deux longueurs. Les requêtes à froid n’ont lu aucun cache, ce qui distingue clairement les requêtes à chaud des requêtes à froid. La requête en échec est la quatrième du groupe 32k dans la fenêtre 2 ; elle a atteint l’échéance de 300 s sans aboutir.
Comparaison avec les quatre autres
R — stabilité du service : 100
Les 300 requêtes se répartissent en quatre types — texte court, longue entrée, appels d’outil et historique multi-tour — et ont été exécutées avec une concurrence de 1 dans trois fenêtres. Une requête ne compte comme réussie que si la première tentative renvoie une réponse valide et complète ; l’exactitude de la réponse n’est pas vérifiée et il n’y a pas de nouvelle tentative. Les échecs des sections sur la qualité des réponses et la vitesse sont comptabilisés dans Q et P, et non une seconde fois dans R.
| Type de requête | Succès à la première tentative |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appels d’outil | 60/60 |
| Historique multi-tour | 30/30 |
| Total · intervalle à 95% : 98.78%–100% | 300/300 |
Les 300 requêtes ont toutes renvoyé une réponse valide et complète dès la première tentative. R = 100 décrit uniquement ces 300 requêtes dédiées ; cela ne signifie pas que toute la chaîne n’a connu aucun échec. La borne inférieure de l’intervalle à 95% est de 98.78% : 300 succès permettent seulement d’affirmer que le taux d’échec est probablement inférieur à 1.22%.
Comparaison avec les quatre autres
R ne couvre que ces 300 requêtes dédiées ; les échecs des sections sur la qualité des réponses et la vitesse sont comptabilisés dans Q et P, et ne sont pas comptés une seconde fois dans R.
| Fournisseur | Succès à la première tentative | Intervalle à 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officiel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
reasoning_effort=none n’a-t-il vraiment pas désactivé le mode de réflexion ?
Oui. Dans les trois fenêtres, les requêtes avec reasoning_effort=none ont tout de même renvoyé du contenu de réflexion ; le contrôle a donc échoué 3/3 fois. Les requêtes des tests de qualité des réponses, de vitesse, de cache et de stabilité ont plutôt utilisé le commutateur natif thinking.type=disabled. La suite de tests de fonctions a conservé reasoning_effort=none volontairement, afin de vérifier si le paramètre prenait effet.
La précision BFCL est de 85.20%. Pourquoi Q est-il de 42.05 ?
Q regroupe trois suites de difficultés très différentes. BFCL a contribué 1,278 réponses correctes sur 1,500, HLE 382 sur 2,490 et AA-LCR 123 sur 250. Au total, 1,783 des 4,240 instances de questions évaluées étaient correctes : 42.05%. Le résultat de 15.34% de HLE fait baisser le score global.
Les 35 échecs de requêtes de Q sont-ils inclus dans le score ?
Oui. Les échecs de requêtes et les sorties tronquées restent dans le dénominateur et comptent comme des réponses incorrectes. Sept réponses HLE ont été tronquées à max_tokens ; 28 requêtes AA-LCR ont échoué, toutes dans la fenêtre 1.
Pourquoi la comptabilisation des tokens d’entrée est-elle importante ?
Parce que la facturation doit correspondre au décompte natif du modèle. Une entrée de 10k tokens a été déclarée comme contenant 10,026 tokens (10,000 en décompte natif), et une entrée de 8 tokens a été déclarée comme en contenant 34. La requête de contrôle sans outils présentait déjà un écart, et le streaming comme le non-streaming ont tous deux déclaré 34. Les cinq contrôles de comptabilisation ont tous échoué, 3/3.
Le résultat du cache pour 32k correspond-il à un défaut de cache ou à un échec ?
À un échec. Huit des neuf requêtes à chaud de 32k ont atteint le cache et lu 32,000 tokens. Le seul défaut de cache concerne la quatrième requête de la fenêtre 2, qui a atteint l’échéance de 300 s sans aboutir. Le groupe 8k a atteint le cache 9/9 fois, avec 7,936 tokens lus.
Peut-on distinguer la qualité des réponses de ByteDance de celle du canal officiel ?
Non. La précision combinée est inférieure de 0.40 point à celle du canal officiel, avec un intervalle à 95% allant de −1.46 à +0.66. Comme l’intervalle inclut 0, les deux ne sont pas distinguables. Cela décrit uniquement ce lot et ne constitue pas un classement.
À lire ensuite : la série DeepSeek V4.1 Flash
- La référence Q de cet article est le canal officiel ; son propre test, y compris les 15 sondes invalides à concurrence unique, est présenté dans DeepSeek V4.1 Flash sur le canal officiel : 94.00 F, 15 sondes invalides.
- Baidu est le seul fournisseur dont l’intervalle Q se situe sous celui du canal officiel ; les échecs de canal à l’origine de ce résultat sont présentés dans DeepSeek V4.1 Flash sur Baidu : aucun canal disponible n’atteint Q et P.
- Les chiffres du cache d’Alibaba Cloud sont à rapprocher des 93.83 indiqués ici : DeepSeek V4.1 Flash sur Alibaba Cloud : premier token en 1.34s, cache à 99.37.
- Fireworks présente les mêmes échecs liés au mode de réflexion et à la comptabilisation des tokens que ceux observés ici, auxquels s’ajoutent des réponses d’arrêt vides : DeepSeek V4.1 Flash sur Fireworks : réponses d’arrêt vides, 3/9 accès au cache.


