Anthropic lanzó Claude Fable 5.2 el 9 de noviembre de 2026. Google llevó Gemini 4 Carbon a disponibilidad general un día después. La propia tabla de benchmarks de lanzamiento de Anthropic incluye una columna para Carbon, lo que permite comparar ambos modelos en la misma tarea de programación de largo horizonte.
Ambos modelos se ofrecen para la misma tarea: programación agéntica de largo horizonte. El agente lee un repositorio, edita varios archivos, ejecuta comandos, lee los resultados de las pruebas y sigue trabajando durante 15 a 45 minutos sin intervención humana. Esa es la tarea que se evalúa aquí. El chat, la autocompletación y los scripts cortos son pruebas distintas.
La respuesta breve
Fable 5.2 lidera los benchmarks de programación exigentes de la lista y es más rápido con el mismo esfuerzo; ocupa los tres primeros puestos de AA por delante de Carbon High, que queda en el puesto n.º 4. Carbon obtiene mejores resultados en las filas indicadas de Terminal-Bench 4.0 y AutomationBench-AA, y cuesta menos por tarea con esfuerzo High hasta que termina el precio promocional de Google el 30 de noviembre. Con esfuerzo Medium, Fable cuesta menos y es mucho más rápido, mientras que Carbon obtiene una puntuación más alta en el índice AA.
Elige Fable para el razonamiento de programación exigente y Carbon para la ejecución en terminal y la automatización; comprueba los límites de entrada, retención y salida antes de elegir cualquiera de los dos.
Qué muestra un mismo entorno de evaluación
Artificial Analysis evalúa todos los modelos con el mismo entorno y las mismas tareas; sus páginas de Carbon y Fable incluyen los resultados de cada evaluación. Las cifras corresponden a la instantánea del 11 de noviembre de 2026; AA utiliza los precios de lista estándar, no el descuento promocional de Google.
| Modelo | Índice AA | $/tarea | Min/tarea | Primer token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Nota: índice de inteligencia de AA y costo por tarea a precios estándar; instantánea del 2026-11-11T05:23Z. Fable Max, Xhigh y High ocupan los puestos n.º 1 a n.º 3; Carbon High queda en el n.º 4; Opus 5.5 Max, en el n.º 5; y Carbon Medium, en el n.º 6. «Primer token» es el tiempo que tarda en llegar el primer token de respuesta.
Con esfuerzo High, Fable aventaja a Carbon por 1.79 puntos, cuesta un 17.0% más por tarea ($9.08 frente a $7.76), termina en 17.3 minutos en lugar de 25.6 y devuelve el primer token en 30.4 segundos en lugar de 67.1. Max cuesta $26.54 por tarea, 3.4 veces más que Carbon High, y tarda 233.9 segundos.
Con Medium cambia el orden: Fable obtiene 56.41 frente a los 58.26 de Carbon, 1.85 puntos menos, pero cuesta $3.80 frente a $6.59 y tarda 7.8 minutos frente a 23.3. El menor precio por token de Carbon no lo hace más barato por tarea en este caso: consume más tokens.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| % sin alucinaciones | 88.58 | 42.02 | 40.73 | 49.66 |
| Precisión % | 58.27 | 77.23 | 79.13 | 65.5 |
| Elo de Briefcase | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Nota: Artificial Analysis, mismo entorno y misma instantánea. «Sin alucinaciones» es la proporción de respuestas de Omniscience que no contienen afirmaciones inventadas; la precisión es una puntuación distinta. Un valor más alto es mejor en todas las filas. Se omite Fable Xhigh para que la tabla sea más legible; su puntuación en FrontierCode 2.0 es 47.58.
¿Qué modelo lidera cada prueba con esfuerzo High? La diferencia con signo que aparece a continuación resta Fable a Carbon; así se ve la dirección, mientras que la tabla de arriba muestra las puntuaciones absolutas.
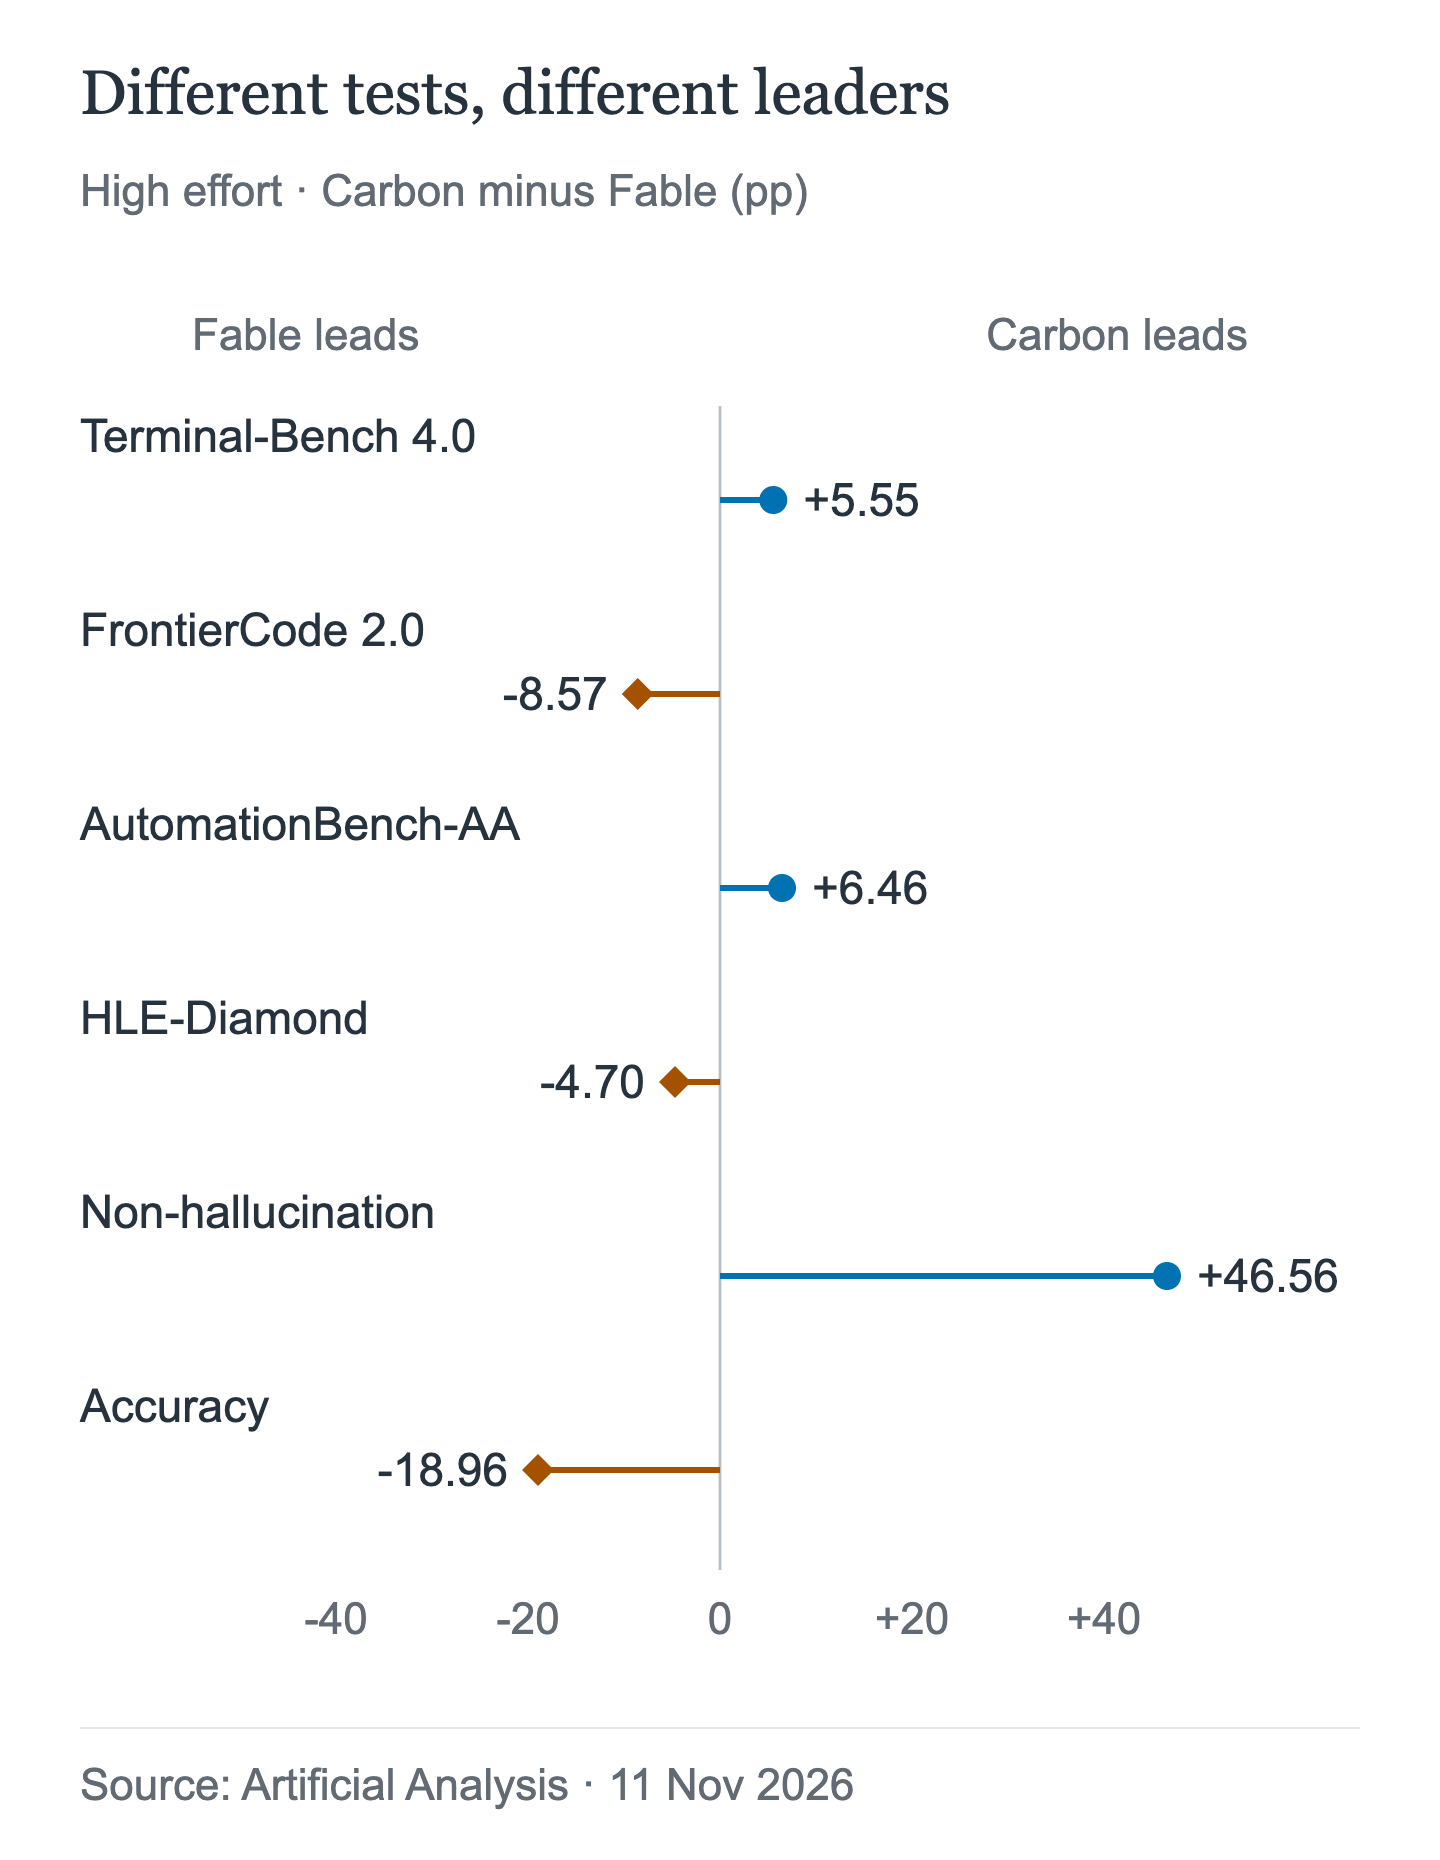
Son diferencias en puntos porcentuales entre pruebas independientes, no una puntuación de calidad combinada. Una diferencia mayor en un benchmark no significa una mejora general mayor en la capacidad. En particular, «sin alucinaciones» y precisión miden resultados distintos.
Fable supera a Carbon por 8.57 puntos en FrontierCode 2.0 con High y por 4.7 en HLE-Diamond; su Elo de Briefcase es 1677.4 frente a 1610.6. FrontierCode es el benchmark que más se aproxima a cambios de código difíciles que afectan a varios archivos. Carbon supera a Fable por 5.55 en Terminal-Bench 4.0 y por 6.46 en AutomationBench, que evalúan la ejecución en la línea de comandos, la recuperación ante errores y la automatización.
La diferencia en ausencia de alucinaciones es la mayor de la tabla: 88.58% para Carbon frente a 42.02% para Fable con High. La precisión va en sentido contrario: 58.27% frente a 77.23%. Carbon tiene menos probabilidades de inventar datos, pero también menos de responder correctamente. Para un agente que no debe inventarse una API, eso puede ser importante; para uno que debe dar la respuesta correcta, la precisión de Fable es una señal más favorable.
Un mayor esfuerzo no siempre es mejor: el 48.76 de Fable Max en FrontierCode queda ligeramente por debajo del 49.13 de High, y Terminal-Bench se mantiene en 59.6.
La tabla de la propia Anthropic
La página de lanzamiento de Anthropic publica una tabla comparativa entre proveedores que incluye a Carbon. La configuración difiere de la de AA: Fable se evalúa con Xhigh, su nivel de esfuerzo más alto publicado, y Carbon con Medium. Esta tabla solo debe compararse internamente.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Elo de Briefcase | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Nota: datos publicados por Anthropic. Fable con Xhigh, su nivel de esfuerzo más alto disponible; Carbon con Medium. La escala de AutomationBench de Anthropic difiere de la de AA (51.4/53.9 frente a 71.36/77.82), así que compara los resultados dentro de esta tabla. El 41.1 de Carbon en FrontierCode corresponde a una ejecución con Medium; el 40.56 de AA corresponde a High en un entorno distinto.
La tendencia coincide con la de AA: Fable lidera en FrontierCode, FrontierSWE, OSWorld y TB-Science; Carbon lidera en AutomationBench por 2.5 puntos, menos que los 6.5 de AA, pero en la misma dirección. La tabla respalda que «Carbon es competitivo en automatización», no que «Carbon sea el mejor modelo para programación exigente».
La recomendación de la propia Anthropic complica la idea de que «Fable es la mejora»: «Para la mayoría de las tareas de programación y conocimiento, recomendamos empezar con Claude Opus 5.5». Según la empresa, con esfuerzo High Fable obtiene una puntuación similar a la mejor de Opus 5.5 (45.3% frente a 45.5%) por aproximadamente la mitad del costo por tarea.
Cuánto cuestan los tokens
| Modelo | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| Carbon, hasta el 30 de noviembre | $2 | $10 | $0.10 |
| Carbon, desde el 1 de diciembre | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Nota: USD por 1M de tokens; precios oficiales. Escrituras en caché de Fable: $10 (5 min) o $16 (1 hora); Batch tiene un 50% de descuento. La cifra de caché de Carbon es el precio de lectura; el precio oficial de lectura de caché de Opus 5.5 es $0.20.
El precio por token de Fable duplica la tarifa estándar de Carbon y cuadruplica su tarifa promocional. La proporción es sencilla; la factura por tarea, no. AA midió $7.76 por tarea para Carbon High a $4/$20, frente a $9.08 para Fable High, una diferencia del 17.0%. Con la tarifa de Google de $2/$10, el mismo uso costaría unos $3.88, según un cálculo estimado. Hasta el 30 de noviembre, Fable High cuesta aproximadamente 2.3 veces más por tarea; desde el 1 de diciembre, la diferencia vuelve al 17.0%.
A precios estándar, Fable Medium cuesta $3.80 frente a los $6.59 de Carbon, un 42% menos pese a que su precio por token es el doble. Carbon tarda 23.3 minutos y consume más tokens; Fable tarda 7.8. Con la tarifa promocional, Carbon Medium costaría alrededor de $3.30, calculado del mismo modo, casi lo mismo que Fable; esa ventaja desaparece el 1 de diciembre.
Max cuesta 3.4 veces más por tarea que Carbon High ($26.54) y tarda 45.2 minutos. Gastar más no garantiza un agente de programación mejor en todos los aspectos: el resultado de Max en FrontierCode queda ligeramente por debajo del de High.
AIHubMix ofrece Carbon al precio promocional de Google. Las cifras de Fable corresponden a las tarifas oficiales de Anthropic.
Diferencias de comportamiento que determinan las implementaciones
| Dimensión | Carbon | Fable 5.2 |
|---|---|---|
| Salida máxima | 65,536; nativo ≤1,048,576−entrada* | 128,000 |
| Contexto | 1,048,576 (nativo de Google) | 1M |
| Pensamiento | low / medium / high; predeterminado: medium | adaptativo; predeterminado: high |
| Herramientas forzadas | auto documentado* | cualquier opción / la herramienta devuelve 400 |
| Muestreo | se ignora; eliminar | algunos valores devuelven 400 |
| Retención | no se indica como límite | 30 días; sin ZDR |
| Entrada | texto en AIHubMix | texto, imagen, PDF† |
| Fecha de corte | Marzo de 2026 | Junio de 2026 |
Nota: *Los límites superiores de Carbon corresponden a las capacidades nativas de Google para generar secuencias largas; AIHubMix solo documenta actualmente entradas de texto y Chat Completions, por lo que no está confirmado que la pasarela sea compatible. †Las modalidades de entrada de Fable proceden del índice de modelos de AIHubMix. *AIHubMix documenta tool_choice="auto", pero no está confirmada la compatibilidad específica con Carbon. El límite de salida documentado del modelo Fable es 128,000. ZDR significa retención cero de datos.
El uso forzado de herramientas es un bloqueo importante para Fable: «El uso forzado de herramientas (los tipos any y tool de tool_choice) devuelve un error 400». Un agente que deba llamar a una herramienta específica en cada turno no puede usar Fable sin cambios. La guía de Carbon de Google recomienda turnos secuenciales de ejecución de herramientas; AIHubMix documenta tool_choice="auto" en su guía de Gemini, pero aún no está confirmada la compatibilidad de la pasarela con las herramientas de Carbon.
La retención supone un bloqueo normativo para Fable: su descripción general indica que «requiere una retención de datos de 30 días y no está disponible con retención cero de datos, salvo autorización expresa de Anthropic». La documentación de Carbon consultada aquí no menciona esa restricción; eso no constituye una garantía. Los equipos sujetos a regulación deberían confirmar ambas políticas antes de la implementación.
El límite estándar de 65,536 tokens de Carbon cubre la mayoría de las ediciones; la generación de archivos enteros puede alcanzarlo. El modo en segundo plano nativo de Google puede llegar hasta 1,048,576 menos la entrada, factura cada salto de segmento y puede devolver incomplete con el texto vacío aunque se cobre. AIHubMix no ha documentado esa vía. Fable puede generar 128,000 tokens en una sola respuesta.
Ninguno de los modelos permite desactivar el pensamiento. Carbon ofrece low, medium y high, usa medium de forma predeterminada e ignora los parámetros de muestreo. El «pensamiento adaptativo siempre está activado y no se puede desactivar» en Fable, que usa high de forma predeterminada y devuelve 400 con algunos valores de muestreo.
Google puso Carbon a disposición de los defensores a través de su programa Fairwind antes de la disponibilidad general. Los clasificadores de Fable bloquean solicitudes de pruebas de penetración y explotación, y recurren a otros modelos para tareas de ciberseguridad y biología. En pruebas de seguridad, el comportamiento ante las negativas importa más que una fila de un benchmark.
Opus 5.5 como referencia
Opus 5.5 no es el rival, sino la referencia que usa la propia Anthropic. A $4/$20 obtiene 59.11 en AA, cuesta $10.04 por tarea, tarda 25.0 minutos y espera 356.4 segundos hasta el primer token, el tiempo más largo de la tabla (la fila de AA corresponde al esfuerzo Max; el valor predeterminado es medium). Lidera en Elo de Briefcase con 1800.6, pero queda por detrás de Fable High en FrontierCode y de Carbon High en Terminal-Bench. Aun así, Anthropic recomienda empezar con Opus 5.5 para la mayoría de las tareas de programación.
Quién debería elegir cada modelo
Elige Fable 5.2 si predominan los cambios de código exigentes y quieres los mejores resultados medidos en FrontierCode y HLE. Con Medium cuesta menos y es más rápido: $3.80 y 7.8 minutos frente a los $6.59 y 23.3 de Carbon, aunque Carbon obtiene una puntuación más alta en el índice AA. Elígelo si necesitas entrada de imágenes, una fecha de corte de junio de 2026 o si te resultan aceptables la retención de 30 días y la imposibilidad de forzar llamadas a herramientas.
Elige Carbon cuando predomine el trabajo en terminal: ciclos de pruebas y correcciones, automatización de shell y operaciones de varios pasos. Obtiene puntuaciones más altas en las filas indicadas de Terminal-Bench 4.0 y AutomationBench-AA, y es más barato con esfuerzo Alto hasta el 30 de noviembre. AIHubMix no confirma los límites de contexto nativos de Google ni los límites de salida larga; impleméntalo solo con texto y tool_choice="auto" únicamente después de confirmar que Carbon es compatible con las herramientas. Su puntuación de no alucinación es más alta, mientras que su precisión es menor.
Elige Opus 5.5 como punto de partida recomendado por Anthropic y por su perfil equilibrado; acepta que el primer token tarda en llegar con el esfuerzo Máximo.
No elijas ninguno si necesitas baja latencia interactiva: los primeros tokens con esfuerzo Alto tardan 30.4 segundos en Fable y 67.1 en Carbon, y los 23.2 de Carbon con esfuerzo Medio siguen estando muy lejos de la velocidad de un chat.
Usa ambos a través de AIHubMix
AIHubMix ofrece ambos modelos con una sola clave y un endpoint compartido de chat completions. El ID de Carbon es gemini-4-carbon; la página del modelo documenta chat completions, entrada de texto y el precio introductorio de Google. El ID de Fable 5.2 es claude-fable-5-2; AIHubMix incluye Chat Completions, Responses y Anthropic Messages, con un contexto de 1M y una salida máxima de 128K. La interfaz documentada de Carbon es más limitada: chat completions, no la API nativa de Gemini. Además, la pasarela vuelve a intentar la solicitud con el siguiente proveedor más adecuado, por lo que el comportamiento puede diferir del de una implementación con un único proveedor.
La guía de inicio rápido explica la autenticación y la URL base. Una prueba de humo puede comprobar si ambos ID se resuelven con la misma clave; no se ejecutó ninguna prueba en vivo para este borrador:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Esto comprueba el enrutamiento, no las capacidades: no incluye herramientas ni una salida larga. Para una comparación real, ejecuta el mismo registro de agente con ambos ID y registra el tiempo de la tarea, el uso de tokens y los fallos. La página de comparación presenta lado a lado el contexto, los protocolos y los precios.
Preguntas frecuentes
¿Gemini 4 Carbon es mejor que Fable 5.2 para la programación agéntica?
Ninguno gana en todos los aspectos del trabajo. Fable 5.2 lidera FrontierCode 2.0 y el índice general con esfuerzo Alto; Carbon lidera Terminal-Bench 4.0 y AutomationBench. Elige según la carga de trabajo que realmente ejecuta el agente.
¿Por qué Fable 5.2 cuesta cuatro veces más que Carbon?
Con las tarifas oficiales, Fable cuesta $8/$40 por millón de tokens frente al precio introductorio de Carbon, de $2/$10: cuatro veces más tanto para la entrada como para la salida. Frente a la tarifa estándar de Carbon, de $4/$20 a partir del 1 de diciembre, cuesta el doble.
¿De verdad Fable 5.2 cuesta menos por tarea con esfuerzo Medio?
A precios estándar, sí: $3.80 frente a $6.59 con Carbon y esfuerzo Medio, y 7.8 minutos frente a 23.3. El precio introductorio por token de Carbon reduce la diferencia; la comparación con las tarifas estándar es la que se mantiene en el tiempo.
¿Puede Fable 5.2 forzar una llamada a herramienta?
No. Anthropic documenta que los valores any y tool de tool_choice devuelven un error 400. Los agentes que necesiten forzar una llamada requieren un ciclo distinto u otro modelo.
¿Es menos probable que Carbon alucine que Fable 5.2?
Según la medida de no alucinación Omniscience de AA, sí: 88.58% frente a 42.02% con esfuerzo Alto. Su precisión es menor, 58.27% frente a 77.23%, así que también es menos probable que dé la respuesta correcta.
¿Se pueden usar ambos modelos a través de AIHubMix con una sola clave?
Sí. Usa gemini-4-carbon y claude-fable-5-2 con la misma clave y URL base. AIHubMix documenta chat completions para Carbon, y chat completions, Responses y Messages para Fable.
Sigue leyendo: la serie Gemini 4 Carbon
- Antes de elegir un rival, resuelve la cuestión entre modelos hermanos: Gemini 4 Carbon vs Argon: mismo precio, ¿cuándo vale la pena elegir Carbon?
- Una vez que Carbon forma parte del ciclo, los primeros errores 400 y tiempos de espera agotados suelen deberse a la configuración, no al modelo: Migración de la API de Gemini 4 Carbon: errores 400, tiempos de espera agotados y límites de salida
Fuentes
- Gemini 4 Carbon ya está disponible — Google, 10 de noviembre de 2026.
- Claude Fable 5.2 — Anthropic, 9 de noviembre de 2026.
- Descripción general de Claude Fable 5.2 — Documentación de Anthropic.
- Gemini 4 Carbon y Claude Fable 5.2 — Artificial Analysis, instantánea del 11 de noviembre de 2026.
- Gemini 4 Carbon en AIHubMix — página del modelo y precios.