

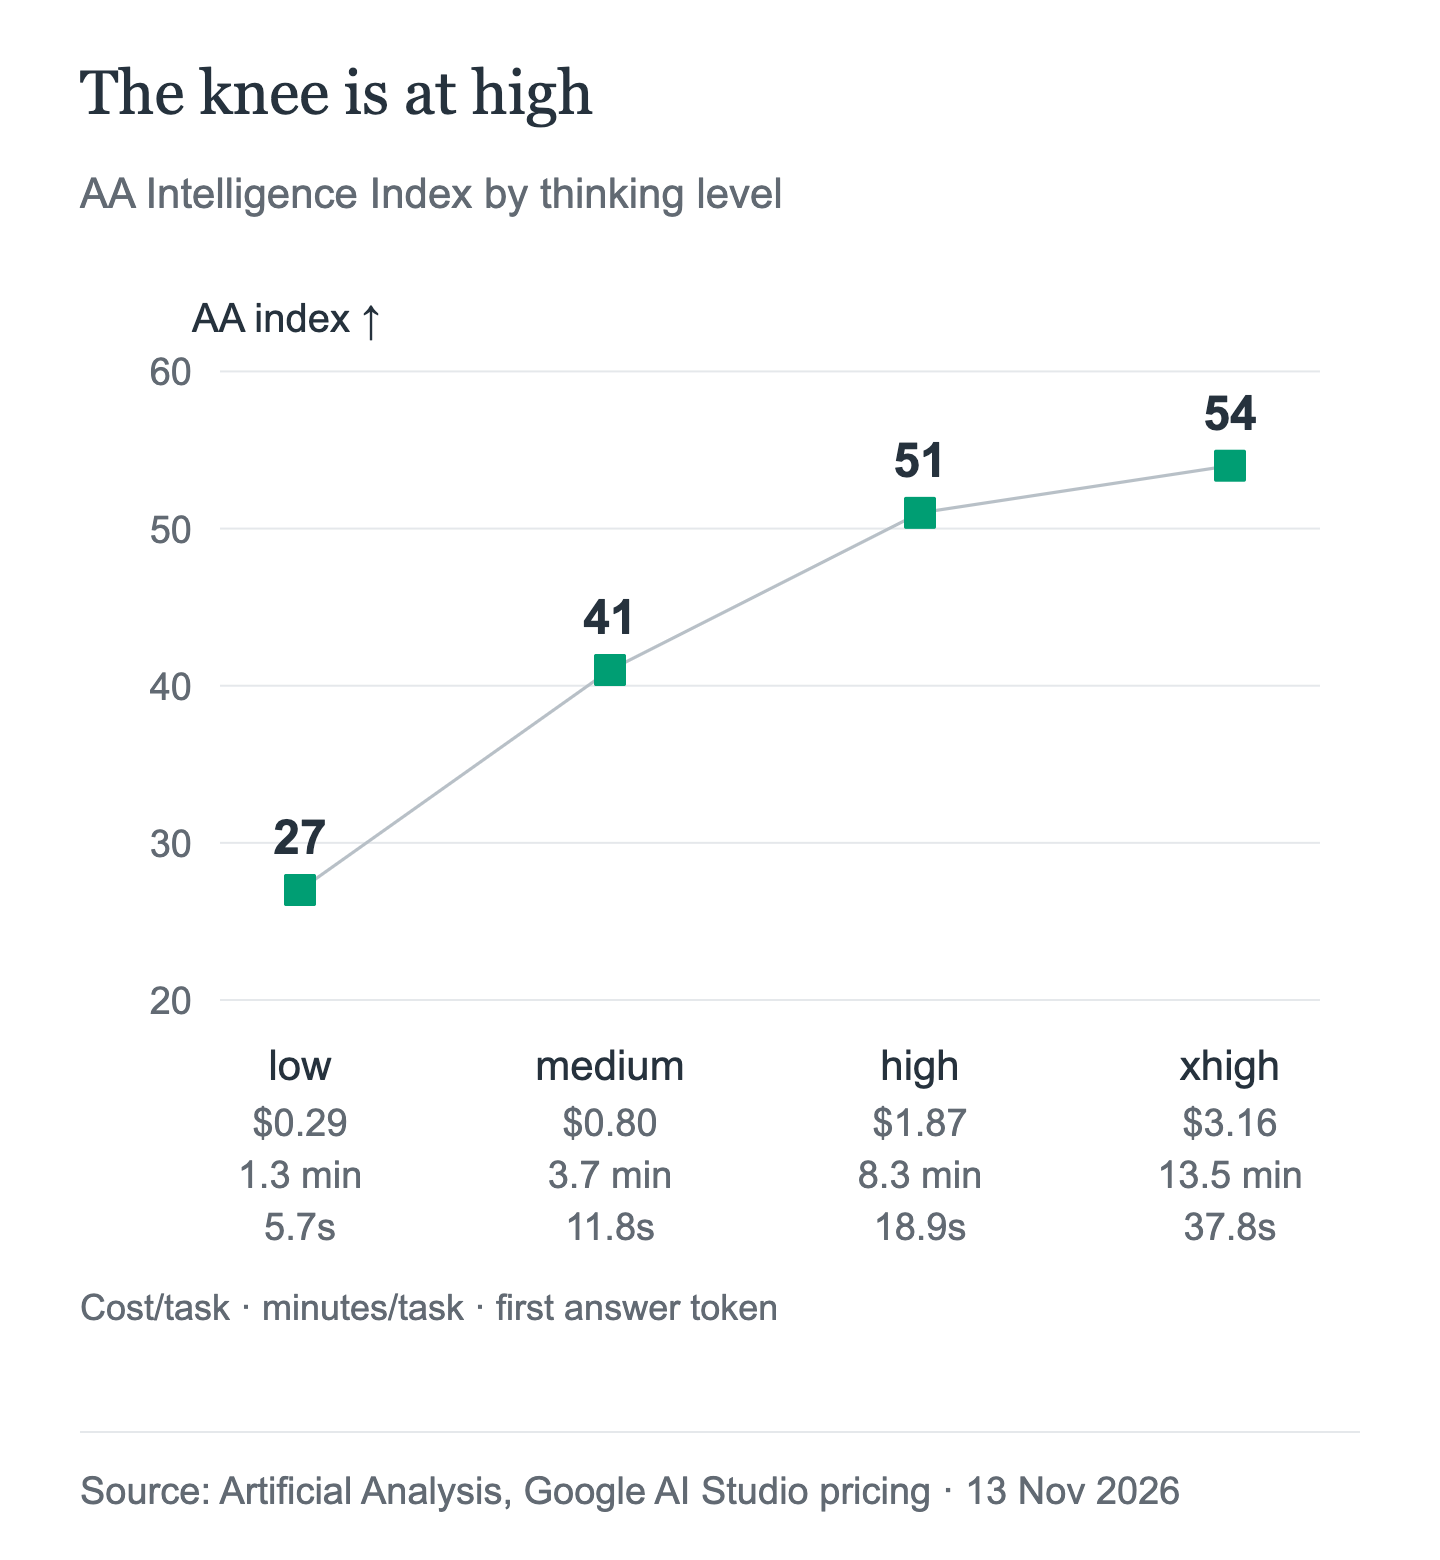
Gemini 4 Hydrogen има четири нива на мислене и те се държат като четири различни модела. Според текущите измервания на Artificial Analysis един и същ модел получава резултат 27 при low, 41 при medium, 51 при high и 54 при xhigh. По подразбиране е high, а xhigh е ново за семейството Gemini 4: Carbon и Argon достигат само до high.
Разликата е голяма: при един и същ модел има 27 индексни пункта между low и xhigh. Преминаването от medium към high носи 10 индексни пункта срещу около $1.07 повече на задача. Преминаването от high към xhigh носи 3 пункта срещу $1.29 и почти удвоява чакането до първия токен отговор. Практическият извод е да започнете с high, да запазите xhigh за сложни задачи с няколко стъпки и да третирате low и medium като настройки за латентност, чиято качество трябва да проверите отделно.
По-долу: за какво служи всяко ниво, колко струва, какво се променя в API и какво AIHubMix документира и какво не.
Четирите нива и какво се промени
Gemini 4 Hydrogen поддържа low, medium, high и xhigh. Бележките за изданието на Google го казват директно: „Моделът по подразбиране е high и въвежда xhigh.“ Това са две промени спрямо Gemini 3.8 Flash, чието ниво по подразбиране е medium и което достига само до high.
Останалата част от семейството не се е променила. Carbon и Argon поддържат low, medium и high, като medium е нивото по подразбиране. Hydrogen е единственият модел Gemini 4 с настройка над high.
| Модел | Нива | По подразбиране |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL не е сред поддържаните нива. В документацията за мисленето на Gemini 4 се казва, че MINIMAL „не се поддържа при моделите Gemini 4“, а в бележките за изданието на Hydrogen Google посочва, че моделът „отхвърля minimal с грешка“. За този модел няма документирана опция за изключване на мисленето.
Какво препоръчва Google
Насоките на Google са разумна отправна точка, но са написани преди измерванията по-долу. По-специално препоръката за medium при интерактивно програмиране предполага качество, което Artificial Analysis не отчита при medium.
| Ниво | Описание и препоръчителна употреба от Google |
|---|---|
| low | „Най-малко токени, най-ниска латентност“ — бърз чат, голям обем |
| medium | „По-малко токени, по-бързи отговори“ — интерактивно програмиране, прототипи на потребителски интерфейси |
| high | „Баланс между интелигентност и скорост“ — по подразбиране за повечето задачи |
| xhigh | „Най-много токени, най-задълбочени разсъждения“ — сложни задачи по програмиране с няколко стъпки |
Към таблицата има две предупреждения. „Използването на xhigh увеличава латентността и броя токени и може да доведе до прекалено обмисляне при по-прости промптове“, казва Google. Съветът за оценяване също е изричен: „Проведете оценяването и на четирите нива с висока стойност на max_output_tokens.“
Измерената скала
Artificial Analysis измери и четирите нива. Измерването е по Intelligence Index v5.0.1, сред 78 модела в класацията, с данни към 2026-11-13T02:40Z и стандартни цени от публичната тарифа. Това са разходи за задача по AA, а не сметки от AIHubMix.
| Ниво | Ранг по AA | Индекс по AA | $/задача | Мин./задача | Първи токен отговор |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Полезната част са разликите между нивата:
lowкъмmedium: +14 индексни пункта, +$0.51 на задача, +2.4 минути, +6.1 секунди до първия токен.mediumкъмhigh: +10 индексни пункта, +$1.07 на задача, +4.6 минути, +7.1 секунди до първия токен.highкъмxhigh: +3 индексни пункта, +$1.29 на задача, +5.2 минути, +18.9 секунди до първия токен.
high е преломната точка. Това е последната стъпка, при която подобрението в качеството е голямо спрямо допълнителния разход; при xhigh чакането до първия токен почти се удвоява срещу малко увеличение на индекса. Това не означава, че xhigh е лоша настройка. Означава, че е подходяща за задачи, с които high не се справя — точно така, както Google я описва.
За контекст, в същата моментна снимка Carbon high получава 60 при $5.48 на задача и 28.1 минути, Carbon medium — 58 при $4.68, Carbon low — 54 при $5.22, а Argon high — 50 при $4.97 и 30.6 минути. Hydrogen xhigh постига същия резултат като Carbon low — 54 — при 39.5% по-нисък разход на задача ($3.16 спрямо $5.22), но първият токен идва след 37.77 секунди спрямо 13.61. Hydrogen high изпреварва Argon high с един индексен пункт при 62.4% по-нисък разход на задача.
Къде се пропуква скалата
low не е просто малък спад. С резултат 27 то е с 24 индексни пункта под high. Работен поток, който преминава от high към low, за да спести $1.58 на задача, не получава същия продукт с по-малко мислене, а значително по-слаб модел. Това може да е приемливо за класификация, маршрутизиране или кратко извличане на информация. Не е приемливо за програмиране или работа с агенти без оценяване, специфично за задачата.
medium е настройка за латентност, а не за качество. Тя получава резултат 41 — с 10 пункта под high — при цена $0.80 спрямо $1.87. Спестяването е реално — 57% на задача — но разликата в качеството е по-голяма, отколкото подсказва разликата в цената. Google препоръчва medium за интерактивно програмиране; резултатът на AA показва, че трябва да проверите тази препоръка със собствените си задачи, преди да я възприемете.
xhigh може да прекалява с обмислянето. Google предупреждава за това директно. Данните на AA за разход и време показват ефекта: $3.16 на задача, 13.5 минути и 37.77 секунди чакане до първия токен. За прост промпт това е много латентност срещу малка печалба. При сложна задача по програмиране с няколко стъпки, с която high не се справя, това е единственото ниво, което стига по-далеч.
Многословността също влиза в сметката. Artificial Analysis описва Hydrogen като „много многословен“: изпълнението с xhigh е генерирало 304 милиона изходни токена, за да завърши индекса, и се нарежда на #76 от 77 при медиана от 72.8 милиона. Изходните токени включват токените за мислене, а изходът се таксува по $7.50 на милион. По-високото ниво не просто мисли по-дълго; то генерира повече таксувани токени.
Разходите: как мисленето се превръща в токени
Тарифата е проста. Hydrogen струва $1.50 на милион входни токена, $7.50 на милион изходни токена и $0.075 на милион кеширани входни токена. Изходът включва токените за мислене. Затова нивото е по-важно от тарифата: таксува се написаното от модела разсъждение, а не името на нивото.
Три правила за таксуване лесно могат да бъдат пропуснати.
Нивото по подразбиране се промени. По подразбиране Gemini 3.8 Flash използваше medium, а Hydrogen използва high. След миграцията работен поток, в който никога не е задавано ниво, ще изразходва повече изходни токени на ход, дори при една и съща цена за токен. Това е промяна в бюджета, прикрита като смяна на модела.
Кеширането е само неявно. Hydrogen поддържа неявно кеширане с минимум 4,096 токена и 95% отстъпка при попадение в кеш; изричното кеширане не се поддържа. В корпоративната документация на Google също се казва: „Записите в кеша по подразбиране се таксуват по 1.25 пъти стандартната цена за входни токени.“ Това е формулировката на Google за таксуването; таксуването на кеша от AIHubMix не е документирано за този модел.
Дългият изход има ограничение на ход. Една синхронна заявка генерира до 65,536 токена на ход, независимо дали се използва поточно предаване. За по-дълъг изход е нужно фоново изпълнение или продължаване с токени, а max_output_tokens ограничава общия брой токени за мислене и изход. Ако зададете background=true, без да посочите max_output_tokens, сървърът спира след 65,536 токена. Google препоръчва бюджети от 131,072 или 262,144 за дълго генериране, до 1,048,576 минус входните токени.
Какво приема API и какво отхвърля
Параметърът е thinking_level (snake_case). В примера на Google за Python той се задава в thinking_config; в примера за Node е вложен в thinkingConfig (camelCase). Страницата за модела изброява стойностите като LOW, MEDIUM, HIGH и XHIGH; в бележките за изданието те са изписани с малки букви. Използвайте enum стойността или документирания низ за вашия SDK, вместо да изписвате на ръка вариант с различен регистър.
Три форми на заявка водят до грешка:
thinking_budgetпри който и да е модел Gemini 4 връща400: INVALID_ARGUMENT. Задаването едновременно наthinking_levelиthinking_budgetсъщо връща грешка.thinking_level="MINIMAL"не се поддържа; Hydrogen го отхвърля.- Потребителските стойности за
temperature,top_pиtop_kсе игнорират. Фиксираните стойности по подразбиране са temperature 1.0, topP 0.95 и topK 64.
В платформата на Google Hydrogen поддържа и извикване на функции, изпълнение на код, URL контекст и управление на компютър. В Interactions API използвайте previous_interaction_id за разговори с няколко хода и с извикване на инструменти.
Какво документира AIHubMix и какво не
Документираният маршрут на AIHubMix за Hydrogen е POST https://aihubmix.com/v1/chat/completions с model="gemini-4-hydrogen". На страницата за модела са посочени входни данни във формат текст, изображение, аудио, видео и PDF, с текстов изход; llms.txt все още съдържа по-старо описание само с текст, затова използвайте страницата като по-нов източник. Поддръжката на извикване на инструменти, структуриран изход и разсъждение е отбелязана като „непубликувана“. Моделът не фигурира в индекса на моделите, генериран на 2026-11-11, и няма публикувана схема на протокола.
Това има значение за тази публикация, защото AIHubMix не документира как се задава ниво на мислене за нито един модел Gemini 4. В ръководството на AIHubMix за Gemini е разгледан reasoning_effort за модели от ерата на Gemini 2.5, а не thinking_level или xhigh за Gemini 4. Не приемайте, че някой от двата параметъра се предава през шлюза, нито че настройката по подразбиране, наблюдавана в API на Google, е същата като тази в AIHubMix.
Безопасната форма на заявка е тази, която AIHubMix документира:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Ако контролът върху нивото е задължително изискване, извикайте директно API на Google или проверете поведението на шлюза с малка заявка, преди да насочите към него продукционния трафик. Страницата за сравнение на AIHubMix е полезна за проверка на разходите, докато вземате решение. За тази публикация не е проведен тест на живо.
С какво ниво да започнете според натоварването
| Натоварване | Начално ниво и причина |
|---|---|
| Бърз чат, маршрутизиране, класификация | medium; тествайте low; low получава 27 точки |
| Интерактивно програмиране, прототипиране на потребителски интерфейси | high; medium на AA е с резултат 41 |
| Изпълнение от агенти, цикли с извикване на инструменти | high; xhigh само ако не успява |
| Сложно отстраняване на грешки, архитектура, планиране | xhigh или Carbon; 3 точки повече срещу 69% по-висока цена |
| Пакетна обработка с голям обем след оценяване | low или medium; най-евтини, но с индекс 27/41 |
| Строг лимит за латентност под 15 секунди | medium или low; high изчаква 18.89 s |
Това са отправни точки, а не правила за маршрутизиране. Подходящото ниво е най-ниското, което издържа собствената ви оценка, а Google препоръчва тази оценка да се проведе и на четирите нива.
Често задавани въпроси
Какви нива на мислене има Gemini 4 Hydrogen?
Четири: low, medium, high и xhigh. Подразбиращата се стойност е high.
Какво се промени спрямо Gemini 3.8 Flash?
Подразбиращата се стойност се промени от medium на high, а над high беше добавено xhigh. Carbon и Argon все още използват medium по подразбиране и достигат най-много до high.
Струва ли си xhigh?
Да — за трудни задачи с много стъпки, при които high не се справя: добавя 3 точки към индекса. Освен това струва с 69% повече на задача от high и почти удвоява изчакването до първия токен, така че не е добър избор по подразбиране за прости промптове.
Защо low изостава толкова много?
Artificial Analysis му дава 27 точки по индекса — с 24 точки по-малко от high. Цената е $0.29 на задача спрямо $1.87, но разликата в качеството е много по-голяма от ценовата разлика. Използвайте го само ако оценката за конкретната задача показва, че е достатъчно добър.
Поддържа ли AIHubMix thinking_level или xhigh?
Според документацията — не. AIHubMix не публикува флаг за поддръжка на възможности за разсъждение за Hydrogen, нито ръководство за нивата на мислене в Gemini 4. Проверете, преди да разчитате на което и да е от двете.
Какво става, ако изпратя thinking_budget?
Gemini 4 връща 400: INVALID_ARGUMENT. Задаването едновременно на thinking_budget и thinking_level също връща грешка.
Мога ли да изключа мисленето?
Няма документиран начин за изключването му. MINIMAL не се поддържа в Gemini 4 и Hydrogen връща грешка, ако го зададете.
Продължете да четете: поредицата за Gemini 4 Hydrogen
- Ако все още преценявате дали Hydrogen е подходящото надграждане спрямо Gemini 3.8 Flash, първата публикация разглежда пускането, промяната в цената и компромисите в бенчмарковете: Gemini 4 Hydrogen срещу Gemini 3.8 Flash: струва ли си надграждането?.
- Ако се питате как Hydrogen се сравнява с Carbon и Argon при една и съща задача, третата публикация сравнява и трите модела по цени, латентност и натоварвания: Gemini 4 Carbon срещу Hydrogen срещу Argon: кой модел за коя задача?.
Източници
- Google AI Studio, Gemini 4 Hydrogen: какво е новото
- Google, Мислене в Gemini 4
- Google, Страница на модела Gemini 4 Hydrogen
- Google AI Studio, Цени на Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — моментна снимка на данните към 2026-11-13T02:40Z, Intelligence Index v5.0.1


