Gemini 4 Carbon е пряк заместител на Gemini 4 Argon на ниво схема на заявките. Тялото на заявката за Chat Completions остава същото: променя се ID на модела, а няколко стойности на параметри не се запазват. Съществените проблеми са на следващото ниво — грешки в параметрите, които връщат 400, ограничения на изхода, които тихомълком прекъсват отговора, и настройки за изчакване и таксуване, съобразени с продължителното мислене.
През първата седмица решаващи са четири настройки по подразбиране:
- Задайте
max_tokensна 65,536 или по-малко в AIHubMix; шлюзът документира само Chat Completions и не посочва път за по-голям изход. - За фонови изпълнения през собствените Interactions на Google задайте
store=trueи изрично задайтеmax_output_tokens; тези полета не са документирани за Carbon в AIHubMix. - При използване на вградения в доставчика път за продължително декодиране увеличете времето за изчакване при четене на HTTP до 15–20 минути за всеки поток.
- Премахнете
temperature,top_pиtop_k, които се игнорират, както и параметрите за наказания и стойностите наcandidate_count, по-големи от 1, които според ръководството на Google за Carbon връщат 400.
Основните неща, които не са се променили — достъпът, отказите по съображения за сигурност и цената за задача — са описани в публикацията за миграцията от Argon. Тази публикация разглежда поведението, характерно за Carbon.
Какво се проваля явно и какво — тихомълком
Проблемите се делят ясно: грешка 400 ви предупреждава веднага, а тихото ограничаване на изхода се забелязва при фактурата.
| Какво виждате | Категория | Първа стъпка |
|---|---|---|
| HTTP 400 за параметър | Явно | Премахнете неподдържаното поле |
| 400 при фонова заявка | Явно | Добавете store=true |
| Отговорът спира на 65,536 токена | Тихомълком | Увеличете max_tokens, най-много до 65,536 |
| Празен текст, статус incomplete | Тихомълком | Увеличете ограничението и опитайте отново |
| Фоновото изпълнение приключва около 64K | Тихомълком | Задайте max_output_tokens |
| Отговорът изглежда по-повърхностен | Тихомълком | Задайте изрично нивото на мислене |
| Сметката надхвърля прогнозата | Тихомълком | Отчитайте мисленето и преходите между декодиранията |
AIHubMix посочва gemini-4-carbon на цена от $2 за вход, $10 за изход и $0.10 за кеширани токени на милион токена — това са промоционалните цени на Google — през Chat Completions. Те са временни; вижте раздела за таксуването.
Явни проблеми: документираните грешки 400
Много от документираните грешки 400 са свързани с проверката на параметрите; грешките със състоянието на заявката се дължат на историята и предварително зададените ходове на модела. Освен ако не е посочено друго, правилата по-долу взети са от вграденото ръководство на Google за Carbon; AIHubMix в момента документира само Chat Completions за Carbon. В описанието на Carbon в AIHubMix класът е обобщен в един ред: „400 — грешка в параметър; повечето се препращат от доставчика нагоре по веригата.“ Това описва шлюза, а не резултат от тест. Подробностите са от ръководството на Google за Carbon и страницата с новостите.
| Причина | Какво виждате | Решение |
|---|---|---|
| max_output_tokens > 1M* | 400; надвишен лимит | Вградено: ≤1M; шлюз: ≤65K* |
| frequency/presence penalty | 400; неподдържан параметър | Премахнете полетата |
| candidate_count > 1 | 400; няколко кандидата | Пропуснете го или задайте 1 |
| background без store* | 400; изисква се store* | Добавете store=true |
| Историята завършва с ход на модела | Отхвърля се; неподдържано | Завършете с ход на потребителя |
| и двата контролни параметъра | 400; не могат да се комбинират | Изпратете само единия |
| thinking_budget или MINIMAL | 400; ръководство за Carbon | Използвайте low/medium/high |
Google показва съобщението точно така: „store=true is required for background interactions.“ * Само за вграденото API на Google: max_output_tokens е ограничен до 1M, а фоновото изпълнение изисква store=true; AIHubMix не е документирал този път. В пътя на Chat Completions в AIHubMix използвайте ≤65K.
Редът за minimal има две значения. В собствените полета на Google за Carbon thinking_budget и thinking_level=MINIMAL връщат HTTP 400; използвайте low, medium или high. В слоя за съвместимост с OpenAI на Google reasoning_effort=minimal се преобразува в low; AIHubMix не е публикувал дали прилага това преобразуване за Carbon.
Работата с инструменти крие сходен капан. В ръководството на Google за Carbon се препоръчват последователни ходове за изпълнение на инструменти, а ръководството на AIHubMix за Gemini документира tool_choice="auto"; поддръжката на инструменти за Carbon в шлюза все още не е потвърдена.
Най-малката безопасна заявка към /v1/chat/completions премахва параметрите, които Carbon игнорира:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Ако получите 200, транспортният слой е наред. Останалото се отнася до отговори, които не предизвикват грешка.
Тихи проблеми: няма грешка, грешен изход, грешна сметка
Стандартното ограничение на изхода е 65,536; продължителното декодиране през доставчика е отделен режим
Стандартният таван за изхода на Carbon е 65,536 токена. В Chat Completions полето за ограничението е max_tokens; в собствените ръководства на Google то се нарича max_output_tokens. Вграденият в Google път за продължително декодиране поддържа до 1,048,576 токена минус входа; 131,072 и 262,144 са примерни стойности. На страницата с новостите Google посочва правилото: „Ако зададете background: true, без да дефинирате max_output_tokens, сървърът спира след 64K токена.“ AIHubMix не е документирал фоново изпълнение или продължаване за Carbon.
Продължителното декодиране през доставчика се изпълнява на сегменти: по 64K за преход при фонов режим или поточно предаване и по 32K за преход при непоточно изпълнение; една REST заявка без поточно предаване спира след 32,768 токена. В ръководството на Google се отбелязва, че „по-ранните версии на SDK и слоят за съвместимост с OpenAI не могат да извличат дълги довършвания с помощта на токени за продължаване“. За AIHubMix задавайте max_tokens на 65,536 или по-малко като консервативен, непотвърден лимит на шлюза; не планирайте сглобяване на по-дълги отговори, докато страницата на модела не го документира.
Ниска горна граница прекъсва мисленето, а празният изход се таксува
Ограничението важи за мисленето, а не само за текста. В ръководството на Google за продължително декодиране се казва: „Ниска стойност, например 8,192, спира модела, преди да е приключил с мисленето.“ Статусът става incomplete, а „текстът може да е празен, ако моделът все още е бил в процес на мислене“. Плащате и в двата случая. Предвидете бюджет за мисленето и отговора и третирайте празен отговор със статус incomplete като проблем с ограничението: увеличете лимита, опитайте отново и очаквайте първият опит да бъде включен в сметката.
Нивото на мислене по подразбиране е medium
По подразбиране Carbon използва medium — същото като Argon. Екипите, които преминават от Gemini 3.1 Pro Preview, при който настройката по подразбиране е high, губят едно ниво без промяна в кода и приемат по-повърхностния отговор за регресия. Google препоръчва medium за повечето задачи по програмиране и работа с агенти. Задайте нивото изрично в тестовата среда и изпращайте само едно контролно поле: reasoning_effort и thinking_level не могат да се комбинират.
Параметрите за семплиране се игнорират
temperature, top_p и top_k се игнорират — няма грешка и не променят семплирането. Премахнете ги. Параметрите за наказания и стойностите на candidate_count, по-големи от 1, връщат 400.
Изричното кеширане вече не се поддържа
cachedContents и caches.create не се поддържат. Неявното кеширане се прилага от 4,096 токена нагоре с 95% отстъпка. Изтрийте кода за изрично кеширане, поставете стабилния префикс на промпта най-отпред и проверете използването на кеширани токени, преди да изчислите отстъпката.
Има правило за състоянието на разговора
Google препоръчва previous_interaction_id за продължаване. В Chat Completions няма такова поле, затова запазете историята, но я завършвайте с ход на потребителя; завършване с роля на модел или предварително зададен ход на модела не се поддържа.
Изчакване: 15–20 минути, а не 60 секунди
В ръководството на Google за продължително декодиране се препоръчва време за изчакване при четене на HTTP от 15–20 минути за всеки поток; в контролния списък за миграция се повтаря минимум от 15 минути. Тази препоръка се отнася за заявки с продължително декодиране. Отделно измерване на AA показва времето до първия токен от отговора: 67.1 секунди за Carbon High, 23.2 за Medium, 12.9 за Low и 40.1 за Argon High. Ще успее ли изобщо да пристигне първият токен, ако прекъсвате след 60 секунди?
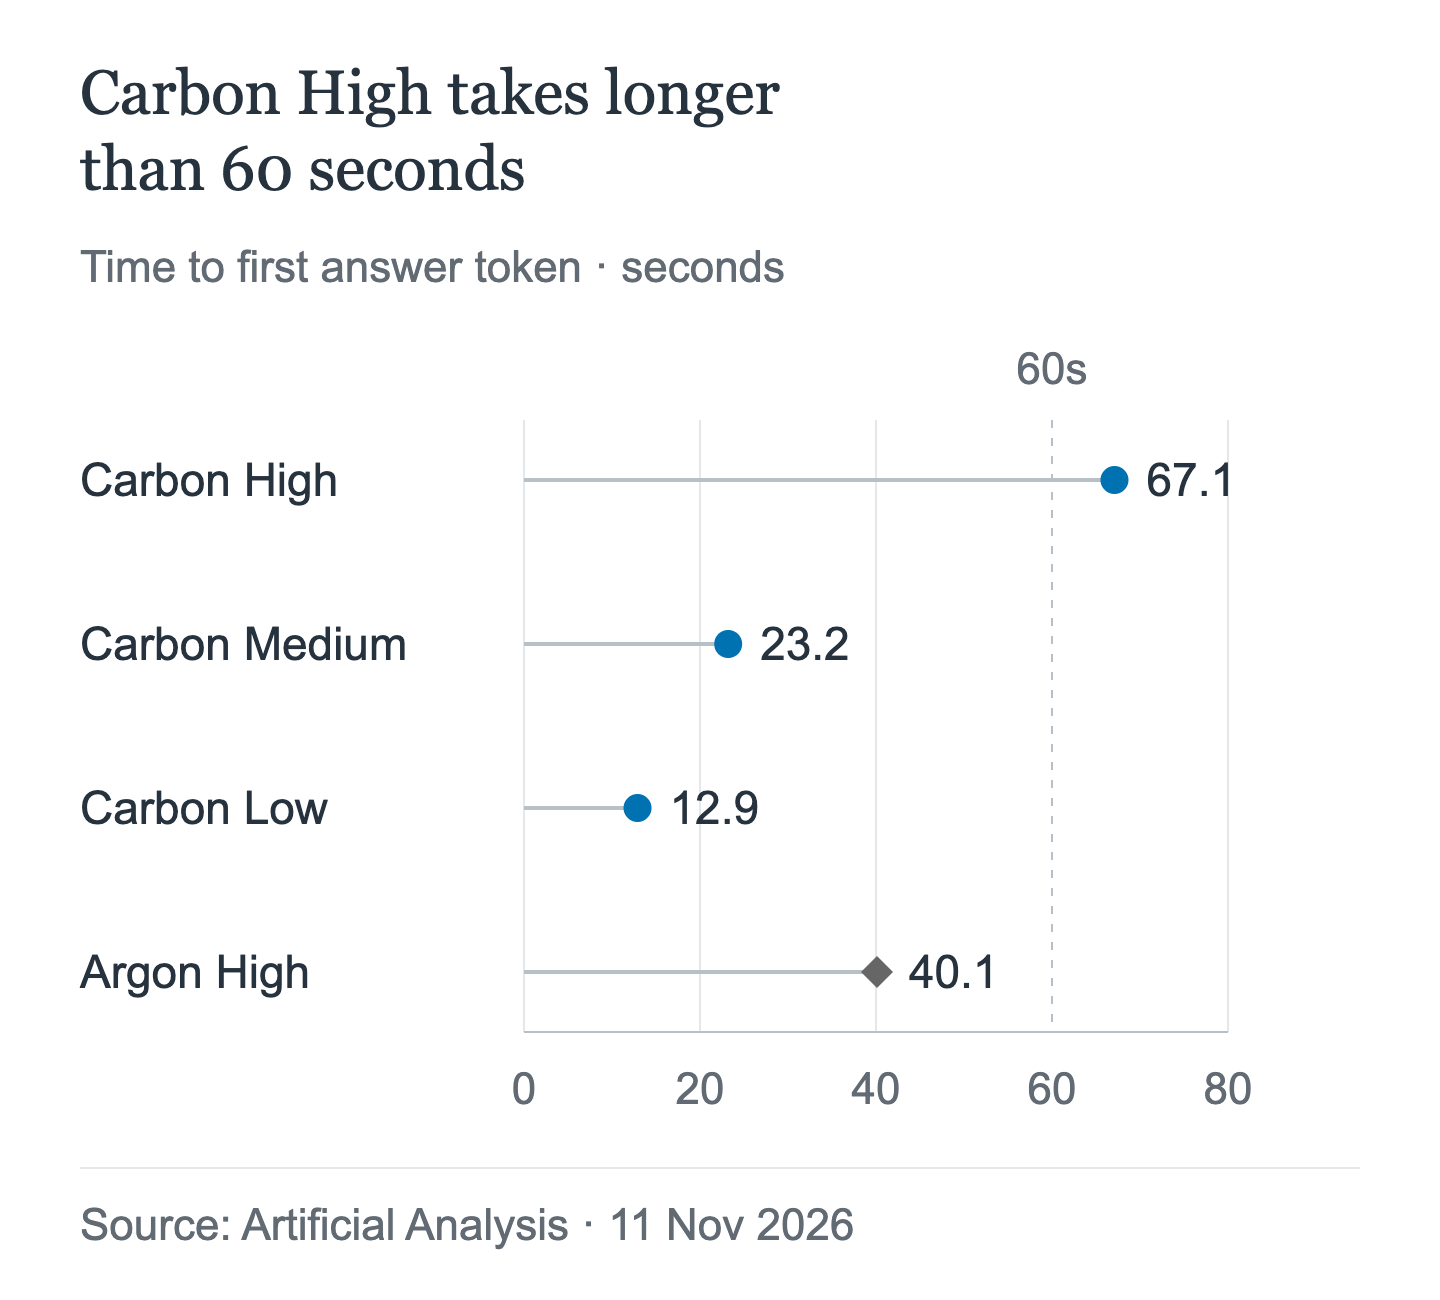
При това измерване Carbon High надхвърля ориентировъчните 60 секунди. Времето до първия токен не определя безопасното време за изчакване на цялата заявка: препоръката за 15–20 минути по-горе е от ръководството на Google за продължително декодиране. Това са резултати от една моментна снимка, а не гаранции за латентност или тест на AIHubMix.
Ограниченията за отделните преходи във вградените клиентски приложения на Google са по-строги от лимита за фоново изпълнение: 20 минути за поток, 10 минути за заявка без поточно предаване и 24 часа за фоново изпълнение. AIHubMix не документира тези ограничения за фонов режим.
Минимални версии на вградените SDK за продължително декодиране: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. По подразбиране API_TIMEOUT_MS в Claude Code е 10 минути; ако по-късно бъде потвърден път за Carbon през Claude Code, увеличете стойността преди първото изпълнение.
Капани при таксуването
Цената на токен за Carbon е проста; сметката — не. Няколко механизма увеличават фактурата, а една планирана промяна удвоява всички цени.
Мисленето се таксува като изход
Токените за мислене се таксуват като изход. Сега цената за изход на Carbon е $10 на милион токена, а от December 1 ще бъде $20.
Таксува се всеки преход при продължително декодиране
Примерът на Google: при промпт от 1,000 токена, който генерира 200,000 токена изход, total_input_tokens отчита 397,216 за преходи от 1,000, 66,536, 132,072 и 197,608 токена. „Плащате за всеки токен във всеки преход, включително за преходите, които съдържат само мислене.“ Неявното кеширане намалява цената на по-голямата част от входа с 95%, но преходите пак се отчитат в употребата. Таксува се и завършената работа, когато изпълнението се провали или бъде отменено: „Завършените сегменти се таксуват в края на всеки сегмент, дори ако по-късен сегмент се провали или бъде отменен“ и „Плащате за цялата работа, завършена преди края на взаимодействието.“
Заземяването се таксува отделно
В собствената услуга на Google за заземяване с Google Search са включени 5,000 безплатни заявки месечно, споделени между Gemini 3 и по-новите модели; след това цената е $14 на 1,000 заявки, с дневен лимит от 1,500. AIHubMix не е документирал заземяване за Carbon.
Бележката за Vertex важи само за доставчика
Страницата с цените на Vertex от Google добавя следното правило: довършванията с над 32K токена се таксуват според броя токени, които могат да бъдат извлечени, дори ако заявката се провали заради изтичане на времето за изчакване при клиента или сървъра; правилото влиза в сила на November 13, 2026. То се отнася за услугата на доставчика; не е публикувано дали доставчикът VertexAI на AIHubMix го прилага. Попитайте, преди да приемете, че важи.
На December 1 всички цени се удвояват
| Цена | До November 30 | От December 1 |
|---|---|---|
| Вход | $2 за 1M | $4 за 1M |
| Изход | $10 за 1M | $20 за 1M |
| Кеширано четене | $0.10 за 1M | $0.20 за 1M |
Carbon и Argon споделят промоционалните цени; на December 1 всяка цена се удвоява. Днес AIHubMix посочва промоционалните цени, но не е публикувал цените след декември. Считайте удвояването за сигурно, а цената на шлюза — за неизвестна, и проверете и двете, преди да определите бюджет.
Агенти с реални разрешения
За извикванията през Google native ръководството за Carbon препоръчва последователни ходове за изпълнение на инструменти. При този подход изпращайте по едно извикване наведнъж. Ръководството на AIHubMix за Gemini описва tool_choice="auto", но поддръжката на инструменти за Carbon и поведението при принудително извикване на инструмент през шлюза не са потвърдени.
Историята не бива да завършва с ход на модела, а предварително попълнените ходове на модела не се поддържат. Ако липсва резултат от инструмент, изпратете потребителски ход с въпрос каква е следващата стъпка.
Картата на модела посочва случайно забавяне или изтичане на времето и повече токени при по-високи нива; срокът на знанието е март 2026 г. При достъп за запис реалният риск е изтичането на времето: изпълнение, което надхвърля клиентския лимит, може да остави частично свършена работа, а завършените сегменти пак се таксуват.
Инструменти за програмиране: проверете страницата на модела, преди да настройвате каквото и да било
В обявата на Carbon в AIHubMix е описано само Chat Completions, а Carbon все още не е в публичния индекс на моделите. Claude Code изисква Anthropic Messages, а Codex — Responses. Нито едното не е потвърдено за Carbon в AIHubMix. Не приемайте, че някое от тях работи: отворете страницата на модела Carbon, към която има връзка по-горе, и проверете списъка с протоколи. Ако е посочен само Chat Completions, използвайте съвместим с OpenAI клиент или изчакайте.
Форматът на заявката е същият като при Argon, но наличността на протоколите е различна: в момента Carbon е описан в AIHubMix само за Chat Completions. Публикацията за Claude Code разглежда ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN и API_TIMEOUT_MS; публикацията за Codex разглежда блока на доставчика, wire_api и model_reasoning_effort. Разликата е в това дали протоколът съществува.
| Клиент | Необходим протокол | Carbon в AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Не е документиран |
| Codex | Responses API | Не е документиран |
| OpenAI SDK | Chat Completions | Документиран |
Настройки:
- ID на модела:
gemini-4-carbon. - Режим на мислене: low, medium, high; по подразбиране medium.
- Съответствие на нивата на усилие: собствено поле
thinking_level, поле за съвместимостreasoning_effort; Google преобразува стойностите за нивото на усилие, но AIHubMix не е публикувала съответствието за Carbon. Изпратете само едно от полетата. - Контекст: 1,048,576 според Google; AIHubMix не е публикувала лимит за Carbon, затова не разработвайте решението си с оглед на стойността на доставчика.
- Известни проблеми: бавен първи токен при high, препоръка на доставчика за последователни ходове с инструменти, предпазлив, непотвърден лимит от 65,536 изходни токена в AIHubMix и срок на знанието март 2026 г.
Бърз тест, 10–15 минути:
- Изберете малко хранилище с един неуспешен модулен тест и команда за тестове, която приключва за по-малко от минута.
- Задайте модела на
gemini-4-carbon,max_tokensна 65,536 или по-малко, а HTTP изчакването — на поне 15 минути. - Поискайте от инструмента да направи възможно най-малката промяна, която ще накара теста да премине, след което изпълнете командата за тестове и прегледайте разликите.
- Успех: редакцията е минимална и тестът преминава за 10–15 минути. Неуспех: запишете дали отговорът е бил грешка 400, непълен отговор, изтичане на времето или неуспешна редакция; за всеки случай има различно решение по-горе.
- Ако инструментът позволява да зададете нивото, тествайте medium и high и оставете това, което приключва в рамките на зададения прозорец.
Контролен списък преди първата заявка в продукционна среда
- Зададено е ID на модела
gemini-4-carbon. - Без
temperature,top_pилиtop_k. - Без
frequency_penaltyилиpresence_penalty; оставетеcandidate_countна 1 или го пропуснете. max_tokensе 65,536 или по-малко.- Заявките във фонов режим през Google native изпращат
store=trueи изрично зададеноmax_output_tokens; AIHubMix не е документирала този подход. - HTTP изчакване от поне 15 минути; препоръчва се поточно предаване.
- Използвайте само едно от
reasoning_effortиthinking_level. - При Google native предпочитайте последователни ходове с инструменти; AIHubMix описва
tool_choice="auto", но поддръжката на Carbon не е потвърдена. - Без изрични извиквания на кеша; първо задайте стабилния префикс на промпта.
- Бюджетът трябва да включва токените за мислене и всяка стъпка с продължително генериране.
- Проверете ставките от 1 декември със собственика на бюджета.
- Проверете инструмента за програмиране спрямо страницата на модела, преди да го конфигурирате.
ЧЗВ
Трябва ли да променя тялото на заявката при преминаване от Argon към Carbon?
Не. Схемата не се променя. Сменете ID на модела, прегледайте стойностите и премахнете полетата, които вече връщат грешка 400.
Защо max_output_tokens връща грешка 400?
Собственият API на Google за Carbon отхвърля стойности над 1,048,576. За пътя Chat Completions в AIHubMix има отделна, предпазлива препоръка: поддържайте max_tokens на или под 65,536, докато не бъде документиран път с по-висок лимит. Ниската стойност вместо това прекъсва мисленето, което е по-лошо: отговорът може да е непълен и да бъде таксуван.
Защо отговорът е празен?
Ако състоянието е „непълен“, текстът може да е празен, защото моделът все още е мислел. Работата се таксува. Увеличете лимита и опитайте отново.
Защо заявка във фонов режим спира на 64K?
При собствения фонов режим на Google, ако не зададете max_output_tokens, сървърът спира на 64K. Задайте изрично лимита; при собственото продължително генериране може да се достигне до 1,048,576 минус входа. AIHubMix не е документирала фонов режим.
Прилага ли се temperature?
Не. temperature, top_p и top_k се игнорират. Стойности на наказанията и на candidate_count над 1 вместо това връщат грешка 400.
Ще струва ли Carbon двойно повече на 1 декември?
Ставките на Google се удвояват: входящите токени от $2 на $4, изходящите от $10 на $20, а кешираните прочитания — от $0.10 на $0.20. AIHubMix не е публикувала цената си след декември, затова я потвърдете, преди да фиксирате бюджет.
Може ли да се използват Claude Code или Codex с Carbon?
Не е потвърдено. AIHubMix описва Chat Completions за Carbon; Claude Code изисква Anthropic Messages, а Codex — Responses. Първо проверете страницата на модела.
Продължете с поредицата за Gemini 4 Carbon
- Ако миграцията вече е в ход и остава въпросът дали Carbon изобщо оправдава цената си, сравнението поставя една до друга общите въвеждащи цени.
Gemini 4 Carbon срещу Argon: еднаква цена — кога Carbon си заслужава? - Ако избирате агент за програмиране, а не мигрирате крайна точка, сравнението разглежда използването на инструменти и разхода за задача.
Gemini 4 Carbon срещу Fable 5.2: кой е по-добър за агентно програмиране?