

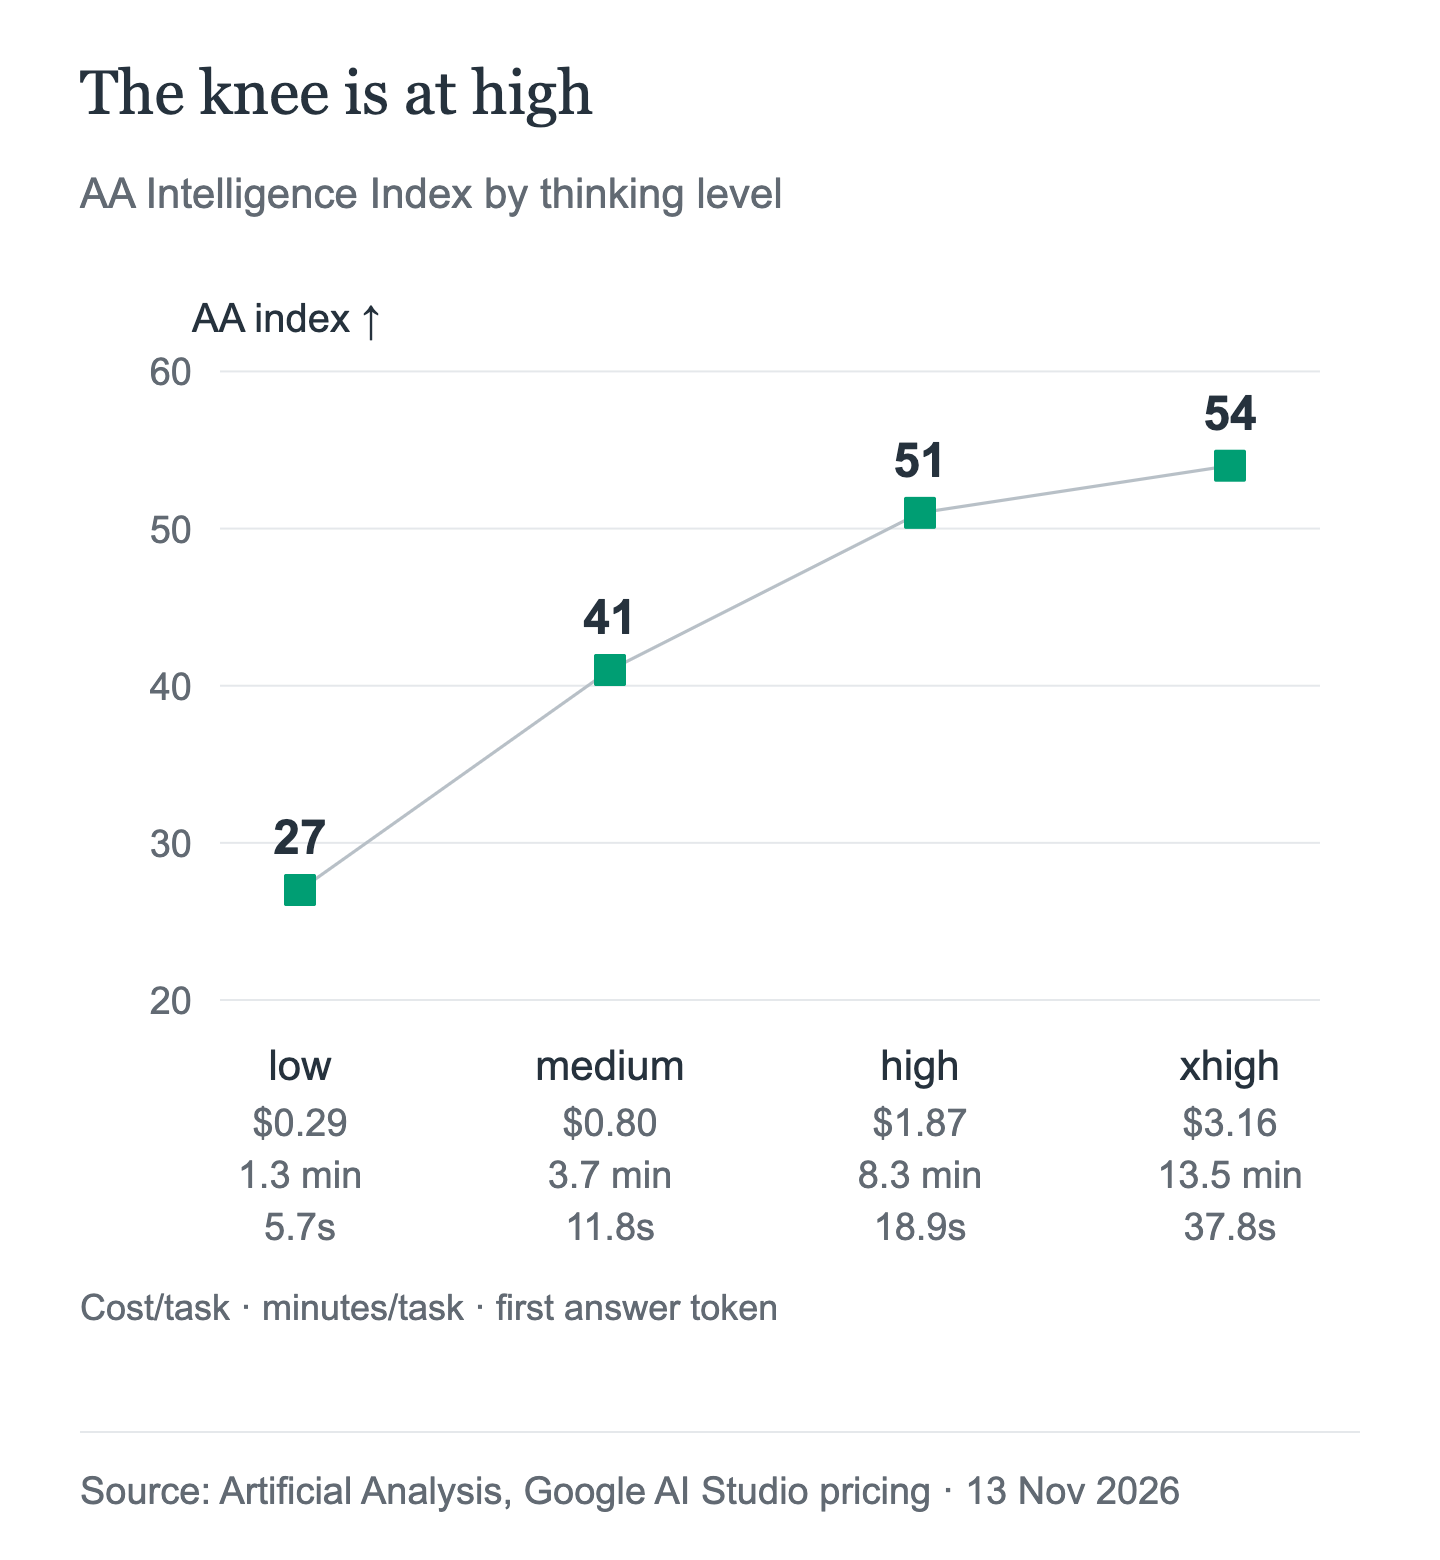
Gemini 4 Hydrogen 有四种思考等级,表现得就像四个不同的模型。根据Artificial Analysis 的实时测量数据,同一模型在low下得分为 27,在medium下为 41,在high下为 51,在xhigh下为 54。默认等级是high,而xhigh是 Gemini 4 系列的新选项:Carbon 和 Argon 最高只支持high。
各等级之间差距很大:同一模型从low到xhigh相差 27 个指数点。从medium升到high,每项任务多花约 $1.07,可提升 10 个指数点。从high升到xhigh,多花 $1.29 只提升 3 个点,而且等待首个回答 token 的时间几乎翻倍。实用建议是从high开始,只有遇到困难的多步骤任务时才用xhigh,并把low和medium视为需要单独进行质量验证的低延迟选项。
下文将介绍各等级的用途、成本、API 中的变化,以及 AIHubMix 有哪些信息尚未说明。
四种等级及其变化
Gemini 4 Hydrogen支持low、medium、high和xhigh。Google 的发行说明说得很清楚:“模型默认使用high,并新增了xhigh。”与Gemini 3.8 Flash相比,有两项变化:后者默认使用medium,最高只支持high。
系列中的其他模型没有变化。Carbon和 Argon 支持low、medium和high,默认使用medium。Hydrogen 是 Gemini 4 系列中唯一支持高于high设置的模型。
| 模型 | 等级 | 默认等级 |
|---|---|---|
| Gemini 4 Hydrogen | low、medium、high、xhigh | high |
| Gemini 4 Carbon | low、medium、high | medium |
| Gemini 4 Argon | low、medium、high | medium |
MINIMAL不属于可选等级。Gemini 4 思考文档指出,Gemini 4 模型“不支持 MINIMAL”;Google 的 Hydrogen 发行说明则称,模型“收到minimal时会返回错误”。该模型没有文档说明的思考关闭选项。
Google 的建议
Google 的指导可以作为合理的初步参考,但它是在下文测量数据公布之前写的。尤其是关于交互式编程使用medium的建议,假设其质量水平足够,而 Artificial Analysis 的数据并不支持medium能达到这一点。
| 等级 | Google 的描述和建议用途 |
|---|---|
| low | “token 最少、延迟最低”——快速聊天、高并发量 |
| medium | “token 用量较低、响应更快”——交互式编程、UI 原型 |
| high | “智能与速度兼顾”——大多数任务的默认选项 |
| xhigh | “token 用量最多、推理最深入”——困难的多步骤编程任务 |
表格中的建议附带两点提醒。Google 表示:“使用xhigh会增加延迟和 token 用量,简单提示词还可能导致过度思考。”评估建议也很明确:“在四种等级下都进行评估,并将max_output_tokens设为较高值。”
实测等级阶梯
Artificial Analysis 对四种等级都进行了测量。本次测试采用 Intelligence Index v5.0.1,涵盖 78 个排名模型,数据访问时间为 2026-11-13T02:40Z,价格采用标准标价。这里的数据是 AA 的任务成本,不是 AIHubMix 的账单金额。
| 等级 | AA 排名 | AA 指数 | 美元/任务 | 分钟/任务 | 首个回答 token |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
各档之间的增幅最值得关注:
low升到medium:增加 14 个指数点,每项任务多花 $0.51,多耗时 2.4 分钟,首个 token 延迟增加 6.1 秒。medium升到high:增加 10 个指数点,每项任务多花 $1.07,多耗时 4.6 分钟,首个 token 延迟增加 7.1 秒。high升到xhigh:增加 3 个指数点,每项任务多花 $1.29,多耗时 5.2 分钟,首个 token 延迟增加 18.9 秒。
high是性价比拐点。升到这一级时,质量提升相对于新增费用仍然可观;而升到xhigh时,指数只小幅提升,等待首个 token 的时间却几乎翻倍。这并不意味着xhigh是个糟糕的设置,而是说它适用于high无法胜任的任务——这恰好符合 Google 对它的描述。
作为参考,在同一份数据快照中,Carbon high 得分为 60,每项任务 $5.48,耗时 28.1 分钟;Carbon medium 得分为 58,每项任务 $4.68;Carbon low 得分为 54,每项任务 $5.22;Argon high 得分为 50,每项任务 $4.97,耗时 30.6 分钟。Hydrogen xhigh得分为 54,与 Carbon low 相同,每项任务成本低 39.5%($3.16 对比 $5.22),但首个 token 延迟为 37.77 秒,而 Carbon low 为 13.61 秒。Hydrogen high的得分比 Argon high 高 1 点,每项任务成本则低 62.4%。
等级阶梯的短板
low并非只是略有降级。它的得分为 27,比high低 24 个指数点。如果工作负载从high降到low,每项任务省下 $1.58,买到的并不是思考少一些但功能相同的产品,而是能力弱得多的模型。对于分类、路由或简短信息提取,这或许没问题;但在没有针对具体任务进行评估的情况下,不适合编程或智能体任务。
medium 是延迟设置,而非质量设置。它的得分为 41,比 high 低 10 分,价格为 $0.80,而后者为 $1.87。节省确实可观——每项任务可节省 57%——但质量差距比价格差距所暗示的更大。Google 建议将 medium 用于交互式编码;AA 的数据表明,在采纳这一建议前,应先用自己的任务进行测试。
xhigh可能导致过度思考。Google 对此有直接提醒。AA 的成本和耗时数据展示了其影响:每项任务 $3.16,耗时 13.5 分钟,等待首个 token 要 37.77 秒。对于简单提示词而言,为了小幅提升而付出这么多延迟并不划算。但对于high无法胜任的困难多步骤编程任务,只有这一等级能更进一步。
输出冗长也会增加账单。Artificial Analysis 将 Hydrogen 描述为“非常冗长”:完成指数测试时,xhigh运行生成了 304 million 个输出 token,在 77 个模型中排名第 #76,而中位数为 72.8 million。输出 token 包括思考内容,每 million 个输出 token 的费用为 $7.50。使用更高等级不仅意味着思考时间更长,也意味着生成更多需要付费的 token。
费用:思考如何转化为 token 用量
价格表很简单。Hydrogen 的输入 token 价格为每 million $1.50,输出 token 为每 million $7.50,缓存输入 token 为每 million $0.075。输出 token 包括思考 token。因此,相比价格,等级更为重要:模型按生成的推理内容收费,而不是按等级名称收费。
有三条计费规则很容易被忽略。
默认等级变了。Gemini 3.8 Flash 默认使用medium,Hydrogen 默认使用high。迁移后,即使每个 token 的价格不变,没有设置等级的工作负载每轮也会消耗更多输出 token。这是伪装成模型切换的预算变更。
只有隐式缓存。Hydrogen 支持隐式缓存,最低要求为 4,096 个 token,缓存命中可享受 95% 的折扣;不支持显式缓存。Google 的企业版页面还称:“缓存写入默认按标准输入 token 价格的 1.25 倍计费。”这是 Google 的计费说明;AIHubMix 尚未公布该模型的缓存计费方式。
长输出受单次处理上限限制。无论是否采用流式输出,同步请求每次最多生成 65,536 个 token。更长的输出需要后台执行或通过后续请求继续生成;max_output_tokens限制思考内容和输出内容的合计 token 数。如果设置了background=true却没有设置max_output_tokens,服务器会在生成 65,536 个 token 后停止。Google 建议长解码任务将预算设为 131,072 或 262,144,最高为 1,048,576 减去输入 token 数。
API 的功能与不接受的参数
参数为thinking_level(蛇形命名法)。Google 的 Python 示例将它设在thinking_config中;Node 示例则将它嵌套在thinkingConfig下(驼峰命名法)。模型页面列出的取值为LOW、MEDIUM、HIGH和XHIGH;发行说明中则使用小写。请使用 SDK 中的枚举值或文档指定的字符串,不要手动输入大小写不一致的值。
以下三种请求写法会失败:
- 在任何 Gemini 4 模型上使用
thinking_budget都会返回400: INVALID_ARGUMENT。同时设置thinking_level和thinking_budget也会报错。 thinking_level="MINIMAL"不受支持;Hydrogen 会拒绝该设置。- 自定义的
temperature、top_p和top_k会被忽略。固定默认值为 temperature 1.0、topP 0.95 和 topK 64。
在 Google 平台上,Hydrogen 还支持函数调用、代码执行、URL 上下文和计算机使用。在 Interactions API 中,多轮对话和工具调用会话应使用previous_interaction_id。
AIHubMix 已说明和未说明的内容
AIHubMix 文档列出的 Hydrogen 端点为POST https://aihubmix.com/v1/chat/completions,模型参数为model="gemini-4-hydrogen"。模型页面列出支持文本、图像、音频、视频和 PDF 输入,以及文本输出;llms.txt中仍保留着较早的纯文本说明,因此应以较新的模型页面为准。工具使用、结构化输出和推理的能力标记均为“未公布”。该模型未出现在 2026-11-11 生成的模型索引中,也没有公布协议架构。
这对本文很重要,因为 AIHubMix 没有说明如何为任何 Gemini 4 模型设置思考等级。其Gemini 指南介绍的是 Gemini 2.5 时代模型的reasoning_effort,并未涉及 Gemini 4 的thinking_level或xhigh。不要假设这两个参数会透传网关,也不要假设在 Google API 上观察到的默认值就是你在 AIHubMix 上得到的默认值。
安全的请求格式应采用 AIHubMix 文档中列出的写法:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
如果必须控制等级,请直接调用 Google API,或先发送一条小型请求,确认网关的实际行为,再将生产流量路由过去。在做决定时,可以通过AIHubMix 对比页面了解成本。本文未进行实时测试。
按工作负载从何处开始
| 工作负载 | 建议起点及原因 |
|---|---|
| 快速聊天、路由、分类 | medium,测试 low;low 得分为 27 |
| 交互式编程、UI 原型设计 | high;AA 的 medium 得分为 41 |
| 智能体执行、工具调用循环 | high;只有在陷入困境时才用 xhigh |
| 复杂调试、架构设计、规划 | xhigh 或 Carbon;多花 69% 可提升 3 分 |
| 评估后的高吞吐量批处理 | low 或 medium;成本最低,但指数得分分别为 27/41 |
| 严格要求在 15 秒内完成的延迟预算 | medium 或 low;high 需要等待 18.89 s |
这些只是起点,并非路由规则。合适的等级是能够通过你自己的评估的最低等级,而 Google 自己的建议是在四个等级下都进行评估。
常见问题
Gemini 4 Hydrogen 有哪些思考等级?
共有四种:low、medium、high 和 xhigh。默认值为 high。
与 Gemini 3.8 Flash 相比有哪些变化?
默认值从 medium 改为 high,并在 high 之上新增了 xhigh。Carbon 和 Argon 的默认值仍为 medium,最高等级仍为 high。
xhigh 值得用吗?
对于 high 无法胜任的复杂多步骤任务,值得:它能让指数得分提高 3 分。但每项任务的成本比 high 高 69%,首 token 等待时间也几乎翻倍,因此不适合作为简单提示词的默认选项。
Why is low so far behind?
Artificial Analysis measures it at 27 on the index, 24 points below high. The price is $0.29 per task against $1.87, but the quality gap is much larger than the price gap. Use it only where a task-specific evaluation says it is enough.
AIHubMix 支持 thinking_level 或 xhigh 吗?
根据现有文档,尚不支持。AIHubMix 未公布 Hydrogen 的推理能力标志,也没有 Gemini 4 思考等级指南。依赖其中任何一项之前,请先确认。
如果我发送 thinking_budget 会怎样?
Gemini 4 会返回 400: INVALID_ARGUMENT。同时设置 thinking_budget 和 thinking_level 也会返回错误。
可以关闭思考吗?
目前没有文档说明如何关闭。Gemini 4 不支持 MINIMAL,Hydrogen 会因该设置而返回错误。
继续阅读:Gemini 4 Hydrogen 系列文章
- 如果你仍在考虑 Hydrogen 是否值得作为 Gemini 3.8 Flash 的升级选择,第一篇文章介绍了发布情况、价格变化和基准测试权衡:Gemini 4 Hydrogen 与 Gemini 3.8 Flash:值得升级吗?。
- 如果你想了解 Hydrogen 与 Carbon、Argon 在相同任务下的表现对比,第三篇文章将三者并列比较,并提供价格、延迟和工作负载表:Gemini 4 Carbon、Hydrogen 与 Argon:不同任务该选哪个模型?。
来源
- Google AI Studio,Gemini 4 Hydrogen:新功能介绍
- Google,Gemini 4 思考
- Google,Gemini 4 Hydrogen 模型页面
- Google AI Studio,Gemini API 定价
- Artificial Analysis,Gemini 4 Hydrogen — 实时快照 2026-11-13T02:40Z,Intelligence Index v5.0.1


