在请求架构层面,Gemini 4 Carbon 可以直接替换 Gemini 4 Argon。相同的聊天补全请求正文仍然适用:只需更改模型 ID,但部分参数值无法继续使用。真正需要注意的问题在下一层——参数错误会返回 400,输出限制会导致内容悄然截断,而超时和计费机制则是围绕长思考设计的。
第一周要确定四项默认设置:
- 在 AIHubMix 上将
max_tokens保持在 65,536 或以下;网关仅记录了 Chat Completions 文档,未公布更大的输出路径。 - 对于 Google 原生 Interactions/后台运行,设置
store=true和明确的max_output_tokens;AIHubMix 尚未记录 Carbon 支持这些字段。 - 使用供应商原生长解码路径时,将 HTTP 读取超时提高到每个流 15–20 分钟。
- 移除会被忽略的
temperature、top_p和top_k,以及会在 Google Carbon 指南中触发 400 错误的 penalties 和大于 1 的candidate_count值。
关于访问、安全拒绝和单任务成本等不变的基础内容,请参阅Argon 迁移文章。本文介绍 Carbon 特有的行为。
哪些故障会明确报错,哪些不会
故障可以清楚地分为两类:400 错误会立即提示你;静默触发的上限则会在账单上提醒你。
| 现象 | 类型 | 第一步处理 |
|---|---|---|
| 参数触发 HTTP 400 | 明确报错 | 移除不受支持的字段 |
| 后台请求触发 400 | 明确报错 | 添加 store=true |
| 回答在 65,536 tokens 处停止 | 静默故障 | 提高 max_tokens,上限为 65,536 |
| 文本为空,状态为 incomplete | 静默故障 | 提高上限并重试 |
| 后台运行在约 64K 处结束 | 静默故障 | 设置 max_output_tokens |
| 回答看起来不够深入 | 静默故障 | 明确设置思考级别 |
| 账单高于预估 | 静默故障 | 将思考和解码跳数计入预算 |
AIHubMix 通过 Chat Completions 提供gemini-4-carbon,价格为每百万 tokens 输入 $2、输出 $10、缓存 $0.10——这是 Google 的入门价格。该价格为临时价格;请参阅计费说明。
明确报错:文档列出的 400 错误
许多文档列出的 400 错误属于参数验证问题;历史记录和预填充的模型轮次则属于请求状态问题。除非另有说明,以下规则均来自 Google 原生 Carbon 指南;AIHubMix 目前仅提供 Carbon 的 Chat Completions 文档。AIHubMix 的 Carbon 条目用一句话描述了这类错误:“400 — 参数错误;大多数错误由上游供应商传递而来。”这是对网关行为的描述,并非测试结果。详细信息来自 Google 的Carbon 指南和更新说明页面。
| 触发条件 | 现象 | 修复方法 |
|---|---|---|
| max_output_tokens > 1M* | 400;超出上限 | 原生接口 ≤1M;网关 ≤65K* |
| frequency/presence penalty | 400;不受支持 | 移除字段 |
| candidate_count > 1 | 400;多候选项 | 省略或设为 1 |
| 后台请求未设置 store* | 400;必须设置 store* | 添加 store=true |
| 历史记录以模型轮次结束 | 请求被拒绝;不受支持 | 以用户轮次结束 |
| 同时使用两项控制字段 | 400;不能同时使用 | 只发送一个 |
| thinking_budget 或 MINIMAL | 400;Carbon 指南 | 使用 low/medium/high |
Google 给出的错误消息原文是:“store=true is required for background interactions.” * 仅适用于 Google 原生接口:max_output_tokens 上限为 1M,后台请求必须设置 store=true;AIHubMix 尚未记录此路径。在其 Chat Completions 路径上,请使用 ≤65K。
minimal 这一行有两种含义。在 Google 原生 Carbon 字段中,thinking_budget 和 thinking_level=MINIMAL 会返回 HTTP 400;请使用 low、medium 或 high。而在 Google 的 OpenAI 兼容层中,reasoning_effort=minimal 会映射为 low;AIHubMix 尚未公布是否会对 Carbon 应用此映射。
工具处理是另一个相关陷阱。Google 的 Carbon 指南建议优先使用顺序工具执行轮次,而AIHubMix 的 Gemini 指南记录了 tool_choice="auto";网关是否支持 Carbon 特有的工具功能仍未得到确认。
/v1/chat/completions 上最精简的安全请求会移除 Carbon 忽略的内容:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
如果请求返回 200,传输层就没有问题了。接下来要关注的是不会报错的回答问题。
静默故障:不报错,但输出不对、账单也不对
标准输出上限为 65,536;供应商长解码是另一条路径
Carbon 的标准输出上限为 65,536 tokens。在 Chat Completions 中,上限字段是 max_tokens;Google 的原生指南将其称为 max_output_tokens。Google 原生长解码路径最多可达到 1,048,576 tokens 减去输入长度;131,072 和 262,144 都是示例值。Google 的更新说明页面明确了规则:“如果设置了 background: true 却未定义 max_output_tokens,服务器会在 64K tokens 后停止。”AIHubMix 尚未记录 Carbon 的后台运行或续接功能。
供应商原生长解码会分段运行:使用后台或流式输出时,每跳 64K;非流式输出时,每跳 32K;单个非流式 REST 请求会在 32,768 处停止。Google 指南指出:“较早版本的 SDK 和 OpenAI 兼容层无法使用续接 token 获取长补全结果。”对于 AIHubMix,保守起见,请将 max_tokens 保持在 65,536 或以下;这只是未经验证的网关限制。在模型页面明确记录之前,不要计划拼接更长的回答。
上限过低会截断思考过程,空输出也会计费
上限限制的是思考过程和文本,不只是文本。Google 的长解码指南指出:“较低的值(例如 8,192)会在模型完成思考前使其停止。”状态会变成 incomplete,而且“如果模型仍在思考,文本可能为空。”无论哪种情况,你都要付费。请为思考过程和回答预留 token;如果响应为空且状态为 incomplete,应视为上限问题:提高上限后重试,并将第一次尝试的费用计入账单预期。
思考级别默认为 medium
Carbon 默认使用 medium,与 Argon 相同。使用默认 high 的 Gemini 3.1 Pro Preview 的团队,如果不改代码就会降低一个级别,并可能误以为较浅的回答是性能退化。Google 建议大多数编程和智能体任务使用 medium。在预发布环境中明确设置级别,并且只发送一个控制字段:reasoning_effort 和 thinking_level 不能同时使用。
采样参数会被忽略
temperature、top_p 和 top_k 会被忽略——不会报错,采样也不会改变。请移除它们。Penalties 和大于 1 的 candidate_count 值会返回 400。
显式缓存已不再支持
cachedContents 和 caches.create 不受支持。对于 4,096 tokens 及以上的内容会应用隐式缓存,并提供 95% 的折扣。请删除显式缓存代码,将稳定的提示词前缀放在最前面,并在按折扣预算前检查缓存 token 用量。
对话状态有一项规则
Google 建议使用 previous_interaction_id 继续对话。Chat Completions 没有这样的字段,因此请保留历史记录,但以用户轮次结束;以模型角色结束或预填充模型轮次均不受支持。
超时:15 到 20 分钟,而不是 60 秒
Google 的长解码指南建议将 HTTP 读取超时设为每个流 15 到 20 分钟;其迁移检查清单也重复了至少 15 分钟的要求。这项建议针对长解码请求。另有一项 AA 测量展示了等待第一个回答 token 所需的时间:Carbon High 为 67.1 秒,Medium 为 23.2 秒,Low 为 12.9 秒,Argon High 为 40.1 秒。60 秒的超时限制真的能让第一个 token 到达吗?
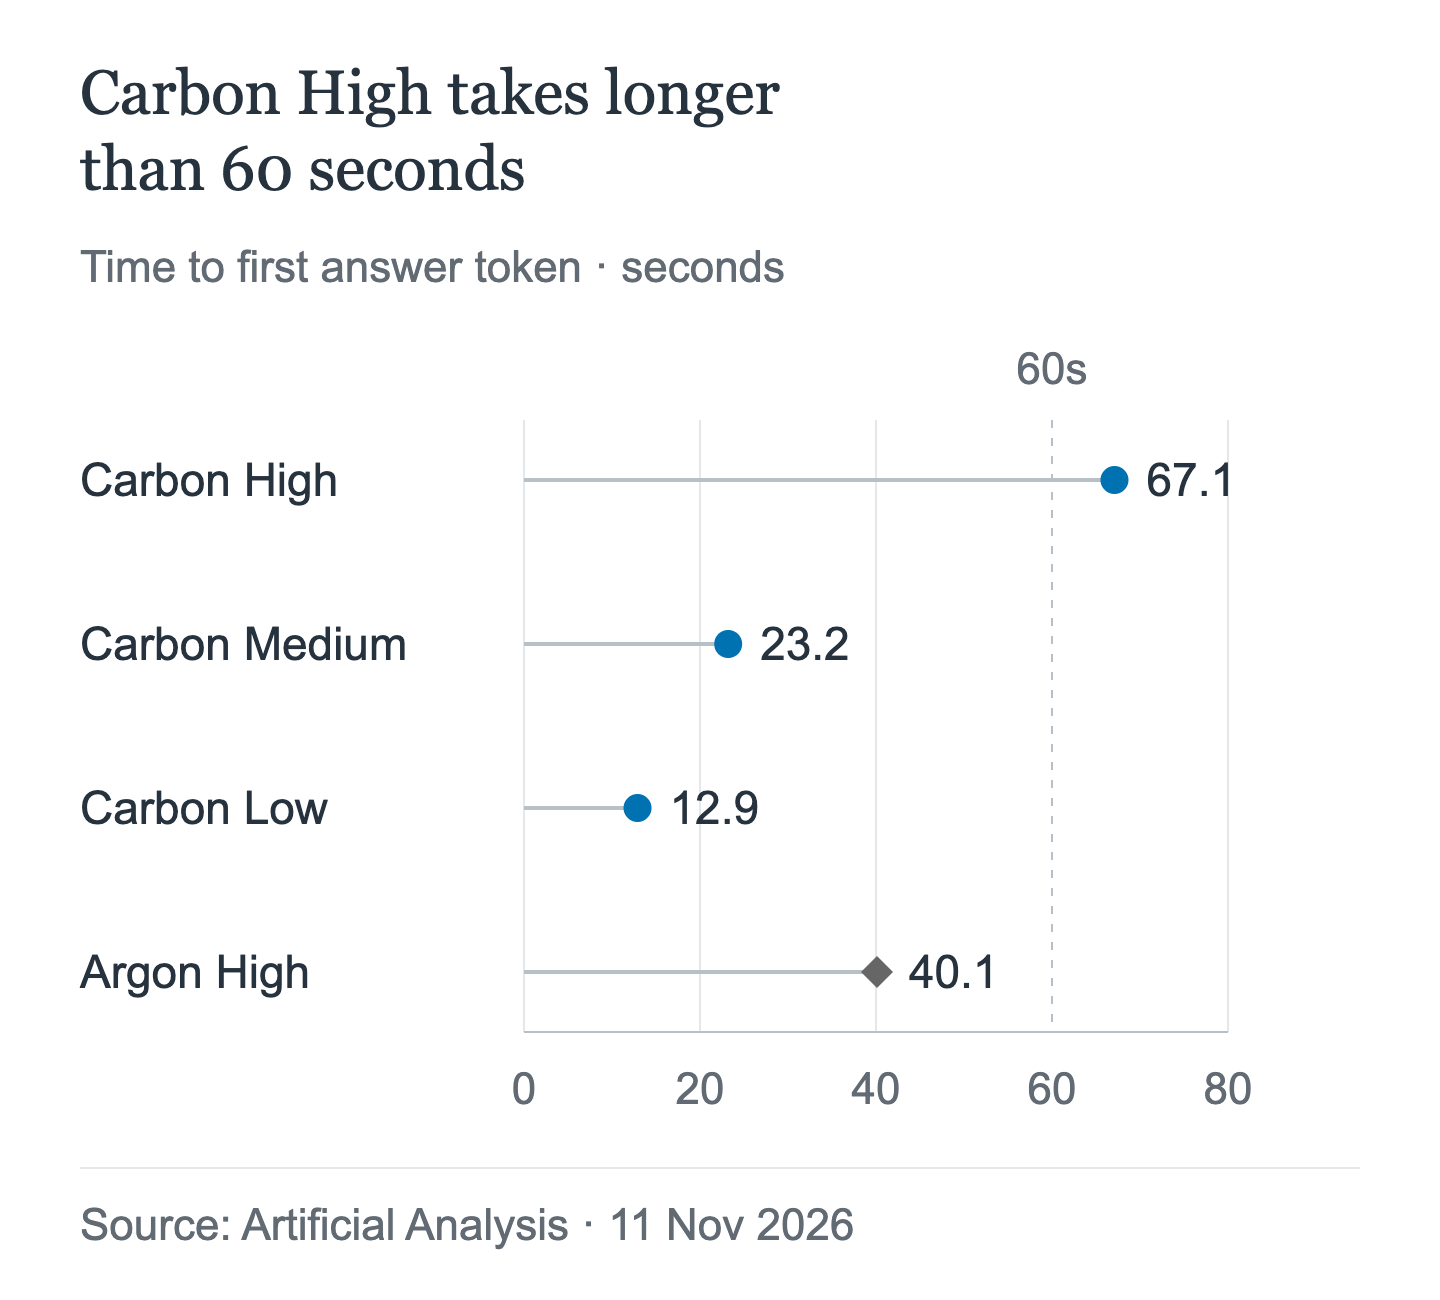
在这项测量中,Carbon High 超过了 60 秒的参考时间。首 token 耗时无法确定整个请求的安全超时;上文 15–20 分钟的建议来自 Google 的长解码指南。这些只是单次测量结果,并非延迟保证,也不是 AIHubMix 的测试结果。
Google 原生客户端的单跳时限比后台任务的限制更短:流式请求为 20 分钟,非流式调用为 10 分钟,而后台任务为 24 小时。AIHubMix 未记录这些后台限制。
长解码所需的原生 SDK 最低版本:Python 2.34.0、JS 2.32.0、Go 1.77.0、Java 1.80.0、.NET 1.28.0。Claude Code 的 API_TIMEOUT_MS 默认值为 10 分钟;如果之后确认 Carbon 支持 Claude Code 调用路径,请在首次运行前调高此值。
计费陷阱
Carbon 的单 token 价格很简单,账单却不简单。几种机制会抬高账单,而且有一项定期调整会让所有费率翻倍。
思考过程按输出计费
思考 token 按输出计费。Carbon 目前的输出费率为每百万 tokens $10,从 12 月 1 日起将涨至 $20。
长解码的每一跳都会计费
Google 给出的示例:一个 1,000-token 提示词生成 200,000 个输出 tokens,经过 1,000、66,536、132,072 和 197,608 这几跳后,报告的 total_input_tokens 为 397,216。“每一跳中的每个 token 都要计费,包括只包含思考内容的跳。”隐式缓存会为大部分输入提供 95% 的折扣,但这些跳仍会计入用量。运行失败或取消时,已完成的工作也会计费:“每段结束时都会为已完成的部分计费,即使后续某一段失败或被取消也一样。”此外,“在交互结束前完成的所有工作都会计费。”
Grounding 有单独的计量方式
在 Google 原生服务上,通过 Google Search 进行 grounding,每月包含 5,000 次免费请求;此额度由 Gemini 3 及更新版本共享,之后的费用为每 1,000 次 $14,每日上限为 1,500 次。AIHubMix 尚未记录 Carbon 的 grounding 功能。
Vertex 的脚注仅适用于供应商
Google 的 Vertex 定价页面补充了一条规则:超过 32K tokens 的补全,即使请求因客户端或服务器超时而失败,也会按可检索 token 用量收费;该规则自 2026 年 11 月 13 日起生效。这是供应商规则;AIHubMix 的 VertexAI 供应商是否适用此规则尚未公布。作出假设前请先询问。
12 月 1 日起所有费率翻倍
| 费率 | 截至 11 月 30 日 | 自 12 月 1 日起 |
|---|---|---|
| 输入 | 每 1M $2 | 每 1M $4 |
| 输出 | 每 1M $10 | 每 1M $20 |
| 缓存读取 | 每 1M $0.10 | 每 1M $0.20 |
Carbon 和 Argon 共用入门价格;所有费率都会在 12 月 1 日翻倍。AIHubMix 目前列出的仍是入门价格,尚未公布 12 月之后的价格。应将费率翻倍视为确定事项,而将网关价格视为未知;确定预算前请核对两者。
拥有真实权限的智能体
对于 Google 原生调用,Carbon 指南建议优先采用顺序执行工具的轮次。使用这条路径时,每次只构建一个调用。AIHubMix 的 Gemini 指南记录了 tool_choice="auto",但网关是否支持 Carbon 专属工具以及强制工具行为尚未得到确认。
历史记录不能以模型轮次结尾,也不支持预填充的模型轮次。如果缺少工具结果,请发送一个用户轮次,询问下一步该怎么做。
模型卡列出的问题包括偶尔变慢或超时,以及较高等级下会产生额外 token;知识截止时间为 March 2026。如果具有写入权限,真正的风险在于超时:运行超出客户端限制时可能留下部分工作成果,而且已完成的部分仍会计费。
编码工具:接入前先查看模型页面
AIHubMix 的 Carbon 列表仅记录了 Chat Completions,而且 Carbon 尚未列入公开模型索引。Claude Code 需要 Anthropic Messages;Codex 需要 Responses。尚未确认 AIHubMix 上的 Carbon 支持这两种协议。不要假设任一种都能用:打开上方链接的 Carbon 模型页面,查看协议列表。如果只显示 Chat Completions,请使用 OpenAI 兼容客户端或等待。
请求结构与 Argon 相同,但协议支持情况不同:目前,AIHubMix 仅记录了 Carbon 对 Chat Completions 的支持。Claude Code 文章介绍了 ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN 和 API_TIMEOUT_MS;Codex 文章介绍了 provider 区块、wire_api 和 model_reasoning_effort。变化之处在于协议是否可用。
| 客户端 | 所需协议 | AIHubMix 上的 Carbon |
|---|---|---|
| Claude Code | Anthropic Messages | 未记录 |
| Codex | Responses API | 未记录 |
| OpenAI SDK | Chat Completions | 已记录 |
设置:
- 模型 ID:
gemini-4-carbon。 - 思考模式:low、medium、high;默认 medium。
- 强度映射:原生字段
thinking_level,兼容字段reasoning_effort;Google 会映射推理强度值,但 AIHubMix 尚未公布 Carbon 的映射方式。只发送其中一个。 - 上下文:Google 标注为 1,048,576;AIHubMix 尚未公布 Carbon 的限制,因此不要按供应商标注的数值来构建。
- 已知问题:high 模式下首 token 较慢;供应商建议优先采用顺序工具轮次;AIHubMix 未经验证的保守上限为 65,536 个输出 token;知识截止时间为 March 2026。
冒烟测试,耗时 10–15 分钟:
- 选择一个小型代码仓库,其中有一个未通过的单元测试,且测试命令可在一分钟内完成。
- 将模型设为
gemini-4-carbon,将max_tokens设为 65,536 或更低,并将 HTTP 超时设为至少 15 分钟。 - 要求工具进行最小幅度的修改,使测试通过,然后运行测试命令并检查差异。
- 通过:修改幅度最小,且测试在 10–15 分钟内通过。失败:记录响应属于 400 错误、答案不完整、超时还是修改不当;每种情况对应的解决方法都不同,见上文。
- 如果工具支持设置等级,请测试 medium 和 high,并保留能在规定时间内完成的等级。
首次生产请求前的检查清单
- 模型 ID 设为
gemini-4-carbon。 - 不设置
temperature、top_p或top_k。 - 不设置
frequency_penalty或presence_penalty;将candidate_count设为 1,或省略该字段。 max_tokens设为 65,536 或更低。- Google 原生后台请求需发送
store=true和明确的max_output_tokens;AIHubMix 尚未记录这条路径。 - HTTP 超时设为 15 分钟或更长;优先使用流式输出。
- 在
reasoning_effort和thinking_level中只使用一个。 - Google 原生接口优先采用顺序工具轮次;AIHubMix 记录了
tool_choice="auto",但尚未确认是否支持 Carbon。 - 不显式调用缓存;稳定的提示词前缀放在最前面。
- 预算需涵盖思考 token 和每一跳长解码的费用。
- 与预算负责人确认过 December 1 的费率。
- 配置前已根据模型页面确认编码工具。
常见问题
从 Argon 迁移到 Carbon 时,请求体需要更改吗?
不需要。架构未变。更改模型 ID、检查参数值,并移除现在会返回 400 的字段。
为什么 max_output_tokens 会返回 400?
Google 的原生 Carbon API 会拒绝超过 1,048,576 的值。AIHubMix 的 Chat Completions 路径另有一项保守建议:在有更高上限的路径公布之前,将 max_tokens 保持在 65,536 或以下。值过低则会截断思考过程,情况反而更糟:答案可能不完整,而且仍会计费。
为什么响应是空的?
如果状态为未完成,文本可能为空,因为模型还在思考。你仍需为已完成的工作付费。提高上限后重试。
为什么后台请求会在 64K 处停止?
在 Google 原生后台路径中,如果省略 max_output_tokens,服务器会在 64K 处停止。请明确设置上限;原生长解码最多可达到 1,048,576 减去输入 token 的数量。AIHubMix 尚未记录后台模式。
temperature 会生效吗?
不会。temperature、top_p 和 top_k 都会被忽略。使用惩罚参数或将 candidate_count 设为大于 1 的值则会返回 400。
Carbon 在 December 1 会贵一倍吗?
Google 的费率会翻倍:输入价格从 $2 涨至 $4,输出价格从 $10 涨至 $20,缓存读取价格从 $0.10 涨至 $0.20。AIHubMix 尚未公布 December 之后的价格,因此请在确定预算前先确认。
Carbon 可以与 Claude Code 或 Codex 配合使用吗?
尚未确认。AIHubMix 记录了 Carbon 对 Chat Completions 的支持;Claude Code 需要 Anthropic Messages,Codex 需要 Responses。请先查看模型页面。
继续阅读:Gemini 4 Carbon 系列
- 如果迁移正在进行,而你接下来想确认的是 Carbon 是否物有所值,这篇对比文章会并列展示双方相同的入门费率。
Gemini 4 Carbon 与 Argon 对比:价格相同,何时值得选 Carbon? - 如果你要选的是编码智能体,而不是迁移端点,这篇正面对比将介绍工具使用和单项任务成本。
Gemini 4 Carbon 与 Fable 5.2 对比:哪款更适合智能体编码?