Anthropic випустила Claude Fable 5.2 9 листопада 2026 року. Наступного дня Google перевела Gemini 4 Carbon у загальну доступність. У таблиці бенчмарків на сторінці запуску Anthropic є стовпець Carbon, тож це зручне порівняння для однакових довготривалих завдань програмування.
Обидві моделі призначені для одного завдання: довготривалого агентного програмування. Агент читає репозиторій, редагує кілька файлів, запускає команди, переглядає результати тестів і продовжує роботу від 15 до 45 хвилин без участі людини. Саме це завдання оцінюється тут. Чат, автодоповнення та короткі скрипти — це інший тест.
Коротка відповідь
Fable 5.2 лідирує в наведених бенчмарках складного програмування та працює швидше за однакового рівня зусиль, посідаючи перші три місця в AA перед Carbon High на #4. Carbon має вищі результати в наведених рядках Terminal-Bench 4.0 та AutomationBench-AA і обходиться дешевше за завдання на рівні High, доки 30 листопада не завершиться вступна ціна Google. На рівні Medium Fable дешевша й значно швидша, а Carbon має вищий результат за індексом AA.
Обирайте Fable для складних міркувань у програмуванні, а Carbon — для виконання команд у терміналі й автоматизації; перш ніж обрати будь-яку з них, перевірте обмеження на введення, зберігання даних і виведення.
Що показує єдиний тестовий стенд
Artificial Analysis тестує всі моделі на тому самому стенді й тих самих завданнях; на сторінках Carbon і Fable наведено результати за окремими оцінюваннями. Дані взято зі знімка станом на 11 листопада 2026 року; AA використовує стандартні ціни, а не вступну знижку Google.
| Модель | Індекс AA | $/завдання | Хв./завдання | Перший токен |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Примітка: індекс інтелекту AA та вартість одного завдання за стандартними цінами, знімок 2026-11-11T05:23Z. Fable Max, Xhigh і High посідають місця з #1 до #3; Carbon High — #4; Opus 5.5 Max — #5; Carbon Medium — #6. Перший токен — це час до появи першого токена відповіді.
За рівня High Fable випереджає Carbon на 1.79 бала, коштує на 17.0% дорожче за завдання ($9.08 проти $7.76), завершує роботу за 17.3 хвилини замість 25.6, а перший токен видає за 30.4 секунди замість 67.1. Max коштує $26.54 за завдання — у 3.4 раза дорожче за Carbon High — і затримує перший токен на 233.9 секунди.
За рівня Medium порядок змінюється: результат Fable — 56.41, Carbon — 58.26, тобто Fable відстає на 1.85 бала, зате коштує $3.80 проти $6.59 і виконує завдання за 7.8 хвилини проти 23.3. Нижча ціна токена Carbon не означає нижчу вартість завдання: тут модель використовує більше токенів.
| Бенчмарк | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Без галюцинацій, % | 88.58 | 42.02 | 40.73 | 49.66 |
| Точність, % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Примітка: Artificial Analysis, той самий тестовий стенд і знімок даних. Частка відповідей без галюцинацій — це частка відповідей Omniscience без вигаданих тверджень; точність — окремий показник. У кожному рядку вищий результат кращий. Fable Xhigh не включено, щоб таблиця залишалася читабельною; її результат у FrontierCode 2.0 — 47.58.
Яка модель лідирує в кожному тесті на рівні High? Знакове відхилення нижче — це результат Carbon мінус результат Fable; воно показує напрям різниці, а в таблиці вище наведено абсолютні результати.
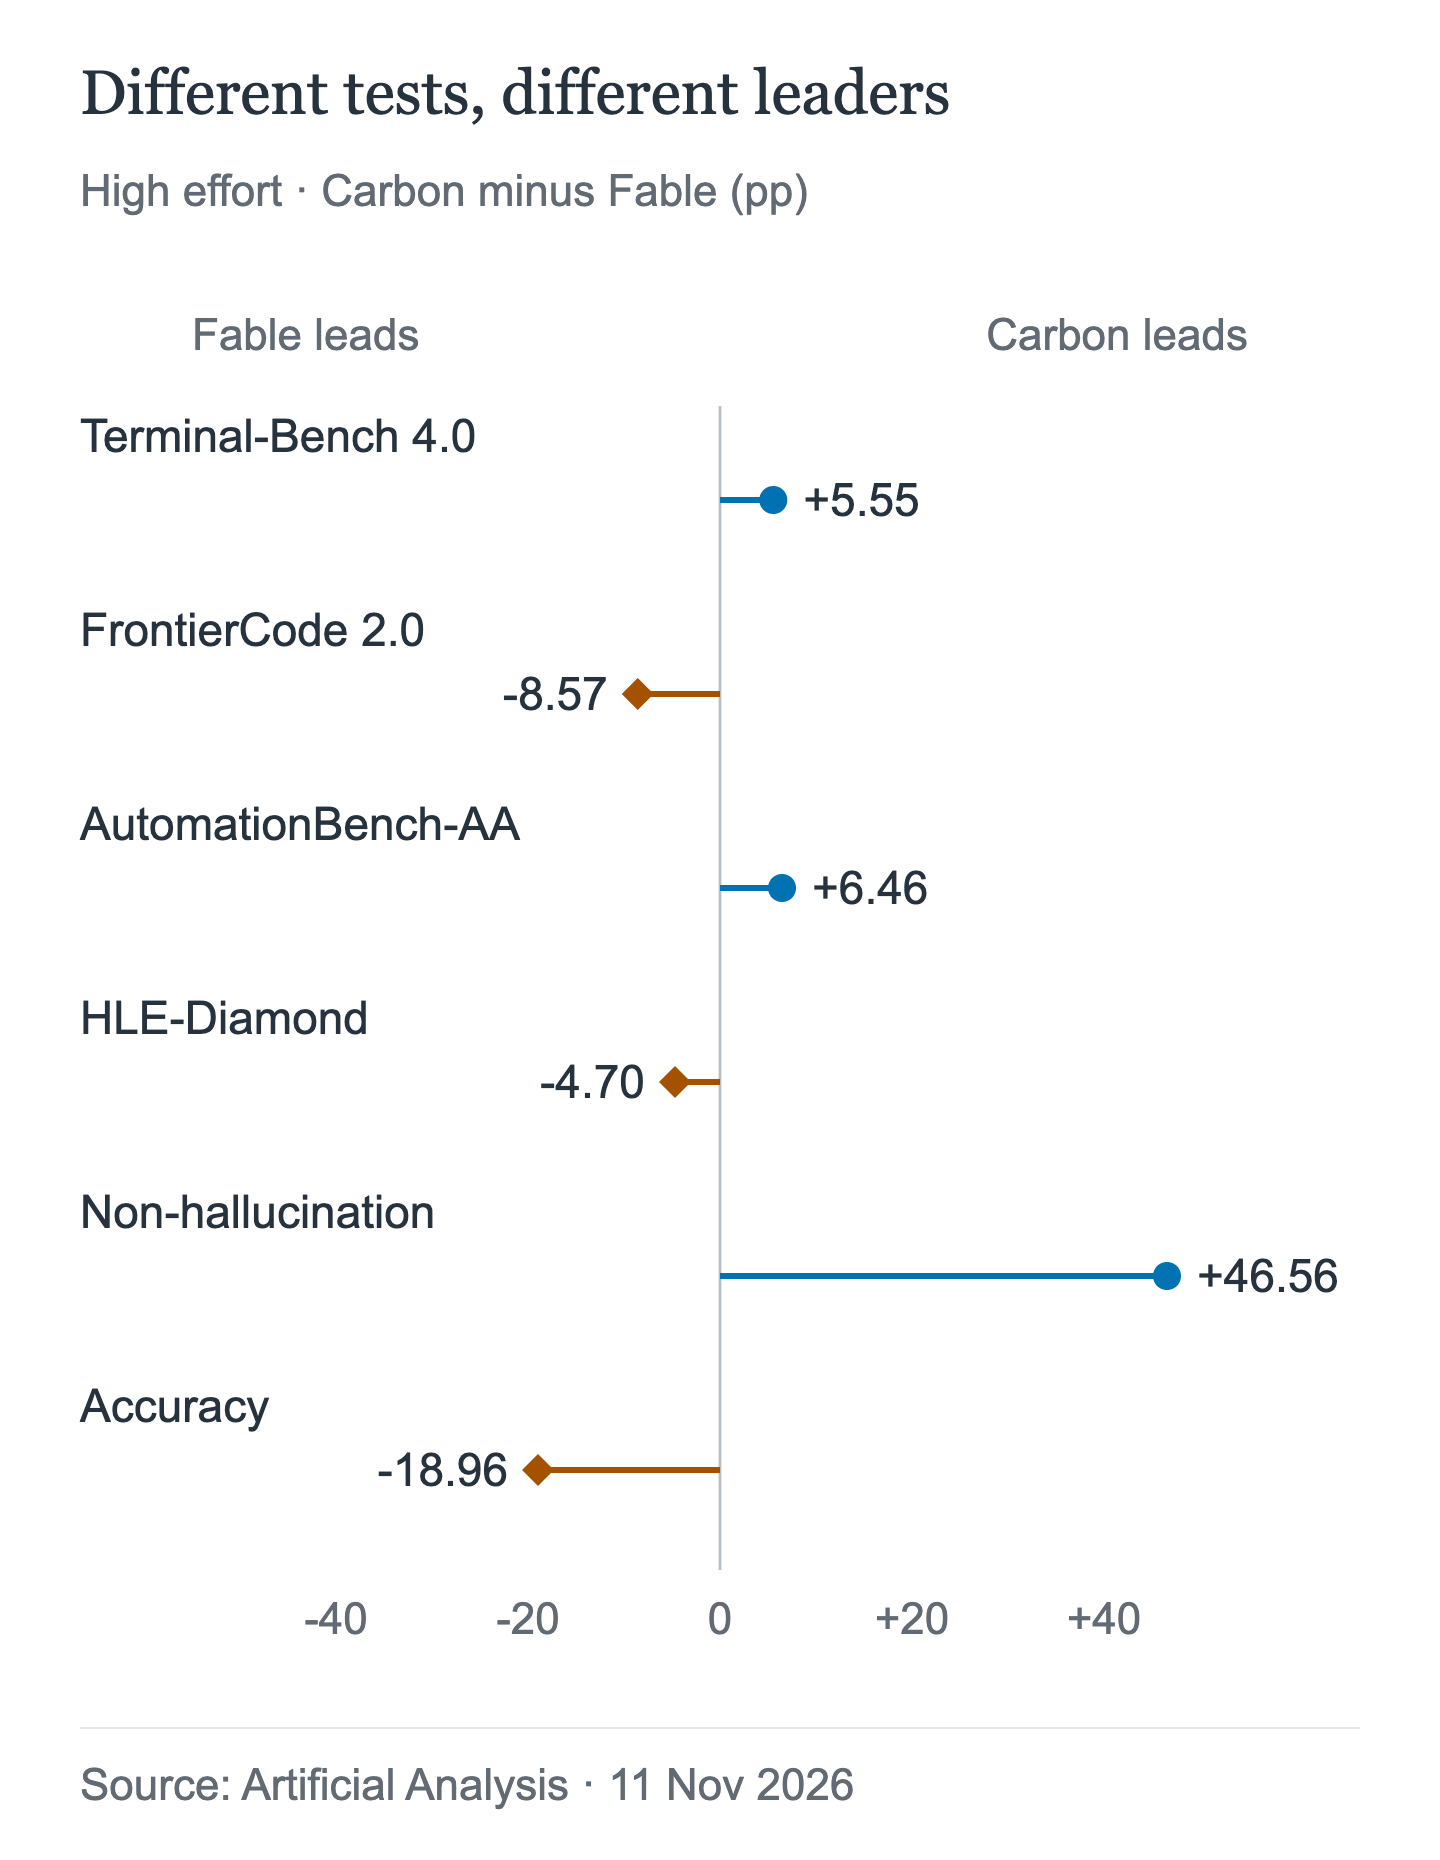
Це різниці у відсоткових пунктах за незалежними тестами, а не зведений показник якості. Більша різниця в одному бенчмарку не означає загального поліпшення здібностей. Зокрема, відсутність галюцинацій і точність вимірюють різні результати.
На рівні High Fable випереджає Carbon у FrontierCode 2.0 на 8.57 бала, а в HLE-Diamond — на 4.7; результат Briefcase Elo становить 1677.4 проти 1610.6. FrontierCode — найближчий бенчмарк до складних змін коду в кількох файлах. Carbon випереджає Fable у Terminal-Bench 4.0 на 5.55 бала, а в AutomationBench — на 6.46; ці тести оцінюють виконання командного рядка, відновлення після збоїв та автоматизацію.
Різниця за відсутністю галюцинацій — найбільша в таблиці: 88.58% у Carbon проти 42.02% у Fable на рівні High. За точністю результати протилежні: 58.27% проти 77.23%. Carbon рідше вигадує факти, але й рідше відповідає правильно. Для агента, який не повинен вигадувати API, це може бути важливішим; якщо ж агент має давати правильні відповіді, точність Fable — переконливіший показник.
Більше зусиль не завжди означає кращий результат: Fable Max набирає 48.76 у FrontierCode — трохи менше, ніж 49.13 у High, а результат у Terminal-Bench залишається на рівні 59.6.
Власна таблиця Anthropic
На сторінці запуску Anthropic опублікувала порівняльну таблицю моделей різних постачальників, до якої включено Carbon. Налаштування відрізняються від AA: Fable тестували на Xhigh, найвищому зазначеному рівні зусиль, а Carbon — на Medium. Порівнюйте результати лише в межах цієї таблиці.
| Бенчмарк | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Примітка: дані надані самою Anthropic. Fable тестували на Xhigh — найвищому доступному рівні зусиль; Carbon — на Medium. Шкала AutomationBench від Anthropic відрізняється від шкали AA (51.4/53.9 проти 71.36/77.82), тож порівнюйте результати в межах цієї таблиці. Результат Carbon 41.1 у FrontierCode отримано на рівні Medium; показник AA 40.56 — це результат на рівні High, отриманий на іншому тестовому стенді.
Напрям результатів збігається з AA: Fable лідирує у FrontierCode, FrontierSWE, OSWorld і TB-Science; Carbon випереджає її в AutomationBench на 2.5 бала — менше, ніж на 6.5 у AA, але з тим самим знаком. Таблиця підтверджує, що «Carbon добре показує себе в автоматизації», а не те, що «Carbon — краща модель для складного програмування».
Власна рекомендація Anthropic ускладнює твердження «Fable — це оновлення»: «Для більшості завдань із програмування та роботи зі знаннями радимо користувачам починати з Claude Opus 5.5». За рівня High, зазначає компанія, Fable показує приблизно такий самий результат, як найкращий результат Opus 5.5 (45.3% проти 45.5%), але вартість одного завдання приблизно вдвічі нижча.
Скільки коштують токени
| Модель | Вхідні | Вихідні | Читання з кешу |
|---|---|---|---|
| Carbon, до 30 листопада | $2 | $10 | $0.10 |
| Carbon, з 1 грудня | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Примітка: USD за 1M токенів, офіційні ціни. Запис у кеш Fable: $10 (5 хвилин) або $16 (1 година); пакетна обробка — знижка 50%. Ціна Carbon для кешованих даних стосується читання; офіційна ціна читання з кешу для Opus 5.5 — $0.20.
Ціна токенів Fable удвічі вища за стандартну ціну Carbon і вчетверо — за вступну. Співвідношення просте, а рахунок за завдання — ні. За даними AA, завдання на Carbon High за цінами $4/$20 коштує $7.76, а на Fable High — $9.08, різниця становить 17.0%. За ціною Google $2/$10 те саме використання коштує близько $3.88 — це обчислена оцінка. До 30 листопада Fable High обходиться приблизно у 2.3 раза дорожче за завдання; з 1 грудня різниця знову становитиме 17.0%.
За стандартними цінами Fable Medium коштує $3.80 проти $6.59 у Carbon — на 42% менше, попри вдвічі вищу ціну токена. Carbon витрачає 23.3 хвилини й використовує більше токенів; Fable — 7.8 хвилини. За вступною ціною Carbon Medium коштує приблизно $3.30 — розрахунок виконано тим самим способом — і майже зрівнюється з Fable; 1 грудня ця перевага зникне.
Max коштує за завдання у 3.4 раза дорожче за Carbon High ($26.54) і працює 45.2 хвилини. Більші витрати не гарантують, що агент для програмування буде кращим за всіма показниками: результат Max у FrontierCode трохи нижчий, ніж у High.
AIHubMix пропонує Carbon за вступною ціною Google. Наведені тут ціни Fable — офіційні тарифи Anthropic.
Відмінності в поведінці, що впливають на розгортання
| Параметр | Carbon | Fable 5.2 |
|---|---|---|
| Максимальний обсяг виведення | 65,536; нативно ≤1,048,576−вхід* | 128,000 |
| Контекст | 1,048,576 (нативне значення Google) | 1M |
| Міркування | low / medium / high; за замовчуванням medium | адаптивне; за замовчуванням high |
| Примусове використання інструментів | документовано auto* | будь-який варіант / інструмент повертає 400 |
| Параметри вибірки | ігноруються; вилучіть | деякі значення повертають 400 |
| Зберігання даних | обмеження не зазначено | 30 днів; без ZDR |
| Вхідні дані | текст в AIHubMix | текст, зображення, PDF† |
| Актуальність знань до | березень 2026 року | червень 2026 року |
Примітка: *Вищі межі Carbon стосуються нативних для Google можливостей тривалого декодування; наразі AIHubMix документує лише текстове введення та Chat Completions, тому підтримку через шлюз не підтверджено. †Модальності введення Fable наведено в індексі моделей AIHubMix. *AIHubMix документує tool_choice="auto", але підтримку Carbon не підтверджено. Документоване обмеження моделі Fable на виведення — 128,000 токенів. ZDR означає нульове зберігання даних.
Примусове використання інструментів — суттєве обмеження для Fable: «Примусове використання інструментів (типи tool_choice any і tool) повертає помилку 400». Агент, який мусить викликати певний інструмент на кожному ході, не може використовувати Fable без змін. У посібнику Google для Carbon рекомендовано послідовні ходи виконання інструментів; у посібнику Gemini від AIHubMix зазначено tool_choice="auto", але підтримку інструментів Carbon через шлюз не підтверджено.
Політика зберігання даних є обмеженням для Fable: в її огляді зазначено, що модель «потребує зберігання даних протягом 30 днів і недоступна за режиму нульового зберігання даних, якщо Anthropic прямо не надасть дозвіл». У документації Carbon, яку розглянуто тут, такого обмеження немає, але це не є гарантією. Командам, що працюють із регульованими даними, слід підтвердити обидві політики перед розгортанням.
Стандартного ліміту Carbon у 65,536 токенів вистачає для більшості редагувань; під час генерування цілих файлів його можна вичерпати. Фоновий режим Google нативно підтримує до 1,048,576 токенів мінус обсяг вхідних даних, тарифікує переходи між сегментами й може повернути incomplete з порожнім текстом, але списати кошти. AIHubMix не документує цей сценарій. Fable повертає 128,000 токенів в одній відповіді.
У жодної з моделей не можна вимкнути режим міркування. Carbon пропонує рівні low, medium і high, за замовчуванням використовує medium та ігнорує параметри вибірки. В Fable «адаптивне міркування завжди ввімкнене й не може бути вимкнене», за замовчуванням встановлено high, а деякі значення параметрів вибірки викликають помилку 400.
Google надала Carbon захисникам кібербезпеки через програму Fairwind ще до загальної доступності. Класифікатори Fable блокують запити на пентест і експлойти та перенаправляють завдання з кібербезпеки й біології до інших моделей. Для тестування безпеки поведінка моделі під час відмови важливіша за рядок у бенчмарку.
Opus 5.5 як модель для порівняння
Opus 5.5 — не конкурент, а власна точка відліку Anthropic. За цінами $4/$20 модель набирає 59.11 в AA, коштує $10.04 за завдання, працює 25.0 хвилин, а на перший токен чекають 356.4 секунди — це найповільніший результат у таблиці (у рядку AA наведено рівень Max; за замовчуванням використовується Medium). Opus 5.5 лідирує в Briefcase Elo з результатом 1800.6, але поступається Fable High у FrontierCode і Carbon High у Terminal-Bench. Попри це, Anthropic і далі радить починати з Opus 5.5 для більшості завдань із програмування.
Кому що обрати
Обирайте Fable 5.2, якщо переважають складні зміни коду й вам потрібні найкращі виміряні результати у FrontierCode та HLE. На рівні Medium вона дешевша й швидша — $3.80 і 7.8 хвилини проти $6.59 і 23.3 у Carbon, — тоді як Carbon має вищий результат за індексом AA. Обирайте Fable, якщо потрібне введення зображень або актуальність знань до червня 2026 року чи якщо вас влаштовують зберігання даних протягом 30 днів і відсутність примусових викликів інструментів.
Обирайте Carbon, якщо основна робота відбувається в терміналі: цикли тестування й виправлення, автоматизація оболонки, багатоетапні операції. У наведених результатах Terminal-Bench 4.0 і AutomationBench-AA він набирає більше балів і коштує дешевше за високого рівня зусиль до 30 листопада. Контекст, інтегрований із Google, і обмеження на довжину виводу не підтверджені через AIHubMix; використовуйте його лише для тексту з tool_choice="auto", попередньо підтвердивши підтримку інструментів у Carbon. Його показник невигадування фактів вищий, а точність — нижча.
Обирайте Opus 5.5, якщо потрібен рекомендований Anthropic варіант для старту зі збалансованими характеристиками; змиріться з повільною появою першого токена за максимального рівня зусиль.
Для інтерактивної роботи не обирайте жодну з моделей: за високого рівня зусиль перший токен з’являється через 30.4 секунди у Fable і через 67.1 секунди у Carbon, а 23.2 секунди у Carbon Medium — усе ще далеко від швидкості чату.
Запустіть обидві моделі через AIHubMix
AIHubMix надає доступ до обох моделей через один ключ і спільний ендпоінт chat completions. Ідентифікатор Carbon — gemini-4-carbon; на сторінці моделі описано chat completions, текстовий ввід і початкову ціну Google. Ідентифікатор Fable 5.2 — claude-fable-5-2; AIHubMix указує Chat Completions, Responses і Anthropic Messages, контекст на 1M і максимальний вивід на 128K. Задокументовані можливості Carbon вужчі: chat completions, а не нативний Gemini API. Шлюз також повторює запит через наступного найкращого провайдера, тож поведінка може відрізнятися від розгортання через одного провайдера.
Короткий посібник пояснює автентифікацію та базову URL-адресу. Димовий тест може перевірити, чи працюють обидва ідентифікатори з одним ключем; для цієї чернетки тест у реальному середовищі не проводили:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Це перевіряє маршрутизацію, а не можливості: без інструментів і довгого виводу. Для реального порівняння запустіть однаковий сценарій агента з обома ідентифікаторами та зафіксуйте час виконання завдання, використання токенів і помилки. На сторінці порівняння поруч наведено контекст, протоколи й ціни.
Поширені запитання
Чи краща Gemini 4 Carbon за Fable 5.2 для агентного програмування?
Жодна модель не перемагає в усіх аспектах роботи. За високого рівня зусиль Fable 5.2 випереджає конкурентів у FrontierCode 2.0 та загальному індексі; Carbon — у Terminal-Bench 4.0 і AutomationBench. Обирайте модель відповідно до завдань, які насправді виконує агент.
Чому Fable 5.2 коштує вчетверо дорожче за Carbon?
За офіційними тарифами Fable коштує $8/$40 за мільйон токенів, а початкова ціна Carbon — $2/$10, тобто вчетверо менше за вхідні й вихідні токени. Порівняно зі стандартним тарифом Carbon $4/$20, чинним із 1 грудня, Fable коштує вдвічі дорожче.
Чи справді Fable 5.2 коштує менше за одне завдання на рівні Medium?
За стандартними цінами — так: $3.80 проти $6.59 у Carbon Medium, а час виконання — 7.8 хвилини проти 23.3. Початкова ціна токенів Carbon скорочує розрив, але стандартне порівняння є показовішим у довгостроковій перспективі.
Чи може Fable 5.2 примусово викликати інструмент?
Ні. В документації Anthropic зазначено, що значення tool_choice any і tool спричиняють помилку 400. Агентам, яким потрібен примусовий виклик, знадобиться інший цикл роботи або інша модель.
Чи менше Carbon схильна до галюцинацій, ніж Fable 5.2?
За показником невигадування фактів Omniscience від AA — так: 88.58% проти 42.02% за високого рівня зусиль. Однак точність у неї нижча — 58.27% проти 77.23%, тож вона також рідше дає правильну відповідь.
Чи можна запускати обидві моделі через AIHubMix з одним ключем?
Так. Використовуйте gemini-4-carbon і claude-fable-5-2 з тим самим ключем і базовою URL-адресою. Для Carbon в AIHubMix задокументовано chat completions, а для Fable — chat completions, Responses і Messages.
Читайте далі: серія Gemini 4 Carbon
- Перш ніж обирати конкурента, розберіться зі спорідненими моделями: Gemini 4 Carbon проти Argon: однакова ціна — коли Carbon варта вибору?
- Коли Carbon уже в роботі, перші помилки 400 і тайм-аути зазвичай пов’язані з конфігурацією, а не з моделлю: Міграція API Gemini 4 Carbon: помилки 400, тайм-аути й обмеження виводу
Джерела
- Gemini 4 Carbon уже доступна — Google, 10 листопада 2026 року.
- Claude Fable 5.2 — Anthropic, 9 листопада 2026 року.
- Огляд Claude Fable 5.2 — документація Anthropic.
- Gemini 4 Carbon і Claude Fable 5.2 — Artificial Analysis, дані станом на 11 листопада 2026 року.
- Gemini 4 Carbon на AIHubMix — сторінка моделі й тарифи.