
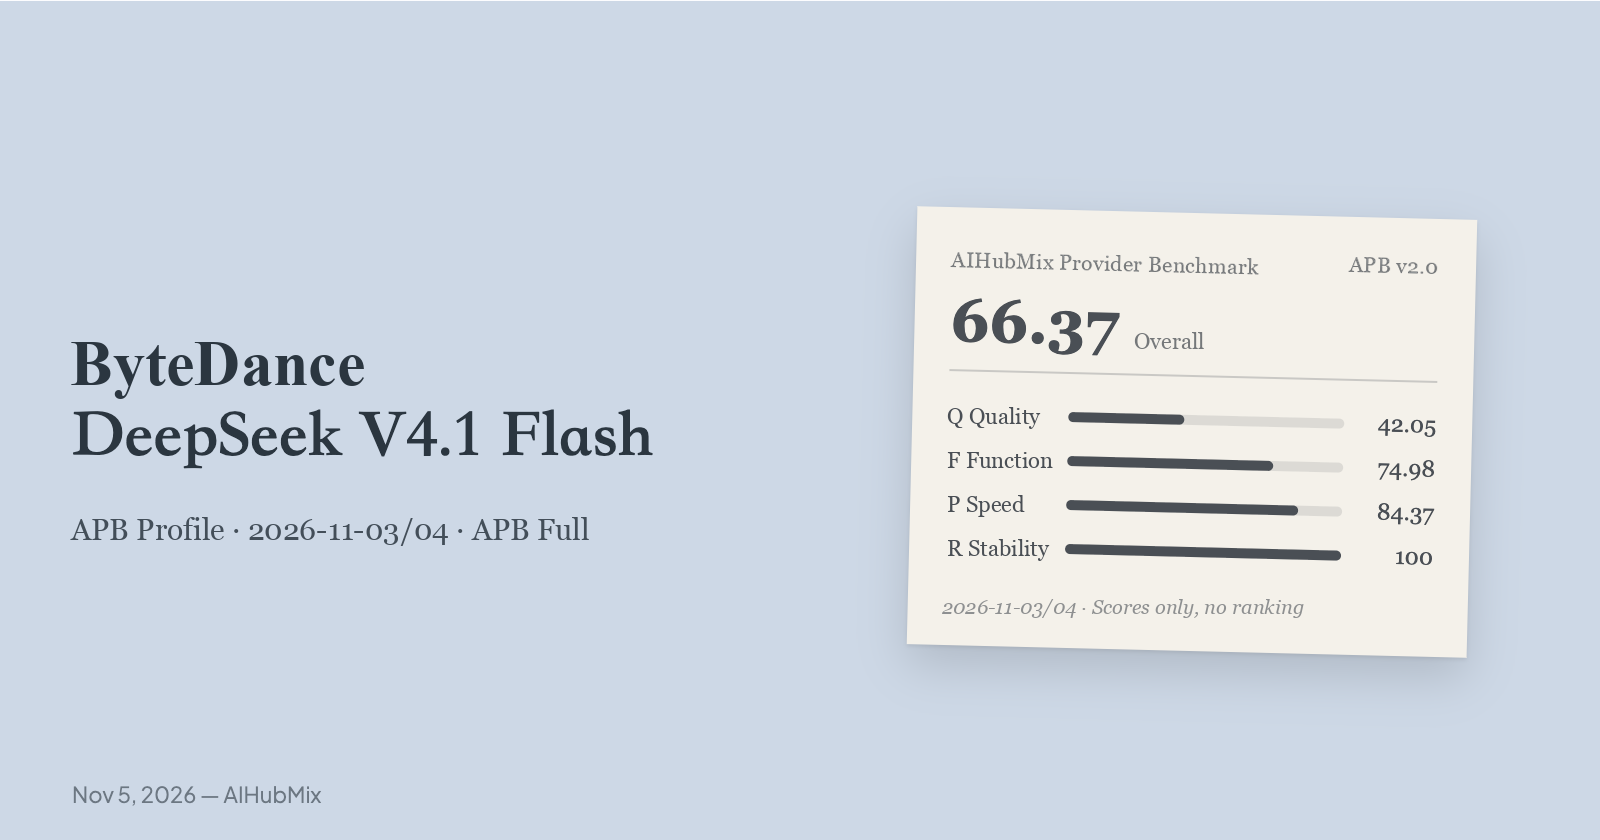
2026-11-03/04 tarihlerinde DeepSeek V4.1 Flash 1017, her seferinde aynı sorular, parametreler ve istek betikleri kullanılarak AIHubMix üzerinden beş sağlayıcıda APB Full paketiyle test edildi. Bu APB Profili, yalnızca ByteDance çalışmasını bölüm bölüm ele alıyor.
Aşağıdaki sayılar puanlardır; sıralama veya sağlayıcı önerisi değildir. Önce Q, F, P, K ve R gelir; genel puan bir özet endeksidir, sertifikasyon değildir ve güven aralığı yoktur. Puanlama kuralları AIHubMix Provider Benchmark Standard v2.0'da tanımlanmıştır.
Beş sağlayıcı genelinde puanlar
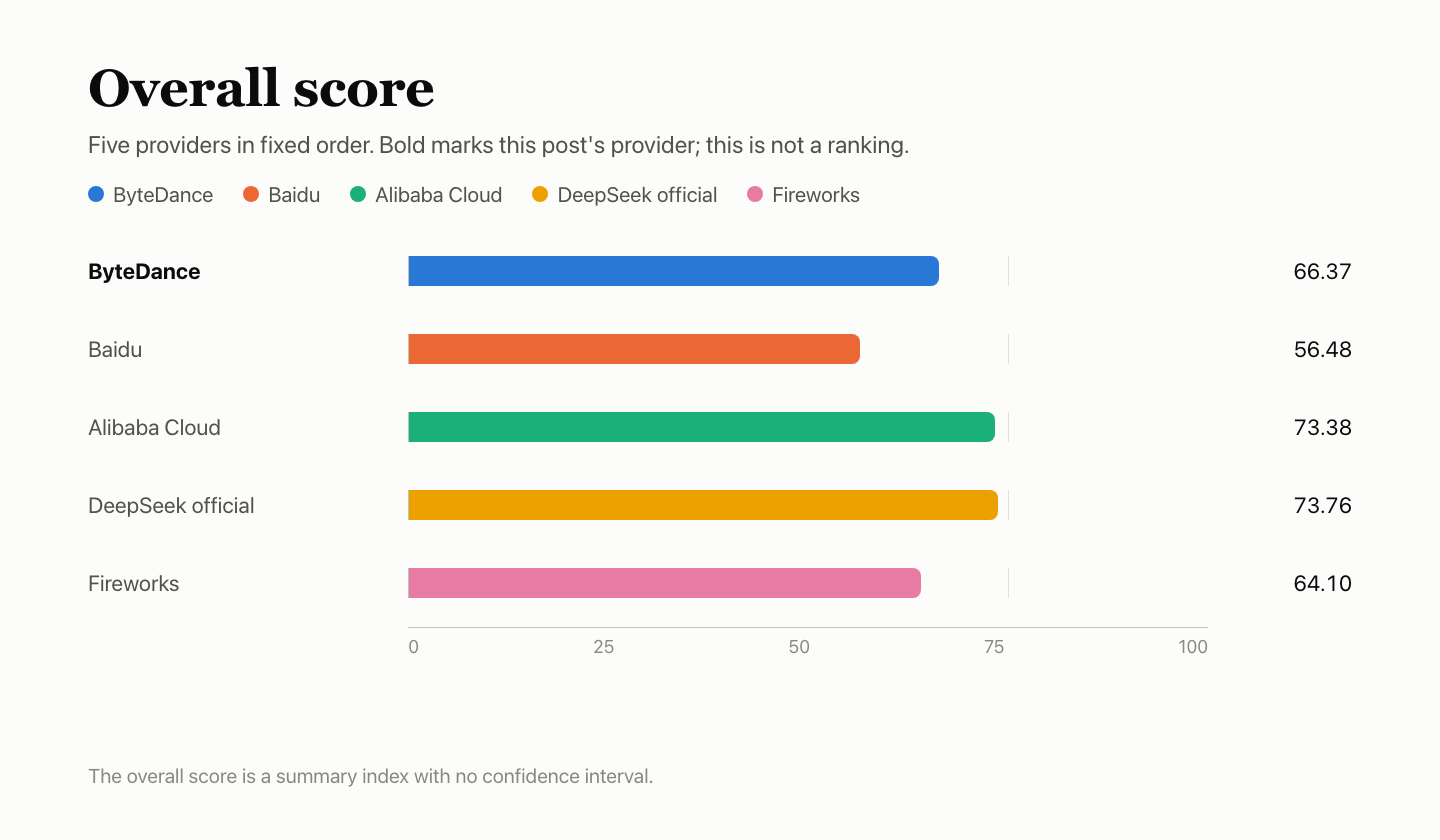
Kalın yazı, bu gönderideki sağlayıcıyı gösterir. Sağlayıcıların sırası sabittir, sıralama değildir. K, P'nin alt puanıdır ve P'nin %20'sini oluşturur. Genel puan, güven aralığı olmayan bir özet endeksidir. DeepSeek'in resmî kanalı ile Alibaba Cloud arasındaki fark 0.37'dir ve bu ikisi birbirinden ayırt edilemez.
Genel bakış
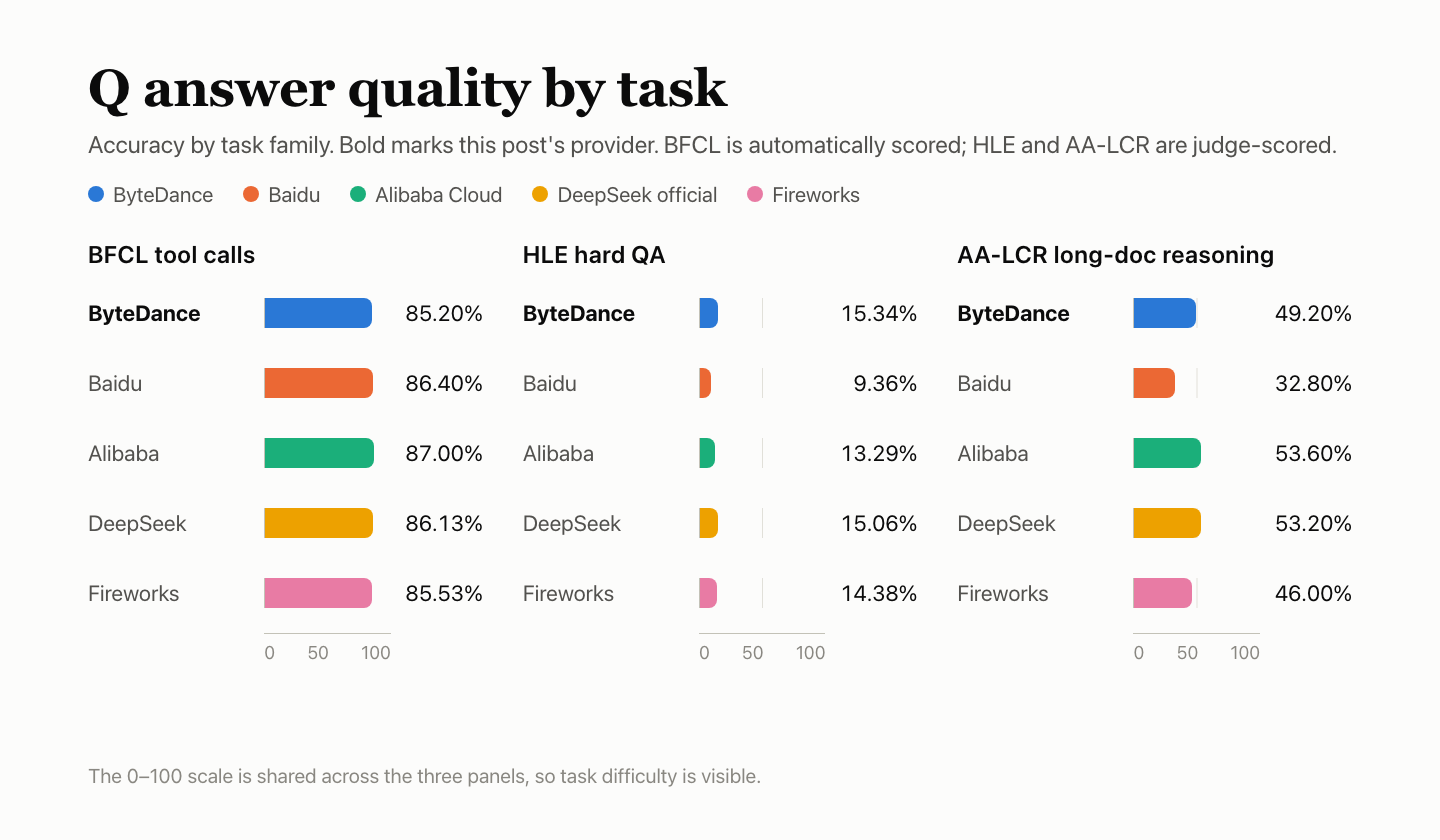
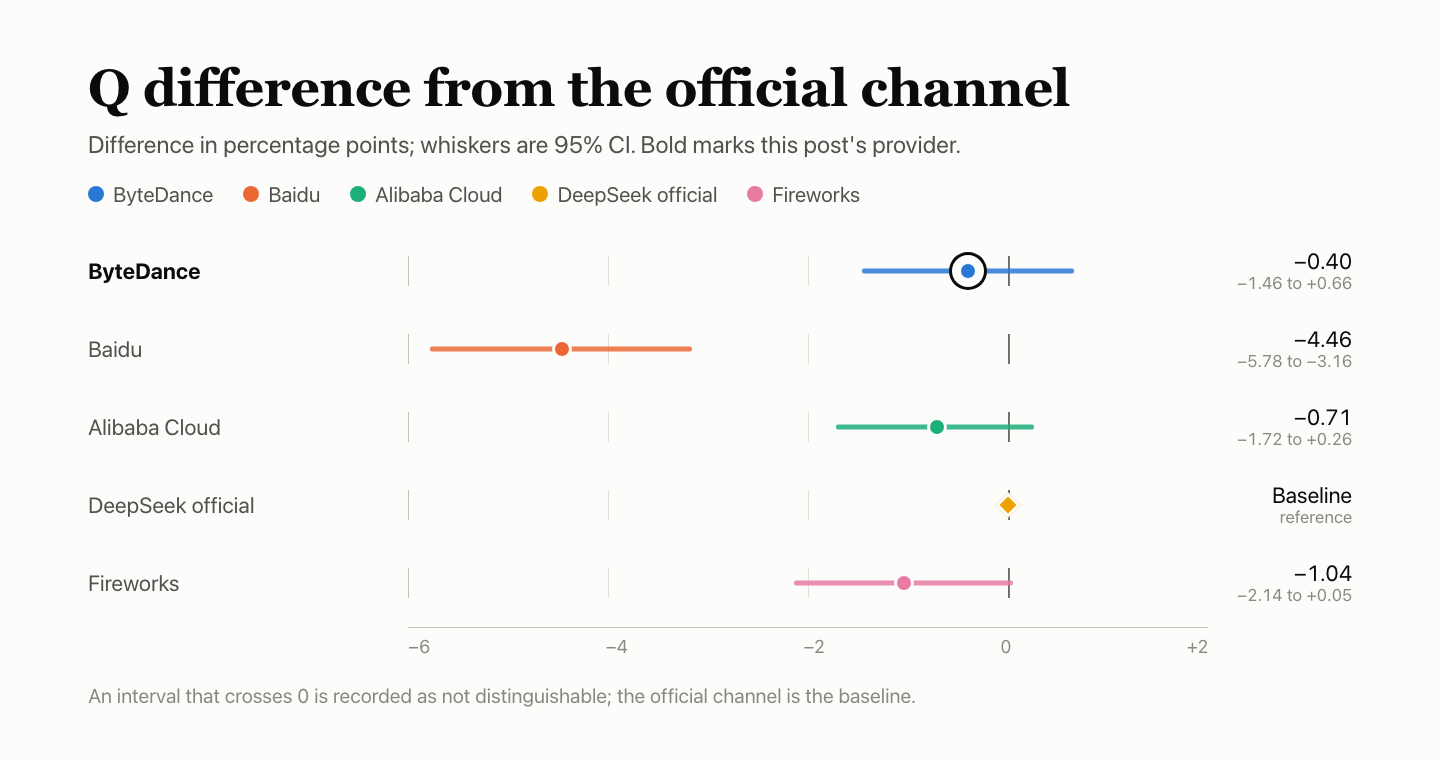
- Q 42.05. BFCL %85.20, HLE %15.34, AA-LCR %49.20. Resmî kanala göre fark −0.40 yüzde puan; %95 aralık −1.46 ile +0.66 arasında: ayırt edilebilir değil. AA-LCR'de, tamamı 1. pencerede gerçekleşen 28 istek hatası vardı ve bunlar yanlış sayıldı.
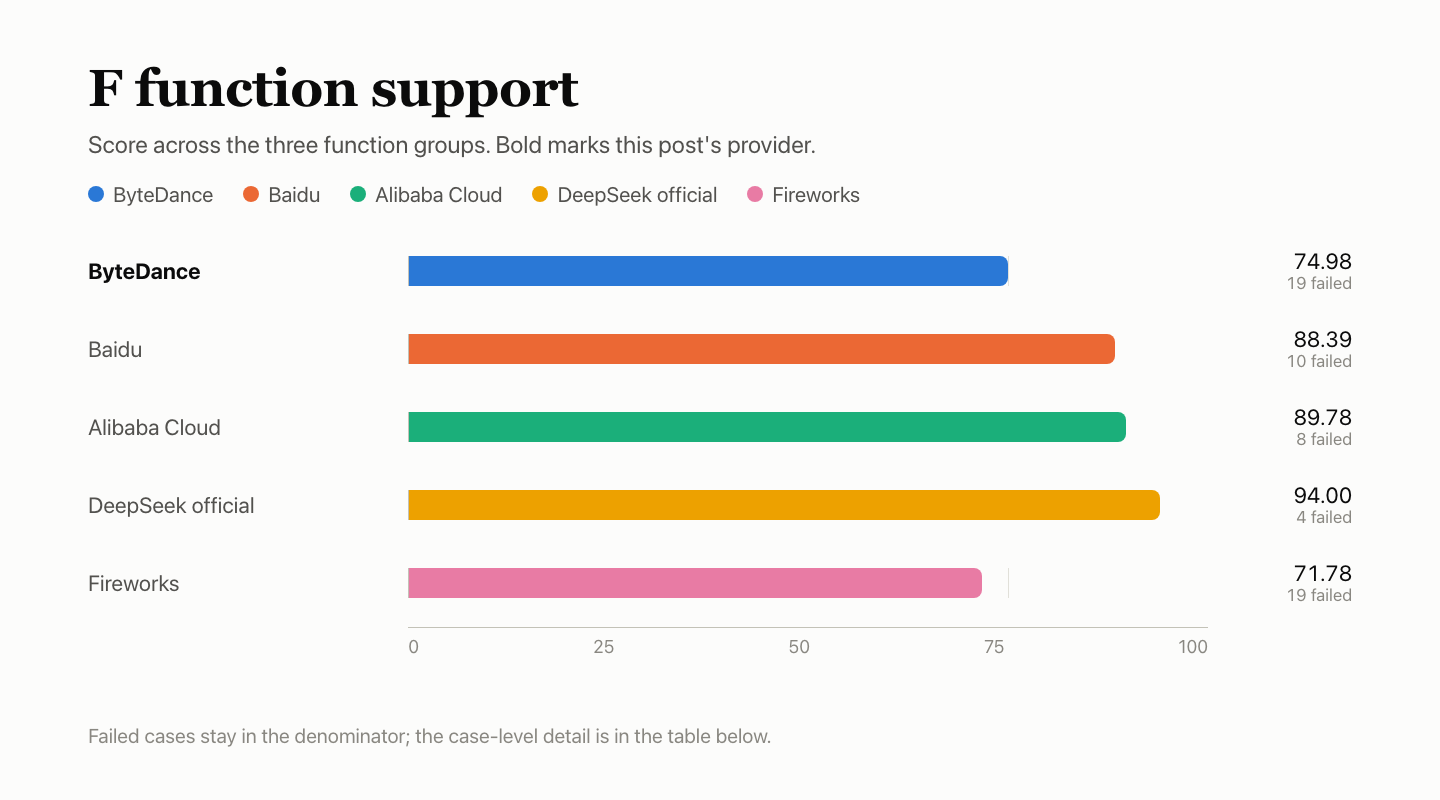
- F 74.98. Sayılan 174 kontrolden 124'ü geçti.
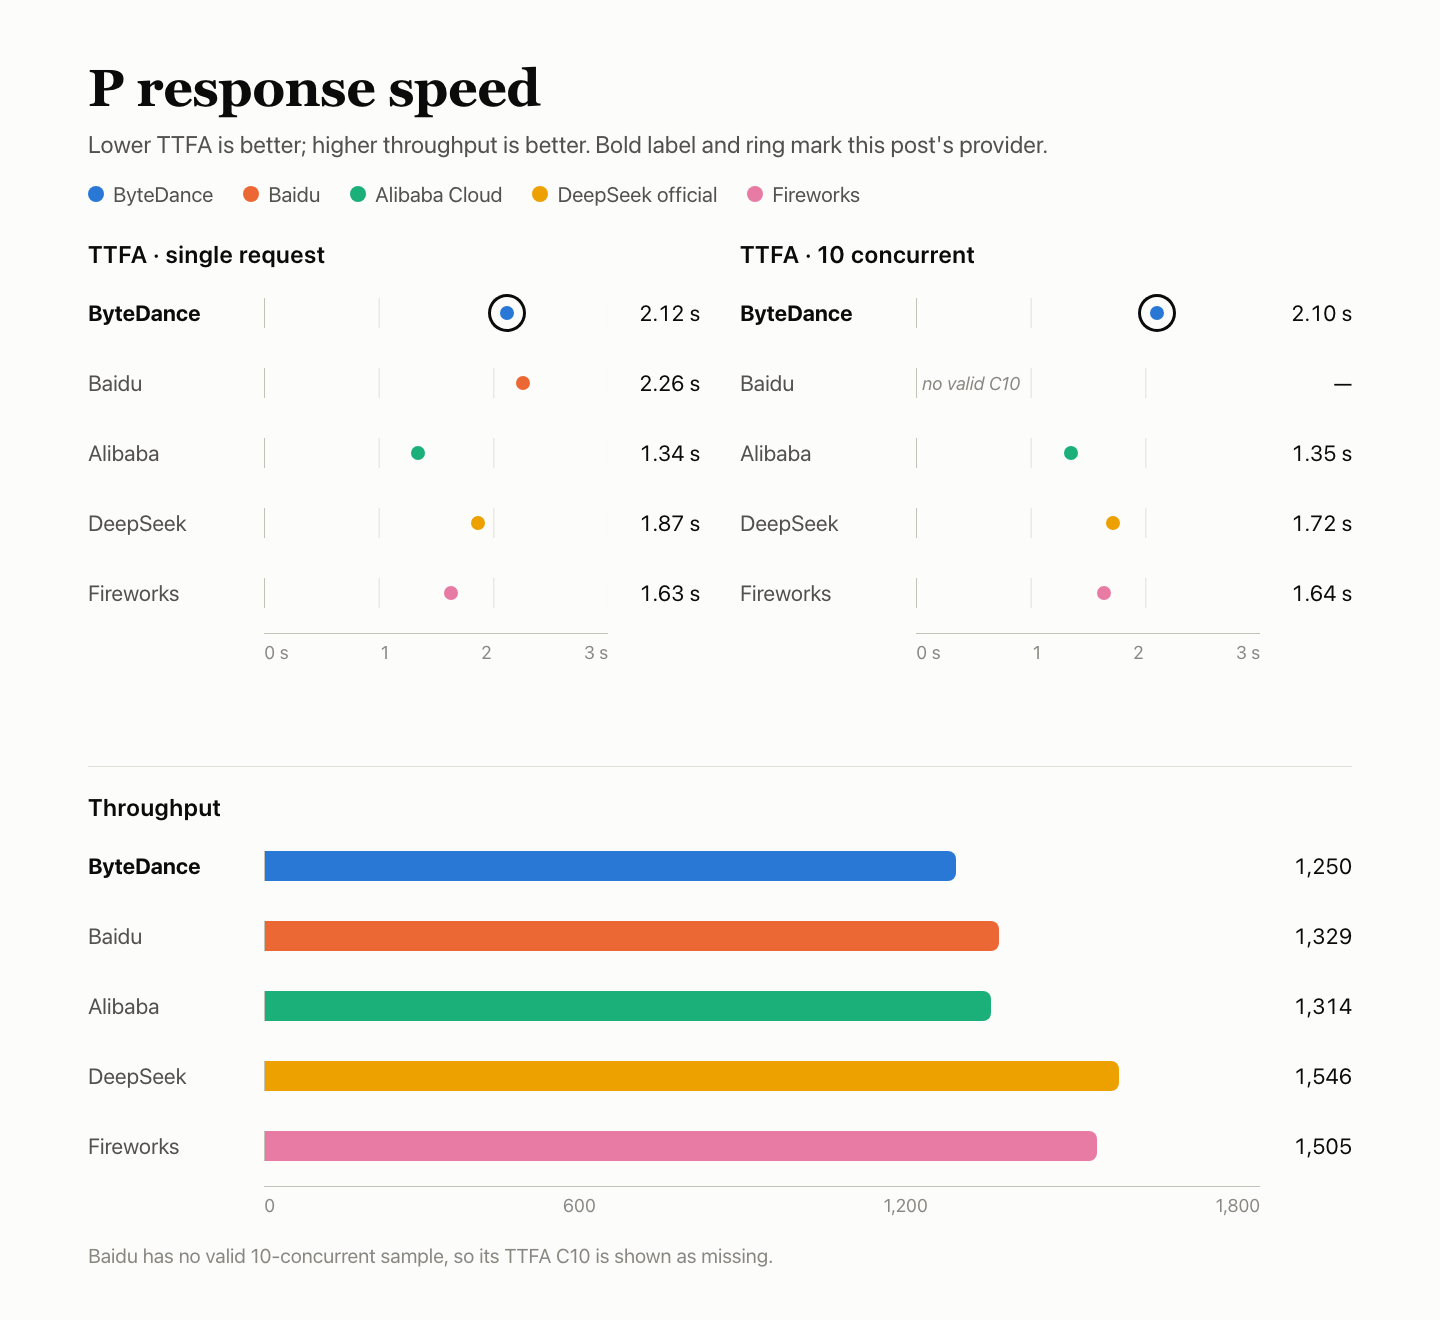
reasoning_effort=nonedüşünme özelliğini kapatmıyor. 10k tokenlık girdi 10,026 token olarak raporlandı (yerel sayım 10,000); 8 tokenlık girdi ise 34 olarak raporlandı. - P 84.37. İlk gövde tokenına kadar geçen süre: tek eşzamanlı istekte medyan 2.12 s, 10 eşzamanlı istekte 2.10 s; TPOT 3.43 ms/token; 180 hız isteğinin tamamı geçerliydi.
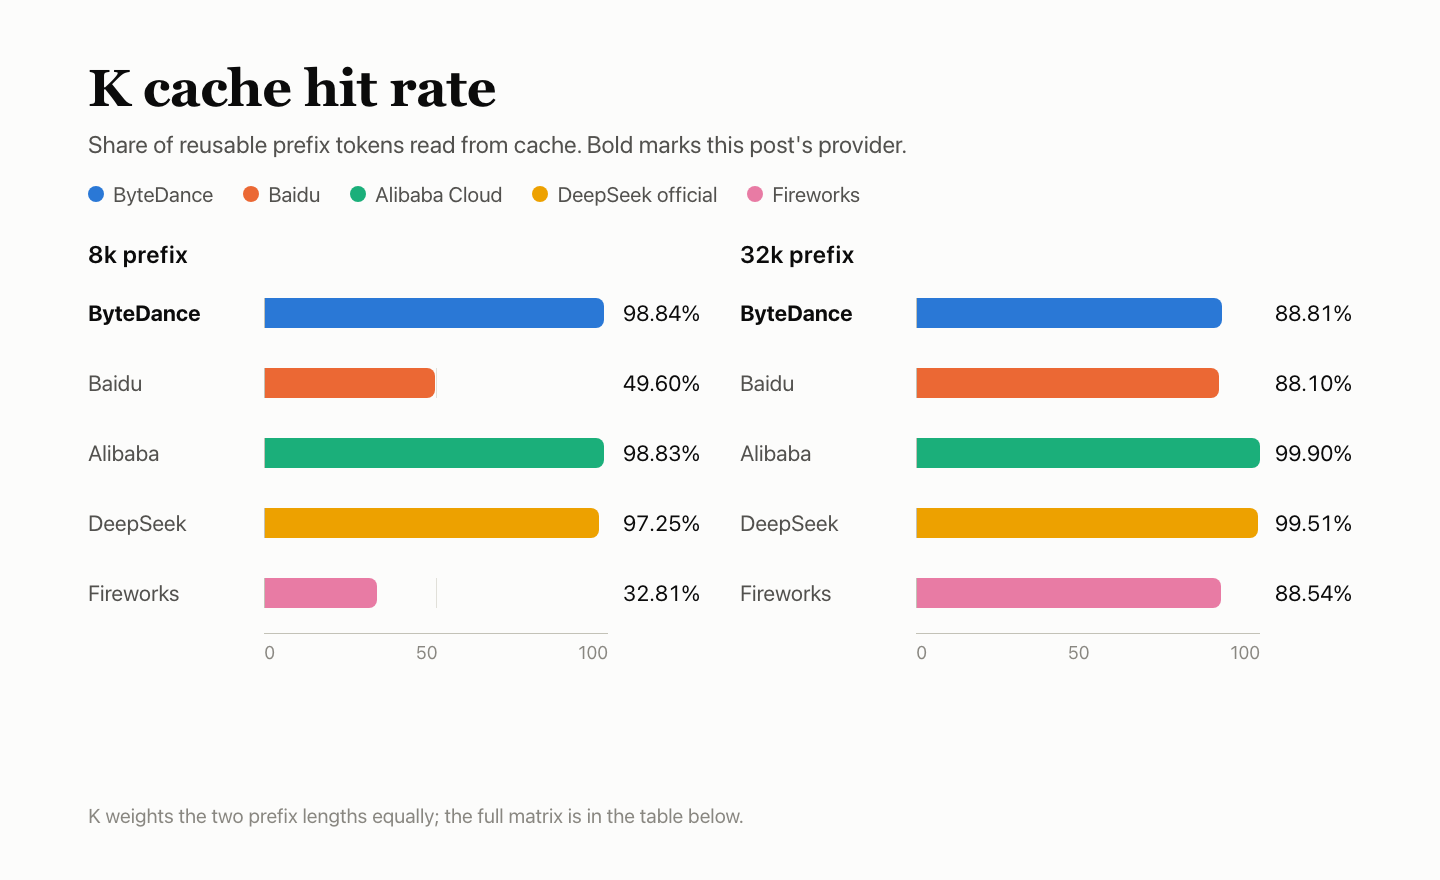
- K 93.83. 8k sıcak istekler 9/9 isabet etti; 32k isteklerde 8 isabet alındı, bir istek ise 300 s'lik süre sınırında tamamlanmadı.
- R 100. Özel amaçlı 300 isteğin tamamı ilk denemede başarılı oldu.
Test düzeni
| Öğe | Ayrıntı |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| İstenen model kimliği | doubao-deepseek-v4.1-flash-1017 |
| Döndürülen model adı | deepseek-v4-1-flash-261017 |
| Erişim yolu | Sağlayıcıya ait hesaba doğrudan bağlanmak yerine, sağlayıcıya özgü bir model kimliğiyle AIHubMix üzerinden |
| Parametreler | Düşünme dışı mod, temperature 1.0, max_tokens 16,384, zaman aşımı 300 s, otomatik yeniden deneme yok |
| Düşünme kapalı | Yanıt kalitesi, hız, önbellek ve kararlılık isteklerinde yerel thinking.type=disabled kullanıldı (bu sağlayıcıda reasoning_effort=none düşünmeyi kapatmadı); parametrenin etkili olup olmadığını kontrol etmek için işlev testlerinde reasoning_effort=none korundu |
| Zaman | 2026-11-03 18:07 – 11-04 16:33 UTC+8; beş sağlayıcı tek bir Mac mini'yi, tek bir ağı ve tek bir hesabı paylaştı |
| Örnekler | Yanıt kalitesi: 4,250 soru örneği (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); işlev: 60 vaka × 3 pencere; hız: tek eşzamanlılıkta 90 ve 10 eşzamanlılıkta 90; kararlılık: 300; önbellek: 30 (8k ve 32k öneklerin her biri için üç grup) |
İsteklerde sağlayıcıya özgü bir kimlikle AIHubMix hızlı başlangıç yolu kullanıldı ve parametreler DeepSeek'in API belgelerini izledi; diğer sağlayıcı kimlikleri modeller sayfasında listelenmiştir.
Q — yanıt kalitesi: 42.05
Yanıt kalitesi üç paketi kapsıyor: her biri 3 tur yapılan 500 BFCL sorusu, her biri 10 tur yapılan 250 HLE sorusu ve her biri 10 tur yapılan 25 AA-LCR sorusu. BFCL otomatik kurallarla puanlanıyor; HLE ve AA-LCR ise deepseek-flash modeli tarafından değerlendiriliyor. Beş sağlayıcının tümüne aynı sorular yöneltildi ve üç paketin sonuçları tek bir doğruluk puanında birleştirildi. Sorusu puanlanamayan 10 yanıt çıkarıldı; geriye puanlanan 4,240 soru örneği kaldı.
| Paket | Sorular | Doğru | Doğruluk | Hatalar |
|---|---|---|---|---|
| BFCL araç çağrıları | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| HLE zor soru-cevap | 250 × 10 | 382/2,490 | 15.34% | 7 |
| AA-LCR uzun belge akıl yürütme | 25 × 10 | 123/250 | 49.20% | 28 |
| Birleşik · %95 aralık 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Hizmet hataları — istek hataları veya kesilen çıktı — paydada kalır ve yanlış sayılır. HLE çıktısı 7 kez max_tokens sınırına ulaştı; AA-LCR'de tamamı 1. pencerede gerçekleşen 28 istek hatası vardı. BFCL otomatik olarak, HLE ve AA-LCR ise değerlendirici tarafından puanlanır.
Her BFCL sorusu 3 kez yanıtlandı; tabloda 3 turun toplamı gösteriliyor.
| BFCL kategorisi | Geçti | Geçme oranı |
|---|---|---|
| simple_python — tek işlev, doğru çağrı ve argümanlar | 329/360 | 91.39% |
| multiple — birkaç işlev arasından birini seçme | 268/300 | 89.33% |
| parallel — aynı işlevi birkaç kez çağırma | 271/300 | 90.33% |
| parallel_multiple — birkaç farklı işlevi çağırma | 207/240 | 86.25% |
| irrelevance — hiçbir işlev uygun değil, çağrı yapılmamalı | 102/150 | 68.00% |
| ahm_multi_turn — üç aşamalı araç zinciri | 101/150 | 67.33% |
Diğer dört sağlayıcıyla karşılaştırma
Resmî kanala göre fark, yüzde puan cinsinden; %95 aralık bıyıklarla gösterilmiştir. 0'ı kesen aralıklar ayırt edilemez olarak kaydedilir. HLE ve AA-LCR değerlendiricisi deepseek-flash, test edilen modelle aynı DeepSeek ailesindendir ve kalibre edilmemiştir; bu nedenle değerlendirmeleri toleranslı olabilir.
F — işlev desteği: 74.98
İşlev paketi, modelin iyi yanıt verip vermediğine değil, arayüz davranışının protokole uyup uymadığına bakar. Altı gruptaki 60 vaka, her pencerede bir kez olmak üzere üç kez çalıştırıldı: toplam 180 kontrol; her sağlayıcının belgelediği biçime göre değerlendirildi. Uygulanamayan, geçersiz veya gözlemlenemeyen kontroller paydaya alınmaz. ByteDance, sayılan 174 kontrolün 124'ünü geçti ve grup ağırlıklarına göre 74.98 puan aldı.
Ağırlıklı puan grup ağırlıklarını uygular; geçen kontrol sayısının 174'e bölünmesi değildir.
| Grup | Ağırlık | Geçti | Hariç tutulan | Grup puanı |
|---|---|---|---|---|
| Akış ve ileti protokolü | 20% | 23/27 | 3 | 85.19 |
| Araç arayüzü | 20% | 30/30 | — | 100.00 |
| Çıktı kısıtları ve parametreler | 20% | 24/30 | — | 80.00 |
| Bağlam ve durum | 15% | 14/30 | — | 46.67 |
| Hata ve kurtarma | 15% | 21/30 | — | 70.00 |
| Ölçüm ve önbellek protokolü | 10% | 12/27 | 3 | 44.44 |
| Toplam · ağırlıklı puan | — | 124/174 | 6 | 74.98 |
“Başarısız pencereler”, 3 pencereden kaçında kontrolün başarısız olduğunu gösterir.
| Başarısız vaka | Başarısız pencereler | Neden |
|---|---|---|
| Akıl yürütme içeriğe sızmıyor — akış ve ileti protokolü | 3/3 | reasoning_effort=none ayarına rağmen düşünme içeriği döndürüldü |
| Düşünme yapılandırması etkili oluyor — çıktı kısıtları ve parametreler | 3/3 | reasoning_effort=none ayarına rağmen düşünme içeriği döndürüldü |
| Örnekleme çeşitliliği — çıktı kısıtları ve parametreler | 3/3 | temperature 0 ve 1'deki çıktılar yeterince farklı değildi; önceden belirlenmiş eşiğin altında kaldı |
| 10k uzun girdi — bağlam ve durum | 3/3 | 10,026 girdi tokenı raporlandı; yerel sayım 10,000 olmalıydı |
| Bağlam sınırı içinde — bağlam ve durum | 3/3 | 10,026 girdi tokenı raporlandı; yerel sayım 10,000 olmalıydı |
| 32k uzun girdi — bağlam ve durum | 3/3 | 10,026 girdi tokenı raporlandı; yerel sayım 10,000 olmalıydı |
| 100k uzun girdi — bağlam ve durum | 3/3 | 10,026 girdi tokenı raporlandı; yerel sayım 10,000 olmalıydı |
| Bağlam sınırı aşıldı — bağlam ve durum | 3/3 | Yukarı akış bağlantı hatası veya zaman aşımı (1); parametre hatası dönmeliydi, 200 döndü (2) |
| 12 turluk geçmiş — bağlam ve durum | 1/3 | Yukarı akış bağlantı hatası veya zaman aşımı |
| messages biçim hatası — hata ve kurtarma | 3/3 | Gövdesi boş bir 400 döndürüldü; yapılandırılmış hata açıklaması yoktu |
| Bağlantısız araç sonucu — hata ve kurtarma | 3/3 | Parametre hatası dönmeliydi, 200 döndü |
| stream_options biçim hatası — hata ve kurtarma | 3/3 | Gövdesi boş bir 400 döndürüldü; yapılandırılmış hata açıklaması yoktu |
| Düşünme tokenı ölçümü — ölçüm ve önbellek protokolü | 3/3 | Düşünme kapatıldıktan sonra düşünme tokenları raporlandı |
| Yerel girdi sayımı — ölçüm ve önbellek protokolü | 3/3 | 34 token raporlandı; yerel sayım 8 olmalıydı |
| Araç tanımları girdiye dahil ediliyor — ölçüm ve önbellek protokolü | 3/3 | Araçsız kontrol isteği bile yerel girdi sayımıyla uyuşmadı |
| Önbellek öncesi ve sonrası tutarlı girdi sayımı — ölçüm ve önbellek protokolü | 3/3 | Aynı önek tekrarlandığında raporlanan girdi tokenları yerel sayımla eşleşmedi |
| Akışlı ve akışsız girdi tutarlı — ölçüm ve önbellek protokolü | 3/3 | Her ikisi de 34 token raporladı; yerel sayım 8 olmalıydı |
| Tam metin çıktısı — akış ve ileti protokolü | 1/3 | Gövdenin sonunda fazladan bir nokta vardı; istenen metin birebir verilmedi |
Bu kontroller paydadan çıkarılır; ne geçer ne de başarısız sayılır.
| Durum | Vaka | Sayı | Neden |
|---|---|---|---|
| Gözlemlenemedi | Akış durdurma dizileri | 3 | Önceki adımdan sonra bu istek gönderilmedi; değerlendirilemiyor |
| Uygulanamaz | Açık cache_control | 3 | Bu arayüz tarafından desteklenmediği önceden kaydedilmişti |
messages biçim hatası ve stream_options biçim hatası vakaları beş sağlayıcının tümünde başarısız oldu: ikisi de gövdesi boş bir 400 döndürdü; bu nedenle istemciler yapılandırılmış bir hata açıklaması alamıyor. Beşinin tamamında görülen bu hata büyük olasılıkla AIHubMix ağ geçidi katmanındadır ve ayrıca incelenmesi gerekir. Düşünme tokenı ölçümü de beşinin tamamında başarısız oldu, ancak nedenler farklıydı: ByteDance ve Fireworks, düşünme kapatıldıktan sonra düşünme tokenları bildirdi; diğer üçü düşünme tokenı sayısı döndürmedi.
Diğer dört sağlayıcıyla karşılaştırma
P — yanıt hızı: 84.37
Her istek yaklaşık 10,000 girdi tokenı içeriyor ve gövde metninde yaklaşık 1,100 çıktı tokenı istiyordu. Üç pencerenin her birinde tek eşzamanlılıkta 30, 10 eşzamanlılıkta 30 istek çalıştırıldı: toplam 180 istek.
| Metrik | Sonuç |
|---|---|
| İlk gövde tokenını bekleme süresi (TTFA) | Tek eşzamanlılıkta medyan 2.12 s; 10 eşzamanlılıkta medyan 2.10 s |
| Üretim hızı (TPOT) | Tek eşzamanlılıkta 3.43 ms/token; 10 eşzamanlılıkta 3.41 ms/token |
| Etkin iş hacmi | 10 eşzamanlılıkta 1,250.0 token/s |
| Geçerli istekler | Tek eşzamanlılıkta 90/90; 10 eşzamanlılıkta 90/90 |
| Bileşen puanları | TTFA 48.59, TPOT 100.00, iş hacmi 100.00; TTFA ve TPOT için iki kademeden düşük olanı alınır; ağırlıklar %35 / %35 / %30; yanıt puanı 82.00 |
| P puanı | Yanıt puanı 82.00 (%80), önbellek K 93.83 (%20); toplam 84.37 |
TPOT, donanımda token başına ölçülmez; akışlı parçalar üzerinden tahmin edilir. İş hacmi, 10 eşzamanlılıkta üretilen geçerli çıktı tokenlarının parti toplam süresine bölünmesiyle hesaplanır.
Diğer dört sağlayıcıyla karşılaştırma
Beş sağlayıcı aynı makineyi, ağı ve hesabı paylaştı. Üç pencere sağlayıcı bazında sırayla planlandı; bu nedenle veri toplama dönemleri tamamen örtüşmüyor. Küçük farklara gereğinden fazla anlam yüklemeyin.
K — önbellek: 93.83
Her grup beş istek gönderir. İlk istek, önbelleği doldurmak için yaklaşık 8k veya 32k tokenlık sabit bir önek taşır. 2–4. isteklerde önek korunur ve yalnızca son soru 5 s, 30 s ve 120 s aralıklarla değiştirilir. Beşinci istekte, soğuk kontrol amacıyla yeni bir önek kullanılır. Üç pencere ve iki uzunlukta, grup başına beş istek olmak üzere toplam 30 istek gönderilir. K, sıcak isteklerde okunan önbellek tokenlarının kurallara göre yeniden kullanılabilir olması gereken tokenlara oranıdır; iki uzunluğa eşit ağırlık verilir. K, P'nin %20'sidir.
| Önek | Pencere | Başlangıç | +5 s | +30 s | +120 s | Soğuk kontrol |
|---|---|---|---|---|---|---|
| 8k | 1. pencere | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 2. pencere | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Pencere 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Pencere 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Pencere 2 | 0 | 32,000 | 32,000 | başarısız | 0 |
| 32k | Pencere 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Değerler, sunucunun bildirdiği önbellekten okunan token sayılarıdır.
Dokuz 8k sıcak isteğin tümü isabet etti ve her biri 7,936 token okudu. Dokuz 32k sıcak isteğin sekizi isabet etti ve her biri 32,000 token okudu; bir istek başarısız oldu. İki uzunluğa eşit ağırlık verildiğinde K 93.83’tür. Soğuk istekler önbellekten veri okumadığından, sıcak ve soğuk istekler net biçimde ayrılır. Başarısız istek, 32k grubunun pencere 2’deki dördüncü isteğidir; istek tamamlanamadan 300 s’lik süre sınırına ulaştı.
Diğer dört sağlayıcıyla karşılaştırma
R — hizmet kararlılığı: 100
300 istek dört türe ayrılır — kısa metin, uzun girdi, araç çağrıları ve çok turlu geçmiş — ve üç pencerede tek eşzamanlılıkla çalıştırıldı. Bir istek, yalnızca ilk denemede geçerli ve eksiksiz bir yanıt döndürürse başarılı sayılır; yanıt doğruluğu denetlenmez ve yeniden deneme yapılmaz. Yanıt kalitesi ve hız bölümlerindeki başarısızlıklar R’de tekrar sayılmaz; bunlar Q ve P’ye dahil edilir.
| İstek türü | İlk denemede başarı |
|---|---|
| Kısa metin | 120/120 |
| 10k uzun girdi | 90/90 |
| Araç çağrıları | 60/60 |
| Çok turlu geçmiş | 30/30 |
| Toplam · %95 güven aralığı 98.78%–100% | 300/300 |
300 isteğin tümü ilk denemede geçerli ve eksiksiz bir yanıt döndürdü. R = 100 yalnızca bu 300 özel isteği ifade eder; tüm zincirde hiç başarısızlık yaşanmadığı anlamına gelmez. %95 güven aralığının alt sınırı 98.78%’dir: 300 başarılı istek, başarısızlık oranının muhtemelen %1.22’nin altında olduğunu söyleyebilir.
Diğer dört sağlayıcıyla karşılaştırma
R yalnızca bu 300 özel isteği kapsar; yanıt kalitesi ve hız bölümlerindeki başarısızlıklar Q ve P’ye kaydedilir ve R’de tekrar sayılmaz.
| Sağlayıcı | İlk denemede başarı | %95 güven aralığı |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek resmî | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
SSS
reasoning_effort=none düşünmeyi gerçekten kapatmadı mı?
Evet. Üç pencerenin tamamında reasoning_effort=none kullanılan istekler yine de düşünme içeriği döndürdü; dolayısıyla kontrol 3/3 başarısız oldu. Yanıt kalitesi, hız, önbellek ve kararlılık isteklerinde bunun yerine yerel thinking.type=disabled anahtarı kullanıldı. İşlev test paketi, parametrenin etkili olup olmadığını sınamak amacıyla reasoning_effort=none değerini özellikle kullandı.
BFCL doğruluğu %85.20. Q neden 42.05?
Q, zorluk düzeyleri oldukça farklı üç test paketinin sonuçlarını bir araya getirir. BFCL’de 1,500 sorudan 1,278’i, HLE’de 2,490 sorudan 382’si, AA-LCR’de ise 250 sorudan 123’ü doğru yanıtlandı. Puanlanan toplam 4,240 soru örneğinin 1,783’ü doğruydu: 42.05%. HLE’nin %15.34’lük sonucu, birleştirilmiş değeri aşağı çekiyor.
Q’daki 35 hizmet hatası puana dahil mi?
Evet. İstek hataları ve kesilmiş çıktılar paydada kalır ve yanlış sayılır. Yedi HLE yanıtı max_tokens sınırında kesildi; 28 AA-LCR isteği başarısız oldu ve bunların tümü pencere 1’deydi.
Girdi token sayımının önemi nedir?
Çünkü faturalandırma, modelin yerel sayımıyla eşleşmelidir. 10k tokenlık bir girdi 10,026 token olarak bildirildi (yerel sayı 10,000); 8 tokenlık bir girdi ise 34 olarak bildirildi. Araç kullanılmayan kontrol isteğinde de zaten uyuşmazlık vardı; hem akış hem de akış dışı kullanımda 34 bildirildi. Beş faturalandırma kontrolünün tümü 3/3 başarısız oldu.
32k önbellek sonucu isabet etmeme mi, yoksa başarısızlık mıydı?
Başarısızlıktı. Dokuz 32k sıcak isteğin sekizi isabet etti ve 32,000 token okudu. İsabet etmeyen tek istek, pencere 2’deki dördüncü istektir; tamamlanamadan 300 s’lik süre sınırına ulaştı. 8k grubu 7,936 token okuyarak 9/9 isabet etti.
ByteDance’in yanıt kalitesi resmî kanaldan ayırt edilebilir mi?
Hayır. Birleşik doğruluk resmî kanaldan 0.40 puan daha düşük; %95 güven aralığı −1.46 ile +0.66 arasındadır. Aralık 0’ı içerdiğinden ikisi birbirinden ayırt edilemez. Bu yalnızca bu veri grubunu tanımlar ve bir sıralama değildir.
Okumaya devam edin: DeepSeek V4.1 Flash serisi
- Bu yazıdaki Q referans değeri resmî kanaldır; tek eşzamanlılıkta yapılan 15 geçersiz yoklama da dahil olmak üzere kanalın kendi çalıştırmasının ayrıntıları Resmî kanalda DeepSeek V4.1 Flash: 94.00 F, 15 geçersiz yoklama başlıklı yazıda yer alıyor.
- Q güven aralığı resmî kanalın altında kalan tek sağlayıcı Baidu’dur; bu sonucun ardındaki kanal hataları Baidu’da DeepSeek V4.1 Flash: kullanılabilir kanal yok, Q ve P’de başarısız başlıklı yazıda ele alınıyor.
- Alibaba Cloud’un önbellek değerleri, burada bildirilen 93.83 değerinin yanına eklenebilir: Alibaba Cloud’da DeepSeek V4.1 Flash: ilk token 1.34s, önbellek %99.37.
- Fireworks’te burada görülen düşünme ve token sayımı hatalarına ek olarak boş stop yanıtları da görülüyor: Fireworks’te DeepSeek V4.1 Flash: boş stop yanıtları, 3/9 önbellek isabeti.


