
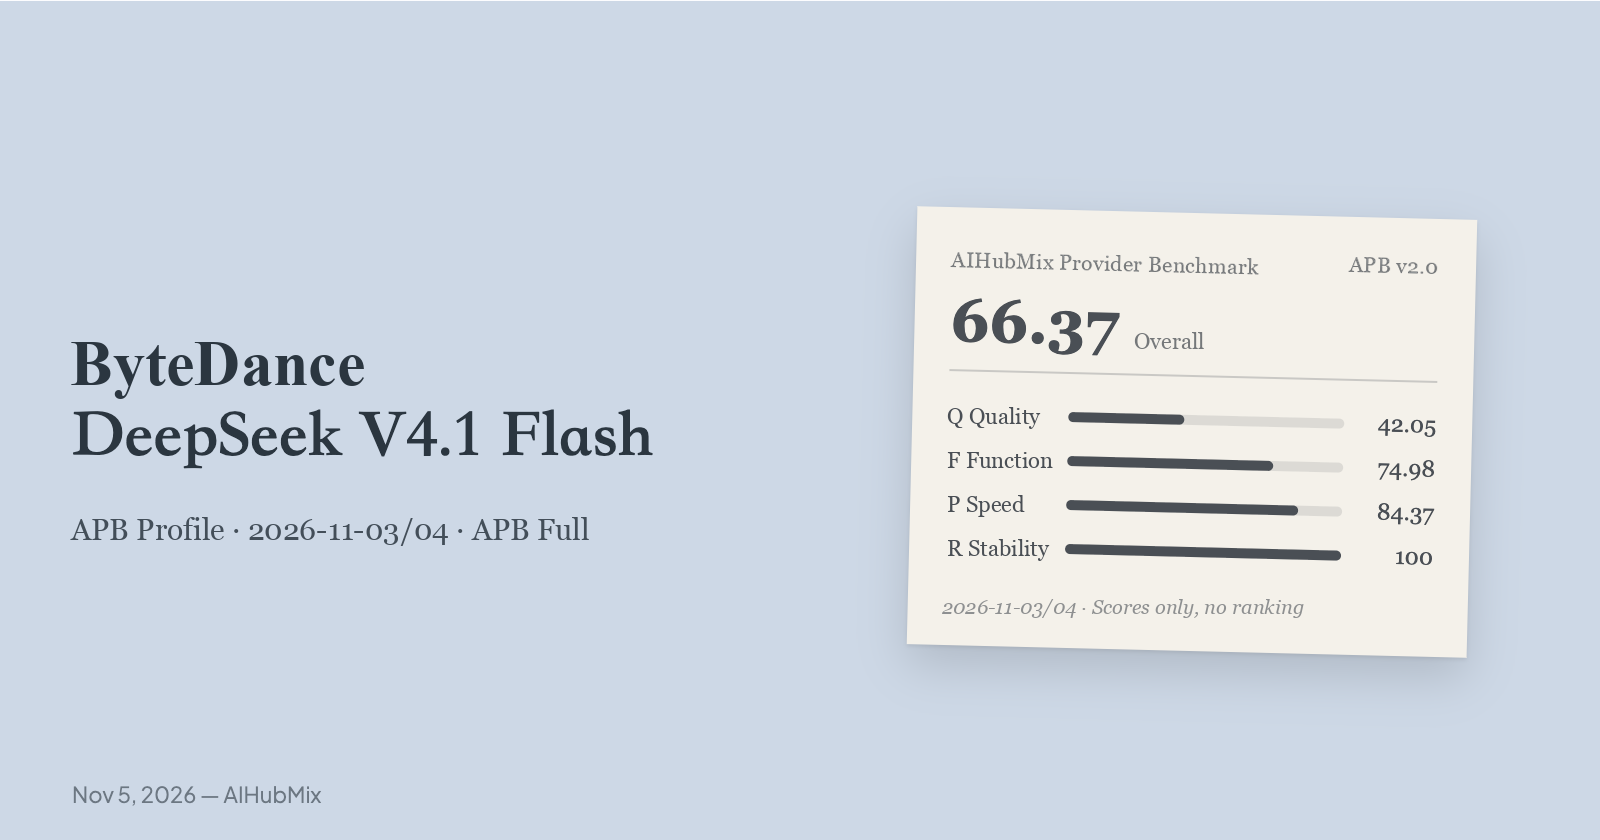
3–4 ноября 2026 года DeepSeek V4.1 Flash 1017 тестировали у пяти провайдеров через AIHubMix с полным набором APB: каждый раз использовались одни и те же вопросы, параметры и сценарии запросов. Этот профиль APB посвящён только запуску на ByteDance и рассматривает его по разделам.
Приведённые ниже числа — это оценки, а не рейтинг и не рекомендация провайдера. Сначала идут Q, F, P, K и R; общий балл — сводный индекс, а не сертификация, и для него не рассчитывается доверительный интервал. Правила оценки определены в стандарте AIHubMix Provider Benchmark Standard v2.0.
Оценки пяти провайдеров
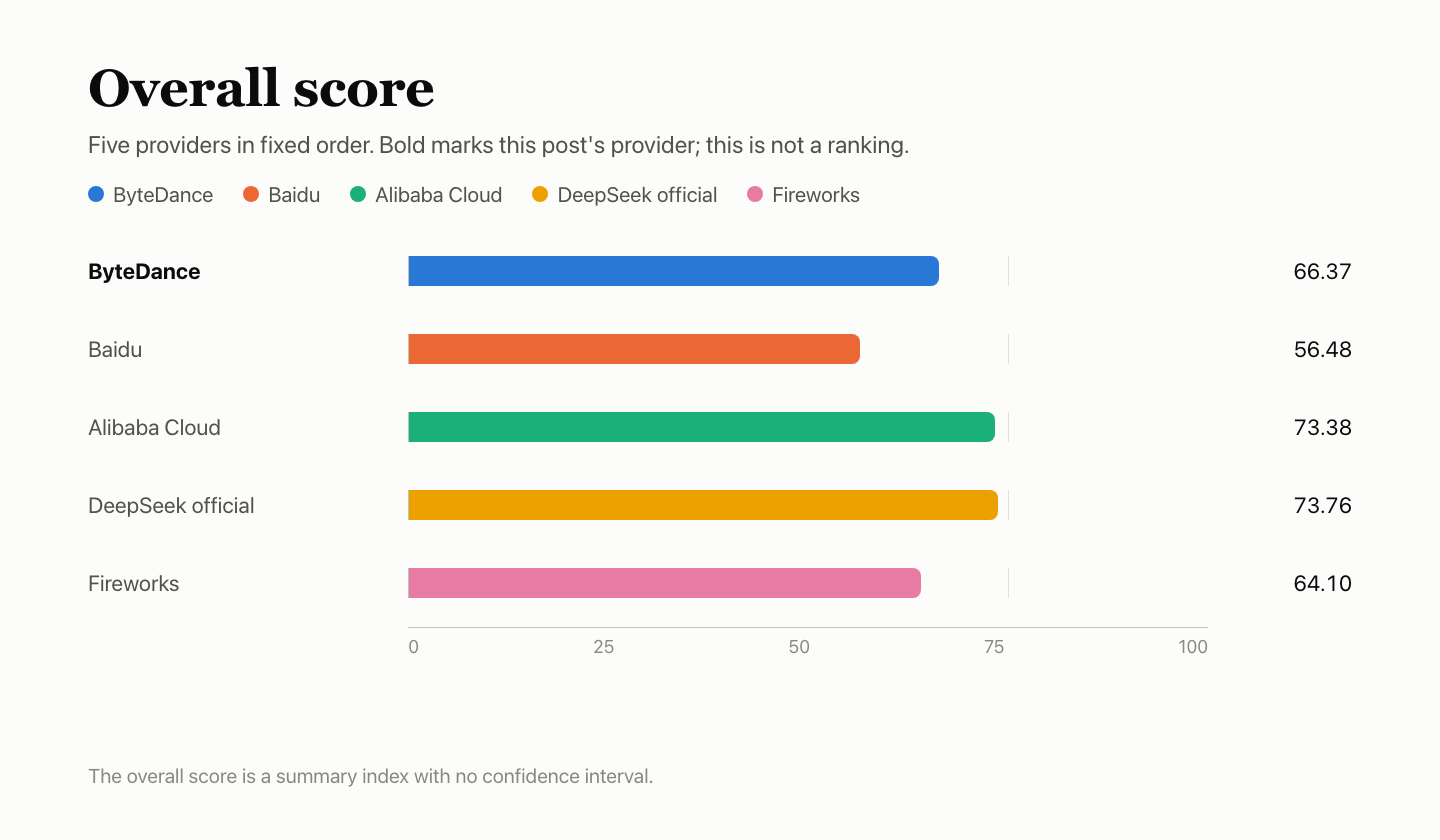
В этой статье полужирным выделен рассматриваемый провайдер. Провайдеры перечислены в фиксированном порядке, это не рейтинг. K — субоценка P, на неё приходится 20% этого показателя. Общий балл — сводный индекс без доверительного интервала. Разница между официальным каналом DeepSeek и Alibaba Cloud составляет 0.37, и их результаты нельзя различить.
Краткий обзор
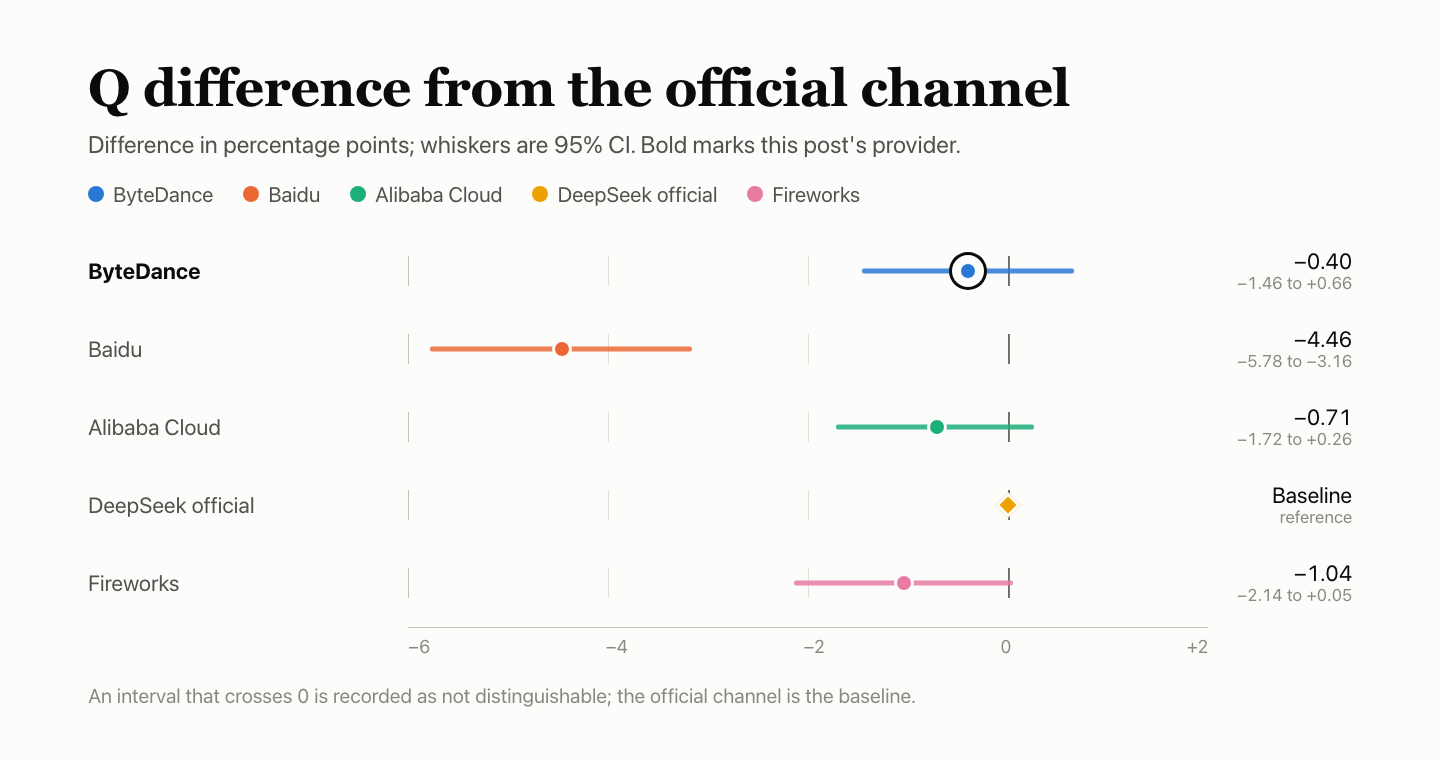
- Q 42.05. BFCL — 85.20%, HLE — 15.34%, AA-LCR — 49.20%. Отставание от официального канала составляет −0.40 процентного пункта; 95%-й интервал — от −1.46 до +0.66: результаты нельзя различить. В AA-LCR было 28 ошибок запросов, все в окне 1; они засчитаны как неправильные ответы.
- F 74.98. Из 174 учтённых проверок пройдены 124.
reasoning_effort=noneне отключает thinking mode. Для входных данных объёмом 10k было указано 10,026 токенов (нативный подсчёт — 10,000); для входных данных объёмом 8 токенов было указано 34. - P 84.37. До первого токена тела ответа: медиана 2.12 с при параллелизме 1 и 2.10 с при параллелизме 10; TPOT — 3.43 мс/токен; все 180 запросов на скорость были валидными.
- K 93.83. Для горячих запросов с префиксом 8k попадание в кэш зарегистрировано в 9 случаях из 9; для 32k — в 8 случаях, а один запрос не завершился за отведённые 300 с.
- R 100. Все 300 специальных запросов выполнились с первой попытки.
Настройки тестирования
| Параметр | Значение |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запрошенный ID модели | doubao-deepseek-v4.1-flash-1017 |
| Возвращённое имя модели | deepseek-v4-1-flash-261017 |
| Маршрут доступа | Через AIHubMix с ID модели для конкретного провайдера, не напрямую через учётную запись провайдера |
| Параметры | Режим без thinking mode, temperature 1.0, max_tokens 16,384, тайм-аут 300 с, автоматические повторные попытки отключены |
| Отключение thinking mode | В запросах на оценку качества ответов, скорости, кэша и стабильности использовался нативный параметр thinking.type=disabled (у этого провайдера reasoning_effort=none не отключал thinking mode); в функциональных тестах оставили reasoning_effort=none, чтобы проверить, действует ли этот параметр |
| Время | 2026-11-03 18:07 – 11-04 16:33 UTC+8; пять провайдеров использовали один Mac mini, одну сеть и одну учётную запись |
| Выборка | Качество ответов: 4,250 экземпляров вопросов (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); функциональные тесты: 60 случаев × 3 окна; скорость: 90 запросов при параллелизме 1 и 90 при параллелизме 10; стабильность: 300; кэш: 30 (по три группы с префиксами 8k и 32k) |
В запросах использовался маршрут AIHubMix быстрого старта с ID модели для конкретного провайдера; параметры соответствуют документации API DeepSeek. ID моделей других провайдеров перечислены на странице моделей.
Q — качество ответов: 42.05
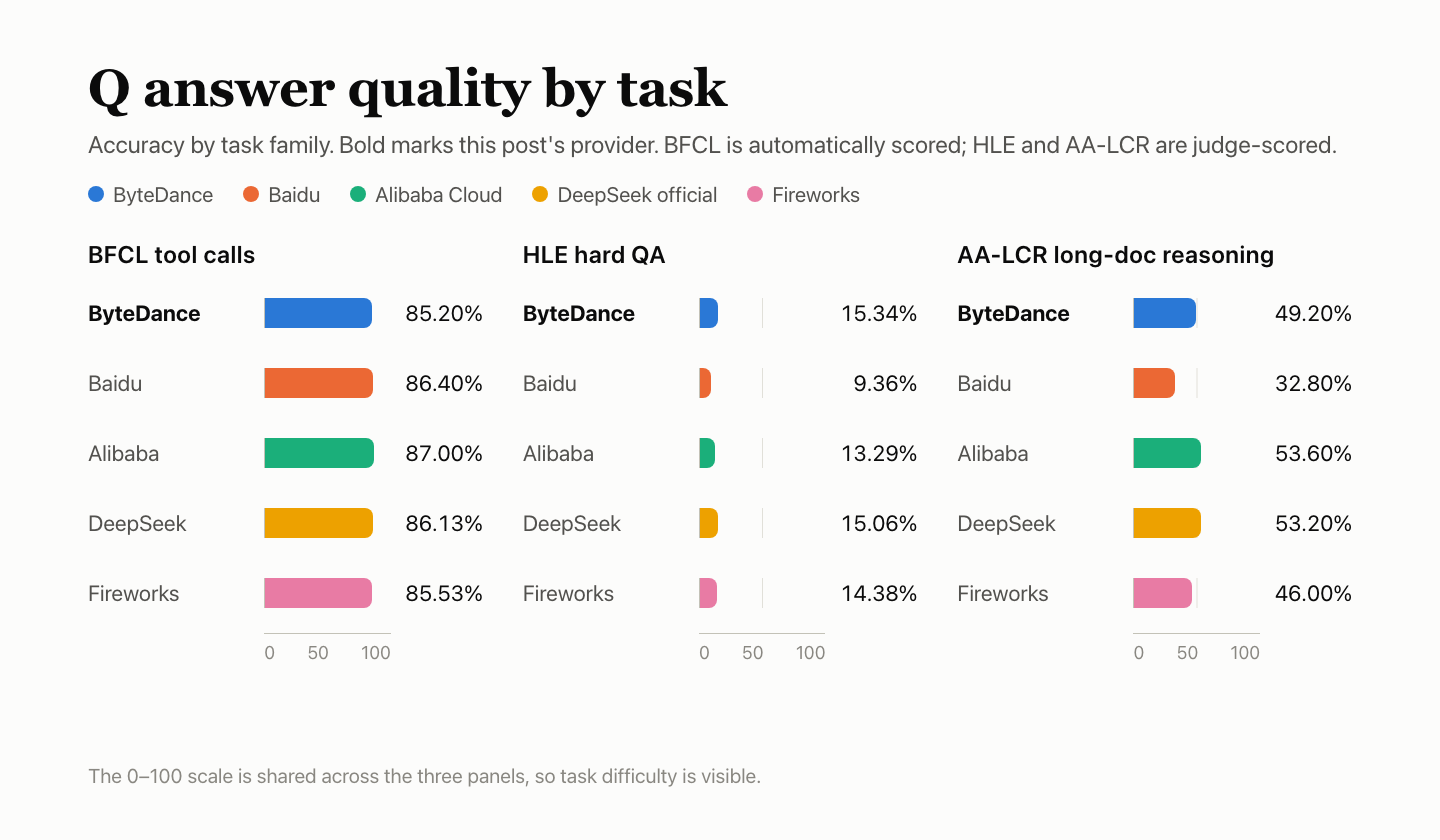
Для оценки качества ответов использовались три набора: 500 вопросов BFCL по 3 раунда на каждый, 250 вопросов HLE по 10 раундов на каждый и 25 вопросов AA-LCR по 10 раундов на каждый. В BFCL применялись автоматические правила оценки; ответы HLE и AA-LCR оценивала модель deepseek-flash. Все пять провайдеров получали одинаковые вопросы, а результаты трёх наборов объединялись в общую точность. Десять ответов исключили, поскольку оценить соответствующие вопросы было невозможно; в итоге осталось 4,240 оцениваемых экземпляров вопросов.
| Набор | Вопросы | Правильные ответы | Точность | Ошибки |
|---|---|---|---|---|
| Вызовы инструментов BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Сложные вопросы и ответы HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Рассуждения по длинным документам AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Вместе · 95%-й интервал 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Ошибки сервиса — сбои запросов или обрезанный вывод — остаются в знаменателе и считаются неправильными ответами. В HLE вывод 7 раз достигал предела max_tokens; в AA-LCR было 28 ошибок запросов, все в окне 1. В BFCL оценка автоматическая, а в HLE и AA-LCR — с помощью модели-судьи.
На каждый вопрос BFCL отвечали 3 раза; в таблице суммированы результаты всех 3 раундов.
| Категория BFCL | Пройдены | Доля успешных проверок |
|---|---|---|
| simple_python — одна функция, корректный вызов и аргументы | 329/360 | 91.39% |
| multiple — выбрать одну из нескольких функций | 268/300 | 89.33% |
| parallel — несколько раз вызвать одну и ту же функцию | 271/300 | 90.33% |
| parallel_multiple — вызвать несколько разных функций | 207/240 | 86.25% |
| irrelevance — ни одна функция не подходит, вызывать её не следует | 102/150 | 68.00% |
| ahm_multi_turn — трёхэтапная цепочка вызовов инструментов | 101/150 | 67.33% |
Сравнение с остальными четырьмя
Разница с официальным каналом в процентных пунктах; 95%-й интервал показан усами. Если интервал пересекает 0, результаты считаются неразличимыми. Для оценки HLE и AA-LCR использовалась модель deepseek-flash из того же семейства DeepSeek, что и тестируемая модель; калибровка не проводилась, поэтому её оценки могут быть снисходительными.
F — поддержка функций: 74.98
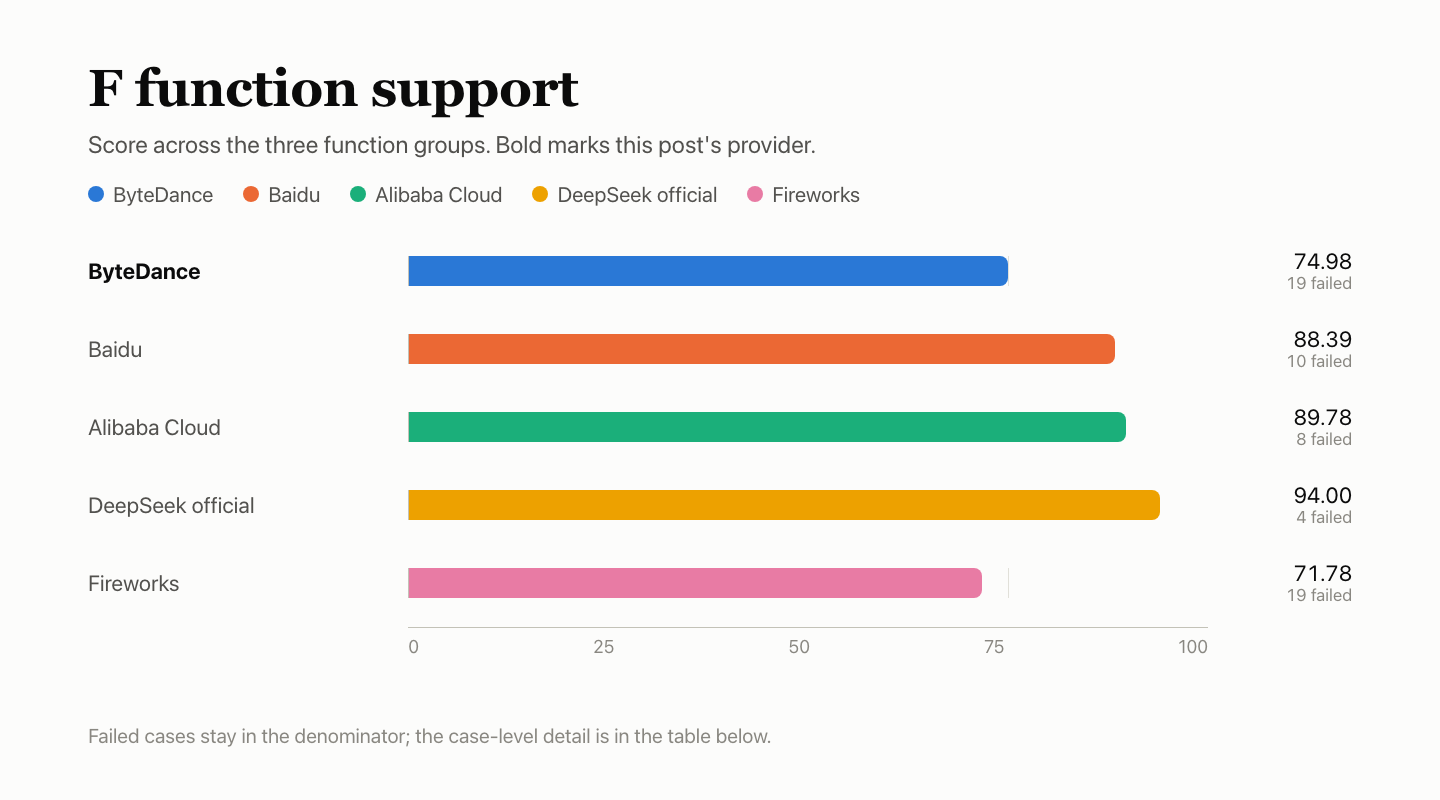
В функциональном наборе оценивается только соответствие поведения интерфейса протоколу, а не качество ответов модели. Шесть групп по 60 случаев проверялись трижды, по одному разу на каждое окно: всего 180 проверок, оценивавшихся по формату, задокументированному каждым провайдером. Неприменимые, некорректные или ненаблюдаемые проверки исключались из знаменателя. ByteDance прошёл 124 из 174 учтённых проверок и набрал 74.98 с учётом весов групп.
При расчёте взвешенной оценки учитываются веса групп; это не отношение числа пройденных проверок к 174.
| Группа | Вес | Пройдены | Исключены | Оценка группы |
|---|---|---|---|---|
| Потоковая передача и протокол сообщений | 20% | 23/27 | 3 | 85.19 |
| Интерфейс инструментов | 20% | 30/30 | — | 100.00 |
| Ограничения вывода и параметры | 20% | 24/30 | — | 80.00 |
| Контекст и состояние | 15% | 14/30 | — | 46.67 |
| Ошибки и восстановление | 15% | 21/30 | — | 70.00 |
| Учёт токенов и протокол кэширования | 10% | 12/27 | 3 | 44.44 |
| Всего · взвешенная оценка | — | 124/174 | 6 | 74.98 |
«Сбой в окнах» — число из 3 окон, в которых проверка не пройдена.
| Не пройденный случай | Сбоев в окнах | Причина |
|---|---|---|
| Рассуждения не попадают в содержимое — потоковая передача и протокол сообщений | 3/3 | При reasoning_effort=none содержимое thinking mode всё равно возвращалось |
| Настройка thinking mode применяется — ограничения вывода и параметры | 3/3 | При reasoning_effort=none содержимое thinking mode всё равно возвращалось |
| Разнообразие сэмплирования — ограничения вывода и параметры | 3/3 | Ответы при temperature 0 и 1 различались недостаточно — ниже порога, заданного до начала теста |
| Длинный ввод 10k — контекст и состояние | 3/3 | Указано 10,026 входных токенов; нативный подсчёт должен быть 10,000 |
| В пределах ограничения контекстного окна — контекст и состояние | 3/3 | Указано 10,026 входных токенов; нативный подсчёт должен быть 10,000 |
| Длинный ввод 32k — контекст и состояние | 3/3 | Указано 10,026 входных токенов; нативный подсчёт должен быть 10,000 |
| Длинный ввод 100k — контекст и состояние | 3/3 | Указано 10,026 входных токенов; нативный подсчёт должен быть 10,000 |
| Превышение ограничения контекстного окна — контекст и состояние | 3/3 | Сбой подключения к вышестоящему сервису или тайм-аут (1); следовало вернуть ошибку параметра, но возвращён код 200 (2) |
| История из 12 ходов — контекст и состояние | 1/3 | Сбой подключения к вышестоящему сервису или тайм-аут |
| Ошибка формата messages — ошибки и восстановление | 3/3 | Возвращён код 400 с пустым телом ответа; структурированного описания ошибки нет |
| Результат вызова инструмента без соответствующего вызова — ошибки и восстановление | 3/3 | Следовало вернуть ошибку параметра, но возвращён код 200 |
| Ошибка формата stream_options — ошибки и восстановление | 3/3 | Возвращён код 400 с пустым телом ответа; структурированного описания ошибки нет |
| Учёт токенов reasoning — учёт токенов и протокол кэширования | 3/3 | Количество токенов thinking mode указано после его отключения |
| Нативный подсчёт входных токенов — учёт токенов и протокол кэширования | 3/3 | Указано 34 токена; нативный подсчёт должен быть 8 |
| Определения инструментов учитываются во входных данных — учёт токенов и протокол кэширования | 3/3 | Контрольный запрос без инструментов уже не совпадал с нативным подсчётом входных токенов |
| Подсчёт входных токенов согласован до и после кэширования — учёт токенов и протокол кэширования | 3/3 | При повторной отправке того же префикса указанное количество входных токенов не совпадало с нативным подсчётом |
| Подсчёт входных токенов согласован для потокового и непотокового режимов — учёт токенов и протокол кэширования | 3/3 | В обоих случаях указано 34 токена; нативный подсчёт должен быть 8 |
| Точное текстовое содержимое — потоковая передача и протокол сообщений | 1/3 | В конце тела ответа добавлена лишняя точка; это не точный запрошенный текст |
Эти проверки исключаются из знаменателя и не считаются ни пройденными, ни не пройденными.
| Статус | Случай | Количество | Причина |
|---|---|---|---|
| Не наблюдалось | Стоп-последовательности в потоковой передаче | 3 | После предыдущего шага этот запрос не отправлялся; оценить его нельзя |
| Неприменимо | Явный cache_control | 3 | Заранее зарегистрирован как неподдерживаемый этим интерфейсом |
Случаи с ошибками формата messages и stream_options не прошли на всех пяти провайдерах: в обоих случаях возвращался код 400 с пустым телом ответа, поэтому клиенты не получают структурированного описания ошибки. Сбой у всех пяти провайдеров, вероятнее всего, возникает на уровне шлюза AIHubMix и требует отдельного расследования. Учёт токенов thinking mode также не прошёл на всех пяти, но по разным причинам: ByteDance и Fireworks указывали токены thinking mode после его отключения, а остальные три провайдера не возвращали количество токенов thinking mode.
Сравнение с остальными четырьмя
P — скорость ответа: 84.37
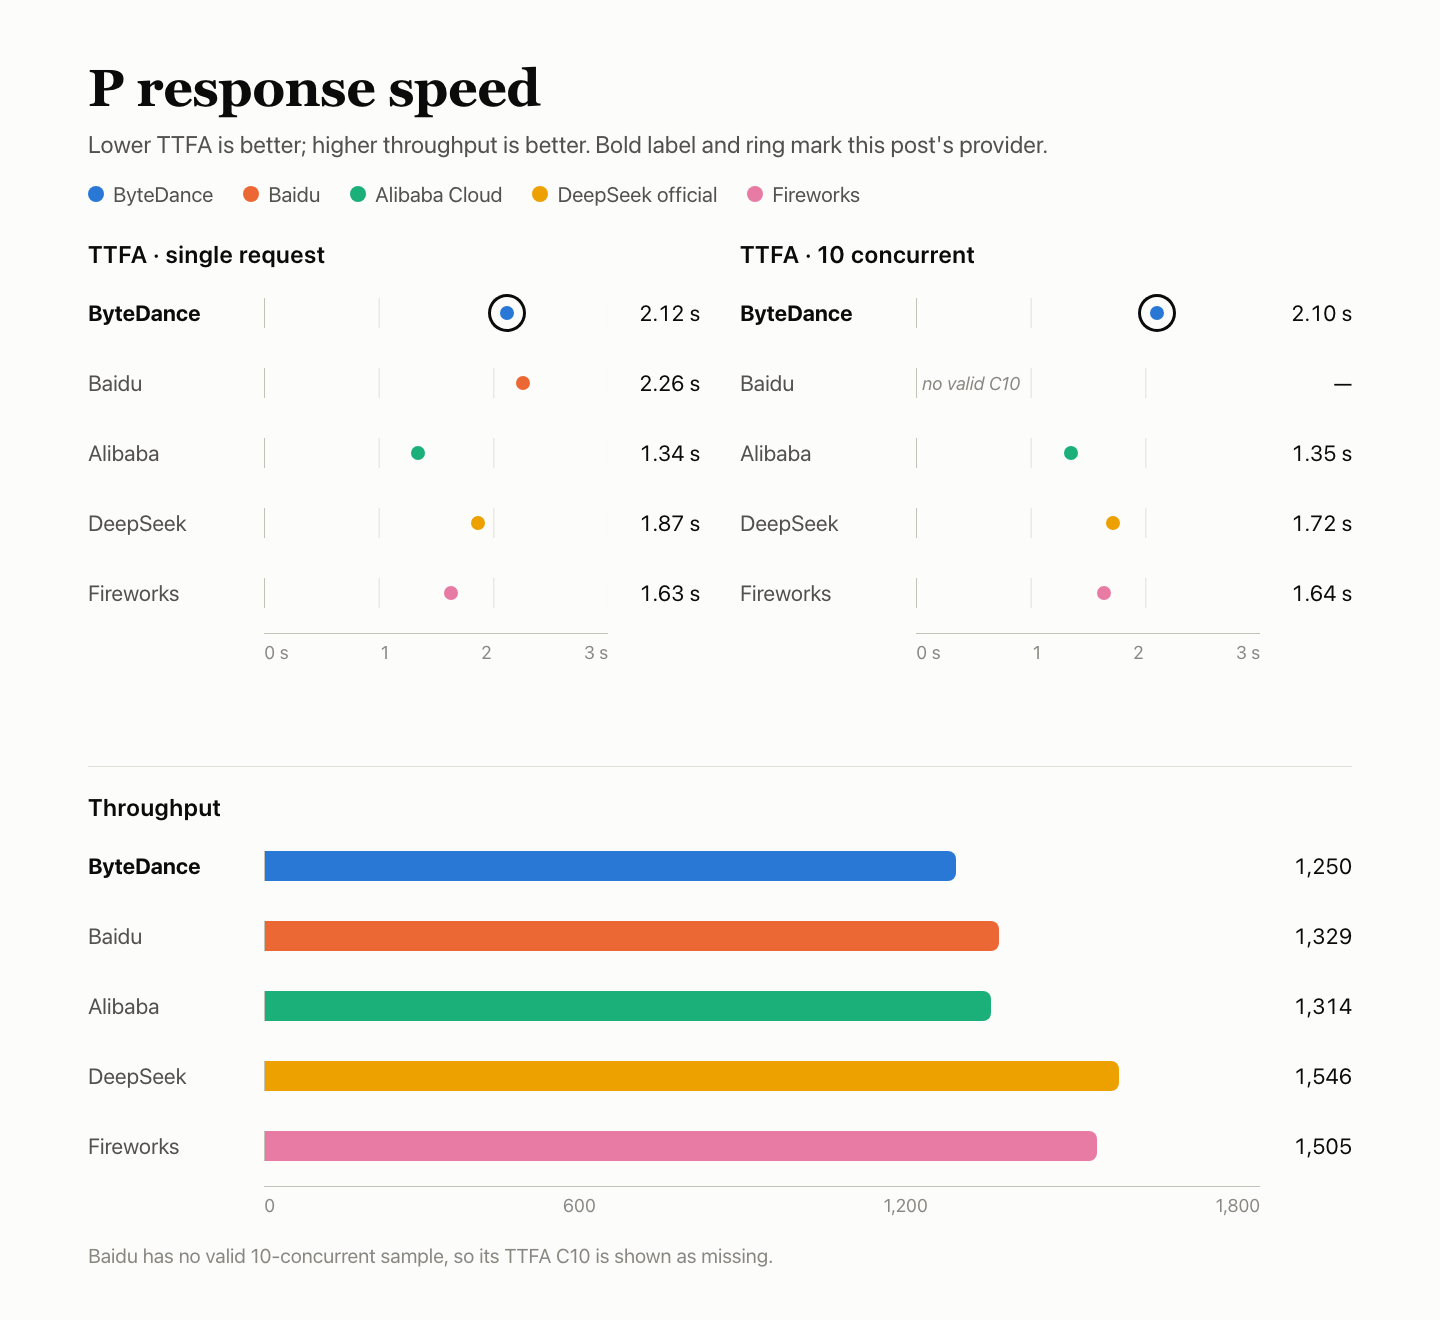
Каждый запрос содержал около 10,000 входных токенов и запрашивал около 1,100 выходных токенов текста в теле ответа. В каждом из трёх окон выполнялось по 30 запросов при параллелизме 1 и по 30 при параллелизме 10: всего 180 запросов.
| Показатель | Результат |
|---|---|
| Ожидание первого токена тела ответа (TTFA) | Медиана 2.12 с при параллелизме 1; медиана 2.10 с при параллелизме 10 |
| Скорость генерации (TPOT) | 3.43 мс/токен при параллелизме 1; 3.41 мс/токен при параллелизме 10 |
| Эффективная пропускная способность | 1,250.0 токен/с при параллелизме 10 |
| Валидные запросы | 90/90 при параллелизме 1; 90/90 при параллелизме 10 |
| Оценки компонентов | TTFA 48.59, TPOT 100.00, пропускная способность 100.00; для TTFA и TPOT берётся меньшее значение из двух режимов; веса — 35% / 35% / 30%; оценка скорости ответа — 82.00 |
| Оценка P | Оценка скорости ответа 82.00 с весом 80%, кэш K 93.83 с весом 20%; итог — 84.37 |
TPOT рассчитывается по сегментам потоковой передачи, а не измеряется для каждого токена на оборудовании. Пропускная способность — это число валидных выходных токенов при параллелизме 10, делённое на общее время выполнения пакета.
Сравнение с остальными четырьмя
Все пять провайдеров использовали одну машину, одну сеть и одну учётную запись. Три окна запускались последовательно для каждого провайдера, поэтому периоды сбора данных совпадали не полностью; небольшие различия не стоит переоценивать.
K — кэш: 93.83
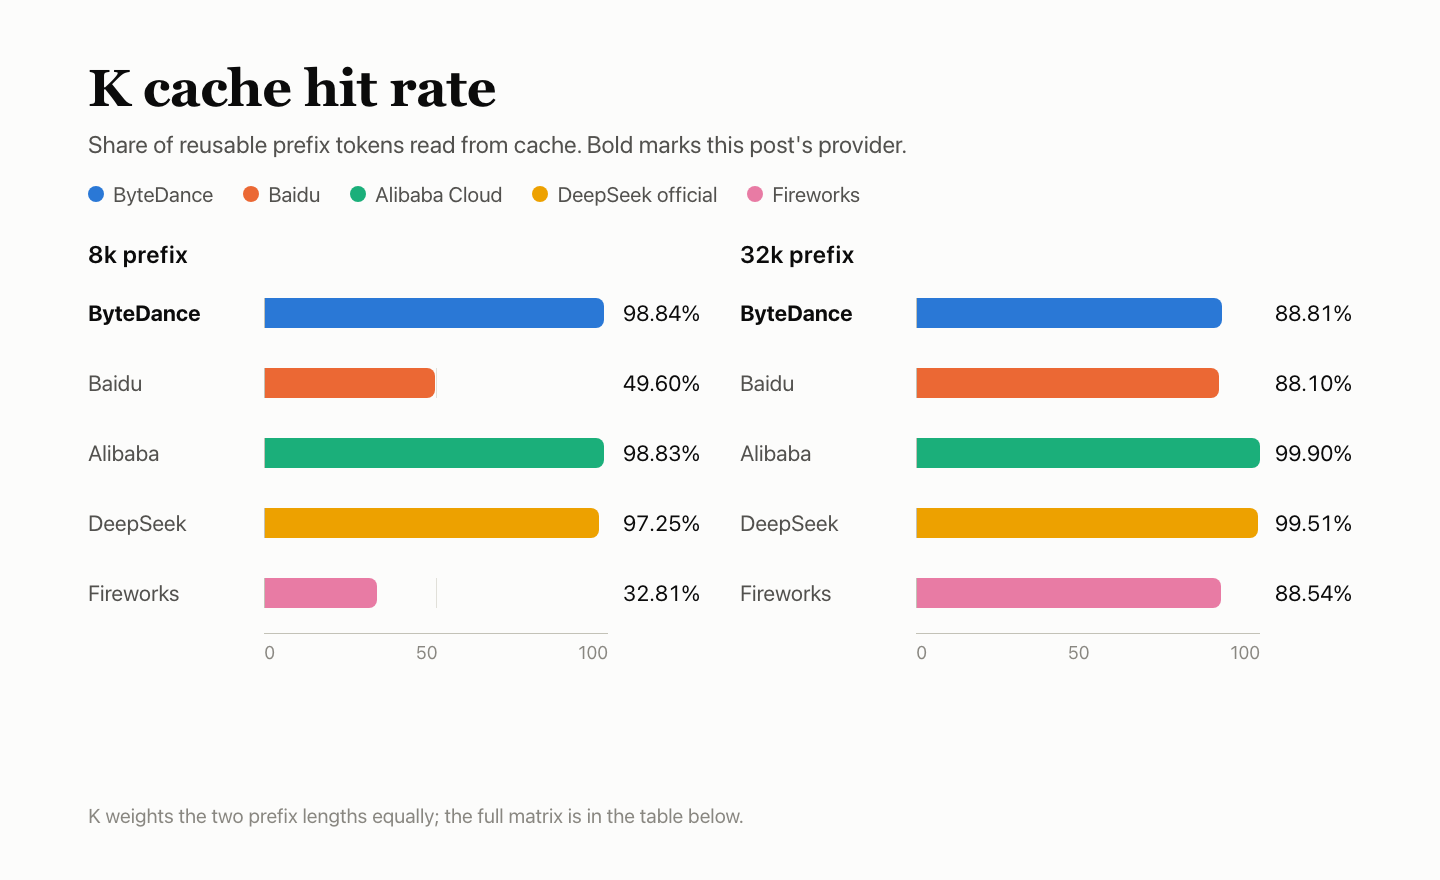
В каждой группе отправляется пять запросов. Первый содержит фиксированный префикс объёмом около 8k или 32k токенов и заполняет кэш. В запросах 2–4 префикс остаётся прежним, меняется только заключительный вопрос; их отправляют через 5, 30 и 120 с. Пятый запрос использует новый префикс и служит холодным контролем. Три окна, две длины и по пять запросов в группе — всего 30 запросов. K — это количество токенов, прочитанных из кэша для горячих запросов, делённое на количество токенов, которые должны повторно использоваться согласно правилам; обе длины имеют одинаковый вес. K составляет 20% показателя P.
| Префикс | Окно | Заполнение кэша | +5 s | +30 s | +120 s | Холодный контроль |
|---|---|---|---|---|---|---|
| 8k | Окно 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Окно 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Окно 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Окно 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Окно 2 | 0 | 32,000 | 32,000 | сбой | 0 |
| 32k | Окно 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Это значения токенов, прочитанных из кэша, по данным сервера.
Все девять горячих запросов на 8k попали в кэш, каждый прочитал 7,936 токенов. Восемь из девяти горячих запросов на 32k попали в кэш, каждый прочитал 32,000 токенов; один запрос завершился ошибкой. При равном весе для двух размеров K составляет 93.83. Холодные запросы не читали кэш, поэтому горячие и холодные запросы чётко разделяются. Неудачный запрос — четвёртый запрос группы 32k в окне 2: он достиг лимита в 300 s, так и не завершившись.
Сравнение с остальными четырьмя
R — стабильность сервиса: 100
300 запросов относятся к четырём типам — короткий текст, длинный ввод, вызовы инструментов и история диалога с несколькими ходами — и выполнялись с параллельностью 1 в трёх окнах. Запрос считается успешным, только если первая попытка вернула корректный полный ответ; правильность ответа не проверяется, повторных попыток нет. Сбои в разделах качества ответов и скорости учитываются в Q и P, а не повторно в R.
| Тип запроса | Успешность с первой попытки |
|---|---|
| Короткий текст | 120/120 |
| Длинный ввод на 10k | 90/90 |
| Вызовы инструментов | 60/60 |
| История диалога с несколькими ходами | 30/30 |
| Итого · 95%-й интервал 98.78%–100% | 300/300 |
Все 300 запросов вернули корректный полный ответ с первой попытки. R = 100 относится только к этим 300 специально выделенным запросам и не означает, что во всей цепочке не было сбоев. Нижняя граница 95%-го интервала — 98.78%: 300 успешных запросов позволяют лишь заключить, что вероятность сбоя, скорее всего, ниже 1.22%.
Сравнение с остальными четырьмя
Показатель R охватывает только эти 300 специально выделенных запросов; сбои в разделах качества ответов и скорости учитываются в Q и P и не учитываются повторно в R.
| Провайдер | Успешность с первой попытки | 95%-й интервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часто задаваемые вопросы
Правда ли, что reasoning_effort=none не отключил thinking mode?
Да. Во всех трёх окнах запросы с reasoning_effort=none по-прежнему возвращали содержимое thinking mode, поэтому проверка завершилась неудачей в 3 случаях из 3. В запросах для проверки качества ответов, скорости, кэша и стабильности вместо этого использовался встроенный переключатель thinking.type=disabled. Для набора тестов функций параметр reasoning_effort=none намеренно оставили, чтобы проверить, сработает ли он.
Точность BFCL составляет 85.20%. Почему Q равен 42.05?
В Q объединены результаты трёх наборов тестов очень разной сложности. В BFCL правильными были 1,278 ответов из 1,500, в HLE — 382 из 2,490, а в AA-LCR — 123 из 250. В сумме правильными оказались 1,783 из 4,240 оцениваемых вопросов: 42.05%. Показатель HLE в 15.34% снижает общий результат.
Включены ли в оценку 35 сбоев сервиса, учитываемых в Q?
Да. Сбои запросов и усечённый вывод остаются в знаменателе и считаются неправильными ответами. Семь ответов HLE были обрезаны на max_tokens; 28 запросов AA-LCR завершились ошибкой — все в окне 1.
Почему важен учёт входных токенов?
Потому что данные о тарификации должны совпадать с нативным подсчётом модели. Ввод на 10k токенов был учтён как 10,026 токенов (нативный подсчёт — 10,000), а ввод на 8 токенов — как 34. Расхождение обнаружилось даже в контрольном запросе без инструментов; при потоковой передаче и без неё сервер сообщал 34. Все три проверки учёта токенов завершились неудачей (3 из 3).
Результат проверки кэша для 32k — это промах или сбой?
Сбой. Восемь из девяти горячих запросов на 32k попали в кэш и прочитали 32,000 токенов. Единственный промах — четвёртый запрос в окне 2: он достиг лимита в 300 s, так и не завершившись. Все девять запросов группы 8k попали в кэш, прочитав по 7,936 токенов.
Можно ли отличить качество ответов ByteDance от качества официального канала?
Нет. Совокупная точность ниже показателя официального канала на 0.40 пункта; 95%-й интервал составляет от −1.46 до +0.66. Интервал включает 0, поэтому различий между ними выявить нельзя. Это описание только данной серии тестов, а не рейтинг.
Читайте дальше: серия DeepSeek V4.1 Flash
- В этой статье за базовый показатель Q взят результат официального канала; отдельный тестовый запуск, включая 15 недействительных проб при параллельности 1, описан в статье DeepSeek V4.1 Flash в официальном канале: F = 94.00, 15 недействительных проб.
- Baidu — единственный провайдер, чей интервал Q ниже, чем у официального канала; сбои канала, обусловившие этот результат, описаны в статье DeepSeek V4.1 Flash на Baidu: недоступность канала влияет на Q и P.
- Показатели кэша Alibaba Cloud можно сопоставить со значением 93.83, приведённым здесь: DeepSeek V4.1 Flash на Alibaba Cloud: первый токен за 1.34s, попадание в кэш — 99.37.
- У Fireworks обнаружены те же проблемы с thinking mode и учётом токенов, а также пустые ответы при остановке: DeepSeek V4.1 Flash на Fireworks: пустые ответы при остановке, 3/9 попаданий в кэш.


