Anthropic wydało Claude Fable 5.2 9 listopada 2026 r. Dzień później Google udostępniło Gemini 4 Carbon w wersji ogólnodostępnej. W tabeli benchmarków z własnego ogłoszenia Anthropic znajduje się kolumna Carbon, co pozwala porównać oba modele pod kątem tego samego zadania programistycznego wymagającego długiego horyzontu działania.
Oba modele są przeznaczone do tego samego zadania: agentowego kodowania wymagającego długiego horyzontu działania. Agent analizuje repozytorium, edytuje kilka plików, uruchamia polecenia, odczytuje wyniki testów i kontynuuje pracę przez 15–45 minut bez udziału człowieka. To właśnie takie zadanie jest tu oceniane. Czat, autouzupełnianie i krótkie skrypty to inne testy.
Krótka odpowiedź
Fable 5.2 prowadzi w wymienionych benchmarkach trudnych zadań programistycznych i działa szybciej przy tym samym poziomie rozumowania, zajmując trzy czołowe miejsca w AA przed Carbon High na 4. miejscu. Carbon uzyskuje wyższe wyniki w wymienionych testach Terminal-Bench 4.0 i AutomationBench-AA, a jego koszt na zadanie przy wysokim poziomie rozumowania jest niższy do zakończenia promocyjnej ceny Google 30 listopada. Przy średnim poziomie Fable jest tańszy i znacznie szybszy, natomiast Carbon osiąga wyższy wynik w indeksie AA.
Wybierz Fable do trudnego rozumowania w kodzie, a Carbon do wykonywania poleceń w terminalu i automatyzacji; przed wyborem sprawdź limity wejścia, przechowywania danych i wyjścia.
Co pokazuje jeden zestaw testowy
Artificial Analysis testuje każdy model na tym samym zestawie narzędzi i zadań; strony Carbon i Fable zawierają wyniki poszczególnych ewaluacji. Dane pochodzą ze snapshotu z 11 listopada 2026 r.; AA stosuje standardowe ceny katalogowe, a nie promocyjną cenę Google.
| Model | Indeks AA | USD/zadanie | Min/zadanie | Pierwszy token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Uwaga: indeks inteligencji AA i koszt na zadanie przy standardowych cenach; snapshot 2026-11-11T05:23Z. Fable Max, Xhigh i High zajmują miejsca od 1. do 3.; Carbon High jest 4.; Opus 5.5 Max — 5.; Carbon Medium — 6. Pierwszy token oznacza czas do wygenerowania pierwszego tokenu odpowiedzi.
Przy wysokim poziomie Fable wyprzedza Carbon o 1,79 punktu, kosztuje 17,0% więcej na zadanie (9,08 USD wobec 7,76 USD), kończy je w 17,3 minuty zamiast 25,6 i zwraca pierwszy token po 30,4 sekundy zamiast 67,1. Koszt Max wynosi 26,54 USD na zadanie, czyli 3,4 raza więcej niż Carbon High, a czas oczekiwania to 233,9 sekundy.
Przy średnim poziomie kolejność się zmienia: Fable uzyskuje 56,41 punktu wobec 58,26 w przypadku Carbon, czyli o 1,85 punktu mniej, ale kosztuje 3,80 USD wobec 6,59 USD i wykonuje zadanie w 7,8 minuty wobec 23,3. Niższa cena tokenów Carbon nie oznacza tu niższego kosztu na zadanie — model zużywa więcej tokenów.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Bez halucynacji, % | 88.58 | 42.02 | 40.73 | 49.66 |
| Dokładność, % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Uwaga: Artificial Analysis, ten sam zestaw narzędzi i ten sam snapshot. Wynik „bez halucynacji” to odsetek odpowiedzi w Omniscience bez zmyślonych twierdzeń; dokładność to odrębna miara. Wyższy wynik jest lepszy w każdym wierszu. Pominięto Fable Xhigh, by tabela była czytelniejsza; jego wynik FrontierCode 2.0 to 47.58.
Który model prowadzi w każdym teście przy wysokim poziomie rozumowania? Podana niżej różnica ze znakiem to wynik Carbon minus wynik Fable; pokazuje kierunek różnicy, podczas gdy tabela powyżej przedstawia wyniki bezwzględne.
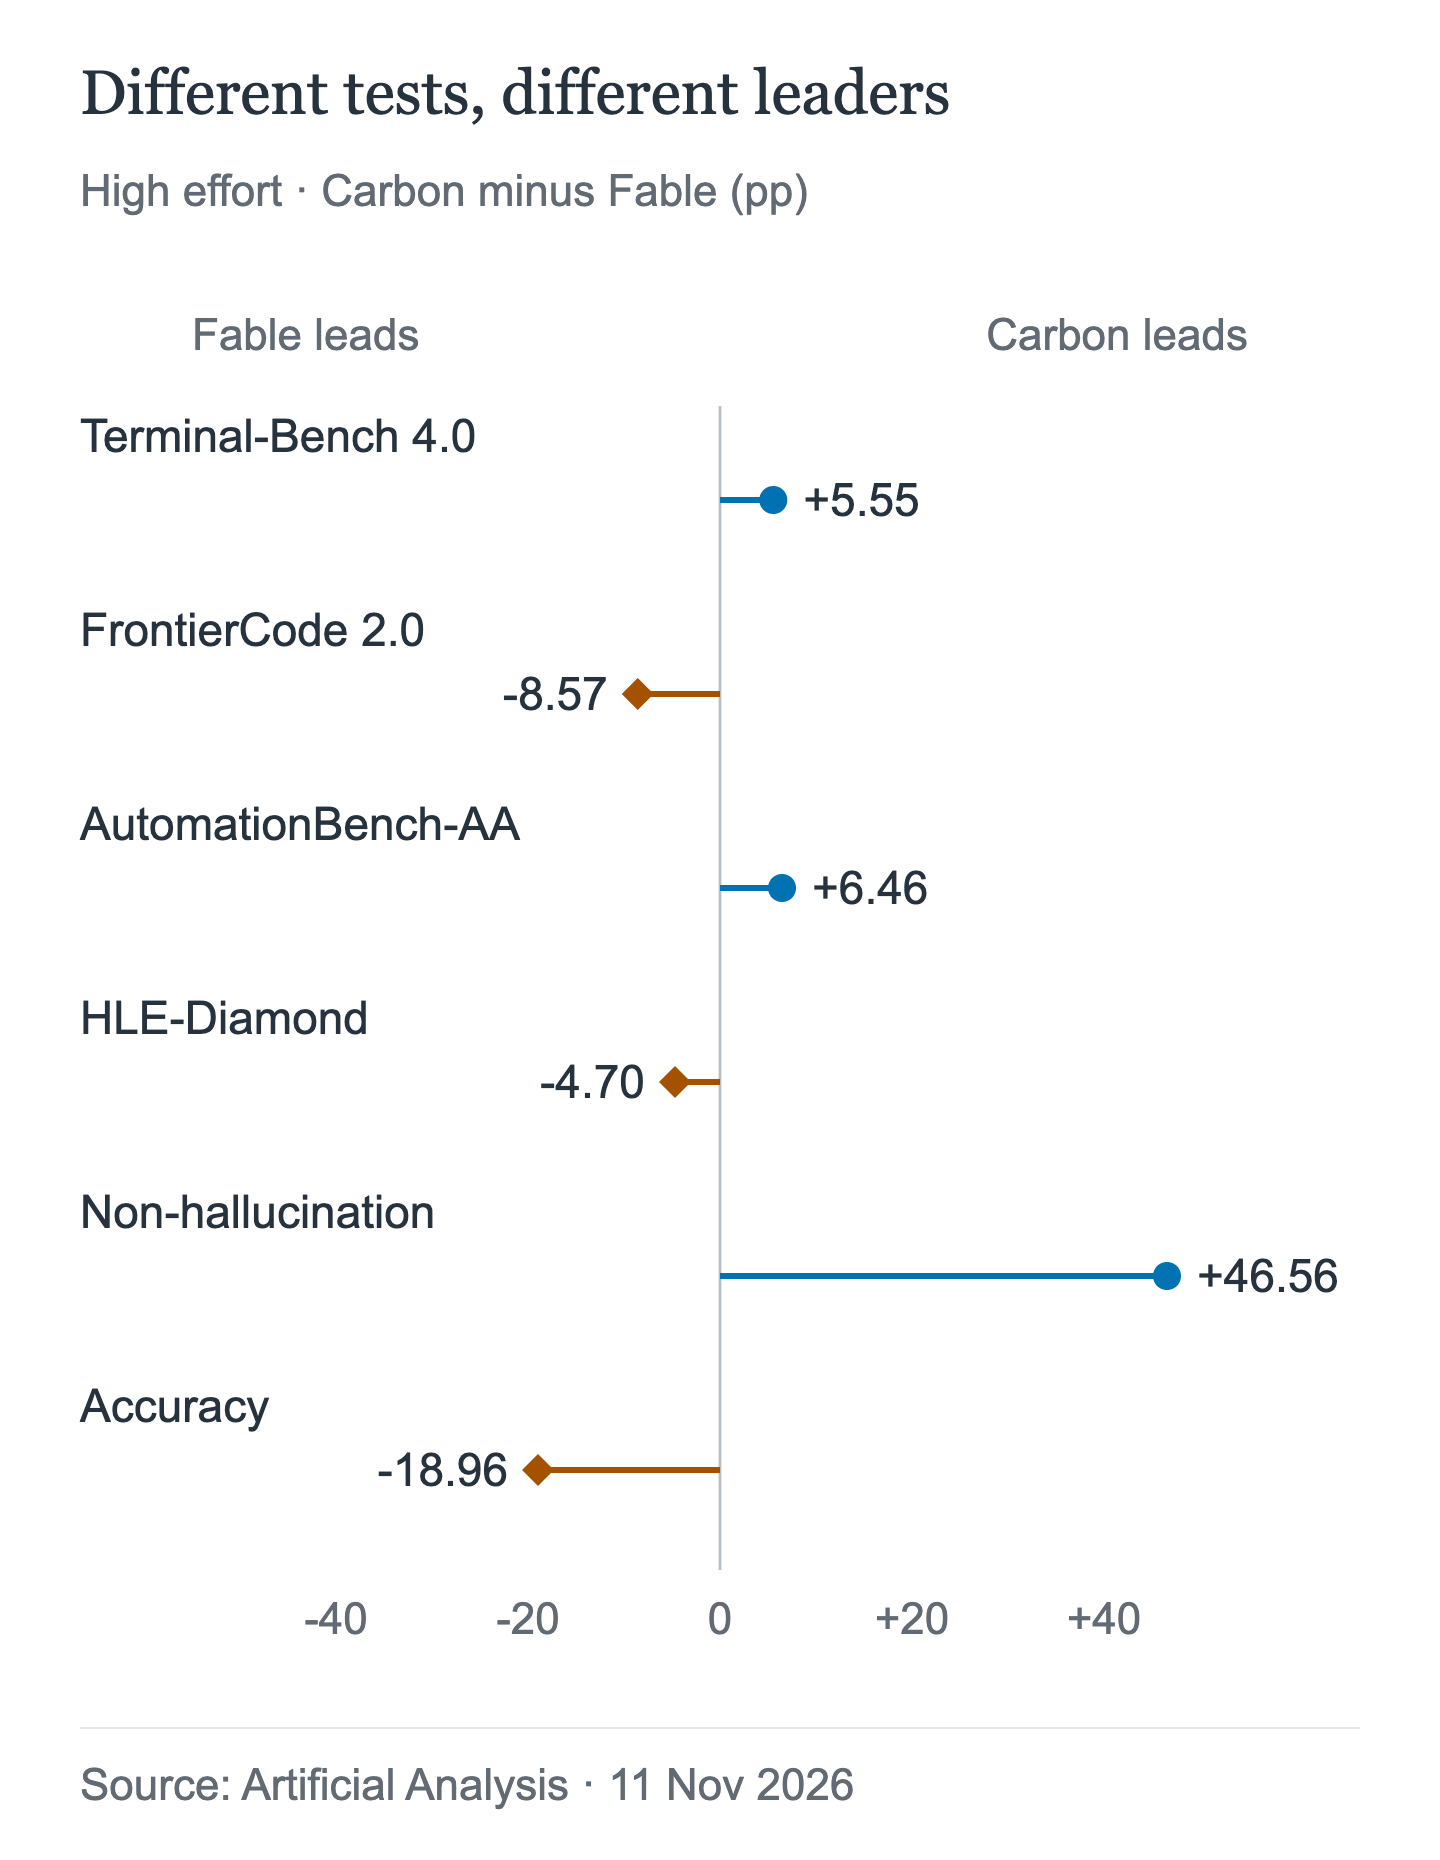
To różnice w punktach procentowych w niezależnych testach, a nie łączny wynik jakości. Większa różnica w jednym benchmarku nie oznacza większej ogólnej poprawy zdolności. W szczególności wynik bez halucynacji i dokładność mierzą różne aspekty.
Przy wysokim poziomie Fable wygrywa z FrontierCode 2.0 o 8,57 punktu, a z HLE-Diamond o 4,7; jego wynik Briefcase Elo to 1677.4 wobec 1610.6. FrontierCode to benchmark najbliższy trudnym zmianom obejmującym wiele plików. Carbon wygrywa z Terminal-Bench 4.0 o 5,55 punktu, a z AutomationBench o 6,46; benchmarki te premiują wykonywanie poleceń, odzyskiwanie sprawności po błędach i automatyzację.
Różnica w wyniku bez halucynacji jest największa w tabeli: 88,58% dla Carbon wobec 42,02% dla Fable przy wysokim poziomie. W przypadku dokładności kierunek jest odwrotny: 58,27% wobec 77,23%. Carbon rzadziej zmyśla, ale też rzadziej udziela poprawnej odpowiedzi. W przypadku agenta, który nie może wymyślać nieistniejącego API, może to być zaleta; jeśli agent ma udzielać odpowiedzi, lepszym wskaźnikiem jest dokładność Fable.
Większy nakład rozumowania nie zawsze oznacza lepszy wynik: Fable Max uzyskuje w FrontierCode 48.76, nieco mniej niż High z wynikiem 49.13, a wynik w Terminal-Bench pozostaje na poziomie 59.6.
Własna tabela Anthropic
Na stronie premierowej Anthropic publikuje tabelę porównującą modele różnych dostawców, uwzględniającą Carbon. Ustawienia różnią się od tych w AA: Fable działa z poziomem Xhigh, najwyższym raportowanym poziomem rozumowania, a Carbon — z poziomem Medium. Porównuj wyniki wyłącznie w ramach tej tabeli.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Uwaga: dane raportowane przez Anthropic. Fable działa z poziomem Xhigh, najwyższym dostępnym poziomem rozumowania; Carbon — z poziomem Medium. Skala AutomationBench w tabeli Anthropic różni się od skali AA (51.4/53.9 wobec 71.36/77.82), więc porównuj wyniki w ramach tej tabeli. Wynik Carbon 41.1 w FrontierCode pochodzi z testu na poziomie Medium; wynik 40.56 w AA uzyskano przy poziomie High i z użyciem innego zestawu narzędzi.
Kierunek wyników zgadza się z AA: Fable prowadzi w FrontierCode, FrontierSWE, OSWorld i TB-Science; Carbon wygrywa z AutomationBench o 2,5 punktu — mniej niż 6,5 punktu w AA, ale różnica ma ten sam znak. Tabela potwierdza, że „Carbon jest konkurencyjny w automatyzacji”, a nie że „Carbon lepiej radzi sobie z trudnym kodowaniem”.
Własna rekomendacja Anthropic komplikuje stwierdzenie, że „Fable to ulepszenie”: „W przypadku większości zadań związanych z programowaniem i wiedzą zalecamy użytkownikom rozpocząć od Claude Opus 5.5”. Firma twierdzi, że przy wysokim poziomie Fable osiąga wyniki zbliżone do najlepszego rezultatu Opus 5.5 (45,3% wobec 45,5%) przy mniej więcej połowie kosztu na zadanie.
Ile kosztują tokeny
| Model | Wejście | Wyjście | Odczyt z pamięci podręcznej |
|---|---|---|---|
| Carbon, do 30 listopada | $2 | $10 | $0.10 |
| Carbon, od 1 grudnia | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Uwaga: USD za 1M tokenów, ceny oficjalne. Zapis w pamięci podręcznej Fable: 10 USD (5 min) lub 16 USD (1 godz.); w trybie Batch zniżka 50%. Cena Carbon w kolumnie pamięci podręcznej dotyczy odczytu; oficjalna cena odczytu z pamięci podręcznej Opus 5.5 wynosi 0.20 USD.
Cena tokenów Fable jest dwukrotnie wyższa od standardowej stawki Carbon i czterokrotnie wyższa od jego ceny promocyjnej. Proporcja jest prosta, ale koszt zadania — nie. Artificial Analysis zmierzyło koszt Carbon High na poziomie 7,76 USD przy cenach 4/20 USD, wobec 9,08 USD w przypadku Fable High, czyli różnicę 17,0%. Przy stawce Google wynoszącej 2/10 USD ten sam poziom użycia kosztowałby około 3,88 USD — to wyliczenie szacunkowe. Do 30 listopada Fable High kosztuje około 2,3 raza więcej na zadanie; od 1 grudnia różnica wraca do 17,0%.
Przy standardowych cenach Fable Medium kosztuje 3,80 USD wobec 6,59 USD w przypadku Carbon, czyli o 42% mniej mimo dwukrotnie wyższej ceny tokenów. Carbon potrzebuje 23,3 minuty i zużywa więcej tokenów; Fable — 7,8 minuty. Przy promocyjnej stawce Carbon Medium kosztuje około 3,30 USD, przy takim samym sposobie szacowania, czyli zbliżoną kwotę do Fable; ta przewaga znika 1 grudnia.
Koszt Max na zadanie jest 3,4 raza wyższy niż w przypadku Carbon High (26,54 USD), a wykonanie zadania trwa 45,2 minuty. Wyższy wydatek nie zapewnia jednolicie lepszego agenta programistycznego: wynik Max w FrontierCode jest nieco niższy niż wynik High.
AIHubMix oferuje Carbon w promocyjnej cenie Google. Ceny Fable podane tutaj to oficjalne stawki Anthropic.
Różnice w działaniu, które wpływają na wdrożenia
| Wymiar | Carbon | Fable 5.2 |
|---|---|---|
| Maks. długość wyjścia | 65,536; natywnie ≤1,048,576−wejście* | 128,000 |
| Kontekst | 1,048,576 (natywnie w Google) | 1M |
| Rozumowanie | low / medium / high; domyślnie medium | adaptacyjne; domyślnie high |
| Wymuszone narzędzia | udokumentowano auto* | any / narzędzie zwraca 400 |
| Parametry próbkowania | ignorowane; usuń | niektóre wartości zwracają 400 |
| Przechowywanie danych | brak podanego limitu | 30 dni; brak ZDR |
| Wejście | tekst w AIHubMix | tekst, obraz, PDF† |
| Granica wiedzy | marzec 2026 | czerwiec 2026 |
Uwaga: *Wyższe limity Carbon dotyczą natywnych w Google możliwości generowania długich wyjść; AIHubMix dokumentuje obecnie tylko wejście tekstowe i Chat Completions, więc obsługa przez bramę nie jest potwierdzona. †Obsługiwane modalności wejściowe Fable podano w indeksie modeli AIHubMix. *AIHubMix dokumentuje tool_choice="auto", ale obsługa Carbon nie została potwierdzona. Udokumentowany limit wyjścia dla modelu Fable wynosi 128,000 tokenów. ZDR oznacza zerowe przechowywanie danych.
Wymuszone użycie narzędzi jest poważną przeszkodą w przypadku Fable: „Wymuszone użycie narzędzi (typy tool_choice any i tool) zwraca błąd 400”. Agent, który musi wywoływać określone narzędzie w każdej turze, nie może używać Fable bez zmian. Przewodnik Google dotyczący Carbon zaleca sekwencyjne tury wykonywania narzędzi; przewodnik AIHubMix dotyczący Gemini dokumentuje tool_choice="auto", ale obsługa narzędzi Carbon przez bramę nie została potwierdzona.
Wymogi dotyczące przechowywania danych mogą uniemożliwić użycie Fable. W jego omówieniu podano, że „wymaga 30-dniowego przechowywania danych i nie jest dostępny w trybie zerowego przechowywania danych, chyba że Anthropic wyrazi na to zgodę”. Dokumentacja Carbon, na podstawie której przygotowano to porównanie, nie podaje takiego ograniczenia; nie jest to jednak gwarancja. Przed wdrożeniem zespoły podlegające regulacjom powinny potwierdzić zasady dotyczące obu modeli.
Standardowy limit Carbon wynoszący 65,536 tokenów wystarcza do większości edycji, ale generowanie całych plików może go przekroczyć. Natywny w Google tryb działania w tle pozwala osiągnąć do 1,048,576 minus liczba tokenów wejściowych, rozlicza kolejne fragmenty i może zwrócić incomplete wraz z pustym tekstem, mimo że użycie nadal podlega opłacie. AIHubMix nie dokumentuje tej funkcji. Fable zwraca do 128,000 tokenów w jednej odpowiedzi.
W żadnym z modeli nie można wyłączyć rozumowania. Carbon oferuje poziomy low, medium i high, domyślnie ustawia medium i ignoruje parametry próbkowania. Fable ma „zawsze włączone adaptacyjne rozumowanie, którego nie da się wyłączyć”, domyślnie używa high i zwraca błąd 400 dla niektórych wartości parametrów próbkowania.
Google udostępniło Carbon zespołom obronnym w ramach programu Fairwind jeszcze przed ogólną dostępnością. Klasyfikatory Fable blokują żądania dotyczące testów penetracyjnych i exploitów, a w zadaniach z zakresu cyberbezpieczeństwa i biologii kierują zapytania do innych modeli. W testach bezpieczeństwa zachowanie przy odmowie jest ważniejsze niż wynik w pojedynczym wierszu benchmarku.
Opus 5.5 jako punkt odniesienia
Opus 5.5 nie jest rywalem, ale stanowi punkt odniesienia Anthropic. Przy cenach 4/20 USD uzyskuje 59.11 w AA, kosztuje 10,04 USD na zadanie, potrzebuje 25,0 minuty i generuje pierwszy token po 356,4 sekundy — najdłużej w tabeli (wiersz AA dotyczy poziomu Max; domyślnie model używa poziomu Medium). Wygrywa w Briefcase Elo z wynikiem 1800.6, ale ustępuje Fable High w FrontierCode i Carbon High w Terminal-Bench. Mimo to Anthropic nadal zaleca Opus 5.5 jako model, od którego warto zacząć w przypadku większości zadań programistycznych.
Kto powinien wybrać który model
Wybierz Fable 5.2, jeśli dominują trudne zmiany w kodzie i zależy Ci na najlepszych zmierzonych wynikach w FrontierCode i HLE. Przy średnim poziomie rozumowania jest tańszy i szybszy — kosztuje 3,80 USD i potrzebuje 7,8 minuty, wobec 6,59 USD i 23,3 minuty w przypadku Carbon — choć Carbon uzyskuje wyższy wynik w indeksie AA. Wybierz Fable, jeśli potrzebujesz obsługi obrazów na wejściu lub granicy wiedzy z czerwca 2026 r., albo jeśli akceptujesz 30-dniowe przechowywanie danych i brak możliwości wymuszenia wywołań narzędzi.
Wybierz Carbon, gdy dominuje praca w terminalu: pętle testowania i naprawiania, automatyzacja powłoki, operacje wieloetapowe. Wypada lepiej w wymienionych wynikach Terminal-Bench 4.0 i AutomationBench-AA, a do 30 listopada jest tańszy przy wysokim poziomie rozumowania. Zgodność z ekosystemem Google i limity długości wyjścia nie zostały potwierdzone w AIHubMix; wdrażaj go wyłącznie do pracy z tekstem z parametrem tool_choice="auto", dopiero po potwierdzeniu obsługi narzędzi przez Carbon. Uzyskuje wyższy wynik w zakresie niehalucynowania, ale niższy pod względem dokładności.
Wybierz Opus 5.5 jako rekomendowany przez Anthropic punkt wyjścia i model o zrównoważonym profilu; zaakceptuj wolniejsze pojawienie się pierwszego tokenu przy maksymalnym poziomie rozumowania.
Nie wybieraj żadnego z nich, jeśli liczy się interaktywne opóźnienie: pierwszy token przy wysokim poziomie rozumowania pojawia się po 30.4 sekundy w przypadku Fable i 67.1 sekundy w przypadku Carbon, a 23.2 sekundy w przypadku Carbon przy średnim poziomie nadal nie oznaczają szybkości typowej dla czatu.
Uruchamiaj oba modele przez AIHubMix
AIHubMix udostępnia oba modele za pomocą jednego klucza i wspólnego punktu końcowego chat-completions. ID Carbon to gemini-4-carbon; strona modelu opisuje chat completions, dane wejściowe w postaci tekstu i cenę wprowadzającą Google. ID Fable 5.2 to claude-fable-5-2; AIHubMix wymienia Chat Completions, Responses i Anthropic Messages, kontekst 1M oraz maksymalnie 128K tokenów wyjściowych. Udokumentowana obsługa Carbon jest węższa: chat completions, a nie natywne API Gemini. Bramka ponawia też próbę u kolejnego najlepszego dostawcy, więc działanie może się różnić od wdrożenia u jednego dostawcy.
Szybki start opisuje uwierzytelnianie i bazowy adres URL. Test dymny może sprawdzić, czy oba ID są dostępne za pomocą tego samego klucza; na potrzeby tej wersji artykułu nie przeprowadzono testu na żywo:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
To sprawdza trasowanie, a nie możliwości: bez narzędzi i długiego wyjścia. Aby przeprowadzić rzeczywiste porównanie, uruchom ten sam przebieg agenta dla obu ID i zanotuj czas wykonania zadania, zużycie tokenów oraz błędy. Strona porównania zestawia obok siebie kontekst, protokoły i ceny.
FAQ
Czy Gemini 4 Carbon lepiej nadaje się do kodowania agentowego niż Fable 5.2?
Żaden model nie wygrywa w każdym aspekcie. Fable 5.2 prowadzi w FrontierCode 2.0 i ogólnym indeksie przy wysokim poziomie rozumowania; Carbon prowadzi w Terminal-Bench 4.0 i AutomationBench. Wybierz model odpowiedni do zadań, które faktycznie wykonuje agent.
Dlaczego Fable 5.2 kosztuje cztery razy więcej niż Carbon?
Według oficjalnych stawek Fable kosztuje $8/$40 za milion tokenów, a wprowadzająca cena Carbon to $2/$10, czyli cztery razy mniej za tokeny wejściowe i wyjściowe. W porównaniu ze standardową ceną Carbon wynoszącą $4/$20 od 1 grudnia różnica wynosi dwa razy.
Czy przy średnim poziomie rozumowania Fable 5.2 naprawdę kosztuje mniej za zadanie?
Przy standardowych cenach tak: $3.80 wobec $6.59 dla Carbon przy średnim poziomie rozumowania, a czas wykonania to 7.8 minuty wobec 23.3. Wprowadzająca cena tokenów Carbon zmniejsza różnicę; porównanie standardowych cen jest bardziej miarodajne na dłuższą metę.
Czy Fable 5.2 może wymusić wywołanie narzędzia?
Nie. Anthropic informuje, że wartości tool_choice any i tool powodują błąd 400. Agenty, które wymagają wymuszonego wywołania, potrzebują innej pętli lub innego modelu.
Czy Carbon rzadziej halucynuje niż Fable 5.2?
Tak, według miary niehalucynowania Omniscience w AA: 88.58% wobec 42.02% przy wysokim poziomie rozumowania. Jego dokładność jest jednak niższa — 58.27% wobec 77.23% — więc rzadziej podaje również prawidłową odpowiedź.
Czy oba modele można uruchamiać przez AIHubMix za pomocą jednego klucza?
Tak. Użyj gemini-4-carbon i claude-fable-5-2 z tym samym kluczem i bazowym adresem URL. AIHubMix dokumentuje obsługę chat completions dla Carbon oraz chat completions, Responses i Messages dla Fable.
Czytaj dalej: seria Gemini 4 Carbon
- Zanim wybierzesz konkurencyjny model, rozstrzygnij kwestię bliźniaczego modelu: Gemini 4 Carbon kontra Argon: ta sama cena — kiedy warto wybrać Carbon?
- Gdy Carbon działa już w pętli, pierwsze błędy 400 i przekroczenia limitu czasu zwykle wynikają z konfiguracji, a nie z modelu: Migracja do Gemini 4 Carbon API: błędy 400, przekroczenia limitu czasu i limity wyjścia
Źródła
- Gemini 4 Carbon jest już dostępny — Google, 10 listopada 2026 r.
- Claude Fable 5.2 — Anthropic, 9 listopada 2026 r.
- Omówienie Claude Fable 5.2 — dokumentacja Anthropic.
- Gemini 4 Carbon i Claude Fable 5.2 — Artificial Analysis, stan na 11 listopada 2026 r.
- Gemini 4 Carbon w AIHubMix — strona modelu i cennik.