
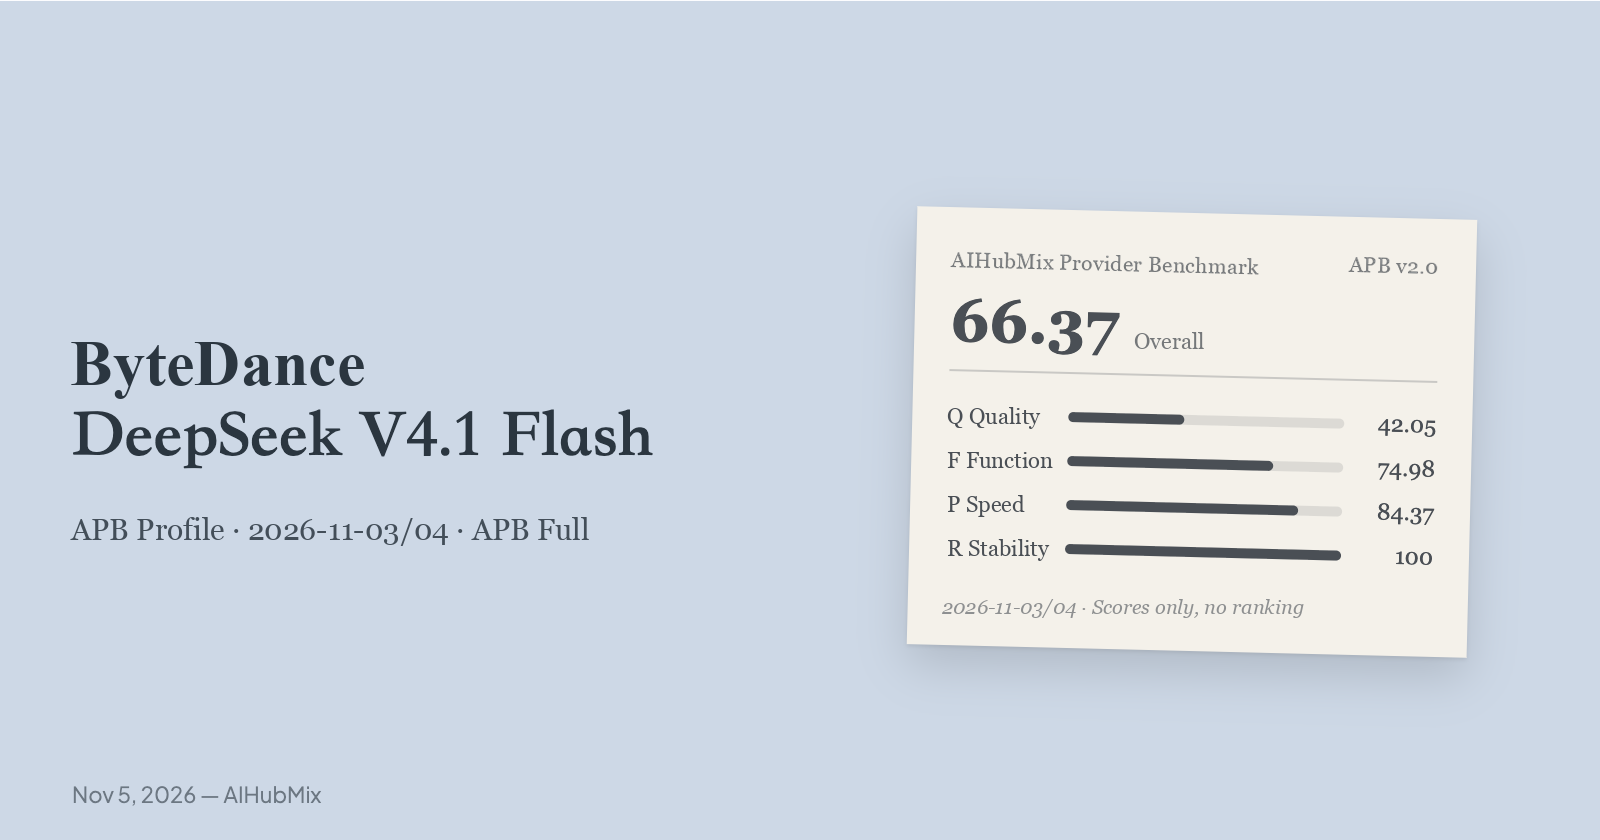
W dniach 2026-11-03/04 model DeepSeek V4.1 Flash 1017 przetestowano u pięciu dostawców za pośrednictwem AIHubMix, korzystając z pełnego zestawu APB: za każdym razem te same pytania, parametry i skrypty żądań. Ten profil APB obejmuje wyłącznie test ByteDance, sekcja po sekcji.
Poniższe liczby to wyniki, a nie ranking ani rekomendacja dostawcy. Najpierw podano Q, F, P, K i R; wynik łączny to indeks podsumowujący, a nie certyfikat, i nie ma przedziału ufności. Zasady punktacji określa AIHubMix Provider Benchmark Standard v2.0.
Wyniki pięciu dostawców
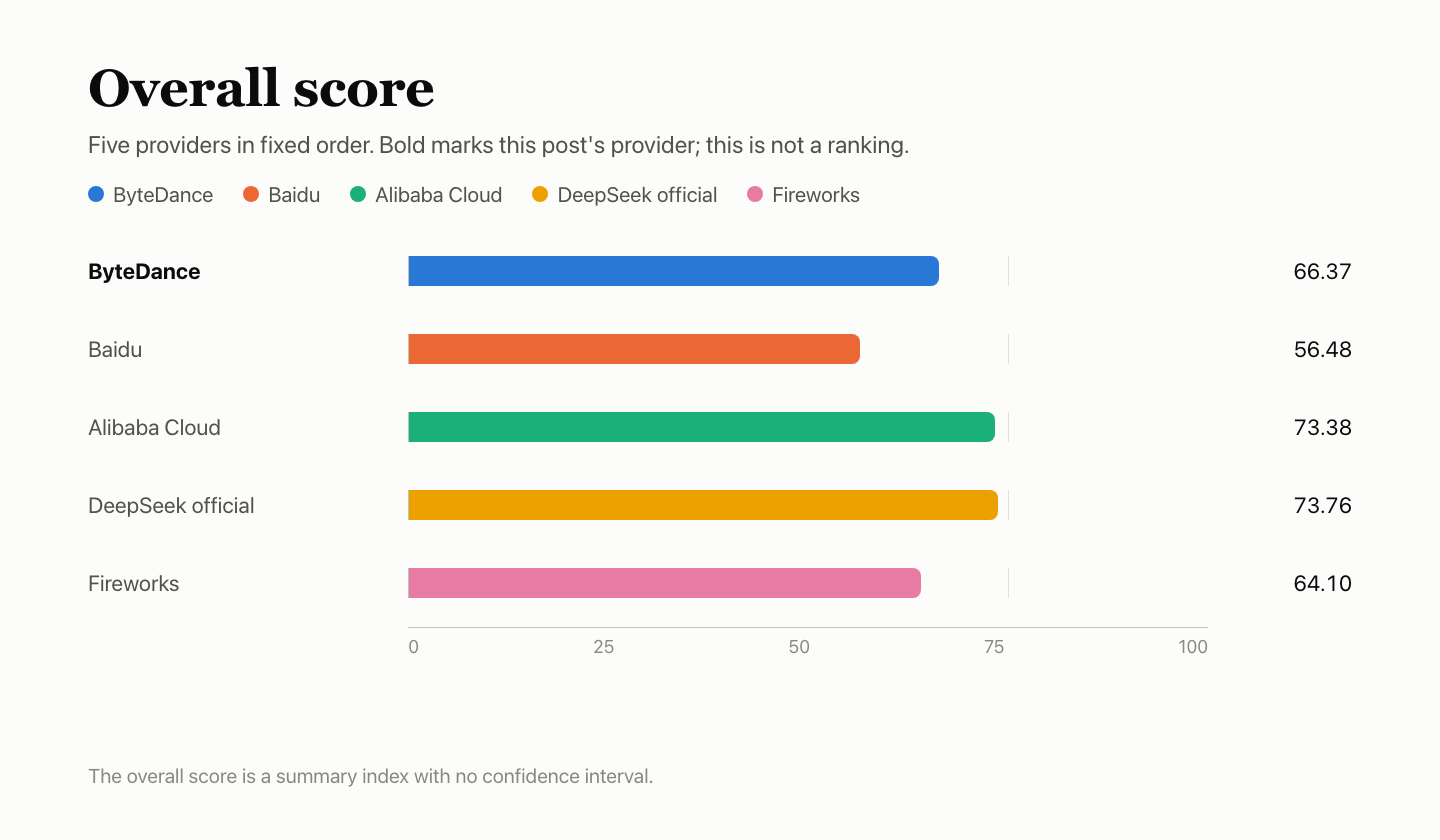
Pogrubieniem oznaczono dostawcę opisywanego w tym wpisie. Stała kolejność dostawców, nie ranking. K jest składową wyniku P i stanowi 20% jego wartości. Wynik łączny to indeks podsumowujący bez przedziału ufności. Wyniki DeepSeek w oficjalnym kanale i Alibaba Cloud różnią się o 0.37 i nie można ich od siebie odróżnić.
W skrócie
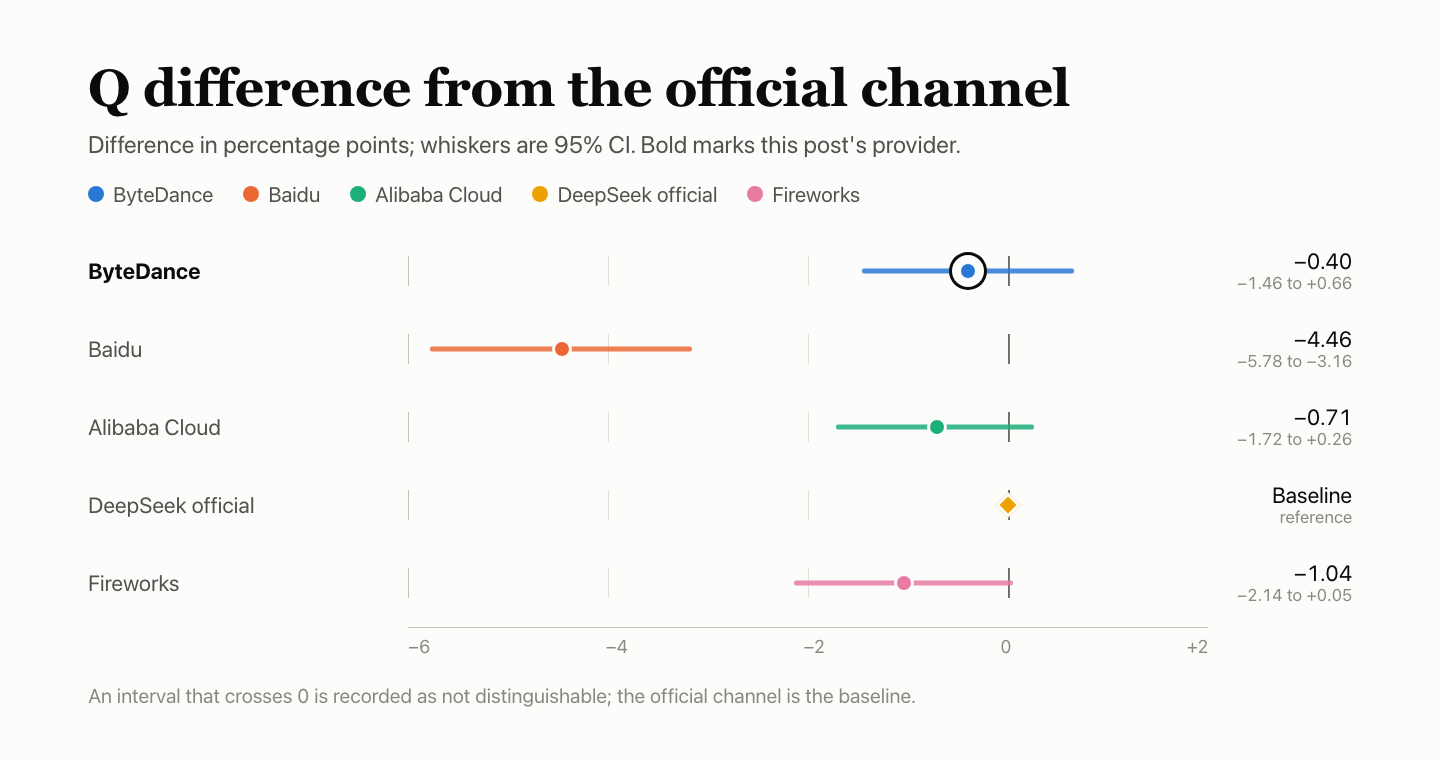
- Q 42.05. BFCL 85.20%, HLE 15.34%, AA-LCR 49.20%. Różnica względem oficjalnego kanału wynosi −0.40 punktu procentowego, a 95-procentowy przedział od −1.46 do +0.66: wyników nie można od siebie odróżnić. W AA-LCR wystąpiło 28 błędów żądań, wszystkie w oknie 1; uznano je za odpowiedzi błędne.
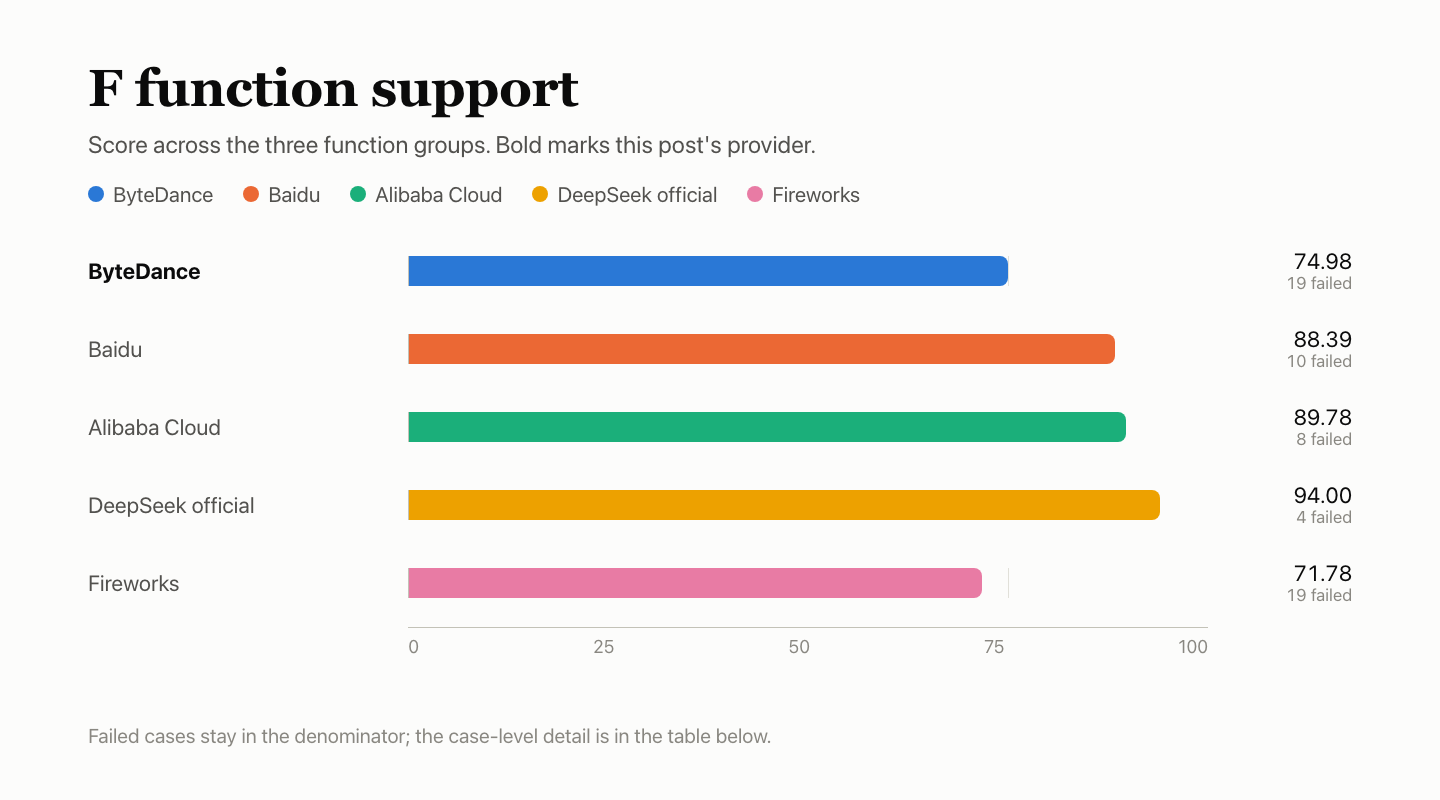
- F 74.98. Zaliczył 124 z 174 uwzględnionych kontroli.
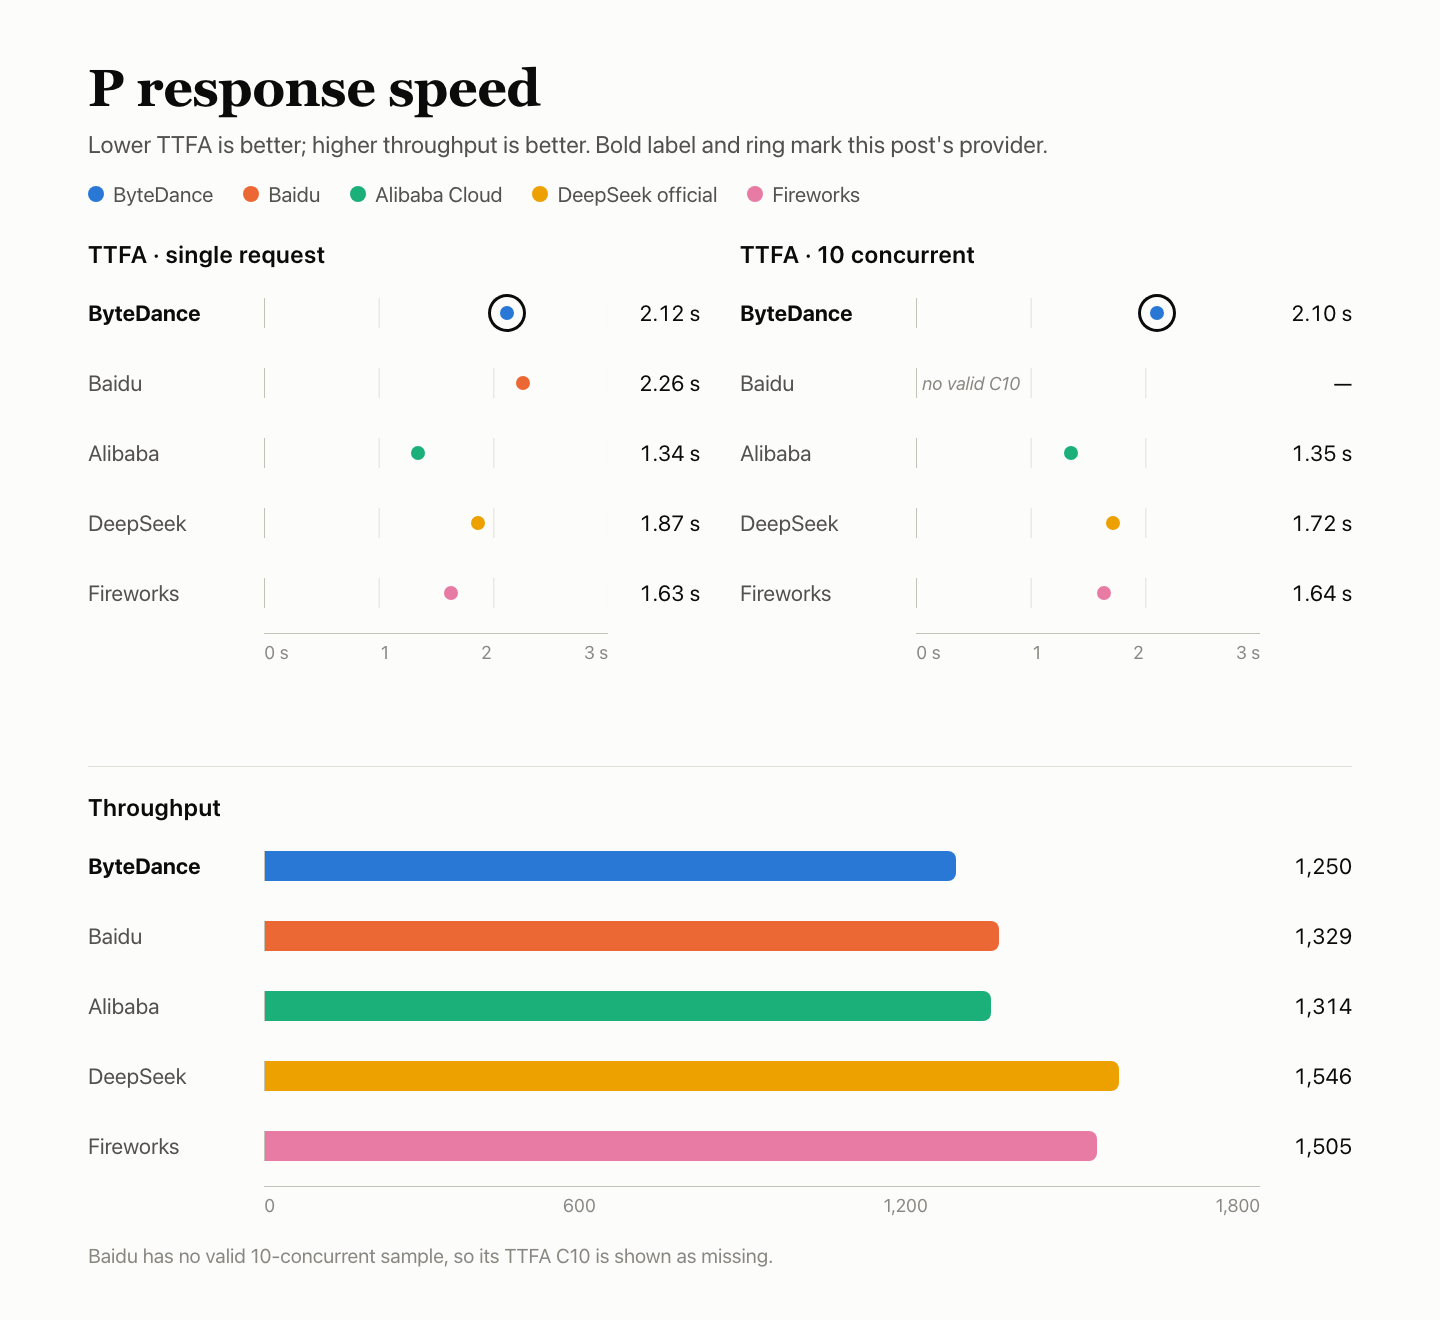
reasoning_effort=nonenie wyłącza myślenia. Wejście o długości 10k tokenów zostało zaraportowane jako 10,026 tokenów (liczba natywna: 10,000); wejście o długości 8 tokenów zaraportowano jako 34. - P 84.37. Mediana czasu do pierwszego tokenu treści: 2.12 s przy współbieżności 1 i 2.10 s przy współbieżności 10; TPOT 3.43 ms/token; wszystkie 180 żądań pomiaru szybkości były prawidłowe.
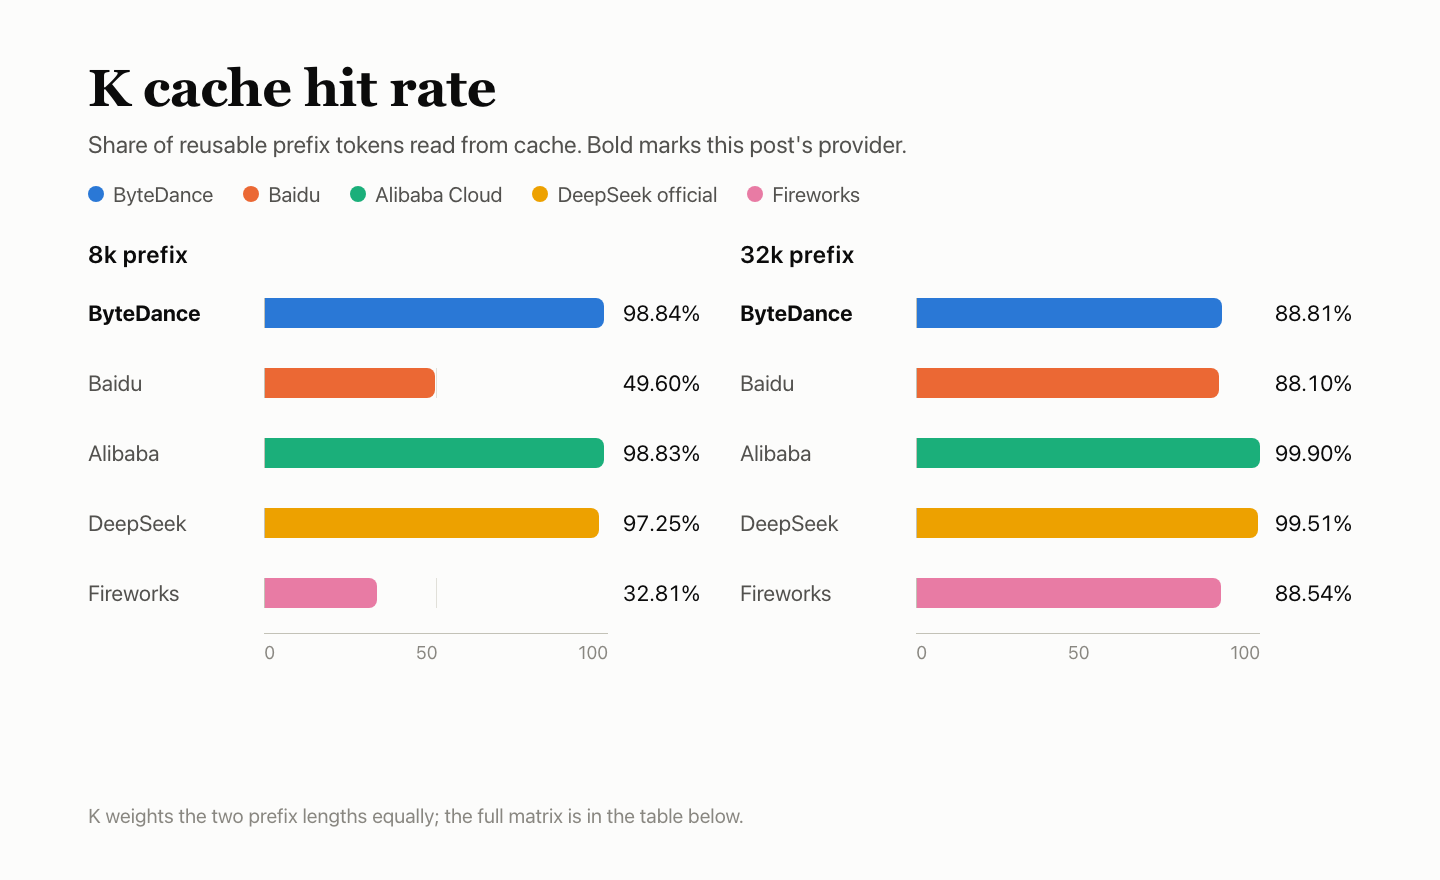
- K 93.83. Gorące żądania dla 8k trafiły do pamięci podręcznej 9/9 razy; dla 32k — 8 razy, a jedno żądanie nie zostało ukończone w terminie 300 s.
- R 100. Wszystkie 300 dedykowanych żądań zakończyło się powodzeniem za pierwszym podejściem.
Konfiguracja testu
| Element | Szczegóły |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Żądany identyfikator modelu | doubao-deepseek-v4.1-flash-1017 |
| Zwrócona nazwa modelu | deepseek-v4-1-flash-261017 |
| Ścieżka dostępu | Przez AIHubMix, z identyfikatorem modelu właściwym dla dostawcy; nie bezpośrednio z konta dostawcy |
| Parametry | Tryb bez myślenia, temperature 1.0, max_tokens 16,384, limit czasu 300 s, bez automatycznych ponowień |
| Wyłączone myślenie | Żądania dotyczące jakości odpowiedzi, szybkości, pamięci podręcznej i stabilności korzystały z natywnego parametru thinking.type=disabled (u tego dostawcy reasoning_effort=none nie wyłączało myślenia); w przypadkach funkcji pozostawiono reasoning_effort=none, aby sprawdzić, czy parametr działa |
| Termin | 2026-11-03 18:07 – 11-04 16:33 UTC+8; pięciu dostawców korzystało z jednego Maca mini, jednej sieci i jednego konta |
| Próbki | Jakość odpowiedzi: 4,250 instancji pytań (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); funkcje: 60 przypadków × 3 okna; szybkość: 90 przy współbieżności 1 i 90 przy współbieżności 10; stabilność: 300; pamięć podręczna: 30 (trzy grupy dla prefiksów 8k i 32k) |
Żądania korzystały ze ścieżki szybkiego startu AIHubMix z identyfikatorem właściwym dla dostawcy, a parametry były zgodne z dokumentacją API DeepSeek; identyfikatory pozostałych dostawców wymieniono na stronie modeli.
Q — jakość odpowiedzi: 42.05
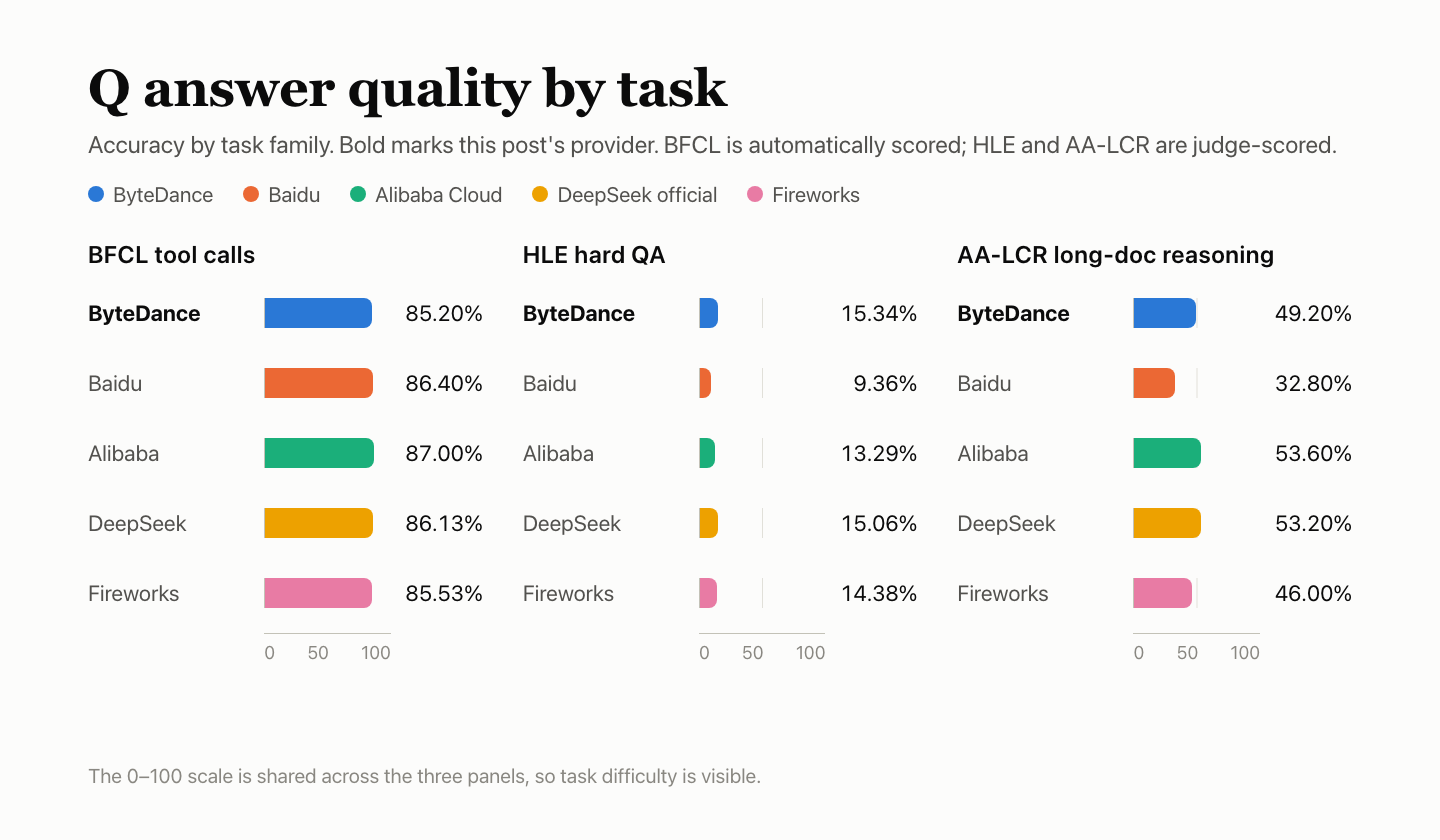
Ocena jakości odpowiedzi opiera się na trzech zestawach: 500 pytaniach BFCL z 3 rundami dla każdego, 250 pytaniach HLE z 10 rundami dla każdego oraz 25 pytaniach AA-LCR z 10 rundami dla każdego. BFCL jest oceniany automatycznie według reguł; HLE i AA-LCR ocenia model deepseek-flash. Wszystkim pięciu dostawcom zadano te same pytania, a wyniki z trzech zestawów połączono w jedną wartość dokładności. Usunięto dziesięć odpowiedzi, ponieważ nie można było ocenić danego pytania; pozostało 4,240 ocenionych instancji pytań.
| Zestaw | Pytania | Poprawne | Dokładność | Błędy |
|---|---|---|---|---|
| Wywołania narzędzi BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Trudne pytania i odpowiedzi HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Rozumowanie na podstawie długich dokumentów AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Łącznie · 95-procentowy przedział 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Błędy usługi — błędy żądań lub ucięte wyjście — pozostają w mianowniku i są liczone jako odpowiedzi błędne. Wyjście HLE osiągnęło limit max_tokens 7 razy; w AA-LCR wystąpiło 28 błędów żądań, wszystkie w oknie 1. BFCL jest oceniany automatycznie, a HLE i AA-LCR — przez model oceniający.
Na każde pytanie BFCL udzielono odpowiedzi 3 razy; tabela sumuje wyniki 3 rund.
| Kategoria BFCL | Zaliczone | Odsetek zaliczeń |
|---|---|---|
| simple_python — jedna funkcja, poprawne wywołanie i argumenty | 329/360 | 91.39% |
| multiple — wybór jednej z kilku funkcji | 268/300 | 89.33% |
| parallel — wielokrotne wywołanie tej samej funkcji | 271/300 | 90.33% |
| parallel_multiple — wywołanie kilku różnych funkcji | 207/240 | 86.25% |
| irrelevance — żadna funkcja nie jest odpowiednia, nie należy jej wywoływać | 102/150 | 68.00% |
| ahm_multi_turn — trzyetapowy łańcuch narzędzi | 101/150 | 67.33% |
Porównanie z pozostałymi czterema
Różnica względem oficjalnego kanału w punktach procentowych, z 95-procentowym przedziałem pokazanym jako wąsy. Przedział obejmujący 0 oznacza, że wyników nie można od siebie odróżnić. Model oceniający HLE i AA-LCR, deepseek-flash, należy do tej samej rodziny DeepSeek co testowany model i nie został skalibrowany, więc jego oceny mogą być pobłażliwe.
F — obsługa funkcji: 74.98
Zestaw testów funkcji sprawdza wyłącznie zgodność zachowania interfejsu z protokołem, a nie jakość odpowiedzi modelu. Sześćdziesiąt przypadków w sześciu grupach uruchomiono trzykrotnie, po jednym razie dla każdego okna: 180 kontroli ocenianych według formatu udokumentowanego przez każdego dostawcę. Kontrole, które nie miały zastosowania, były nieprawidłowe lub nie zostały zaobserwowane, pominięto w mianowniku. ByteDance zaliczył 124 z 174 uwzględnionych kontroli i uzyskał 74.98 punktu przy wagach grup.
Wynik ważony uwzględnia wagi grup; nie jest ilorazem zaliczonych kontroli i 174.
| Grupa | Waga | Zaliczone | Wykluczone | Wynik grupy |
|---|---|---|---|---|
| Strumieniowanie i protokół wiadomości | 20% | 23/27 | 3 | 85.19 |
| Interfejs narzędzi | 20% | 30/30 | — | 100.00 |
| Ograniczenia wyjścia i parametry | 20% | 24/30 | — | 80.00 |
| Kontekst i stan | 15% | 14/30 | — | 46.67 |
| Błędy i odzyskiwanie | 15% | 21/30 | — | 70.00 |
| Rozliczanie i protokół pamięci podręcznej | 10% | 12/27 | 3 | 44.44 |
| Łącznie · wynik ważony | — | 124/174 | 6 | 74.98 |
„Nieudane okna” oznaczają liczbę spośród 3 okien, w których kontrola zakończyła się niepowodzeniem.
| Nieudany przypadek | Nieudane okna | Przyczyna |
|---|---|---|
| Rozumowanie nie przedostaje się do treści — strumieniowanie i protokół wiadomości | 3/3 | Przy reasoning_effort=none nadal zwracano treść z procesu myślenia |
| Konfiguracja myślenia działa — ograniczenia wyjścia i parametry | 3/3 | Przy reasoning_effort=none nadal zwracano treść z procesu myślenia |
| Różnorodność próbkowania — ograniczenia wyjścia i parametry | 3/3 | Wyjścia przy temperaturze 0 i 1 nie różniły się wystarczająco; nie osiągnęły progu ustalonego przed testem |
| Długie wejście 10k — kontekst i stan | 3/3 | Zaraportowano wejście o długości 10,026 tokenów; natywna liczba powinna wynosić 10,000 |
| W granicach limitu kontekstu — kontekst i stan | 3/3 | Zaraportowano wejście o długości 10,026 tokenów; natywna liczba powinna wynosić 10,000 |
| Długie wejście 32k — kontekst i stan | 3/3 | Zaraportowano wejście o długości 10,026 tokenów; natywna liczba powinna wynosić 10,000 |
| Długie wejście 100k — kontekst i stan | 3/3 | Zaraportowano wejście o długości 10,026 tokenów; natywna liczba powinna wynosić 10,000 |
| Przekroczenie limitu kontekstu — kontekst i stan | 3/3 | Błąd połączenia z systemem nadrzędnym lub przekroczenie limitu czasu (1); należało zwrócić błąd parametru, zwrócono 200 (2) |
| Historia 12 tur — kontekst i stan | 1/3 | Błąd połączenia z systemem nadrzędnym lub przekroczenie limitu czasu |
| Błąd formatu messages — błędy i odzyskiwanie | 3/3 | Zwrócono 400 z pustą treścią odpowiedzi; brak ustrukturyzowanego objaśnienia błędu |
| Osierocony wynik narzędzia — błędy i odzyskiwanie | 3/3 | Należało zwrócić błąd parametru, zwrócono 200 |
| Błąd formatu stream_options — błędy i odzyskiwanie | 3/3 | Zwrócono 400 z pustą treścią odpowiedzi; brak ustrukturyzowanego objaśnienia błędu |
| Rozliczanie tokenów myślenia — rozliczanie i protokół pamięci podręcznej | 3/3 | Zaraportowano tokeny myślenia po wyłączeniu myślenia |
| Natywna liczba tokenów wejściowych — rozliczanie i protokół pamięci podręcznej | 3/3 | Zaraportowano 34 tokeny; natywna liczba powinna wynosić 8 |
| Definicje narzędzi wliczone do wejścia — rozliczanie i protokół pamięci podręcznej | 3/3 | Żądanie kontrolne bez narzędzi już wykazało rozbieżność z natywną liczbą tokenów wejściowych |
| Zgodna liczba tokenów wejściowych przed trafieniem w pamięć podręczną i po nim — rozliczanie i protokół pamięci podręcznej | 3/3 | Po ponownym użyciu tego samego prefiksu zaraportowana liczba tokenów wejściowych nie zgadzała się z liczbą natywną |
| Zgodna liczba tokenów wejściowych w trybie strumieniowym i bez strumieniowania — rozliczanie i protokół pamięci podręcznej | 3/3 | W obu przypadkach zaraportowano 34 tokeny; natywna liczba powinna wynosić 8 |
| Dokładny tekst wyjściowy — strumieniowanie i protokół wiadomości | 1/3 | Na końcu treści dodano jedną kropkę; tekst nie był dokładnie tym, o który proszono |
Te kontrole pominięto w mianowniku; nie są liczone ani jako zaliczone, ani jako niezaliczone.
| Status | Przypadek | Liczba | Przyczyna |
|---|---|---|---|
| Niezaobserwowane | Sekwencje zatrzymujące strumieniowanie | 3 | Po poprzednim kroku tego żądania nie wysłano; brak możliwości oceny |
| Nie dotyczy | Jawny cache_control | 3 | Z góry zarejestrowano jako nieobsługiwane przez ten interfejs |
Przypadki błędu formatu messages i błędu formatu stream_options zakończyły się niepowodzeniem u wszystkich pięciu dostawców: w obu przypadkach zwrócono 400 z pustą treścią odpowiedzi, więc klient nie otrzymuje ustrukturyzowanego objaśnienia błędu. Błąd wspólny dla wszystkich pięciu najprawdopodobniej występuje na poziomie bramy AIHubMix i wymaga osobnego zbadania. Kontrola rozliczania tokenów myślenia również nie powiodła się u wszystkich pięciu, ale z różnych powodów: ByteDance i Fireworks zaraportowały tokeny myślenia po jego wyłączeniu; pozostali trzej nie zwrócili liczby tokenów myślenia.
Porównanie z pozostałymi czterema
P — szybkość odpowiedzi: 84.37
Każde żądanie zawierało około 10,000 tokenów wejściowych i prosiło o około 1,100 tokenów tekstu w treści odpowiedzi. W każdym z trzech okien wykonano 30 żądań przy współbieżności 1 i 30 przy współbieżności 10: łącznie 180 żądań.
| Metryka | Wynik |
|---|---|
| Czas oczekiwania na pierwszy token treści (TTFA) | Mediana 2.12 s przy współbieżności 1; mediana 2.10 s przy współbieżności 10 |
| Szybkość generowania (TPOT) | 3.43 ms/token przy współbieżności 1; 3.41 ms/token przy współbieżności 10 |
| Efektywna przepustowość | 1,250.0 tokenów/s przy współbieżności 10 |
| Prawidłowe żądania | 90/90 przy współbieżności 1; 90/90 przy współbieżności 10 |
| Wyniki składowe | TTFA 48.59, TPOT 100.00, przepustowość 100.00; dla TTFA i TPOT przyjmuje się niższy z dwóch poziomów; wagi 35% / 35% / 30%; wynik szybkości odpowiedzi 82.00 |
| Wynik P | Wynik szybkości odpowiedzi 82.00 z wagą 80%, pamięć podręczna K 93.83 z wagą 20%; łącznie 84.37 |
TPOT jest szacowany na podstawie fragmentów strumieniowanych, a nie mierzony dla każdego tokenu na sprzęcie. Przepustowość to liczba prawidłowych tokenów wyjściowych przy współbieżności 10 podzielona przez czas zegarowy całej partii.
Porównanie z pozostałymi czterema
Wszyscy pięciu dostawcy korzystali z jednego komputera, jednej sieci i jednego konta. Trzy okna zaplanowano kolejno dla poszczególnych dostawców, więc okresy zbierania danych nie pokrywają się w pełni; nie należy przeceniać niewielkich różnic.
K — pamięć podręczna: 93.83
Każda grupa wysyła pięć żądań. Pierwsze zawiera stały prefiks o długości około 8k lub 32k tokenów i zasila pamięć podręczną. Żądania 2–4 zachowują prefiks i zmieniają wyłącznie końcowe pytanie, po 5 s, 30 s i 120 s. Piąte wykorzystuje nowy prefiks jako zimne żądanie kontrolne. Trzy okna i dwie długości, po pięć żądań w grupie, dają 30 żądań. K to liczba tokenów odczytanych z pamięci podręcznej w gorących żądaniach podzielona przez liczbę tokenów, które zgodnie z zasadami powinny nadawać się do ponownego wykorzystania; obie długości mają taką samą wagę. K stanowi 20% wyniku P.
| Prefiks | Okno | Zasilające | +5 s | +30 s | +120 s | Zimne żądanie kontrolne |
|---|---|---|---|---|---|---|
| 8k | Okno 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Okno 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Okno 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Okno 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Okno 2 | 0 | 32,000 | 32,000 | niepowodzenie | 0 |
| 32k | Okno 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Wartości oznaczają tokeny odczytane z pamięci podręcznej, zgodnie z raportem serwera.
Wszystkie dziewięć gorących zapytań 8k trafiło w pamięć podręczną, a każde odczytało 7,936 tokenów. Osiem z dziewięciu gorących zapytań 32k trafiło w pamięć podręczną, a każde odczytało 32,000 tokenów; jedno zapytanie zakończyło się niepowodzeniem. K wynosi 93.83 przy jednakowej wadze obu długości. Zimne zapytania nie odczytały danych z pamięci podręcznej, więc gorące i zimne rozdzielają się wyraźnie. Niepowodzenie dotyczy czwartego zapytania z grupy 32k w oknie 2, które nie zostało ukończone przed upływem limitu 300 s.
W porównaniu z pozostałą czwórką
R — stabilność usługi: 100
300 zapytań obejmuje cztery typy — krótki tekst, długie dane wejściowe, wywołania narzędzi i historię wieloturową — i zostało wykonanych przy współbieżności równej 1 w trzech oknach. Zapytanie liczy się jako udane tylko wtedy, gdy pierwsza próba zwróciła prawidłową, kompletną odpowiedź; poprawność odpowiedzi nie jest sprawdzana i nie ma ponownych prób. Niepowodzenia z sekcji dotyczących jakości odpowiedzi i szybkości są uwzględniane w Q i P, a nie ponownie w R.
| Typ zapytania | Sukces przy pierwszej próbie |
|---|---|
| Krótki tekst | 120/120 |
| Długie dane wejściowe 10k | 90/90 |
| Wywołania narzędzi | 60/60 |
| Historia wieloturowa | 30/30 |
| Łącznie · przedział 95%: 98.78%–100% | 300/300 |
Wszystkie 300 zapytań zwróciły prawidłową, kompletną odpowiedź przy pierwszej próbie. R = 100 opisuje wyłącznie te 300 dedykowanych zapytań; nie oznacza, że w całym łańcuchu nie było niepowodzeń. Dolna granica przedziału 95% wynosi 98.78%: 300 udanych zapytań pozwala jedynie stwierdzić, że prawdopodobny odsetek niepowodzeń jest niższy niż 1.22%.
W porównaniu z pozostałą czwórką
R obejmuje tylko te 300 dedykowanych zapytań; niepowodzenia z sekcji dotyczących jakości odpowiedzi i szybkości są odnotowywane w Q i P, a nie ponownie wliczane do R.
| Dostawca | Sukces przy pierwszej próbie | Przedział 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Oficjalny DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Czy reasoning_effort=none rzeczywiście nie wyłączyło myślenia?
Tak. We wszystkich trzech oknach zapytania z reasoning_effort=none nadal zwracały treść rozumowania, więc test zakończył się niepowodzeniem w 3/3 przypadków. W zapytaniach dotyczących jakości odpowiedzi, szybkości, pamięci podręcznej i stabilności użyto zamiast tego natywnego przełącznika thinking.type=disabled. W zestawie testów funkcji celowo pozostawiono reasoning_effort=none, aby sprawdzić, czy parametr zadziałał.
Dokładność BFCL wynosi 85.20%. Dlaczego Q to 42.05?
Q łączy wyniki trzech zestawów testowych o bardzo różnym poziomie trudności. BFCL dał 1,278 poprawnych odpowiedzi z 1,500, HLE — 382 z 2,490, a AA-LCR — 123 z 250. Łącznie poprawnych było 1,783 z 4,240 ocenianych instancji pytań: 42.05%. Wynik HLE na poziomie 15.34% obniża łączny rezultat.
Czy 35 niepowodzeń usługi w Q uwzględniono w wyniku?
Tak. Niepowodzenia zapytań i ucięte dane wyjściowe pozostają w mianowniku i są liczone jako odpowiedzi błędne. Siedem odpowiedzi HLE zostało uciętych na poziomie max_tokens; 28 zapytań AA-LCR zakończyło się niepowodzeniem — wszystkie w oknie 1.
Dlaczego rozliczanie tokenów wejściowych ma znaczenie?
Ponieważ rozliczanie powinno odpowiadać natywnej liczbie tokenów modelu. Dane wejściowe o długości 10k tokenów zostały zgłoszone jako 10,026 tokenów (natywnie 10,000), a dane wejściowe o długości 8 tokenów — jako 34. Zgodność była już zaburzona w zapytaniu kontrolnym bez narzędzi, a zarówno strumieniowanie, jak i tryb bez strumieniowania zgłaszały 34. Wszystkie 3/3 testy rozliczania tokenów zakończyły się niepowodzeniem.
Wynik pamięci podręcznej dla 32k oznaczał brak trafienia czy niepowodzenie?
Niepowodzenie. Osiem z dziewięciu gorących zapytań 32k trafiło w pamięć podręczną i odczytało 32,000 tokenów. Jedno nietrafienie dotyczy czwartego zapytania w oknie 2, które nie zostało ukończone przed upływem limitu 300 s. Grupa 8k trafiła w pamięć podręczną w 9/9 przypadkach, odczytując 7,936 tokenów.
Czy jakość odpowiedzi ByteDance różni się od jakości w oficjalnym kanale?
Nie. Łączna dokładność jest niższa od wyniku oficjalnego kanału o 0.40 punktu, a przedział 95% wynosi od −1.46 do +0.66. Przedział obejmuje 0, więc wyników tych nie da się od siebie odróżnić. Opisuje to wyłącznie tę serię testów i nie stanowi rankingu.
Czytaj dalej: seria DeepSeek V4.1 Flash
- Punktem odniesienia dla Q w tym artykule jest oficjalny kanał; jego własny test, obejmujący 15 nieprawidłowych prób przy współbieżności równej 1, opisano w artykule DeepSeek V4.1 Flash w oficjalnym kanale: F 94.00, 15 nieprawidłowych prób.
- Baidu jest jedynym dostawcą, którego przedział Q znajduje się poniżej wyniku oficjalnego kanału; niepowodzenia kanału, które do tego doprowadziły, opisano w artykule DeepSeek V4.1 Flash w Baidu: brak dostępnego kanału osiągającego Q i P.
- Wyniki pamięci podręcznej Alibaba Cloud można zestawić z wartością 93.83 podaną tutaj: DeepSeek V4.1 Flash w Alibaba Cloud: 1.34s do pierwszego tokenu, 99.37 dla pamięci podręcznej.
- Fireworks wykazuje te same problemy z rozumowaniem i rozliczaniem tokenów co tutaj, a ponadto zwraca puste odpowiedzi po zatrzymaniu: DeepSeek V4.1 Flash w Fireworks: puste odpowiedzi po zatrzymaniu, 3/9 trafień w pamięć podręczną.


