Anthropic heeft Claude Fable 5.2 uitgebracht op 9 november 2026. Google heeft Gemini 4 Carbon een dag later algemeen beschikbaar gemaakt. De benchmarktabel bij de lancering van Anthropic bevat een kolom voor Carbon, wat dit een nuttige vergelijking maakt voor dezelfde coding-workload met een lange tijdshorizon.
Beide modellen zijn bedoeld voor dezelfde taak: agentic coding met een lange tijdshorizon. De agent leest een repository, bewerkt meerdere bestanden, voert opdrachten uit, leest testuitvoer en gaat 15 tot 45 minuten door zonder tussenkomst van een mens. Dat is de taak die hier wordt beoordeeld. Chat, autocomplete en korte scripts zijn een andere test.
Het korte antwoord
Fable 5.2 staat bovenaan in de vermelde benchmarks voor moeilijke codeertaken en werkt sneller bij gelijke inspanning: het bezet de eerste drie AA-posities, vóór Carbon High op #4. Carbon scoort hoger op de vermelde rijen voor Terminal-Bench 4.0 en AutomationBench-AA en is per taak goedkoper bij High-inspanning, totdat Google's introductieprijs op 30 november afloopt. Bij Medium is Fable goedkoper en veel sneller, terwijl Carbon hoger scoort op de AA-index.
Kies Fable voor complexe codeerredeneringen en Carbon voor terminaluitvoering en automatisering; controleer vóór gebruik van een van beide de limieten voor invoer, gegevensbewaring en uitvoer.
Wat één testopstelling laat zien
Artificial Analysis test elk model met dezelfde testopstelling en taken; de pagina's voor Carbon en Fable bevatten de resultaten per evaluatie. De cijfers komen uit de momentopname van 11 november 2026; AA gebruikt de standaardprijzen, niet de introductiekorting van Google.
| Model | AA-index | $/taak | Min/taak | Eerste token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Opmerking: AA Intelligence Index en kosten per taak tegen standaardprijzen, momentopname 2026-11-11T05:23Z. Fable Max, Xhigh en High staan op #1 tot en met #3; Carbon High staat op #4; Opus 5.5 Max staat op #5; Carbon Medium staat op #6. Eerste token is de tijd tot het eerste antwoordtoken.
Bij High-inspanning scoort Fable 1.79 punten hoger, kost het per taak 17.0% meer ($9.08 tegenover $7.76), is het klaar in 17.3 minuten in plaats van 25.6 en levert het zijn eerste token na 30.4 seconden in plaats van 67.1. Max kost $26.54 per taak, 3.4 keer zoveel als Carbon High, en laat 233.9 seconden op het eerste token wachten.
Bij Medium verandert de volgorde: Fable scoort 56.41 tegenover 58.26 voor Carbon, dus 1.85 punten lager, maar kost $3.80 tegenover $6.59 en doet er 7.8 minuten over tegenover 23.3. De lagere tokenprijs van Carbon maakt het hier niet goedkoper per taak; het verbruikt meer tokens.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Niet-hallucinerend % | 88.58 | 42.02 | 40.73 | 49.66 |
| Nauwkeurigheid % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Opmerking: Artificial Analysis, dezelfde testopstelling en momentopname. Niet-hallucineren is het aandeel Omniscience-antwoorden zonder verzonnen beweringen; nauwkeurigheid is een afzonderlijke score. Hoger is beter op elke rij. Fable Xhigh is weggelaten om de tabel leesbaar te houden; de score voor FrontierCode 2.0 is 47.58.
Welk model leidt bij elke test met High-inspanning? Het ondertekende verschil hieronder is Carbon min Fable; zo wordt de richting duidelijk, terwijl de tabel hierboven de absolute scores toont.
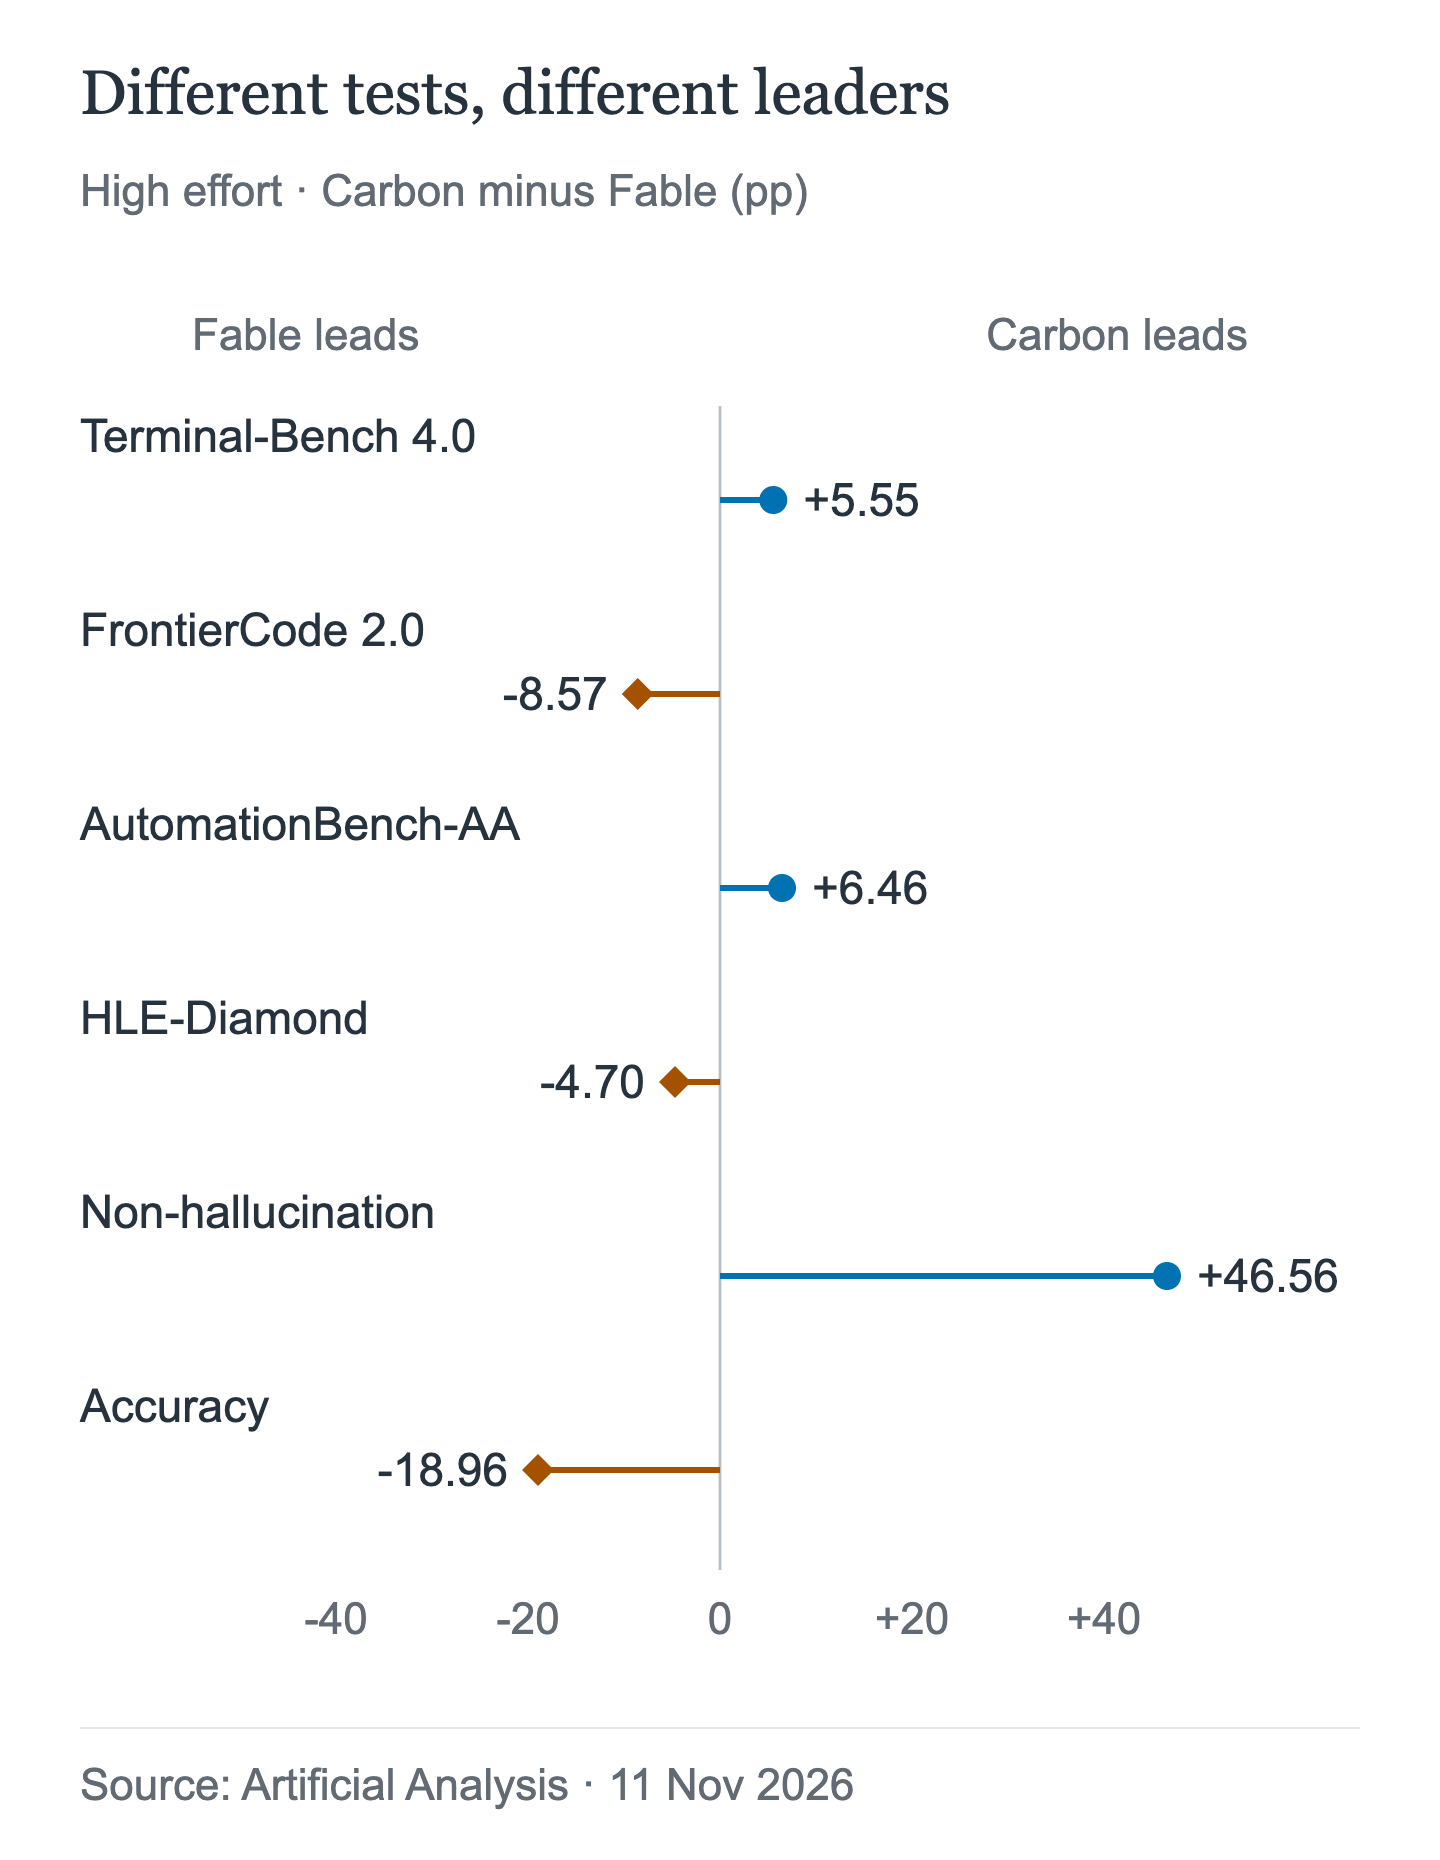
Dit zijn verschillen in procentpunten op onafhankelijke tests, geen gecombineerde kwaliteitsscore. Een groter verschil op één benchmark betekent niet dat de algemene vaardigheden sterker zijn verbeterd. Niet-hallucineren en nauwkeurigheid meten met name verschillende uitkomsten.
Fable verslaat FrontierCode 2.0 bij High met 8.57 punten en HLE-Diamond met 4.7; Briefcase Elo is 1677.4 tegenover 1610.6. FrontierCode komt het dichtst in de buurt van complexe codewijzigingen in meerdere bestanden. Carbon verslaat Terminal-Bench 4.0 met 5.55 punten en AutomationBench met 6.46; deze benchmarks belonen uitvoering via de opdrachtregel, herstelvermogen en automatisering.
Het verschil in niet-hallucineren is het grootste in de tabel: 88.58% voor Carbon tegenover 42.02% voor Fable bij High. Nauwkeurigheid valt juist de andere kant op: 58.27% tegenover 77.23%. Carbon verzint minder snel iets, maar geeft ook minder vaak het juiste antwoord. Voor een agent die geen API mag verzinnen, kan dat de doorslag geven; voor een agent die het juiste antwoord moet geven, is de nauwkeurigheid van Fable een betere graadmeter.
Meer inspanning is niet altijd beter: Fable Max scoort met 48.76 iets lager op FrontierCode dan High met 49.13, en de score voor Terminal-Bench blijft 59.6.
Anthropic's eigen tabel
De lanceringspagina van Anthropic bevat een vergelijkingstabel met modellen van andere aanbieders, inclusief Carbon. De instellingen verschillen van die van AA: Fable wordt getest op Xhigh, de hoogste gerapporteerde inspanning, en Carbon op Medium. Vergelijk deze tabel alleen met zichzelf.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Opmerking: cijfers gerapporteerd door Anthropic zelf. Fable op Xhigh, de hoogste beschikbare inspanning; Carbon op Medium. De schaal van Anthropic voor AutomationBench verschilt van die van AA (51.4/53.9 tegenover 71.36/77.82), dus vergelijk binnen deze tabel. De 41.1 van Carbon voor FrontierCode is een run op Medium; de 40.56 van AA is High op een andere testopstelling.
De richting komt overeen met die van AA: Fable loopt voor op FrontierCode, FrontierSWE, OSWorld en TB-Science; Carbon loopt 2.5 punten voor op AutomationBench. Dat verschil is kleiner dan de 6.5 van AA, maar de richting is hetzelfde. De tabel ondersteunt de conclusie 'Carbon is competitief op het gebied van automatisering', niet 'Carbon is het betere model voor complexe codeertaken'.
De eigen aanbeveling van Anthropic maakt de bewering 'Fable is de upgrade' minder eenduidig: 'Voor de meeste codeer- en kennistaken raden we gebruikers aan te beginnen met Claude Opus 5.5.' Bij High-inspanning scoort Fable volgens Anthropic ongeveer even goed als de beste score van Opus 5.5 (45.3% tegenover 45.5%), voor ongeveer de helft van de kosten per taak.
Wat de tokens kosten
| Model | Invoer | Uitvoer | Cache lezen |
|---|---|---|---|
| Carbon, t/m 30 nov | $2 | $10 | $0.10 |
| Carbon, vanaf 1 dec | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Opmerking: USD per 1M tokens, officiële prijzen. Cache-schrijven voor Fable: $10 (5 min) of $16 (1 uur); Batch 50% korting. Het cachetarief van Carbon geldt voor lezen; het officiële cacheleestarief van Opus 5.5 is $0.20.
De tokenprijs van Fable is twee keer het standaardtarief van Carbon en vier keer het introductietarief. De verhouding is eenvoudig; de kosten per taak niet. AA heeft voor Carbon High tegen $4/$20 $7.76 per taak gemeten, tegenover $9.08 voor Fable High: een verschil van 17.0%. Bij Google's tarief van $2/$10 kost hetzelfde gebruik ongeveer $3.88, een berekende schatting. Tot en met 30 november kost Fable High per taak ongeveer 2.3 keer zoveel; vanaf 1 december loopt het verschil weer op tot 17.0%.
Tegen standaardprijzen kost Fable Medium $3.80 tegenover $6.59 voor Carbon, 42% minder ondanks een twee keer zo hoge tokenprijs. Carbon doet er 23.3 minuten over en verbruikt meer tokens; Fable doet er 7.8 minuten over. Tegen het introductietarief kost Carbon Medium ongeveer $3.30, op dezelfde manier berekend, bijna evenveel als Fable; dat voordeel verdwijnt op 1 december.
Max kost per taak 3.4 keer zoveel als Carbon High ($26.54) en doet er 45.2 minuten over. Meer uitgeven levert niet automatisch een betere codeeragent op: de FrontierCode-score van Max is iets lager dan die van High.
AIHubMix biedt Carbon aan tegen Google's introductieprijs. De Fable-bedragen hier zijn de officiële tarieven van Anthropic.
Gedragsverschillen die bepalend zijn voor implementaties
| Kenmerk | Carbon | Fable 5.2 |
|---|---|---|
| Max. uitvoer | 65,536; native ≤1,048,576−input* | 128,000 |
| Context | 1,048,576 (native van Google) | 1M |
| Denkmodus | low / medium / high; standaard medium | adaptief; standaard high |
| Tools afdwingen | auto gedocumenteerd* | any / tool retourneert 400 |
| Sampling | genegeerd; verwijderen | sommige waarden retourneren 400 |
| Bewaartermijn | niet vermeld als limiet | 30 dagen; geen ZDR |
| Invoer | tekst op AIHubMix | tekst, afbeelding, PDF† |
| Cutoff | maart 2026 | juni 2026 |
Opmerking: *De hogere limieten van Carbon zijn mogelijkheden voor lange decodering die eigen zijn aan Google; AIHubMix documenteert momenteel alleen tekstinvoer en Chat Completions, dus ondersteuning via de gateway is niet bevestigd. †De invoermodaliteiten van Fable zijn afkomstig uit de modelindex van AIHubMix. *AIHubMix documenteert tool_choice="auto", maar ondersteuning specifiek voor Carbon is niet bevestigd. De gedocumenteerde uitvoerlimiet van Fable is 128,000 tokens. ZDR staat voor zero data retention.
Het afdwingen van toolgebruik is een harde blokkade voor Fable: 'Het afdwingen van toolgebruik (de typen tool_choice any en tool) retourneert een 400-fout.' Een agent die elke beurt een specifieke tool moet aanroepen, kan Fable niet ongewijzigd gebruiken. Google's Carbon-gids raadt opeenvolgende tool-uitvoeringsbeurten aan; AIHubMix documenteert tool_choice="auto" in de Gemini-gids, maar ondersteuning van tools voor Carbon via de gateway is nog niet bevestigd.
De bewaartermijn is voor Fable een beleidsmatige blokkade: in het overzicht staat dat het 'gegevens 30 dagen moet bewaren en niet beschikbaar is met zero data retention, tenzij Anthropic daarvoor uitdrukkelijk toestemming geeft'. In de hier geraadpleegde documentatie van Carbon staat geen vergelijkbare beperking; dat is geen garantie. Gereguleerde teams moeten beide beleidsregels bevestigen vóór implementatie.
De standaardlimiet van 65,536 tokens van Carbon is voldoende voor de meeste bewerkingen; het genereren van complete bestanden kan die limiet bereiken. De native achtergrondmodus van Google kan tot 1,048,576 minus de invoer aan, brengt kosten voor segmentovergangen in rekening en kan incomplete retourneren met lege tekst, terwijl er wel kosten worden berekend. AIHubMix heeft deze mogelijkheid niet gedocumenteerd. Fable levert maximaal 128,000 tokens in één antwoord.
Bij geen van beide modellen kan de denkmodus worden uitgeschakeld. Carbon biedt low, medium en high, staat standaard op medium en negeert samplingparameters. Fable's 'adaptive thinking is altijd ingeschakeld en kan niet worden uitgeschakeld', staat standaard op high en retourneert voor sommige samplingwaarden 400.
Google heeft Carbon vóór de algemene beschikbaarheid beschikbaar gesteld aan verdedigers via het Fairwind-programma. De classificatoren van Fable blokkeren verzoeken voor pentests en exploits en schakelen voor cyber- en biologietaken over op andere modellen. Bij beveiligingstests is het weigeringsgedrag belangrijker dan een benchmarkscore.
Opus 5.5 als referentiemodel
Opus 5.5 is niet de tegenstander, maar wel Anthropic's eigen referentie. Bij $4/$20 scoort het 59.11 op AA, kost het $10.04 per taak, doet het er 25.0 minuten over en wacht het 356.4 seconden op het eerste token: het langst in de tabel (de AA-rij is voor Max-inspanning; de standaardinstelling is Medium). Het wint Briefcase Elo met 1800.6, maar scoort lager dan Fable High op FrontierCode en lager dan Carbon High op Terminal-Bench. Toch raadt Anthropic aan om voor de meeste codeertaken met Opus 5.5 te beginnen.
Wie kiest welk model?
Kies Fable 5.2 wanneer complexe codewijzigingen centraal staan en je de beste gemeten resultaten voor FrontierCode en HLE wilt. Op Medium is het goedkoper en sneller: $3.80 en 7.8 minuten tegenover $6.59 en 23.3 voor Carbon, terwijl Carbon hoger scoort op de AA-index. Kies het voor afbeeldingsinvoer, een cutoff van juni 2026, of als een bewaartermijn van 30 dagen en het ontbreken van geforceerde tool-aanroepen geen probleem zijn.
Kies Carbon wanneer terminalwerk de boventoon voert: test-fixcycli, shellautomatisering en bewerkingen in meerdere stappen. De scores zijn hoger op de vermelde rijen van Terminal-Bench 4.0 en AutomationBench-AA, en tot en met 30 november is het model goedkoper bij High effort. De Google-native context- en languitvoerlimieten zijn niet bevestigd via AIHubMix; gebruik het uitsluitend voor tekst met tool_choice="auto", en pas nadat je hebt bevestigd dat Carbon tools ondersteunt. De score voor niet-hallucineren is hoger, maar de nauwkeurigheid is lager.
Kies Opus 5.5 als je Anthropic's aanbevolen startpunt en een gebalanceerd profiel wilt; accepteer de trage eerste token bij Max effort.
Kies geen van beide als interactieve latentie belangrijk is: de eerste tokens bij High effort verschijnen na 30.4 seconden bij Fable en 67.1 seconden bij Carbon, en de 23.2 seconden van Carbon Medium liggen nog steeds ver van chatsnelheid.
Gebruik beide via AIHubMix
AIHubMix biedt beide modellen aan met één sleutel en een gedeeld chat-completions-eindpunt. De ID van Carbon is gemini-4-carbon; de modelpagina documenteert chat completions, tekstinvoer en de introductieprijs van Google. De ID van Fable 5.2 is claude-fable-5-2; AIHubMix vermeldt Chat Completions, Responses en Anthropic Messages, met een contextvenster van 1M en een maximale uitvoer van 128K. Het gedocumenteerde aanbod van Carbon is beperkter: chat completions, niet de native Gemini API. De gateway probeert ook de volgende beste aanbieder, waardoor het gedrag kan afwijken van een implementatie met één aanbieder.
De snelstartgids behandelt authenticatie en de basis-URL. Een rooktest kan nagaan of beide ID's met dezelfde sleutel beschikbaar zijn; voor dit concept is geen live test uitgevoerd:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Dit controleert de routering, niet de mogelijkheden: geen tools en geen lange uitvoer. Voer voor een echte vergelijking hetzelfde agenttracé uit met beide ID's en registreer de taakduur, het tokengebruik en de fouten. De vergelijkingspagina zet context, protocollen en prijzen naast elkaar.
Veelgestelde vragen
Is Gemini 4 Carbon beter dan Fable 5.2 voor agentic coding?
Geen van beide wint op elk onderdeel van het werk. Fable 5.2 scoort beter op FrontierCode 2.0 en de totaalscore bij High effort; Carbon scoort beter op Terminal-Bench 4.0 en AutomationBench. Kies op basis van de taken die de agent daadwerkelijk uitvoert.
Waarom kost Fable 5.2 vier keer zoveel als Carbon?
Volgens de officiële tarieven kost Fable $8/$40 per miljoen tokens, tegenover de introductieprijs van $2/$10 voor Carbon: vier keer zoveel voor zowel invoer als uitvoer. Vergeleken met Carbon's standaardtarief van $4/$20 vanaf 1 december is dat twee keer zoveel.
Kost Fable 5.2 bij Medium echt minder per taak?
Bij de standaardprijzen wel: $3.80 tegenover $6.59 voor Carbon Medium, en 7.8 minuten tegenover 23.3. De introductieprijs per token van Carbon verkleint het verschil; de vergelijking op basis van standaardprijzen blijft langer geldig.
Kan Fable 5.2 een tool-aanroep afdwingen?
Nee. Anthropic documenteert dat de waarden any en tool voor tool_choice een 400-fout opleveren. Agents die een afgedwongen aanroep nodig hebben, moeten een andere lus of een ander model gebruiken.
Is de kans op hallucinaties bij Carbon kleiner dan bij Fable 5.2?
Volgens de maatstaf voor niet-hallucineren van Omniscience van AA wel: 88.58% tegenover 42.02% bij High. De nauwkeurigheid is lager, 58.27% tegenover 77.23%, dus de kans dat het juiste antwoord wordt gegeven is ook kleiner.
Kun je beide modellen via AIHubMix met één sleutel gebruiken?
Ja. Gebruik gemini-4-carbon en claude-fable-5-2 met dezelfde sleutel en basis-URL. AIHubMix documenteert chat completions voor Carbon, en chat completions, Responses en Messages voor Fable.
Lees verder: de Gemini 4 Carbon-serie
- Voordat je een concurrent kiest, beantwoord eerst de vraag over de verwante modellen: Gemini 4 Carbon vs Argon: Zelfde prijs, wanneer is Carbon de moeite waard?
- Zodra Carbon onderdeel is van de workflow, zijn de eerste 400-fouten en time-outs meestal het gevolg van de configuratie, niet van het model: Gemini 4 Carbon API-migratie: 400-fouten, time-outs en uitvoerlimieten
Bronnen
- Gemini 4 Carbon nu beschikbaar — Google, 10 november 2026.
- Claude Fable 5.2 — Anthropic, 9 november 2026.
- Overzicht van Claude Fable 5.2 — Anthropic-documentatie.
- Gemini 4 Carbon en Claude Fable 5.2 — Artificial Analysis, momentopname van 11 november 2026.
- Gemini 4 Carbon op AIHubMix — modelpagina en prijzen.