
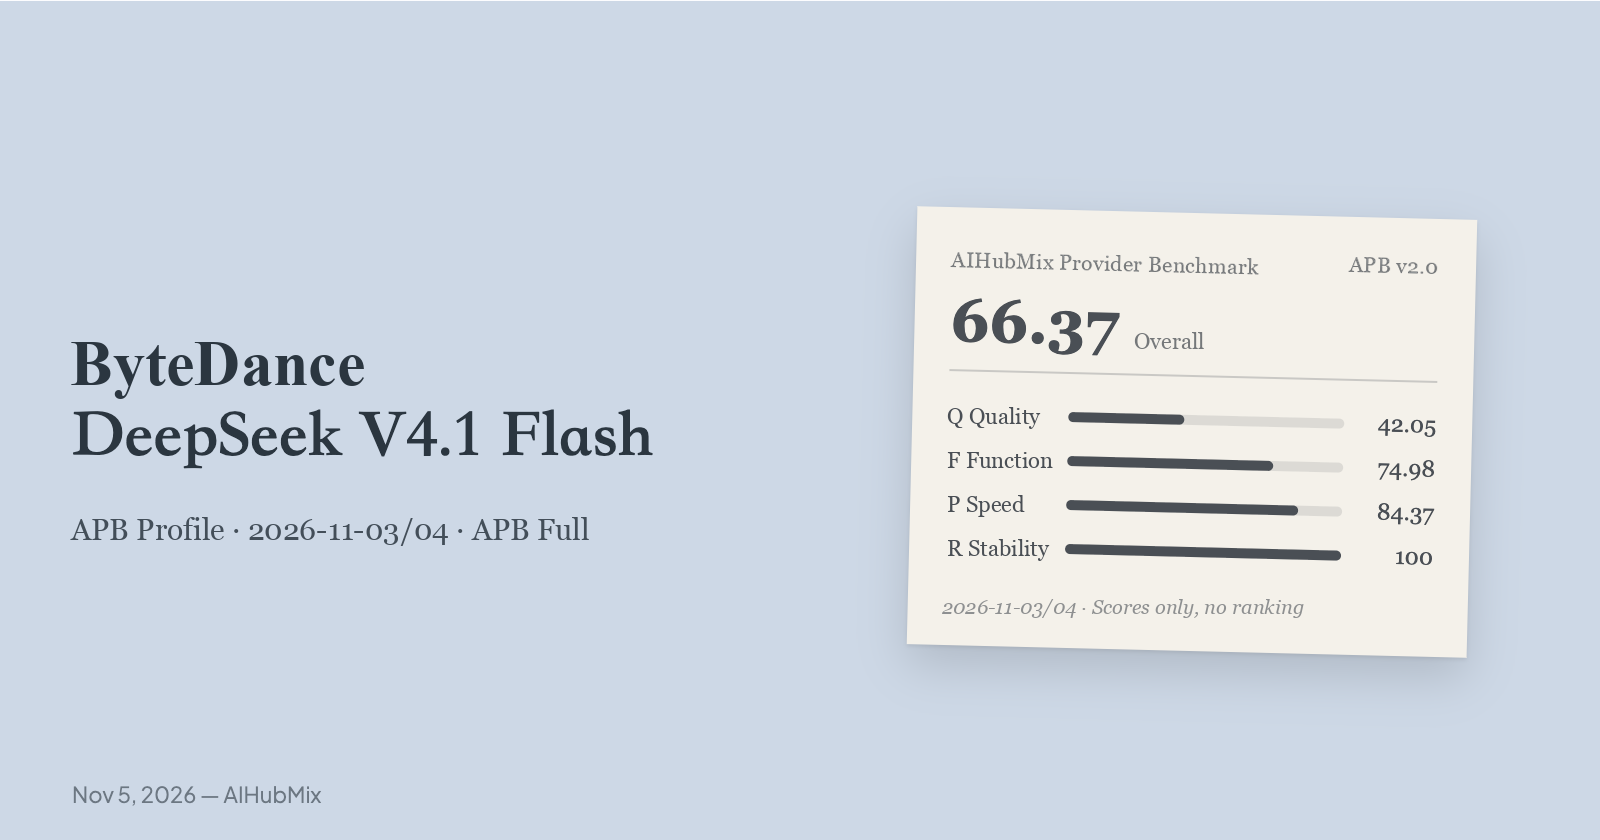
Op 2026-11-03/04 is DeepSeek V4.1 Flash 1017 getest bij vijf aanbieders via AIHubMix met de volledige APB-suite: elke keer dezelfde vragen, parameters en aanvraagscripts. Dit APB-profiel behandelt uitsluitend de ByteDance-run, onderdeel voor onderdeel.
De onderstaande cijfers zijn scores, geen rangschikking of aanbeveling van een aanbieder. Eerst komen Q, F, P, K en R; de totaalscore is een samenvattende index, geen certificering, en heeft geen betrouwbaarheidsinterval. De scoringsregels zijn vastgelegd in AIHubMix Provider Benchmark Standard v2.0.
Scores bij vijf aanbieders
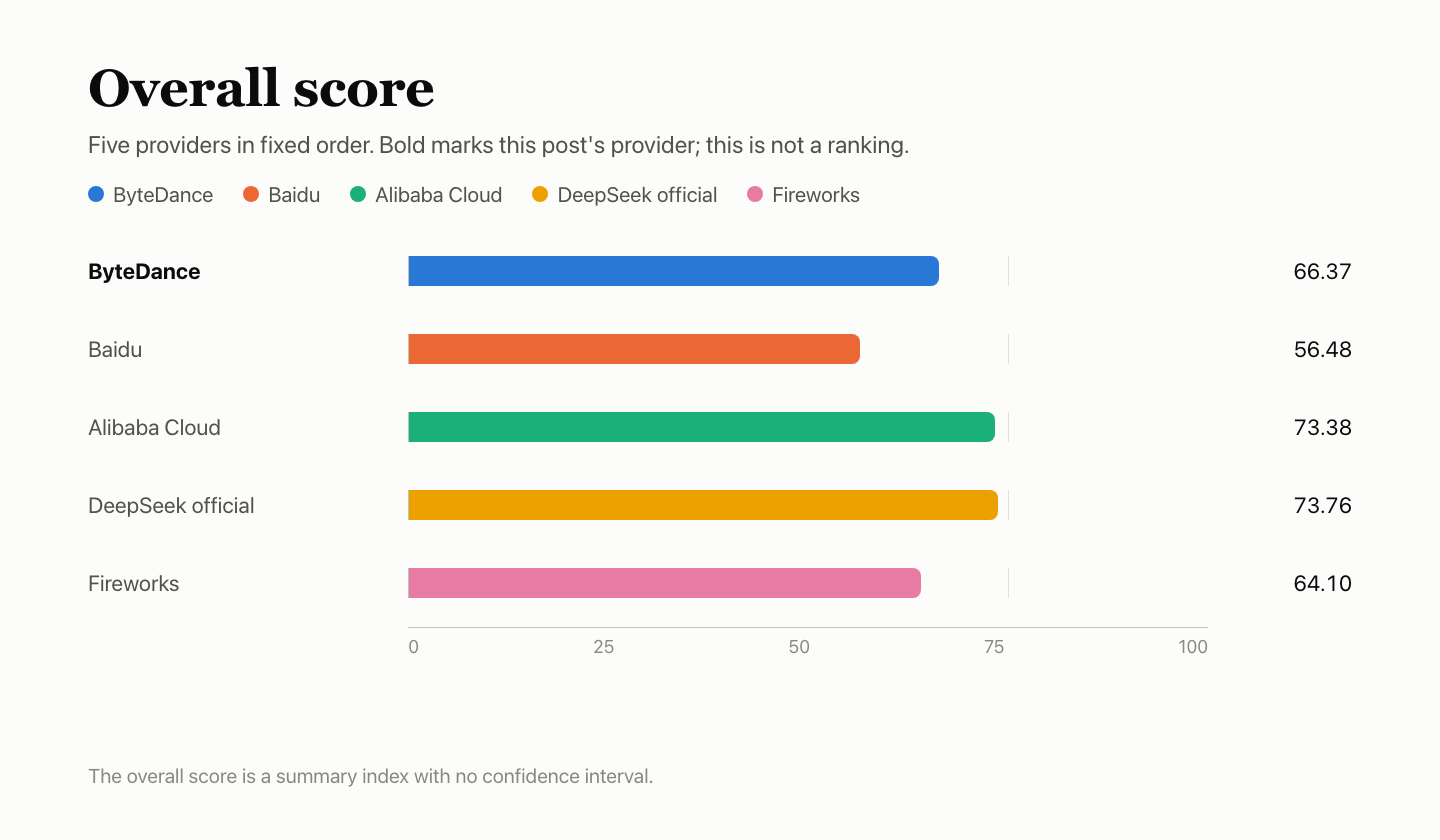
Vetgedrukt is de aanbieder van dit artikel. De aanbieders staan in een vaste volgorde, niet in een rangschikking. K is een deelscore van P en vertegenwoordigt 20% daarvan. De totaalscore is een samenvattende index zonder betrouwbaarheidsinterval. DeepSeek official channel en Alibaba Cloud verschillen 0.37 en zijn niet van elkaar te onderscheiden.
In één oogopslag
- Q 42.05. BFCL 85.20%, HLE 15.34%, AA-LCR 49.20%. Het verschil met het officiële kanaal is −0.40 procentpunt, met een 95%-interval van −1.46 tot +0.66: niet van elkaar te onderscheiden. Bij AA-LCR mislukten 28 aanvragen, allemaal in venster 1; die telden als fout.
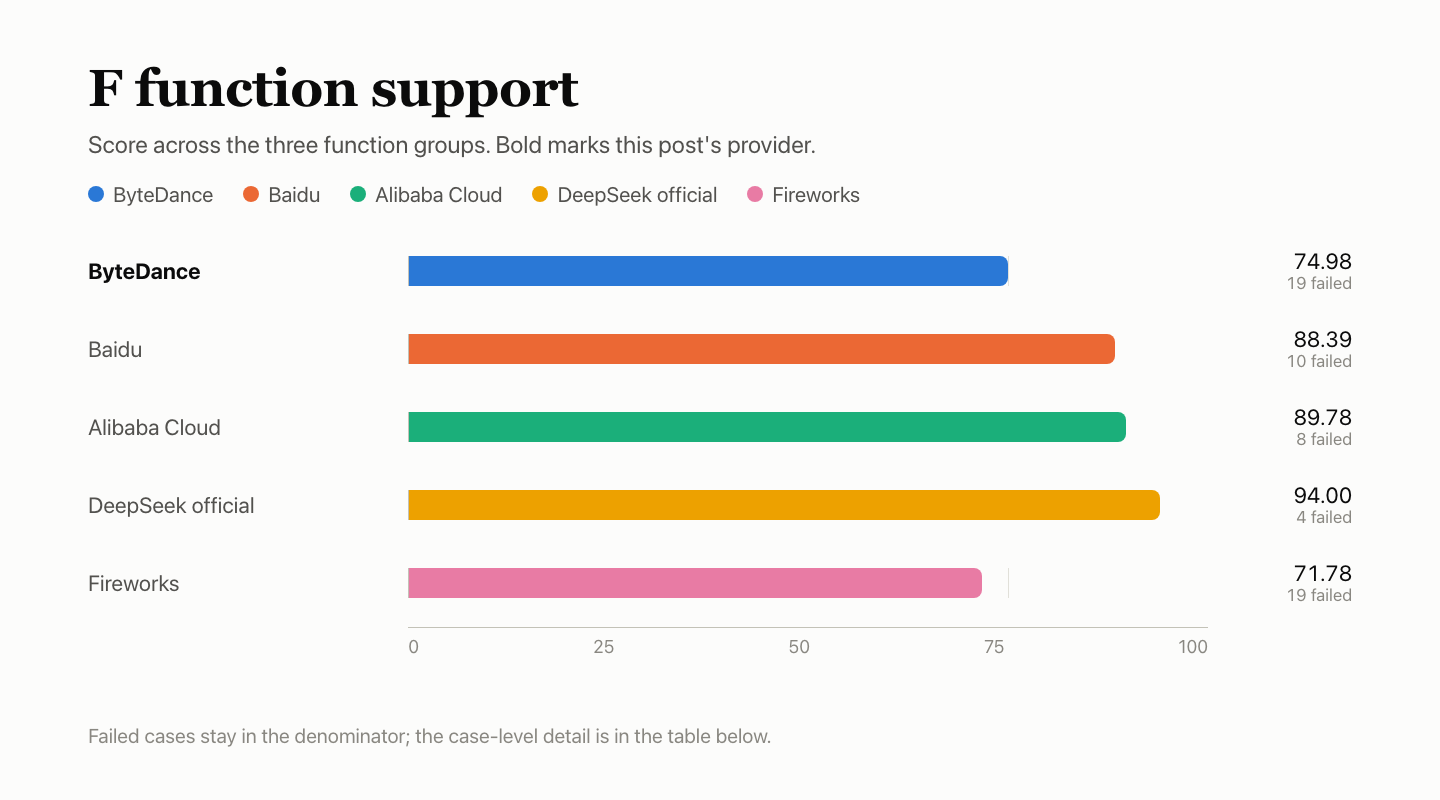
- F 74.98. 124 van de 174 meegetelde controles geslaagd.
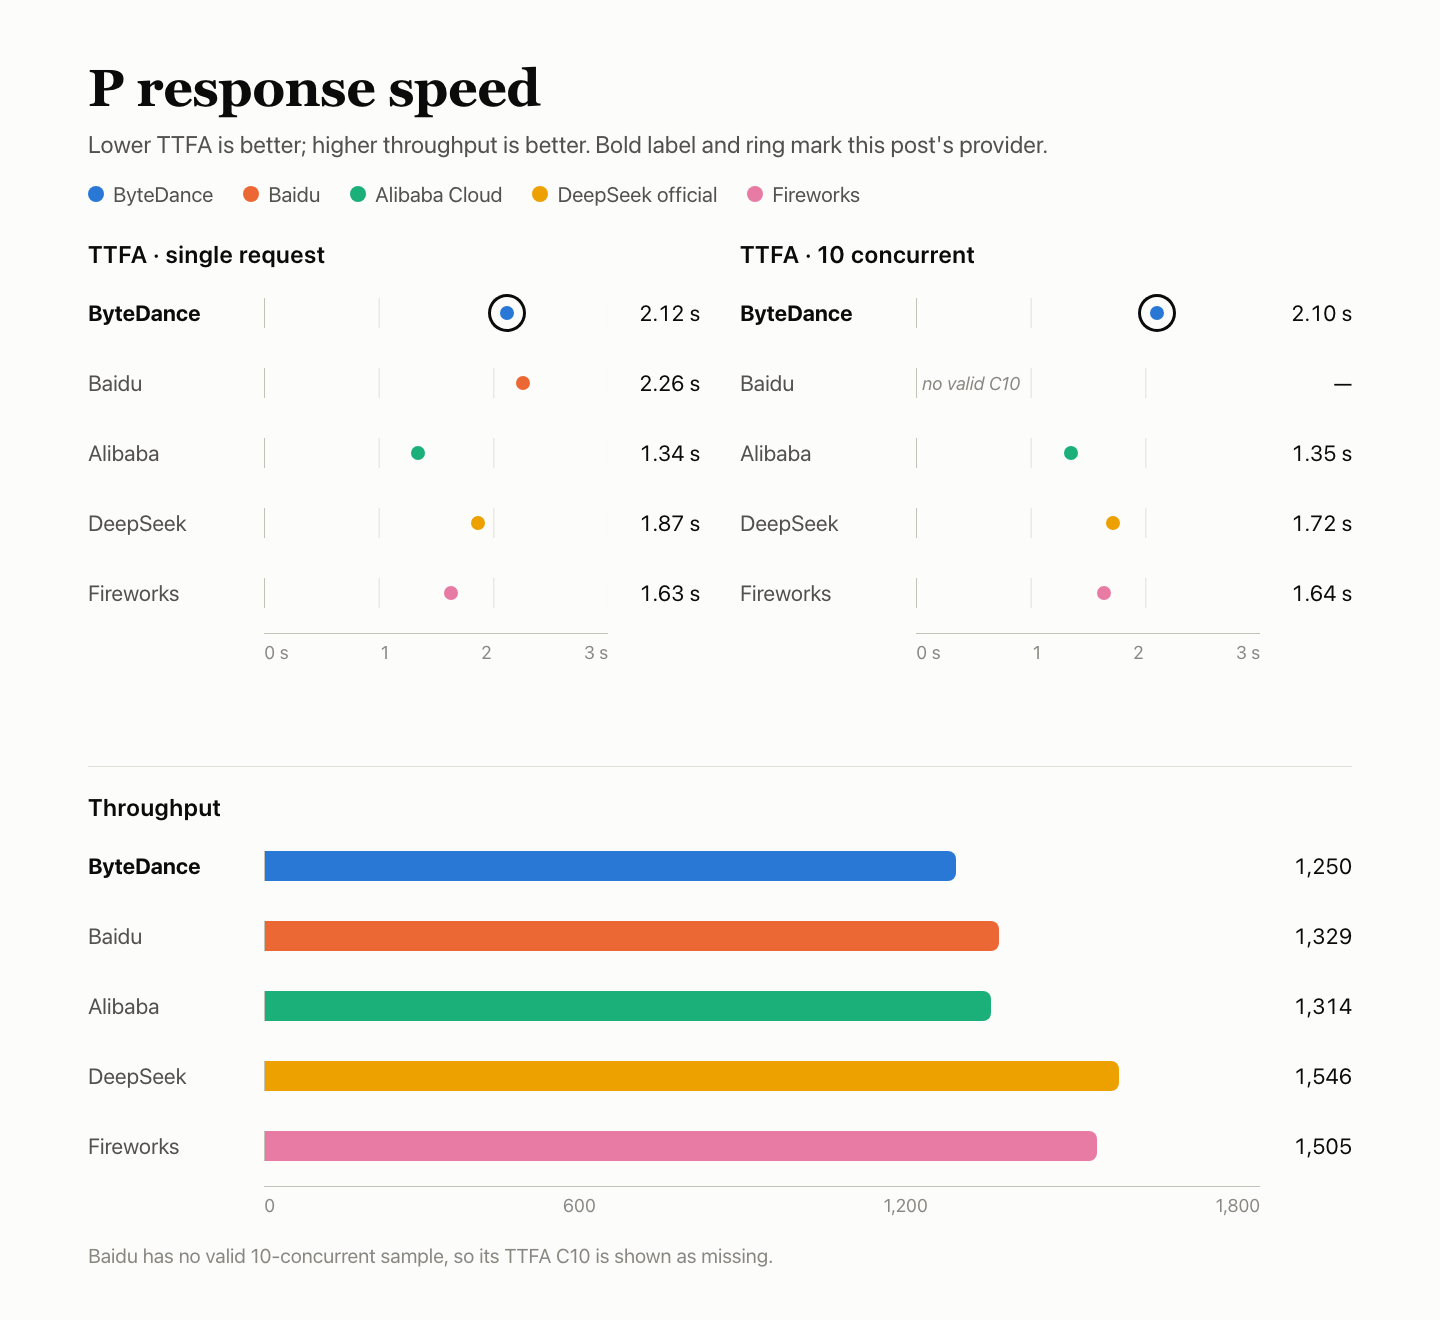
reasoning_effort=noneschakelt het denken niet uit. Een invoer van 10k tokens werd gerapporteerd als 10,026 tokens (native telling: 10,000); een invoer van 8 tokens werd gerapporteerd als 34. - P 84.37. Eerste bodytoken: mediaan 2.12 s bij gelijktijdigheid 1 en 2.10 s bij gelijktijdigheid 10; TPOT 3.43 ms/token; alle 180 snelheidsaanvragen waren geldig.
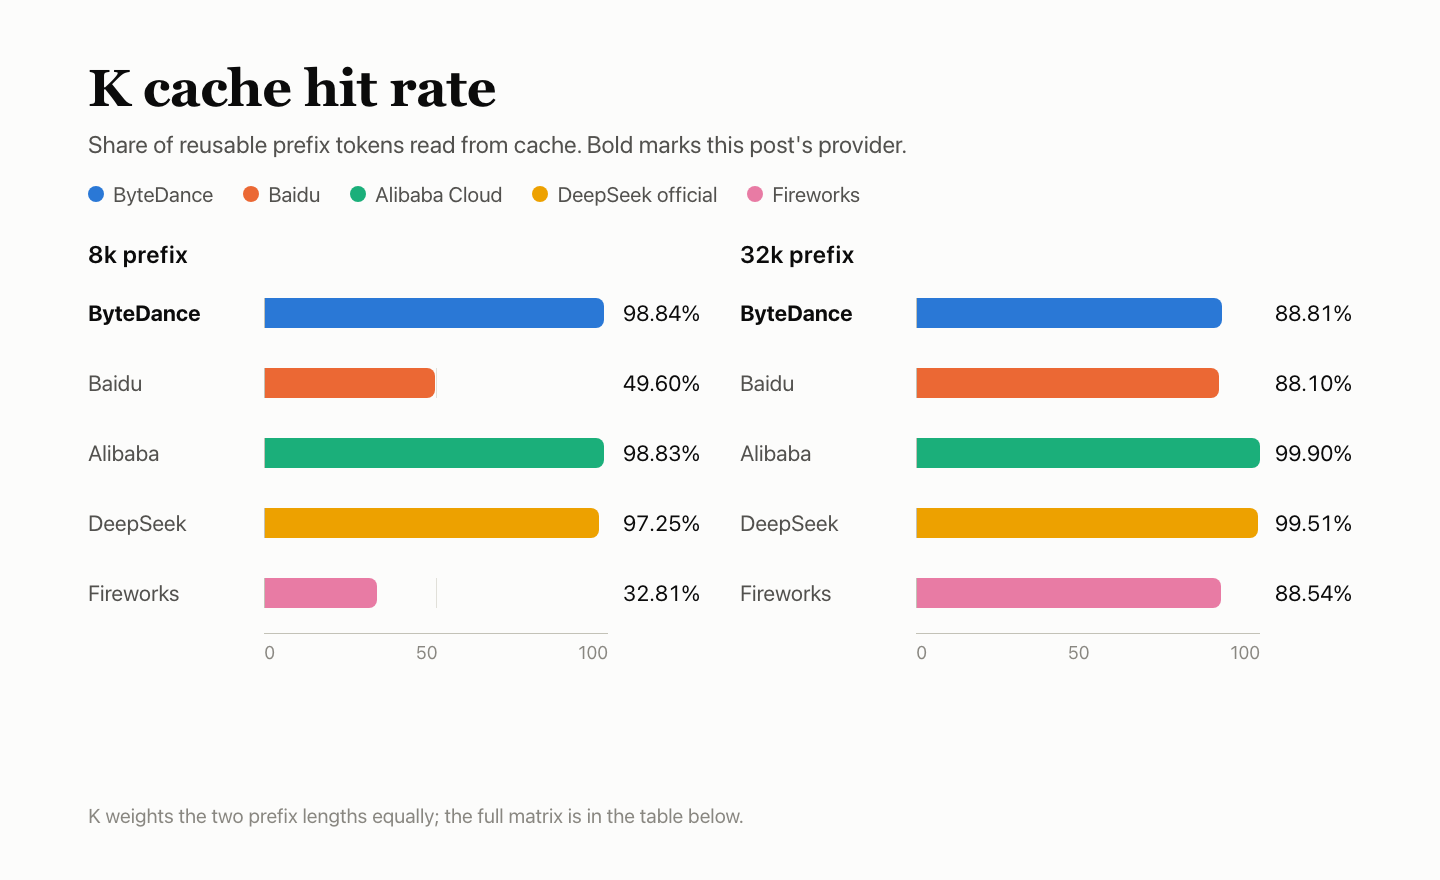
- K 93.83. Bij 8k haalden warme aanvragen 9/9; bij 32k waren er 8 hits en werd één aanvraag niet voltooid binnen de deadline van 300 s.
- R 100. Alle 300 specifieke aanvragen slaagden bij de eerste poging.
Testopstelling
| Onderdeel | Details |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| Aangevraagd model-ID | doubao-deepseek-v4.1-flash-1017 |
| Geretourneerde modelnaam | deepseek-v4-1-flash-261017 |
| Toegangsroute | Via AIHubMix met een providerspecifiek model-ID, niet rechtstreeks verbonden met het account van de aanbieder |
| Parameters | Niet-denkmodus, temperatuur 1.0, max_tokens 16,384, time-out 300 s, geen automatische nieuwe pogingen |
| Denken uitgeschakeld | Aanvragen voor antwoordkwaliteit, snelheid, cache en stabiliteit gebruikten native thinking.type=disabled (bij deze aanbieder schakelde reasoning_effort=none het denken niet uit); bij functiegevallen bleef reasoning_effort=none behouden om te controleren of de parameter effect heeft |
| Tijd | 2026-11-03 18:07 – 11-04 16:33 UTC+8; vijf aanbieders deelden één Mac mini, één netwerk en één account |
| Steekproeven | Antwoordkwaliteit 4,250 vraaginstanties (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); functies 60 gevallen × 3 vensters; snelheid 90 bij gelijktijdigheid 1 en 90 bij gelijktijdigheid 10; stabiliteit 300; cache 30 (drie groepen van elk 8k- en 32k-prefixen) |
Voor aanvragen is de AIHubMix-route quick start gebruikt met een providerspecifiek ID; de parameters volgen de API-documentatie van DeepSeek. Andere provider-ID's staan op de modellenpagina.
Q — antwoordkwaliteit: 42.05
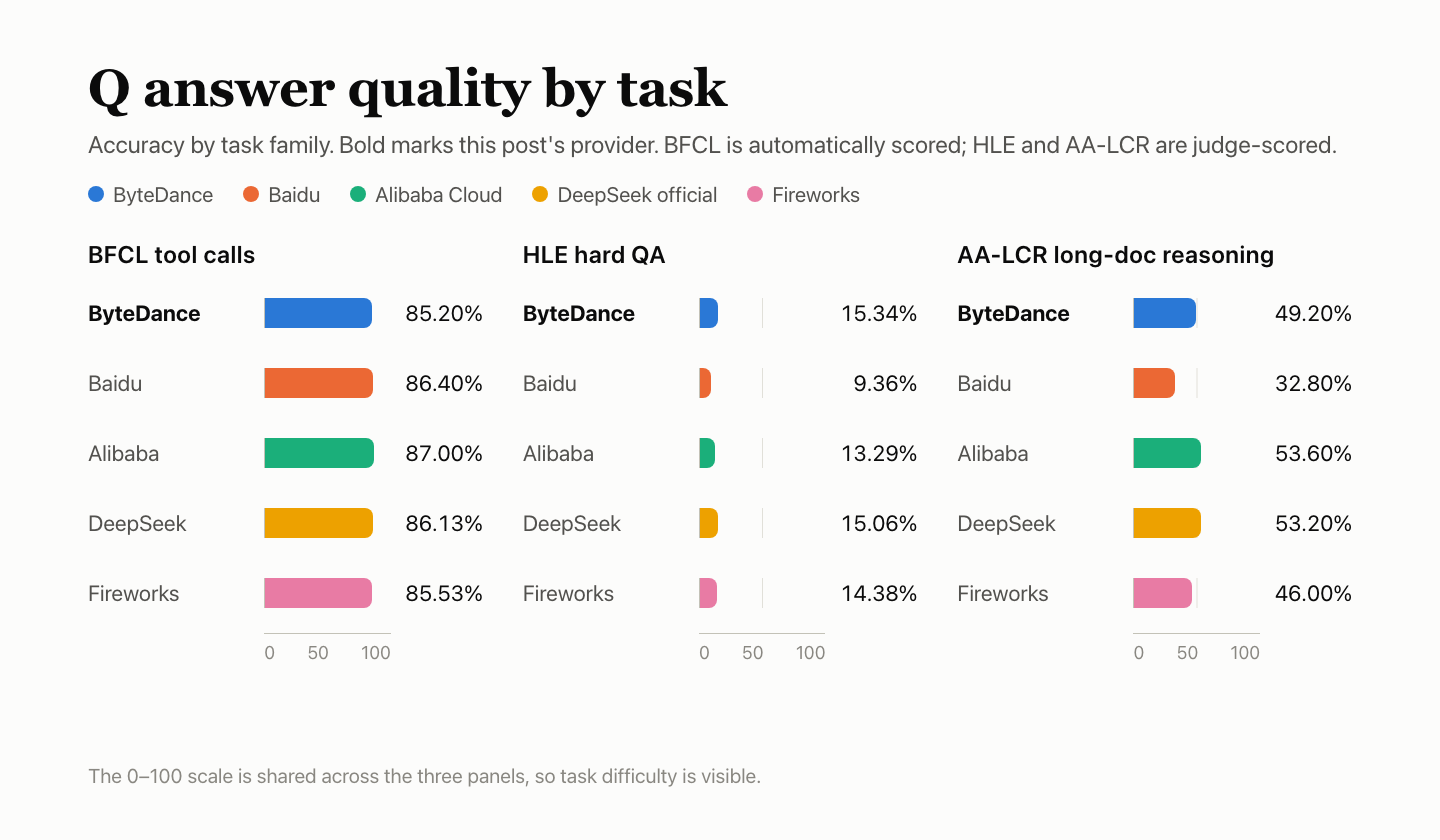
De antwoordkwaliteit is gebaseerd op drie suites: 500 BFCL-vragen met elk 3 rondes, 250 HLE-vragen met elk 10 rondes en 25 AA-LCR-vragen met elk 10 rondes. BFCL wordt automatisch beoordeeld; HLE en AA-LCR worden beoordeeld door het model deepseek-flash. Alle vijf aanbieders kregen dezelfde vragen en de drie suites zijn samengevoegd tot één nauwkeurigheidsscore. Tien antwoorden zijn verwijderd omdat de vraag niet kon worden beoordeeld; er bleven 4,240 beoordeelde vraaginstanties over.
| Suite | Vragen | Correct | Nauwkeurigheid | Mislukt |
|---|---|---|---|---|
| BFCL-tool-aanroepen | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| HLE-moeilijke QA | 250 × 10 | 382/2,490 | 15.34% | 7 |
| AA-LCR-redeneren over lange documenten | 25 × 10 | 123/250 | 49.20% | 28 |
| Gecombineerd · 95%-interval 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Servicefouten — mislukte aanvragen of afgebroken uitvoer — blijven in de noemer en tellen als fout. De HLE-uitvoer bereikte 7 keer de limiet van max_tokens; bij AA-LCR mislukten 28 aanvragen, allemaal in venster 1. BFCL wordt automatisch beoordeeld; HLE en AA-LCR worden beoordeeld door een beoordelingsmodel.
Elke BFCL-vraag is 3 keer beantwoord; de tabel telt de 3 rondes bij elkaar op.
| BFCL-categorie | Geslaagd | Slaagpercentage |
|---|---|---|
| simple_python — één functie, juiste aanroep en argumenten | 329/360 | 91.39% |
| multiple — kies één uit meerdere functies | 268/300 | 89.33% |
| parallel — roep dezelfde functie meerdere keren aan | 271/300 | 90.33% |
| parallel_multiple — roep meerdere verschillende functies aan | 207/240 | 86.25% |
| irrelevance — geen enkele functie is relevant; geen aanroep doen | 102/150 | 68.00% |
| ahm_multi_turn — toolketen in drie stappen | 101/150 | 67.33% |
Vergeleken met de andere vier
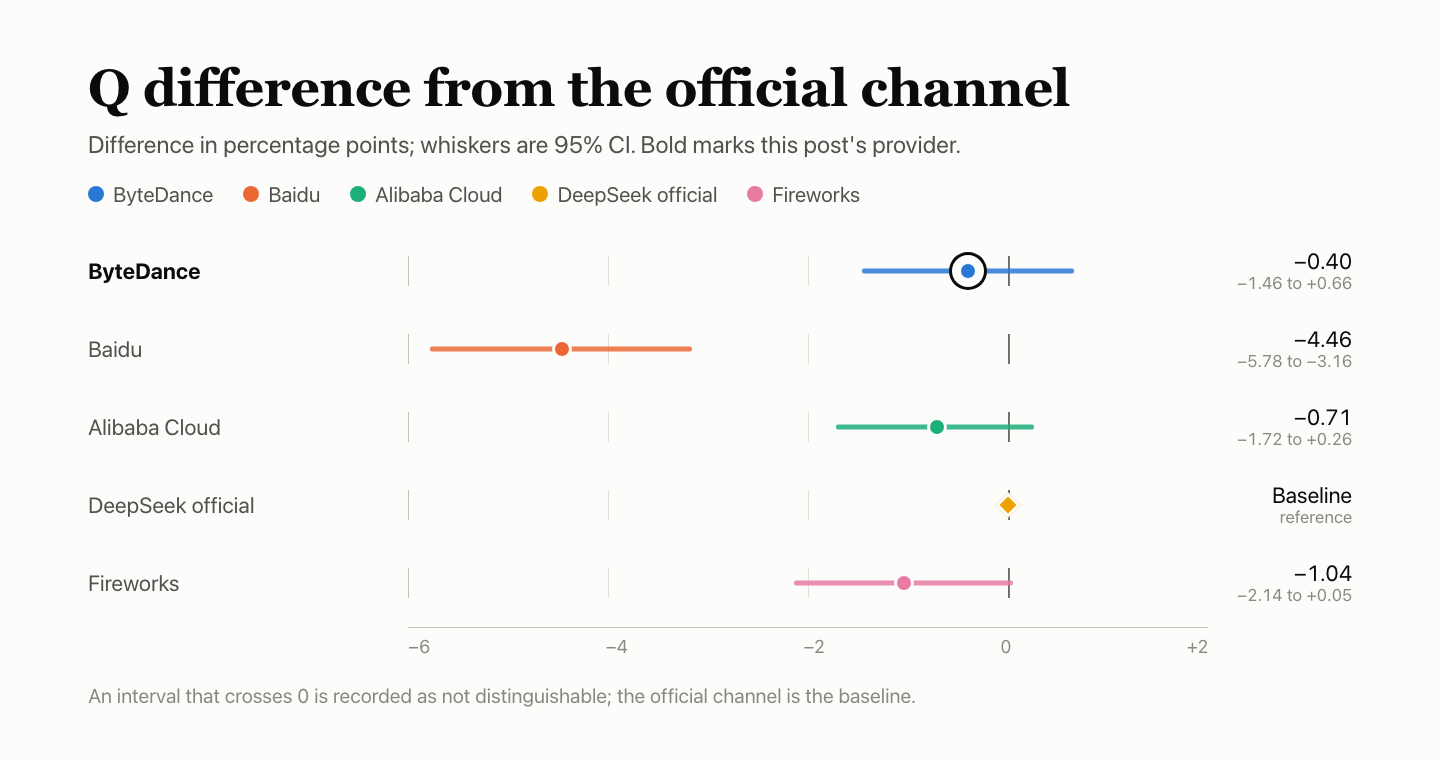
Verschil met het officiële kanaal in procentpunten, met het 95%-interval weergegeven als foutbalken. Een interval dat 0 kruist, wordt als niet te onderscheiden geregistreerd. De beoordelaar voor HLE en AA-LCR, deepseek-flash, behoort tot dezelfde DeepSeek-familie als het geteste model en is niet gekalibreerd; de beoordelingen kunnen daarom mild uitvallen.
F — functieondersteuning: 74.98
De functiesuite kijkt alleen of het gedrag van de interface overeenkomt met het protocol, niet of het model goed antwoordt. Zestig gevallen in zes groepen zijn drie keer uitgevoerd, één keer per venster: 180 controles, beoordeeld aan de hand van de indeling die elke aanbieder documenteert. Controles die niet van toepassing, ongeldig of niet waargenomen waren, zijn buiten de noemer gelaten. ByteDance slaagde voor 124 van de 174 meegetelde controles en scoorde 74.98 op basis van de groepsgewichten.
De gewogen score past de groepsgewichten toe; het is niet het aantal geslaagde controles gedeeld door 174.
| Groep | Gewicht | Geslaagd | Uitgesloten | Groepsscore |
|---|---|---|---|---|
| Streaming- en berichtprotocol | 20% | 23/27 | 3 | 85.19 |
| Toolinterface | 20% | 30/30 | — | 100.00 |
| Uitvoerbeperkingen en parameters | 20% | 24/30 | — | 80.00 |
| Context en status | 15% | 14/30 | — | 46.67 |
| Fouten en herstel | 15% | 21/30 | — | 70.00 |
| Metering- en cacheprotocol | 10% | 12/27 | 3 | 44.44 |
| Totaal · gewogen score | — | 124/174 | 6 | 74.98 |
‘Vensters mislukt’ geeft aan in hoeveel van de 3 vensters de controle mislukte.
| Mislukte test | Vensters mislukt | Reden |
|---|---|---|
| Redenering lekt niet door naar de inhoud — streaming- en berichtprotocol | 3/3 | Met reasoning_effort=none werd er toch denkcontent geretourneerd |
| Denkconfiguratie heeft effect — uitvoerbeperkingen en parameters | 3/3 | Met reasoning_effort=none werd er toch denkcontent geretourneerd |
| Variatie in sampling — uitvoerbeperkingen en parameters | 3/3 | Uitvoer bij temperatuur 0 en 1 verschilde niet genoeg; bleef onder de vooraf geregistreerde drempel |
| Lange invoer van 10k — context en status | 3/3 | Invoer gerapporteerd als 10,026 tokens; native telling hoort 10,000 te zijn |
| Binnen contextlimiet — context en status | 3/3 | Invoer gerapporteerd als 10,026 tokens; native telling hoort 10,000 te zijn |
| Lange invoer van 32k — context en status | 3/3 | Invoer gerapporteerd als 10,026 tokens; native telling hoort 10,000 te zijn |
| Lange invoer van 100k — context en status | 3/3 | Invoer gerapporteerd als 10,026 tokens; native telling hoort 10,000 te zijn |
| Boven de contextlimiet — context en status | 3/3 | Fout bij upstreamverbinding of time-out (1); had een parameterfout moeten retourneren, maar retourneerde 200 (2) |
| Geschiedenis van 12 beurten — context en status | 1/3 | Fout bij upstreamverbinding of time-out |
| Fout in messages-indeling — fouten en herstel | 3/3 | Retourneerde 400 met een lege body; geen gestructureerde foutuitleg |
| Losstaand toolresultaat — fouten en herstel | 3/3 | Had een parameterfout moeten retourneren, maar retourneerde 200 |
| Fout in stream_options-indeling — fouten en herstel | 3/3 | Retourneerde 400 met een lege body; geen gestructureerde foutuitleg |
| Telling van denk-tokens — metering- en cacheprotocol | 3/3 | Denk-tokens gerapporteerd nadat denken was uitgeschakeld |
| Native telling van invoer — metering- en cacheprotocol | 3/3 | 34 tokens gerapporteerd; native telling hoort 8 te zijn |
| Tooldefinities meegeteld in invoer — metering- en cacheprotocol | 3/3 | De controleaanvraag zonder tools kwam al niet overeen met de native telling van de invoer |
| Invoertelling consistent voor en na cache — metering- en cacheprotocol | 3/3 | Bij herhaling van hetzelfde prefix kwamen de gerapporteerde invoertokens niet overeen met de native telling |
| Invoer consistent bij streaming en niet-streaming — metering- en cacheprotocol | 3/3 | In beide gevallen 34 tokens gerapporteerd; native telling hoort 8 te zijn |
| Exacte tekstuitvoer — streaming- en berichtprotocol | 1/3 | Een extra punt aan het einde van de body; niet de exact gevraagde tekst |
Deze controles blijven buiten de noemer; ze tellen noch als geslaagd, noch als mislukt.
| Status | Geval | Aantal | Reden |
|---|---|---|---|
| Niet waargenomen | Streaming-stopsequenties | 3 | Na de vorige stap is deze aanvraag niet verzonden; beoordeling is niet mogelijk |
| Niet van toepassing | Expliciete cache_control | 3 | Vooraf geregistreerd als niet ondersteund door deze interface |
De gevallen met een fout in de messages-indeling en de stream_options-indeling mislukten bij alle vijf aanbieders: beide retourneerden 400 met een lege body, waardoor clients geen gestructureerde foutuitleg krijgen. Een fout die bij alle vijf voorkomt, zit waarschijnlijker op de gatewaylaag van AIHubMix en moet afzonderlijk worden onderzocht. Ook de telling van denk-tokens mislukte bij alle vijf, maar om verschillende redenen: ByteDance en Fireworks rapporteerden denk-tokens nadat denken was uitgeschakeld; de andere drie retourneerden geen telling van denk-tokens.
Vergeleken met de andere vier
P — reactiesnelheid: 84.37
Elke aanvraag bevatte ongeveer 10,000 invoertokens en vroeg om ongeveer 1,100 outputtokens aan bodytekst. In elk van de drie vensters zijn 30 aanvragen uitgevoerd bij gelijktijdigheid 1 en 30 bij gelijktijdigheid 10: in totaal 180 aanvragen.
| Metriek | Resultaat |
|---|---|
| Wachttijd tot eerste bodytoken (TTFA) | Mediaan 2.12 s bij gelijktijdigheid 1; mediaan 2.10 s bij gelijktijdigheid 10 |
| Generatiesnelheid (TPOT) | 3.43 ms/token bij gelijktijdigheid 1; 3.41 ms/token bij gelijktijdigheid 10 |
| Effectieve doorvoer | 1,250.0 token/s bij gelijktijdigheid 10 |
| Geldige aanvragen | 90/90 bij gelijktijdigheid 1; 90/90 bij gelijktijdigheid 10 |
| Deelscores | TTFA 48.59, TPOT 100.00, doorvoer 100.00; voor TTFA en TPOT geldt de laagste van de twee niveaus; gewichten 35% / 35% / 30%; reactiescore 82.00 |
| P-score | Reactiescore 82.00 met een gewicht van 80%, cache K 93.83 met een gewicht van 20%; totaal 84.37 |
TPOT is geschat op basis van gestreamde chunks, niet per token gemeten op de hardware. De doorvoer is het aantal geldige outputtokens bij gelijktijdigheid 10 gedeeld door de wandkloktijd van de batch.
Vergeleken met de andere vier
Alle vijf deelden één machine, netwerk en account. De drie vensters zijn per aanbieder ingepland, waardoor de verzamelperioden elkaar niet volledig overlappen; hecht dus niet te veel waarde aan kleine verschillen.
K — cache: 93.83
Elke groep verstuurt vijf aanvragen. De eerste bevat een vast prefix van ongeveer 8k of 32k tokens en vult de cache. Aanvragen 2–4 behouden het prefix en wijzigen alleen de laatste vraag, na 5 s, 30 s en 120 s. De vijfde gebruikt een nieuw prefix als koude controle. Drie vensters en twee lengtes, met vijf aanvragen per groep, leveren 30 aanvragen op. K is het aantal cacheleestokens bij warme aanvragen gedeeld door het aantal tokens dat volgens de regels herbruikbaar zou moeten zijn, waarbij de twee lengtes even zwaar wegen; K vormt 20% van P.
| Prefix | Venster | Vullen | +5 s | +30 s | +120 s | Koude controle |
|---|---|---|---|---|---|---|
| 8k | Venster 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Venster 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Venster 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Venster 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Venster 2 | 0 | 32,000 | 32,000 | mislukt | 0 |
| 32k | Venster 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Dit zijn de tokens die de server rapporteert als gelezen uit de cache.
Alle negen warme verzoeken van 8k werden uit de cache geleverd en lazen elk 7,936 tokens. Acht van de negen warme verzoeken van 32k werden uit de cache geleverd en lazen elk 32,000 tokens; één verzoek mislukte. K is 93.83, waarbij beide lengtes even zwaar wegen. Koude verzoeken lazen niets uit de cache, dus warm en koud zijn duidelijk van elkaar te onderscheiden. Het mislukte verzoek was het vierde verzoek van de 32k-groep in venster 2; het bereikte de deadline van 300 s zonder te worden voltooid.
Vergeleken met de andere vier
R — servicebetrouwbaarheid: 100
De 300 verzoeken vallen in vier typen — korte tekst, lange invoer, tool-aanroepen en gespreksgeschiedenis met meerdere beurten — en zijn bij gelijktijdigheid 1 in drie vensters uitgevoerd. Een verzoek telt alleen als geslaagd als de eerste poging een geldig, volledig antwoord opleverde; de juistheid van het antwoord wordt niet gecontroleerd en er wordt geen nieuwe poging gedaan. Mislukkingen in de onderdelen antwoordkwaliteit en snelheid tellen mee in Q en P, en worden niet nogmaals in R meegeteld.
| Verzoektype | Succes bij eerste poging |
|---|---|
| Korte tekst | 120/120 |
| Lange invoer van 10k | 90/90 |
| Tool-aanroepen | 60/60 |
| Gespreksgeschiedenis met meerdere beurten | 30/30 |
| Totaal · 95%-interval 98.78%–100% | 300/300 |
Alle 300 verzoeken leverden bij de eerste poging een geldig, volledig antwoord op. R = 100 geldt alleen voor deze 300 afzonderlijke verzoeken; het betekent niet dat de volledige keten geen mislukkingen kende. De ondergrens van het 95%-interval is 98.78%: 300 geslaagde verzoeken geven alleen aan dat het faalpercentage waarschijnlijk lager is dan 1.22%.
Vergeleken met de andere vier
R omvat alleen deze 300 afzonderlijke verzoeken; mislukkingen in de onderdelen antwoordkwaliteit en snelheid worden geregistreerd in Q en P en niet nogmaals meegeteld in R.
| Aanbieder | Succes bij eerste poging | 95%-interval |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officieel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Veelgestelde vragen
Is reasoning_effort=none er echt niet in geslaagd het denken uit te schakelen?
Ja. In alle drie de vensters retourneerden verzoeken met reasoning_effort=none nog steeds denkcontent, dus de controle mislukte 3/3 keer. Voor verzoeken over antwoordkwaliteit, snelheid, cache en stabiliteit werd in plaats daarvan de native schakelaar thinking.type=disabled gebruikt. De functiesuite hield bewust reasoning_effort=none aan om te testen of de parameter effect had.
De BFCL-nauwkeurigheid is 85.20%. Waarom is Q dan 42.05?
Q voegt drie suites met sterk uiteenlopende moeilijkheidsgraden samen. BFCL behaalde 1,278 juiste antwoorden van de 1,500, HLE 382 van de 2,490 en AA-LCR 123 van de 250. In totaal waren 1,783 van de 4,240 gescoorde vraaginstanties juist: 42.05%. De 15.34% van HLE drukt het samengevoegde cijfer omlaag.
Zijn de 35 servicefouten van Q in de score opgenomen?
Ja. Mislukte verzoeken en afgebroken uitvoer blijven in de noemer staan en tellen als onjuist. Zeven HLE-antwoorden werden afgekapt bij max_tokens; 28 AA-LCR-verzoeken mislukten, allemaal in venster 1.
Waarom is het belangrijk om invoertokens te tellen?
Omdat de afrekening overeen moet komen met de native telling van het model. Een invoer van 10k tokens werd gerapporteerd als 10,026 tokens (native: 10,000), en een invoer van 8 tokens als 34. Zelfs het controleverzoek zonder tools week al af, en zowel streaming als niet-streaming rapporteerde 34. Bij alle vijf afrekencontroles mislukte de controle 3/3 keer.
Was het cache-resultaat voor 32k een cache-miss of een mislukking?
Een mislukking. Acht van de negen warme verzoeken van 32k werden uit de cache geleverd en lazen 32,000 tokens. De ene mislukking was het vierde verzoek in venster 2; het bereikte de deadline van 300 s zonder te worden voltooid. De 8k-groep werd bij 9/9 verzoeken uit de cache geleverd en las 7,936 tokens.
Is de antwoordkwaliteit van ByteDance te onderscheiden van die van het officiële kanaal?
Nee. De gecombineerde nauwkeurigheid ligt 0.40 punten lager dan die van het officiële kanaal, met een 95%-interval van −1.46 tot +0.66. Het interval omvat 0, dus de twee zijn niet van elkaar te onderscheiden. Dit beschrijft alleen deze batch en is geen rangschikking.
Lees verder: de DeepSeek V4.1 Flash-reeks
- De Q-basislijn in dit artikel is het officiële kanaal; de eigen run daarvan, inclusief de 15 ongeldige probes bij gelijktijdigheid 1, wordt besproken in DeepSeek V4.1 Flash via het officiële kanaal: 94.00 F, 15 ongeldige probes.
- Baidu is de enige aanbieder waarvan het Q-interval onder dat van het officiële kanaal ligt; de kanaalfouten achter dat resultaat staan in DeepSeek V4.1 Flash op Baidu: geen beschikbaar kanaal haalt Q en P.
- De cachecijfers van Alibaba Cloud staan naast de 93.83 die hier wordt gerapporteerd: DeepSeek V4.1 Flash op Alibaba Cloud: 1.34s tot het eerste token, 99.37 cache.
- Fireworks vertoont dezelfde problemen met denken en tokentelling als hier, en voegt daar lege antwoorden bij stop aan toe: DeepSeek V4.1 Flash op Fireworks: lege antwoorden bij stop, 3/9 cache-hits.


