Anthropicは2026年11月9日にClaude Fable 5.2をリリースしました。Googleはその翌日、Gemini 4 Carbonを一般提供開始しました。Anthropic自身のローンチ時ベンチマーク表にはCarbonの列もあり、同じ長時間にわたるコーディング作業を比較するのに役立ちます。
両モデルは、長時間にわたるエージェント型コーディングという同じ用途向けに提供されています。エージェントがリポジトリを読み、複数のファイルを編集し、コマンドを実行し、テスト結果を読み取り、人間とのやり取りを挟まずに15〜45分間作業を続けます。ここで評価するのはこのタスクです。チャット、オートコンプリート、短いスクリプトは別のテストです。
結論
掲載されている難度の高いコーディングベンチマークではFable 5.2が優位で、同じeffortならより高速です。Carbon Highを#4に抑え、上位3位を占めています。掲載されているTerminal-Bench 4.0とAutomationBench-AAではCarbonのスコアが高く、Googleの導入価格が11月30日に終了するまでは、High effortでタスクあたりの費用も安くなります。MediumではFableのほうが安く、はるかに高速ですが、AAインデックスではCarbonのスコアが上回ります。
難度の高いコード推論にはFable、ターミナル操作と自動化にはCarbonを選びましょう。どちらを選ぶ場合も、入力、データ保持、出力の上限を事前に確認してください。
同一ハーネスでの比較
Artificial Analysisは全モデルを同一のハーネスとタスクで実行しており、CarbonとFableのページで評価ごとの結果を公開しています。数値は2026年11月11日のスナップショットに基づきます。AAではGoogleの導入割引ではなく、標準価格を使用しています。
| モデル | AAインデックス | $/タスク | 分/タスク | 最初のトークン |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
注:AA Intelligence Indexとタスクあたりの費用は標準価格に基づく。スナップショットは2026-11-11T05:23Z。Fable Max、Xhigh、Highは#1〜#3、Carbon Highは#4、Opus 5.5 Maxは#5、Carbon Mediumは#6。最初のトークンは、最初の回答トークンが出るまでの時間です。
High effortではFableが1.79ポイント上回り、タスクあたりの費用は17.0%高く($9.08対$7.76)、所要時間は25.6分ではなく17.3分、最初のトークンが返るまでの時間は67.1秒ではなく30.4秒です。Maxはタスクあたり$26.54でCarbon Highの3.4倍かかり、最初のトークンまで233.9秒待ちます。
Mediumでは順位が逆転します。Fableのスコアは56.41で、Carbonの58.26を1.85ポイント下回りますが、費用は$6.59に対して$3.80、所要時間は23.3分に対して7.8分です。ここではCarbonのトークン単価が低くても、タスクあたりの費用は安くなりません。使用トークン数が多いためです。
| ベンチマーク | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| 非幻覚率 % | 88.58 | 42.02 | 40.73 | 49.66 |
| 正確性 % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
注:Artificial Analysis。同一のハーネスとスナップショットを使用。非幻覚率は、Omniscienceの回答のうち、捏造された主張を含まないものの割合です。正確性は別のスコアです。すべての項目で高いほど優れています。表を見やすくするためFable Xhighは省略しています。同モデルのFrontierCode 2.0スコアは47.58です。
High effortで各テストの首位に立つのはどちらでしょうか?以下の符号付き差分はCarbonからFableを引いた値です。表の絶対スコアを保ちながら、優劣の方向を示します。
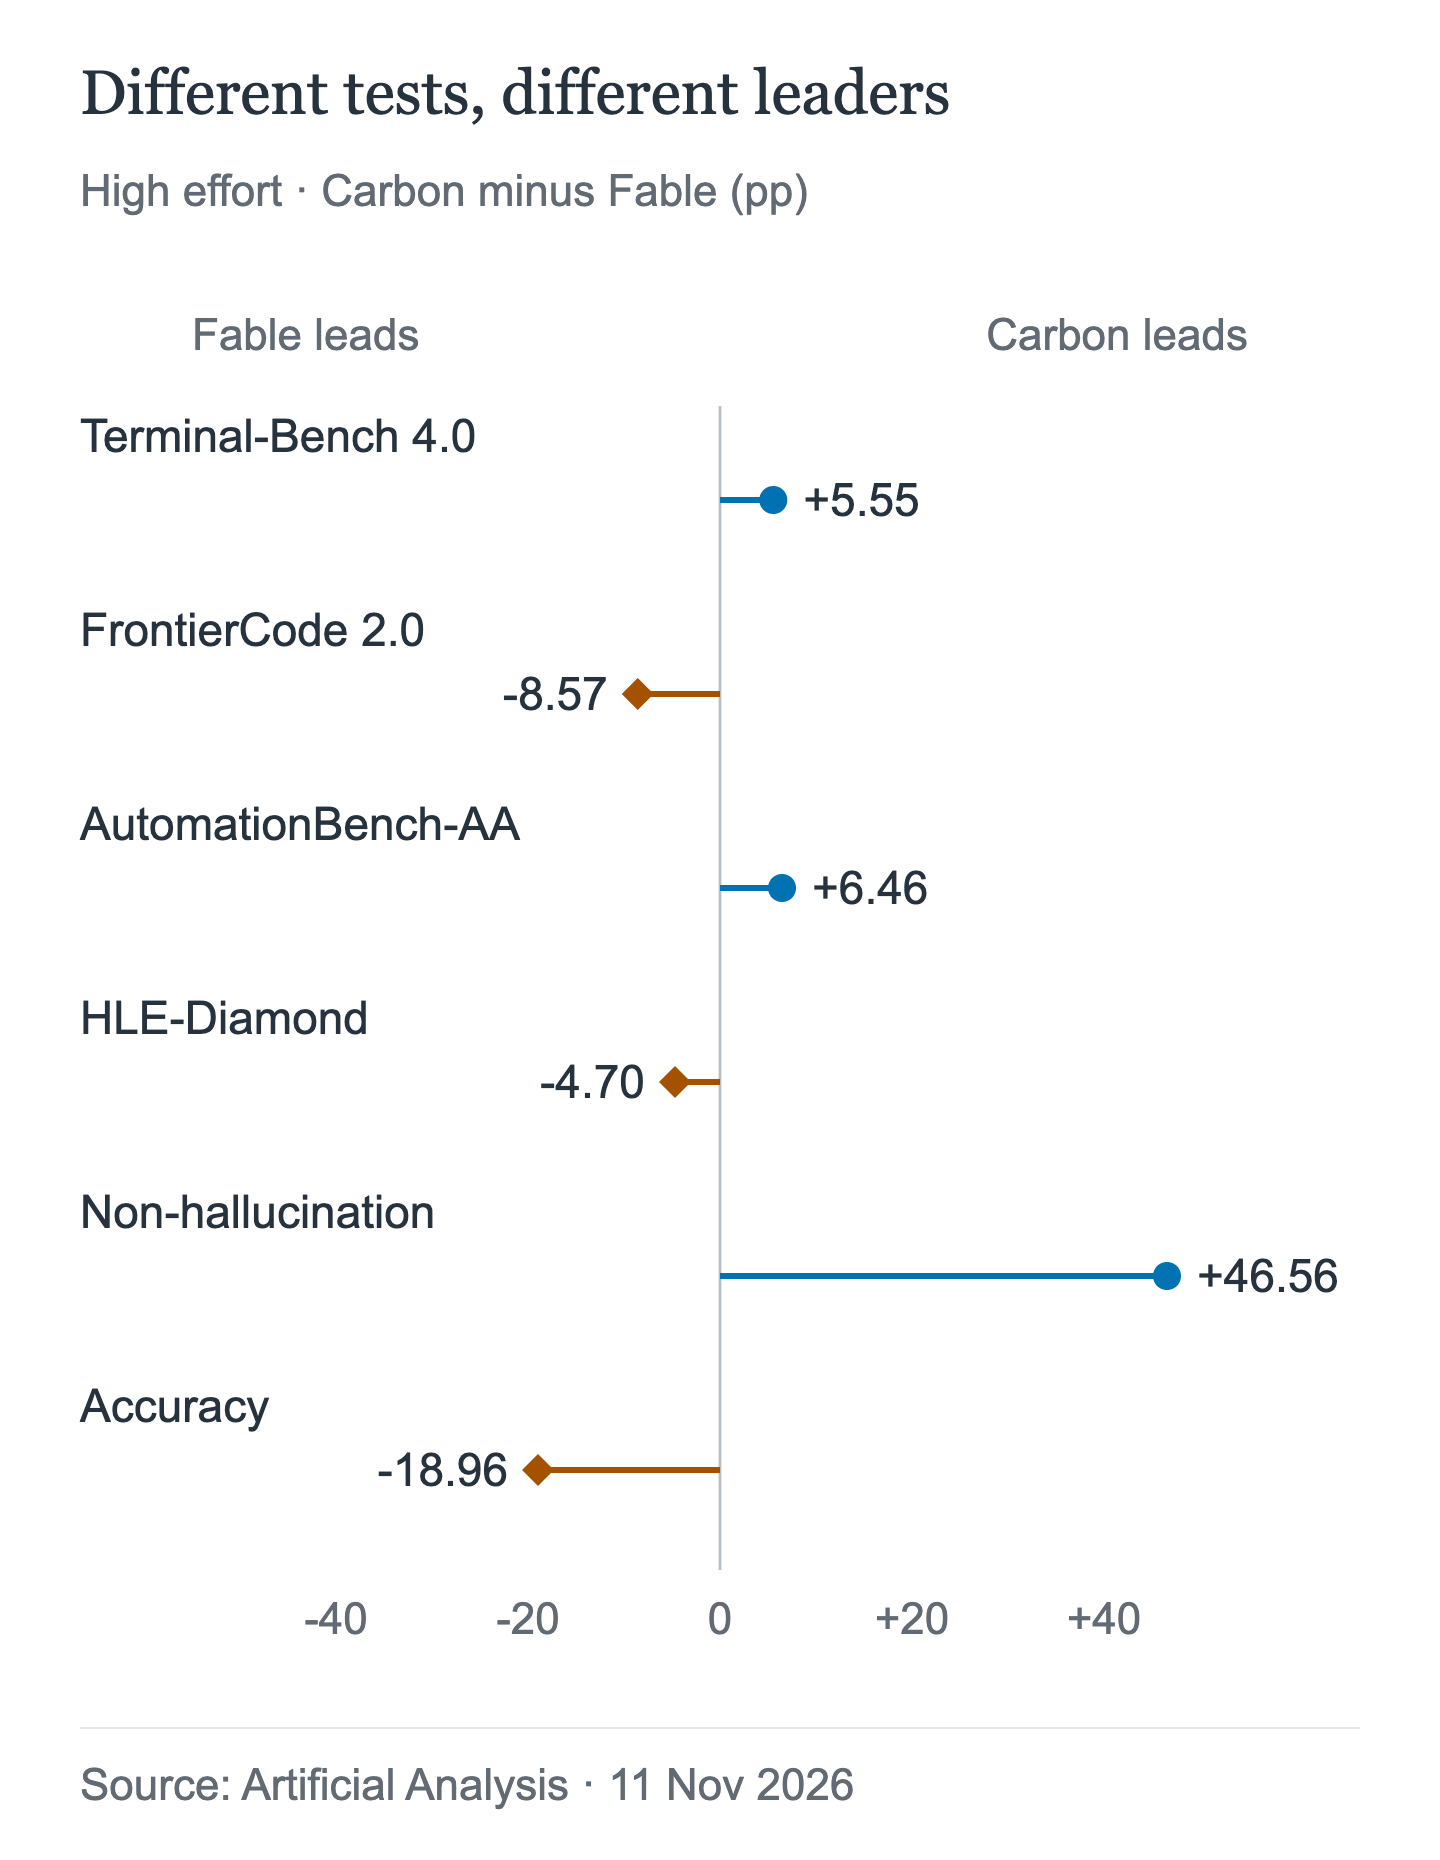
これらは独立したテストでのパーセンテージポイント差であり、品質を総合したスコアではありません。あるベンチマークで差が大きくても、総合的な能力が大きく向上しているとは限りません。特に、非幻覚率と正確性は異なる結果を測定しています。
HighではFableがFrontierCode 2.0で8.57ポイント、HLE-Diamondで4.7ポイント上回ります。Briefcase EloはFableが1677.4、Carbonが1610.6です。FrontierCodeは、難度の高い複数ファイルのコード変更に最も近いベンチマークです。CarbonはTerminal-Bench 4.0で5.55ポイント、AutomationBenchで6.46ポイント上回り、コマンドライン実行、エラーからの復旧、自動化が評価されています。
非幻覚率の差は表の中で最大です。HighではCarbonが88.58%、Fableが42.02%です。一方、正確性は逆方向で、Carbonが58.27%、Fableが77.23%です。Carbonは捏造する可能性が低い一方、正答する可能性も低くなります。APIをでっち上げてはならないエージェントなら、その特性が有利になる場合があります。正答が求められるエージェントでは、Fableの正確性のほうが有力な指標です。
より高いeffortが常に優れているわけではありません。Fable MaxのFrontierCodeスコアは48.76で、Highの49.13をわずかに下回り、Terminal-Benchも59.6のままです。
Anthropic独自の表
Anthropicのローンチページには、Carbonを含む他社モデルとの比較表が掲載されています。設定はAAと異なり、Fableは報告されている中で最も高いeffortのXhigh、CarbonはMediumで実行されています。この表の中だけで比較してください。
| ベンチマーク | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
注:Anthropicによる自己申告値。Fableは利用可能な中で最も高いeffortのXhigh、CarbonはMediumで実行。AnthropicのAutomationBenchはAAとはスケールが異なります(51.4/53.9対71.36/77.82)。そのため、この表の中で比較してください。CarbonのFrontierCode 41.1はMediumでの実行結果で、AAの40.56は別のハーネスでのHighの結果です。
傾向はAAと一致しています。FrontierCode、FrontierSWE、OSWorld、TB-ScienceではFableが優位です。CarbonはAutomationBenchで2.5ポイント上回ります。AAの6.5ポイントより小さいものの、方向は同じです。この表から言えるのは「Carbonは自動化で競争力がある」ということであり、「難度の高いコーディングではCarbonが優れている」ということではありません。
Anthropic自身の推奨は、「Fableがアップグレード」という見方を複雑にします。「ほとんどのコーディングおよび知識タスクでは、まずClaude Opus 5.5から使い始めることを推奨します」としています。High effortでは、FableのスコアはOpus 5.5の最高値(45.3%対45.5%)とほぼ同等で、タスクあたりの費用はおよそ半分だと述べています。
トークンの料金
| モデル | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| Carbon、11月30日まで | $2 | $10 | $0.10 |
| Carbon、12月1日以降 | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
注:公式価格。1MトークンあたりのUSD。Fableのキャッシュ書き込み料金は$10(5分)または$16(1時間)。Batchは50%割引です。Carbonのキャッシュ価格は読み取り料金です。Opus 5.5の公式キャッシュ読み取り価格は$0.20です。
Fableのトークン単価はCarbonの標準料金の2倍、導入料金の4倍です。比率は単純ですが、タスクあたりの請求額はそう単純ではありません。AAの測定では、Carbon Highは料金が$4/$20で$7.76、Fable Highは$9.08となり、差は17.0%でした。Googleの$2/$10の料金なら、同じ使用量で約$3.88になる計算です。11月30日までは、Fable Highのタスクあたりの費用は約2.3倍です。12月1日以降は差が17.0%に戻ります。
標準価格では、Fable Mediumの費用は$3.80で、Carbonの$6.59より42%安くなります。トークン単価が2倍でも、費用を抑えられます。Carbonは23.3分かかり、より多くのトークンを使うのに対し、Fableは7.8分です。導入料金では、同じ方法で計算するとCarbon Mediumは約$3.30で、Fableに近い水準です。この優位性は12月1日に失われます。
MaxはCarbon Highのタスクあたりの費用($26.54)の3.4倍で、所要時間は45.2分です。費用を増やしても、コーディングエージェントの性能が一様に向上するわけではありません。MaxのFrontierCodeはHighをわずかに下回っています。
AIHubMixではCarbonをGoogleの導入価格で提供しています。Fableの数値はAnthropicの公式料金に基づきます。
導入を左右する挙動の違い
| 項目 | Carbon | Fable 5.2 |
|---|---|---|
| 最大出力 | 65,536。ネイティブでは≤1,048,576−入力* | 128,000 |
| コンテキスト | 1,048,576(Googleネイティブ) | 1M |
| 思考 | low / medium / high。デフォルトはmedium | adaptive。デフォルトはhigh |
| ツールの強制指定 | autoが文書に記載* | any / toolは400を返す |
| サンプリング | 無視される。削除すること | 一部の値は400を返す |
| データ保持 | 上限の記載なし | 30日。ZDRなし |
| 入力 | AIHubMixではテキスト | テキスト、画像、PDF† |
| カットオフ | 2026年3月 | 2026年6月 |
注:*Carbonのより高い上限はGoogleネイティブの長時間デコード機能によるものです。AIHubMixが現在文書化しているのはテキスト入力とChat Completionsのみのため、ゲートウェイでの対応は未確認です。†Fableの入力モダリティはAIHubMixのモデルインデックスに基づきます。*AIHubMixはtool_choice="auto"を文書化していますが、Carbon固有の対応は未確認です。Fableの出力上限128,000は、文書に記載されたモデル上限です。ZDRはゼロデータ保持を意味します。
ツールの強制使用はFableの重大な障害になります。「Forced tool use(tool_choiceの型がanyおよびtoolの場合)は400エラーを返します」。毎ターン特定のツールを必ず呼び出す必要があるエージェントでは、Fableをそのまま使えません。GoogleのCarbonガイドは、ツール実行を逐次的なターンで行うことを推奨しています。AIHubMixはGeminiガイドでtool_choice="auto"を文書化していますが、ゲートウェイ上でのCarbon固有のツール対応は未確認です。
データ保持はFableのポリシー上の障壁です。Fableの概要には、「30日間のデータ保持が必要であり、Anthropicから明示的な許可を得ない限り、ゼロデータ保持では利用できません」とあります。ここで確認したCarbonの文書には同様の制約は記載されていませんが、保証を意味するものではありません。規制対象の業務で導入する場合は、両方のポリシーを事前に確認してください。
Carbonの標準上限65,536トークンでほとんどの編集に対応できますが、ファイル全体の生成では上限に達する可能性があります。Googleネイティブのバックグラウンドモードでは、入力を差し引いた最大1,048,576まで対応できますが、セグメントごとのホップにも料金が発生し、請求が続いているのにテキストが空のままincompleteを返すことがあります。AIHubMixはこの経路を文書化していません。Fableは128,000トークンを1回の応答で出力します。
どちらのモデルも思考を無効にできません。Carbonはlow、medium、highを選べ、デフォルトはmediumです。また、サンプリングパラメーターは無視されます。Fableでは「adaptive thinkingは常に有効で、オフにできません」。デフォルトはhighで、一部のサンプリング値に対して400を返します。
GoogleはGAに先立ち、Fairwindプログラムを通じてCarbonを防御側の担当者に提供しました。Fableの分類器はペネトレーションテストやエクスプロイトの依頼をブロックし、サイバーセキュリティや生物学の作業では他のモデルにフォールバックします。セキュリティテストでは、ベンチマークの数値よりも拒否の挙動が重要です。
比較基準としてのOpus 5.5
Opus 5.5は競合モデルではありませんが、Anthropic自身の比較基準です。料金は$4/$20で、AAスコアは59.11、タスクあたりの費用は$10.04、所要時間は25.0分、最初のトークンまで356.4秒で、表中最も遅いモデルです(AAの行はMax effortで、デフォルトはmedium)。Briefcase Eloでは1800.6で首位ですが、FrontierCodeではFable Highに、Terminal-BenchではCarbon Highに及びません。それでもAnthropicは、ほとんどのコーディング作業でまずOpus 5.5から使い始めることを推奨しています。
どちらを選ぶべきか
難度の高いコード変更が中心で、測定上のFrontierCodeおよびHLEの最高成績を求めるならFable 5.2を選びましょう。MediumではCarbonの$6.59、23.3分に対し、Fableは$3.80、7.8分と、より安く高速です。一方、AAインデックスではCarbonのほうが高いスコアです。画像入力や2026年6月のカットオフを重視する場合、または30日間のデータ保持とツール呼び出しの強制ができないことを許容できる場合にもFableを選びましょう。
ターミナル作業が中心ならCarbonを選びましょう。テストと修正の反復、シェルの自動化、複数ステップの操作に適しています。掲載されているTerminal-Bench 4.0とAutomationBench-AAの項目ではより高いスコアを記録し、11月30日まではHigh effortでより低価格です。Googleネイティブのコンテキストと長文出力の上限は、AIHubMix経由では確認されていません。Carbonのツール対応を確認したうえで、tool_choice="auto"を使い、テキストのみでデプロイしてください。非ハルシネーションスコアは高い一方、精度は低くなっています。
Anthropicが推奨する出発点とバランスの取れた性能を重視するなら、Opus 5.5を選びましょう。ただし、Max effortでは最初のトークンが遅くなります。
対話型の低レイテンシを求めるなら、どちらも選ばないでください。High effortで最初のトークンが出るまで、Fableは30.4秒、Carbonは67.1秒かかります。CarbonのMediumでも23.2秒と、チャット用途にはまだ遅すぎます。
AIHubMix経由で両方を試す
AIHubMixでは、1つの API キーと共通のチャット補完エンドポイントで両モデルを利用できます。Carbonの ID はgemini-4-carbonです。モデルページには、チャット補完、テキスト入力、Googleの導入価格が記載されています。Fable 5.2の ID はclaude-fable-5-2です。AIHubMixでは、Chat Completions、Responses、Anthropic Messagesに対応し、コンテキストは1M、最大出力は128Kとされています。Carbonの対応範囲はより限定的で、Google Gemini APIネイティブではなく、チャット補完に対応しています。また、ゲートウェイは次に最適なプロバイダーへ再試行するため、単一プロバイダーでのデプロイとは挙動が異なる場合があります。
クイックスタートでは、認証とベース URLについて説明しています。簡単なスモークテストで、同じキーから両方の ID にアクセスできるか確認できます。この原稿ではライブテストを実施していません。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
これはルーティングの確認であり、機能の確認ではありません。ツールも長文出力も使っていません。実際に比較するには、同じエージェントのトレースを両方の ID に対して実行し、タスク時間、トークン使用量、失敗を記録してください。比較ページでは、コンテキスト、プロトコル、価格を並べて確認できます。
よくある質問
Gemini 4 Carbonはエージェント型コーディングでFable 5.2より優れていますか?
どちらも、あらゆる作業で優れているわけではありません。High effortでは、FrontierCode 2.0と総合指数でFable 5.2が上回り、Terminal-Bench 4.0とAutomationBenchではCarbonが上回ります。エージェントが実際に行う作業に応じて選びましょう。
Fable 5.2の価格はなぜCarbonの4倍なのですか?
公式価格では、Fableは100万トークンあたり入力$8/出力$40、Carbonは導入価格$2/$10なので、入力も出力も4倍です。12月1日以降のCarbonの通常価格$4/$20と比べると、2倍です。
Fable 5.2はMediumで本当にタスクあたりのコストが低いのですか?
通常価格ではそのとおりです。Fableは$3.80、Carbon Mediumは$6.59で、所要時間もそれぞれ7.8分と23.3分です。Carbonの導入価格ではトークン単価の差が縮まりますが、長期的に参考になるのは通常価格での比較です。
Fable 5.2でツール呼び出しを強制できますか?
できません。Anthropicのドキュメントによると、tool_choiceの値にanyまたはtoolを指定すると400エラーになります。ツール呼び出しの強制が必要なエージェントでは、別のループ構成にするか、別のモデルを使用してください。
Fable 5.2よりCarbonのほうがハルシネーションを起こしにくいですか?
AAのOmniscienceにおける非ハルシネーション指標では、そのとおりです。HighではCarbonが88.58%、Fable 5.2が42.02%です。一方、Carbonの精度は58.27%で、Fable 5.2の77.23%を下回るため、正しい回答を返す可能性も低くなります。
両方のモデルを1つのキーでAIHubMix経由で利用できますか?
はい。同じキーとベース URLを使い、gemini-4-carbonとclaude-fable-5-2を指定してください。AIHubMixのドキュメントでは、Carbonはチャット補完、Fableはチャット補完、Responses、Messagesに対応しています。
続けて読む:Gemini 4 Carbonシリーズ
- 別のモデルを選ぶ前に、まず兄弟モデルとの比較を確認しましょう。Gemini 4 Carbon vs Argon:同じ価格で、Carbonを選ぶべきなのはどんなとき?
- Carbonをワークフローに組み込んだあとに最初に発生する400エラーやタイムアウトは、通常、モデルではなく設定が原因です。Gemini 4 Carbon APIへの移行:400エラー、タイムアウト、出力上限
出典
- Gemini 4 Carbonが利用可能に — Google、2026年11月10日。
- Claude Fable 5.2 — Anthropic、2026年11月9日。
- Claude Fable 5.2の概要 — Anthropicのドキュメント。
- Gemini 4 CarbonおよびClaude Fable 5.2 — Artificial Analysis、2026年11月11日時点のスナップショット。
- AIHubMixのGemini 4 Carbon — モデルページと価格。